話者ダイアライゼーションとは?仕組みと活用例
- 公開日
- 最終更新日
話者ダイアライゼーションは、話者数が不明なオーディオストリームから、ラベル付きセグメントのタイムラインを作成します。たとえば、0:00〜0:42は話者A、0:42〜1:15は話者B、1:15以降は再び話者Aといった形です。システムは話者が誰なのかは把握していませんが、別々の人物であることを認識し、録音全体を通してラベルの一貫性を保ちます。
このプロセスにより、複数話者のオーディオを活用できるようになります。会議メモ、コールセンター分析、インタビューの文字起こし、ポッドキャスト編集、法的記録では、何が話されたかだけでなく、誰が話したかを知ることが不可欠です。
このガイドでは、ダイアライゼーションの仕組み、セグメンテーションや識別などの関連技術との違い、対応するオープンソースツール、ダイアライゼーションシステムの性能評価方法を解説します。
概要
- 話者ダイアライゼーションは、誰が話しているかに基づいて録音をセグメント化し、名前で個人を特定せずにラベル付きの話者ターンを生成します。
- 話者ダイアライゼーションは、話者の切り替わり時点を検出する話者セグメンテーションや、声を実名と照合する話者識別とは異なります。
- ダイアライゼーションの性能は、全体精度を示すダイアライゼーション誤り率(DER)と、すべての話者で精度が保たれているかを確認するJaccard誤り率(JER)で測定します。
話者ダイアライゼーションとは?仕組みとユースケース
話者ダイアライゼーションは、誰が話しているかに応じてオーディオストリームをセグメントに分割するプロセスです。話者ダイアライゼーション付きの文字起こしでは、各オーディオセグメントに話者IDが付与されます。簡単に言えば、「誰がいつ話したか?」という問いに答えるものです。
会議の生の文字起こしでは発言内容だけがわかりますが、ダイアライゼーション済みの文字起こしでは、話者1が質問し、話者2が答え、話者3が途中で割り込んだことまでわかります。
ほとんどの話者ダイアライゼーションシステムは、4段階のパイプラインに従います。
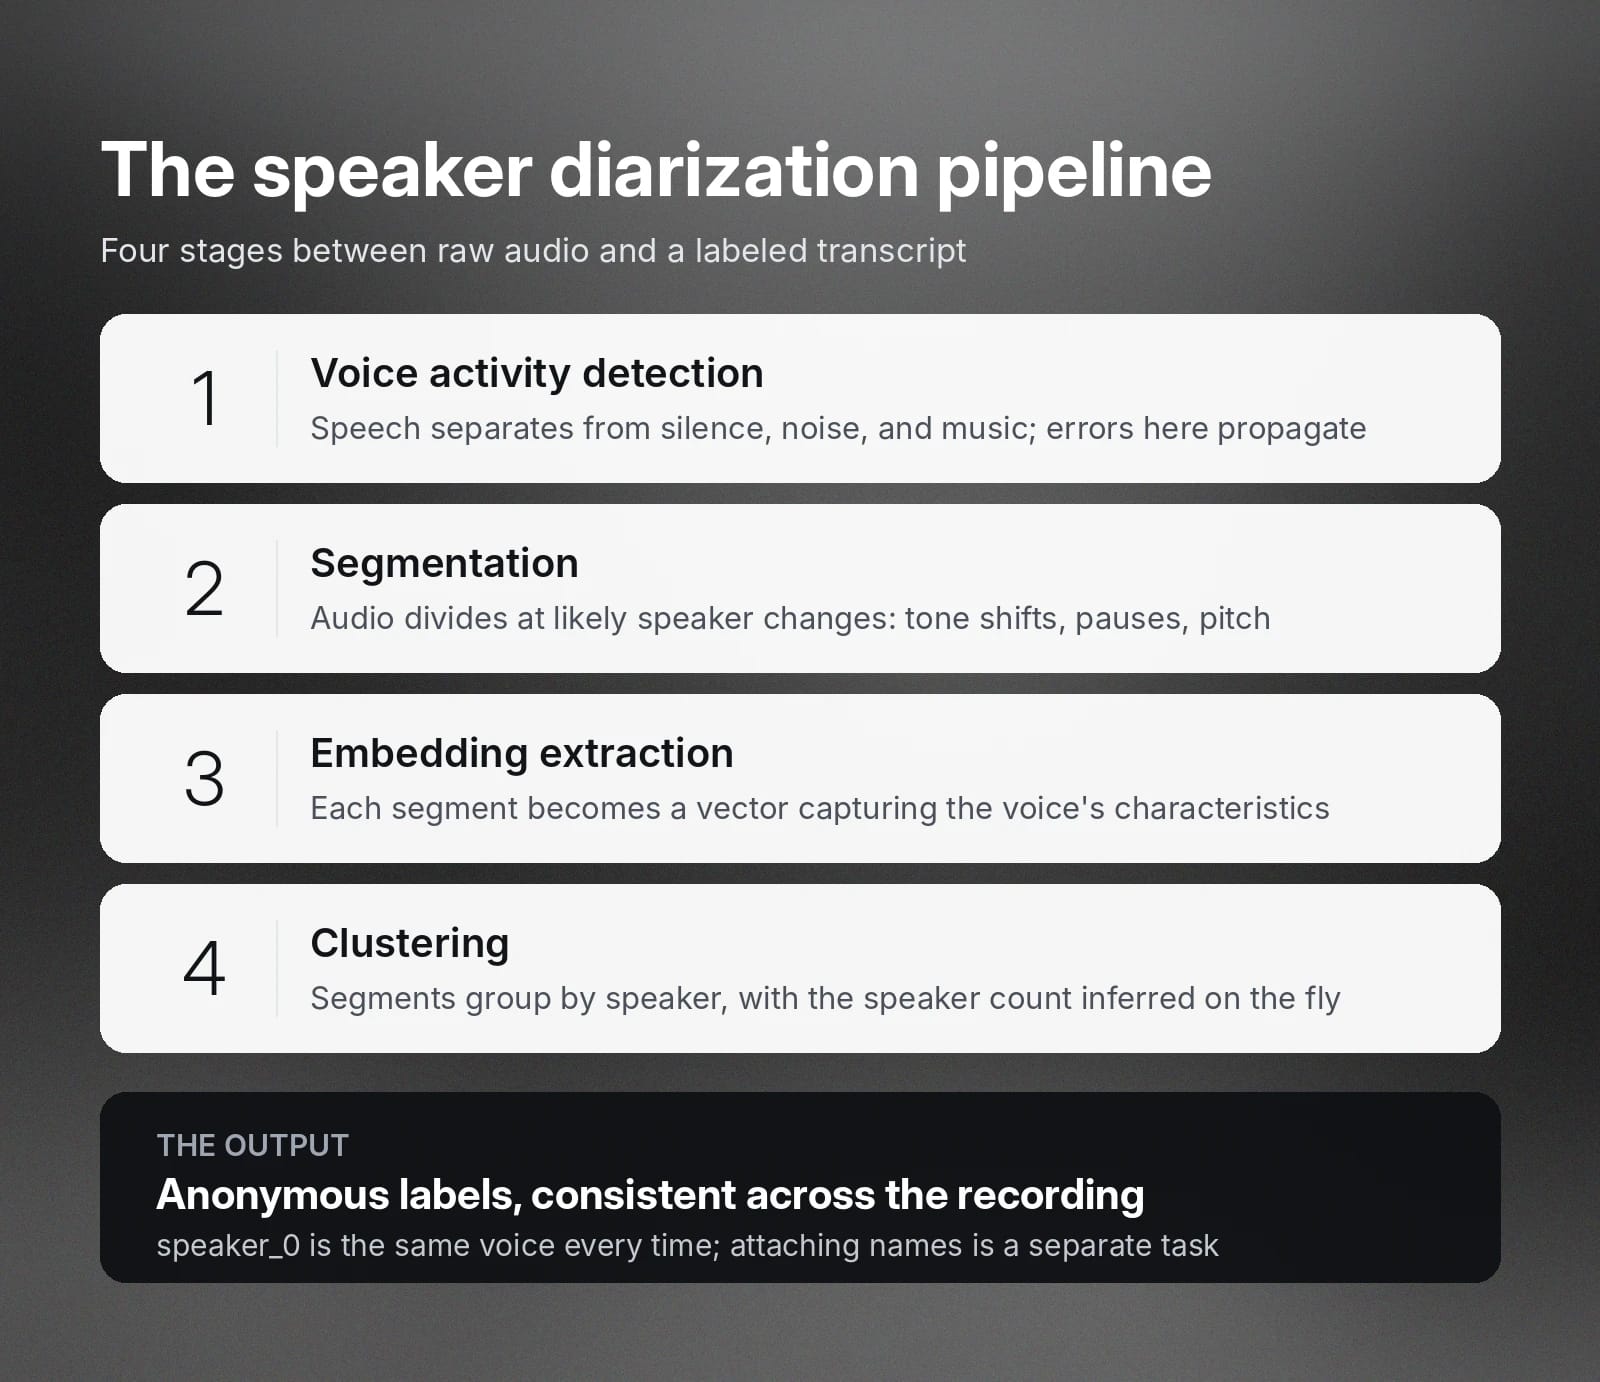
各段階を詳しく見ていきましょう。
音声区間検出(VAD)
音声区間検出は、音声をそれ以外の要素、つまり無音、バックグラウンドノイズ、音楽、キーボードのクリック音から分離します。実際の音声を含むオーディオセグメントだけが次の段階に進みます。
この段階で発生したエラーは、後続のすべての段階に波及します。
セグメンテーション
音声を含むセグメントは、話者が切り替わる可能性が高い地点でさらに分割されます。たとえば、声色の変化、発話ターン間の間、ピッチパターンの変化などです。ほとんどのシステムは、候補となる境界の両側にある音響特性を比較して、こうした変化点を直接検出します。
一部のセグメンテーションツールは、オーディオを2秒単位のような短く均一なウィンドウに分割し、同じ話者に属する隣接ウィンドウをクラスタリング段階で統合します。
埋め込み抽出
各音声セグメントは、そのセグメントで話している人物の音声特性を捉えた数値ベクトル、つまり話者埋め込みに変換されます。同じ話者の埋め込みはベクトル空間内で近くに集まり、異なる話者の埋め込みはより離れた位置にあります。
クラスタリング
次に埋め込みをグループ化し、同じ話者のセグメントに同一のラベルを付与します。通常、システムは話者数を事前には把握していないため、クラスタリングアルゴリズムが推定する必要があります。つまり、少し異なって聞こえるセグメントが新しい話者なのか、声色を変えた同一人物なのかを判断します。
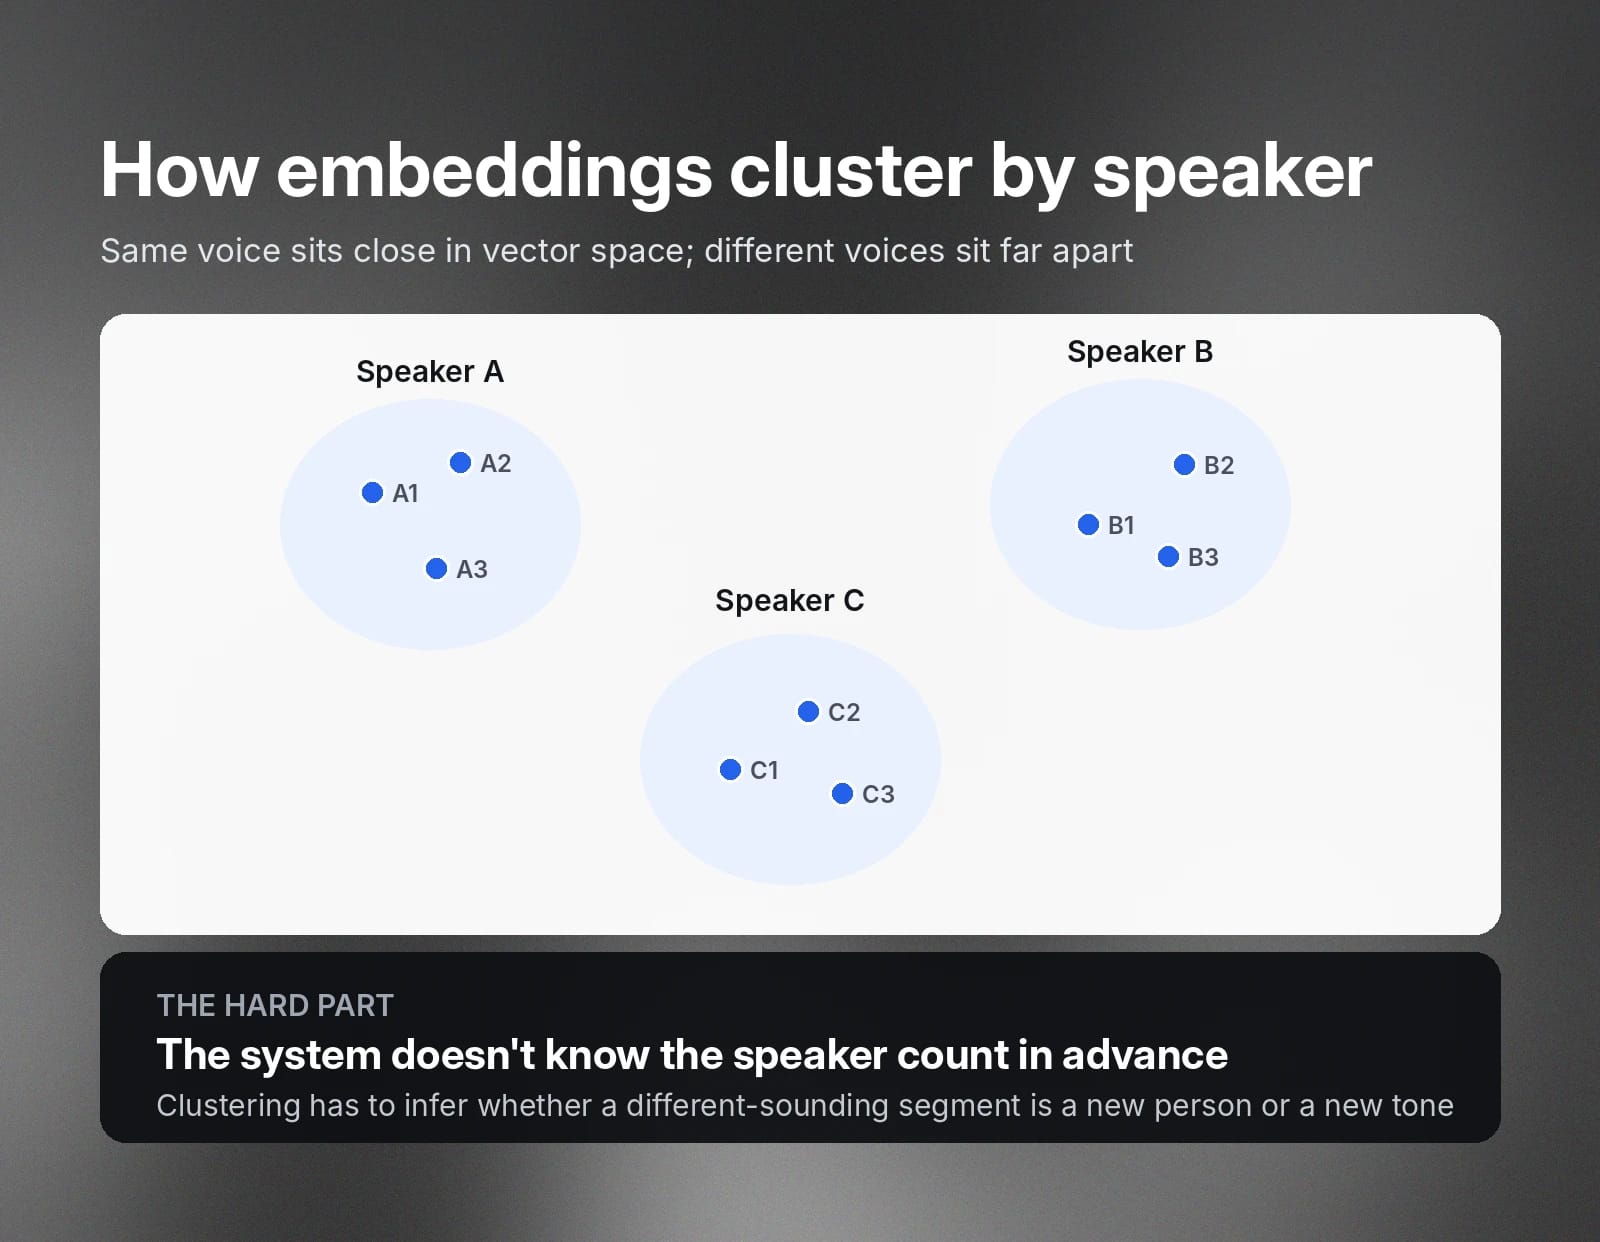
出力は、通常は文字起こしと組み合わせた、時間範囲に紐づく話者ラベルのセットです。たとえば、2人の通話をダイアライゼーションした文字起こしは次のようになります。
- [speaker_0] お電話ありがとうございます。どのようなご用件でしょうか?
- [speaker_1] こんにちは。先月の請求書についてお電話しました。
- [speaker_0] 承知しました。確認します。
ラベルは匿名で、内部的な一貫性があります。speaker_0は表示されるたびに同じ声を指しますが、システムはspeaker_0がFergalという名前であることは知りません。実際の身元を紐づけるのは別のタスクで、後ほど説明します。
話者セグメンテーションと話者識別の主な違い
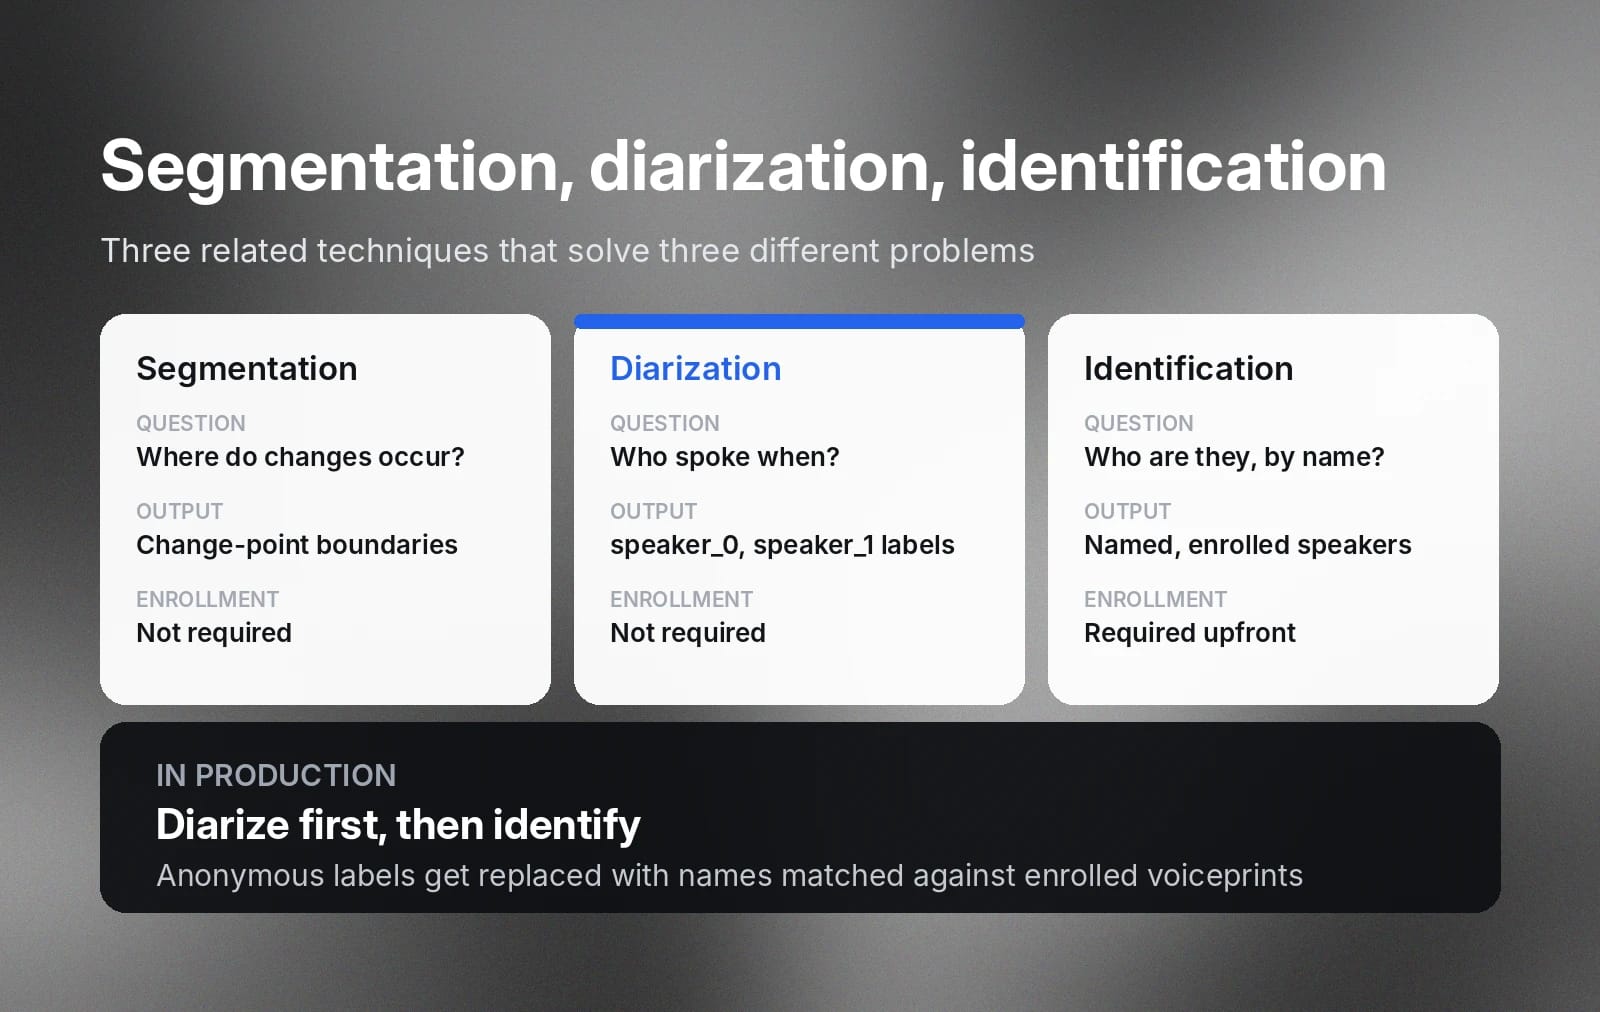
話者セグメンテーションと話者識別はいずれもダイアライゼーションと密接に重なるため、この3つは混同されがちです。
それぞれが少し異なる課題を解決するため、ツールを評価する際には違いを理解することが重要です。
前述のとおり、話者セグメンテーションはパイプラインの初期に行われるダイアライゼーション内のステップです。ラベルを付与せずに、話者がある声から別の声へ切り替わる境界を検出します。セグメンテーションでは、0:42に変化が起きたことがわかります。その結果得られたセグメントをグループ化して完全なラベル付き出力を生成するのがダイアライゼーションで、1:15の声が録音の冒頭で話していた声と同じであることまでわかります。
話者識別はダイアライゼーションとは別の機能ですが、しばしば組み合わせて利用されます。識別では、話者が実際に誰なのかを特定します。識別システムは、既知の話者を参照情報として登録済みの声紋と声を比較し、本人のIDを返します。識別後、speaker_0とspeaker_1は「Fergal」と「Eric」になります。
より包括的な最終文字起こしを作成するために、これらのツールを組み合わせるプロダクトも多くあります。会議ツールでは、TeamsやMeetで設定された名前などの文字列を参照しながら、手動で確認しなくても各参加者の発言を名前付きで自動的に紐づけることがあります。
人気のオープンソース話者ダイアライゼーションツールとライブラリ
制御性、柔軟性、ローカルデプロイが必要な場合は、オープンソースの話者ダイアライゼーションツールを検討する価値があります。最適な選択は、扱うオーディオの種類(通話、会議、ポッドキャスト、放送)、レイテンシー要件、投入できるエンジニアリング工数によって異なります。
代表的な選択肢を紹介します。
Pyannote.audio
Pyannote.audioは、話者ダイアライゼーション専用に構築されたPyTorchベースのツールキットで、最も広く使われているオープンソースの選択肢の1つです。VAD、セグメンテーション、埋め込み、クラスタリングを含むダイアライゼーションスタック全体をカバーする事前学習済みパイプラインに加え、自社データでモデルを学習または微調整するための構成要素も提供します。
事前学習済みモデルはHugging Faceを通じて配布されており、大規模な文字起こしプロジェクトではダイアライゼーション層としてよく使用されています。
WhisperX
WhisperXは、OpenAIのWhisper ASRにダイアライゼーションと強制アラインメントを組み合わせています。Whisper単体でも高品質な文字起こしを生成しますが、話者ラベルは付与せず、タイムスタンプも概算にとどまります。WhisperXは単語レベルのタイムスタンプアラインメントを追加し、pyannoteベースのダイアライゼーションを統合することで、各単語に正確なタイムスタンプと話者ラベルの両方が付いた文字起こしを生成します。
NVIDIA NeMo
NVIDIA NeMoは、より広範な会話型AIフレームワークの一部としてダイアライゼーションを提供します。重複発話を処理するエンドツーエンドのアプローチを含む、学習可能なダイアライゼーションモデルを提供しており、GPUインフラ上で大規模なカスタム音声システムを構築するチーム向けに設計されています。
これらのツールでは、モデルのデプロイ、スケーリング、モニタリング、更新など、ダイアライゼーションのインフラを管理する必要があります。こうした運用負荷を避けたいチームには、マネージド型の音声ダイアライゼーションAPIというよりシンプルな選択肢があります。既存のワークフローに統合することも、ダイアライゼーションパイプライン全体を処理することもできるため、カスタマーサポート分析、会議の文字起こし、ポッドキャスト処理といった本番ユースケースに適しています。
リアルタイムダイアライゼーション:課題とユースケース
リアルタイムダイアライゼーションは、システムが不完全なコンテキストで判断しなければならないため、完成済み録音のダイアライゼーションよりも大幅に困難です。
オフラインシステムは、何らかの判断を確定する前に録音全体を確認できます。2分時点の声と40分時点の声を比較し、両方の時点を同時に参照できるため、同じ話者であると確信を持って判断できます。リアルタイムシステムにはその余裕がありません。音声が届いた瞬間にラベルを付与する必要があり、その後の発言にはアクセスできず、一度下した判断を修正する機会もほとんど、あるいはまったくありません。
未来のコンテキストがないことにより、特に次の3つの問題はリアルタイムでの解決がはるかに難しくなります。
- レイテンシーと精度のトレードオフ:会話全体を前後に確認できないため、より厳しい応答時間を満たそうとすると、精度が直接的に犠牲になります。
- 重複発話:複数人が同時に話す場合、オーディオを再処理できるシステムなら分離できるかもしれません。リアルタイムシステムでは、単一のラベルに割り当てるか、その場で重複発話対応の専用モデルに頼る必要があります。
- 短い発話:「はい」や「どうぞ」といった短い発話では、システムが判断するための声の情報がほとんど得られません。周囲のコンテキストも利用できない中で、すぐにラベルを確定する必要があります。
難しさはあるものの、録音の終了を待てないアプリケーションもあります。ライブキャプションでは、会議や放送で人が話すのに合わせて話者ラベルが必要です。コンタクトセンターソフトウェアでは、通話中にエージェントへガイダンスを提示するため、顧客が使っている言葉をリアルタイムで把握する必要があります。音声エージェントは、複数の参加者との通話を処理する際、誰が何を尋ねているかを遅延なく追跡する必要があります。いずれの場合も、少し精度が低くても即時に結果を返すシステムの方が、高精度でも遅延するシステムより優れています。
分析、コンプライアンスレビュー、文字起こし生成など、リアルタイムのラベルが本当に必要ではないワークロードでは、大幅に高精度なバッチダイアライゼーションが引き続き最適な選択です。
話者ダイアライゼーションの性能を評価する方法
ダイアライゼーションの精度を測定する際に特に重要な指標は2つです。全体精度を捉えるダイアライゼーション誤り率(DER)と、その精度がすべての話者で維持されているかを確認するJaccard誤り率(JER)です。
DERは、総発話時間のうち誤って帰属された時間の割合を計算します。次の3種類のエラーを組み合わせたものです。
- 誤検出音声:誰も話していないセグメントを、システムが音声としてラベル付けしました。
- 見逃し音声:誰かが話していたにもかかわらず、システムが無音としてラベル付けしました。
- 話者混同:音声は検出されたものの、誤った話者に帰属されました。
DER = (誤検出 + 見逃し音声 + 話者混同)/ 総発話時間
DERが10%とは、これら3種類のエラーの合計が総発話時間の10分の1に相当することを意味します。低いほど良く、同じ条件で同じデータを測定した場合にのみスコアを比較できます。DERは、オーディオ品質、話者数、録音に含まれる重複発話の量によって大きく変動します。
Jaccard誤り率(JER)は、各話者のダイアライゼーション精度を個別に測定し、その結果を全話者で平均します。各参照話者について、評価者はシステム内で最も近い話者ラベルを対応付け、正しく重複した時間と、いずれかの話者に割り当てられた総時間を比較します。
たとえば、話者Aが50分、話者Bが10分話す60分間の会議を想定します。ダイアライゼーションシステムは話者Aの50分のうち48分を正しくラベル付けしたものの、話者Bの10分では4分しか正しくラベル付けできませんでした。会議の大部分を話者Aが占めるため、全体のDERは比較的高く見える可能性があります。JERでは、話者Aと話者Bを独立して評価してからスコアを平均するため、話者Bの不十分な結果も同等に反映されます。
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
最終的なJERは、話者ごとの誤り率の平均です。
JER = (1 / N)* Σ[JER_speaker_i]、i = 1..N
DERとJERの両方を追跡することで、ダイアライゼーションの精度をより包括的に把握できます。DERは全体精度、JERは発話頻度の低い参加者を含むすべての参加者で精度が維持されているかを示します。
本番環境を代表するオーディオでのテスト
話者ダイアライゼーションシステムを評価する際は、実際のデプロイ条件に合うオーディオでDERとJERの両方を計算してください。典型的な話者数、オーディオ品質、クロストークの量を反映したデータを使います。
公開されているベンチマークスコアは、クリーンで管理されたデータセット、たとえばスタジオ録音で測定されている場合があり、実際の通話録音やライブ会議の音声とはほとんど一致しません。ベンチマークで高スコアのシステムでも、ノイズや重複発話のある実環境のオーディオでは大幅に性能が低下する可能性があります。ダイアライゼーションプロダクトを導入する前に、自社データでテストしてください。
話者ダイアライゼーション向けElevenAPIの始め方
複数話者対応の文字起こし機能を構築する準備ができたら、 Scribe v2なら、ElevenLabsの話者ダイアライゼーションを単一のスピーチtoテキストAPIで利用できます。diarize=trueを指定してエンドポイントにオーディオを送信すると、JSONレスポンスで最大32人の話者、90以上の言語、最長10時間のファイルにわたり、各単語に話者IDが付与されます。
標準のダイアライゼーション出力は、2つのオプションで拡張できます。通話録音では、detect_speaker_roles=trueにより、匿名の番号ではなく話者をagentとcustomerとしてラベル付けします。ワークスペースに話者プロフィールが登録されている場合は、use_speaker_library=trueで検出した話者を登録済みの声と照合でき、1回のリクエストでダイアライゼーションと識別を組み合わせられます。
「ダイアライゼーションしきい値パラメータ」で、話者を過剰に分割することと統合することのトレードオフを調整できます。また、ステレオ通話録音のように、話者がすでに別々のオーディオチャンネルに分離されている場合は、マルチチャンネル文字起こしがチャンネルごとに話者を割り当てるため、ダイアライゼーションは不要です。
「スピーチtoテキスト クイックスタート」では、最初のインテグレーションを手順ごとに解説しています。規制対象のデプロイメント向けに、プラットフォームはSOC 2、ISO 27001、PCI DSS L1、HIPAAに準拠しており、EUデータレジデンシーとゼロ保持モードも利用できます。
話者ダイアライゼーションをシステムに組み込む準備はできましたか?まずはAPIキーを取得するか、ElevenLabsドキュメントをご覧ください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。