
インタラクションモデル:自然な人間とAIの対話を実現
- 公開日
- 最終更新日
聴くこの記事を聴く
AI 音声エージェントの話を途中で遮ろうとしたことがある方なら、人との会話のために設計されていないシステムがどんなものか、ご存じでしょう。会話のリズムが合わず、声と内容が切り離されていて、情報が正しくても、やり取りに違和感があります。知識のある人と話しているというより、たまたま言葉を使うソフトウェアを操作しているように感じられるのです。
この不自然さの原因は構造にあります。多くの音声AIシステムは、実際の会話の流れではなく、ターンを処理するために作られています。一度に1つのやり取りを聞き取り、処理し、応答します。単純なデモでは機能しますが、会話が感情的で予測できないものになると、うまく機能しなくなります。
インタラクションモデルは、音声とテキストをまたいでリアルタイムにコミュニケーションするよう設計されたAIシステムです。何が話されたかだけでなく、いつ話されたか、その瞬間にどのような感情的反応が求められるかも捉えます。この記事では、インタラクションモデルが何を違ったものにするのか、音声AIを導入する企業にとってなぜ重要なのか、そしてElevenLabsがどのように実現へ向けて取り組んでいるかを解説します。
概要
- 多くの音声AIは、割り込み、沈黙、ターンをまたいで引き継がれる文脈を扱えないため、実際の会話ではうまく機能しません。
- ElevenLabsのインタラクションスタックは、文脈や会話の流れを失うことなく、割り込み、間、発話の重なりを処理できるよう設計されています。
- ElevenLabsは、高度なカスケード型アーキテクチャと自社開発のスピーチtoテキスト(STT)、テキスト読み上げ(TTS)、そして低レイテンシーで自然な対話の往復を実現するよう調整されたスタックにより、真のインタラクションモデルの実現を目指しています。
人間とAIの音声コミュニケーションの多くが自然に感じられない理由
多くの音声AIは、会話を個別の入力と出力の連続として扱います。システムはひとまとまりの発話を待ち、それをテキストに変換して処理し、応答します。これは命令と応答のやり取りには機能しますが、実際の会話は整然としたテキストの交換ではありません。間や相づちが入り混じる、絶え間ない往復です。
ターン間の流れと、その間で引き継がれる文脈を取り除くと、次の3つの問題が生じます。
- 話を遮る、または待たせる:システムは、考えるための間と発話の終わりを区別できないため、まだ話している途中で割り込むか、話し終えた後に沈黙したままになります。文の途中で考えをまとめようとすれば遮られ、言いたいことを言い終えれば、無音の時間を待つことになります。
- 話し始めると反応できない:システムは応答を始めた瞬間に、聞くのをやめます。話題を変えるために割り込んでも、何かが変わったことを認識できないため、すでに関心がなくなった質問への答えを話し続けます。
- 会話の途中で忘れる:各ターンが個別に処理されるため、5回前のやり取りの文脈は引き継がれません。同じことを繰り返し説明することになったり、システムが会話が始まったばかりのように応答したりします。
その結果、機能的には正しくても、どこか違和感のある会話になります。
従来の音声AIにはできない、インタラクションモデルの機能
従来の音声AIが1ターンずつ処理するのに対し、インタラクションモデルは会話全体を動かし、何が話されているか、次に何をすべきかを同時に捉えます。機能面での違いは、インタラクションモデルがやり取りの実際の状態に応答することです。
インタラクションモデルには、次の特徴があります。
- リアルタイム応答:設定に応じてエンドツーエンドのサイクルを1秒未満で実行できる、会話の速度で応答するよう設計されています。
- 割り込み、沈黙、重なりの自然な処理:考えるための間とターンの終了を区別するため、相手の話を遮ったり、無音の時間を残したりしません。また、顧客が話題を変えるために発話を重ねても、文脈を失ったり会話が破綻したりすることなく処理します。
- やり取り全体での一貫性:ターンごとに文脈をリセットするのではなく、会話の履歴を引き継ぐため、10ターン目の発言にも、最初のターン以降に起きたすべてが反映されます。
- 状況に応じた話し方:実行するタスクの種類に応じて、声のトーンをより穏やかに、より直接的に、より安心感のあるものへと変えるようプログラムできます。
- 並行タスク実行:情報の取得やツール呼び出しを行いながら話し続けられるため、何かを調べている間に沈黙しません。
インタラクションモデルが真価を問われるのは、通話がうまく進んでいないときです。以下の録音では、顧客がフライトの欠航について電話しています。顧客は緊張しており、問題を早く解決する必要があります。
エージェントは、顧客が使う言葉から緊急性や苛立ちを即座に認識します。トーンを調整し、話の位置を見失わずに割り込みを処理し、接続されたツールを使って欠航便への具体的な解決策を提示します。最終的に、顧客は人間のエージェントを介さずに問題を解決できます。
現在使われている一般的なターンベースのエージェントと比べてみましょう。こうしたシステムは、間があるたびに待ち、中立的な基準で応答するため、顧客が感じている苛立ちを完全に見逃します。発信者が実際に感じていることに対処しないやり取りが数回続けば、通話は人間に引き継ぐ必要が出てくるでしょう。顧客は、電話をかけたとき以上に不満を抱くことになります。
ElevenLabsがインタラクションモデルの実現に向けて進めていること
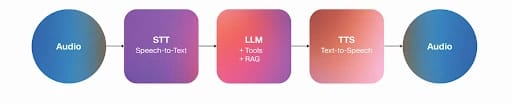
会話パイプラインには、高度なカスケード型アーキテクチャを採用しています。融合型とは異なり、1つのモデルですべてを処理するのではなく、各段階が専門的なコンポーネントとして機能します。
このアプローチの利点は、システム全体を作り直すことなく、パイプラインの各段階を個別に最適化し、任意のコンポーネントをより優れたモデルに置き換えられることです。また、これらのコンポーネントはすべて社内で開発しているため、豊富なコンテキストを相互に受け渡せるよう共同で最適化されています。これにより、パイプラインは個別のツールの連鎖ではなく、一貫したひとつの会話として動作します。
カスケード型モデルの構造
融合型モデルの構造
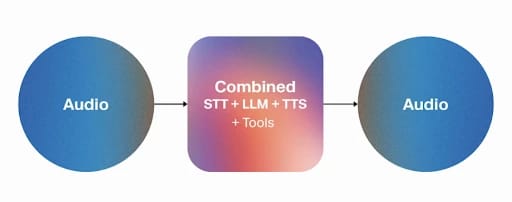
画像:カスケード型モデルと融合型モデル
現在、パイプラインを構成する技術は次のとおりです。
- Scribe v2 Realtime:自社開発のSTTモデルは、90以上の言語で約150msの音声文字起こしを実現します。バックグラウンドノイズ、アクセント、割り込み、笑い声や間といった非言語イベントにも対応します。医療用語から金融業界の専門用語まで、分野固有の語彙も処理できるよう設計されています。
- 予測的ターンテイキング:このシステムは、固定的な無音しきい値に頼るのではなく、会話の流れを読み取り、話す、間を置く、待つタイミングを判断します。音声アクティビティ検出モデルの改善により、バックグラウンドの発話や短い応答をより適切に除外し、より自然なターンテイキングを実現します。
- Eleven v3 Conversational:ライブでの双方向対話のために作られた、最も表現力豊かなTTSモデル。ライブでの双方向対話向けに設計されており、会話の感情的な温度感をターンをまたいで引き継ぎます。そのため、10ターン目のエージェントの話し方にも、それまでのすべてのやり取りが反映されます。
- Expressive Mode:Eleven v3 Conversationalとターンテイキングシステムを基盤とするExpressive Modeは、その瞬間のエージェントの話し方を制御します。顧客が苛立っているときは状況を鎮め、混乱しているときは安心させ、明確さが必要なときは率直に伝えます。また、表現タグも読み取るため、[laughs]、[whispers]、[sighs]のような手がかりに基づき、特定の場面での話し方を形作れます。
- Flash v2.5:当社の低レイテンシーTTSモデルは32言語に対応し、75ms未満で音声を生成します。レイテンシーが最優先の場合でも、応答時間を自然な人間の会話リズムの範囲に保ちます。
- スピーチエンジン:スタック全体をつなぐ接続レイヤーで、サーバーをElevenAPIにWebSocket経由で接続します。接続は会話ごとに1つです。ElevenLabsがSTTとTTSを処理し、サーバー側でLLMを実行するため、技術チームは独自のモデルを持ち込み、会話ロジックを自社のインフラ上で管理できます。
これらのモデルは継続的に改善されており、新バージョンも定期的にリリースされています。各リリースにより、応答はより速く、感情認識はより的確に、対応言語はより多く、話し方はより滑らかになり、ソフトウェアと話すことと人と話すことの差が縮まっています。
考えながら話す
インタラクションモデルのすべての部分を、厳密な順序で実行する必要はありません。ElevenAgentsは、質問と回答の間を沈黙で埋めるのではなく、会話が続く間もバックグラウンドで作業を続けられます。
複数の中核システムが連携し、話すことと思考を同時に可能にします。
- 並列ツール呼び出し:エージェントは、データベースへの問い合わせ、ツールの実行、注文状況の確認を、話している間にも行えます。そのため情報取得が会話の中で無音の間のように感じられることはありません。
- ソフトタイムアウト:LLMが応答の生成に予想より時間がかかる場合、エージェントは気まずい沈黙を残す代わりに、「少々お待ちください」や「うーん」といった短いつなぎの言葉を発します。ソフトタイムアウトは自然な会話の流れを維持し、割り込みが起こる可能性を減らします。
- 割り込み無視語句:固定的な無音しきい値を使うのではなく、システムは話されている内容の意味を読み取り、ターンが実際に終わったタイミングを推測します。同様に、「はい」や「うん」といった短い相づちは、完全な割り込みをトリガーせずに通過させるよう設定できます。これにより、発信者が相づちを打つたびにエージェントが話の位置を見失うことはありません。
これらのシステムが連携することで、エージェントが応答をバッファリングまたは読み込み中のように感じられるのを防ぎます。バックグラウンドで情報を処理し考えをまとめながら、人のように自然に間を埋める、効率化された会話エンジンを形成します。
ElevenLabsで会話が実際にどのように機能するか
上記のコンポーネントは、整然と一列に順番に実行されるわけではありません。重なり合って動作します。サポート通話の途中で、発信者が「私の注文はもう発送されましたか? それともまだ処理中ですか?」と尋ねた場合、ElevenLabsのエージェントがどのように対応するかを見てみましょう。
- 発信者が話す:音声はWebSocket接続を通じてElevenLabsにストリーミングされ、Scribeは音声から約150ms遅れてリアルタイム文字起こしを開始します。
- システムが流れを読む:Scribeがまだ文字起こししている間にも、予測的ターンテイキングは発信者が話し終えたのか、考えの途中なのかをすでに評価しています。末尾の「それともまだ処理中ですか?」は、間ではなく話を渡す合図として認識されるため、無音で待つのではなく次のステップが実行されます。
- LLMが文脈を組み立てて応答する:文字起こしされた質問は、会話履歴、企業の自社システムからRAG、通話の前半で得られたツール出力、システムプロンプトとともにLLMへ送られます。LLMはそれらすべてをもとに推論し、発信者の注文内容に基づいた応答を生成します。
- TTSモデルが応答を合成する:テキストは自然な音声になります。Expressive Modeが有効な場合、応答にはその場に合った話し方の手がかりが含まれるため、通常の更新連絡も平坦ではなく、落ち着いて余裕のある印象で伝わります。レイテンシーが最優先の場合、Flashが75ms未満で合成を処理します。
- 応答がストリーミングで返る:合成が完了する前に音声の再生が始まるため、残りの部分がまだ生成中でも、発信者は回答の冒頭を聞き始められます。
- サイクルが繰り返される:新しいターンごとに、会話のトーン、文脈、履歴が引き継がれます。
この高速なプロセスを通じて、会話は自然に感じられます。発信者が機械に合わせる必要はなくなります。ゆっくり話したり、過剰にはっきり発音したり、ビープ音を待ったりしません。人と話すときのように、ただ話すだけです。
自然な音声エージェントをビジネス全体に導入
ここで説明した機能は、すべて現在本番環境で提供されています。カスケードアーキテクチャからサブ秒のパイプラインまで、世界中の企業がすでにElevenAgentsを活用し、大規模に実際の顧客との会話を処理しています。
エージェントアーキテクチャはガードレール、監査ログ、コンプライアンス制御に対応しているため、規制対象の重要度が高い環境でも利用できます。ElevenLabsは、SOC 2 Type II、ISO 27001、HIPAA、PCI DSS Level 1の認証を取得しています。また、データを特定の境界内に保持する必要があるチーム向けに、Zero Retention Modeと地域別データレジデンシーも提供しています。
エージェントを実務に活用する準備はできましたか?エージェントを作成してコンソールで構築を始めることも、営業チームに相談することもできます。お客様の環境に合わせた導入をご案内します。
インタラクションモデルに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


