
タイムスタンプとイベントタグを用いた音声文字起こしは、どのように機能しますか?
- 公開日
- 最終更新日
ネイティブの単語レベル文字起こしモデルは、音声録音またはリアルタイムストリームを入力として受け取り、発話と非発話音を表す、タグ付け・タイムスタンプ付きトークンオブジェクトの構造化配列を出力します。各トークンは、word、spacing、audio_eventの3種類のいずれかです。オーディオイベントには、笑い声、拍手、その他のバックグラウンドサウンドが含まれます。
この記事では、タイムスタンプ付き音声文字起こしの仕組みと、強制アラインメントに依存する従来の文字起こしよりも柔軟で強力な理由を解説します。
概要
- 単語レベル文字起こしでは、発話データと非言語オーディオイベントの、タイムスタンプ付き構造化配列を直接出力します。
- これは、テキストのまとまりを出力する従来の自動音声認識モデルとは対照的です。生音声にタイムスタンプを付けるには、2回目の強制アラインメント処理が必要で、時間がかかるうえ計算負荷も増えます。
- イベントタグを使えば、笑い声や拍手などの非言語コンテンツを捉えられます。このデータは検索可能なため、視聴者の反応に基づいてハイライトやバズる瞬間を見つけるのに役立ちます。
- 構造化された出力データは、精度の高いキャプション作成、検索可能な音声アーカイブ、自動SNSクリッピングなど、さまざまな用途でアプリケーションに活用できます。
- Scribeの単語レベル文字起こしは、最大5チャンネルをサポートし、それぞれを個別に文字起こしできます。
タイムスタンプとイベントタグ付きの音声文字起こしとは?
タイムスタンプ付き文字起こしは、自動音声認識(ASR)の一種で、文字起こしと同時に、単語や拍手などのオーディオイベントの正確な開始・終了位置を追跡します。出力は完全に構造化され、ナビゲーション可能なデータです。
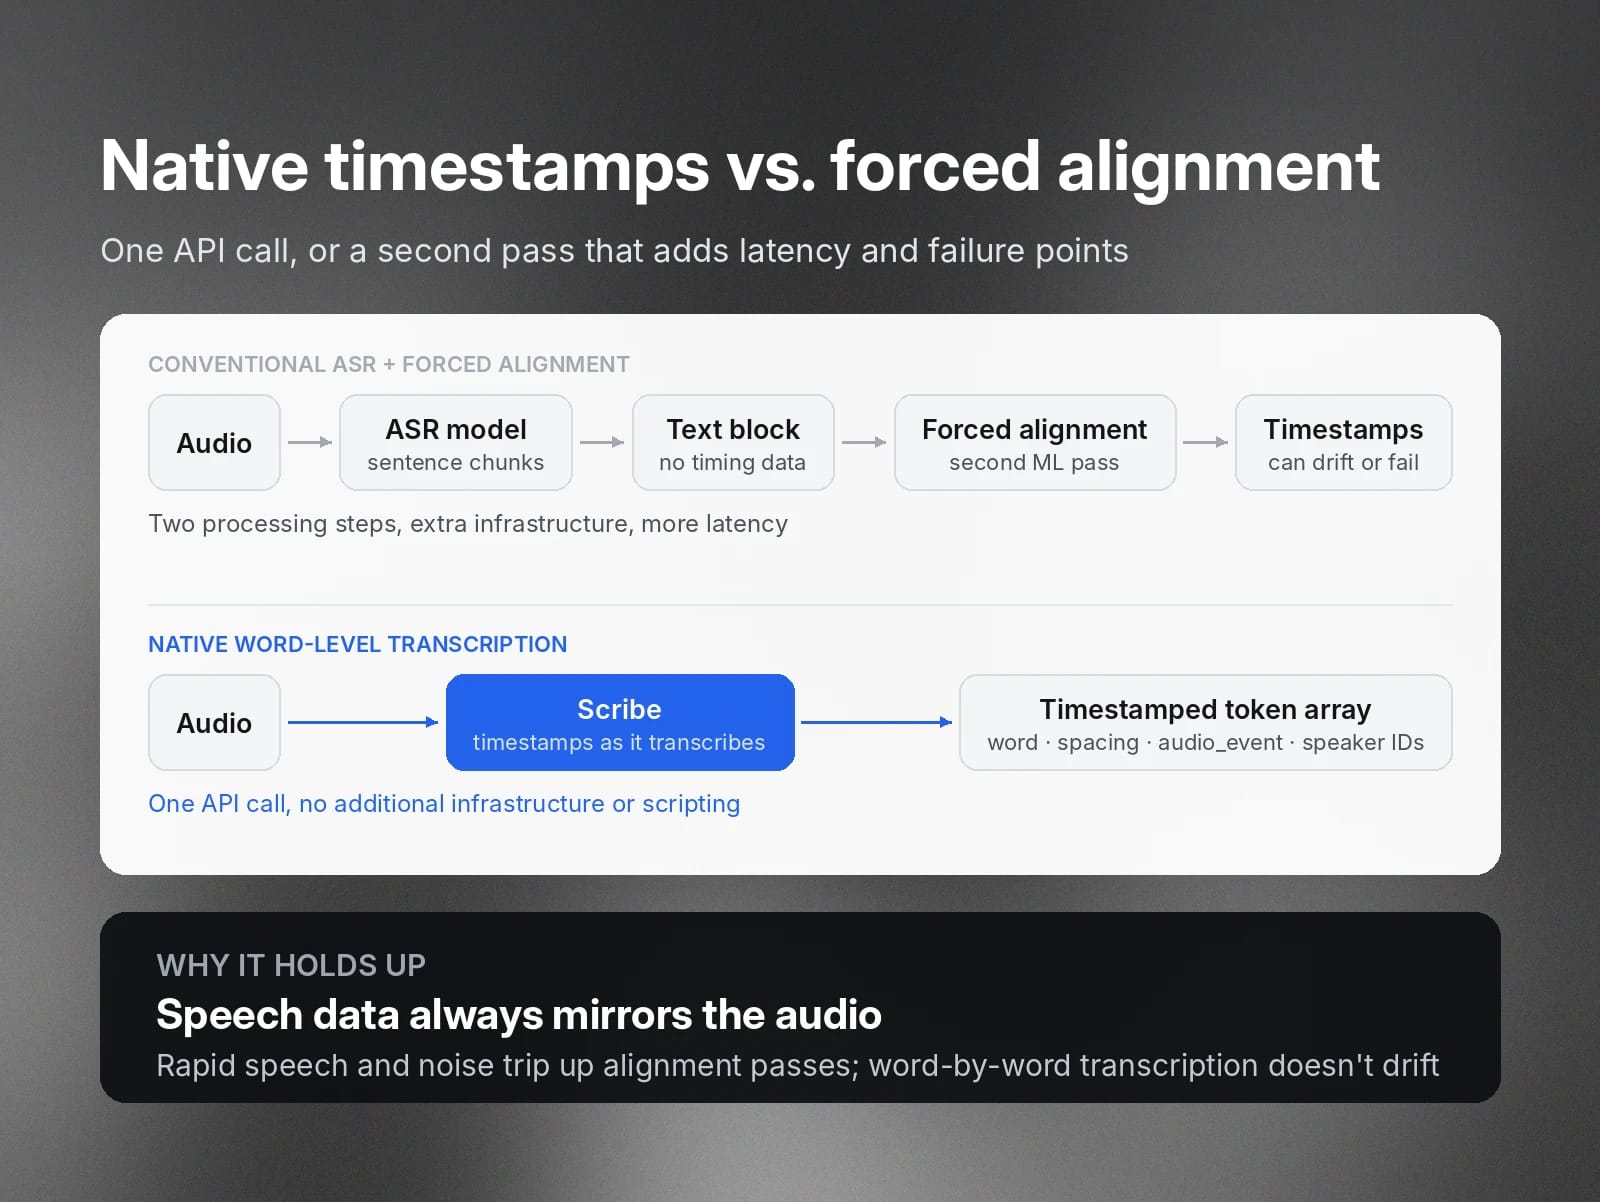
従来のASR文字起こしは、音声を人間が読める大きなテキストブロックに解析します。キャプションやトランスクリプトを人間の読者に提供できますが、データとしてはあまり有用ではありません。
タイムスタンプ付きで構造化したい場合は、テキストを音声に対応付けるため、二次的な機械学習サービスで再処理する必要があります。最終的には似たような出力を生成できますが、APIからネイティブに得られるのではなく複数の処理工程が必要なため、レイテンシーと追加の計算負荷が発生します。
音声にナビゲーションを追加
タイムスタンプとイベントタグ付き文字起こしの主な利点は、人間にも機械にも読み取れることです。重要なビジネス用途として、次のようなものがあります。
- コンプライアンス監査:文字起こし内のキーワードを検索し、機密データへの言及がある正確なタイムスタンプを取得できます。
- 映像制作・編集:映像制作ソフトウェアでは、画面上の発話に字幕をミリ秒単位で同期できます。視聴者の反応にも適切なラベルを付けられます。
- 検索可能なアーカイブ:広報、営業、研修チームなどは、大量の顧客インタビュー、展示会でのスピーチ、ウェビナー、全社会議を、膨大で検索可能なアーカイブとして文字起こしできます。
- マーケティング分析と顧客感情:イベントタグ付けにより、基本的なテキスト文字起こしでは失われがちな視聴者の反応にラベルを付けられます。
ネイティブの単語レベルタイムスタンプを取得する利点は?
標準的なスピーチtoテキストモデルは、音声を処理する際、通常は文や段落全体といったチャンク単位で処理します。単語ごとのタイムスタンプが必要な場合は、2回目の処理で強制アラインメントを行うための別の処理レイヤーを構築する必要があります。これによりインフラとレイテンシーが増え、障害が発生する可能性も高くなります。たとえば、速い発話や大きなバックグラウンドノイズに埋もれた発話を処理しようとすると、タイミングがずれたり、完全に失敗したりする場合があります。
タイムスタンプ付き文字起こしは、Scribeのように単語単位というより細かいレベルで文字起こしすることで、この問題を回避します。これは1回のAPI呼び出しで実行されます。追加のインフラやスクリプトは必要ありません。モデルは文字起こしと同時にタイムスタンプを計算するため、音声データは常に音声を正確に反映します。
タイムスタンプとイベントタグ付き文字起こしの仕組みは?
例として、Scribeを見てみましょう。
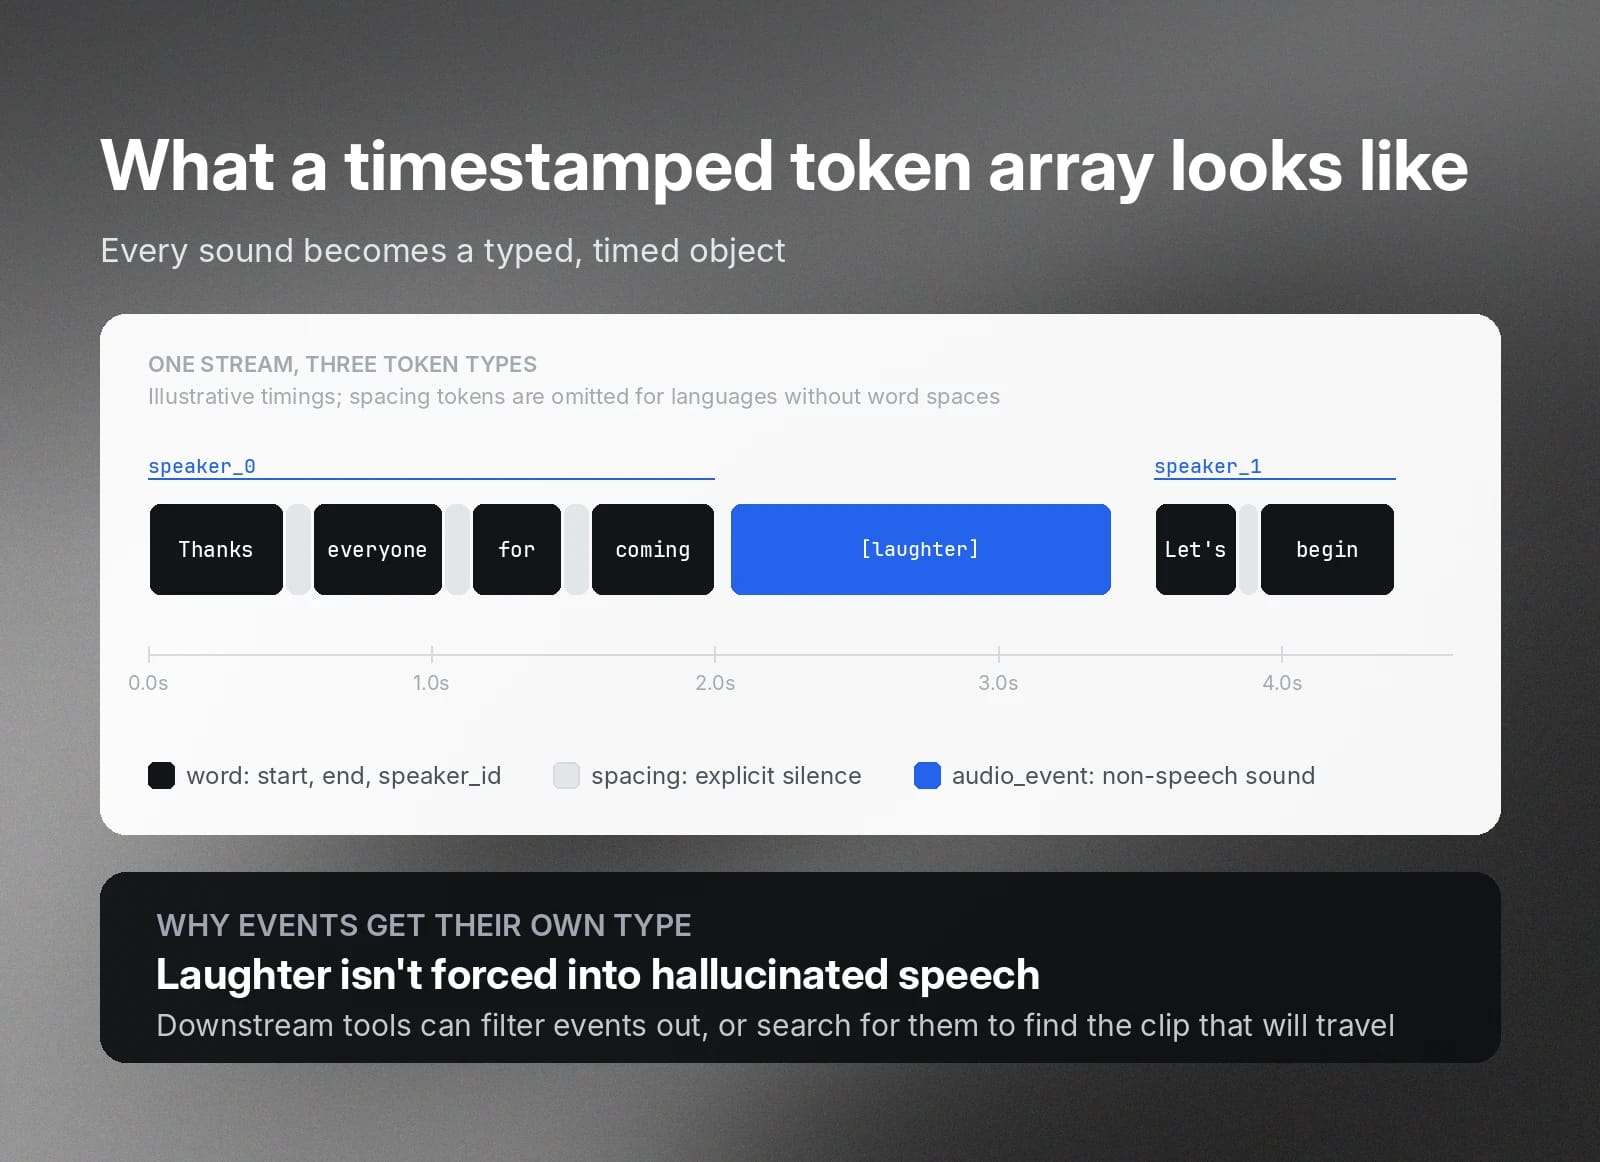
ネイティブの単語レベル文字起こしモデルは、音声フィード内の発話音をトークンオブジェクトの構造化配列にマッピングします。すべてのトークンをword、spacing、audio_eventの3種類のいずれかにラベル付けします。
- word:開始時刻と終了時刻、およびspeaker_idタグが記録された、認識済みの個別の発話単語。
- spacing:明示的にタグ付けされた無音または発話途中の間。キャプションサービスが適切なペースで表示するのに役立ちます。日本語、中国語(標準語)、タイ語、ラオス語、ビルマ語、広東語など、単語間にスペースを使用しないと識別された言語では使用されません。
- audio_event:笑い声や拍手など、意味のある非言語オーディオ。モデルはこれらを別のイベントタイプとして構造化し、存在しない発話として音声を無理に解釈しません。
リアルタイムストリーミングのパラメータ
単語レベル文字起こしモデルには、ライブWebSocket音声文字起こしをサポートする特別な機能を含めることもできます。たとえば、
- include_timestamps=true:このパラメータを指定すると、確定した各音声チャンクの末尾で送信されるcommitted_transcript_with_timestamps JSONメッセージに単語レベルのタイムスタンプが含まれるため、ストリームの実行中にタイムスタンプを取得できます。オーディオイベントタグは、tag_audio_eventsも有効な場合にのみ含まれます。
- include_language_detection=true:このパラメータを指定すると、検出された異なる話し言葉の言語と、検出に対するモデルの信頼度スコアが接続にタグ付けされます。これにより、多言語キャプションをライブで実行できます。
スピーチtoテキストモデルは、非発話イベントにどのようにタグ付けしますか?
tag_audio_eventsパラメータを有効にすると、Scribeはオーディオイベントにタグを付けます。その場合、単語と同様に特定の開始・終了時刻にタグとタイムスタンプを付与します。最も一般的な笑い声や拍手のほか、足音やバックグラウンドの音楽など、文脈上意味を持つ可能性のあるさまざまな環境音にもタグを付けられます。
最も直接的な利点として、重要なコンテキストが加わることで、トランスクリプトとキャプションがより豊かになります。単純で平板なテキストを読むだけでは、皮肉を読み手が直感的に理解しにくいことがあります。[laughter]タグはトランスクリプトに情報を加え、より感情が伝わるものにします。
より優れた分析
イベントタグ付けにより、下流で行う分析もよりクリーンになります。ツールが単一の非構造化テキストブロックを解析する必要がなくなるためです。ネイティブの単語レベル文字起こしでは、オーディオイベントを構造化データとして分離するため、必要に応じてツール側で除外し、発話コンテンツだけを対象に処理できます。
spacingトークンによって間が可視化されるため、分析できます。これは、通話中にカスタマーサービス担当者がどのくらい沈黙していたかを測定するなど、感情分析やQAのユースケースで役立ちます。
タイムスタンプ検索を簡単に
あるいは、特定のイベントを検索することもできます。製品テストのインタビューで感情分析を行う場合、意味のある感情的な反応を抽出できます。SNSアカウントを運用している場合は、1時間にわたるスピーチから笑い声をすばやく検索し、バズる可能性が最も高いと思われるクリップを見つけられます。
構造化されたタイムスタンプ付きトランスクリプトの実用的な用途は?
文字起こしからネイティブに構造化データを取得することには、いくつかの重要なユースケースがあります。
キャプションと字幕の生成
タイムスタンプ付きトランスクリプトは、中間処理なしでSRTやVTTを含む制作向けキャプション形式に直接エクスポートできます。動画編集ツールでは、単語のタイミングを使って、発話に合わせてキャプション内の単語をハイライトできます。
文字起こしモデルは単語ごとに処理するため、速い発話も簡単に解析できます。従来のモデルでは早口の発話や重なった声でつまずくことがありますが、Scribeのような単語レベルモデルなら、クリーンで構造化された文字起こしを出力できます。
音声・ビデオ検索
従来の文字起こしではテキストブロック内のキーワードを照合できますが、強制アラインメントがなければ、フレーズが発話された瞬間に移動することはできません。単語レベル文字起こしのキーワード検索は完全にインデックス化されており、音声内でフレーズが発話された秒まで直接移動できます。これにより、音声アーカイブは完全に検索可能な参照カタログになります。この機能は、大規模なメディアライブラリ、ポッドキャストネットワーク、企業アーカイブの管理に特に役立ちます。
コンプライアンスとリスク監査
たとえば、QAのためにカスタマーサービス通話を録音するなど、機密情報を含む音声を録音したい場合は多くあります。こうした通話には、機密性の高い、または規制対象の個人情報が含まれる可能性が特に高くなります。
音声データを分析に活用しながらコンプライアンスを維持するには、トランスクリプトから機密データをリアルタイムで編集する方法が必要です。ネイティブの単語レベルタイムスタンプを使えば、ElevenLabsのエンティティ検出のような機能を活用できます。この機能は、クレジットカード番号や氏名などの機密エンティティにフラグを付け、オフセットとタイムスタンプを返すため、トランスクリプトのストリーミング中に該当箇所をマスキングできます。
たとえば、本人確認の通話で発話されたクレジットカード番号、母親の旧姓、生年月日、顧客名を検出して編集できます。
SNSクリッピングの自動化
キーワード検索をプログラムで自動化し、長尺コンテンツからハイライトを見つけることもできます。たとえば、選挙演説や企業セミナーの重要な場面をハイライトできます。これにより、最近のコンテンツをYouTube、LinkedIn、TikTok向けのプロ仕様に編集されたハイライトへと活用できます。
マルチチャンネル・複数話者のタイミング
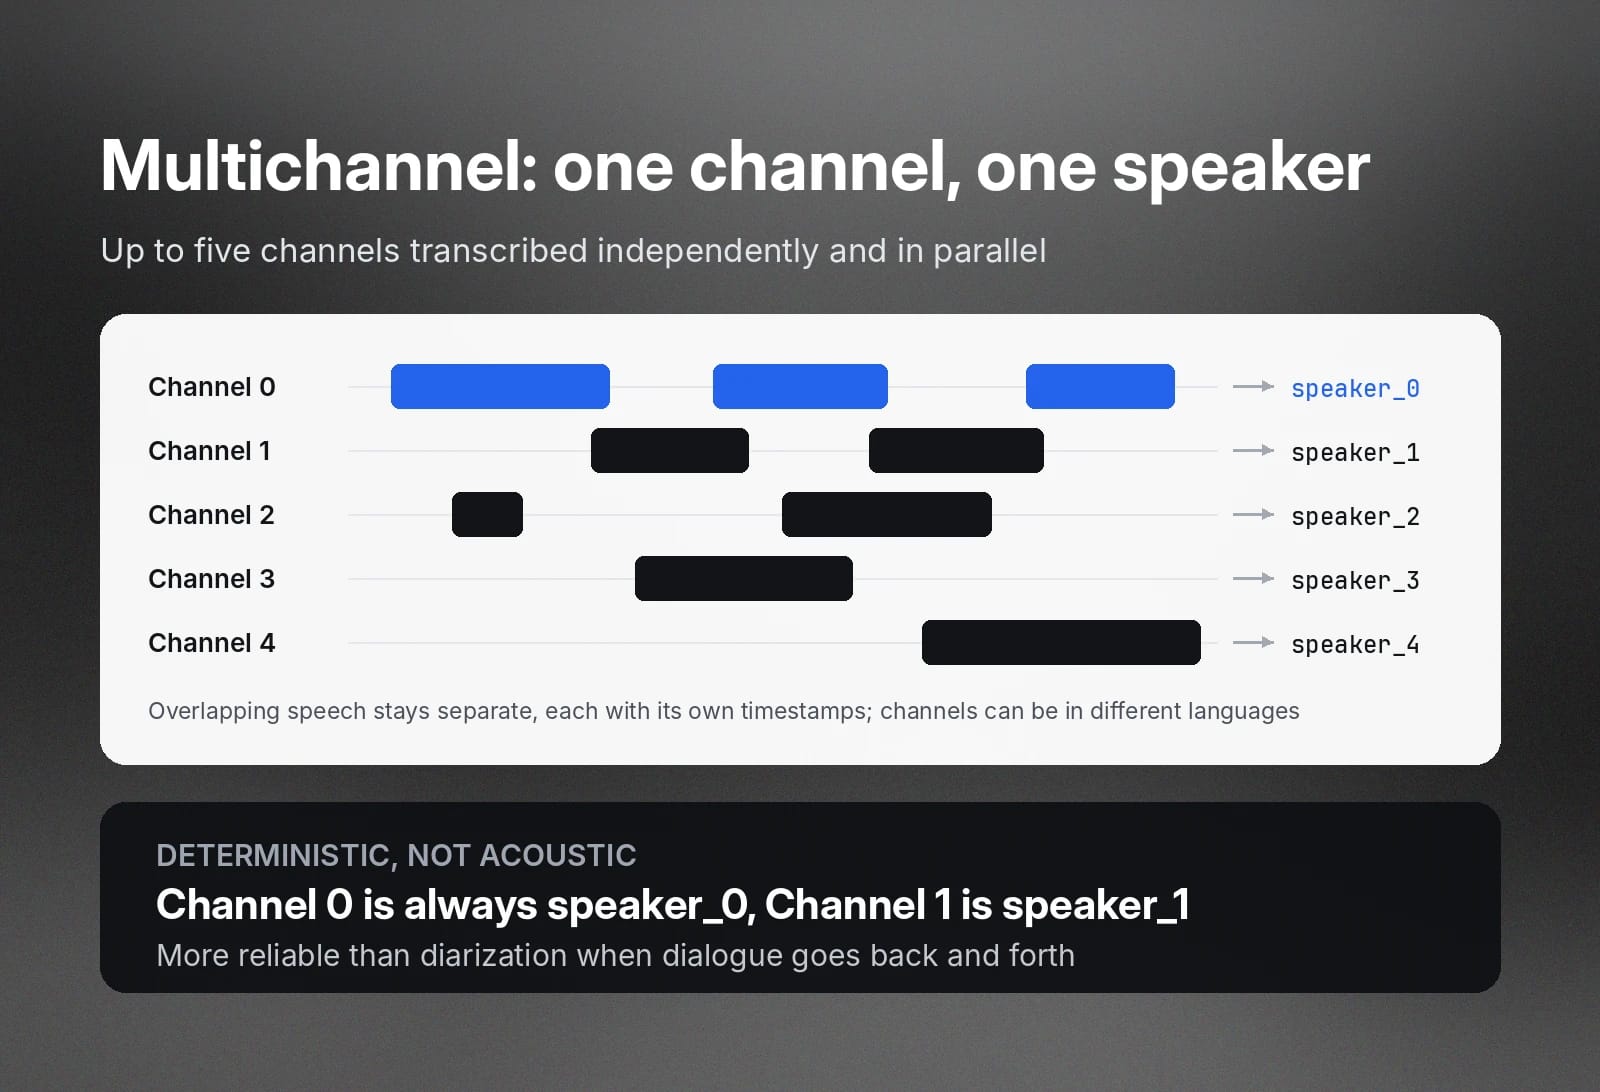
Scribeでは、最大5チャンネルを個別かつ並列に文字起こしできます。各チャンネルには話者IDとタイムスタンプが割り当てられます。これは、標準的な音響話者ダイアライゼーションよりも信頼性が高く、後者はしばしば会話のやり取りに苦戦します。マルチチャンネル録音では、Scribeの話者割り当ては完全に決定論的です。つまり、チャンネル0はspeaker_0、チャンネル1はspeaker_1というように対応します。
同時に話そうとしている話者を認識し、それぞれの発話に対して独立したタイムスタンプを生成できます。話者が異なる言語を話している場合にも対応します。
必要な形式でタイムスタンプ付きデータをエクスポート
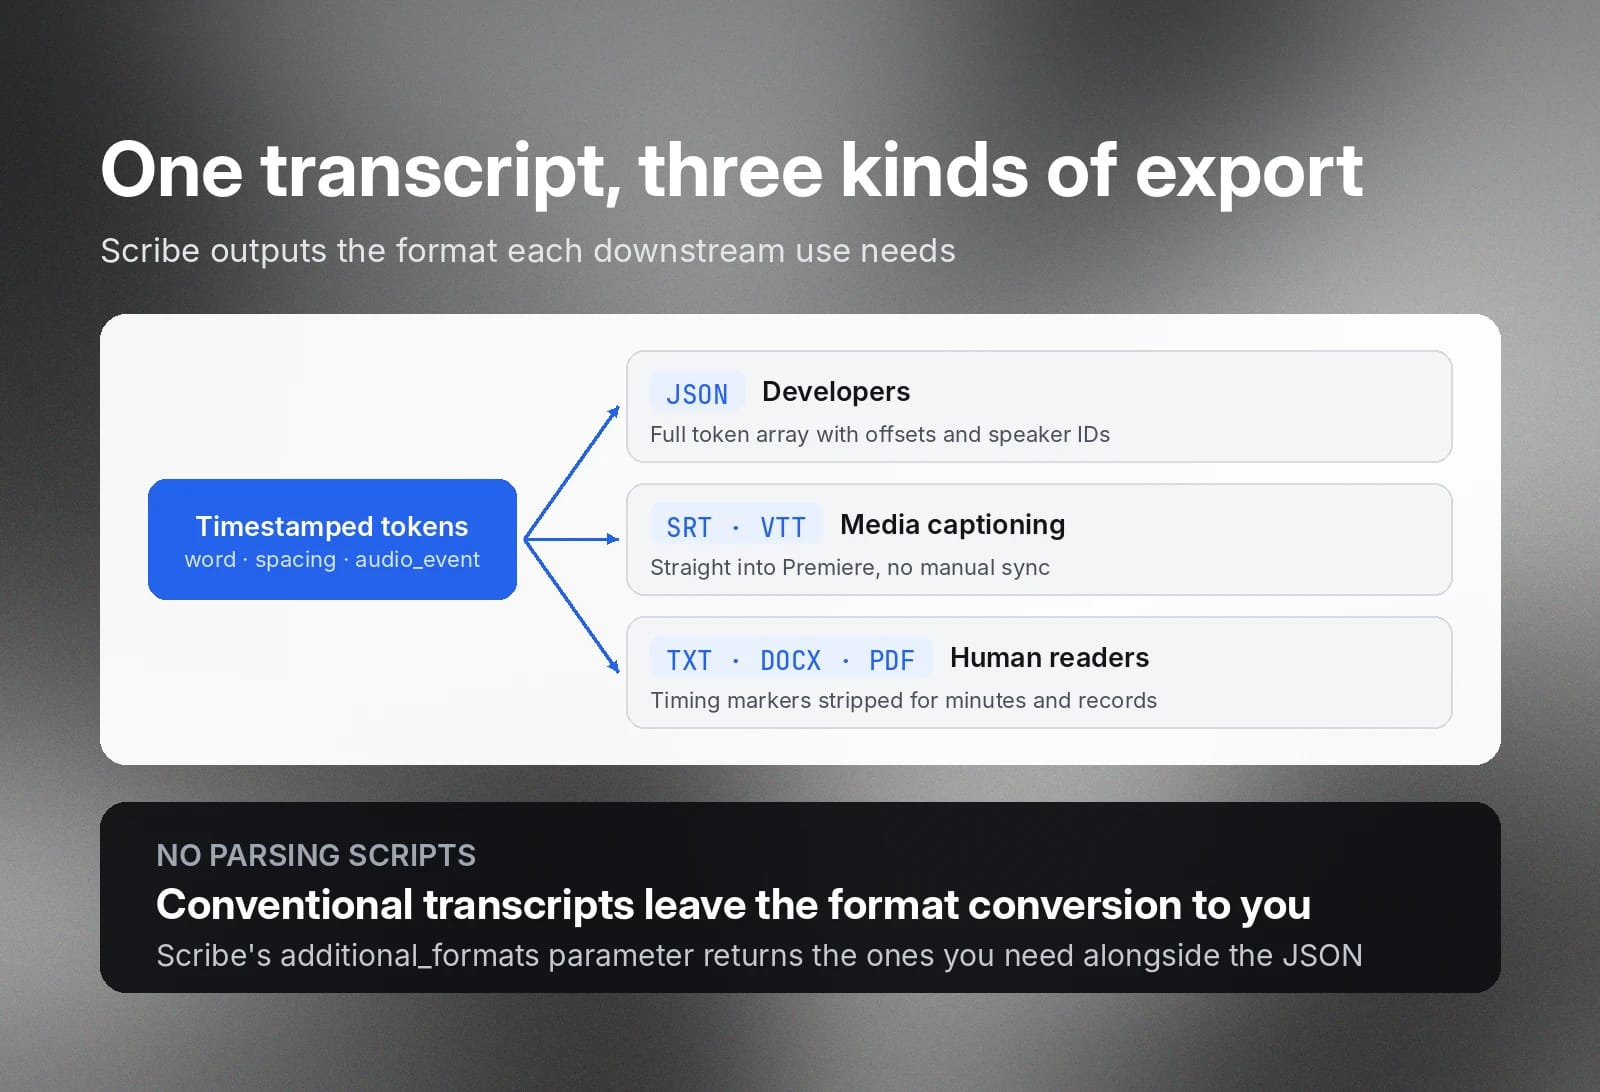
従来型のトランスクリプトを複数の形式で配布したい場合は、解析スクリプトを自分で作成する必要があるでしょう。Scribeは、用途に応じてトランスクリプトを複数の形式でエクスポートできます。完全なスキーマ定義は、 ElevenLabs Create Transcript APIリファレンスで確認できます。
デベロッパー向け構造化データ:JSON
Scribeは、下流アプリケーションに渡せるスキーマのデータを必要とするデベロッパー向けに、JSONエクスポートをサポートしています。たとえばデベロッパーは、このJSONデータを使ってインタラクティブメディアや組織向けのセマンティック検索データベースを構築できます。word、spacing、audio_eventトークンの完全な配列が、開始・終了オフセットと話者IDとともに出力されます。
メディアキャプション:SRTとVTT
Scribeは、手動で同期しなくてもAdobe Premiereなどの制作アプリケーションに直接取り込めるSRTおよびVTTトランスクリプトを出力できます。
人間が読みやすい形式:TXT、DOCX、PDF
読み手に優しい形式でトランスクリプトを出力することもできます。これらの形式では、Scribeが低レベルのタイミングマーカーを取り除き、テキストを読みやすくし、法務・監査文書に適したものにします。たとえば、セッション終了直後に取締役会議事録を効率的に配布する必要がある場合、SEO向けにポッドキャストのトランスクリプトを公開する場合、または法的記録をアーカイブする場合に便利です。
ElevenLabsのタイムスタンプ・イベントタグ付き文字起こしを始める
ネイティブの単語レベル文字起こしなら、ワークフローに必要な構造化データを迅速かつ効率的に取得できます。
今すぐElevenAPIでScribeを使った音声文字起こしを始めるか、単語レベル文字起こしの詳細をご覧ください。
タイムスタンプ・イベントタグ付き文字起こしに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


