
ワードエラー率(WER):基本概念、計算式、活用方法
- 公開日
- 最終更新日
理論上、単語誤り率(WER)は、自動音声認識(ASR)ツールの精度を判断する指標です。WERが低いほど最終的な文字起こしの精度は高く、エラー率が高いほど誤って文字起こしされた情報が多いことを示します。
実際には、WERの差が、患者に必要な処方量を「15ミリグラム」ではなく「50ミリグラム」と記録してしまう医療文字起こしソフトウェアを分けることがあります。また、顧客の要望を正確に文字起こしするサポートツールと、ユーザーに不満を感じさせるツールとの差でもあります。
この記事では、WERとは何か、計算方法、自社のASRプロバイダーをベンチマークするための活用方法を解説します。
概要
- 単語誤り率は、置換・削除・挿入の3種類のエラー数を、参照文字起こしの単語数で割って算出します。
- WERの式は、WER = (S + D + I)/ Nです。
- WERスコアが低いほど、最終出力の精度は高くなります。
- WERが5%未満なら良いベンチマークですが、法務や医療の文字起こしでは、さらに低い単語誤り率が求められる場合があります。
- WERではすべてのエラーを同等に扱うため、文脈を読むうえで完璧な指標ではありません。Semantic Word Error Rate(SWER)などの新しい指標は、発話の意味が保たれているかを測定することで、この課題に対応しようとしています。
単語誤り率とは?
単語誤り率(WER)は、スピーチtoテキストモデルにおける音声認識精度を測る標準的な指標です。STTシステムが文字起こしで誤った内容を、置換・削除・挿入に基づいて0〜1で表します(0.8はエラー率80%を意味します)。
置換とは、単語が誤った別の単語に置き換わることです。削除とは、単語が完全に抜け落ちることです。挿入とは、実際には発話されていない単語が文字起こしに追加されることです。WERではこの3要素をすべて用い、正しい文字起こしの単語数で割ります。これにより、他のベンダーと比較できる数値が得られます。
WERの式は次のとおりです。
WER = (S + D + I)/ N
各記号の意味:
- S:置換(単語が誤っている)
- D:削除(単語が欠けている)
- I:挿入(余分な単語がある)
- N:参照文字起こしの総単語数
WERは小数またはパーセンテージで表せます。モデルが文字起こし時に犯すエラーが少ないほど、WERは低くなり、スコアは良くなります。
実際には、WERが10%なら、会議の文字起こしに含まれる10語に約1語は再確認が必要という意味です。
音声認識システムで単語誤り率が重要な理由
単語誤り率は、チームが異なるプロバイダーを比較するために使える客観的な指標です。マーケティング上の主張に左右されず、音声認識モデルの精度を明確に把握できます。根拠に基づいて比較することで、選択肢を評価する企業は、この分野で現在どのモデルが優れているかを明確に判断できます。
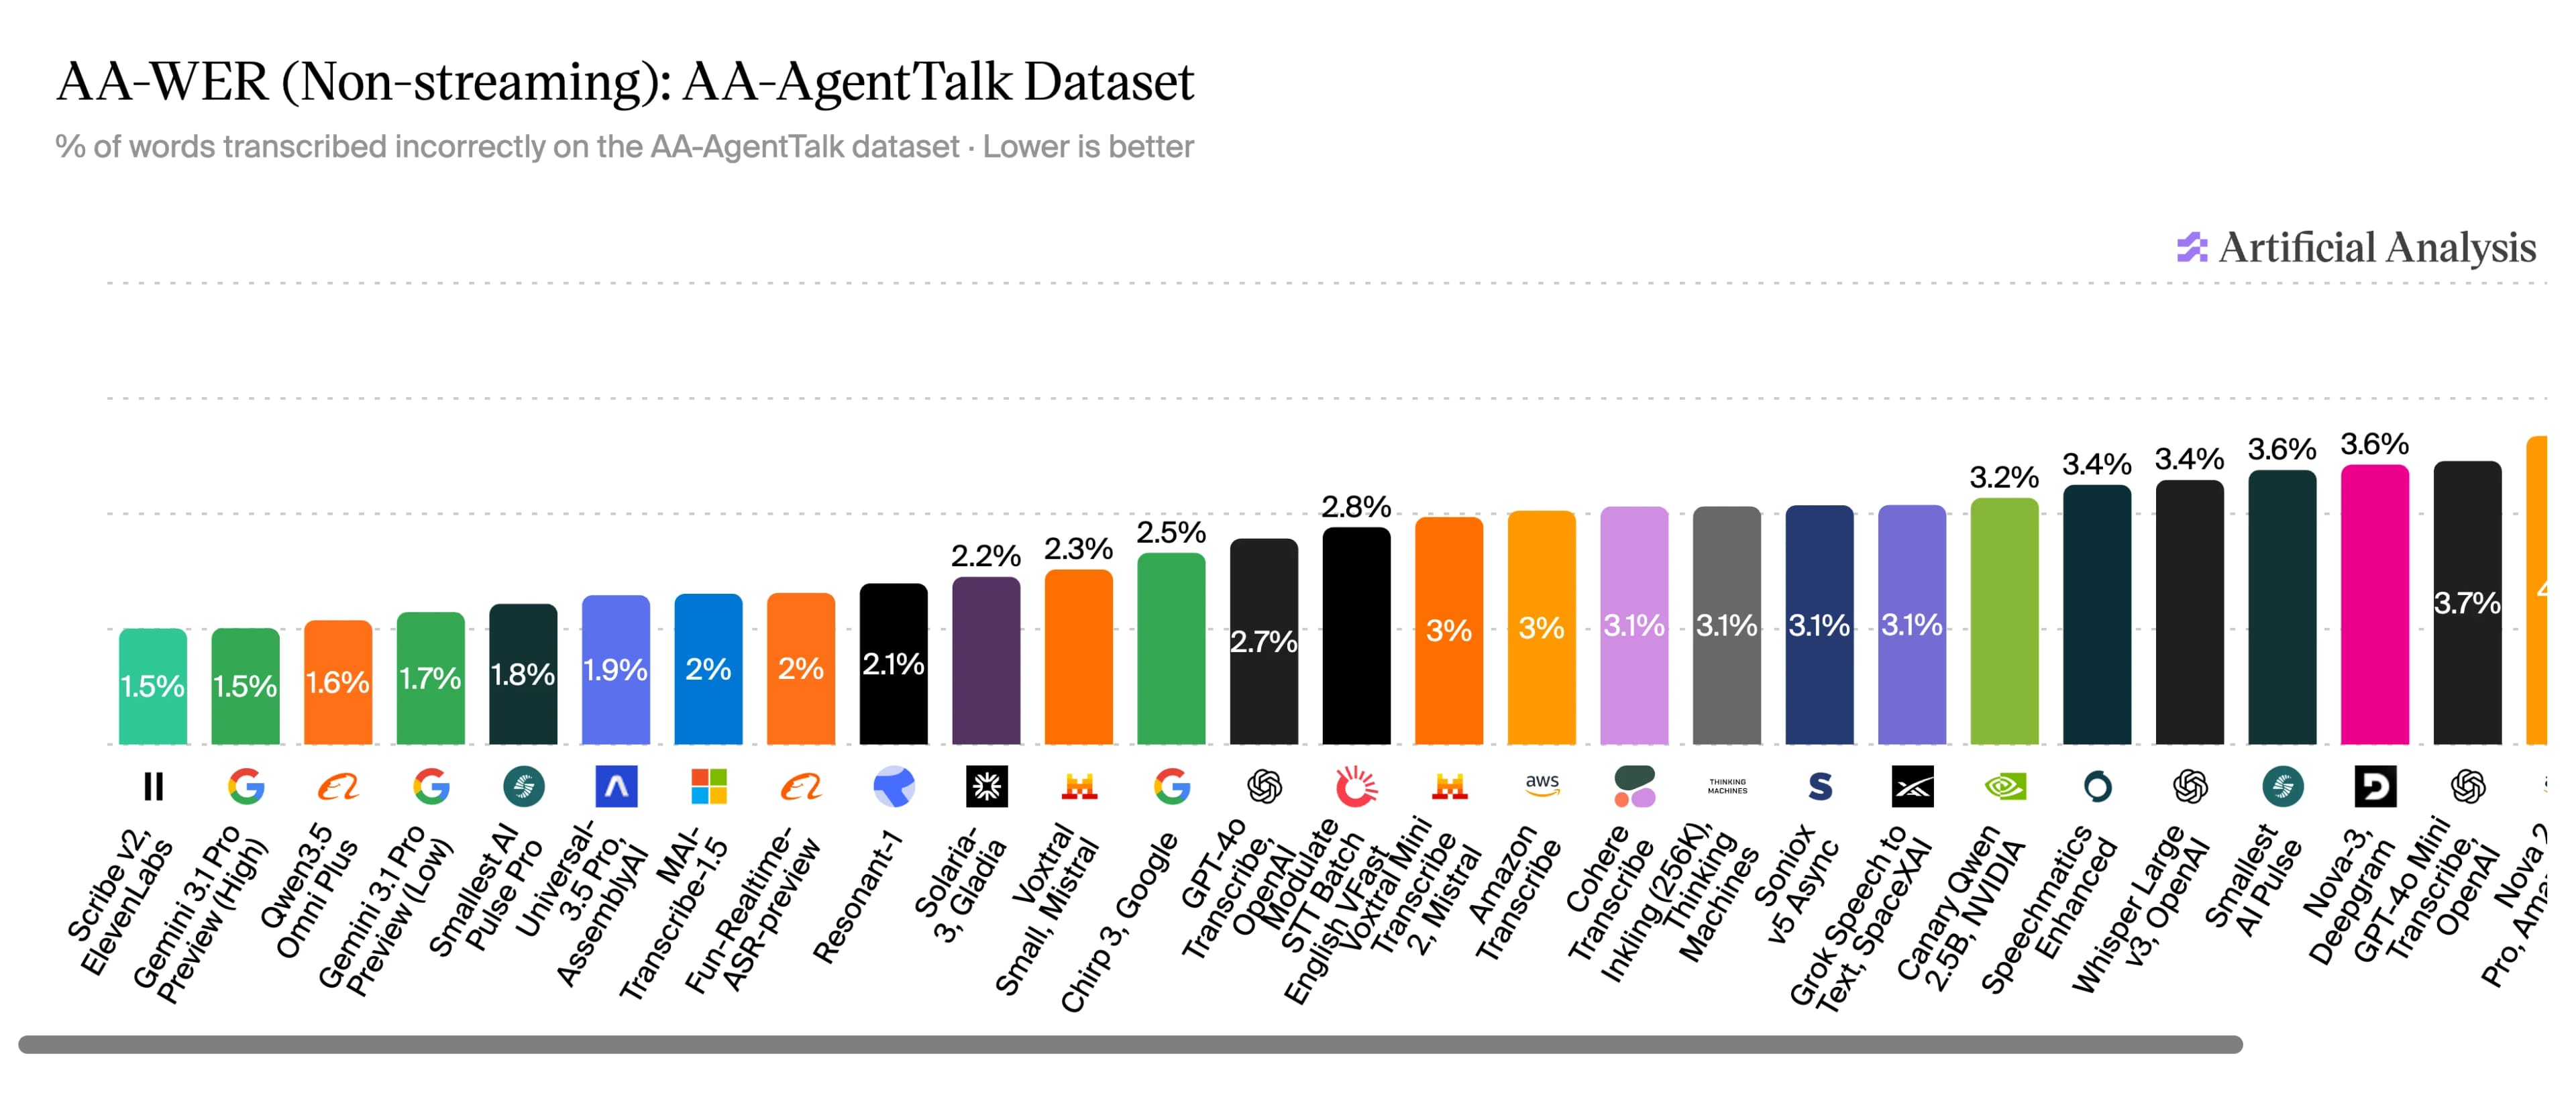
出典:Artificial Analysis(2026年7月10日アクセス)。
2026年7月時点で、独立調査機関の Artificial Analysisは、ElevenLabsのScribe v2を、非ストリーミング文字起こしモデルにおけるAA-AgentTalkデータセットで業界最低のWERを達成したモデルとして評価しています。WERは1.5%でした。
ベンダー評価にとどまらず、WERはプロダクトレベルでも現実的な影響を与えます。WERが12%の医療文字起こしソフトウェアでは、患者記録に重大なエラーが入り込む可能性があります。カスタマーサポートの通話で文字起こしを誤ると、不正確な感情分析や不適切な分類など、後続工程の失敗につながる場合があります。
こうしたユースケース固有の問題に加え、ASRシステムが機能しない場合、特に大きな影響を受けるのは、文字起こしが音声コンテンツにアクセスする唯一の手段である人々です。World Wide Web Consortiumは、アクセシビリティ施策で求められる最低基準について、詳しいドキュメントを提供しています。
単語誤り率の計算方法:式と例
単語誤り率の計算は、手順を理解すれば簡単です。前述のとおり、使用する式はWER = (S + D + I)/ Nです。各項目の説明は上記のとおりですが、簡単に言うと、置換、削除、挿入、そして文字起こしの総単語数を表すNです。
WERは次の手順で計算します。
- 参照文字起こしを作成: 人による文字起こしと検証を行い、音声クリップの正確な文字起こしを作成します。
- STTツールを使用: ASRプラットフォームで音声クリップを文字起こしし、テストに使用するAI文字起こしを作成します。
- 2つのバージョンをアラインメント: 動的計画法(具体的にはレーベンシュタインアルゴリズム)を使って、最小編集回数を求めます。このアルゴリズムについては後ほど詳しく説明します。
- 式を適用: AI生成版と人が検証した原稿を比較して総エラー数を数え、WER = (S + D + I)/ Nで正確なWERを算出します。
紙の上ではかなり技術的に見えますが、実際にはずっと簡単です。ここでは、具体例で説明します。
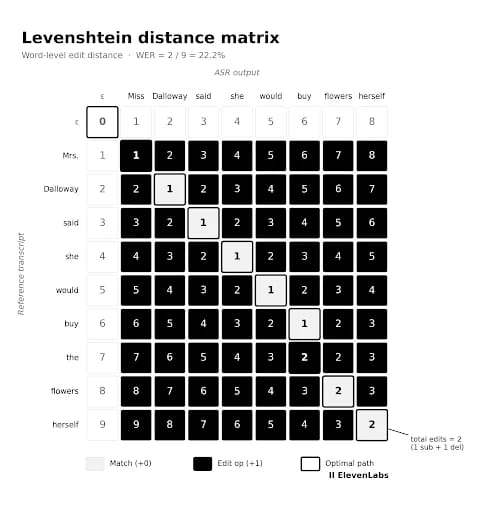
参照文字起こし: ダロウェイ夫人は、自分で花を買うと言った。
ASR出力: ダロウェイ嬢は、自分で花を買うと言った。
総エラー数を計算すると、全9語のうちSが1つ、Dが1つです。
式に当てはめると、WER = 2 / 9 = 0.222 = 22.2%となります。
Pythonで単語誤り率を計算する
手動の方法でも十分に機能しますが、PythonでWERを計算すれば時間を節約できます。jiwerライブラリを使えば、これらすべてを完全に自動化できます。
jiwerのドキュメントを参照して、ASRシステムの評価とWERなどの主要指標の算出に特化したパッケージをインストールできます。ダウンロード後は、次のコードでPythonを使ってWERをすばやく計算できます。
この例では、ASR出力は元の参照文と2か所異なります。「jumps」は誤って「leaps」と文字起こしされており(置換)、「lazy」の前には「last」が挿入されています(挿入)。参照文字起こしの9語に対して2つのエラーがあるため、単語誤り率(WER)は0.222、つまり22.2%になります。
単語誤り率と他の認識指標の比較
WERはASRの精度を算出する標準的な指標ですが、ほかにも使用できる指標があります。たとえば、以下のとおりです。
- 文字誤り率(CER): WERと同様に、単語単位ではなく文字単位で文字起こし精度を測定します。明確な単語境界がない言語(scriptio continua)や、スペルの正確さが重要なタスクに適しています。
- 一致誤り率(MER): 置換・挿入・削除をWERとはやや異なる方法で扱い、文字起こしエラーの割合を測定します。文中で誤っているエラーの割合に焦点を当てます。
- 単語情報損失(WIL): 文字起こしの過程で元の情報がどの程度失われたかを推定します。WERのような直接的なエラー数ではなく、理解可能性を測る指標です。
- 埋め込み誤り率(EmbER): 文字起こし間の意味的な分析を行います。WERを超えて、正しい単語と誤った文字起こしの意味的距離に関する洞察を提供します。
これらの指標はそれぞれ異なるシナリオに適しています。以下の表を参照してください。
レーベンシュタイン距離の例:WERを支える数学
単語誤り率は、元の文と仮説出力との距離を測るものです。この差を数学的に理解するために、レーベンシュタイン距離を使用します。
レーベンシュタイン距離は、あるシーケンスを別のシーケンスに変換するために必要な、最小の単位編集回数を数えます。WERでいう編集とは、具体的には置換・挿入・削除です。たとえば、CatをMatに変換するには、「C」を「M」に1文字置き換える必要があるため、レーベンシュタイン距離は1になります。
CERの計算ではこの考え方をより多く使いますが、WERではレーベンシュタイン距離を単語レベルに拡張します。各単位は文字ではなく単語全体であり、実際の距離はASR出力を正確な原文に変換するのに必要な単語編集の回数です。
元の文字起こしとASR文字起こしの総距離を各セルで表す行列を作成します。レーベンシュタイン距離は行列を左上から右下へ埋めていき、最後のセルが単語レベルの総編集回数を示します。その数をNで割ったものがWERです。
この行列は通常、個々の文字を使って計算されますが、ここではわかりやすくするため、先ほどの例を単語レベルに拡張したバージョンを示します。
単語誤り率に関するよくある落とし穴と誤解
特に、STT APIが利用しやすくなり、ASRソフトウェアがより幅広いエージェントスタックの一般的な一部となるにつれて、さまざまなツールの比較が増えていくでしょう。
独自の単語誤り率を計算する前に、理解しておくべきよくある問題と誤解がいくつかあります。
- すべてのエラーは同じではない: WERでは、すべてのエラーを同じ重要度として扱います。多くの文脈では問題ないかもしれませんが、これが許容できないユースケースもあります。たとえば病院では、良いWERとされる5%のエラー率であっても、1つか2つのエラーが患者を危険にさらす可能性があるため、受け入れられない場合があります。この限界から、すべての単語が完全に一致したかではなく、文の意味が保たれたかを測ろうとするSemantic Word Error Rate(SWER)などの新しい指標が開発されています。
- WERは100%を超えることがある: WERは0〜1の範囲と説明しましたが、100%を超えるWERもあり得ます。挿入エラーによって、元の文字起こしの総単語数より多くの単語が生じるためです。よくある例は、「I’m」を「I am」と文字起こしするケースで、1語が2語になります。
- 技術的には、WERが低いほど常に良いとは限らない: WERが5%なら、数値上はWERが10%より優れています。しかし、その5%を構成するエラーが文の文脈を大きく変えており、10%のエラーはそうではなかった場合、数値だけでは全体像を表せません。文脈は依然として非常に重要であり、この意味的な影響を捉えるためにSWERなどの指標が開発されています。
2024年、Appleは上記の最後の点を検証する興味深い研究を発表しました。ASRの可読性という観点から、人間がWER計算値9.4%を評価したところ、同じ文章に対してわずか2.2%のWERを付けました。テストした例では、人間は多くの場合で「エラー」を重要ではないと見なし、機械より4倍以上寛容なHuman WERとなりました。
WERの業界ベンチマーク
理想的なWERは、ASR技術を使用する業界やユースケースに大きく依存します。WERの業界ベンチマークは5%未満ですが、医療や法務の文字起こしなど、特定の業界ではさらに低い値が必要です。
Artificial Analysisの2026年7月の調査では、ElevenLabsのScribe v2はWER 1.5%を記録しました。ただし、これらの統計は通常、主要言語として英語を対象に実施されている点に注意が必要です。他の言語では、STT技術の精度が同等ではない可能性があります。
ElevenLabsドキュメントでは、WERの一般的な範囲を、Scribe v1とScribe v2が対応するすべての言語について詳しく説明しています。
ElevenAPIで認識精度を向上させる
文字起こし品質が重要なアプリケーションやプロダクトを構築する場合、適切に選んだASR APIと平凡なAPIとの差は、まずWERに、次にユーザー体験に表れます。
ElevenLabs Scribeは、スピーチtoテキストのレイヤーであり、ElevenAPIを通じて利用できます。90以上の言語対応と業界最高水準のWERに加え、話者ダイアライゼーション、単語レベルのタイムスタンプ、キータームプロンプティング、エンティティ検出などの機能を提供します。
ElevenLabsドキュメントでElevenAPIについて詳しく確認するか、登録して今すぐ始めましょう。
単語誤り率に関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


