よりスマートなワークフローでスピーチtoテキストの精度問題を解決
- 公開日
- 最終更新日
スピーチtoテキスト(STT)の精度は、音質、話し方、使用する言葉の3つで決まります。ノイズや強い圧縮によって録音の細部が失われると、高性能なモデルでも重なった音声や馴染みのない専門用語の処理が難しくなります。このガイドでは、STTの各問題が生じる原因と解決方法を説明します。
文字起こしの誤りは、そのテキスト内だけにとどまることはほとんどありません。診療記録で聞き間違えた薬剤名や通話記録の誤った口座番号は、検索や分析から、発言内容に基づいて動作するAIエージェントまで、そのテキストを利用するすべてのシステムに引き継がれます。また、精度が低いと、誰かが手作業で誤りを見つけて修正する必要があるため、確認時間も増えます。
幸い、STTの精度問題のほとんどは解決できます。多くの場合、既存の設定や録音環境を少し変更するだけで済むため、モデル設定を変えずに問題を解決できます。
このテーマは、音声認識精度、ASR精度、文字起こし精度とも呼ばれます。スピーチtoテキスト、音声認識、自動音声認識(ASR)は、いずれも話し声のオーディオをテキストに変換する同じ処理を指します。どの用語を使う場合でも、このガイドの対策を適用できます。
要点
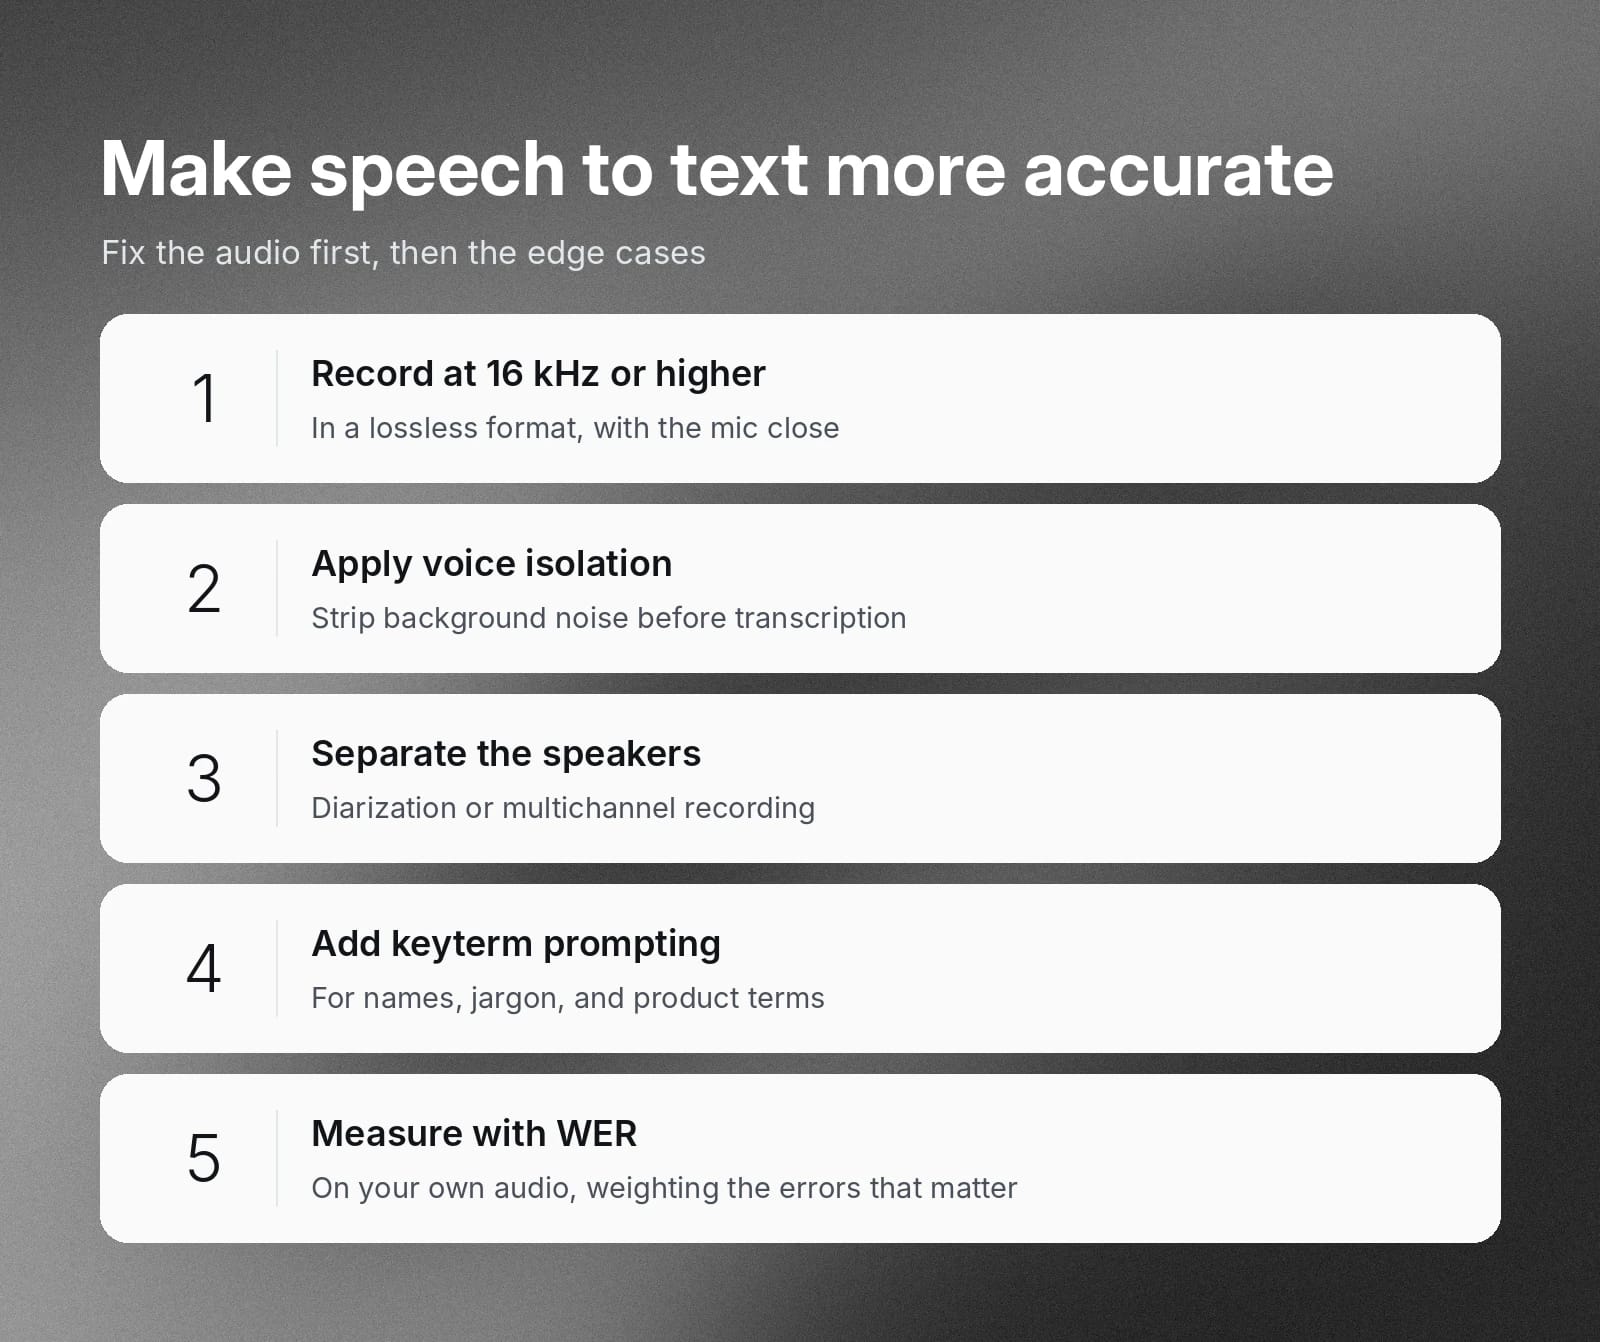
- スピーチtoテキストの精度は、入力オーディオの品質、話者の話し方、語彙と文脈の問題に左右されます。
- 精度問題を解決するには、パイプラインのどこ(入力、処理、出力)を変更できるか特定します。
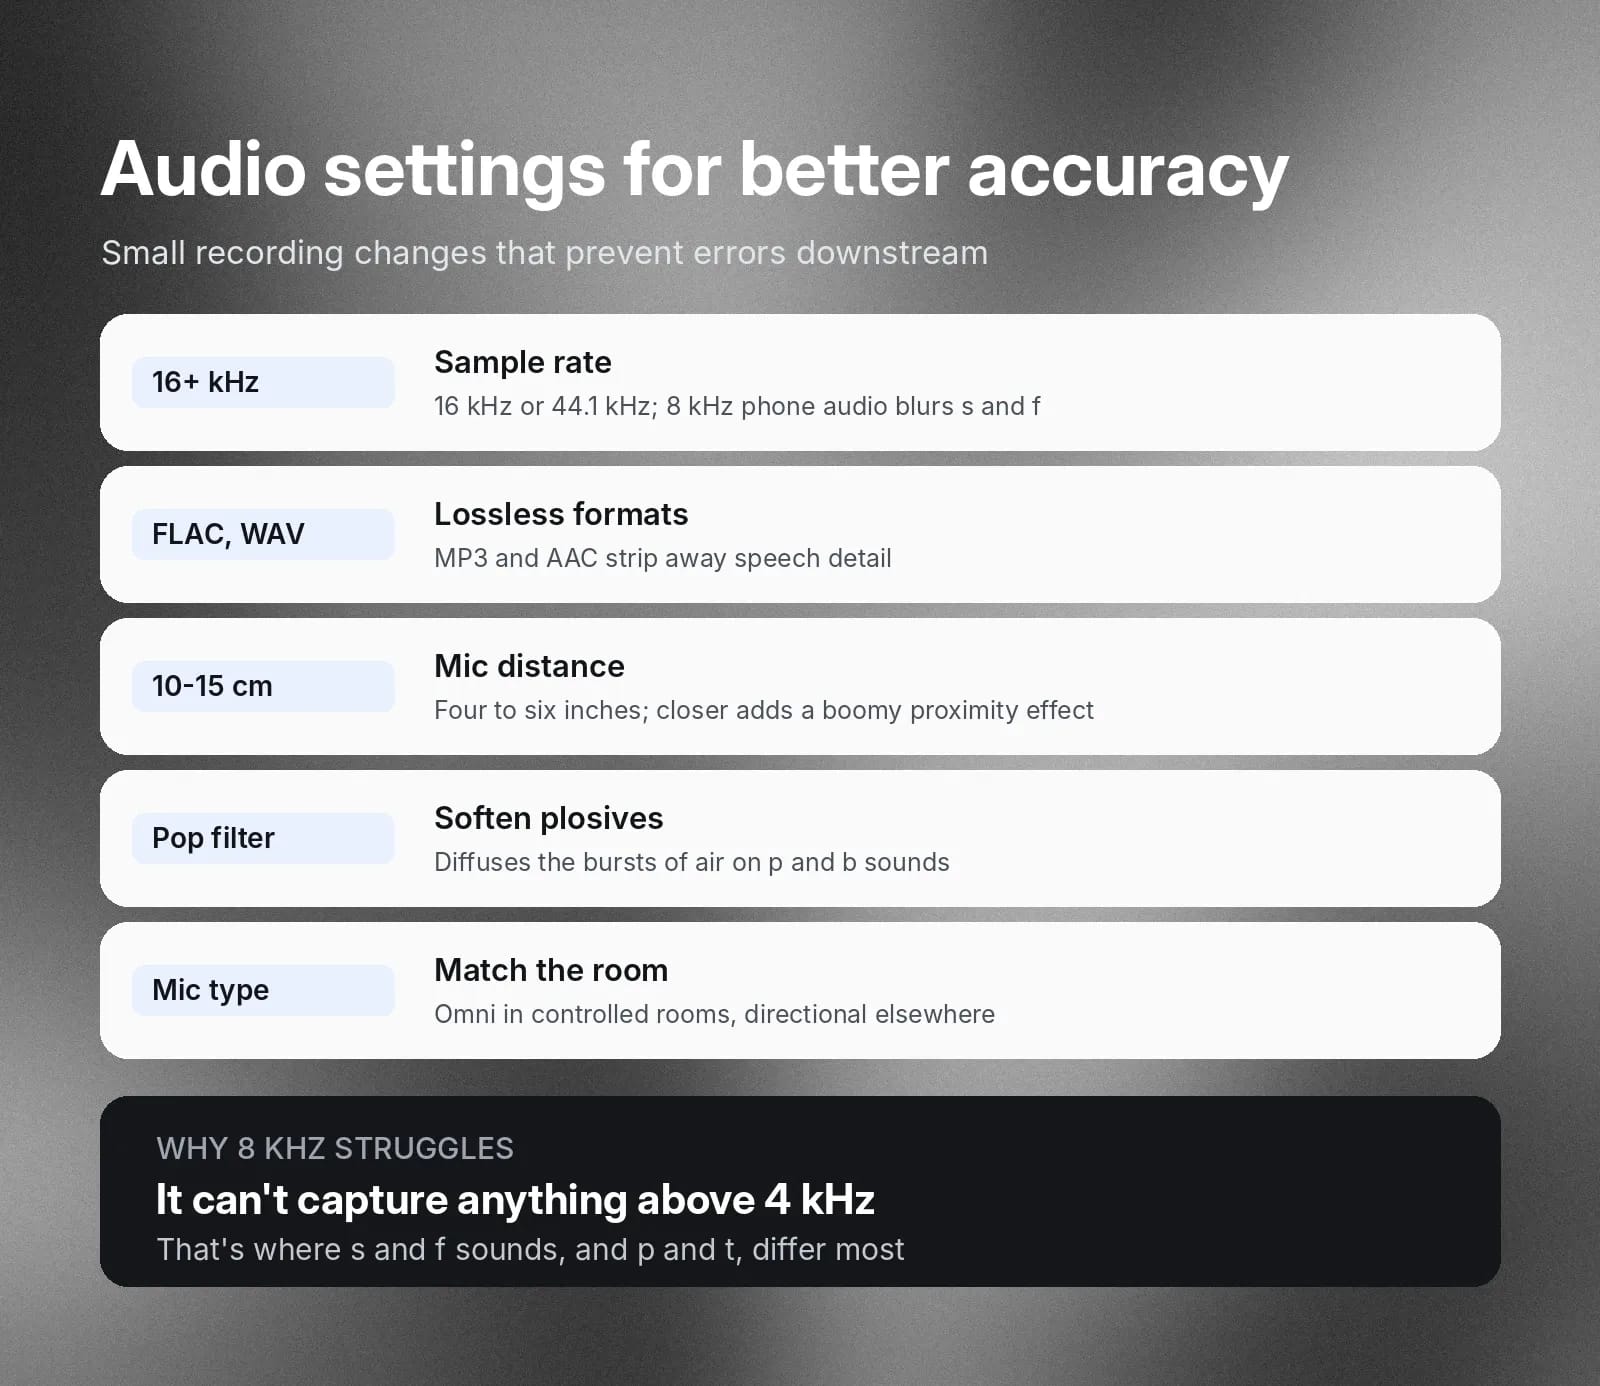
- 16kHz以上で録音し、ロスレス形式を使用して、マイクを話者から10~15cm離して設置します。
- ノイズ、重なった音声、専門用語には、ボイスアイソレーション、話者ダイアライゼーションまたはマルチチャンネル録音、キータームプロンプトを使用します。
- 単語誤り率(WER)で精度を測定し、用途にとって特に重要な誤りを確認します。
スピーチtoテキストの精度問題の原因は?
強いアクセントのある教授が複雑な理論物理学について話す音声を、BGMや周囲の話し声が響く混雑したレストランで録音し、その文字起こしを頼まれたと想像してください。コンピューターシステムは、音響のばらつきに本来適応しているわけではありません。STTを効果的に機能させるには相当なトレーニングと微調整が必要です。最新のAIツールは非常に高性能ですが、出力に影響する問題はまだ数多くあります。ただし、その問題を理解すれば、文字起こしのワークフローで対処できます。
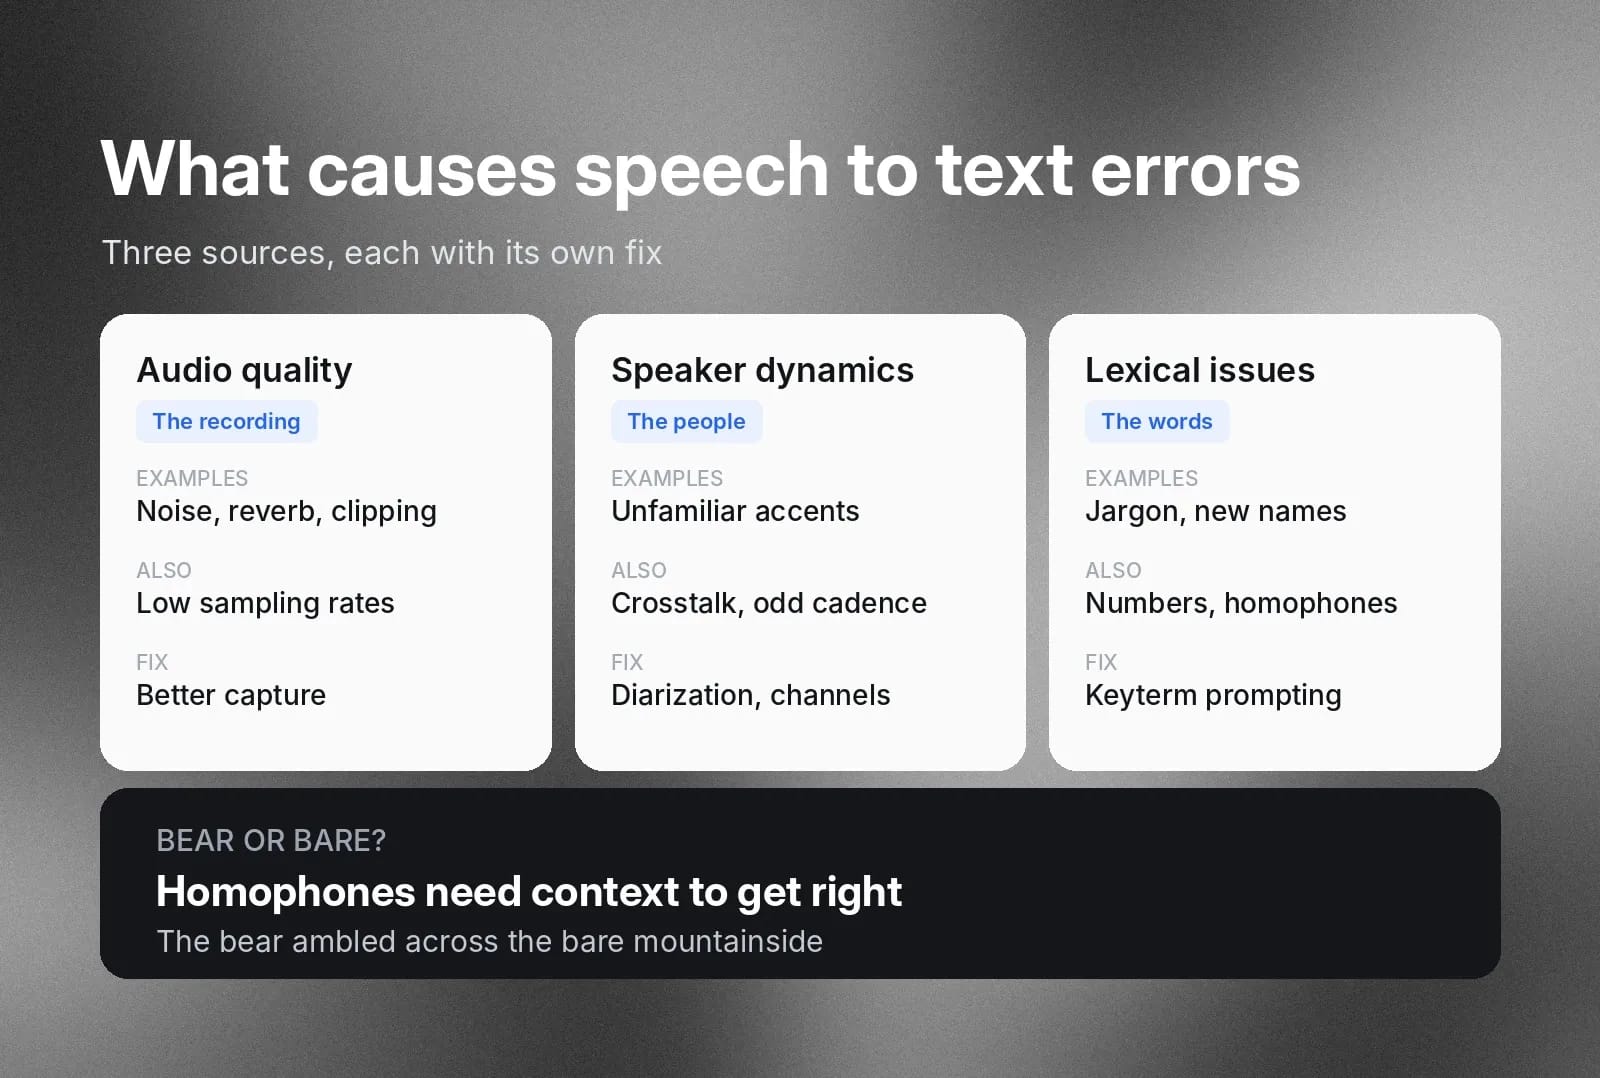
スピーチtoテキストの精度が低下する主な原因は3つあります。
- 入力オーディオの品質問題
- 話者の話し方
- 語彙と文脈の問題
原因ごとに異なる対策が必要です。以下で順番に説明します。
音質の問題
まず、録音されたオーディオ自体に問題がある場合があります。マイクの不具合により、音声が歪んだり途切れたりすることがあります。また、会場の音響による残響、録音時の低い信号対雑音比(SNR)、低いサンプリングレートによって、重要な音声情報が失われる可能性もあります。
話者の話し方
静かな場所で標準的なアクセントの1人の話者が話す音声は、比較的簡単に文字起こしできます。しかし、実際に文字起こししたい録音がこの条件を満たすことはまれです。馴染みのないアクセントや、途切れがちで一般的ではない話し方は、標準的な発話でトレーニングされたSTTモデルの精度を下げることがあります。話者同士の割り込みや音声の重なりも、発言内容を正確に解析する妨げになります。
語彙と文脈の問題
さらに、発話の内容によってはSTTモデルでの処理が難しくなります。業界用語や新しいプロダクト名は、モデルがトレーニング中に学習していない可能性があります。モデルは統計的に最も可能性の高い出力を選ぶため、馴染みのない言葉は有力な候補にならないことがあります。数値や数式、通常は数字で表記する発話も、明確に文字起こしされない場合があります。
同音異義語とは、発音は同じでも綴りが異なる単語です。STTモデルが区別するには、十分な文脈理解が必要です。たとえば「the bear ambled across the bare mountainside(クマが草木のない山腹をゆっくり歩いた)」の場合、動物は「bear」、何も覆っていない状態を表す形容詞は「bare」と綴ることをモデルが理解する必要があります。
オーディオ入力から出力まで、スピーチtoテキストの精度問題を解決する方法
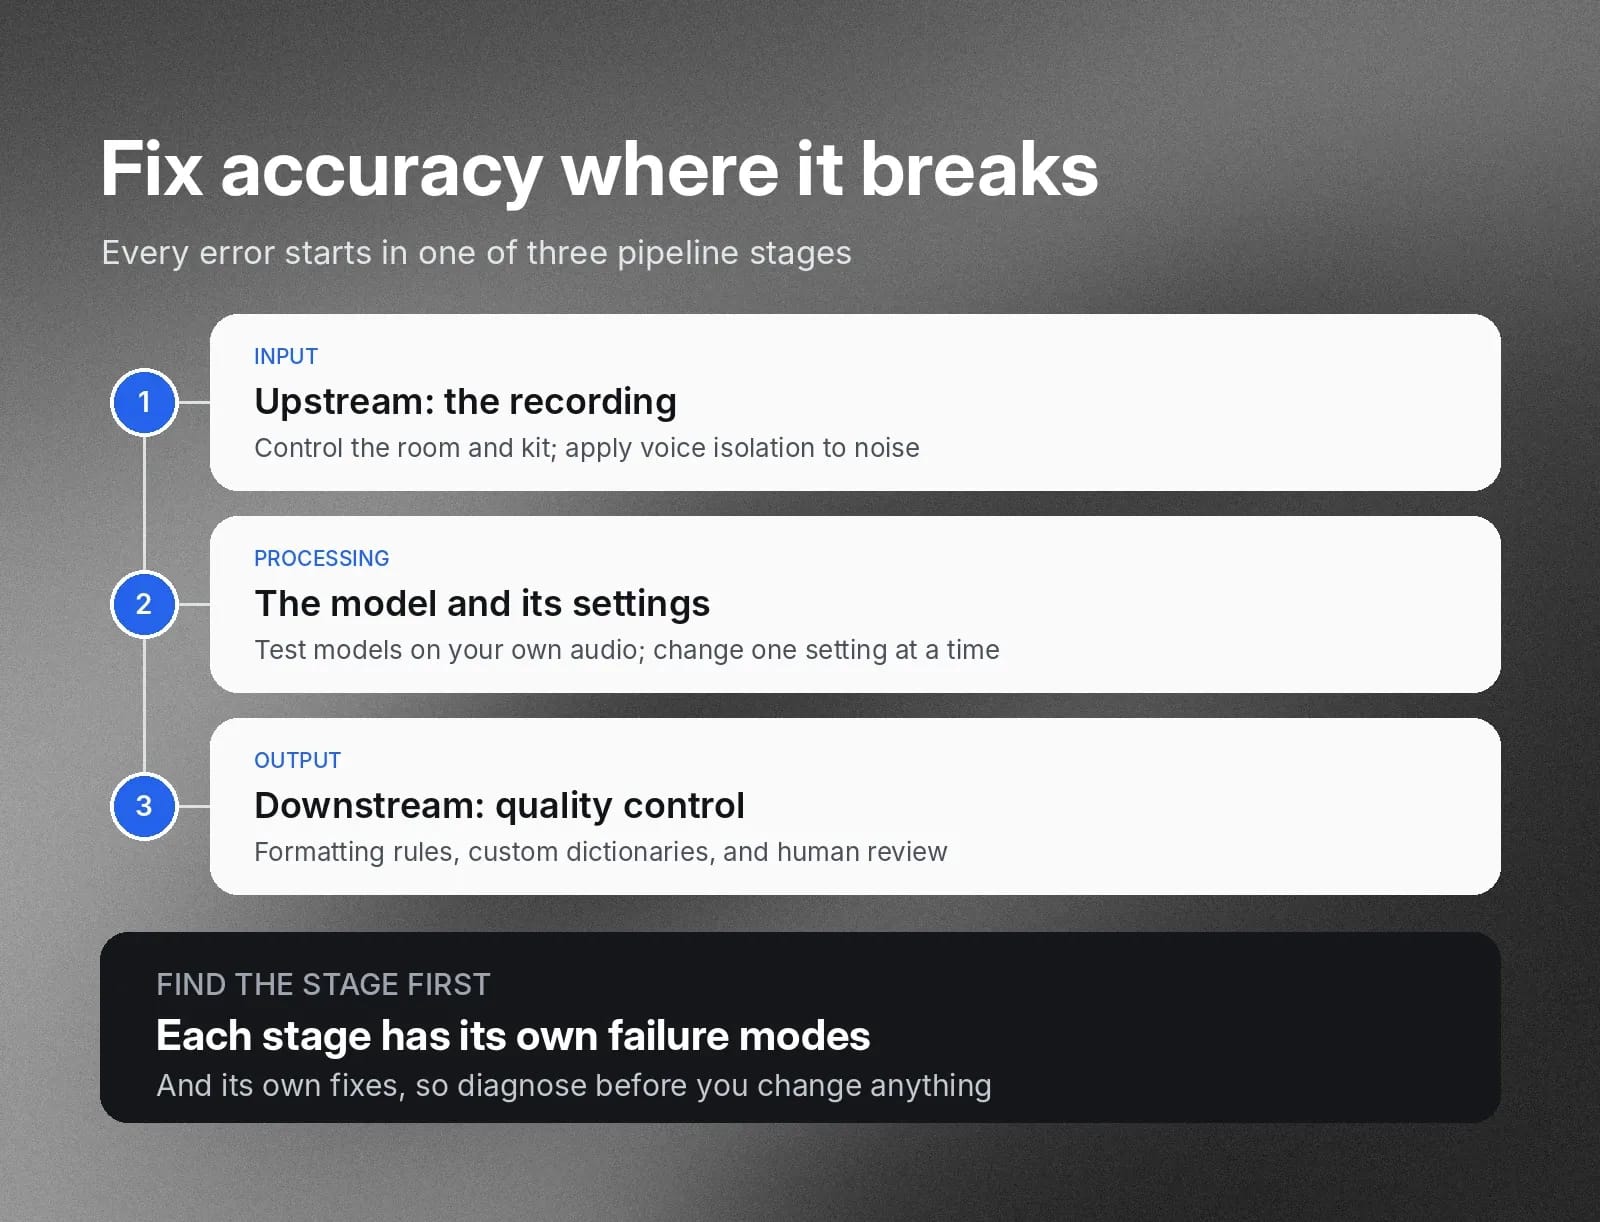
スピーチtoテキストの処理は、明確に定義された複数のステップで構成されます。精度問題を解決するには、パイプラインのどこを変更できるか特定する必要があります。STTの処理は、大きく次の3つに分かれます。
- 入力
- 処理
- 出力
各段階には、それぞれ固有の問題と対策があります。
上流の入力精度の問題
録音環境に問題がある可能性があります。よくある問題は、バックグラウンドノイズや反響です。録音機器に不具合がある場合は、機器自体が原因になることもあります。
この段階の問題は、通常、原因を切り分けて解消します。たとえば、STTツールが大きな背景音を苦手としている場合は、管理しやすい環境で会話を収録するのが効果的です。
避けられないノイズには、オーディオがモデルに届く前にボイスアイソレーションを適用します。
処理段階の精度問題
STTエンジンに接続するAPIの設定は、処理に影響します。プロンプトの構造や選択するモデルも、品質や誤りの数を左右します。
この段階の問題を解決するには、実際のオーディオで設定をテストします。同じサンプル録音を各候補モデルで処理し、単語誤り率を比較してから、設定を一度に1つずつ変更して調整します。
ノイズの多い通話や特定地域のアクセントなど、ある種類の発話をモデルが何度も認識できない場合は、実際に使用する環境で複数のモデルの精度をテストしてください。
下流の出力精度の問題
ここは品質管理の段階です。メインエンジンが見逃した可能性のある文字起こしの誤りや曖昧さを、専用の処理で修正します。STTパイプラインでは、ルールベースのパターンマッチングを使って表記を標準化することがあります(例:「ten dollars」を「$10.00」に変更)。これは逆テキスト正規化(ITN)と呼ばれます。ただし、話者が対象の言葉を一般的ではない方法で使ったり、誤って発音したりすると、固定的な検索置換ツールでは検出できません。
ヒューマン・イン・ザ・ループ(HITL)で出力品質を確認するかどうかも重要です。確認しなければ、不正確な内容が本番環境の出力に入り込む可能性があります。また、人が作業する以上、人的ミスが発生する可能性もあります。
この段階では、メインエンジンが残した誤りを検出して修正します。文字起こしを正解サンプルと比較して繰り返し発生する誤りを特定し、その用語に対応するルールやカスタム辞書を追加できます。特に重要度の高い文字起こしには、必ず人による確認を加えてください。
音質を改善して音声認識の精度を高める方法
録音時の音質を改善すると、下流で生じる多くの精度問題を減らせます。高いサンプリングレートを使用し、圧縮を最小限にするか使用せず、できるだけクリアな録音環境を維持してください。
サンプリング品質
録音には16kHzまたは44.1kHzのオーディオを使用してください。従来の電話品質である8kHz以下のサンプリングでは、STTモデルによる解析が難しくなる場合があります。モデルには音がこもって不明瞭に聞こえますが、人が電話で話す場合のように、話者に聞き返すことはできません。
サンプリングレートで再現できる周波数は、その半分までです。これはシステムのナイキスト周波数と呼ばれます。8kHzでは4kHzを超える周波数がカットされるため、特に摩擦音(「s」と「f」の音)や破裂音(「p」と「t」の音)をSTTモデルが区別しにくくなります。
圧縮
MP3やAACなどの非可逆形式で録音すると、発話の微妙なニュアンスも失われる場合があります。モデルが利用できる信号が少なくなるためです。FLACやPCM WAVなど、ロスレスまたは非圧縮形式を使用してください。
録音環境
マイクの使用について、オーディオエンジニアリングのベストプラクティスに従ってください。無指向性マイクは管理された環境に適しています。それ以外では、音声を分離しやすい指向性マイクが適しています。マイクは話者の口から10~15cm離して設置し、話者がマイクに近づきすぎないようにしてください。近づきすぎると近接効果が発生し、低周波が強調されて録音が不明瞭になります。
可能な限り、マイクにポップフィルターも使用してください。ポップフィルターは、破裂子音(「p」や「b」の音など)の発音時に生じる空気の噴出を拡散します。
バックグラウンドノイズを減らして音声認識を改善
前のセクションで説明したとおり、可能な限りマイクを話者に近づけ、理想的には口から10~15cm離して録音します。録音を不明瞭にするホワイトノイズやバックグラウンドノイズは避けてください。現場録音の経験がないと気づきにくい一般的なノイズ源には、空調設備のハム音、キーボードの打鍵音、街中の環境音などがあります。これらはすべて、STTモデルによる音声解析を難しくします。
ただし、バックグラウンドノイズを避けられないことも多くあります。その場合は、オーディオをSTTモデルに送信する前の前処理としてボイスアイソレーションを適用します。ボイスアイソレーションは、ソフトウェアアルゴリズムや軽量の専用ニューラルモデルを使用して、音声録音から背景音を除去します。
アクセント、重なった音声、専門用語に対応する
最新の多言語モデルは多様な発話データでトレーニングされていますが、実環境のオーディオに対する精度は依然として異なります。対象となるユーザー層のサンプルオーディオを使い、複数のモデルを独自にベンチマークしてください。過去のカスタマーサービス通話を利用できる場合は、実際に文字起こししたいアクセント、話すリズム、発話パターンを含む通話を文字起こししてテストします。
出力の誤りを確認し、関連するパターンを特定します。若年層が使うスラングを認識できていないでしょうか?よく遭遇する特定地域のアクセントでつまずいていないでしょうか?
重なった音声に対応する
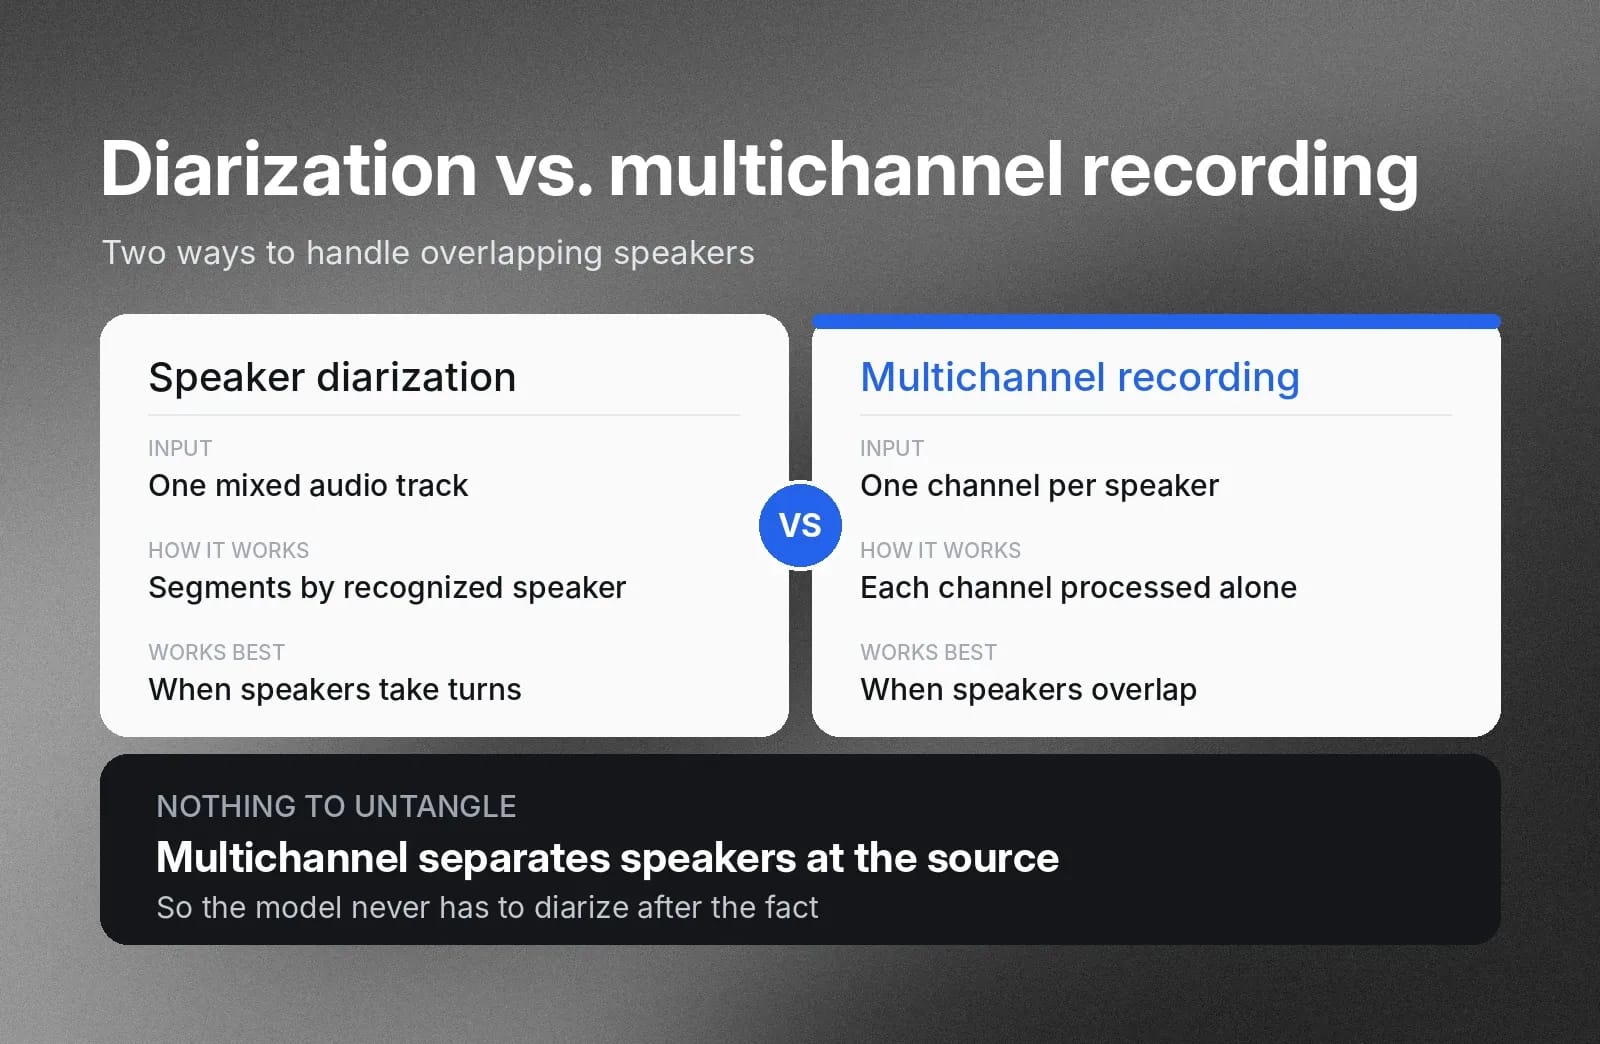
重なった音声を正確に文字起こしするための主な手段は、話者ダイアライゼーションとマルチチャンネル録音です。話者ダイアライゼーションは、生の入力オーディオを認識した話者ごとに分割します。話者が明確に交代しながら話す場合に効果的です。
すべての音声ストリームを1つのオーディオトラックに混ぜる代わりに、ネイティブのマルチチャンネル録音では、話者ごとに別々のチャンネルへ保存できます。STTモデルは各チャンネルを個別に識別して処理できます。録音時点で話者が分けられているため、音声モデルが後から話者ダイアライゼーションを実行する必要はありません。
キータームプロンプトで認識候補を優先
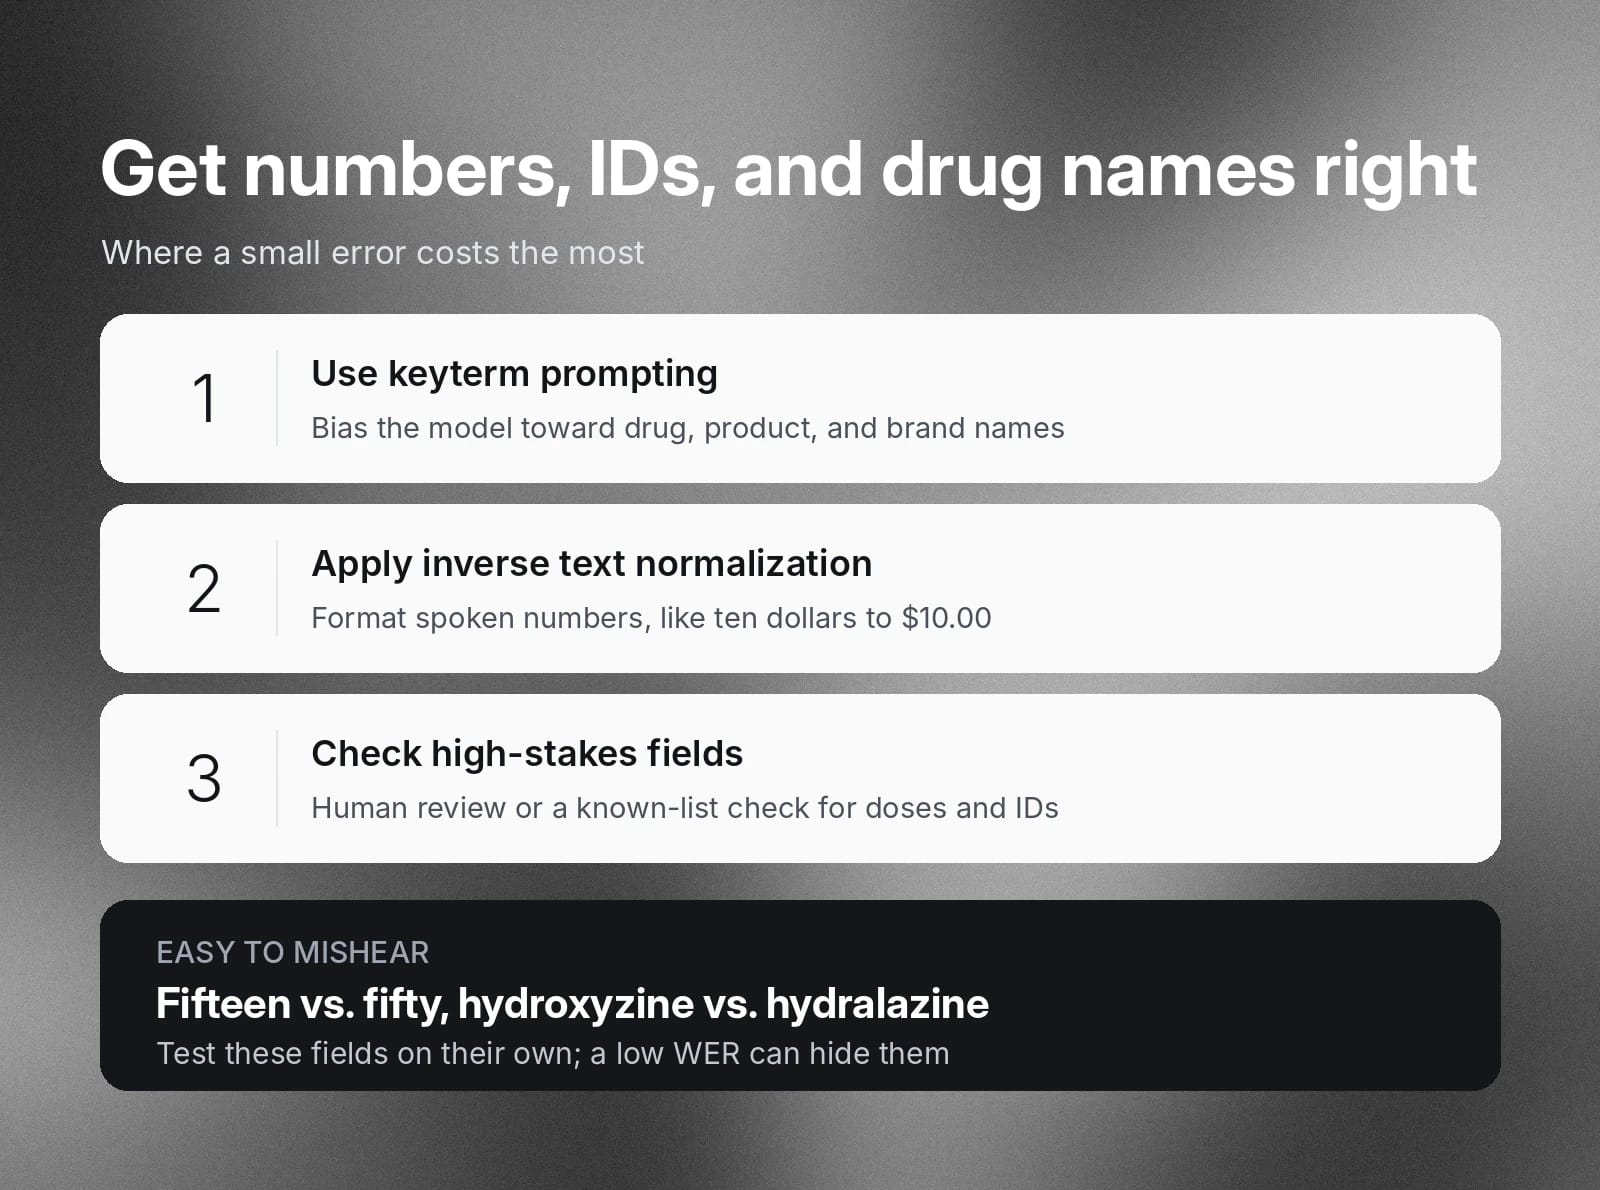
ブランド名、新しいプロダクト名、業界用語などの固有表現がSTTモデルのトレーニングデータに含まれていない場合、正確に文字起こしされないことがあります。キータームプロンプトとは、優先してほしい特定の綴りをSTTモデルに指定する方法です。通常は単純な一対一の置換指示ではなく、文脈に基づいて目的のカスタム表記が選ばれやすくなるようモデルにバイアスをかけます。
数字、ID、薬剤名を正確に文字起こしする
数字、アカウントID、郵便番号、薬剤名は、わずかな誤りでも大きな損失につながります。モデルが「fifteen(15)」を「fifty(50)」と聞き間違えたり、hydroxyzineとhydralazineのように1音節しか違わない2つの薬剤名を混同したりすることがあります。
次の3つの手順が役立ちます。
- キータームプロンプトを使用:想定される薬剤名、プロダクト名、その他の用語の綴りが選ばれやすいようにモデルを調整します。
- 逆テキスト正規化(ITN)を適用:発話された数字の表記を統一します。たとえば「ten dollars」を「$10.00」に変換します。
- 重要なフィールドを確認:投薬量や口座番号などのフィールドは、人による確認、または既知のリストとの自動照合を行います。
全体のWERが低くても、最も重要な単語の誤りが隠れる可能性があるため、これらのフィールドは個別にテストしてください。
音声認識の単語誤り率で品質を測定
単語誤り率(WER)は、STTエンジンの精度を評価するのに役立つ指標です。複数のモデルテストでWERを比較すると、それぞれの相対的な精度を把握できます。
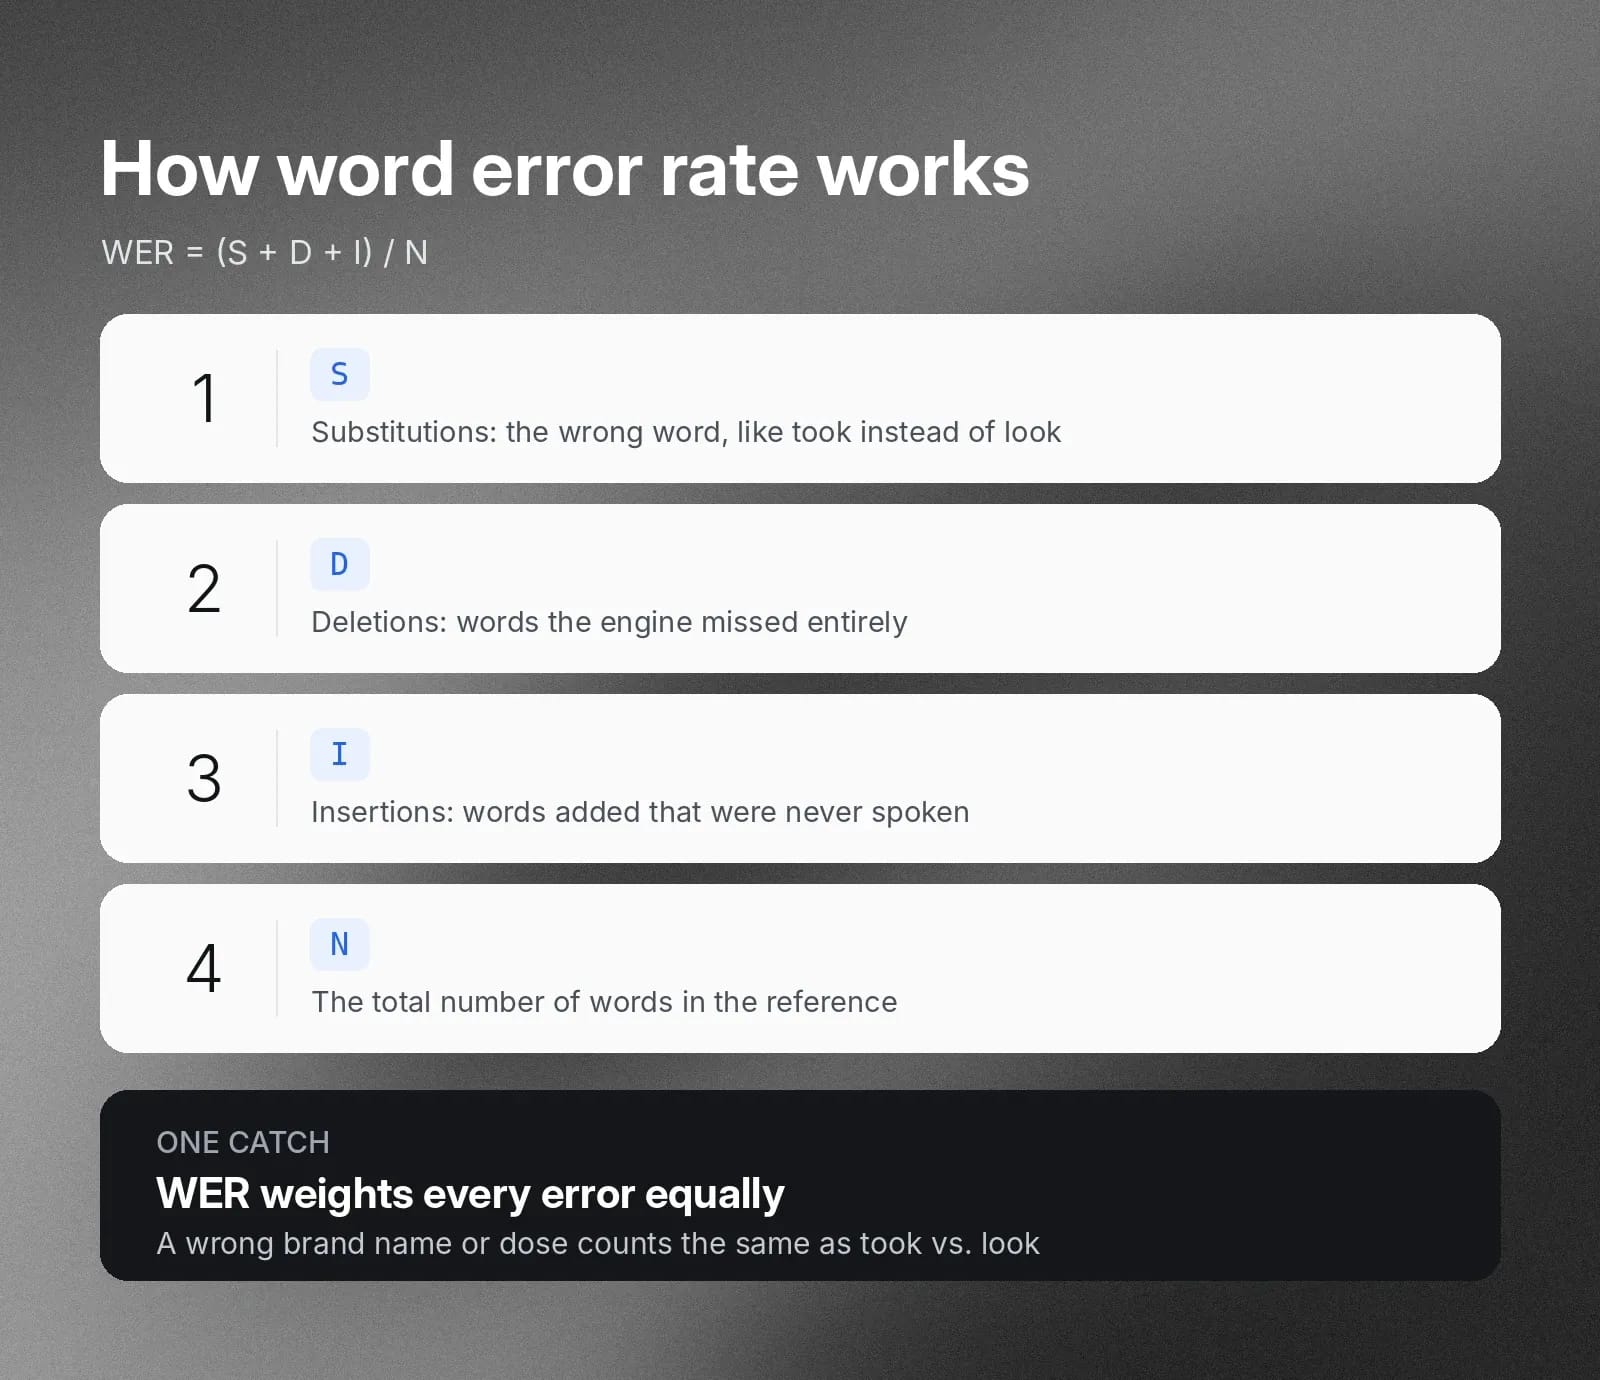
WERは次の式で計算します。
WER = (S + D + I) / N
- 置換(S):文字起こしでSTTエンジンが誤った単語を出力した回数(例:「look」ではなく「took」と出力)。
- 削除(D):完全に欠落した単語の数。
- 挿入(I):実際には発話されていないのに追加された単語の数。
- 正解文の総単語数(N):サンプル音声入力に含まれる単語の総数。
WERでは、すべての誤りが同じ重みで評価される点に注意してください。たとえば、「look」を「took」に置き換える誤りも、ブランド名や投薬量などの重要な数値を誤認する場合も同じ1件として扱われます。複数のモデルのWERを確認してください。
良好な単語誤り率の目安は?
良好なWERに一律の基準はありません。適切な目標値は、オーディオと用途によって異なるためです。クリアな1人の話者による音声は、複数の話者が重なりノイズも多い通話より、はるかに低い誤り率になります。一般的な数値だけに頼らず、実際の録音を使ってモデルを比較してください。
専門的なオーディオでの参考として、Scribe v2 Medicalは、公開されている医療分野のASRベンチマークでトップクラスの性能を持つモデルの1つです。最新の数値は現在のベンチマーク結果で確認してください。
新しいモデルがリリースされると、ベンチマーク結果も変わります。比較する前に最新の結果を確認してください。
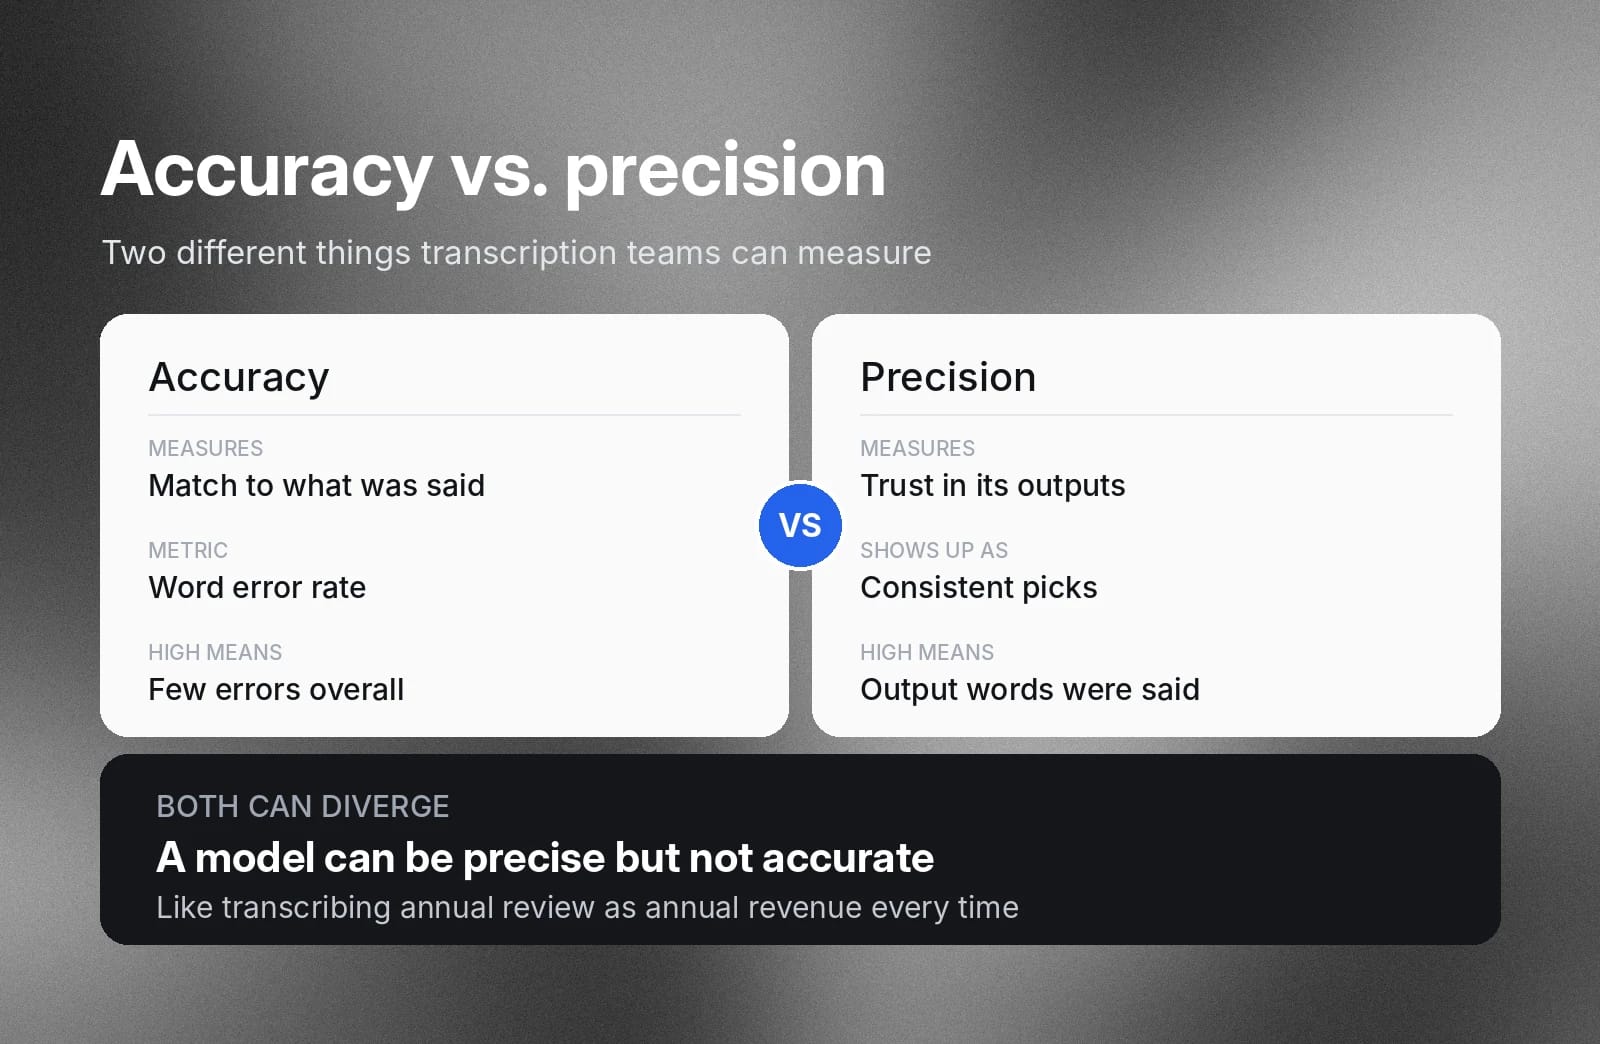
正確性と精密性:文字起こしチームが測定すべき指標
正確性とは、文字起こしの出力が、発話された正解データにどれだけ一致しているかを示すものです。単語誤り率は正確性を測定します。
精密性とは、STTモデルの肯定的な予測がどれだけ信頼できるかを示すものです。精密性の高いモデルは、複雑な発話でも複数回の実行で同じ単語を選びます。モデルがある単語を出力した場合、その単語が実際の発話に含まれていたと信頼できます。ただし、精密性が高くても、多くの単語が削除されて正確性が低い場合があります。
ElevenAPIで、より正確な文字起こしを始める
ElevenAPIでは、ElevenLabsのスピーチtoテキストモデルScribe v2に加え、このガイドで説明した精度問題に対応する機能を利用できます。名前や専門用語に対応するキータームプロンプト、重なった音声に対応するマルチチャンネル文字起こし、話者ダイアライゼーションなどがあります。
APIを使わずに文字起こしする場合は、ElevenCreateive STTも利用できます。
ElevenAPIで高品質なスピーチtoテキストの生成を今すぐ始めるか、ElevenAPIのスピーチtoテキスト機能について詳しくご覧ください。
スピーチtoテキストの精度に関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。