Scribe v2 Medicalをどなたでもご利用いただけるようになりました
- 執筆者
- Min Kim
- 公開日
- 最終更新日
聴くこの記事を聴く
臨床オーディオは、正確な音声認識にとって最も難しい試験の一つです。薬剤名は長く、まれで、混同しやすいものです(hydroxyzineとhydralazineは、聞き間違えやすい1音節分の違いしかありません)。投与量、単位、解剖学、病理学の用語が立て続けに現れるため、語彙も非常に専門的です。文字起こしの誤りが患者のカルテに記載される可能性があるため、リスクもより大きくなります。
そこでElevenLabsは本日、Scribe v2 Medicalをリリースします。これは臨床オーディオ向けに微調整したスピーチtoテキストモデルで、ElevenAPIで一般提供を開始しました。以下の評価では、比較対象モデルの中でも一貫して最も低い単語誤り率(WER)の一つを記録し、ベースモデルのScribe v2と比べて臨床オーディオのWERを約35%削減しています。
汎用モデルは日常会話の処理に優れていますが、臨床ワークフローで最も必要とされる場面では性能が低下することがあります。そこで、Scribe v2をベースに、薬剤名と臨床ディクテーションに焦点を当てた医療向けの微調整モデルを、誰でも再現できる公開ベンチマークでトレーニングしました。
Scribe v2 Medicalは臨床ユースケース向けに最適化
臨床ディクテーション(MedDictate)
CortiのMedDictateは、英語、フランス語、ドイツ語で薬剤名、投与量、単位が連続して含まれる口述形式の臨床ノートの文字起こしをテストします。評価では、Scribe v2 Medicalがテストしたモデルの中で総合WERが最も低く、ベースのScribe v2よりもWERが約35%低い結果となりました。
モデル
英語
フランス語
ドイツ語
総合WER
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2(ベース)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*英語のみ(24クリップ)— Deepgram Nova-3 Medicalはフランス語またはドイツ語に対応していません。
医療用語(MedTerm)
MedTermもCortiが公開したデータセットで、同じ3言語による600サンプルの臨床用語ベンチマークが含まれ、各サンプルの医療用語にはアノテーションが付与されています。このアノテーションにより、文字起こし全体のWERに加えて、2つの指標でモデルを評価できます。用語再現率は、アノテーション付きの医療用語が文字起こしに正しく現れる割合です(高いほど良好)。Term-WERは、周囲の通常会話を除外し、それらの用語のみを対象とした誤り率です(低いほど良好)。
Scribe v2 Medicalは、テストしたすべてのモデルを両指標で上回り、3言語すべてで他のプロバイダーをリードしています。
モデル
用語再現率 ↑
用語WER ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2(ベース)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Eka Medical ASRベンチマーク
Eka Medical ASRベンチマークには、単独の薬剤名・疾患名、臨床文、臨床医と患者の会話にわたる3,619件の英語臨床オーディオサンプルが含まれています。用語ごとのアノテーションと、データセットカードで公開されているリーダーボードも提供されています。
公開データセットにはGemini 2.5 FlashやGPT-4oなどの旧モデルが含まれているため、新しいモデルを対象に評価を実施しました。SemWER(意味WER)は、表記にかかわらずモデルが正しい内容を聞き取れたかを評価します(「mg」と「milligrams」は同じ回答として扱われます)。kwWER(キーワードWER)は、アノテーション付きの医療キーワードのみに同じ評価を適用します。
モデル
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2(ベース)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Ekaでは各サンプルの医療用語にアノテーションが付けられているため、医療用語のみについて、ベースモデルに対するScribe v2 Medicalの改善をより細かく評価できます。Scribe v2 Medicalはベースモデルより誤りが15%少なく(9.5%対11.1%)、用語が完全な臨床文内に現れる場合に改善幅が最も大きくなります(7.5%対9.9%)。
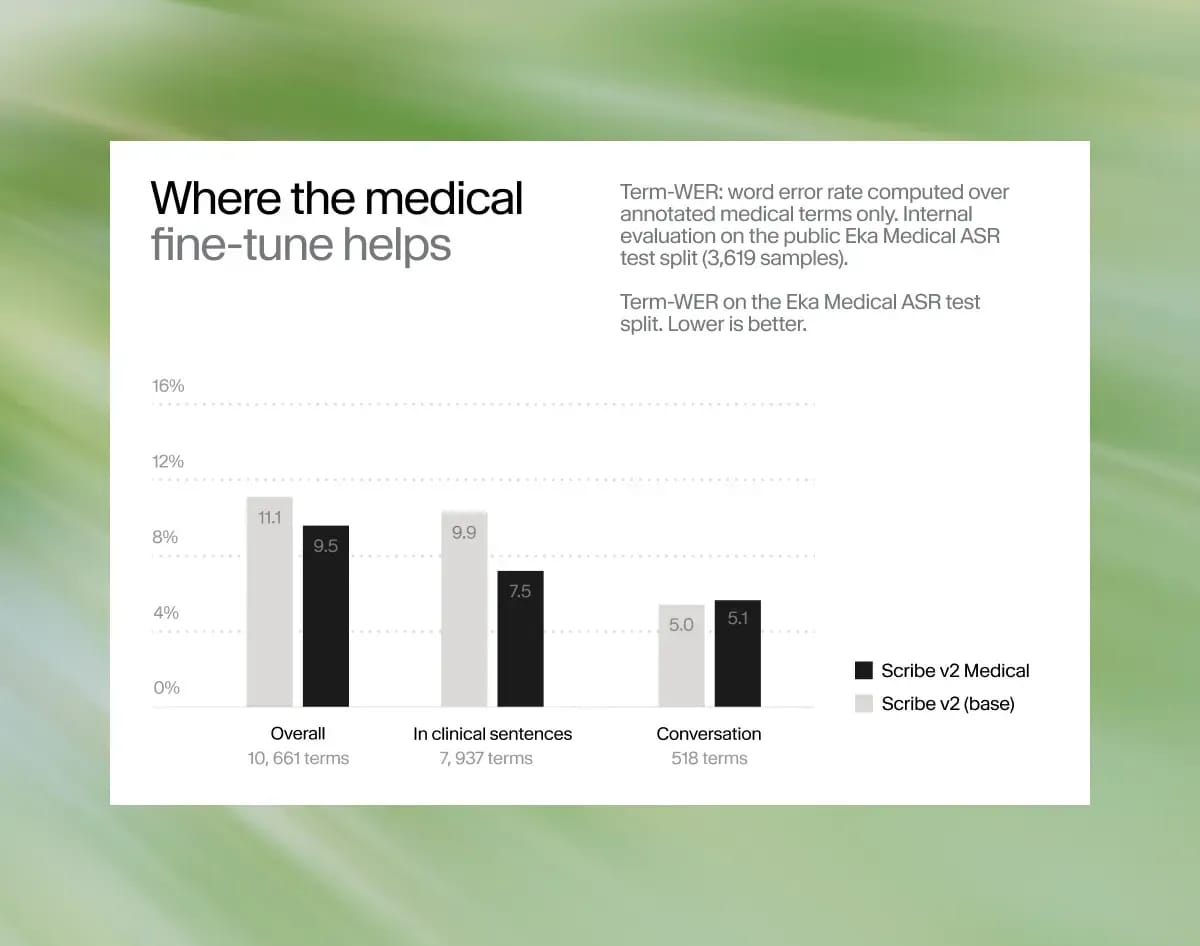
同じデータから得られる注意点として、単独の1語クリップ(周囲の文脈なしに薬剤名だけを発話したもの)は、Scribe v2 Medicalを含むリーダーボード上のすべてのモデルにとって依然として最も難しいケースです。単独の用語ではWERが14.3%だったのに対し、それらの用語が文中に現れる場合は7.5%でした。文脈がまったくないと、1音節の聞き間違いが印象的な失敗につながることがあります。
- etodolac(NSAID)→「It'll do the luck」
- levomilnacipran(抗うつ薬)→「Leave me alone now, Sephora.」
- methdilazine(抗ヒスタミン薬)→「Let's play our scene.」
こうした誤りを減らす方法の一つが、キータームプロンプティングです。薬剤名や医療フレーズを強調し、モデルがそれらを正しく文字起こしするよう誘導できます。
本番環境での導入事例
すでに多くのお客様が本番環境でScribe v2 Medicalを利用し、臨床オーディオの改善を実感しています。
「DeepgramからElevenLabs Scribe v2 Medicalに切り替えて以来、臨床用語の精度が大幅に向上し、チームの働き方が変わりました」と、CareCoのCEO兼創業者であるMendel Erlenwein氏は述べています。「コーディネーターが文字起こしを信頼できれば、ノートの修正にかける時間を減らし、患者との電話により多くの時間を使えます。患者は複雑な治療レジメンを受けているため、ケアチームが読むノートは正確でなければなりません。」
一般的な音声でも高いパフォーマンス
チームは、医療向けの微調整が他の領域のパフォーマンスを低下させないことも検証しました。Common Voice由来の日常的な非医療音声6,000サンプルでは、Scribe v2 Medicalは四捨五入後のスコアでベースのScribe v2と同等で、どちらもWERは5.3%でした。v2 Medicalなら、このベンチマークでの精度を損なうことなく、医療特化モデルの利点を得られます。
保護対象医療情報のために設計
Scribe v2 Medicalは、業務提携契約(BAA)を締結し、ゼロ保持モード(ZRM)を有効にしているエンタープライズのお客様向けにHIPAA対応可能です。
スピーチtoテキストAPIリクエストでZRMを有効にすると、オーディオ入力とテキスト出力は各リクエストの完了直後に削除されます。ElevenLabsはいずれも保持せず、アプリケーションは完全なAPIレスポンスを受け取り、文字起こしの保持方法を管理できます。
始めるには
Scribe v2 Medicalは、スピーチtoテキストAPIで利用できます。新しいモデルIDを渡すだけです:scribe_v2_medical
このモデルは、バッチスピーチtoテキストエンドポイントで動作します。