コンテンツクリエイター向けスピーチtoテキスト:キャプション作成と再利用のワークフローガイド
- 公開日
- 最終更新日
正確なスピーチtoテキストツールは、すべてのコンテンツクリエイターに欠かせないツールです。AI搭載のスピーチtoテキストを使えば、既存のオーディオから動画キャプション、ポッドキャストのショーノート、ブログ記事などを作成できます。コンテンツを複数のチャネルで再利用し、より幅広いオーディエンスに届けられます。
スピーチtoテキストは、忙しいコンテンツクリエイターにとって大幅な時間短縮にもなります。すべてのボイスオーバーやポッドキャストを手作業で文字起こしすると何時間もかかりますが、スピーチtoテキストモデルなら数分で完了するため、投稿スケジュールを維持できます。
この記事では、コンテンツクリエイター向けスピーチtoテキストの仕組み、効果的な理由、コンテンツ制作ワークフローへの取り入れ方を解説します。
概要
- コンテンツクリエイターは、スピーチtoテキストモデルを使って動画キャプションを生成し、ポッドキャストのショーノート(概要文)を作成し、オーディオコンテンツを書き起こした形式で再利用しています。
- AI搭載のスピーチtoテキストモデルは、SNSの自動キャプションよりも正確な文字起こしとフォーマットを提供します。
- スピーチtoテキストでポッドキャストを書き起こせば、ショーノートをすばやく作成したり、ブログやニュースレターとして再利用したりできます。
- キータームプロンプティングを使うと、名前や業界固有の用語を明確にし、より正確な文字起こしを作成できます。
- キャプションを翻訳するには、まず選択した言語で動画を吹き替え、そのオーディオをスピーチtoテキストで文字起こしします。
コンテンツクリエイターにとってのスピーチtoテキストの主な用途は?
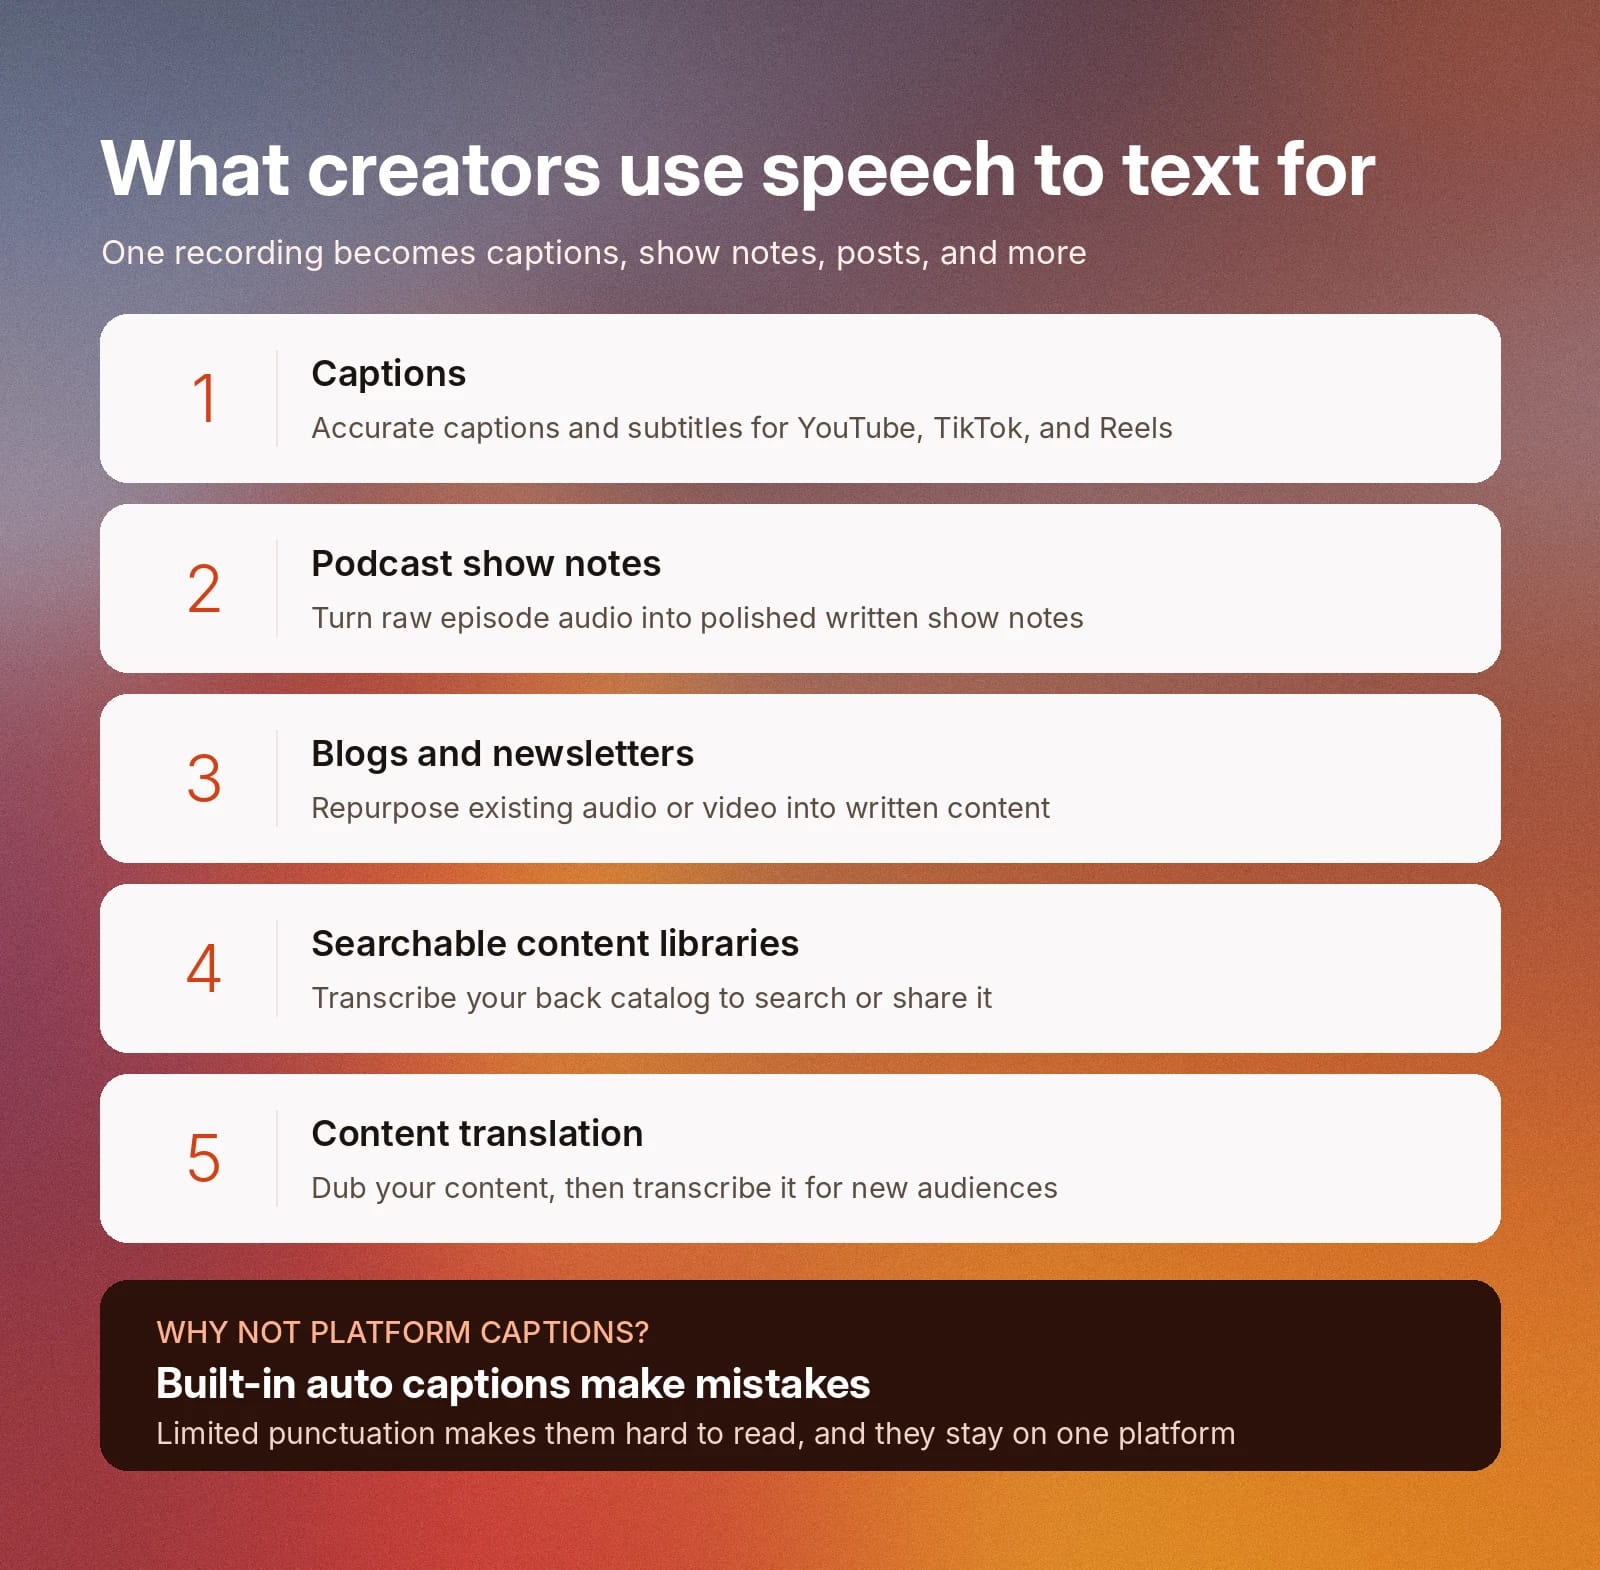
コンテンツクリエイターは、次のようなさまざまな作業にスピーチtoテキストを活用しています。
- キャプション:スピーチtoテキストは、YouTube、TikTok、Instagram Reelsなどのプラットフォーム向けに、短尺・長尺動画の正確な字幕(キャプションとサブタイトル)を生成します。
- ポッドキャストのショーノート:スピーチtoテキストは、エピソードの生オーディオを洗練された概要文へと変換するのに役立ちます。
- ブログとニュースレター:スピーチtoテキストを使えば、既存のオーディオやビデオコンテンツをブログ、ニュースレター、その他のテキストコンテンツに変換できます。
- 検索可能なコンテンツライブラリ:自動スピーチtoテキストツールは、既存のコンテンツライブラリを書き起こして検索可能にします。社内の整理に使うことも、オーディエンス向けの外部リソースライブラリを作成することもできます。
- コンテンツ翻訳:スピーチtoテキストは、世界中のオーディエンスに届けるために、コンテンツをさまざまな言語へ翻訳します。
多くのSNSプラットフォームには、動画コンテンツ用の自動キャプション生成機能があります。しかし、これらのツールは誤りが生じることがあり、句読点も限られるため、キャプションが読みにくくなります。
専用のスピーチtoテキストモデルを使うと、動画向けに読みやすく正確なキャプションを作成できます。文字起こしをダウンロードし、さまざまなプラットフォームで再利用することも可能です。
文字起こしをキャプションとサブタイトルに変換する
SNS動画にとって、もはや字幕やテロップは必須です。聴力にかかわらず、誰もが動画にアクセスできるようになります。また、視聴者は音声をオフにしたまま動画を視聴できます。
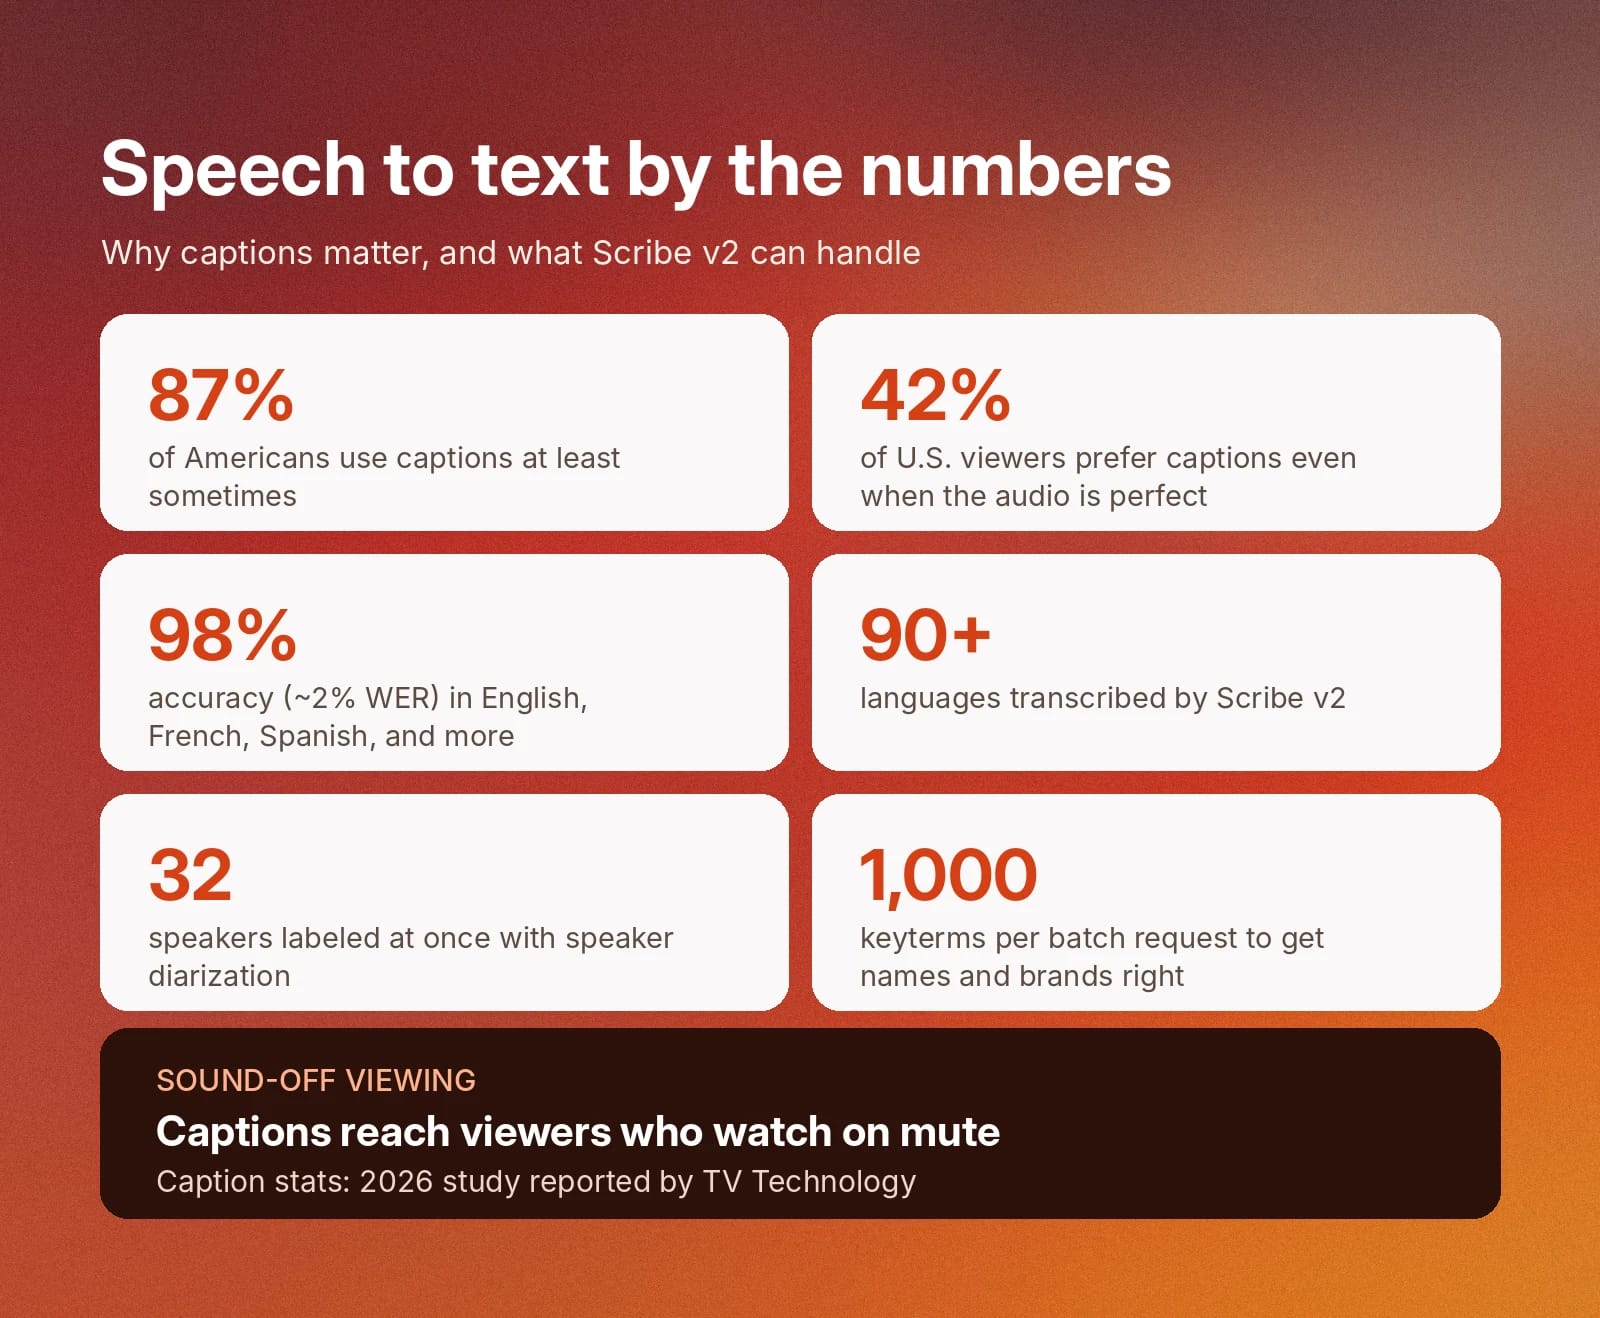
特に公共の場所にいるときや、すぐにヘッドホンを使えないときなど、多くのSNSユーザーにとって音声オフでの視聴が標準になっています。2026年の調査では、米国人の87%が動画視聴時に少なくとも時々キャプションを利用していることがわかりました。
実際、米国の視聴者の42%は、動画の音声がすでに完璧でもキャプションを好みます。すべての動画にキャプションを付けることで、コンテンツの魅力が大きく高まることがわかります。
スピーチtoテキストモデルは、キャプションとサブタイトルの生成に向けてSNS動画を書き起こします。ElevenLabs キャプションジェネレーターは、単語・文字レベルのタイムスタンプ付き文字起こしを作成するため、動画内の音声と同期します。元の動画をプラットフォームごとに短いクリップへ切り分けても、このタイムスタンプは保持されます。
キャプションはSRTおよびVTTファイルとして書き出せるため、SNSやお好みのビデオ編集プラットフォームに直接アップロードできます。ビデオを編集するときは、会話の流れに沿って読みやすくなるよう、改行を調整してください。
SRTとVTT:どちらのキャプションファイルをエクスポートすべき?
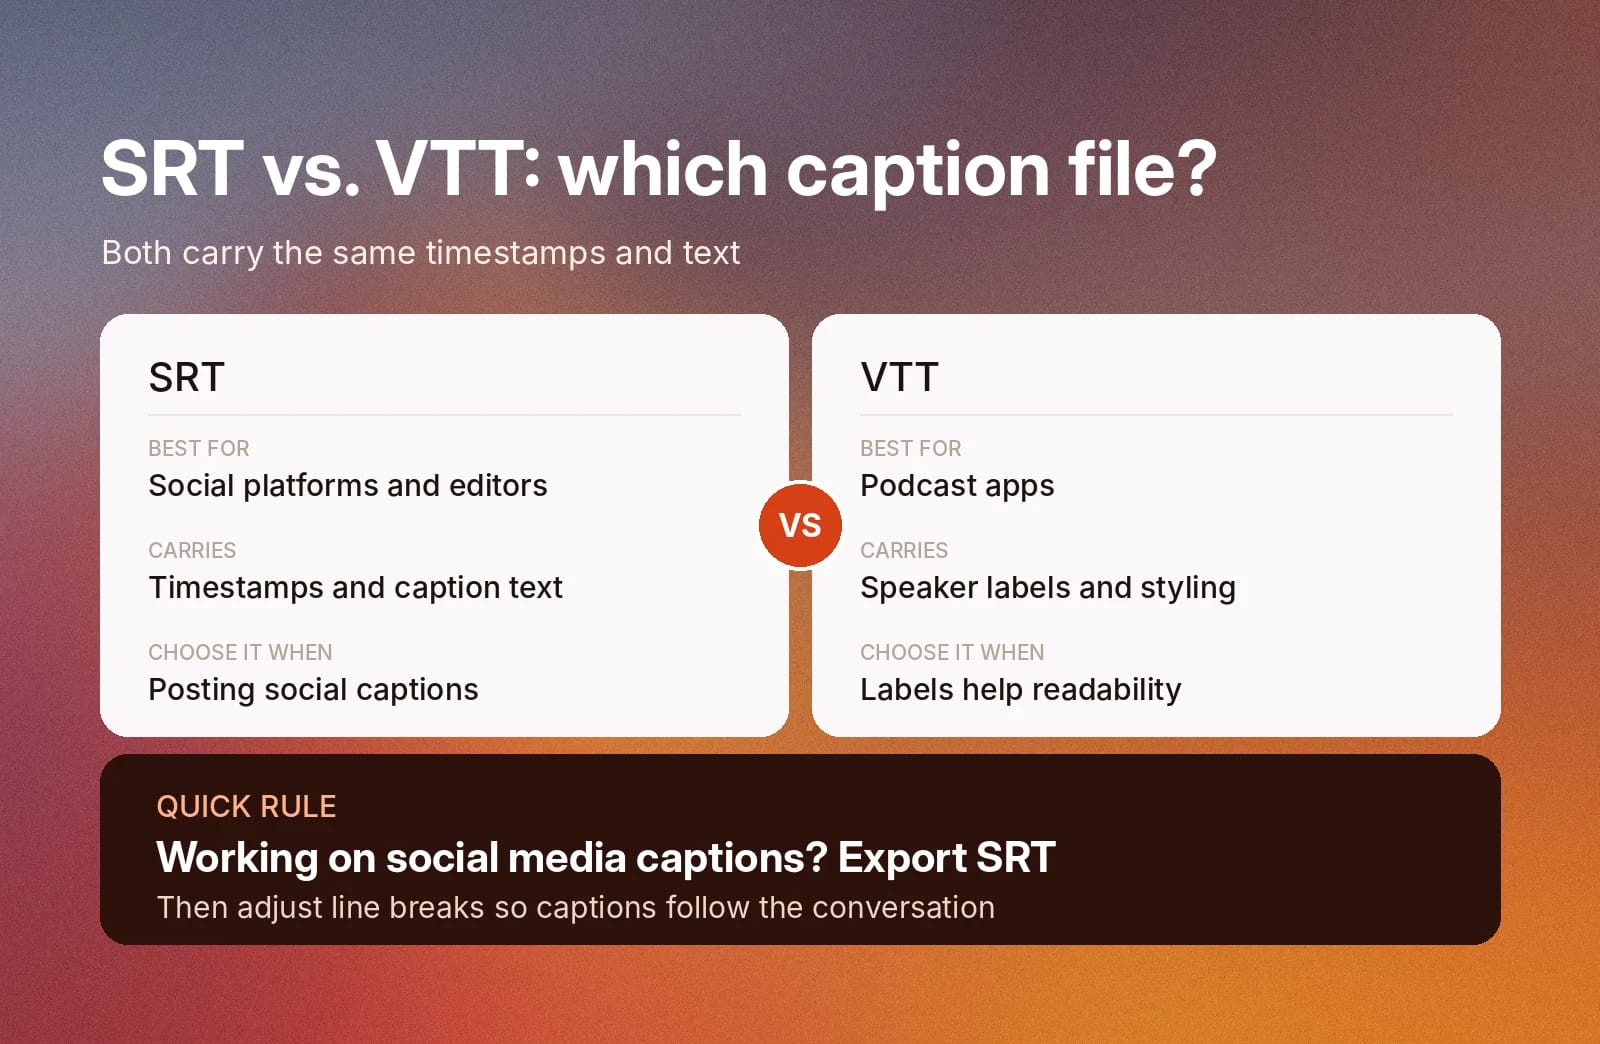
SRTとVTTには、どちらも同じタイムスタンプとテキストが含まれます。
それぞれを選ぶ目安は次のとおりです。
- 多くのSNSプラットフォームや動画編集ソフトウェアで使えるシンプルなファイルが必要な場合は、SRTをエクスポートします。
- ポッドキャストアプリにキャプションや文字起こしを公開する場合は、VTTをエクスポートします。話者ラベルや、読みやすさを高める基本的なスタイルを追加できます。
SNS向けキャプションを作成する場合は、SRTが適した選択肢です。
SNSキャプション向けのクリーン文字起こしと逐語文字起こし
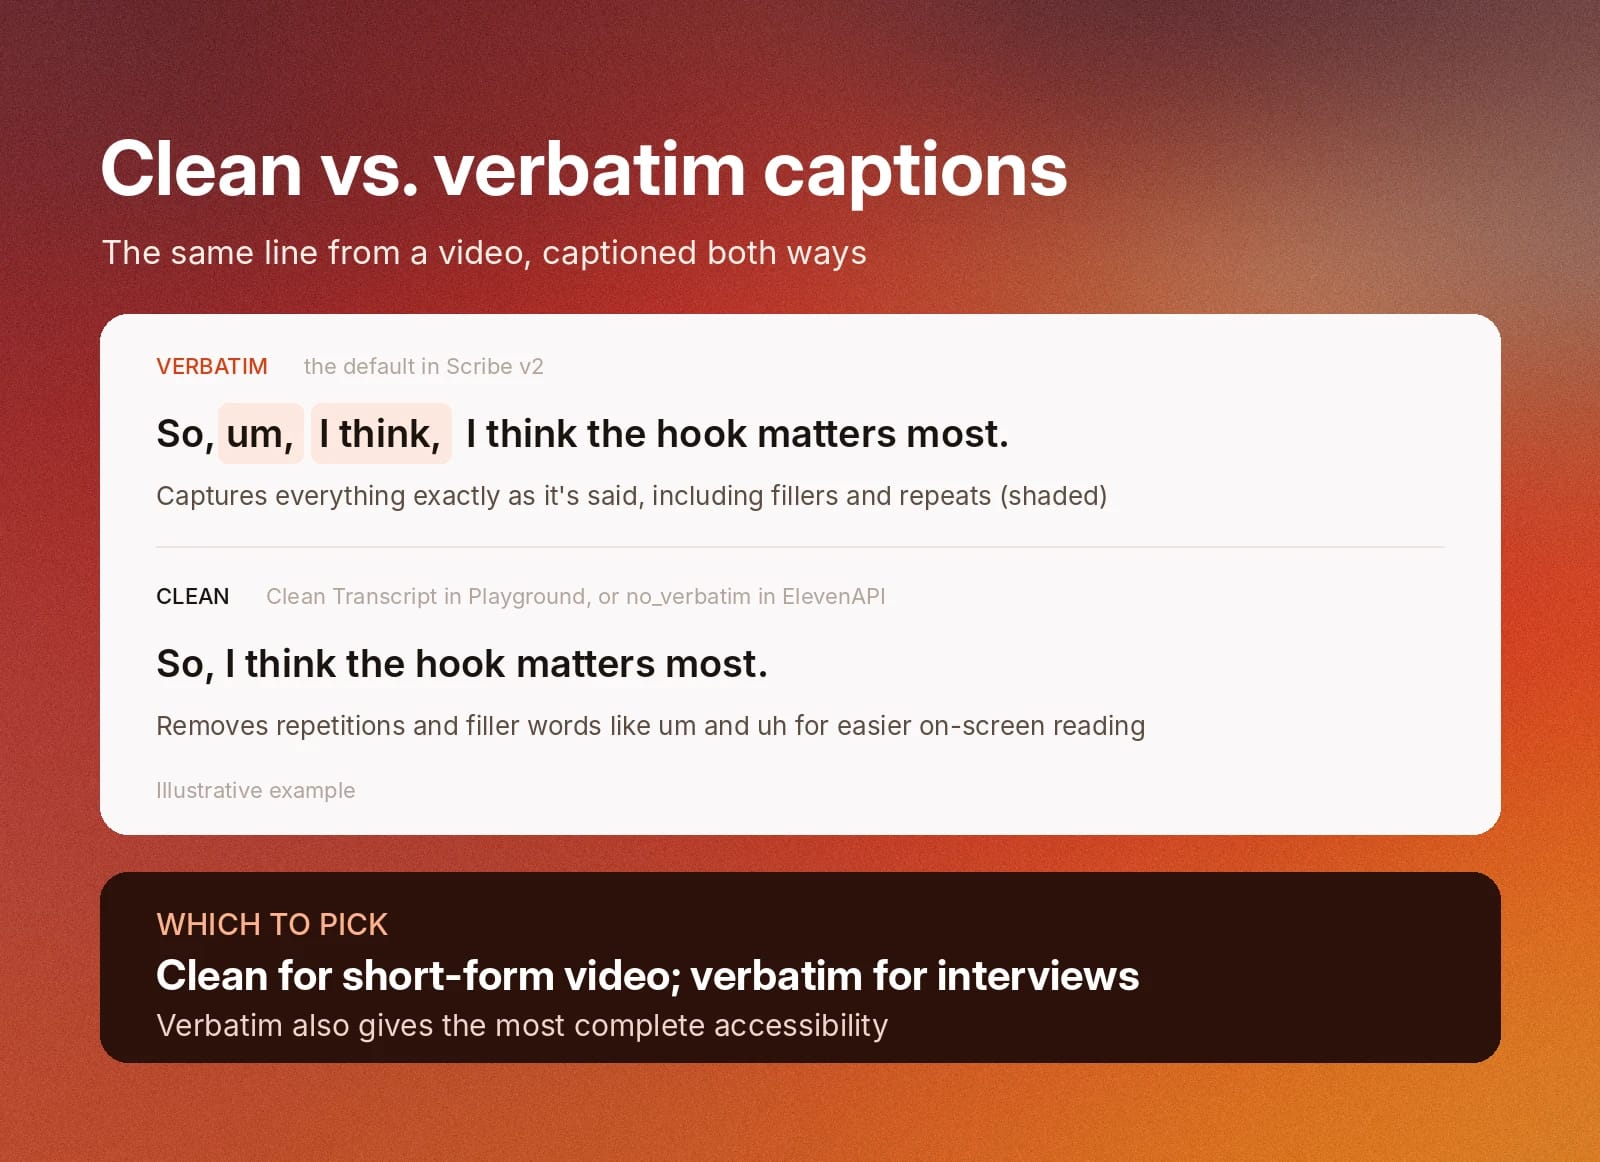
SNSキャプションを作成する際は、クリーン文字起こしと逐語文字起こしを選べます。クリーン文字起こしは繰り返しや「えー」「あの」といったフィラーワードを除去し、逐語文字起こしは発話をそのまますべて記録します。
クリーンキャプションは画面上で読みやすい一方、逐語キャプションは完全なアクセシビリティに適しています。どちらが適しているかは、オーディエンスとその固有のニーズによって異なります。
ElevenLabs Scribe v2モデルでは、デフォルトで逐語的に文字起こしします。ただし、ElevenLabs Playgroundで「Clean Transcript」をオンにするか、ElevenAPIでno_verbatimパラメーターを使用すると、読みやすく整えた文字起こしに切り替えられます。
短尺動画には、動画を流し見しながら内容を読む視聴者に適したクリーンを選びましょう。正確な表現が重要な長時間のインタビューや調査には、逐語文字起こしが最適です。
ポッドキャストを書き起こしてショーノート作成と再利用に活かす
ポッドキャストは、コンテンツ戦略全体の土台になります。より幅広いオーディエンスに届けるには、各エピソードで話したアイデアをショーノート(概要文)、ブログ、ニュースレター、短尺SNSコンテンツに変換しましょう。
スピーチtoテキストツールは、ポッドキャストのエピソードを簡単に再利用できるよう書き起こします。文字起こしの後、オーディエンスがいつでも参照できるショーノートに編集できます。
記事を一から書く代わりに、各文字起こしの一部をブログやニュースレターのコンテンツに変換することもできます。聞くより読むことを好むオーディエンスにも届けられます。
テキストコンテンツのライブラリは簡単に検索できます。オーディエンスが過去のエピソードのアイデアを振り返りたい場合も、ショーノートやブログを検索するだけです。テキストコンテンツはオーディオより検索結果に表示されやすく、オンラインでの認知度向上にも役立ちます。
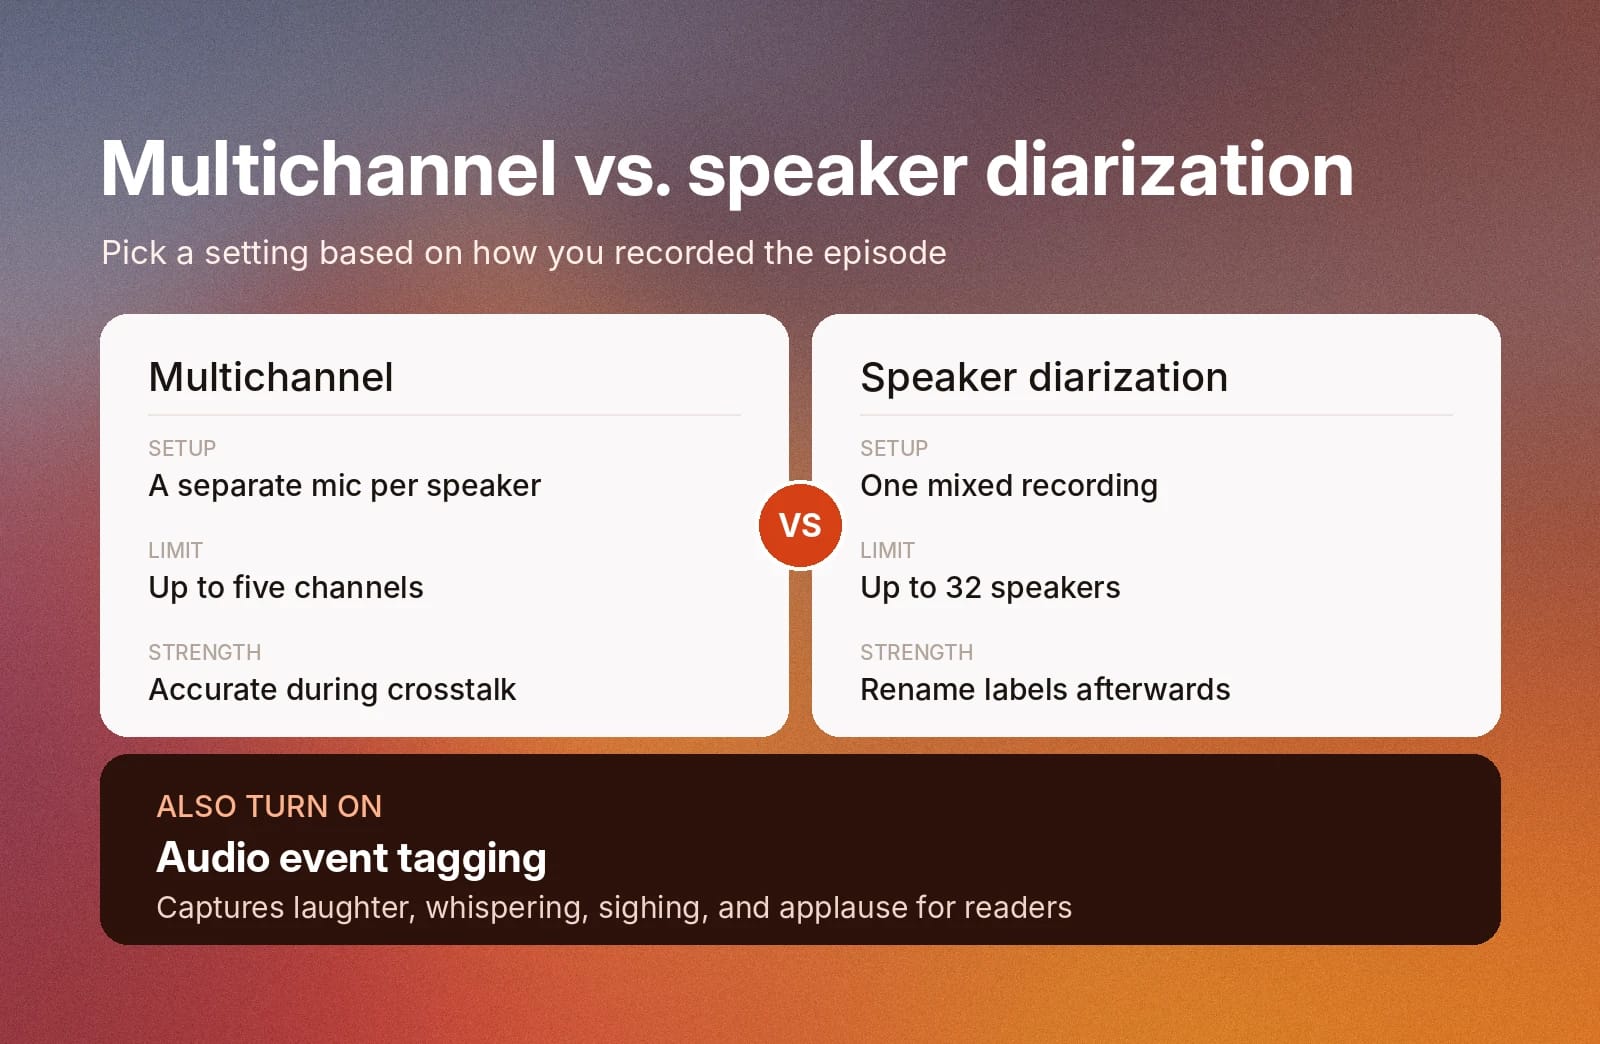
ポッドキャストを最も効率的に文字起こしするには、マルチチャンネル文字起こしを利用します。話者ごとに別のマイクを使用してください。文字起こしモデルが話者ごとに個別に書き起こすため、発話が重なっても正確な結果を得られます。
さらに、ポッドキャストを書き起こす際はオーディオイベントタグ付けをオンにしてください。この設定では、笑い声、ささやき声、ため息、拍手を記録するため、読者に文脈全体を伝えられます。ElevenLabs スピーチtoテキストでは、「Tag Audio Events」をオンにするか、ElevenAPIでtag_audio_eventsパラメータを使用します。
1つの録音で話者を識別する
マルチチャンネル文字起こしは、最大5チャンネルに対応しています。すべての音声を1つのミックストラックに録音する場合や、話者の数がチャンネル数を上回る場合は、代わりに話者ダイアライゼーションをオンにしてください。Scribe v2は文字起こしで各話者にラベルを付け、一度に最大32人の話者に対応します。文字起こし後は、ElevenLabsダッシュボードで話者ラベルの横にある編集ボタンをクリックすると、話者名を変更できます。
録音をクリップ、ブログ、ニュースレターに再利用する
インタビューを書き起こすのは一度だけで、公開するすべてのチャネルで再利用できます。
同じ文字起こしから、キャプションとクリップ、テキストコンテンツの素材を得られます。ElevenLabs STTは、ポッドキャストからテキストコンテンツへの制作プロセスを加速するため、世界中のクリエイターや企業に利用されています。
私が手がけるすべてのポッドキャスト、基調講演、インタビューはスピーチtoテキストにかけています。1つの文字起こしから、全体の正確なキャプション、短い動画に切り出すべき最高の場面、テキストコンテンツに変える重要な引用を得られます。
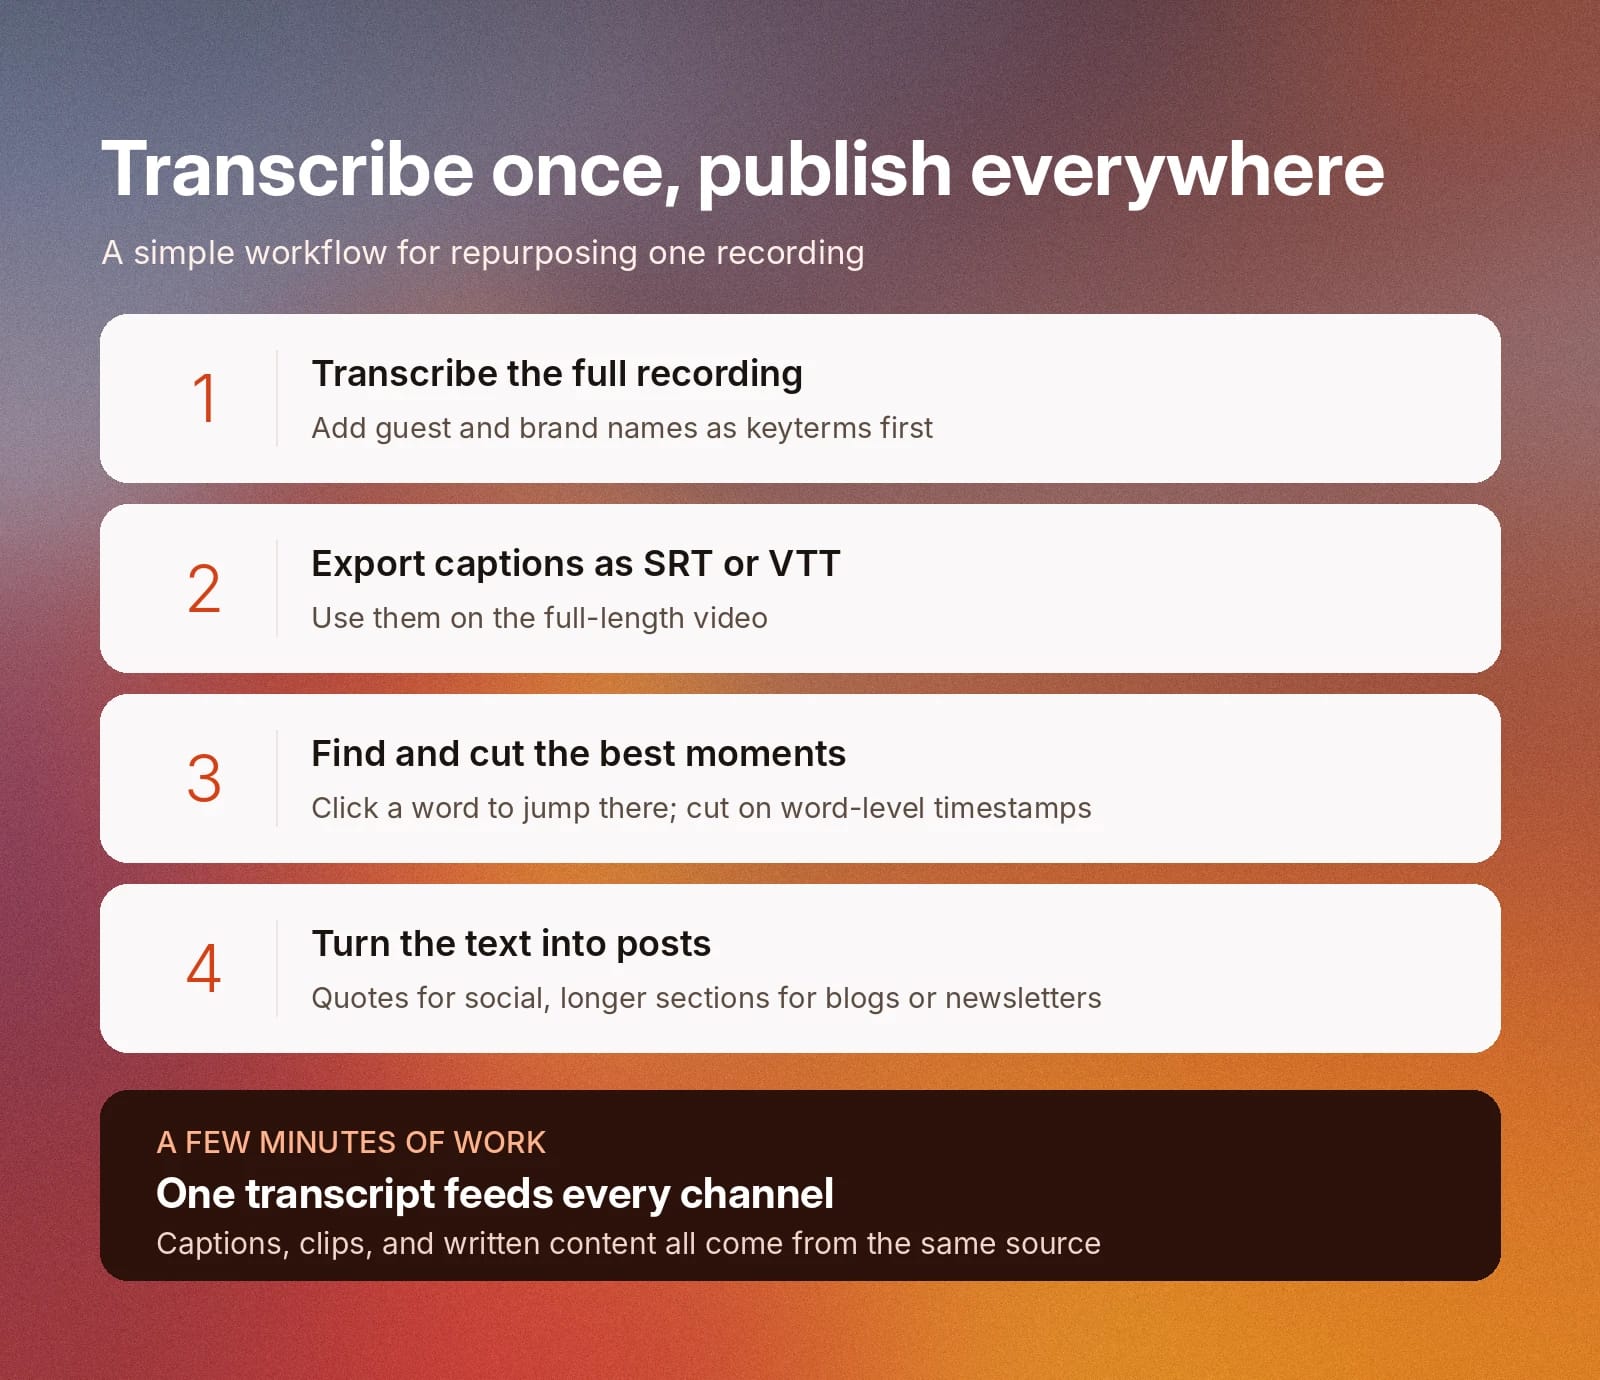
使えるシンプルな再利用ワークフローは次のとおりです。
- 録音全体を書き起こし、ゲスト名とブランド名を発音辞書に追加します。
- キャプションをSRTまたはVTTでエクスポートし、フル動画で使用します。
- 文字起こしを読み、最も強い場面を探します。文字起こし内の単語をクリックしてオーディオの該当箇所へ移動し、単語レベルのタイムスタンプを使って各クリップを正確な開始・終了位置で切り出します。
- 重要な引用をSNS投稿にコピーし、より長いセクションはブログ記事やニュースレターに編集します。
STTによるポッドキャスト文字起こしから長尺コンテンツを作るのに、数分しかかかりません。
動画をLLM分析用の文字起こしに変換する
動画をテキストに変換した後、コンテンツをLLMへ一括アップロードして分析できます。新しいアイデアの発見、再利用に使える論点の抽出、コンテンツの何が機能しているかの把握に役立ちます。
私が作るものはすべて声から始まりますが、AIツールの多くは今でもテキストで最もよく機能します。ElevenLabs Scribeは私の翻訳レイヤーです。動画を文字起こしに変換するので、どのLLMでも何が機能しているか、何が機能していないかを分析できます。これはAIにおける最大級の隔たりの1つを埋めるものだと思います。
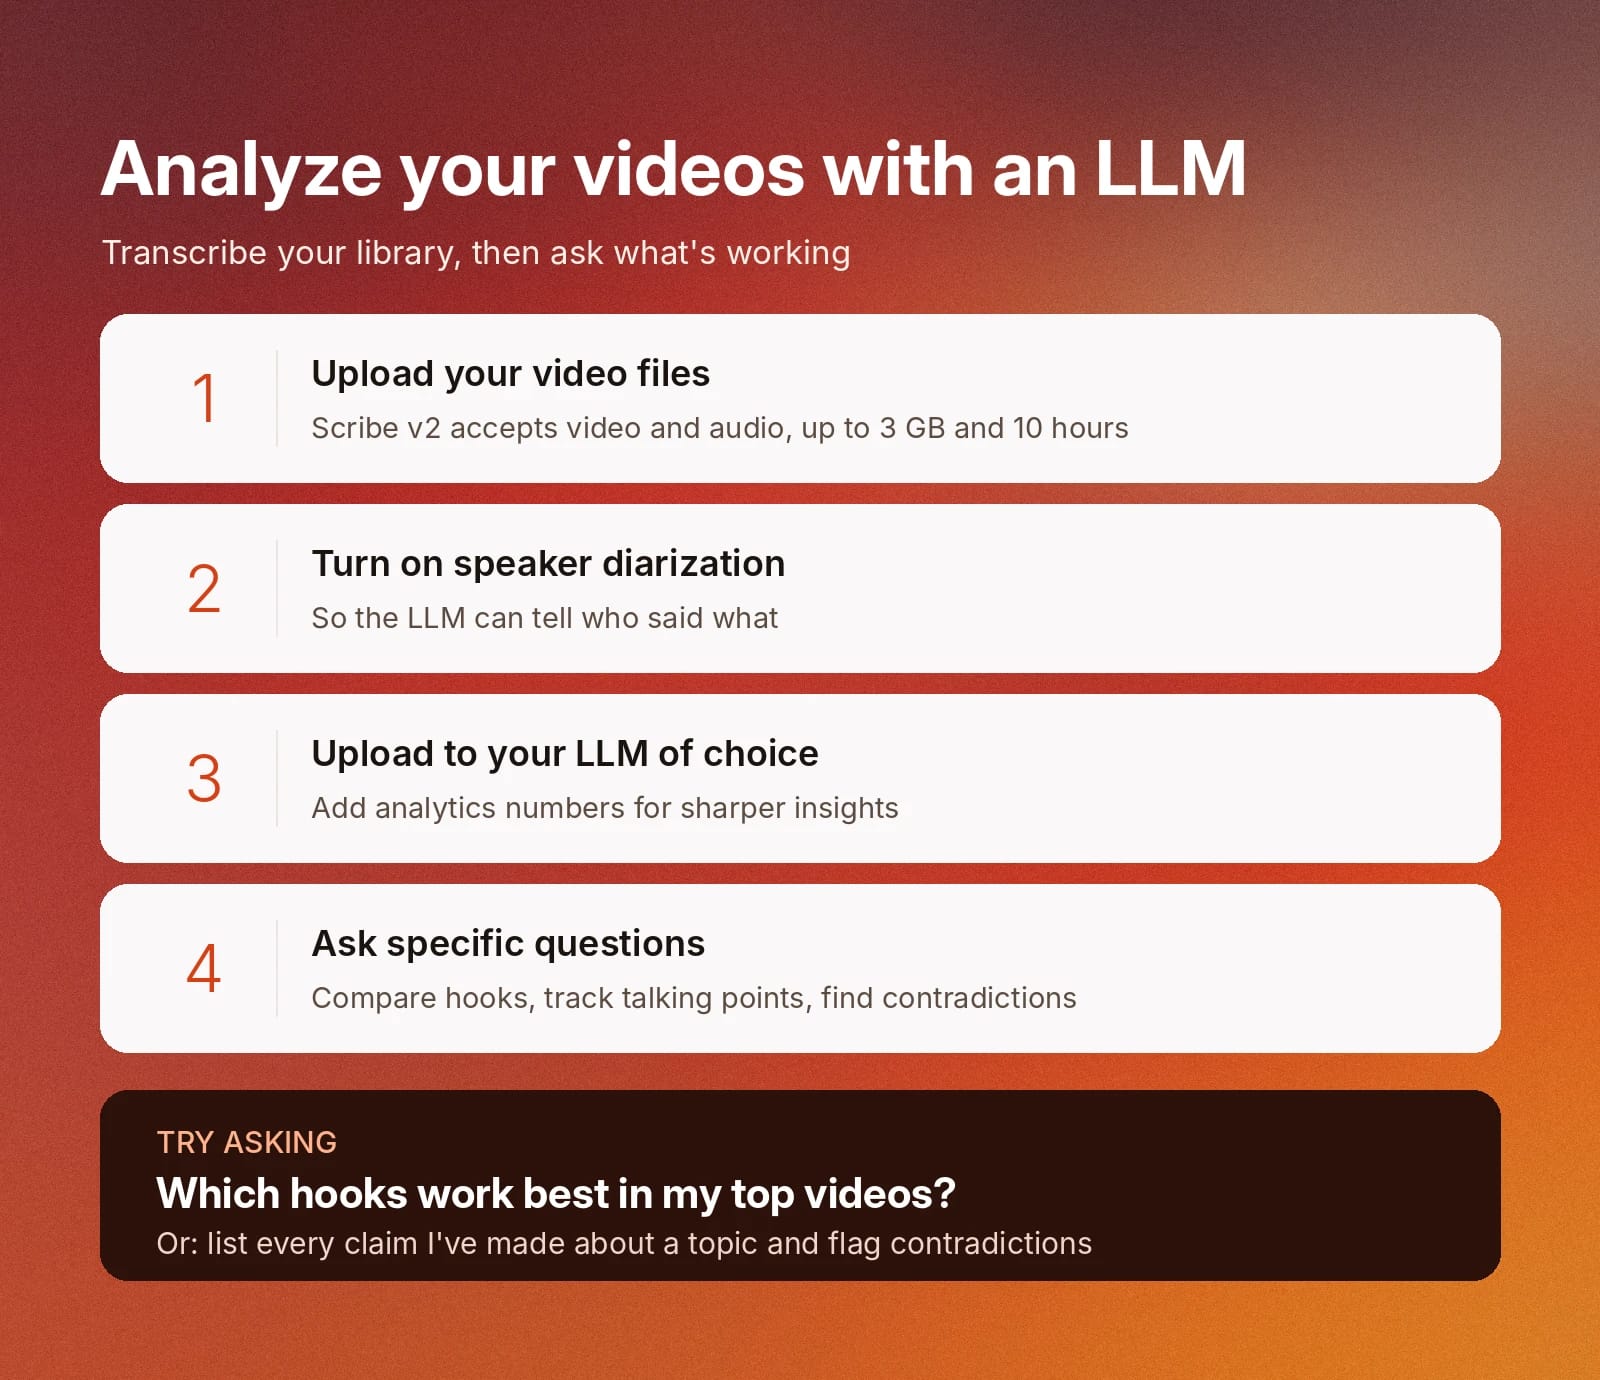
同様のワークフローを設定する方法は次のとおりです。
- 文字起こし用に動画ファイルをアップロード:ElevenLabs STTはオーディオだけでなく動画にも対応し、最大3GB・最長10時間のファイルを受け付けます。
- 話者ダイアライゼーションをオンにする:複数人が話す場合は、誰が何を言ったかをLLMが判別できるよう、ダイアライゼーションを有効にします。
- 選択したLLMにアップロード:分析データや追加情報を加えると、得られるインサイトの質が向上します。
- コンテンツについて具体的に質問する:「最も成果の高い動画の最初の20秒を比較し、オーディエンスに最も効果的なフックを確認して」や、「Xのトピックについて私が行った主張をすべて列挙し、矛盾があれば指摘して」と尋ねると、新たなインサイトを発見できます。
プロンプトとメモを音声入力する
音声入力では、すべてを入力するなら省いてしまうかもしれない背景やニュアンスをAIツールに伝えられます。スピーチtoテキストは、話した内容をプロンプト、ブリーフ、メモにそのまま貼り付けられるテキストへ変換します。すべてを入力する代わりに音声を書き起こし、より速く書くためにSTTを使い始めるライターもいます。
特にプロンプト作成では、これなしで働くことは考えられません。AIとのやり取りには毎回多くのニュアンスが必要で、それをすべて入力する気にはなれません。
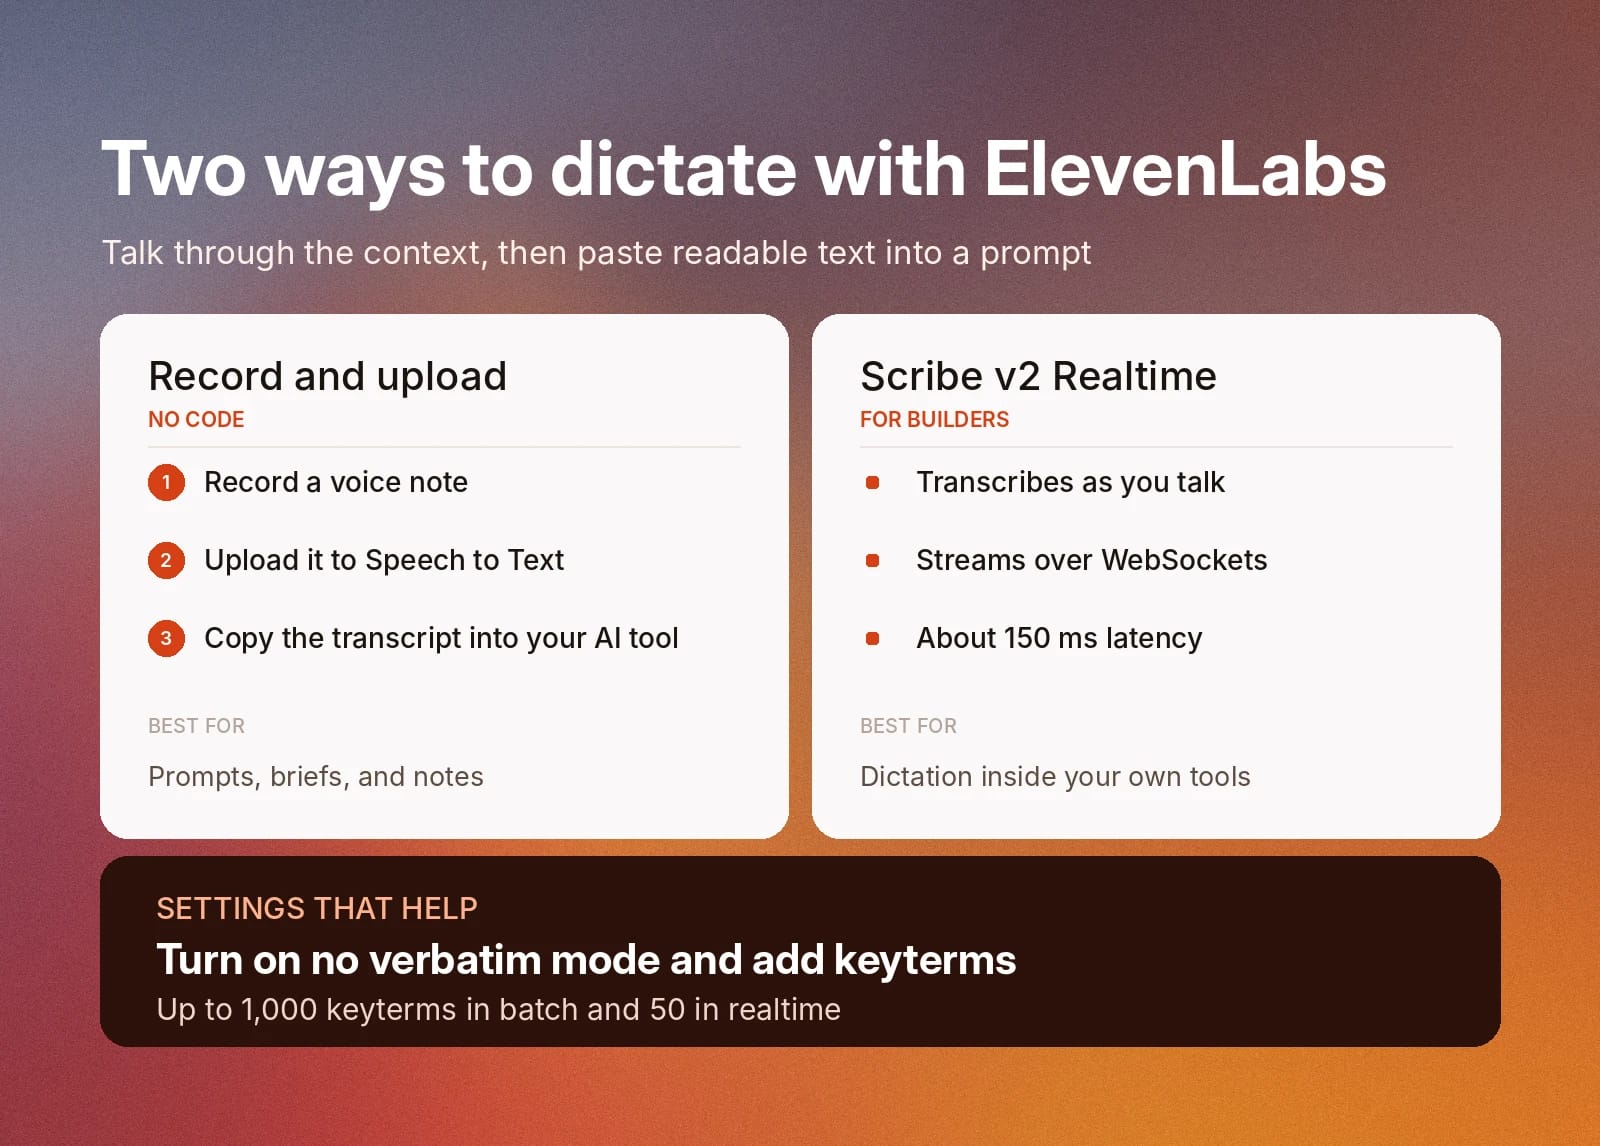
ElevenLabsで音声入力する方法は2つあります。
- 録音してアップロード:ボイスメモを録音し、ElevenLabs スピーチtoテキストページへアップロードして、文字起こしをAIツールへコピーします。
- リアルタイムでストリーミング:独自のツールを開発している場合は、Scribe v2 Realtimeを使うと、WebSocket経由で話した内容をリアルタイムに文字起こしできます。ドキュメントによると、レイテンシーは約150ミリ秒です。
フィラーワード、言い直し、流暢でない発話を除去するno verbatimモードを必ずオンにし、まとまりのないボイスメモも読みやすいテキストにしましょう。続けて、よく使うプロダクト名や専門用語をキータームプロンプティングに追加すると、毎回正確に書き起こせます。バッチ文字起こしは最大1,000個、リアルタイムは最大50個のキータームに対応します。
STTで名前、ブランド、ニッチな用語を正確に扱う
スピーチtoテキストモデルは、話者名、ブランド名、業界固有の用語を常に認識できるとは限りません。コンテンツを書き起こす際は、キータームプロンプティングを使ってスペルと表記を明確にしてください。
キータームプロンプティングでは、文字起こし開始前に名前やニッチな用語の正しいスペルを指定できます。動画やポッドキャストのエピソードごとに、頻繁に言及するゲスト、チャネル、ブランドの名前を追加します。業界用語やその他のニッチな用語も追加が必要な場合があります。
キータームプロンプティングにより、文字起こしの精度とオーディエンスにとっての読みやすさが向上します。これらの用語を手作業で修正する必要がなくなるため、編集も速くなります。
他の言語のオーディエンスに届ける
スピーチtoテキストモデルは、文字起こしにとどまりません。コンテンツクリエイターは、コンテンツをローカライズして他言語を話すオーディエンスに届けるためにも活用できます。
ElevenLabs Scribe v2は90以上の言語でコンテンツを書き起こします。ElevenLabs ダビングスタジオと組み合わせれば、完全なローカリゼーションワークフローを構築できます。
まず、オーディオをダビングスタジオにアップロードし、希望する言語でコンテンツを吹き替えます。その後、吹き替えたオーディオを書き起こして、ローカライズされたキャプション、ショーノート、その他のテキストコンテンツを作成します。
スピーチtoテキストでできないこと
スピーチtoテキストは強力なツールですが、限界もあります。スピーチtoテキストモデルは正確なタイムスタンプ付きでオーディオを書き起こしますが、動画編集ツールではありません。最終成果物の作成には別の動画編集プラットフォームが必要です。
コンテンツを作成する際は、まずスピーチtoテキストでオーディオを書き起こします。次に、生の文字起こしとキャプションの両方をエクスポートし、コンテンツ全体で活用します。キャプションは動画エディターまたはSNSへ直接アップロードし、文字起こしはショーノート、ブログ記事、その他のテキスト素材の基礎として使います。
公開前には、すべての文字起こしを必ず確認してください。特に名前や、話者が同時に話している箇所は重要です。Transcript Editorを使えば、アプリ内で簡単に誤りを修正できます。
コンテンツクリエイターが最適なスピーチtoテキストツールを選ぶ方法
適切なSTTツールは、録音を正しいスペルの読みやすいテキストとタイムスタンプに変換し、コンテンツの再利用をできる限り簡単にします。
最適なスピーチtoテキストプラットフォームを探す際は、次の5点を確認してください。
- 使用言語での精度:STTの性能は言語間で異なることがあり、特に利用可能なデータが少ない言語で顕著です。公開されている精度指標を確認しましょう。たとえば、ElevenLabs Scribe v2の精度は98%(WER約2%WER)で、英語、フランス語、イタリア語、スペイン語などに対応しています。
- 名前と業界用語の処理:STTモデルは会話の文脈を理解し、正確に書き起こせる必要があります。キータームプロンプティングと発音辞書を提供するSTTプラットフォームを探しましょう。
- タイムスタンプとエクスポート形式:単語レベルのタイムスタンプと、SRTまたはVTTキャプションをエクスポートできる機能が必要です。
- 話者の処理:特に複数の話者を含むオーディオを扱う場合は、それぞれの音声を正確に識別することで文字起こしを明確に保てます。
- ファイル上限:ポッドキャストのような大規模なオーディオ・動画プロジェクトでは、ファイルサイズも大きくなります。ElevenLabsは最大3GB、標準モードでは最長10時間のファイルに対応しています。
Eleven Scribe v2のような専用STTモデルと、SNSプラットフォームに組み込まれた自動キャプションツールを比較すると、次のようになります。
必要なこと
プラットフォームの自動キャプション
Scribe v2のような専用モデル
名前とブランドの正しいスペル
誤りが生じる可能性
キータームプロンプティング、バッチリクエストごとに最大1,000語
読みやすい句読点
制限されていることが多い
no verbatimモードによるクリーンな出力
テキストの他用途での再利用
キャプションはプラットフォーム内に残る
文字起こしとキャプションをダウンロードしてどこでも使用可能
タイミング
そのプラットフォームのプレーヤーに紐付く
クリップにも引き継げる単語レベルのタイムスタンプ
言語
プラットフォームにより異なる
90以上の言語
開始方法は2つ:ノーコードでアップロード、またはAPI
ElevenLabsでは、スピーチtoテキストを使って動画コンテンツを書き起こす方法が2つあります。
1つ目は、オーディオファイルをElevenLabs Playgroundダッシュボードへアップロードする方法です。文字起こし設定を調整し、Transcript Editorで出力を直接編集して、必要なファイル形式でエクスポートします。手順はすばやく簡単で、コーディングは必要ありません。
独自のコンテンツ公開ワークフローを構築している場合は、ElevenAPI。すでに構築しているツールへAPIを直接追加すれば、ツールを切り替えずに同じ正確な文字起こしを得られます。
ElevenLabsに登録して、今すぐSTTを始めましょう。または、詳細を見るで、クリエイター向けスピーチtoテキストが業界をどう変えているかをご確認ください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。