
JavaScript音声認識チュートリアル:音声UXを構築
- 公開日
- 最終更新日
Web Speech APIのようなブラウザネイティブのスピーチtoテキスト(STT)APIにより、Webサイトやブラウザベースのアプリに音声認識を導入することが簡単になりました。デベロッパーは、ローカルの自動音声認識サーバーを構築しなくても、API呼び出しでマイク入力をストリーミングし、オーディオデータを分析して文字起こしを処理できます。
Web Speech APIは、JavaScriptで音声コマンドを実装する際によく使われる音声認識APIです。Webブラウザでリアルタイム文字起こしを実行するためのメソッド、引数、プロパティを提供します。ただし、複雑なWebクライアントでは、Web Speech APIの機能に制約を感じる場合があります。
このガイドでは、Web Speech APIを使ったシンプルなJavaScript音声認識Webアプリのセットアップ、その制約、より堅牢なリアルタイム文字起こしクライアントを構築するための代替手段を解説します。
概要
- Web Speech APIは、マイクのオーディオをバックエンドのクラウドサービスへ送信して処理する、ブラウザネイティブのスピーチtoテキストAPIです。
- デベロッパーはSpeechRecognition APIクラスを使用して、JavaScriptの音声コマンドアプリケーションを構築します。
- 音声認識アプリを構築する際は、オーディオ録音中であることを示し、ユーザーのプライバシーに配慮しましょう。
- Web Speech APIには、文字起こしの一貫性のなさ、ブラウザ依存、意図理解の不足など、いくつかの制約があります。
- ElevenLabsは、クライアント側とサーバー側のストリーミングの両方に対応する、高精度でプロダクション品質のスピーチtoテキストAPIを提供しています。
Web Speech APIの仕組み
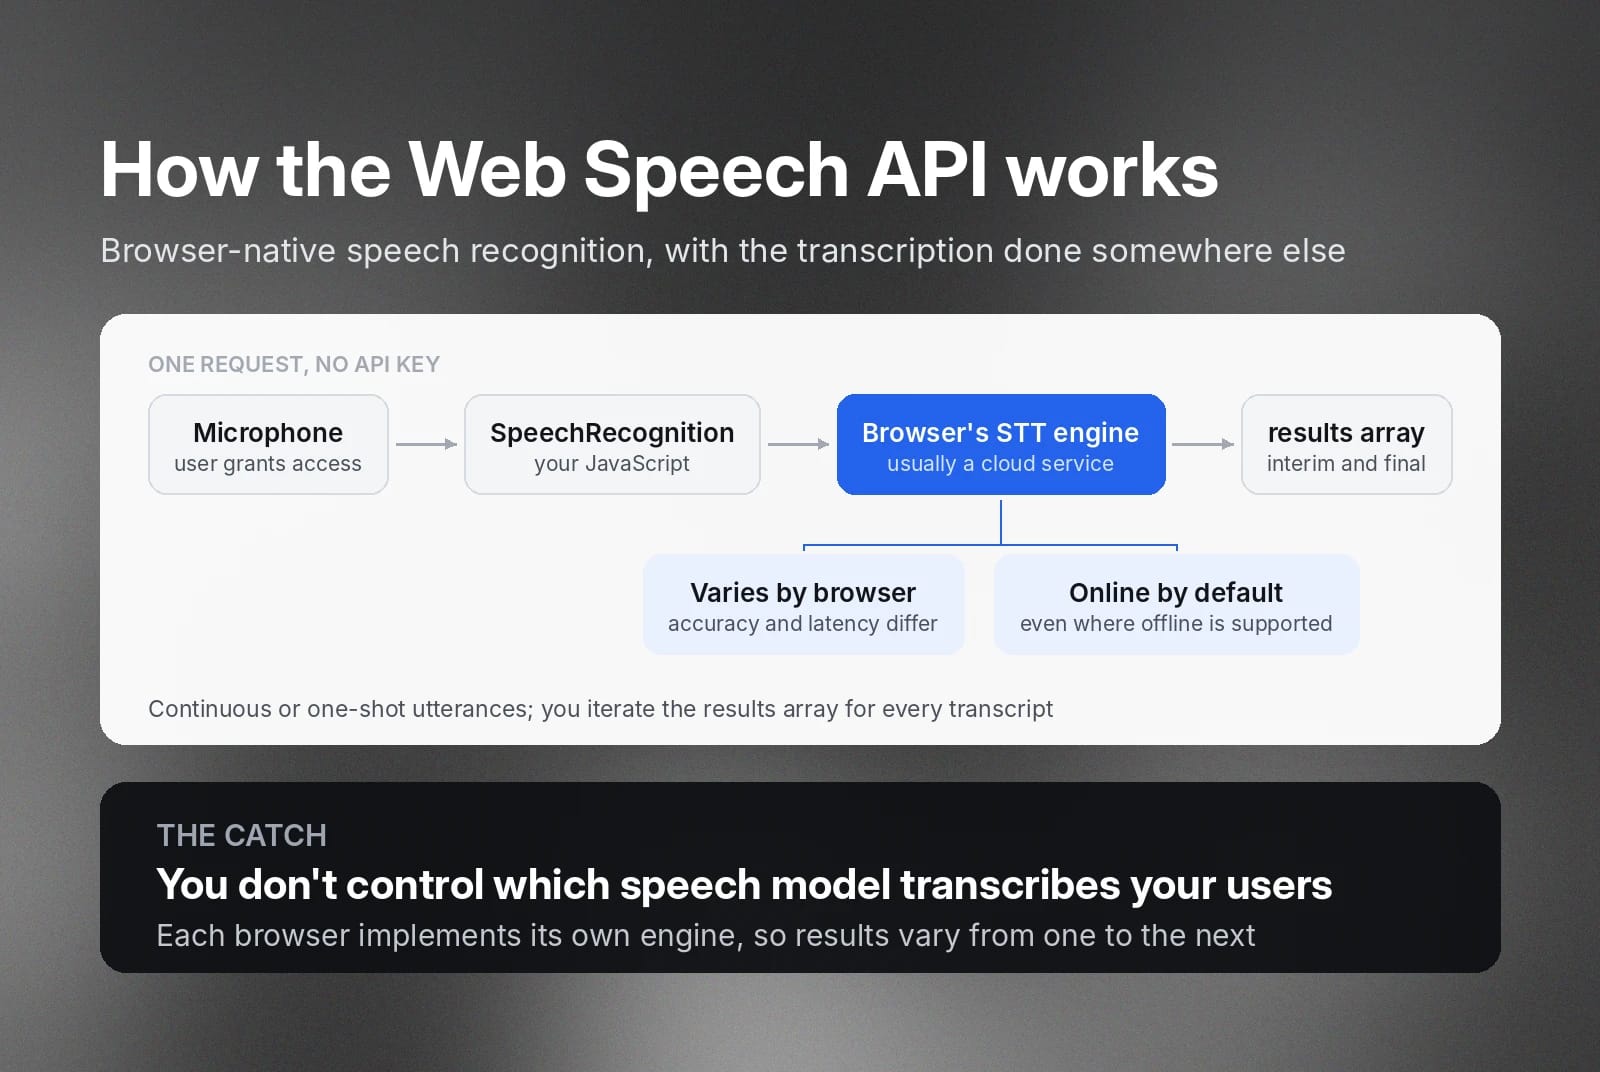
Web Speech APIは、ローカルサーバーなしでブラウザネイティブの音声認識をWebデベロッパーに提供します。基本的には、Webブラウザからバックエンドのクラウドサービスへオーディオストリームを送信し、処理、分析、文字起こしへの変換を行います。文字起こしはブラウザのバックエンドエンジンに依存するため、ブラウザごとに結果が異なります。
一般に、Web Speech APIでオーディオストリームを文字起こしするには、特にChromeやSafari向けに構築する場合、アクティブなオンライン接続が必要です。ただし、現在では一部のブラウザがオフライン文字起こしに対応しています。オフライン文字起こしでは、ブラウザがスピーチtoテキストエンジンとして機能し、音素を識別して自然なテキストに変換します。
使用するブラウザにかかわらず、APIの基本は同じです。
- APIリクエストにAPIキーは必要ありません。
- Web Speech APIは、連続発話と単発発話に対応しています。
- 中間文字起こしと確定文字起こしの両方を返します。
ただし、ブラウザごとにSTTエンジンの実装が異なる場合があるため、精度とレイテンシーは変動する可能性があります。
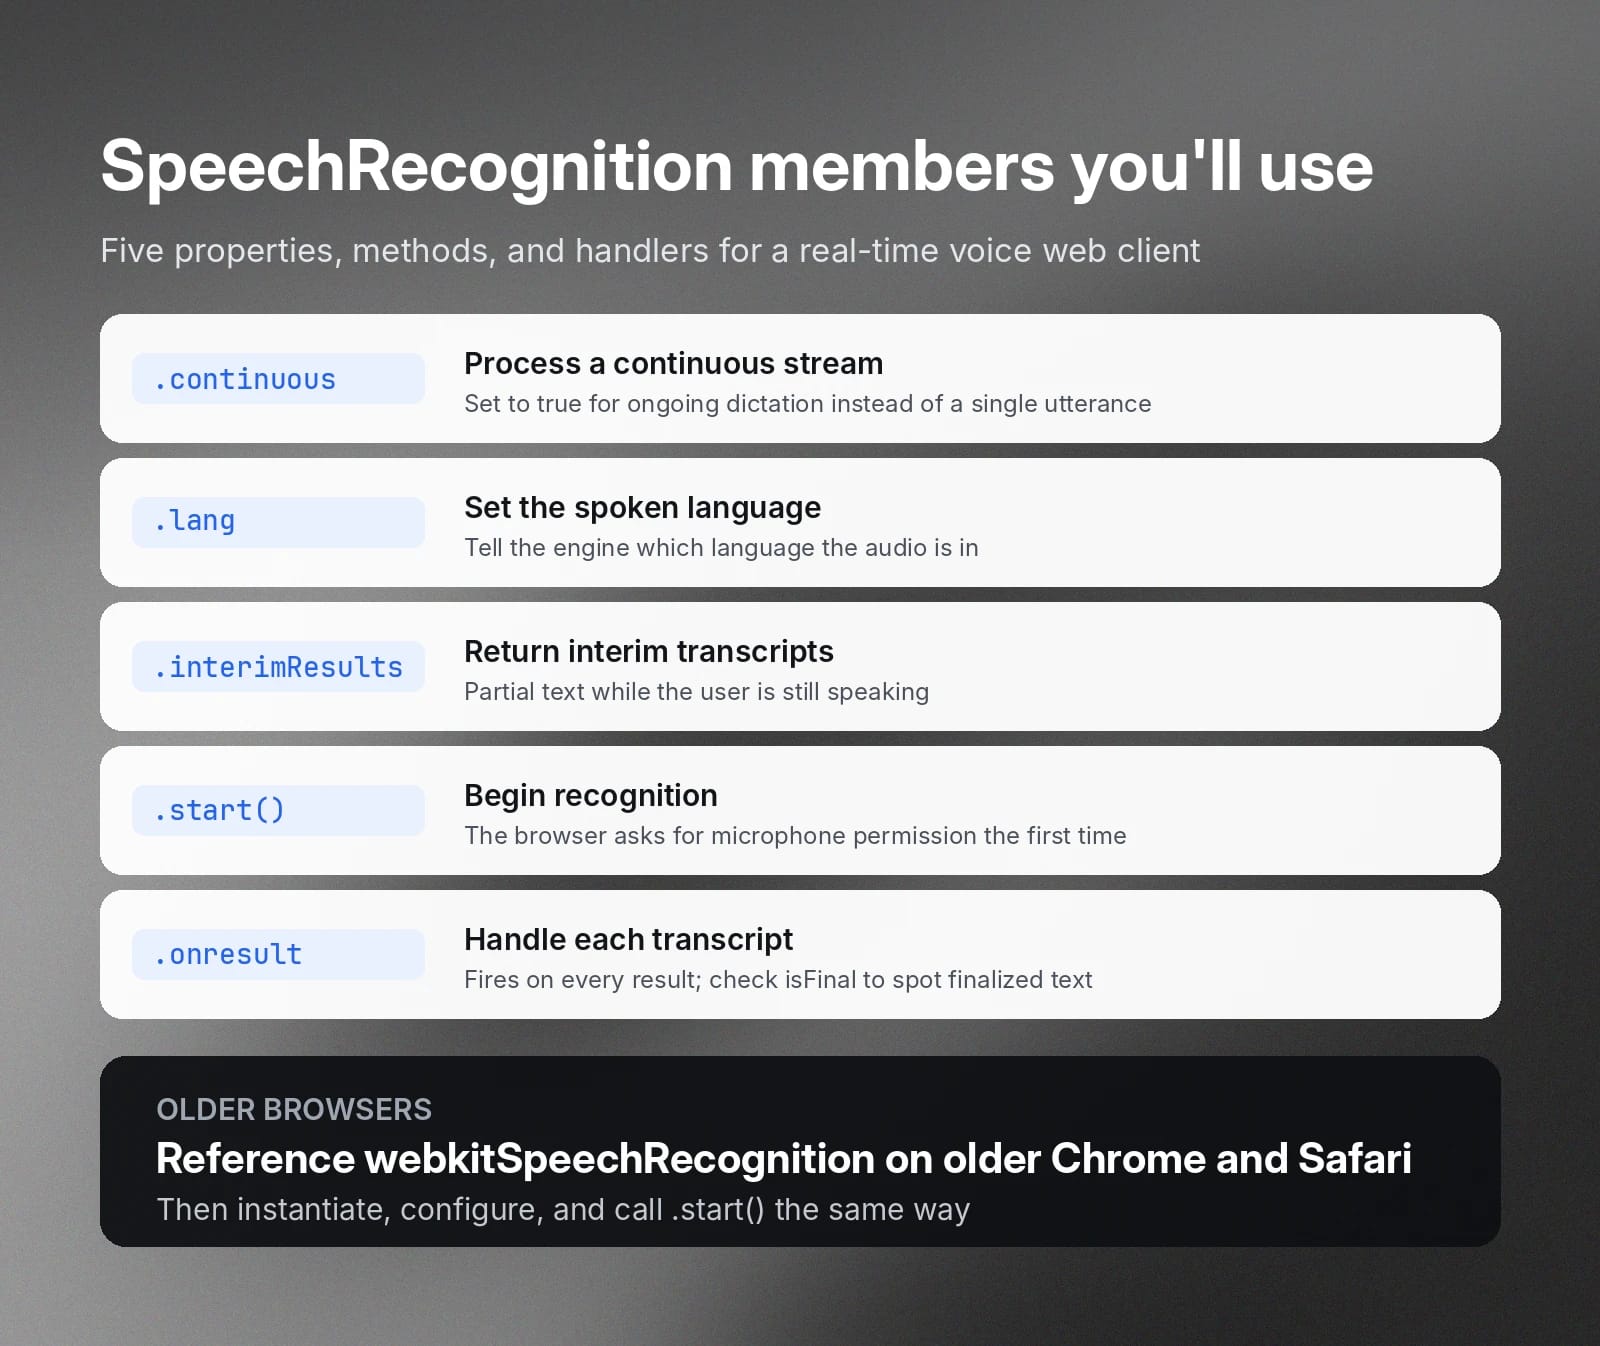
Web Speech APIを使用するには、JavaScriptコードでSpeechRecognitionインターフェースを初期化します。その後、コーディング中にメソッド、属性、イベントハンドラーへアクセスします。以下は、音声検索Webクライアントの構築で使用する項目です。
- SpeechRecognition.continuous: 音声エンジンが、値をtrueに設定した場合に連続ストリームを処理できるようにします。
- SpeechRecognition.lang: オーディオの言語を設定します。
- SpeechRecognition.interimResults: エンジンに中間文字起こしを返すよう指示します。
- SpeechRecognition.start():音声認識プロセスを開始します。
- SpeechRecognition.onresult: 文字起こし完了時にAPIがトリガーするイベントハンドラーを受け取ります。
Web Speech APIは、文字起こしを文字列配列で返します。STTエンジンが中間か確定かを問わず文字起こしを返すと、results配列で確認できます。1つ以上の文字列が返されることがあります。そのため、すべての文字起こしテキストを取得するには、結果の文字列を反復処理する必要があります。
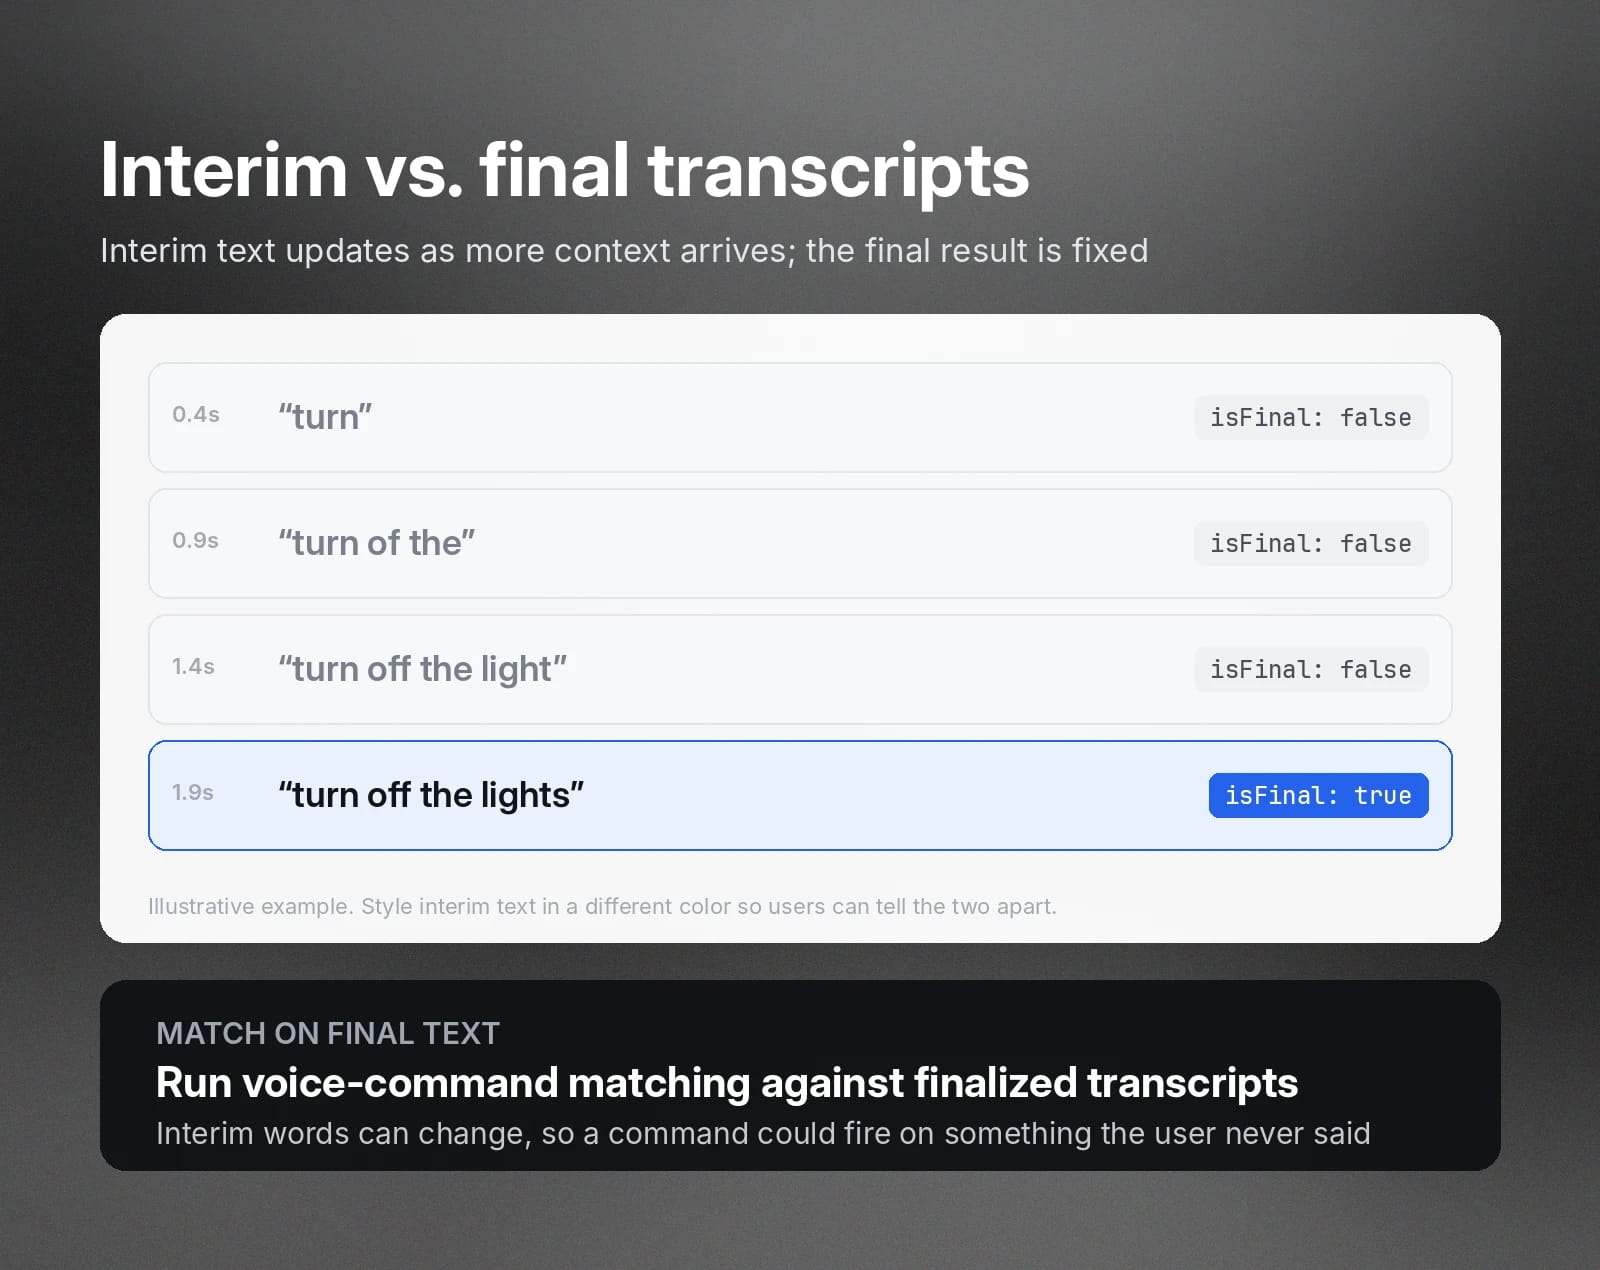
注: 中間文字起こしを有効にしている場合は、isFinalプロパティで、テキストが確定済みの文字起こしかどうかを判断します。
JavaScript音声認識の例を構築する
この例では、JavaScriptのSpeechRecognitionインターフェースを使用して、リアルタイム文字起こしWebアプリを構築します。以下のスクリーンショットは完成したページです。
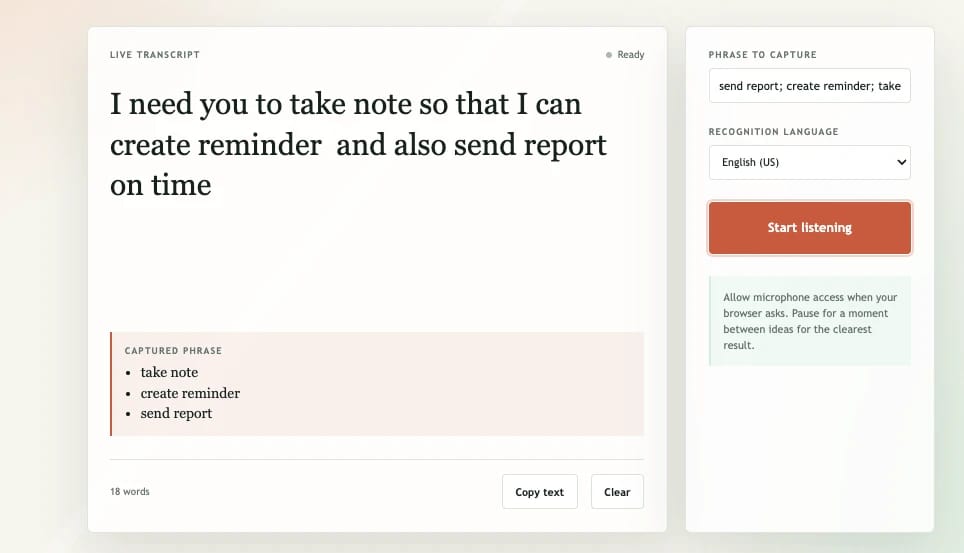
このサンプルページでは、[Start listening]ボタンで録音を開始します。ユーザーが話すと、ブラウザはオーディオをSTTエンジンに送信し、文字起こしを待ってから、中間テキストと確定テキストの両方を表示します。
この例には、ユーザーが指定した特定の用語を取得する音声コマンド機能も含まれています。コード内で文字起こしを事前定義されたフレーズリストと照合しますが、これはスピーチtoテキストAPIのキータームプロンプティングとは異なります。
以下のスニペットは、この例の主要部分を示しています。
SpeechRecognition APIを設定し、マイクへのアクセスをリクエストする
コードで使用するには、まずSpeechRecognitionクラスをインスタンス化する必要があります。古いChromeまたはSafariを使用している場合は、webkitSpeechRecognitionを参照します。
次に、SpeechRecognitionインスタンスを作成し、ストリーミングモード、中間文字起こしのサポート、発話言語を設定します。
次に、.start()メソッドを呼び出して文字起こしを開始できます。
初めて音声認識プロセスを開始すると、ブラウザはユーザーに権限を求めます。文字起こしを開始するには、ユーザーが[許可]をクリックする必要があります。それ以外の場合、APIはSpeechRecognitionErrorEvent ハンドラーで"not-allowed"値を返します。
ライブ文字起こしと確定結果を表示する
この例では、ユーザーがマイクに話しかける間、文字起こしを表示します。そのために、onresultイベントに関数を追加します。
中間文字起こしは確定していません。そのため、表示されるテキストが実際に話した言葉と正確に一致しない場合があります。STTエンジンは後続の単語からより多くのコンテキストを受け取ると、文字起こしを修正して文字列で返します。
中間テキストを確定文字起こしと区別できるよう、別の色でスタイル設定することもできます。このCSSで実現できます:
JavaScriptに音声コマンドを追加する
ユーザーが検出したいフレーズをセミコロン区切りで入力できるテキストボックスを追加します。(代わりに、フレーズをJSONファイルに保存してコードへ読み込むこともできます。)
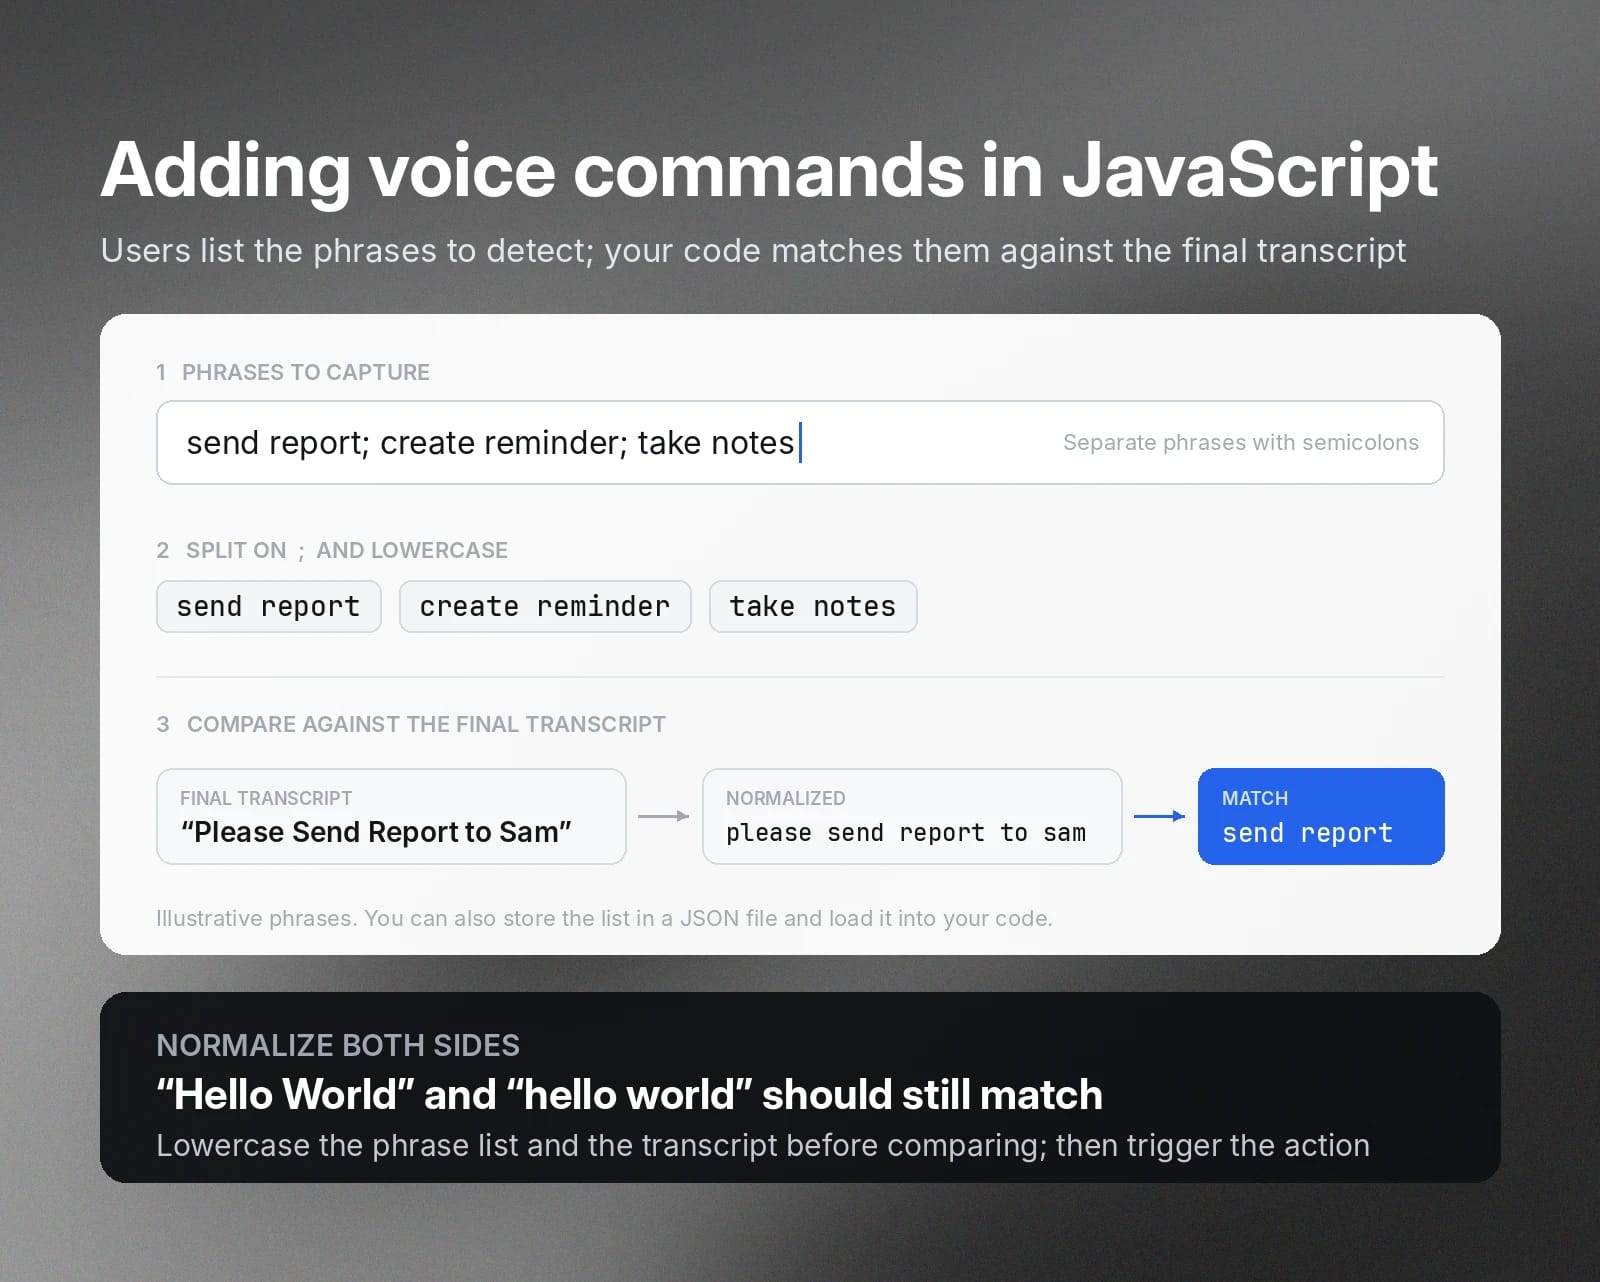
次に、確定文字起こしをフレーズリストと比較する関数を作成します。テキスト照合を行う際は、両方のリストを小文字に変換して正規化します。ユーザーが単語を大文字で入力する可能性があり、同じ単語でも不一致になることがあるためです。たとえば、“Hello World”と“hello world”は、一方が大文字であっても一致する必要があります。
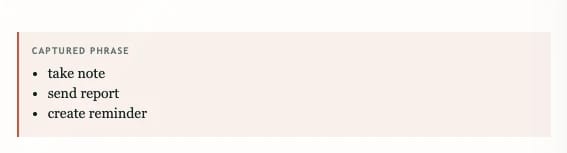
コードが文字起こしを受け取るたびに、フレーズリストを反復処理します。一致があれば、アプリケーションの起動や、この例のように一致したフレーズを別パネルに表示するなどのアクションを実行します。
ブラウザのサポート、権限、認識エラーを処理する
Web Speech APIを使うと、JavaScriptでスピーチtoテキスト認識を手軽に実行できますが、常に問題なく動作するわけではありません。ユーザーがSpeechRecognition APIのバックエンドサポートが限定的、または存在しないブラウザを使用する可能性があります。ネットワークの問題で文字起こしに失敗する場合もあります。
そのため、コードでこれらの状態を処理し、適切にユーザーへ通知する必要があります。
たとえば、SpeechRecognition APIの動作が確認されているChromeまたはEdgeを使用するよう、ユーザーに案内します。
一方、エラーを処理するには、onerror イベントハンドラーにエラー処理関数を関連付け、それぞれのエラーコードを処理します。
例:
エラーコード | 対応 |
not-allowed | ブラウザの設定を確認するようユーザーに伝えるテキストを表示します。 |
no-speech | マイクに近づいて話すようユーザーに案内します |
network | インターネット接続を確認するようユーザーに促します |
aborted | 音声認識プロセスが停止したことをユーザーに知らせます。 |
JavaScript音声認識をアクセシブルかつプライバシーに配慮したものにする
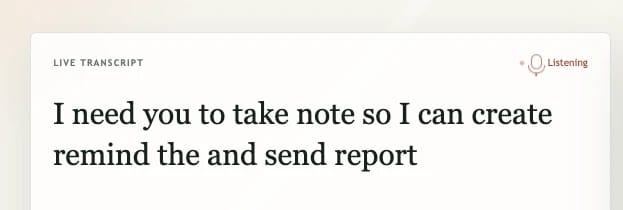
Web Speech APIを統合する際は、プライバシーを念頭に置きましょう。Webクライアントが録音を開始する前には、必ず視覚的または音声によるインジケーターを表示してください。たとえば、JavaScript音声認識コードがマイク信号をスピーチtoテキストエンジンに送信している間、視覚的な合図としてリスニングアイコンを表示します。
デベロッパーが注意すべきもう一つの領域は、データプライバシーです。SpeechRecognition APIで文字起こしを行うと、APIはデフォルトでオンライン文字起こしを実行します。ブラウザがオフラインのスピーチtoテキストに対応している場合でも、APIはまずオンライン文字起こしを試みます。
データレジデンシー、ガバナンス、コンプライアンスが厳格に規制される文字起こしサービスを構築する場合、これらの技術仕様は重要です。
ブラウザ音声認識だけでは本番環境に不十分な場合を知る
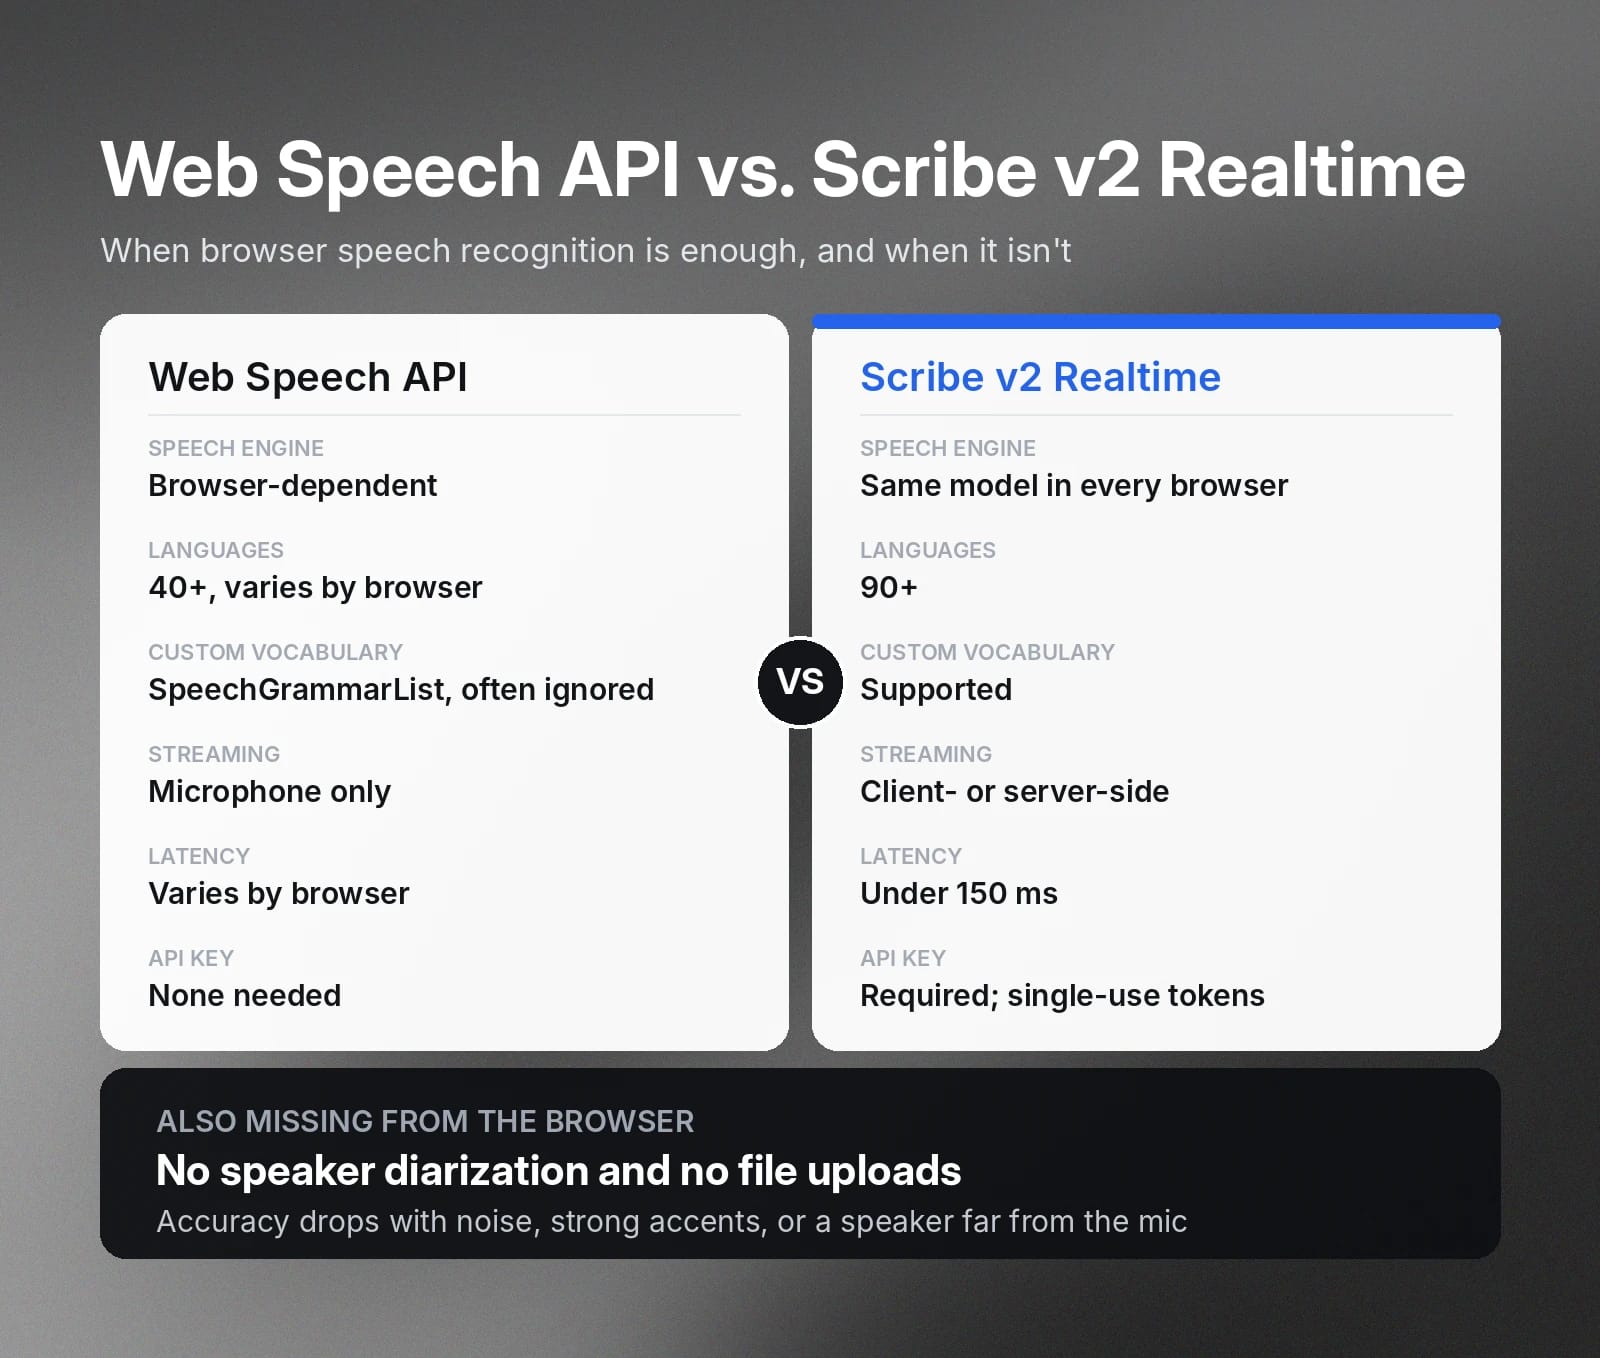
Web Speech APIを使用して、ブラウザベースの音声アプリ向けに自動音声認識を構築する手順を紹介しました。このAPIにより、JavaScriptデベロッパーはスピーチtoテキスト機能を利用できます。ただし、特に商用Webプロダクトでは、いくつかの制約がユースケースを制限します。
- ブラウザ依存: 文字起こしはユーザーのブラウザに大きく依存します。デベロッパーは使用される特定の音声モデルを制御できないため、文字起こしのパフォーマンスに一貫性がありません。
- 限定的な言語サポート:APIは40以上の言語をサポートしますが、正確な数はブラウザによって異なる場合があります。
- 話者ダイアライゼーション:誰が話しているかを検出し、話者ごとに文字起こしへ反映することはできません。
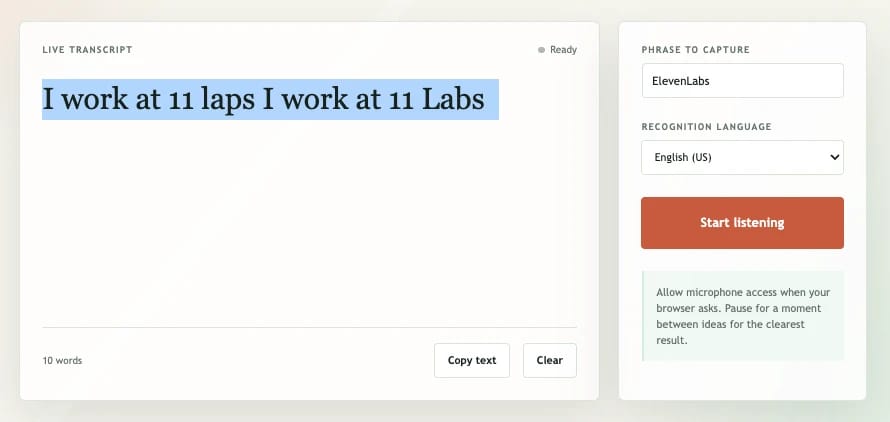
- カスタム語彙:SpeechRecognition APIには、カスタム語彙に対する信頼性の高いサポートがありません。たとえば、“ElevenLabs”を正確に文字起こしできません。(公式のSpeechRecognition APIはSpeechGrammarListを使用したカスタム語彙インターフェースを提供していますが、最新のブラウザでは無視されることがよくあります。)
- 精度:話者が騒がしい環境にいる、強いアクセントがある、またはマイクから離れている場合、文字起こしの精度は低下します。
- サーバー側ストリーミング:Web Speech APIはサーバーストリーミングや手動でのオーディオファイルアップロードをサポートしていないため、マイクからのみストリーミングできます。
こうした制約により音声認識プロダクトを商用化できない場合は、ElevenLabs Scribe v2 Realtimeの使用をおすすめします。
ElevenLabs Scribe v2 Realtimeは、高精度な150ms未満のレイテンシーによるリアルタイム文字起こしを提供する音声認識モデルです。90以上の言語、ブラウザに依存しない一貫性、カスタム語彙をサポートします。ElevenLabs Scribe v2 Realtimeでは、Webアプリのアーキテクチャに合わせてクライアント側またはサーバー側ストリーミングを実行できます。
ElevenLabs Scribe v2 RealtimeによるJavaScript音声認識チュートリアル
ElevenLabsを使用してJavaScriptで音声コマンドを構築する方法も、同様のアプローチです。ただし、APIリクエストを認可するにはElevenLabs APIキーを作成する必要があります。以下では、マイクからストリーミングするWebクライアントを作成する手順を簡単に紹介します。
- ElevenLabs SDKをインストールする
- APIキーを公開せずに渡すための単回使用トークンを作成する
- 必要なパラメーターでScribe v2 Realtimeモデルを設定して接続する
- 文字起こしを処理し、例外を処理するイベントハンドラーを作成する
Scribe v2 Realtimeの詳しいガイドについては、公式ドキュメントをご確認ください。
本番環境のスピーチtoテキストにElevenAPIを活用する
ElevenAPIは、Webクライアントおよびサーバー開発向けのプロダクション品質のスピーチtoテキストモデルを提供しています。リアルタイム音声認識に加え、デベロッパーはElevenAPIのスピーチtoテキストモデルを使用して、話者ダイアライゼーション、単語レベルのタイムスタンプ、非同期処理に対応したバッチ文字起こしを実現できます。
スピーチtoテキストエンジンを継続的にポーリングする代わりに、ElevenLabsダッシュボードでWebhookを作成し、APIが完成した文字起こしを配信するコールバックURLを指定できます。
自動音声認識を備えたWebクライアントまたはサーバーアプリのどちらを構築する場合でも、ElevenAPIはコードに簡単に統合できるオーディオモデルを提供します。
ElevenLabs APIキーを取得し、APIドキュメントを見るして、構築を始めましょう。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


