会話インテリジェンスとは?ビジネス向けガイド
- 公開日
- 最終更新日
営業やサポートの会話では、話された内容の大半が会話後に活用されることはほとんどありません。通話が終わり、誰かがCRMで完了と記録すると、その会話は二度と確認されない録音ファイルになってしまいます。
会話インテリジェンスは、こうした状況を防ぐためのレイヤーです。会話を取得して文字起こしし、AI分析を適用することで、チームや経営陣と共有・活用できる社内リソースへと変換します。社内レビューのために一部の会話だけを選ぶのではなく、すべての会話について、感情、反論、アクションアイテムのタグ付き記録を残せます。
このガイドでは、会話インテリジェンスとは何か、どのように機能するか、主にどこで使われるかを解説します。顧客との会話に活用する際にお役立てください。
概要
- 会話インテリジェンスは、通話量が管理者の手作業でのモニタリング能力を超え、重要なインサイトが見落とされるようになると価値を発揮します。
- この同じパイプラインは、営業コーチングやサポート品質から、規制業界のコンプライアンス、社内会議まで、会話を軸に業務を行うあらゆるチームに役立ちます。
- プラットフォームの有用性は、話者ごとに計測された単語誤り率で評価する、実環境のオーディオに対する精度に左右されます。あらゆるスコアと要約は、元となる文字起こしに依存するためです。
- 効果的なプラットフォームには、リアルタイムおよびバッチモード、多言語対応、エンティティ検出、CRMインテグレーションも必要です。ElevenLabsは、SOC2、HIPAA、GDPR、EU域内データ保管に対応したScribe v2およびScribe v2 Realtimeでこれらを提供します。
会話インテリジェンスとは何か、どのように使われるのか?
会話インテリジェンスは、顧客との会話を録音・文字起こしし、AIを使って感情、トピック、アクションアイテム、反論といった構造化されたインサイトに変換するソフトウェアです。このインテリジェンスは、正確な文字起こしと、会話の文字起こしから意味を読み取る解釈レイヤーという2つの層で構成されています。
この解釈レイヤーこそが、録音や単なる文字起こしと会話インテリジェンスを分けるものです。たとえば、通話録音は通常オーディオだけを保存しますが、文字起こしでは同じオーディオを読めるようになります。会話インテリジェンスは、誰が話したか、どのトピックが話されたか、未解決の質問は何か、会話が目的にどの程度沿っていたかを判断し、分析を強化します。
実際の仕組みを詳しく見ていくために、1件の営業通話を例にしてみましょう。会話インテリジェンスシステムは、次のことを行います。
- オーディオを文字起こし: 通話を、各話者が適切にラベル付けされた正確なタイムスタンプ付きテキストに変換します。
- 重要な瞬間を検出: 価格に関する質問、競合他社への言及、合意した次のステップなど、重要な話し合いの場面にフラグを付けます。
- 会話をスコアリング: 会話を取り上げ、話す時間と聞く時間の比率や発見質問の網羅度など、定義されたフレームワークに照らして評価します。
- CRMに同期: 会話の要約とアクションアイテムが、手動でデータ入力することなくレコードに書き込まれます。
社内のチームは、会話インテリジェンスを同じパターンで活用します。収益チームは営業通話に適用し、サポートチームはサービス対応で利用します。コンプライアンス部門はデータプライバシーが守られていることを確認するために規制対象の会話に適用し、プロダクトチームはプロダクト改善に向けて顧客フィードバックをより深く理解するために使用します。
会話インテリジェンスが重要な理由:会話インテリジェンスのメリット
会話インテリジェンスのメリットは、企業が社内リソースとして活用したい会話の量に応じて大きくなります。
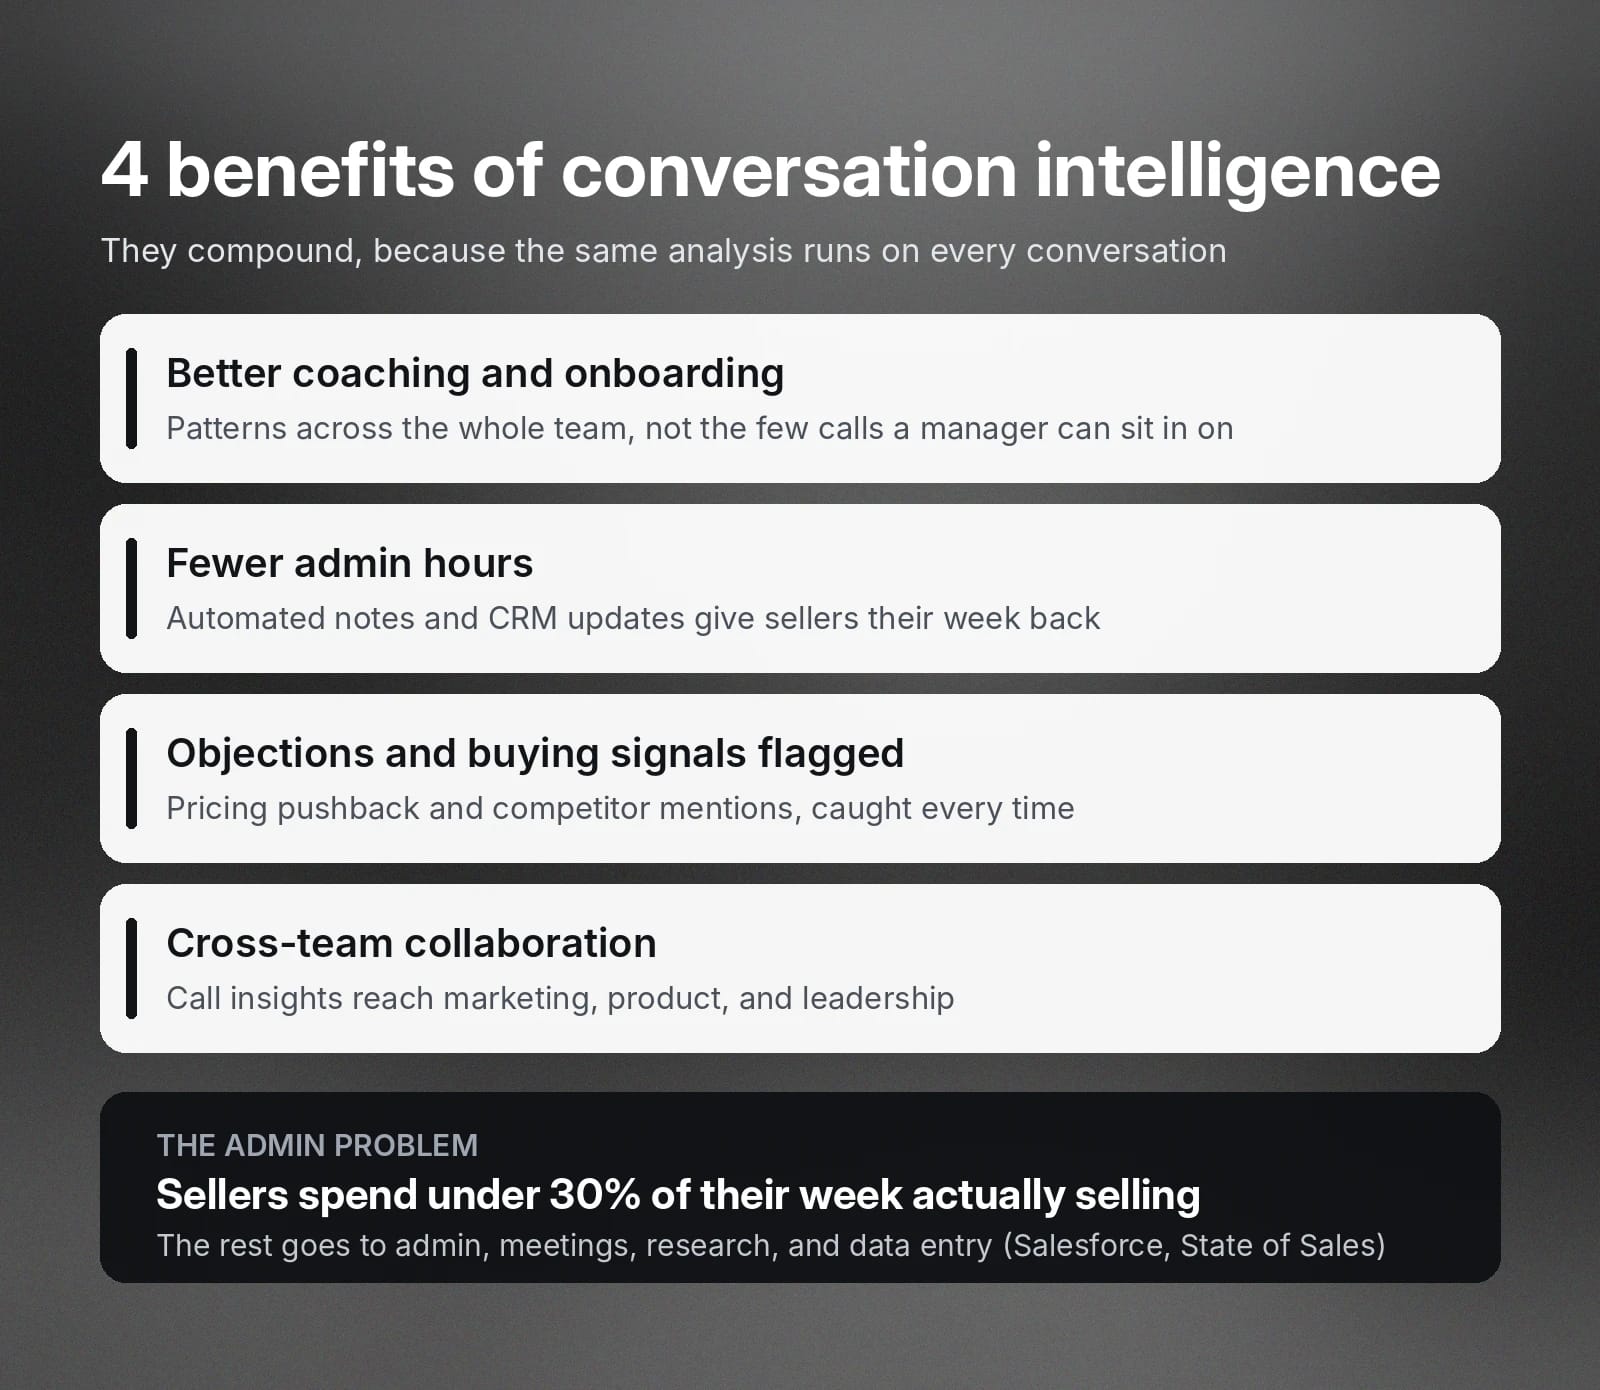
会話インテリジェンスが最も効果を発揮するのは、非構造化の対話を、企業が測定・改善できるデータへ変えるときです。チームが導入すると、いくつかのメリットが一貫して現れます。主なメリットは次のとおりです。
- コーチングとオンボーディングの改善: 管理者は、同席できる数件の通話だけでなく、チーム全体のパターンを確認できます。これにより、新入社員や他のチームメンバーは理論ではなく、優れた通話の実例から学べます。
- 管理業務の時間を削減し、CRM入力を迅速化: Salesforceの「State of Sales」レポートで最近報告されたデータによると、営業担当者が週の勤務時間で直接的な営業活動に費やす時間は30%未満です。残りの時間は、管理業務、社内会議、手作業での調査、データ入力に使われています。メモ作成、CRM更新、その他の重要な管理業務を自動化することで、営業担当者は販売により多くの時間を割けます。
- 購買シグナルと顕在化した反論をフラグ付け: 会話インテリジェンスの分析レイヤーは、価格への反発、競合他社への言及、その他の注目ポイントにフラグを付け、重要なトピックを見逃さないようにします。価格や競合他社への言及が繰り返される会話を管理者が調べ、改善策を立てるのに役立ちます。
- チーム横断の連携: このメリットにより、通話から得られたインサイトを1つの部門に閉じ込めず、マーケティング、プロダクト、経営層にも届けられます。他部門が支援できる領域を特定し、社内の営業・サポートプロセスの改善に役立ちます。
同じ分析がすべての会話に対して実行されるため、これらのメリットは時間とともに積み重なります。会話から学び、インサイトを引き出すことこそが、会話インテリジェンスの目的です。
会話インテリジェンスの仕組み
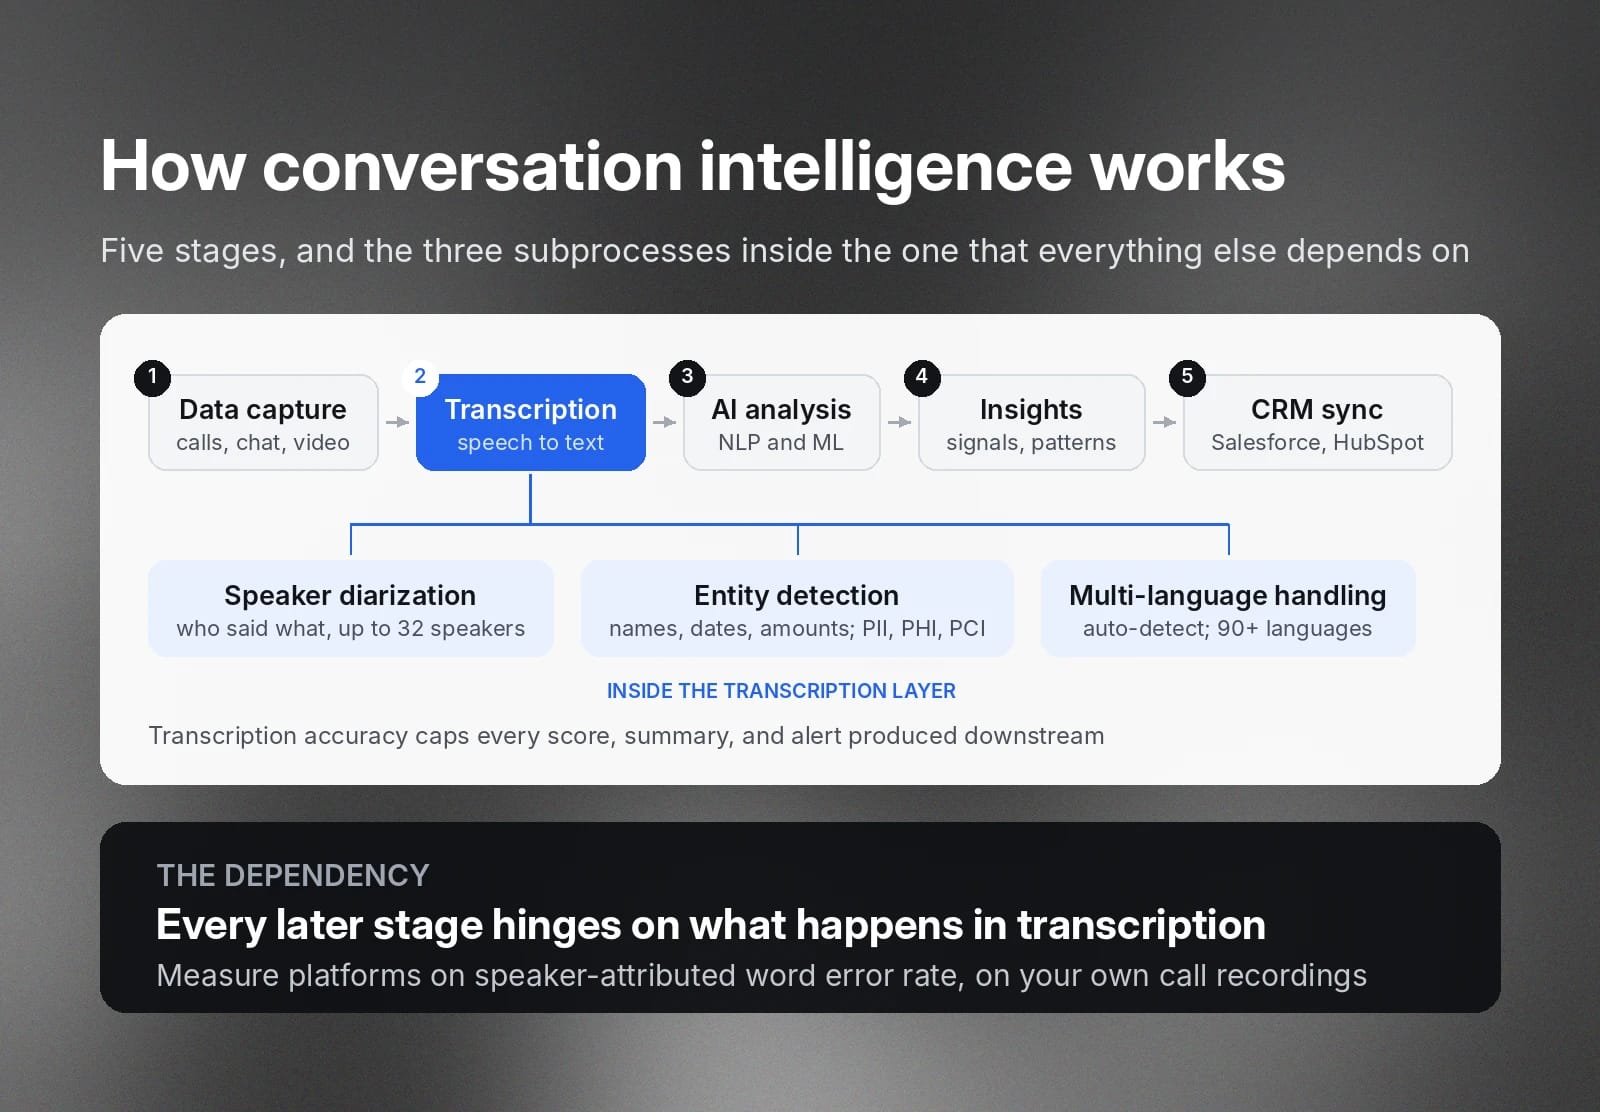
現在市場にある会話インテリジェンスプラットフォームの大半は、ベンダーにかかわらず5段階のプロセスに従っています。このパイプラインは次のとおりです。
- データ取得: 電話、チャットスクリプト、ZoomやTeamsなどのビデオ会議プラットフォームといった発生元から、録音または収集された会話を取り込みます。
- 文字起こし: 音声認識を使う技術によってオーディオをテキストに変換し、検索可能な記録を作成します。
- AI分析: 自然言語処理(NLP)と機械学習(ML)モデルがテキストを処理して、感情を識別し、重要な場面やアクションアイテムを抽出します。一部のプラットフォームはこの分析をライブで実行し、通話中の担当者にガイダンスを提供します。
- インサイト: 会話を分析し、繰り返される反論、価格に関する質問、その他の関連シグナルなど、活用可能な出力に変換します。
- CRMインテグレーション: インサイトと通話要約をSalesforceやHubSpotなどのCRMプラットフォームに同期し、継続的な手動入力なしでレコードを更新します。
文字起こしレイヤーの内部
この5ステップのフローがパイプライン全体をカバーする一方で、第2ステップの「文字起こし」は非常に重要であり、その後の段階の有効性はここで何が起こるかにかかっています。会話インテリジェンスにおいて文字起こしがどのように機能するか、より技術的に見ていきましょう。
- 話者ダイアライゼーション: 文字起こしの各セグメントを特定の話者に紐付け、誰が何を言ったかをラベル付けします。営業通話では、この機能によりコーチングツールは話す時間と聞く時間の比率を計算し、営業担当者が質問の大半を投げかけたことを確認できます。 ダイアライゼーションは、モデルが通話開始時の声と終了時の声を比較できるため、完了した録音では比較的容易です。一方、リアルタイムでは次に何が話されるかを聞かずに話者ラベルを割り当てなければならないため、困難です。
- エンティティ検出: 文字起こし内の氏名、日付、金額、口座番号など、特定の情報カテゴリを識別し、それぞれに正確なタイムスタンプを付与します。これにより、誰かがすべての文字起こしを読んだり各通話を聞いたりしなくても、「競合他社に言及したすべての通話」の検索可能なインデックスを構築できます。また、コールセンターがPCIまたはPHIデータを扱う際、コンプライアンス要件を満たすための編集・マスキングを可能にします。
- 多言語対応: 通話内での自動言語識別と、チームが実際に顧客とのやり取りで使う言語での正確な文字起こしの両方をカバーします。英語のみに限定されたプラットフォームでは、サポートチームがスペイン語、ポルトガル語、日本語での通話対応を始めた時点で、会話を完全に取りこぼしてしまいます。
ElevenLabsのスピーチtoテキスト機能は、単一のAPIでこの3つすべてをカバーします。最大32人の話者に対応するダイアライゼーション、エンティティ検出はPII、PHI、PCIのカテゴリにまたがるエンティティタイプに対応し、90以上の言語で文字起こしを行えます。
会話インテリジェンスと会話型AIの違い
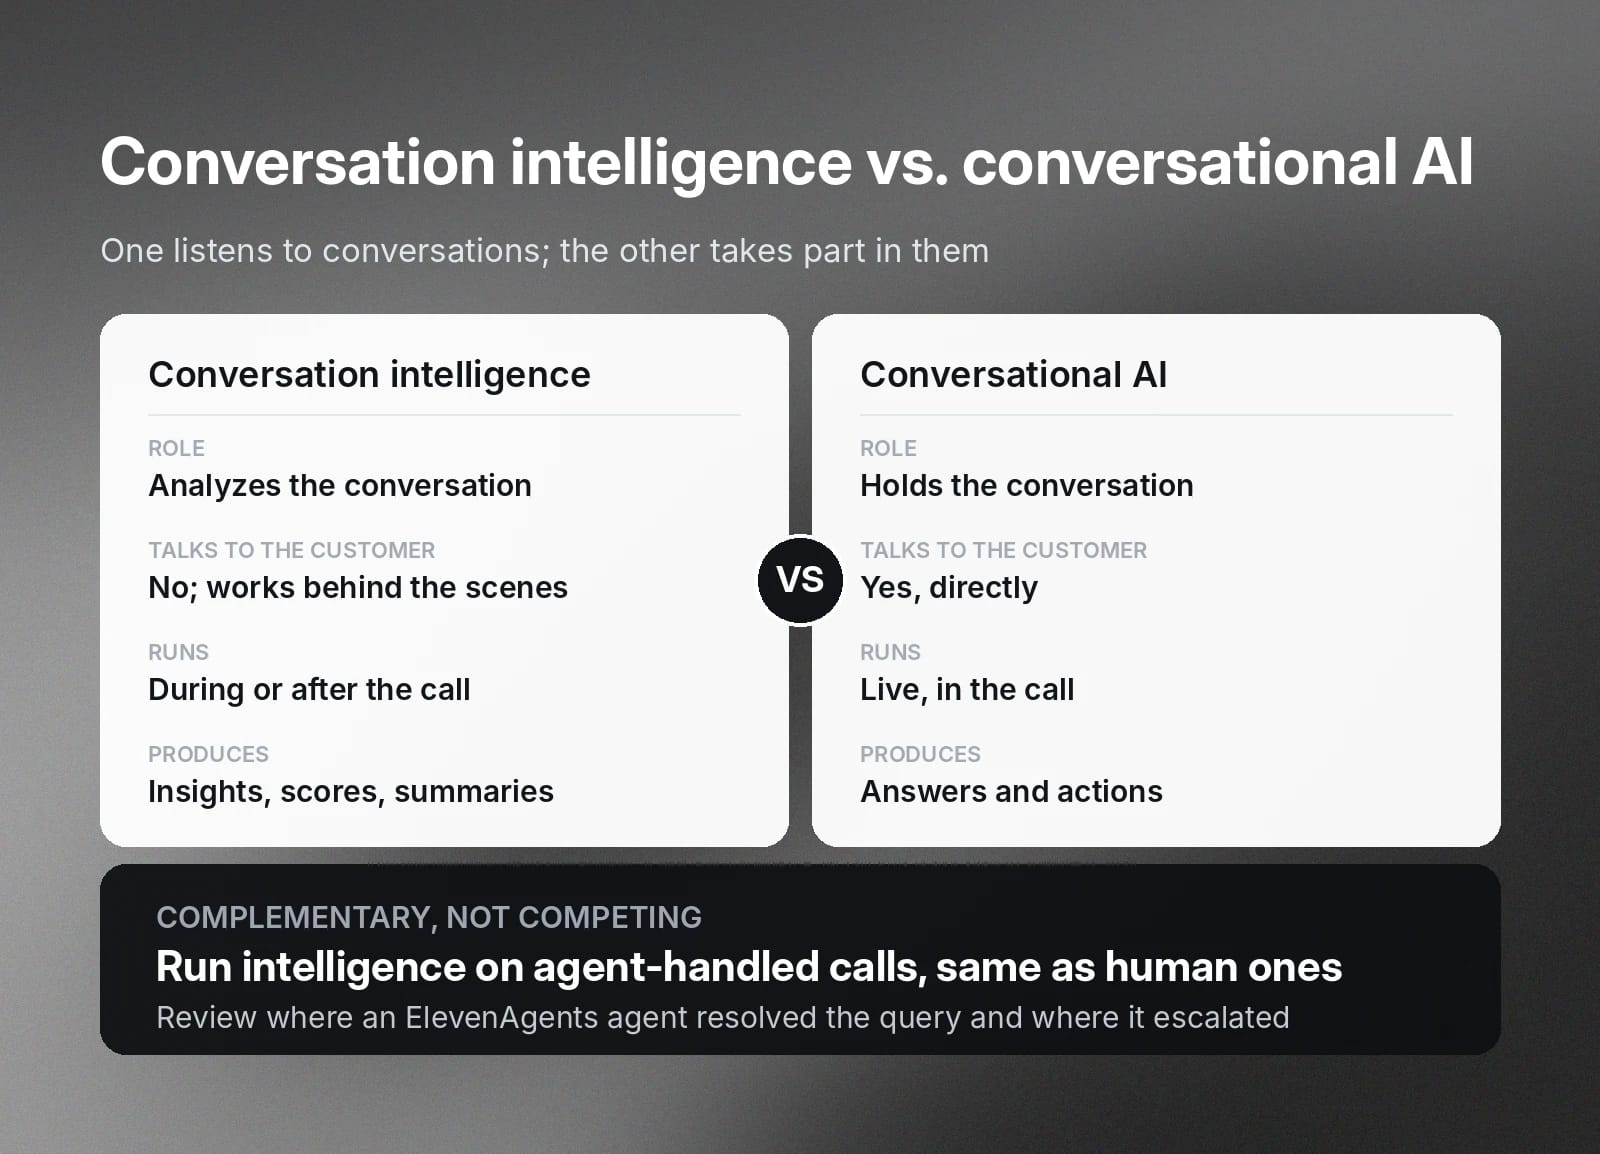
この2つの用語はしばしば混同されます。両者の違いは、会話型AIが音声会話を行うのに対し、会話インテリジェンスはそれを分析する点です。
会話型AIには、質問への回答やサポート上の問題への対応を通じて、顧客と直接会話できるチャットボットや音声エージェントが含まれます。会話インテリジェンスはバックグラウンドで機能し、顧客とやり取りしません。すでに行われている会話を聞き、そこからインサイトを抽出します。
両者は競合するものではなく、補完し合うものです。会話に関わる業務の中で、それぞれ独立した役割を担います。たとえば、ElevenAgents のようなプラットフォームで音声エージェントを運用するサポートチームは、人間が対応した通話と同じように、エージェント対応の通話にも会話インテリジェンスを適用できます。会話インテリジェンスの目的は、エージェントが問い合わせに適切に対応できた箇所と、エスカレーションされた箇所を確認することです。
会話インテリジェンスのユースケース
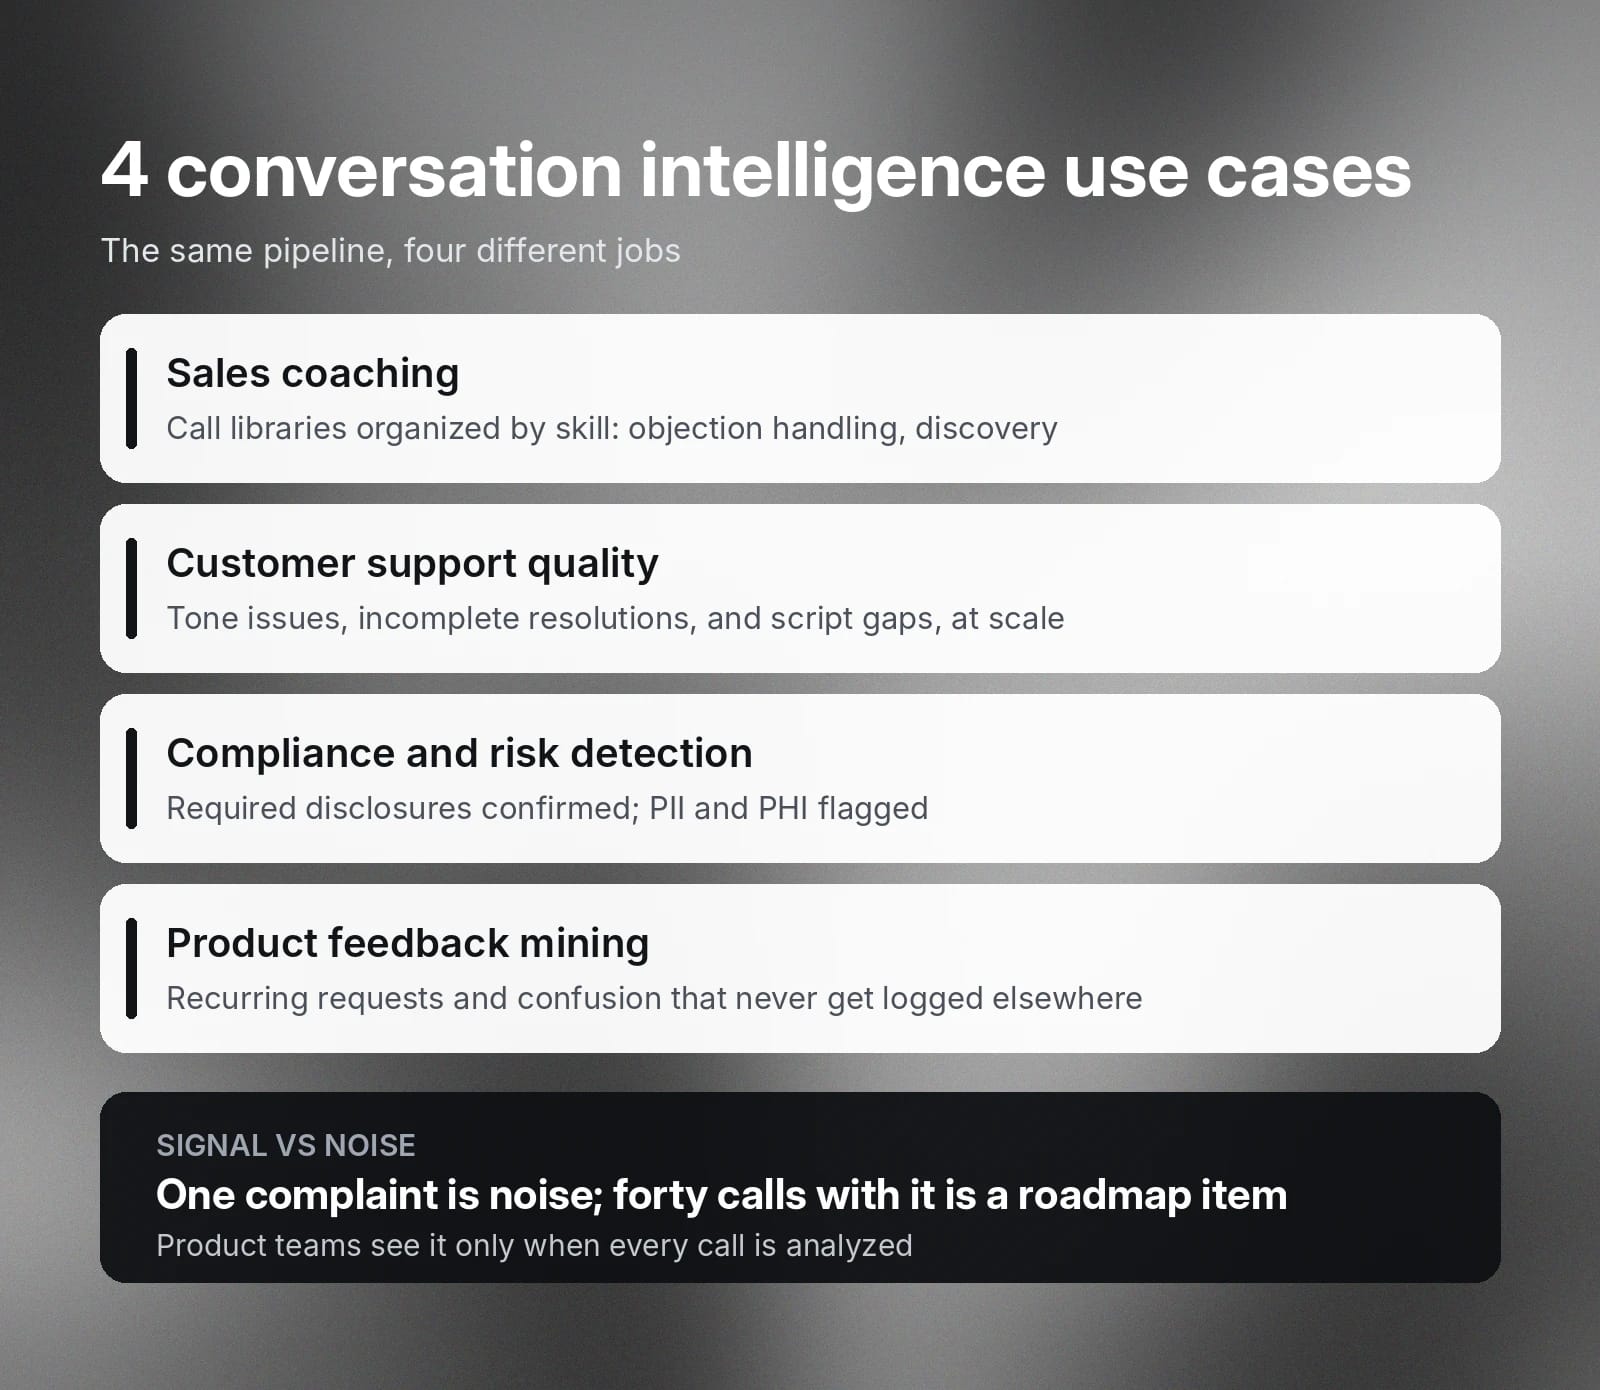
会話インテリジェンスの機能は、チームが利用する特定のユースケースによって異なります。導入するユースケースに応じて、得られるメリットも変わります。会話インテリジェンスの主なユースケースには、次のようなものがあります。
営業コーチング
営業リーダーは、特定のスキル別に整理した通話ライブラリを構築できます。反論への対応や発見質問などのスキルを活用することで、新しい営業担当者をより迅速にオンボーディングし、チーム全体における成功の基準を定められます。
カスタマーサポートの品質
サポートリーダーは、これまで以上の規模でエージェントの通話をレビューできます。会話インテリジェンスにより、口調の問題、未完了の解決、スクリプトの欠落を把握できます。これらはすべて、通話にライブで参加することなく行えます。請求に関する質問が出た後に会話の感情スコアが下がる場合、それが複数の会話で見られれば対処すべきパターンです。
コンプライアンスとリスク検出
医療や金融サービスなど、多くの規制業界では、必要な開示が行われたことを確認し、機密情報を含む通話にフラグを付けるために会話インテリジェンスを利用しています。特に、社会保障番号(SSN)などの個人識別情報(PII)や、機密データの取り扱いをせずに話された医療診断が該当します。エンティティ検出により、人間のレビュアーがすべての事例を見つけることに頼らず、このユースケースを大規模に実用化できます。
プロダクトフィードバックの分析
プロダクトチームは、他では正式に記録されない、繰り返し寄せられる機能要望や混乱が生じている領域を特定するために、サポートと営業の文字起こしをレビューします。苦情が1回だけ現れるなら、それは単なるノイズです。しかし、同じ苦情が40件の通話にまたがって現れるなら、対処すべきロードマップ項目です。こうした苦情は、プロダクトの機能や性能にどのようなギャップがあるかをプロダクトチームに示すことができます。
ElevenLabs APIで会話インテリジェンスを構築
会話インテリジェンスプラットフォームを支えるインフラは、主にスピーチtoテキストの課題であり、その上にいくつかの特有の要件が加わります。
複数の録音済み通話を文字起こしする場合、Scribe v2は、話者ダイアライゼーション、単語レベルのタイムスタンプ、エンティティ検出を組み込み、オーディオおよびビデオファイルを処理します。ライブ分析では、Scribe v2 Realtimeが約150msのレイテンシーで文字起こしをストリーミングし、通話後ではなく通話中にリアルタイムのコーチングプロンプトやコンプライアンスアラートを提供できます。
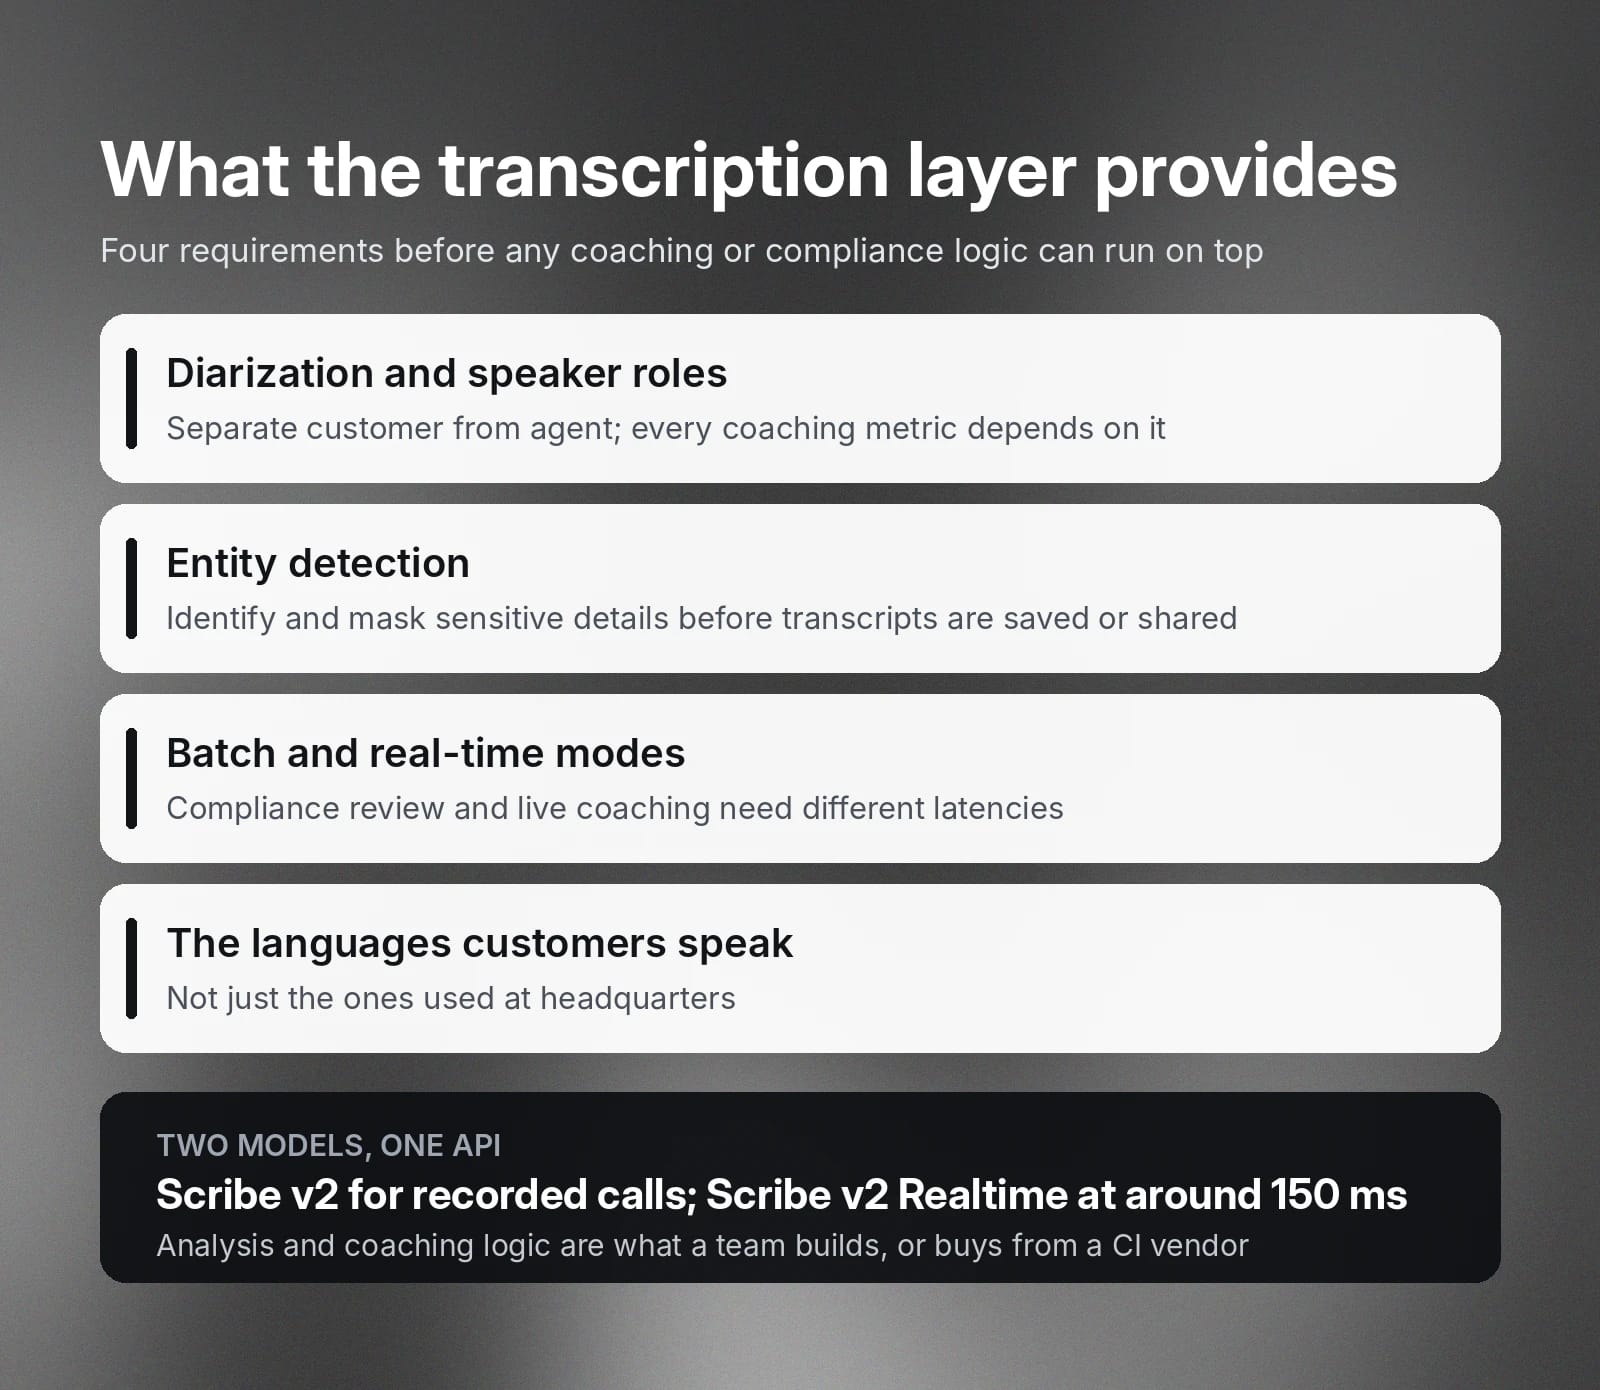
会話インテリジェンスプラットフォームがインフラレイヤーに求めるもの:
- ダイアライゼーションと話者ロールのラベル付けによって顧客とエージェントの発話を分離すること。これは、話者識別を必要とするあらゆるコーチング指標の基盤です。
- エンティティ検出を導入すると、文字起こしを保存・共有する前の手動レビューに頼らず、機密情報を自動で識別・マスキングできます。
- コンプライアンスレビューとライブコーチングでは必要なレイテンシー水準が異なるため、バッチとリアルタイムの両方の選択肢が必要です。
- 本社で使われる言語だけでなく、チームの顧客が話す言語に対応する多言語サポート。
これらの機能が、会話インテリジェンスプロダクトの基盤となる文字起こしレイヤーを構成します。分析とコーチングのロジックは、チームが自ら構築するか、専用のCIベンダーから購入するコンポーネントです。
ElevenAPIを始める
Scribe v2とScribe v2 Realtimeは、単一のAPIでダイアライゼーション、エンティティ検出、単語レベルのタイムスタンプを備えた、会話インテリジェンス向けの文字起こしレイヤーを提供します。対応モデルと言語については、ElevenLabs スピーチtoテキストをご確認ください。
会話インテリジェンスを自社プロダクトや社内ツールに組み込む場合は、無料アカウントを作成して、最初の通話の文字起こしを始めましょう。スピーチtoテキストAPIリファレンスでは、ダイアライゼーション、エンティティ検出、言語サポートの全パラメータを確認できます。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。