
音声エージェント評価フレームワーク:6つの柱を解説
- 公開日
- 最終更新日
音声エージェントは、ほぼ同時に動作する多数のツールを連携させる必要があります。顧客の発言をリアルタイムで記録し、スピーチtoテキスト(STT)で文脈を取り込み、大規模言語モデル(LLM)で応答を生成し、さらにテキスト読み上げ(TTS)ソフトウェアで音声ファイルを生成する、繊細な連携が求められます。
これほど多くの要素が関わるなか、音声エージェントのパフォーマンスを正確に評価するにはどうすればよいのでしょうか?
この記事では、エージェントの成功を評価する際に何を測定すべきかを明確にする、6つの柱からなる音声エージェント評価フレームワークを紹介します。業界ごとにこれらの柱の重み付けが異なる理由や、評価時に注意すべき一般的なミスについても解説します。
概要
- 音声エージェント評価で用いる6つの主要な柱は、TTS音声品質、会話品質、ツール使用とタスク完了、インテリジェンス、コンプライアンスとセーフティ、信頼性です。
- 目標とすべき主な本番環境の指標は、MOS 4.3、TSR 85%超、初回音声までの時間が500ms未満です。
- 業界によって各柱の重み付けは異なり、導入形態によっては特定の柱がほかより重視されます。
- よくあるテストのミスには、クリーンな音声だけを評価することや、P99レイテンシの急上昇を無視することがあります。
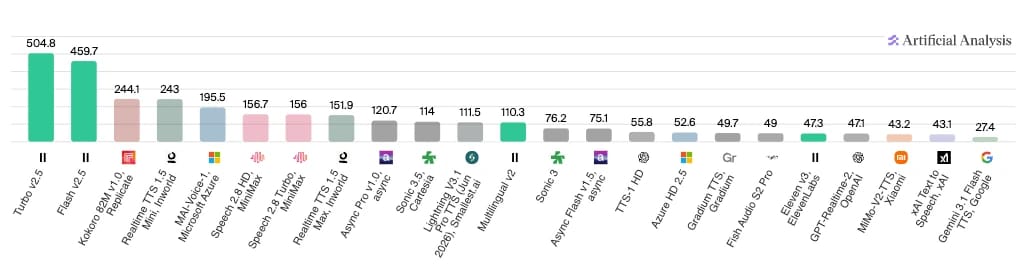
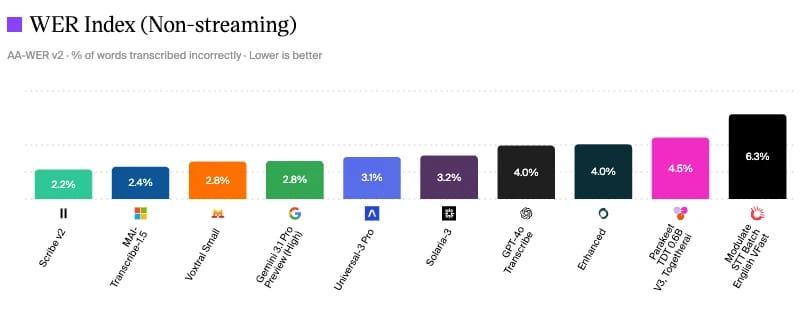
- ElevenLabsは、最も重要な指標で優れた成果を示しています。Scribe v2はWER 2.2%で業界最低水準を達成し(Artificial Analysis、2026年6月)、Flash v2.5とTurbo v2.5は速度面でトップクラスのモデルです(Artificial Analysis、2026年6月)。ElevenAgentsは約75msのモデル推論レイテンシを実現します。
音声エージェント評価フレームワークとは?
AI音声エージェント評価フレームワークは、複数の側面からパフォーマンスをテストできる構造化された仕組みです。包括的なフレームワークには、音声の忠実度、会話の流れ、規制コンプライアンスまで評価するための指標が含まれます。
テキストチャットボットとは異なり、音声エージェントではすべてのやり取りが少なくとも3つの連携技術を経由します。自動音声認識(ASR)はユーザーの発話をテキストに変換し、LLMが応答を組み立て、TTSシステムが応答を再び音声へ変換します。これらのシステムのどれか1つでも失敗すれば、体験全体が損なわれます。
この複雑さこそ、企業がプロバイダーを選定して導入する前に音声エージェントを評価する必要がある理由です。レイテンシの増加や不正確な応答は、顧客離れ、最悪の場合は規制上の罰金や評判の損失といった現実的な影響につながる可能性があります。
音声エージェントを評価するフレームワークでは、ベンチマークと測定可能なデータを用いて、エージェントが特定のユースケースに適しているかを定義します。ビジネスの観点からは、異なる音声モデルを評価できれば、顧客に最適なモデルを選択できます。
評価すべき6つの音声エージェント評価の柱
AIエージェントの作成と導入はかつてないほど簡単になりましたが、その裏側で進行する処理はかなり複雑です。ユーザーの話を聞き、要望を理解し、その情報をLLMに渡して音声応答を生成する複数のコンポーネントが連携するため、ほぼ同時に多くの処理が実行されます。
最高の音声エージェントと連携するには、企業には比較対象となる厳格なフレームワークが必要です。
テスト結果に関心がある場合は、Artificial Analysisが、さまざまなコンポーネントに基づく複数のエージェント比較を提供しています。以下では、モデル間の速度比較の結果を確認できます。ElevenLabsのTurbo v2.5とFlash v2.5は、1秒あたりの処理文字数で大幅にリードしています。
独自の実験を行いたいデベロッパーや企業向けに、AIエージェント評価フレームワークで使用すべき6つの柱を紹介します。
- TTS音声品質:合成音声がエンドユーザーにとってどれだけ自然で、明瞭かつ表現力豊かに聞こえるかを示します。たとえば、Eleven v4のような業界トップクラスのモデルは、70以上の言語で人間らしく感情豊かな話し方を提供します。
- 会話品質:モデルは人の発話を理解し、意味を処理し、複数ターンにわたって文脈に沿った応答を迅速に返せるでしょうか?
- ツール使用:人の介入を必要とせず、利用可能なリソースを使ってAIエージェントがどの程度タスクを完了できるかを示します。
- インテリジェンス:モデルがどれだけ適切に推論し、新しい入力を処理し、不正確な応答やハルシネーションを回避できるかを示します。
- コンプライアンスとセーフティ:すべての機能に加え、AI音声エージェントは、アクティブなガードレールを含むすべての規制・コンプライアンス要件を遵守する必要があります。
- 信頼性:総稼働時間や負荷時の一貫したパフォーマンスなどの要素から、会話型AIエージェントが需要に応じてスケールできるかを判断します。
これらの柱はそれぞれ独立していますが、互いに連携してユーザーに高品質な最終体験を提供します。たとえば、モデルの音声品質が向上してもレイテンシが高いままであれば、顧客は音声が返るまで不自然な待ち時間を体験することになります。
これらの音声AI評価の柱を、それぞれ詳しく見ていきましょう。
TTS音声品質
まずは音声品質から見ていきます。AI会話エージェントとやり取りした際、人が最初に気づく要素である可能性が高いためです。ロボットのよう、または不気味に聞こえると、エージェントとの主観的な体験は大幅に悪化します。
国際電気通信連合電気通信標準化部門(ITU-T)が定義した初期の評価指標の1つに、平均オピニオン評点(MOS)があります。MOSは1~5の尺度で、1は使用に耐えず、5は優れていることを示します。主観的な測定であるため、人間のリスナーを使い、通話後にフィードバックを収集します。
この尺度でMOS 3.5未満は、特に現代の基準ではあまり優れた水準ではなく、顧客満足度に影響する可能性があります。
MOSは人間を中心とした指標ですが、この数値には複数の技術的要件が影響します。
- ピッチの一貫性とジッター:ピッチとジッターは、人が聞く際に自然に認識する2つの言語的要素です。「ピッチ」とは、質問時に自然と声が高くなるような、発話中のイントネーションの変化を指します。ジッターは、音声モデルのピッチ理解にばらつきがあり、文全体で一貫したプロソディを維持できない状態です。ジッターの業界ベースラインは30msです。
- 感情表現:明瞭で正確な音声でも、文で意図された感情的なトーンと一致しなければ、不自然に聞こえます。正確なトーンの手がかりがなければ、人間のリスナーはAI会話エージェントとの親近感を持ちにくく、評価も低くなります。ElevenAgentsは、人間に近い表現力を提供し、明確な感情的意図に沿って各応答を表現します。
- バックグラウンドノイズ:音声エージェントにおけるバックグラウンドノイズには、評価すべき2つの異なる側面があります。出力側では、エージェントをより自然に聞かせるため、環境音を応答にさりげなく加えます。入力側では、STTレイヤーのバックグラウンドノイズフィルタリングは精度を高める任意の切り替え機能です。エージェントを評価する際は両方をテストしてください。環境音が自然かを確認し、ノイズフィルターのオン・オフ両方でSTT精度を評価します。
MOSを算出する際は、これらすべての知覚的カテゴリで高得点を示す4.3~4.5を目指すべきです。人間による評価パネルを使わず大規模にMOSを予測するには、UTMOSやNISQAのようなツールを利用できます。
会話品質
会話品質は、音声品質とタスク完了の間に位置する複合的な柱です。音声エージェントがユーザーのニーズをどれだけ効果的に理解し、文脈に応じて割り込み、複数ターンの対話を通じて完了まで導けるかを測定します。
ここでの主要指標は意図分類精度です。一般的には85%~92%の範囲で、上位のモデルは96%以上に達します。85%は高く見えるかもしれませんが、それでもすべての受信トラフィックの15%が誤分類され、誤ったリソースに振り分けられることを意味します。
高い意図分類精度に寄与する技術的要素は次のとおりです。
- ターンテイキング:ターンテイキングは、音声エージェントが会話の自然な流れをどれだけ適切に管理できるかを示します。いつ聞き、応答し、追加の入力を待つべきかを判断できるかを評価します。また、ユーザーの割り込みに対応することも含まれます。これは、処理中の応答を取り消し、新しい入力に基づいて新たな応答を生成する機能です。ElevenLabsは、マルチコンテキストWebSocketを使用し、このような自然な割り込みをシームレスに処理します。
- レイテンシ:レイテンシは、ユーザーが発話を終えてからエージェントが音声応答を開始するまでのエンドツーエンドの遅延を表します。本番品質の音声エージェントでは、初回音声までの時間を500ms未満、より優れた水準としては300ms未満にすることを目標にすべきです。ElevenLabs Flashモデルは、業界をリードする約75msのモデル推論時間を提供し、このカテゴリでの成功を支えます。
- フォールバック率:フォールバック率は、AIエージェントがユーザーを理解できず、説明や繰り返しを求める頻度を表す指標です。これは主にSTT精度の下流の結果です。音声認識レイヤーが顧客の発言を聞き間違えたり誤って表現したりすると、LLMは破損した入力を受け取ります。フォールバック率は次の式で算出します。フォールバック率(%)=(フォールバック数/総インタラクション数)* 100。
ElevenLabs Scribe V2は、Artificial Analysisのスピーチtoテキストモデル評価でWER 2.2%の最低値を達成
Artificial Analysisのスピーチtoテキストモデル評価
会話品質を測定する方法の1つは、コンポーネントごとの業界ベンチマーク基準を見ることです。ご覧のとおり、ElevenLabsのScribe v2は、2026年6月時点で単語誤り率が2.2%と最も低く、聞き間違いとフォールバックが少なく、意図分類の精度が高いことを意味します。
会話品質は、音声エージェントが稼働するワークフローにも左右される場合があります。たとえばカスタマーサービスでは、エスカレーション時の引き継ぎ品質やFAQ解決も考慮すべきです。
ツール使用とタスク完了
品質が会話の体験を測るのに対し、タスク完了は会話が成功した結果につながったかを測ります。ビジネス成果と直接結び付いているため、企業は音声エージェント評価フレームワークのこの部分に特に注意を払うべきです。
ツール使用の指標の1つに、スロット充填精度があります。これは、顧客情報をフォームに入力するような比較的定型的なタスクを、AIエージェントがどれだけ適切に完了できるかを示します。スロット充填精度が高いほど、エージェントが途中で情報を失うことなく、会話からアクションへスムーズに移行できることを示します。
タスク成功率(TSR)は、エージェントがエンドツーエンドのタスクを正常に完了した割合を測る指標です。完了は、エージェントがリクエストを理解し、適切に接続されたツール(API、データベース、検索拡張生成(RAG)、社内ナレッジベース)を活用できるかに基づきます。
TSRの式は次のとおりです。
TSR =(完全に完了したタスク数/試行したタスク総数)x 100
本番運用に対応する音声エージェントは、ツール呼び出しの精度と信頼性を監視しながら、TSR 85%超を目標にすべきです。TSRの低下を防ぐため、プロンプトや接続モデルを変更した場合は必ず回帰テストを行ってください。わずかなずれでも、TSRに大きな影響を与える可能性があります。
インテリジェンス
インテリジェンスは、音声エージェントの推論能力と高次の能力を捉える柱です。音声主導のIVR(自動音声応答)と音声AIエージェントの違いを明確に示すのが、この柱です。
ここで評価すべき主な側面は次のとおりです。
- ハルシネーションのリスク:エージェントが不正確な情報や社内文書と矛盾する情報を生成するハルシネーションは、自信を持って伝えられる可能性があるため、音声AIでは特に有害です。最近の研究では、一般的なハルシネーションが音声エージェントに対する顧客満足度を大きく損なうことが示唆されています。
- スコープ外の処理:インテリジェントなエージェントは、質問が自身の文脈上の領域外であることを理解し、適切に応答できます。回答をハルシネーションするのではなく、回答を控えるか、会話を文脈として定義された領域へ戻します。
- コンテキスト保持:複数ターンにわたり、エージェントは以前に言及されたエンティティや約束を追跡できるでしょうか?この能力がなければ、顧客は同じ内容を繰り返す必要があったり、矛盾した応答を受けたりする可能性があります。
- 推論とマルチステップロジック:エージェントは条件付きロジックを正しく処理し、複数ターンにわたる推論をつなげられるでしょうか?特に、金融サービスのようなより技術的なユースケースでは、あらかじめ定義されたコンテキスト内で推論する能力が成功に不可欠です。
これらの側面とコンポーネントには、複数のサードパーティ製ベンチマークがあります。たとえば、スタンフォード大学のHolistic Evaluation of Language Models(HELM)は、さまざまなカテゴリでLLMのパフォーマンスをベンチマークします。ハルシネーションについては、TruthfulQAが、誤った回答がどの程度頻繁に応答へ混入するかを堅牢に分析します。
ElevenAgentsの利点の1つは、単一の基盤モデルに固定される一部の音声プラットフォームとは異なり、LLMレイヤーを完全に入れ替えられることです。実際には、特定のユースケースにおける推論ベンチマークで優れたモデルを組み込めます。
コンプライアンスとセーフティ
企業は、有害な出力やポリシー違反の出力を防ぐため、アクティブなガードレールを実装する必要があります。回避や上書きが可能なシステムレベルのプロンプト指示とは異なり、独立したガードレールチェックはモデル自体の外部にある別レイヤーとして実行されます。これらは出力がユーザーに届く前に評価し、危険な領域に入った場合は会話を停止します。
監査可能性も関連する要件です。本番環境のエージェントは、事後レビューを可能にする形式で、決定と出力の詳細なログを維持する必要があります。特に規制の厳しい業界では、後からコンプライアンスを証明できることは、そもそも遵守することと同じくらい重要です。
ビジネスが遵守すべき具体的な規制は、業界によって異なります。よく適用されるフレームワークには次のものがあります。
- HIPAA:米国の医療分野における保護対象の医療データ向け。
- PCI-DSS:決済カードデータを扱うすべてのエージェント向け。
- GDPR:EUおよびEUに顧客を持つ企業に対するデータプライバシー義務。
コンプライアンス体制を評価する企業向けに、ElevenLabsはAICPA SOC Type IIおよびGDPRに準拠し、AIUC-1認証も取得しています。AIUC-1は、AIエージェント向けに特化して設計されたセキュリティ標準です。
信頼性
信頼性は音声エージェント評価フレームワークの最後の柱であり、エージェントがリアルタイムで一貫して成果を提供できるかを扱います。
音声エージェントを評価する際は、次の特性を確認してください。
- 稼働時間:顧客向けの導入では、障害を避けるために99.9%の稼働時間が求められます。特にインバウンドサポートのような常時稼働のユースケースでは、信頼できる稼働時間が大きな要因です。
- グレースフルデグラデーション:音声エージェントは基盤となる構造が複雑であるため、1つのコンポーネントが障害を起こし始めた場合でも、その劣化を適切に処理する必要があります。実際には、負荷が増した状態やエラーを返しながら動作を続けるのではなく、人間へ引き継ぐことを意味します。
- 負荷時のパフォーマンス:負荷テストでは、本番稼働前に想定ピーク同時接続数の少なくとも2倍をシミュレートすることを目標にすべきです。高負荷でのテストにより、大規模な環境でのみ現れるレイテンシの増加やパフォーマンス低下を特定できます。
他のすべての要件を満たす高品質なモデルであっても、顧客需要に応じてスケールできなければ利用できない可能性があります。ElevenAgentsは100万人の主要クリエイターや企業から信頼されており、パフォーマンスベンチマークを損なうことなくエンタープライズ規模の導入を支援できるプラットフォームの能力を示しています。
音声エージェントのMOSを測定する方法(ステップバイステップ)
ビジネスでMOSを手動測定する場合は、多数の人間のリスナーと、実際の会話から取得した音声クリップの選定が必要です。これは、フィードバックの収集、平均化、データの解釈を含む構造化されたプロセスです。
音声エージェントのMOSを実務で測定する方法は次のとおりです。
- テストセットを準備する:さまざまな会話をカバーする、エージェントの音声出力から代表的なサンプルを選びます。少なくとも100件のクリップを用意してください。
- 評価セッションを実施する:人間のリスナーに、コミュニケーション体験の品質に基づいて各クリップを1~5の尺度で評価してもらいます。
- 評価を集計してスコアを算出する:各クリップの評価を平均し、さらにすべてのサンプルクリップで平均して、総合MOSを算出します。MOSが4.3以上であれば、音声エージェントは本番運用の準備ができていることを示します。
手作業は多くなりますが、このプロセスにより選択した音声エージェントの確かなMOSを得られます。大規模にテストしたい場合は、MOSスコアをプログラムで予測するNISQAのような自動ツールで人間のリスナーを置き換えられます。これらのシステムを稼働中のパイプラインに統合すれば、MOSを継続的に監視できます。
AIと人間のテストベンチマーク:FCR、AHT、CSAT
MOSを継続的に算出するとモデルの改善や劣化を確認できますが、人間のパフォーマンスをベンチマークすることで、さらなる文脈を得られます。類似した役割で人が実際に達成する水準を見ることで、音声エージェントが理想的なレベルに近いパフォーマンスを発揮しているかが分かります。
AIと人間のテストベンチマークで検討すべき指標をいくつか紹介します。
AIエージェントは、人間のFCRとCSATに匹敵しつつ、AHTを大幅に改善できる必要があります。後者が改善されるのは、AIエージェントが通常、人間のエージェントより一般的な会話を扱うためです。多くの企業では、AIエージェントを最初の対応者とし、自律的に処理するには複雑すぎる場合にのみ人間のエージェントへ通話を引き継ぐワークフローを導入しています。
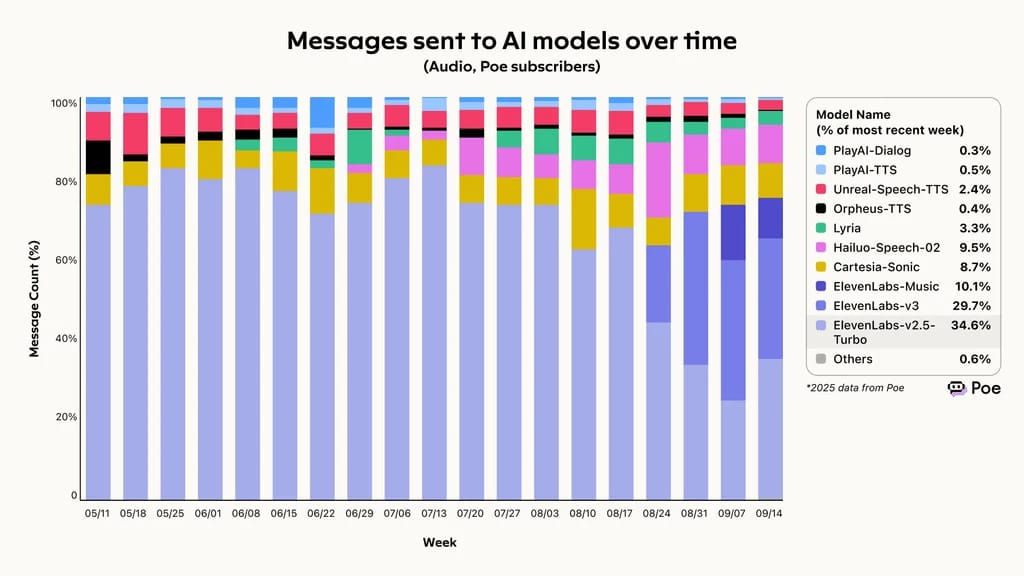
AI比較アグリゲーターであるPoeの2025年データによると、ElevenLabsはリクエストを満たす総合的な能力で最も優れた水準を維持しました。受信したすべてのリクエストの74.4%を完了しています。この成功により利用が急速に拡大し、Eleven v3とv2.5-Turboは、AIモデルに送信されるメッセージ全体の60%以上を占めています。
より優れた体験には、最も感情表現豊かなTTSモデルであるEleven v4をご利用ください。
Poeの音声エージェント評価フレームワークでElevenLabsがリード:AIモデルに送信されたメッセージの推移
Poeがベンチマークした、AIモデルに送信されたメッセージの推移
よくある音声エージェントテストのミス
音声エージェント評価フレームワークに従う際、最良のシナリオをテストしたくなりがちです。しかし実際には、顧客が日常的に音声AIシステムとやり取りする体験は、理想的な条件から生まれるものではありません。
よくある音声エージェントテストのミスと、その修正方法を3つ紹介します。
- 最も簡単な経路だけをテストする:特にMOS用の音声クリップを選ぶ際は、必ずエッジケースを含めてください。バックグラウンドノイズやアクセントのある発話を含むクリップは実生活で非常に一般的なため、「クリーンな」音声ファイルだけでテストするとMOSの校正を誤ります。
- 解決よりコンテインメントを優先する:ユーザーをエージェントシステム内にとどめるようモデルを最適化すると、成果を改善せずにコンテインメント率だけが上がります。コンテインメント率が高いにもかかわらずFCRが低い場合、エージェントは解決を提供せず、ユーザーを不満の残るループに陥らせています。希望するユーザーが人間のエージェントと話せる仕組みを用意してください。
- レイテンシのパーセンタイルを無視する:SLAでは、レイテンシをP95レベルで定めることがよくあります。この指標は大多数の顧客に一貫した体験を提供するうえで重要ですが、残りの5%も実在する顧客であることを忘れてはいけません。1日10,000件の通話を処理するシステムでは、5%でも500人が遅い会話を体験します。中央値やP95だけではなく、P99を主要なSLA目標にしてください。
これらを念頭に置くことで、理想化された平均値に頼るのではなく、公平で代表性のあるベースラインを確立できます。
ユースケース別評価が重要な理由
このフレームワークで示した6つの柱は、検討すべき領域の指針になりますが、各柱の重み付けは業界によって異なります。たとえば、金融サービス業界の企業はコンプライアンスとツール使用を優先する一方、消費者向けブランドはTTS音声品質を指針とするでしょう。
ユースケース別評価が実際にどのように機能し、各柱のバランスをどう変えるか、2つの例を紹介します。
カスタマーサポート
コールセンターのような特定の業界では、初回通話解決率(FCR)のようなタスク完了指標も重要です。人の介入なしに受電を正常に処理できれば、人間のカスタマーサービスエージェントにかかる需要を大幅に減らせます。McKinseyの推計では、音声エージェントを利用するコールセンターは、インタラクション量を最大50%削減できます。
タスク成功率ほど重要ではありませんが、ここで検討すべきもう1つの側面はコンテインメント率です。コンテインメント率は、通話の総継続時間を調べる指標です。コンテインメント率が非常に高い一方でFCRが低い場合、エージェントは顧客に解決を提供せずに通話を長引かせています。実際には、顧客が堂々巡りをするような不満の残る体験になりかねません。
追跡すべきほかの指標には、AIエージェントが定型的な問題を迅速に解決することを目指すAHTがあります。そのため、カスタマーサポート分野では、ほかの領域よりも、特にターンテイキングとフォールバック率を含む会話品質が優先されます。
医療
医療は厳しく規制された分野であり、厳格なコンプライアンス要件により音声エージェントの運用は非常に繊細です。コンプライアンスは中心的な懸念事項であり、フレームワークのセーフティの柱は、何よりもコンプライアンスとインテリジェンスに大きく重み付けされます。
医療チャットボットは、予約のスケジューリング、遠隔医療へのアクセス経路、症状のトリアージ、保険に関する質問を処理する必要があります。これらすべてには高度なインテリジェンスとツール使用が求められ、業界や役割に固有の要求が、どの柱が最も重要かに影響することを改めて示しています。
ビジネスの分野がどこであっても、音声エージェント評価の中核となる柱を理解し、バランスよく適用することで、自社に最適なエージェントを見つけやすくなります。
高パフォーマンス・低レイテンシのElevenAgentsで構築
構築に選ぶプラットフォームは、実際のワークフローにおける音声エージェントのパフォーマンスに直接影響します。特に顧客とやり取りする際には、エージェントがすべてのカテゴリで優れた成果を出せるという確信が必要です。
ElevenAgentsは、本番環境の音声導入向けに構築されています。Eleven v4による業界トップクラスのTTS、リアルタイムSTTであるScribe v2、そしてエージェントオーケストレーションレイヤーを組み合わせ、エンタープライズ規模に対応します。各コンポーネントは、このフレームワークで示したベンチマークに対応できるよう構築されており、顧客に高品質な体験を提供できます。
選択肢を検討中の場合も、すぐに構築を始める準備ができている場合も、ElevenLabsには最適な道筋があります。ElevenAgentsプラットフォームを確認してユースケースへの適合を確認するか、登録して、今すぐ構築を始めましょう。
音声エージェント評価に関するFAQ

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


