文字が音声のどこで発話されているかを文字起こしで把握する仕組み
- 執筆者
- Mike Murphy
- 公開日
- 最終更新日
テレビで映画を観ていて、放送トラブルのせいで俳優のセリフと字幕がまったくずれていたら、どれほど気が散り、物語への没入感が損なわれるかは想像に難くありません。音声モデルを使うビデオやソフトウェアにも同じ問題があります。字幕が1秒遅れて表示されたり、文字起こしで間違った単語がハイライトされたりすると、同じように不自然に感じられます。
「人間は、少なくとも単語レベルでは、メディアの位置合わせがかなり得意です」と、アラインメントに取り組むElevenLabsの研究者、Danila Kozlovは話します。「単語がどこから始まるかは感覚的にわかることが多いですが、文字レベルでサブミリ秒の精度となると、はるかに難しくなります。」
本日ElevenLabsは、オーディオファイル内のすべての文字を正確なタイムライン上に配置する強制アラインメントモデル、Cueについて詳しくご紹介します。CueはElevenLabsのScribeモデルファミリーを支えており、実際の録音では、ベンチマークの29言語すべてでElevenLabsがテストしたどのアライナーよりも高精度でした。また、長さを問わず録音を1回の処理で扱え、1時間分のオーディオを1秒未満でアラインできます。
強制アラインメントとは?
誰かからビデオと文字起こしを渡され、各単語を発話された瞬間と対応付けてほしいと頼まれたと想像してください。それが強制アラインメントです。ElevenLabsの文字起こしで単語をクリックすると、プレーヤーがその箇所へ正確に移動します。これはアライナーが処理しています。
ただし、強制アラインメントは、より曖昧な概念であるAIアラインメントとは異なります。AIアラインメントは、AIシステムの振る舞いが人々の価値観やビジネス上の好みに沿うよう設計することです。強制アラインメントで扱うのは、テキストと音声を対応付けることだけです。
Cueはスピーチtoテキストのパイプラインにおける最後のステップです。ElevenLabsのスピーチtoテキストモデルであるScribeがオーディオを文字起こしし、アライナーがタイミングを設定します。すべてのScribeリクエストはCueを通過します。同じモデルは、字幕、吹き替え、音楽の歌詞タイミングにも使われており、強制アラインメントAPIを通じて単体でも利用できます。
多くのプロダクトが依存しているため、アライナーには、対応するすべての言語での正確性、極めて高い処理速度、多数のリクエストを同時に処理できる能力が求められます。
従来のアライナーの課題
新モデル以前、チームはそれまでのすべてのElevenLabsプロダクトで使われてきたアライナーモデルを開発しました。強力なモデルではありましたが、新バージョンをさらに改善できると考えていました。Kozlovが加わると、彼とチームはまず、以前のアライナーを使う際に何が不満だったかを、ElevenLabsの顧客と社内ユーザーに聞くことから始めました。その不満は、チームがテストしたオープンソースツールの限界とも一致していました。
最初の大きな問題は長さです。現在の多くのアライナーは約30秒のクリップではうまく機能しますが、より長いファイルはチャンクに分割する必要があります。新しいチャンクごとにわずかなタイミング誤差が加わる可能性があり、チャンク間のつなぎ合わせでさらに誤差が増えることもあります。完全な録音では、Cueの平均タイミング誤差はわずか179ミリ秒であるのに対し、オープンソースツールでは283msから6,000ms超の範囲でした。
実環境で録音されたオーディオは、さらに難しい課題です。バックグラウンドノイズ、重なった発話、環境音楽があると、多くのツールはテキストとオーディオを対応付ける際に位置を見失います。しかし、完璧に静かな場所で暮らしている人はほとんどいないため、こうしたファイルこそ多くの人が文字起こししたいものです。バックグラウンドの問題がある英語の録音では、Cueの平均誤差は57msで、他のツールの65msから920msと比べて優れていました。
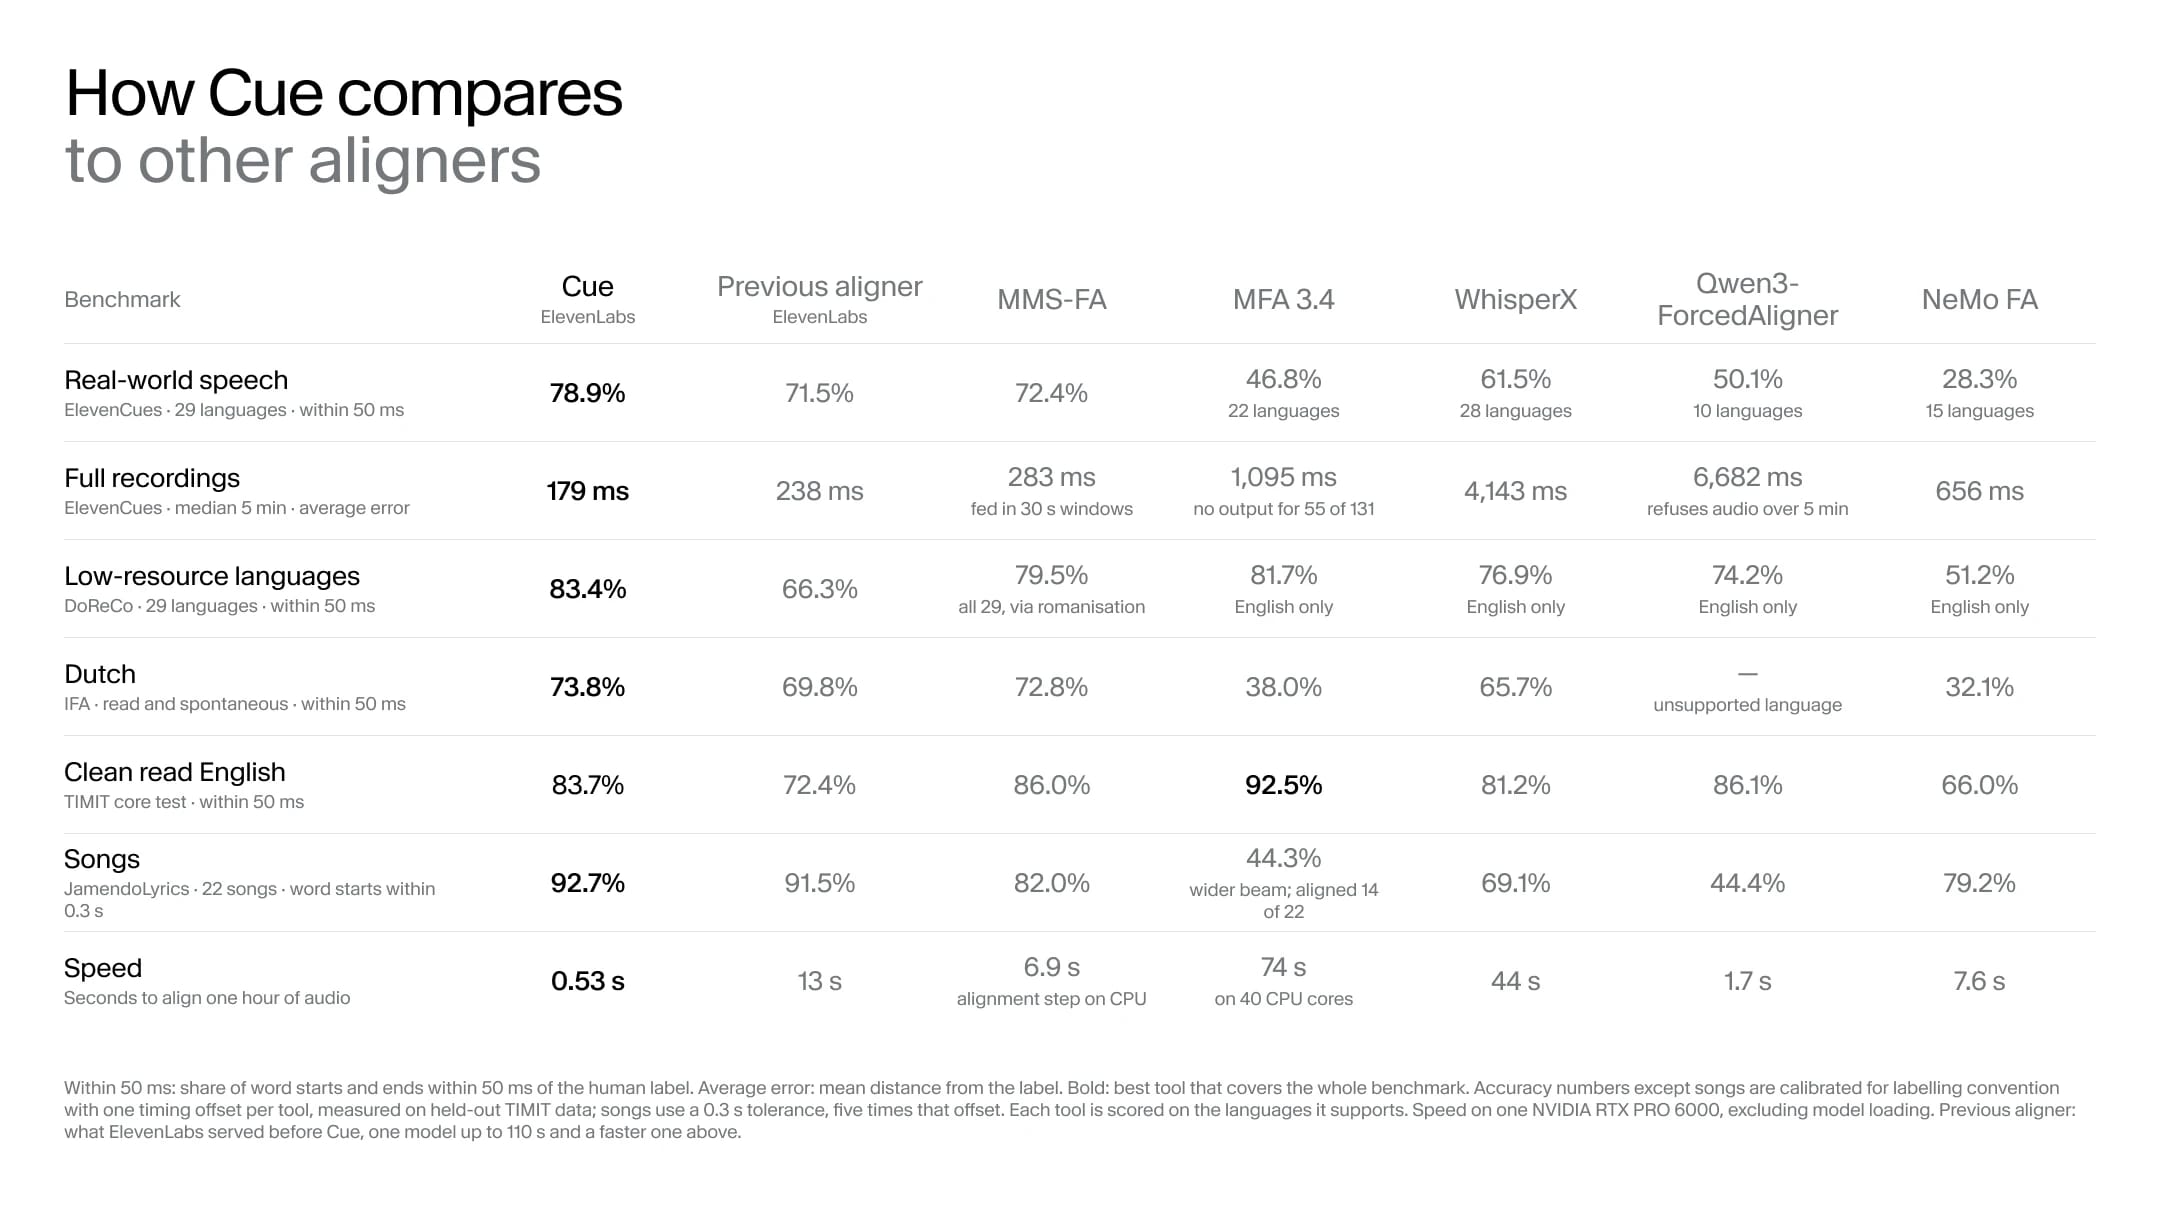
言語サポートも制約の一つです。ほとんどのオープンソースアライナーでは、対応する言語ごとに別のモデルが必要なため、学習データが少ない言語では性能が低くなったり、そもそもサポートされなかったりします。MMS-FAは、ベンチマークの29言語すべてを扱える唯一の他のツールですが、Cueは単語の境界を見つける速度も総じて優れていました。
大量のオーディオをアラインするとコストが急速に増えるため、これらのモデルでは速度も課題です。Cueは本番GPU上で、1時間のオーディオを約0.5秒でアラインできます。次に高速なツールであるQwen3-ForcedAlignerは約2秒かかり、テストした中で最も遅いツールは1分以上かかりました。
Cueの違い
Cueは、競合の大半とは異なり、90を超えるベンチマーク言語をカバーする単一モデルです。また、どの長さの録音でも1回の処理で扱えるため、長いファイルでタイミング誤差が蓄積する原因となるチャンク分割を避けられます。
ピンチまたはControlキーを押しながらスクロールしてズームします。横にスワイプするか、Shiftキーを押しながらスクロールして表示を移動します。単語にフォーカスしている場合は、プラスとマイナスでズームし、Shiftキーと左右の矢印キーで表示を移動できます。
単語を選択すると、その文字を確認できます
多くのモデルは性能の向上に伴って大規模化してきましたが、Cueは以前のElevenLabsのアライナーより小さいモデルだとKozlovは言います。それでもGPU上で動作し、1時間のオーディオを約0.5秒でアラインします。
チームは、人々が実際にアップロードする種類のオーディオを中心にCueを構築しました。以前のアライナーを基準として、実際のリクエストからベンチマークを作成し、ツールが配置できなかった単語をすべてエラーとして数える同じ方法で、各ツールを評価しました。Cueは、ほとんどのベンチマークで使われる単語レベルのラベルより細かい文字レベルで動作するため、これらのスコアはCueの精度を実際より低く見積もっている可能性があります。
「ある時点で、人間の能力の水準に達します」とKozlovはアライナーモデルについて語ります。「現在のアライナーはその水準を超えているため、完全に正しいのか、どれほど正確なのかを検証するのはずっと難しくなります。基準となる完璧なベンチマークがないからです。文字レベルのシステムを評価するために単語レベルのベンチマークを使わなければならず、Cueの真の性能を必ずしも十分に示せているわけではありません。」
Cueの品質は、ElevenLabsがユーザーフィードバックに迅速に対応できることも示しています。Cueの展開後まもなく、ある顧客から、ジョージア語やその他のリソースが少ないいくつかの言語で、性能が期待を下回っているとの連絡がありました。ElevenLabsでは、研究チームをプロダクトを利用するチームや顧客の近くに置いているため、問題をすばやく把握し、可能なモデル改善を研究し、新バージョンのモデルをトレーニングしてリリースできました。顧客が最初に問題を報告してから24時間以内のことでした。
楽曲のアラインメント
歌唱では単語が引き伸ばされたり曖昧になったりするため、音楽は難しく、うまく扱えるモデルはほとんどありません。チームもCueがこれほど対応できるとは予想していませんでした。Cueは、クリエイティブ・コモンズ・ライセンスのJamendoLyrics MultiLangデータセットに含まれる楽曲の一部をアラインできました。英語、フランス語、スペイン語、ドイツ語で、1回の処理で、驚くほど高い精度を実現しました。ラベルから0.3秒以内に92.7%の単語を配置し、次点のツールの82.0%を上回りました。
Cueの平均開始誤差は0.82秒で、最も近い競合の約半分でした。22曲中少なくとも19曲で、他のすべてのツールより高精度でした。お気に入りの新曲をリリース当日にカラオケで歌える可能性は大きく広がります。
Cueを今すぐ試す
Cueはすでに、ElevenLabsのすべてのスピーチtoテキスト文字起こしを支えています。直接利用するには、強制アラインメントAPIをお試しください。
謝辞
ElevenLabsのアライナーモデルに関する取り組みは、社内の多くの人々の協力なくして実現しませんでした。チームは、共同創業者兼CTOのPiotr Dąbkowski、研究者のDanila Kozlov、Luca Lanzendörfer、Flavio Schneider、Max Levi、Tim von Känel、Angelos Perivolaropoulosをはじめ、旧バージョンと新バージョンのモデルに携わったすべての方々に感謝します。また、データオペレーションのAni Janelidze、Forward Deployed Engineerチームとサポートチーム、このブログのビジュアライゼーションを手がけたLorenzo Dossiにも感謝します。
Mike MurphyはElevenLabsブログの主任編集者兼ライターです。複雑な研究やテクノロジーを、明快で説得力のあるストーリーに変えています。ElevenLabs入社前は、Quartzを含む複数のメディアでテクノロジー記者として長年活動し、IBM Researchではコンテンツ部門を率いていました。ノースウェスタン大学でジャーナリズムの修士号を取得しています。