Infrastructure d’IA vocale : la stack 2026 expliquée
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
L’infrastructure d’IA vocale regroupe les modèles, connexions, outils et services qui permettent à un agent IA d’écouter un appel, de décider quoi faire, d’agir dans d’autres systèmes et de répondre à voix haute. Avec des fournisseurs comme ElevenLabs, tout cela se produit en une fraction de seconde.
Un agent vocal en production repose sur une stack incluant la reconnaissance vocale, la gestion des tours de parole, un grand modèle de langage, l’orchestration, les outils, la récupération de connaissances, la synthèse vocale, la téléphonie et le monitoring.
Ce guide explique l’architecture d’agent IA derrière un agent vocal opérationnel. Chaque section décrit le rôle d’une couche, son importance dans l’infrastructure et son implémentation par ElevenAgents, avec Eleven v4 comme exemple de couche vocale.
Comment s’articule l’infrastructure d’IA vocale
Un agent vocal convertit l’audio en texte, raisonne à partir de cette entrée, génère une réponse, puis la reconvertit en audio entendu par le client. Cette succession d’actions repose sur une solide stack d’architecture d’agent IA.
Voici les principales couches qui composent l’infrastructure d’IA vocale en 2026 :
- Reconnaissance vocale : La technologie Automatic Speech Recognition (ASR) convertit l’audio de l’appelant en texte à traiter.
- Gestion des tours de parole : La gestion des tours de parole détermine quand l’appelant a terminé et quand cesser de parler, pour une conversation plus fluide et réactive.
- Modèle(s) de langage : Interprète la demande transcrite et génère une réponse après avoir récupéré le contexte nécessaire.
- Orchestration : Une couche d’orchestration IA achemine la conversation entre prompts, sous-agents, outils et intervenants humains.
- Outils et MCP : Connectent l’agent à des systèmes externes, tels que des plateformes CRM ou des centres de contact, afin d’exécuter des tâches.
- Connaissances et mémoire : Fournissent des faits et le contexte de l’appelant via la génération augmentée par récupération.
- Synthèse vocale : Utilise Text to Speech pour transformer la réponse générée en audio.
- Transport et téléphonie : Transporte l’audio entre l’agent et l’appelant.
- Garde-fous, tests et monitoring : Maintiennent l’agent dans son périmètre et permettent de le mesurer.
Ensemble, ces composants créent des conversations en temps réel entre les agents IA et les clients qui appellent.
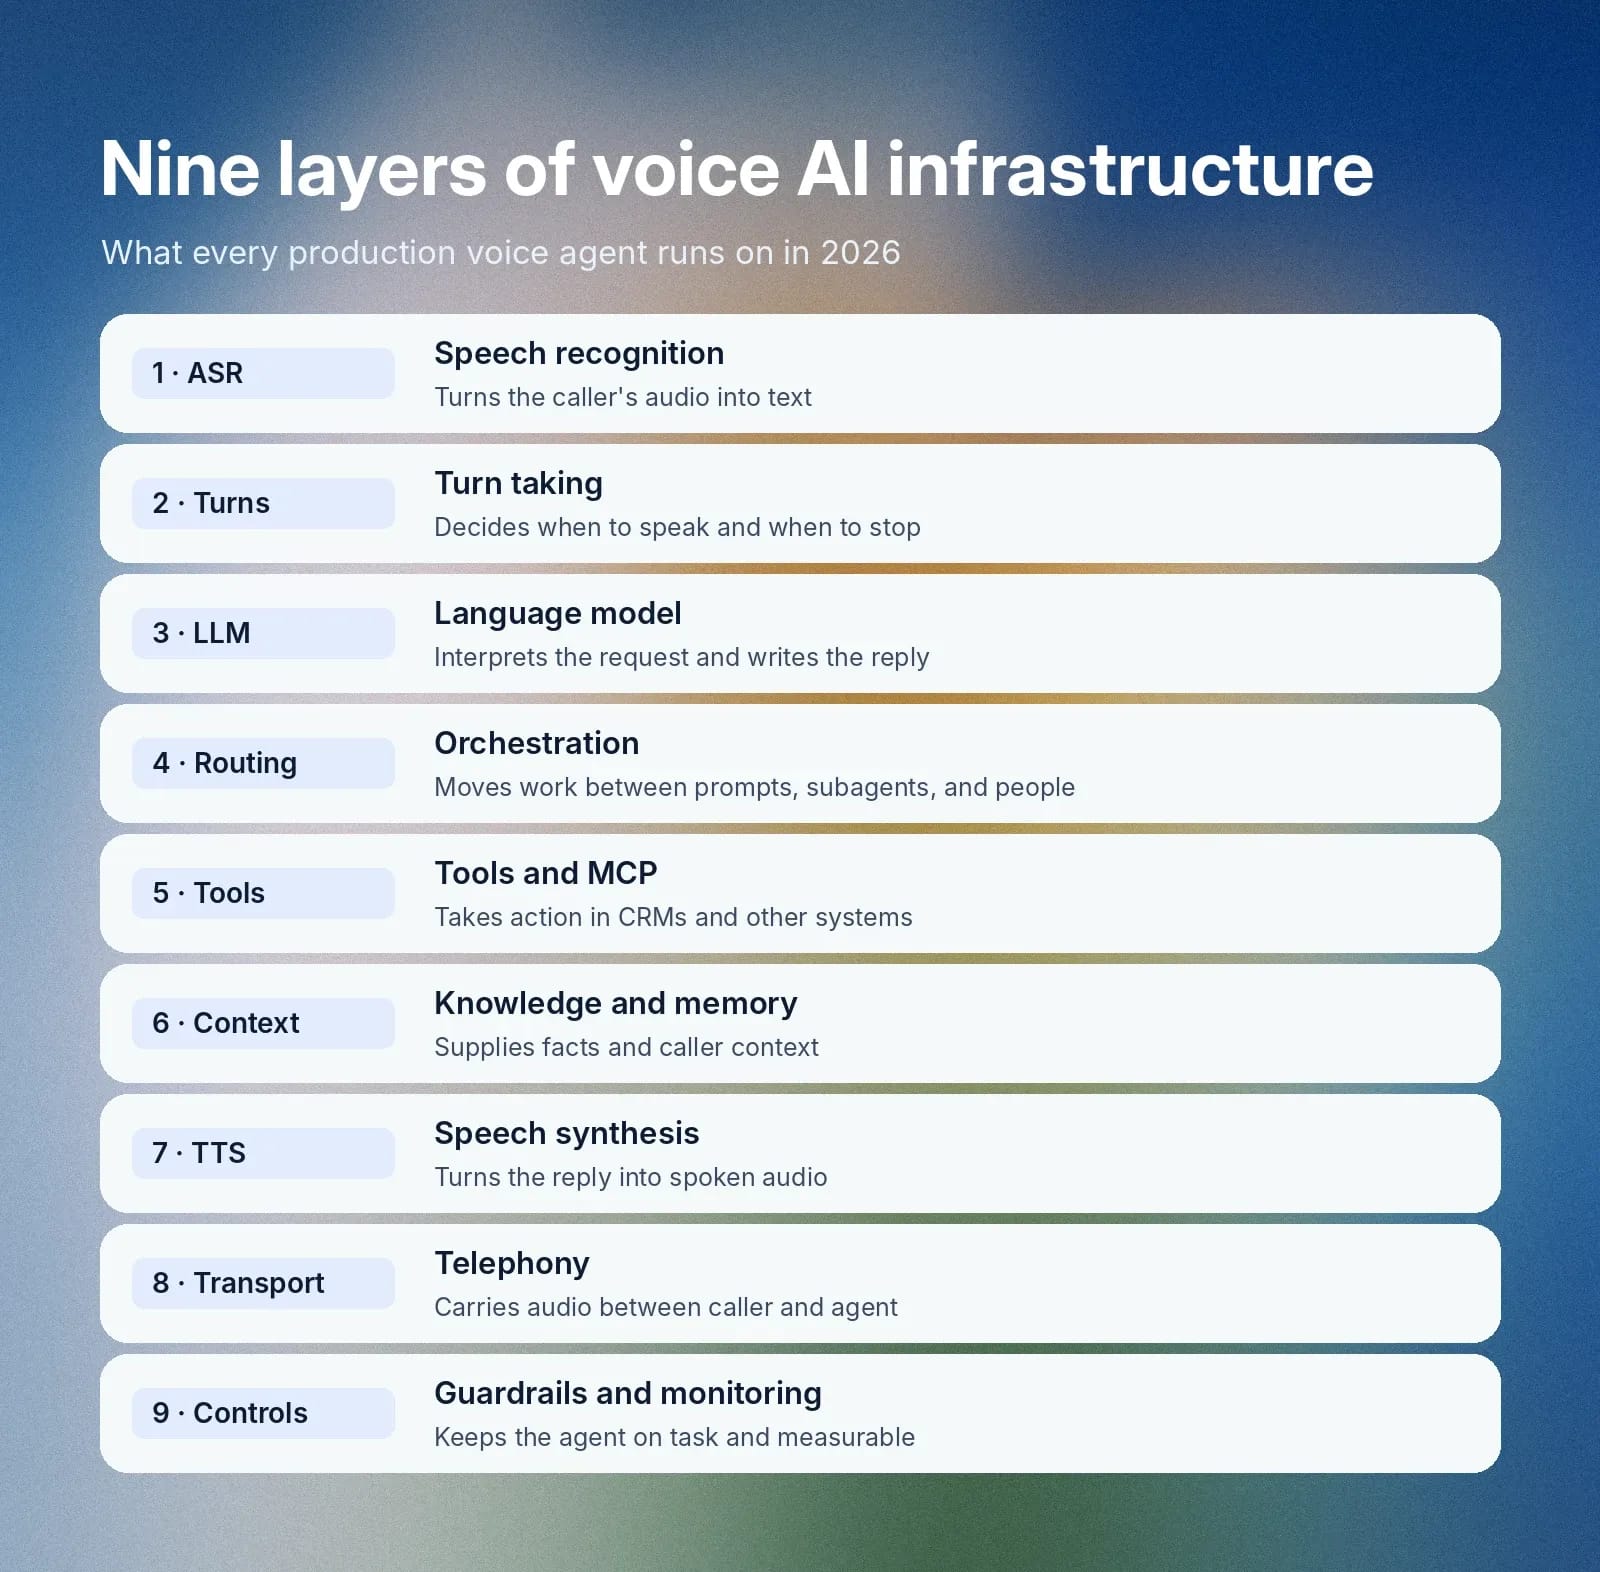
Schéma d’architecture d’IA vocale
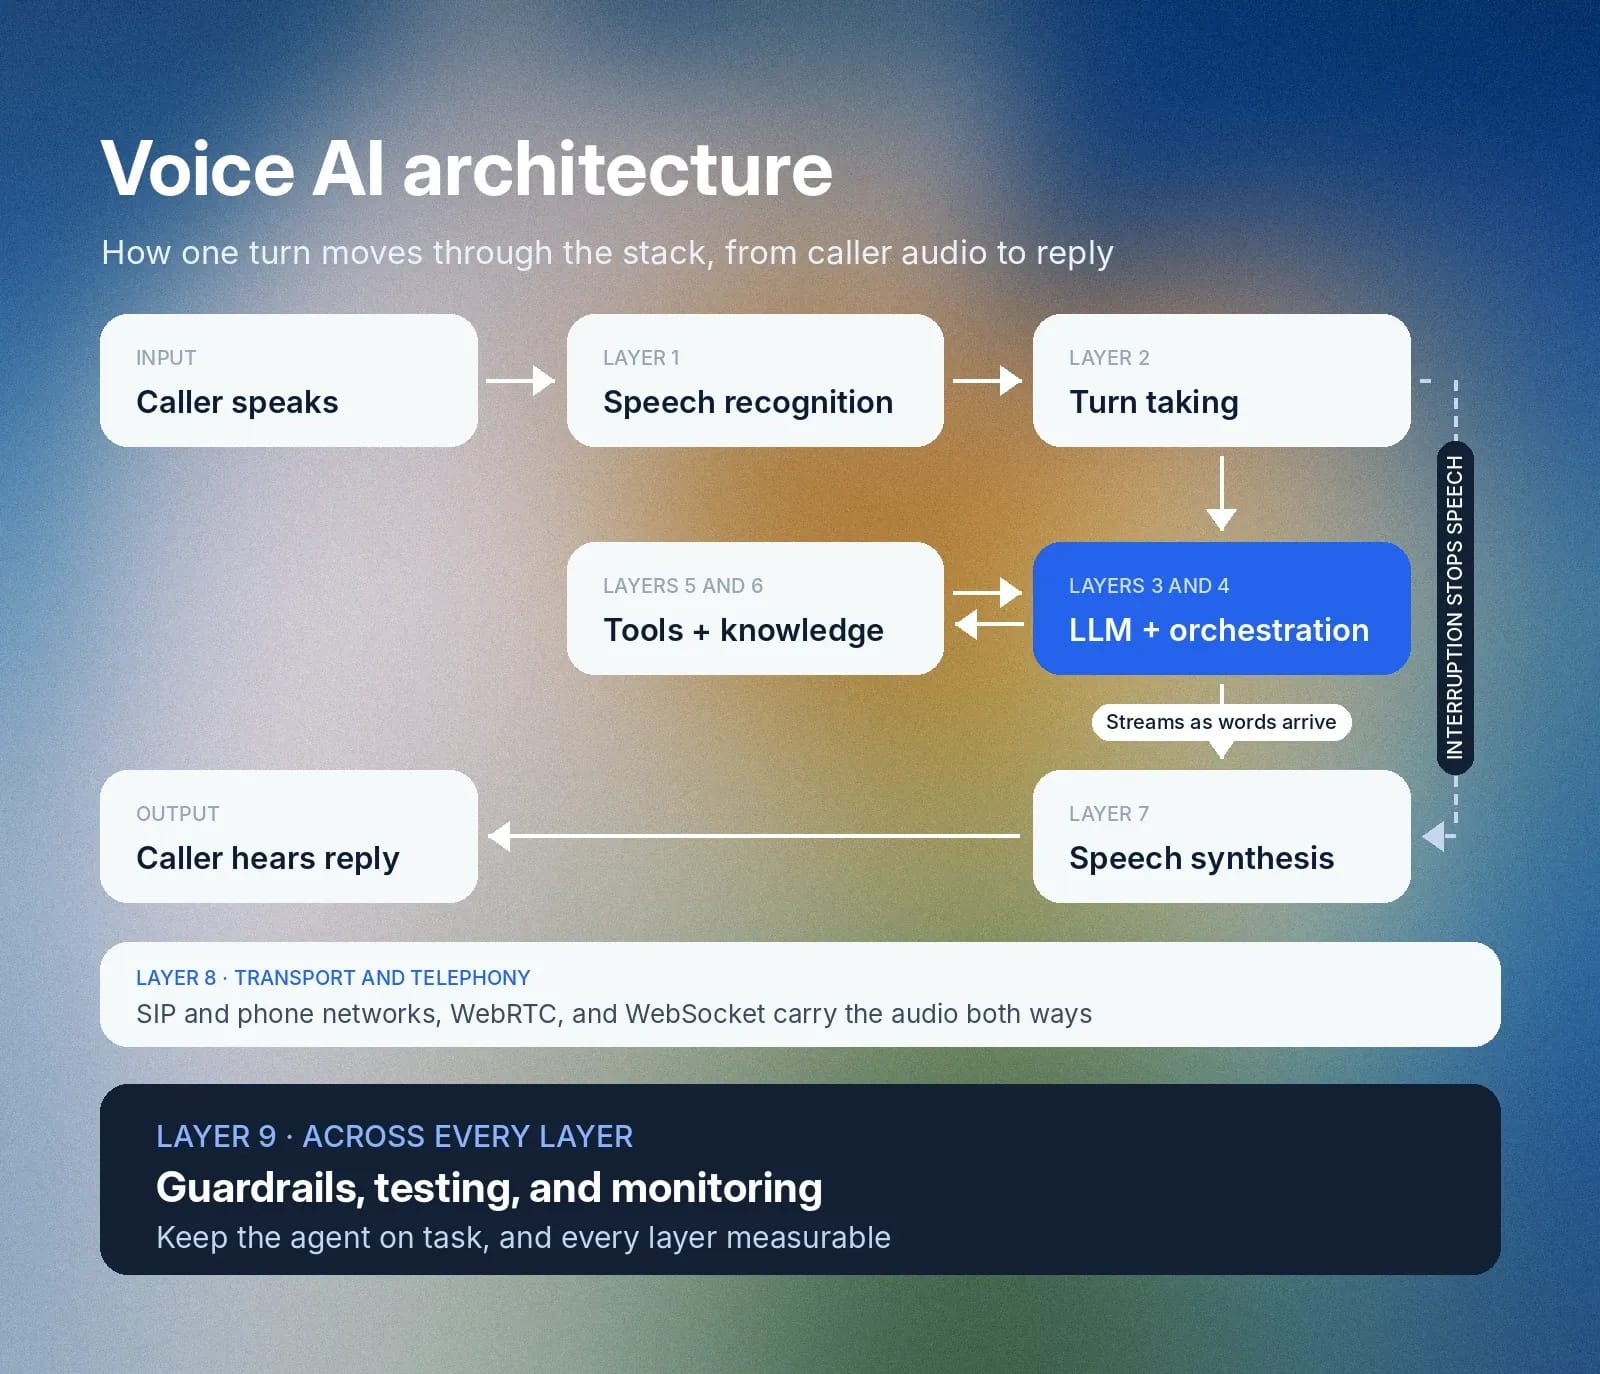
Le flux n’est pas linéaire. ElevenAgents commence à parler après avoir reçu « suffisamment de mots et une virgule » du modèle de langage : l’audio démarre donc avant que la réponse complète existe. Les appels d’outils et la récupération s’exécutent au milieu d’un tour. L’agent gère naturellement les interruptions pendant qu’il génère la parole.
Deux façons de concevoir une architecture d’IA vocale
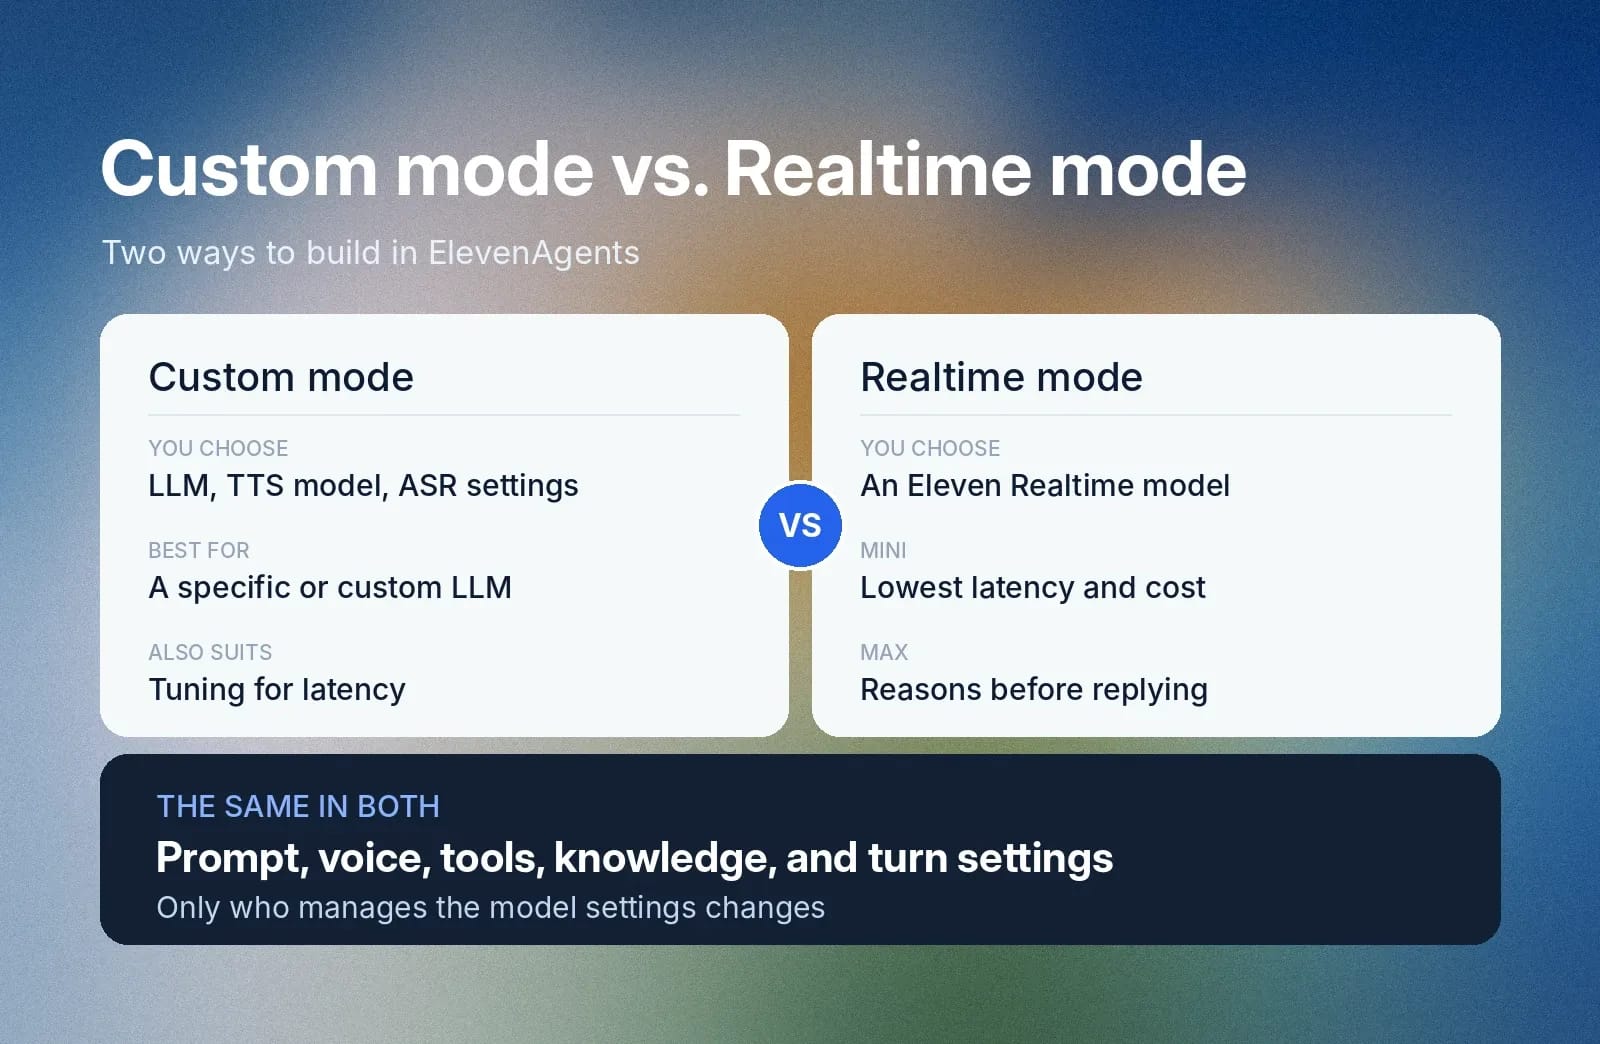
ElevenAgents propose deux modes vocaux. En mode Custom, vous choisissez vous-même le modèle de langage, le modèle Text to Speech et les paramètres de reconnaissance vocale.
En mode Realtime, vous sélectionnez un modèle Eleven Realtime et ElevenLabs gère ces paramètres. Eleven Realtime v1 Mini est le modèle par défaut, avec la latence et le coût les plus faibles. Eleven Realtime v1 Max raisonne avant de répondre, ce qui convient aux instructions complexes et aux cas exigeant plusieurs appels d’outils.
Le prompt système, la voix choisie, les outils, la base de connaissances associée et les paramètres de tour fonctionnent de la même manière dans les deux modes. Le mode Custom est préférable si vous avez besoin d’un modèle de langage précis, d’un LLM personnalisé ou d’un modèle TTS spécifique, pour les performances ou l’optimisation de la latence.
Reconnaissance vocale : transformer l’audio en texte
La reconnaissance vocale, aussi appelée ASR ou speech to text, est la première couche de la stack.
Son rôle
Le modèle transcrit en continu l’audio de l’appelant pendant qu’il parle. Le reste du pipeline peut ainsi démarrer avant la fin de la phrase, ce qui réduit la latence. Les modèles avancés gèrent les accents marqués, différents débits de parole et le bruit de fond.
Pourquoi elle compte pour l’infrastructure d’IA vocale
La transcription est sans doute l’une des couches les plus importantes de la stack, car toute erreur se propage aux étapes suivantes. Une référence de réservation mal entendue ? Le mauvais dossier client est traité. Un médicament mal identifié ? Les conséquences peuvent être graves.
Dans son Trust Framework for Healthcare, ElevenLabs montre l’enjeu d’une seule syllabe mal entendue : hydroxyzine contre hydralazine.
Comment ElevenAgents l’implémente
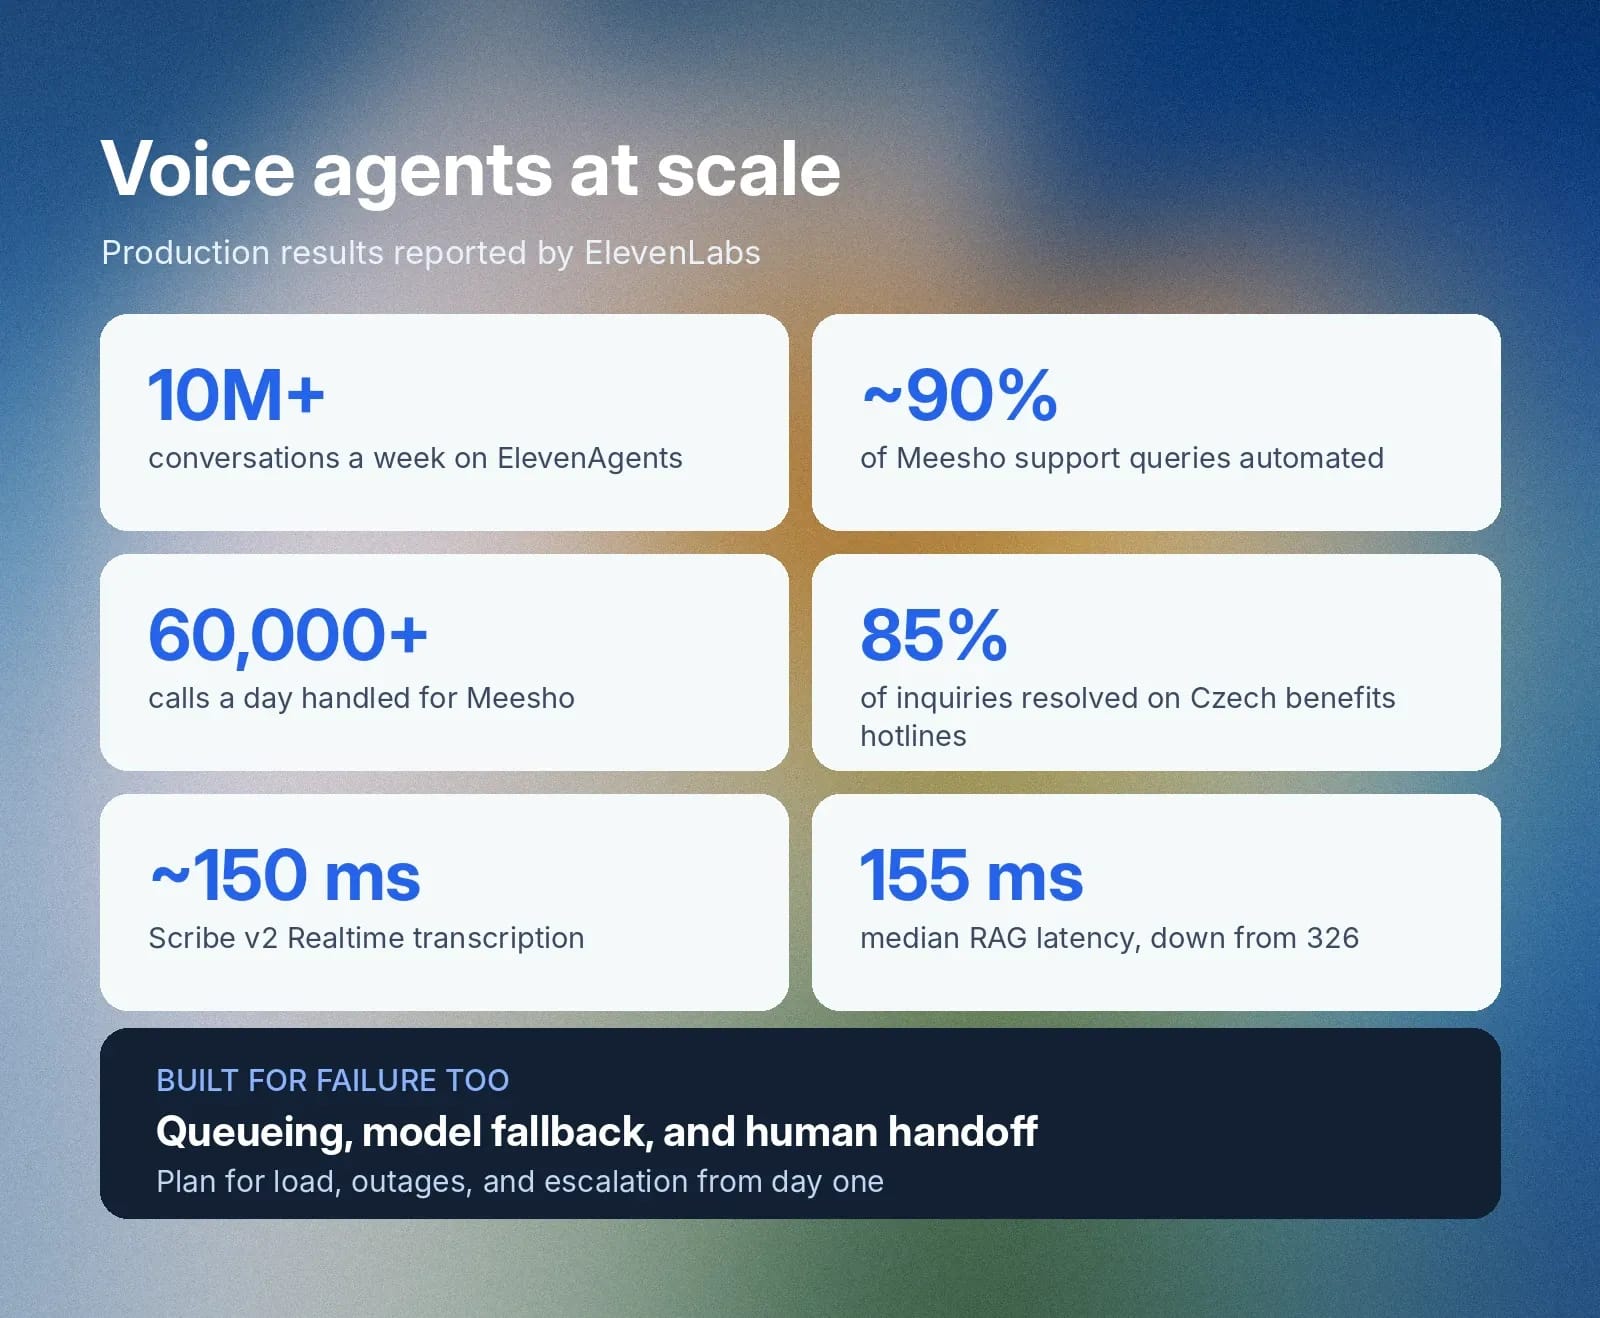
ElevenAgents utilise Scribe v2 Realtime, qui transcrit la parole en environ 150 ms. ElevenLabs l’a entraîné pour les environnements bruyants, les accents variés et les identifiants tels que les noms, emails et ID. Sur le benchmark multilingue FLEURS, couvrant 30 langues, ElevenLabs a signalé le taux d’erreur sur les mots le plus faible de tous les modèles ASR à faible latence.
Vous l’activez dans la section Advanced de la configuration de l’agent. Dans le même livre blanc, ElevenLabs indique que Scribe v2 Medical devance tous les modèles sur le benchmark public Eka Medical ASR, avec un taux d’erreur sur les mots de 7,0 % à la date de publication.
Une transcription précise et rapide fournit aux couches suivantes des données propres sans ajouter de latence significative.
Gestion des tours de parole : savoir quand parler et s’arrêter
La gestion des tours de parole est l’ensemble des règles qui détermine quand l’agent répond et quand il écoute. C’est sa capacité à comprendre efficacement les tours de conversation et à agir en conséquence qui distingue une conversation d’un menu téléphonique SVI classique.
Son rôle
Un composant de gestion des tours de parole apporte plusieurs fonctions à l’infrastructure d’IA vocale :
- Détection d’activité vocale (VAD) : La VAD classe l’audio entrant comme parole ou silence, des dizaines de fois par seconde.
- Détection de fin de tour : Détermine si l’appelant a terminé à partir du ton, du rythme et du contexte des mots.
- Barge-in : Permet à l’appelant d’interrompre l’agent, qui cesse alors de parler pour le laisser poursuivre.
- Signaux d’écoute : Brèves marques d’acquiescement comme « oui » qui ne prennent pas le tour de parole.
Pourquoi c’est important
Dans une conversation humaine, l’intervalle typique entre deux locuteurs est d’environ 200 ms. Un agent qui répond trop tôt coupe la parole, tandis qu’un agent qui attend trop longtemps crée des silences donnant l’impression d’un appel défaillant ou sans réponse.
Prenez un appelant qui dit : « Je voudrais réserver vendredi après-midi, mais… » puis marque une pause. Un minuteur de silence répond pendant cette pause et manque la précision. Un modèle qui interprète les mots et le rythme attend, laissant l’utilisateur terminer : « Ce ne peut pas être entre 15 h et 17 h, car je serai occupé. »
Un agent interprète mal l’intention de l’appelant et planifie le rendez-vous au mauvais horaire. L’autre, doté d’une gestion efficace des tours de parole, évite le créneau spécifié.
Comment ElevenAgents l’implémente
ElevenAgents exécute un modèle propriétaire de gestion des tours de parole qui analyse le ton, le rythme et le contexte des mots, au lieu de s’appuyer uniquement sur des minuteurs de silence. Lorsqu’un appelant interrompt, le signal qui arrête l’agent arrive en moins de 200 ms.
ElevenLabs mesure une médiane d’environ 150 ms entre la requête et la parole audible avec Eleven v4 Turbo sur ElevenAgents.
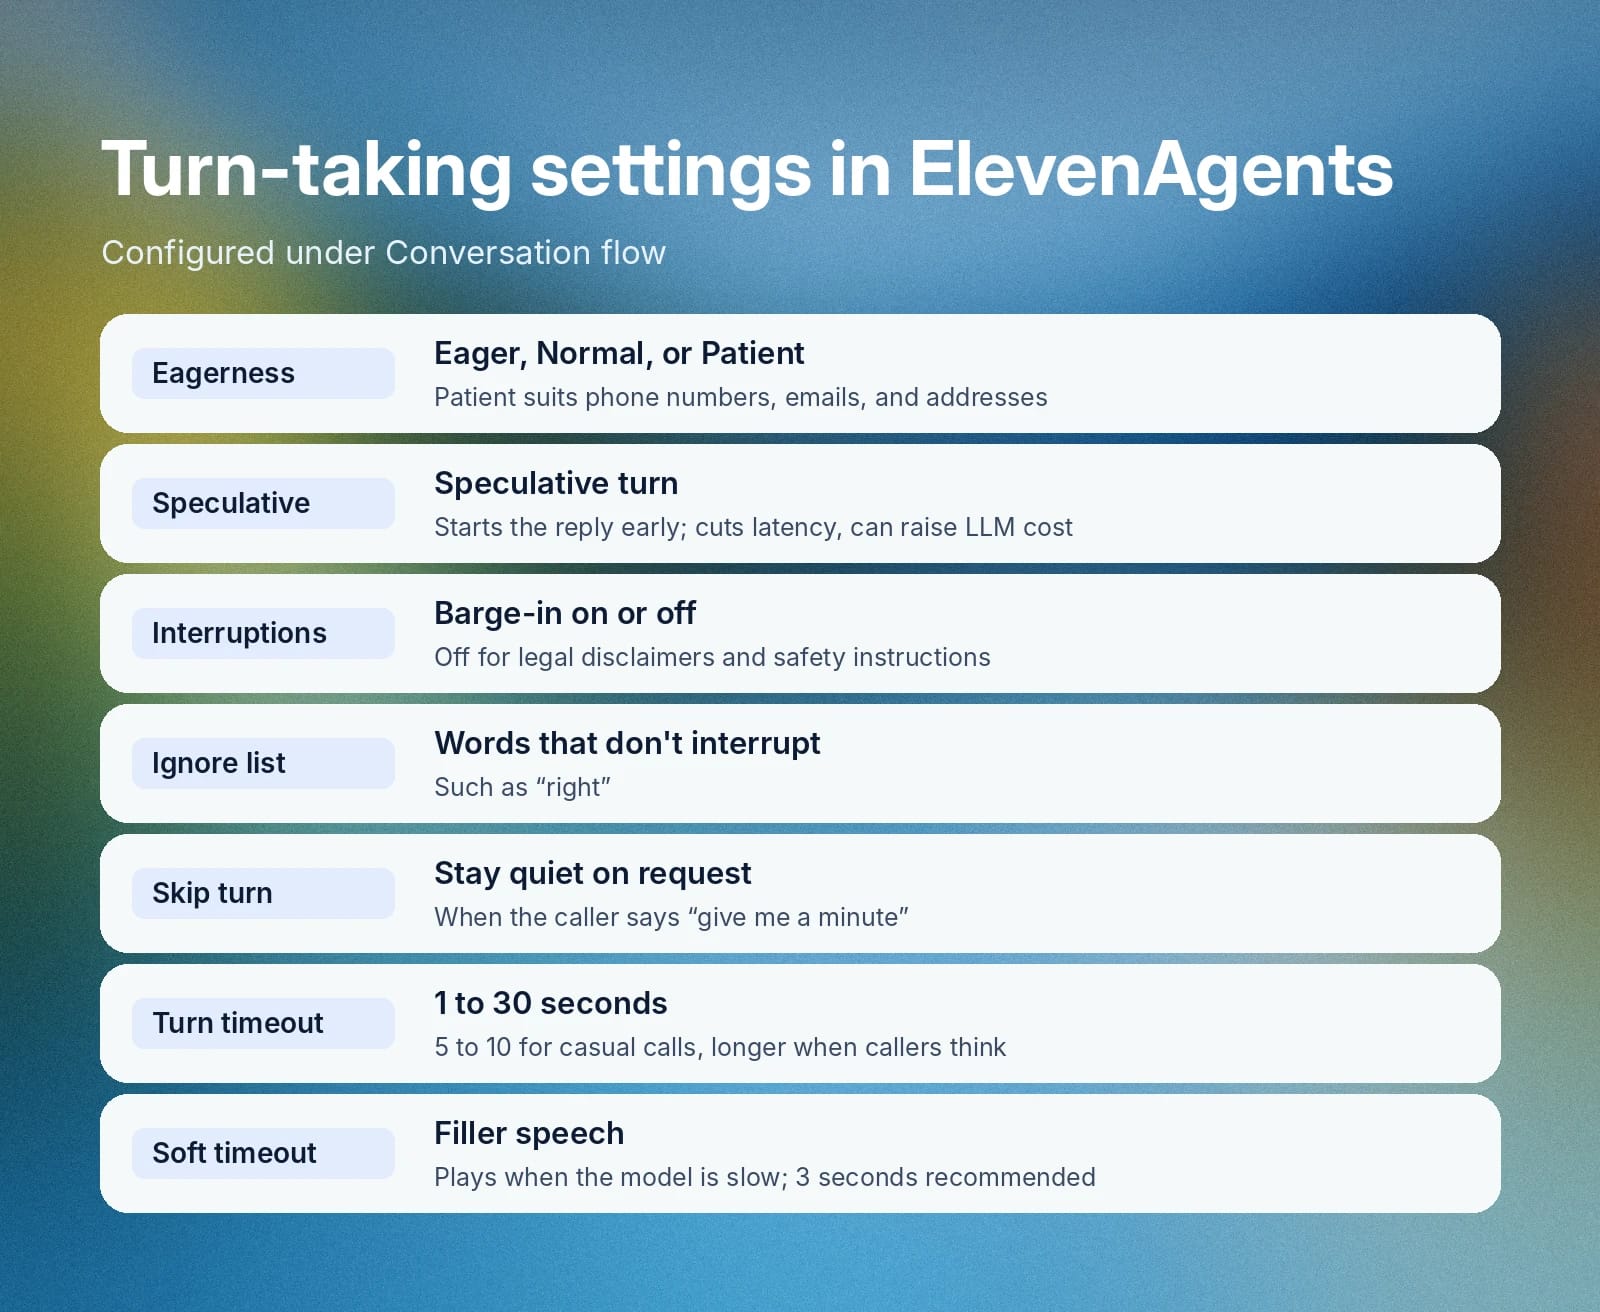
Le comportement est configurable via Conversation flow :
Paramètre
Ce qu’il contrôle
Réactivité du tour
Eager répond dès que possible. Normal est le réglage équilibré par défaut. Patient attend davantage, ce qui convient aux numéros de téléphone, adresses et emails.
Tour spéculatif
Démarre la réponse du modèle de langage avant confirmation que l’appelant a terminé. Il réduit la latence, mais peut augmenter le coût du LLM.
Interruptions
Désactivez-les lorsque chaque mot doit être entendu, par exemple pour les mentions légales et les consignes de sécurité.
Liste d’exclusion
Mots tels que « d’accord » qui ne doivent pas interrompre l’agent.
Outil Skip turn
Garde l’agent silencieux lorsque l’appelant dit : « Donnez-moi une minute. »
Délai d’expiration du tour
Prend le tour après 1 à 30 secondes de silence. Utilisez 5 à 10 secondes pour les conversations informelles et 10 à 30 secondes lorsque les appelants doivent réfléchir.
Délai d’attente souple
Joue une phrase d’attente telle que « Hhmmmm… oui. » lorsque le modèle est lent. Plage de 0,5 à 8 secondes, 3 secondes recommandées.
Détection d’environnement bruyant
Un paramètre Enterprise qui détecte les voix en arrière-plan et demande à l’appelant de se déplacer dans un endroit plus calme, au plus une fois par conversation.
Les workflows peuvent modifier la réactivité du tour en cours d’appel. Votre client reçoit également un événement vad_score, soit une probabilité de 0 à 1 que l’utilisateur parle.
Une gestion des tours de parole bien réglée détermine si les appelants perçoivent l’agent comme attentif ou abrupt. Retrouvez de plus amples informations dans notre guide complet sur la gestion des tours de parole.
Le modèle de langage : raisonner et générer la réponse
Le grand modèle de langage (LLM) est la couche de raisonnement. Il lit la transcription, les instructions et la conversation en cours, puis rédige une réponse ou décide d’appeler un outil.
Son rôle
Un bot vocal scripté reconnaît quelques commandes. Un LLM interprète des demandes formulées de nombreuses façons, conserve le contexte entre les tours et décide quand récupérer des informations ou effectuer un transfert.
Pourquoi c’est important
Les modèles diffèrent par la profondeur de leur raisonnement, leur vitesse et leur coût. Dans une conversation vocale en direct, le temps de réponse compte autant que la qualité de la réponse : le choix du modèle est donc une décision de latence et de coût.
Comment ElevenAgents l’implémente
ElevenAgents vous offre une interface unique pour les modèles de Google, OpenAI et Anthropic, ainsi que des modèles ouverts hébergés par ElevenLabs. Vous pouvez aussi connecter votre propre LLM en spécifiant un endpoint et en stockant les identifiants comme secrets. ElevenLabs répercute les coûts des LLM tiers au tarif public du fournisseur, sans marge.
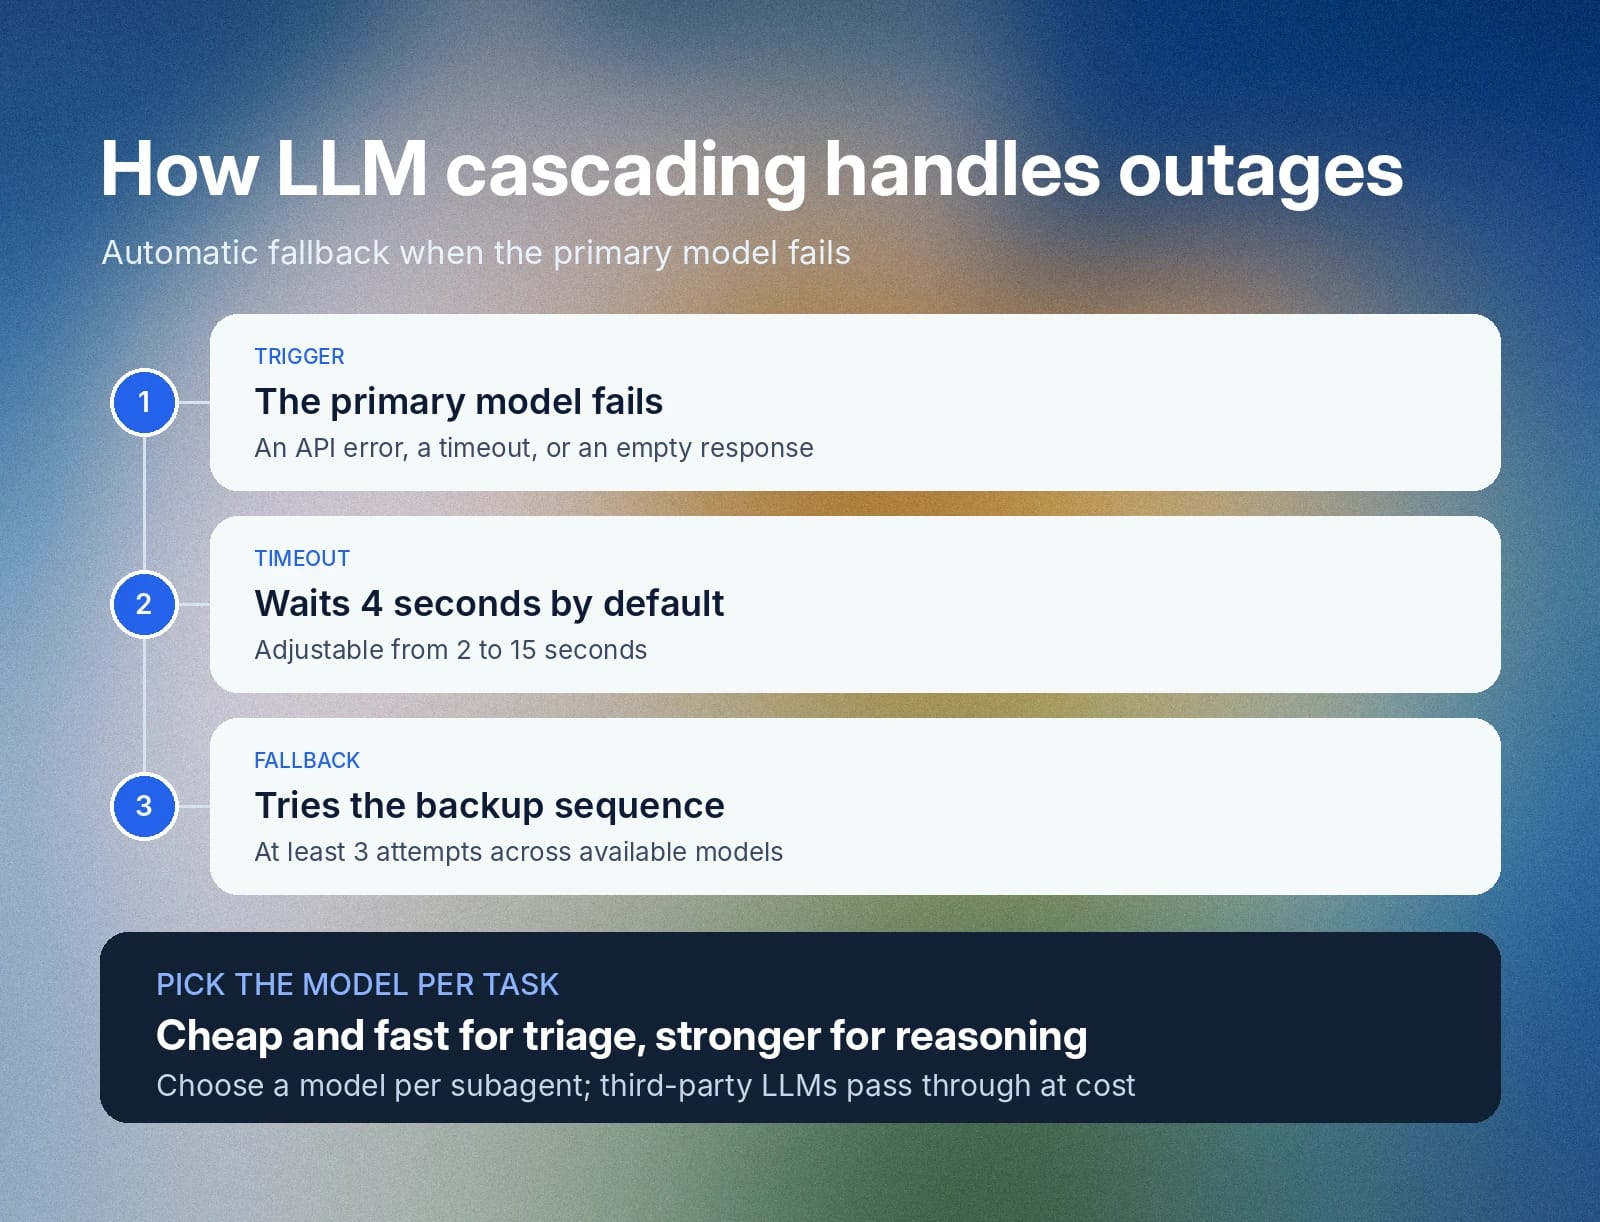
Vous pouvez choisir le modèle pour chaque sous-agent. Le volume 2 de The Enterprise Conversational Agent Playbook recommande de réserver les modèles les plus performants aux raisonnements complexes et d’utiliser des modèles moins coûteux à faible latence pour des tâches telles que la classification d’intention et les FAQ.
Les fournisseurs connaissent des pannes. Le chaînage de LLM les gère : si le modèle principal renvoie une erreur API, expire ou envoie une réponse vide, ElevenAgents essaie une séquence de secours. Le délai par défaut entre le modèle principal et le modèle de secours est de 4 secondes, réglable de 2 à 15 secondes, et le système effectue au moins 3 tentatives parmi les modèles disponibles.
Un LLM personnalisé utilisé comme modèle principal réessaie au moins 3 fois, sauf si vous définissez votre propre ordre de secours. Le bon modèle pour chaque tâche permet de garder l’agent rapide et abordable.
Orchestration : acheminer le travail entre agents et intervenants humains
L’orchestration des agents coordonne les prompts, sous-agents, outils et personnes impliqués dans l’exécution d’une tâche. Elle détermine la suite à chaque étape de l’appel.
Son rôle
Un agent avec un long prompt devient difficile à gérer à mesure que les responsabilités s’accumulent. L’orchestration divise le travail en étapes, chacune avec ses instructions, son modèle et ses outils, et fait passer l’appelant de l’une à l’autre.
Pourquoi c’est important
Les prompts plus courts sont plus faciles à tester et moins coûteux à exécuter, car chaque interaction charge moins de texte. Scinder un flux permet à un modèle économique de gérer le triage et les FAQ, puis de transférer vers un modèle plus puissant uniquement lorsque nécessaire.
Comment ElevenAgents l’implémente
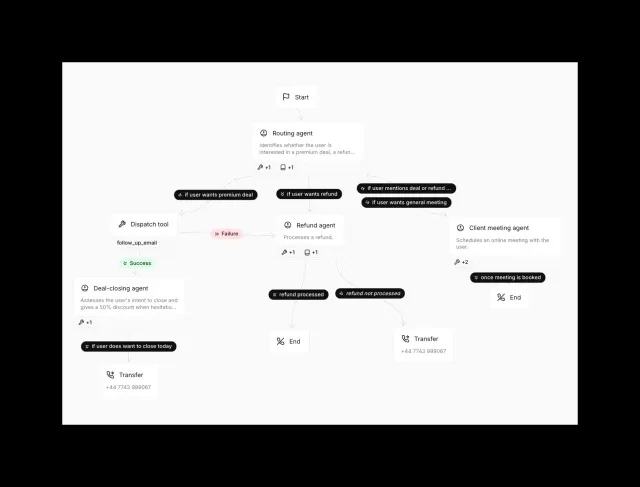
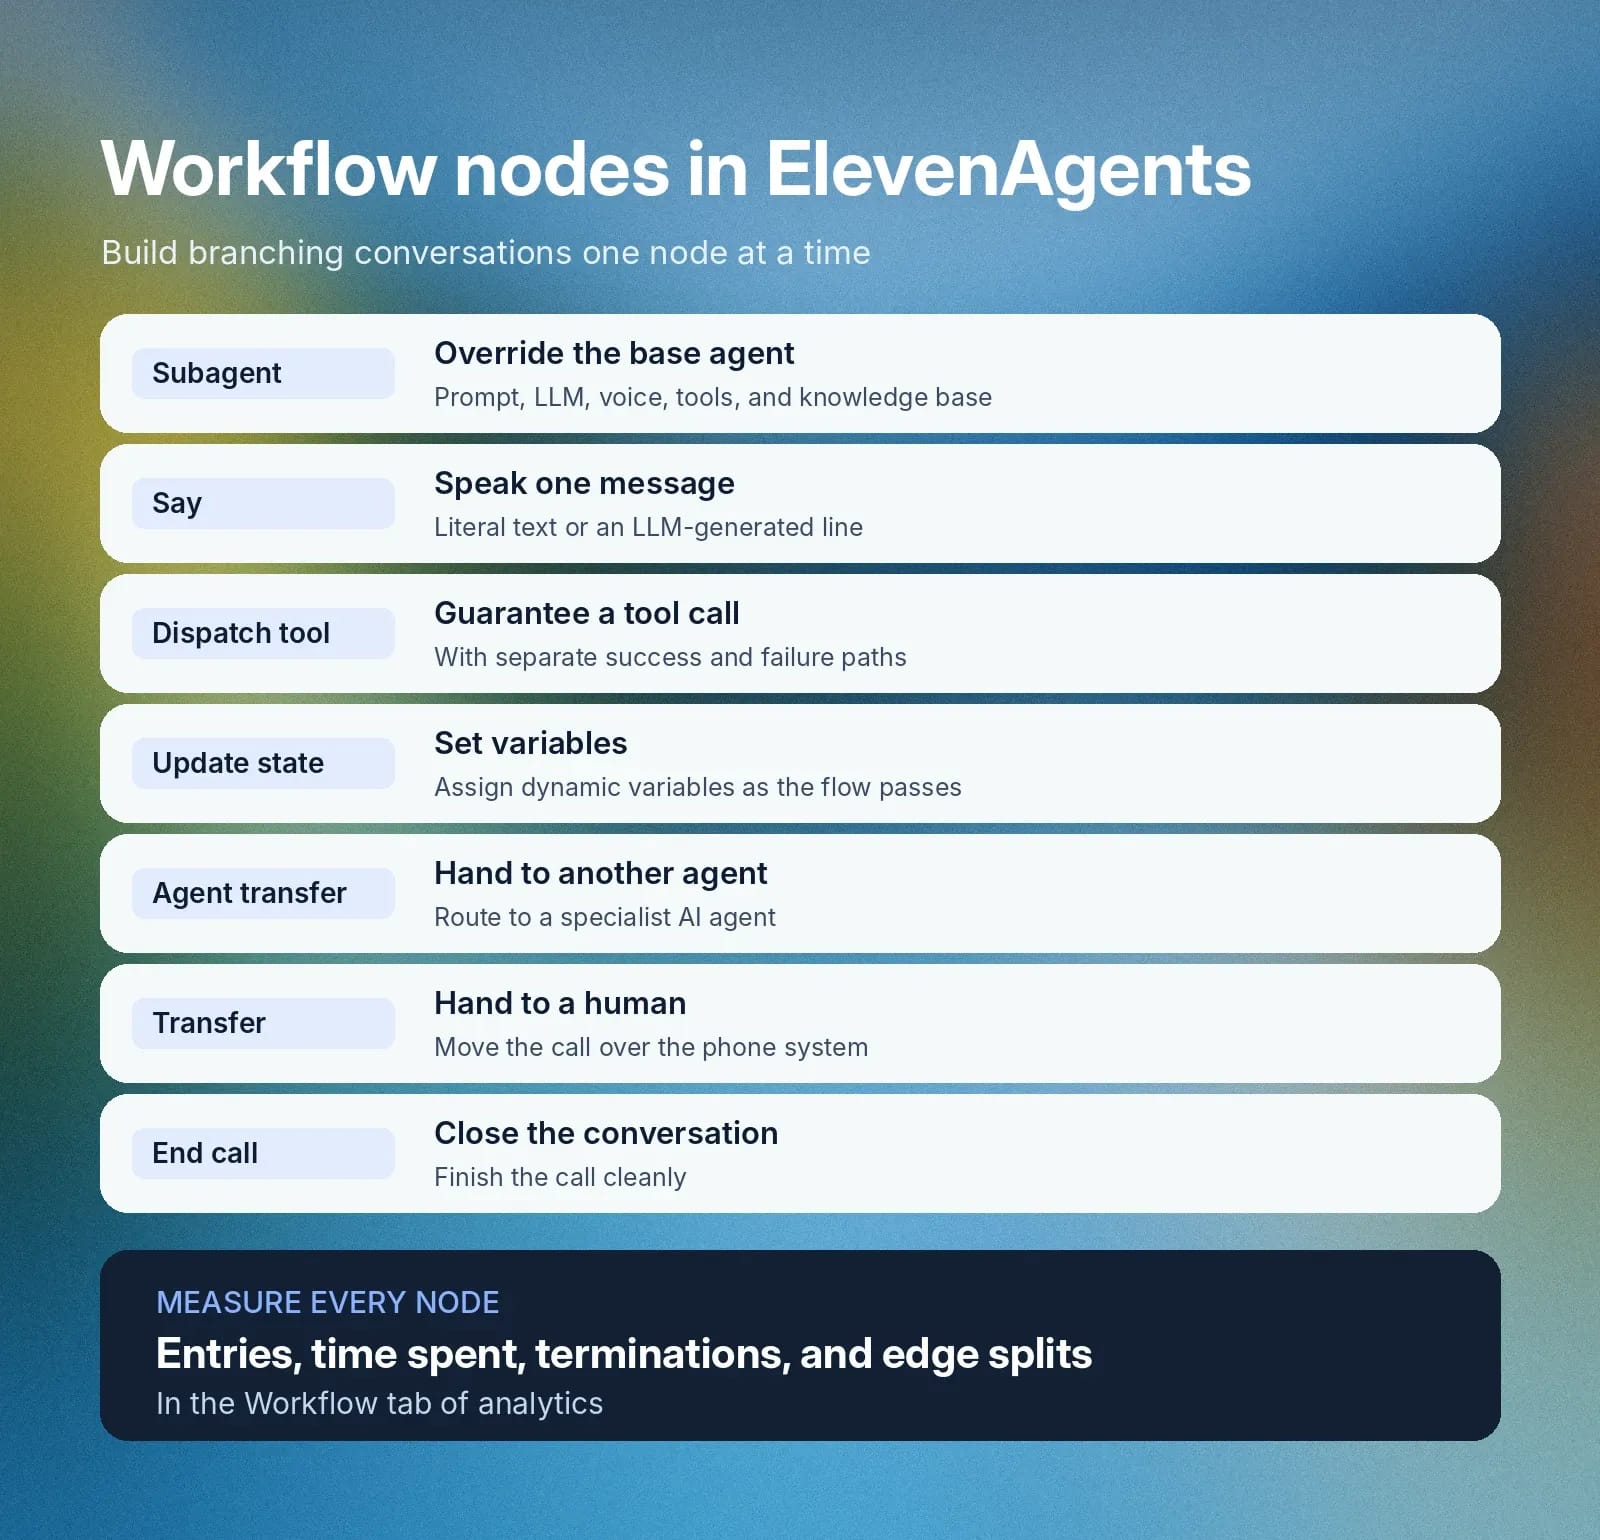
Les workflows dans ElevenAgents constituent un éditeur visuel de graphes conversationnels à embranchements.
Les nœuds sont :
- Sous-agent : Modifie ou remplace l’agent de base, y compris son prompt, son LLM, sa voix, ses outils et sa base de connaissances.
- Say : Énonce un message, sous forme de texte littéral ou de ligne générée par un LLM.
- Dispatch tool : Étape dédiée garantissant un appel d’outil, avec des chemins distincts de réussite et d’échec.
- Update state : Attribue des variables dynamiques au fur et à mesure du flux.
- Agent transfer : Transfère l’appel vers un autre agent.
- Transfer to number : Transfère l’appel de l’agent IA à un intervenant humain via le système téléphonique.
- End call : Termine la conversation.
Les arêtes entre les nœuds portent des conditions en langage naturel que le LLM évalue en temps réel. Un flux de support peut démarrer avec un sous-agent de routage sur un modèle rapide, envoyer les questions de facturation à un sous-agent dédié sur un modèle plus puissant, puis finir par un nœud Transfer to number lorsque l’appelant demande à parler à quelqu’un. Après le lancement, l’onglet Workflow des analytics indique les entrées, le temps moyen passé, les terminaisons et la distribution des arêtes pour chaque nœud.
L’orchestration transforme un agent unique en système que vous pouvez concevoir, mesurer et améliorer, un nœud à la fois.
Outils et MCP : permettre à l’agent d’agir
L’appel de fonctions, aussi appelé appel d’outils, permet à un agent de demander des actions à des logiciels externes connectés à votre stack technique.
Il transforme une interface de questions-réponses en système d’IA agentique capable d’exécuter des tâches et d’interagir avec d’autres outils pour votre compte.
Son rôle
Prenez un appelant qui demande à déplacer le rendez-vous de demain à vendredi. L’agent récupère la réservation, vérifie les disponibilités du vendredi, met à jour le système de planification et confirme le changement. Chaque étape est un appel d’outil qui déclenche une action.
Pourquoi c’est important
Les outils sont là où les conversations produisent des résultats. Chaque outil requiert des entrées et sorties claires, et l’agent doit savoir si l’appel a réussi avant de l’annoncer à l’appelant.
Comment ElevenAgents l’implémente
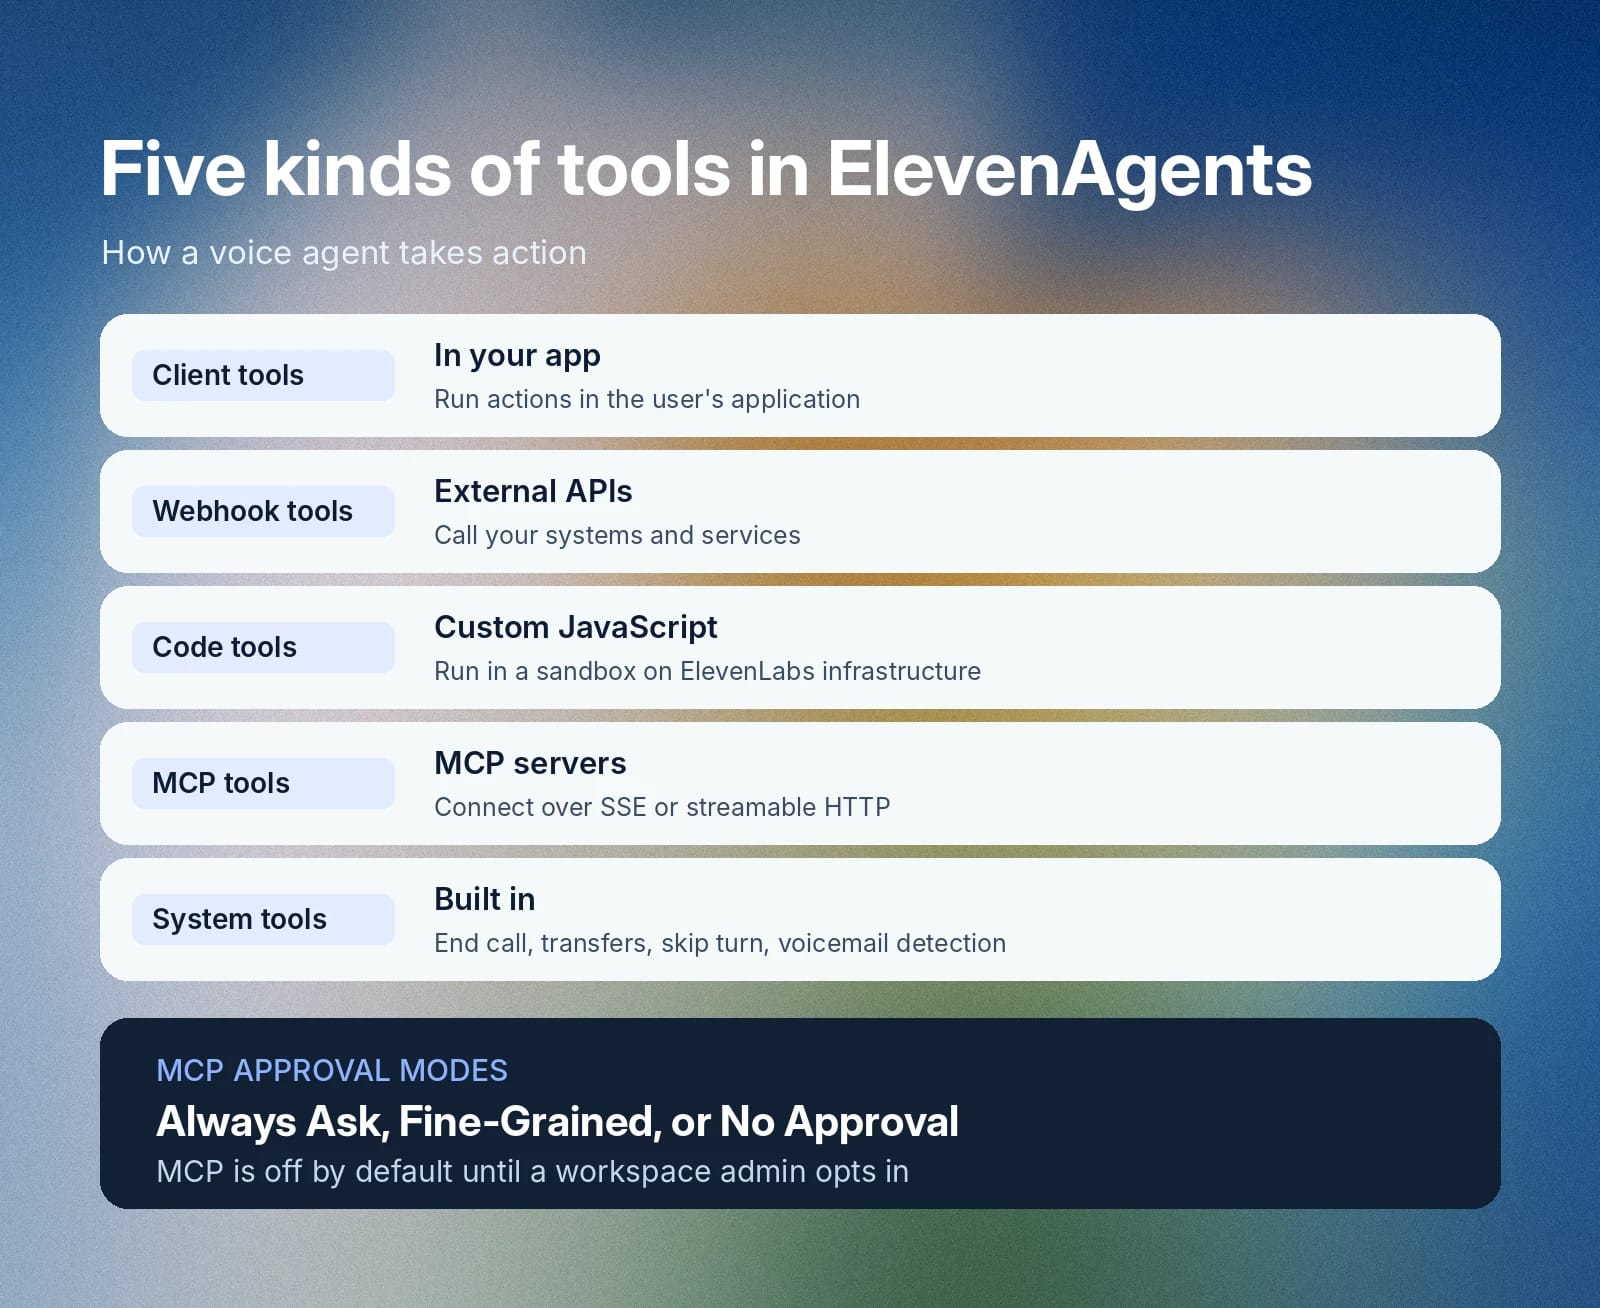
ElevenAgents prend en charge les outils client exécutés dans l’application de l’utilisateur, les outils webhook qui appellent des API externes, les outils de code qui exécutent du JavaScript personnalisé dans un sandbox sur l’infrastructure ElevenLabs, les outils MCP et les outils système intégrés.
Les outils système comprennent End call, la détection de langue, Agent transfer, Transfer to number, Skip turn, la lecture de tonalités clavier et la détection de messagerie vocale. Vous pouvez ajouter un audio d’ambiance pendant l’exécution d’un outil et définir si les appelants peuvent interrompre son exécution.
Le Model Context Protocol (MCP) est une norme ouverte qui définit la manière dont les applications fournissent du contexte et des outils aux modèles de langage. ElevenAgents se connecte aux serveurs MCP via SSE et HTTP streaming. Les administrateurs du Workspace doivent d’abord l’activer, car MCP est désactivé par défaut dans chaque Workspace. Vous choisissez ensuite un mode d’approbation pour chaque serveur : Always Ask, Fine-Grained Tool Approval ou No Approval.
Les événements client tels que client_tool_call et mcp_tool_call signalent l’activité des outils, et le rapport d’événements MCP présente quatre états : chargement, en attente d’approbation, réussite et échec. Des outils fiables donnent à l’agent une portée concrète, tandis que des règles d’approbation claires la maintiennent sous contrôle.
Connaissances et mémoire : faits et contexte de l’appelant
La génération augmentée par récupération (RAG) fournit à l’agent des faits issus de votre contenu, comme une base de données interne ou un historique client plus large. La mémoire et la personnalisation lui donnent le contexte sur l’appelant nécessaire pour améliorer la personnalisation et l’utilité pour votre entreprise.
Son rôle
Un modèle de langage a une date limite d’entraînement et n’a pas accès à votre documentation ni à vos dossiers. Le RAG cherche dans une base de connaissances pour chaque requête, récupère les passages les plus pertinents et les fournit au modèle afin de lui donner le contexte supplémentaire nécessaire à une réponse utile.
Les données de personnalisation indiquent à l’agent qui appelle et ce qui le concerne.
Pourquoi c’est important
Ancrer les réponses dans du contenu approuvé garantit leur exactitude. La vitesse de récupération compte également, car chaque milliseconde ajoutée est une milliseconde d’attente supplémentaire pour vos clients. La personnalisation évite aussi aux appelants de répéter des informations d’un appel à l’autre : vos agents disposent des dossiers CRM dès le début de chaque session.
Comment ElevenAgents l’implémente
Vous ajoutez des documents à la base de connaissances sous forme de fichiers PDF, DOCX, TXT, MD, HTML ou EPUB, jusqu’à 20 Mo chacun, d’URL ou de texte collé. Un document utilise le contexte complet lorsque son texte extrait tient dans le prompt, jusqu’à environ 300 000 caractères. Les documents plus volumineux utilisent le RAG. La récupération peut s’exécuter à chaque tour ou à la demande ; le mode par défaut, Auto, utilise le RAG lorsqu’il est activé et que le document est indexé.
ElevenLabs travaille directement sur la vitesse de récupération. Son article technique, How we reduced RAG latency, documente une réduction de la latence RAG médiane, de 326 ms à 155 ms, grâce à des modèles auto-hébergés sur une infrastructure déjà exploitée par ElevenLabs.
Pour le contexte de l’appelant, ElevenAgents utilise des variables dynamiques écrites sous la forme {{ var_name }}, qui alimentent les messages, prompts système et outils. Pour les appels entrants via Twilio, SIP trunk, WhatsApp et SMS, ElevenAgents peut récupérer les données d’initialisation depuis votre serveur avant le début de la conversation. Votre serveur recherche l’appelant par caller_id et renvoie les variables, par exemple depuis votre CRM, dans une réponse pouvant atteindre 256 KB. Après l’appel, des webhooks post-appel transmettent les résultats d’évaluation et les données extraites à vos systèmes externes.
Ensemble, la récupération et la personnalisation donnent à l’agent les bons faits et le bon contexte sur l’appelant.
Synthèse vocale : donner une voix à l’agent
Text to Speech (TTS) transforme la réponse du modèle de langage en audio parlé. C’est la couche réellement entendue par l’appelant.
Son rôle
Le modèle convertit le texte en audio avec un rythme naturel et une expression émotionnelle. Lors d’un appel en direct, il diffuse l’audio par segments pour démarrer la lecture avant que la réponse complète soit générée.
Pourquoi c’est important
La latence comme l’interprétation influencent l’évaluation de l’appel par les appelants. Deux chiffres comptent en temps réel : le temps de génération de l’audio et le temps avant le premier son entendu. Les noms, noms de médicaments et termes techniques doivent aussi être correctement prononcés, faute de quoi les appelants perdent confiance dans l’agent.
Comment Eleven v4 alimente la couche vocale
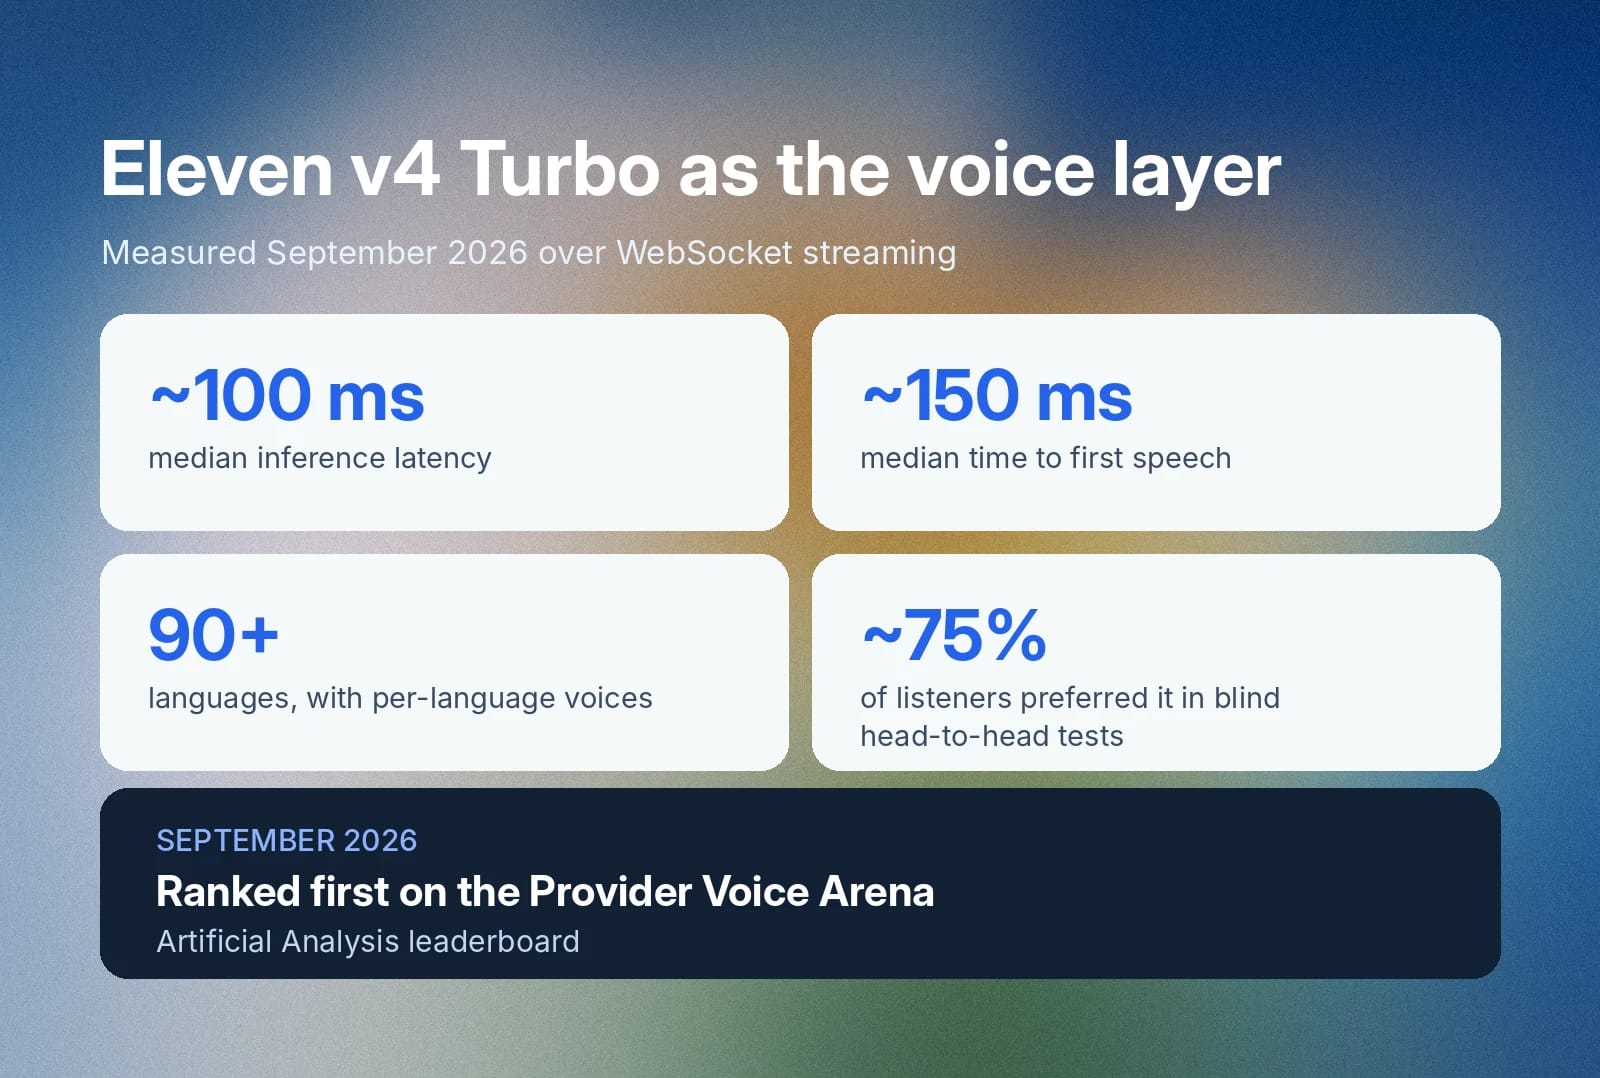
Eleven v4 est le modèle Text to Speech le plus expressif d’ElevenLabs à ce jour, fondé sur une architecture entièrement nouvelle. Eleven v4 Turbo est la variante à faible latence pour les usages en temps réel, notamment les agents, optimisée avec ElevenAgents comme système unique.
Eleven v4 Turbo
Valeur
Latence d’inférence médiane
Environ 100 ms
Temps médian avant la première parole
Environ 150 ms
Langues
90+
ElevenLabs a mesuré ces chiffres de latence en septembre 2026 via le streaming WebSocket, sans la latence réseau. Eleven v4 s’est classé premier du Artificial Analysis Provider Voice Arena Leaderboard en septembre 2026*, et environ 75 % des auditeurs l’ont préféré lors de tests à l’aveugle**.
* Artificial Analysis, Provider Voice Arena Leaderboard, septembre 2026
** Basé sur des tests de préférence utilisateur en comparaison directe avec Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS et Google Gemini 3.8 Flash TTS.
Eleven v4 prend en charge les audio tags intégrés, tels que [laughs] pour l’interprétation, ainsi que les phonèmes IPA pour la prononciation. Dans les agents de santé, ce contrôle couvre les termes médicaux. ElevenAgents ajoute des contrôles au niveau de l’agent. La prise en charge de plusieurs voix permet à un agent de changer de voix dans les conversations à plusieurs personnages. La vitesse va de 0,7x à 1,2x. Chaque langue supplémentaire peut utiliser sa propre voix. Les dictionnaires de prononciation acceptent la notation IPA ou CMU pour des mots précis.
Un premier son rapide et une voix précise, expressive, donnent à l’agent l’impression d’être un interlocuteur de conversation.
Téléphonie et transport : connecter l’agent aux appelants
La couche de transport achemine l’audio entre l’appelant et l’agent. Les intégrations à inclure dans votre infrastructure d’IA vocale varient selon le canal téléphonique utilisé.
Son rôle
Les appels téléphoniques passent par un réseau téléphonique et SIP, tandis que les conversations dans le navigateur et l’application passent par WebRTC ou WebSocket. Un widget de site web encapsule la connexion navigateur dans une interface prête à l’emploi.
Pourquoi c’est important
Chaque canal a des exigences de configuration et contraintes audio différentes : choisissez donc vos canaux tôt. Un déploiement centré sur le téléphone requiert du trunking et une gestion des numéros. Un déploiement produit nécessite un SDK.
Comment ElevenAgents l’implémente
- SIP trunking : Connecte directement votre système téléphonique à ElevenLabs, pour les appels entrants et sortants. Il fonctionne avec Twilio, Vonage, Sinch, Infobip, Telnyx et d’autres fournisseurs standards. La signalisation utilise TCP sur le port 5060 ou TLS 1.2 ou supérieur sur le port 5061, et l’audio utilise G.711 ou G.722. Prévoyez au moins 100 Kbps par appel. Les limites d’appels simultanés dépendent de votre forfait, et les appelants attendent lorsque la mise en file d’attente est activée.
- Intégration Twilio native : Importez un numéro Twilio acheté pour les appels entrants et sortants. Les identifiants appelants vérifiés fonctionnent uniquement pour les appels sortants.
- Appels par lots : Importez une liste de destinataires CSV ou XLS, chaque colonne supplémentaire devenant une variable dynamique. Vous pouvez les lancer immédiatement ou en planifier le démarrage. Les lots utilisent la plus faible des valeurs suivantes : 50 % de la limite de requêtes simultanées de votre Workspace ou 70 % de celle de votre agent, afin de conserver de la capacité pour les appels entrants.
- WebRTC et WebSocket : Les SDK utilisent WebRTC pour la voix et WebSocket pour les conversations uniquement textuelles par défaut. Les agents privés s’authentifient avec une URL signée ou un jeton de conversation créé sur votre serveur. L’endpoint WebSocket est wss://api.elevenlabs.io/v1/convai/conversation.
- SDK : Python, JavaScript, React, React Native, Swift, Kotlin et Unity.
- Widget : Ajoutez l’élément <elevenlabs-convai> à une page. Il prend en charge les modes voix seule, voix et texte, et chat ; l’agent peut afficher des réponses rapides et des carrousels.
Un agent peut gérer le téléphone, le web, WhatsApp, les textos et les emails, ce qui permet aux équipes de concevoir une fois et de déployer sur tous les canaux.
Garde-fous : maintenir l’agent dans son périmètre
Les garde-fous sont des contrôles qui maintiennent le comportement d’un agent dans des limites définies. Ils complètent l’ancrage : un garde-fou limite ce que l’agent peut dire, sans garantir l’exactitude des faits. Les garde-fous s’exécutent parallèlement aux conversations de l’agent afin de les maintenir conformes et précises.
Son rôle
ElevenAgents applique des garde-fous à trois niveaux. Le prompt système définit les comportements autorisés et interdits, idéalement sous un titre # Guardrails. La validation des entrées utilisateur filtre les messages pour détecter l’injection de prompt. La validation des réponses vérifie chaque réponse avant sa transmission.
Pourquoi c’est important
Un agent qui s’écarte du sujet ou invente une politique érode rapidement la confiance. Un agent de support client doit récupérer la politique de remboursement depuis une source approuvée avant de répondre, et un garde-fou impose cette limite.
Comment ElevenAgents l’implémente
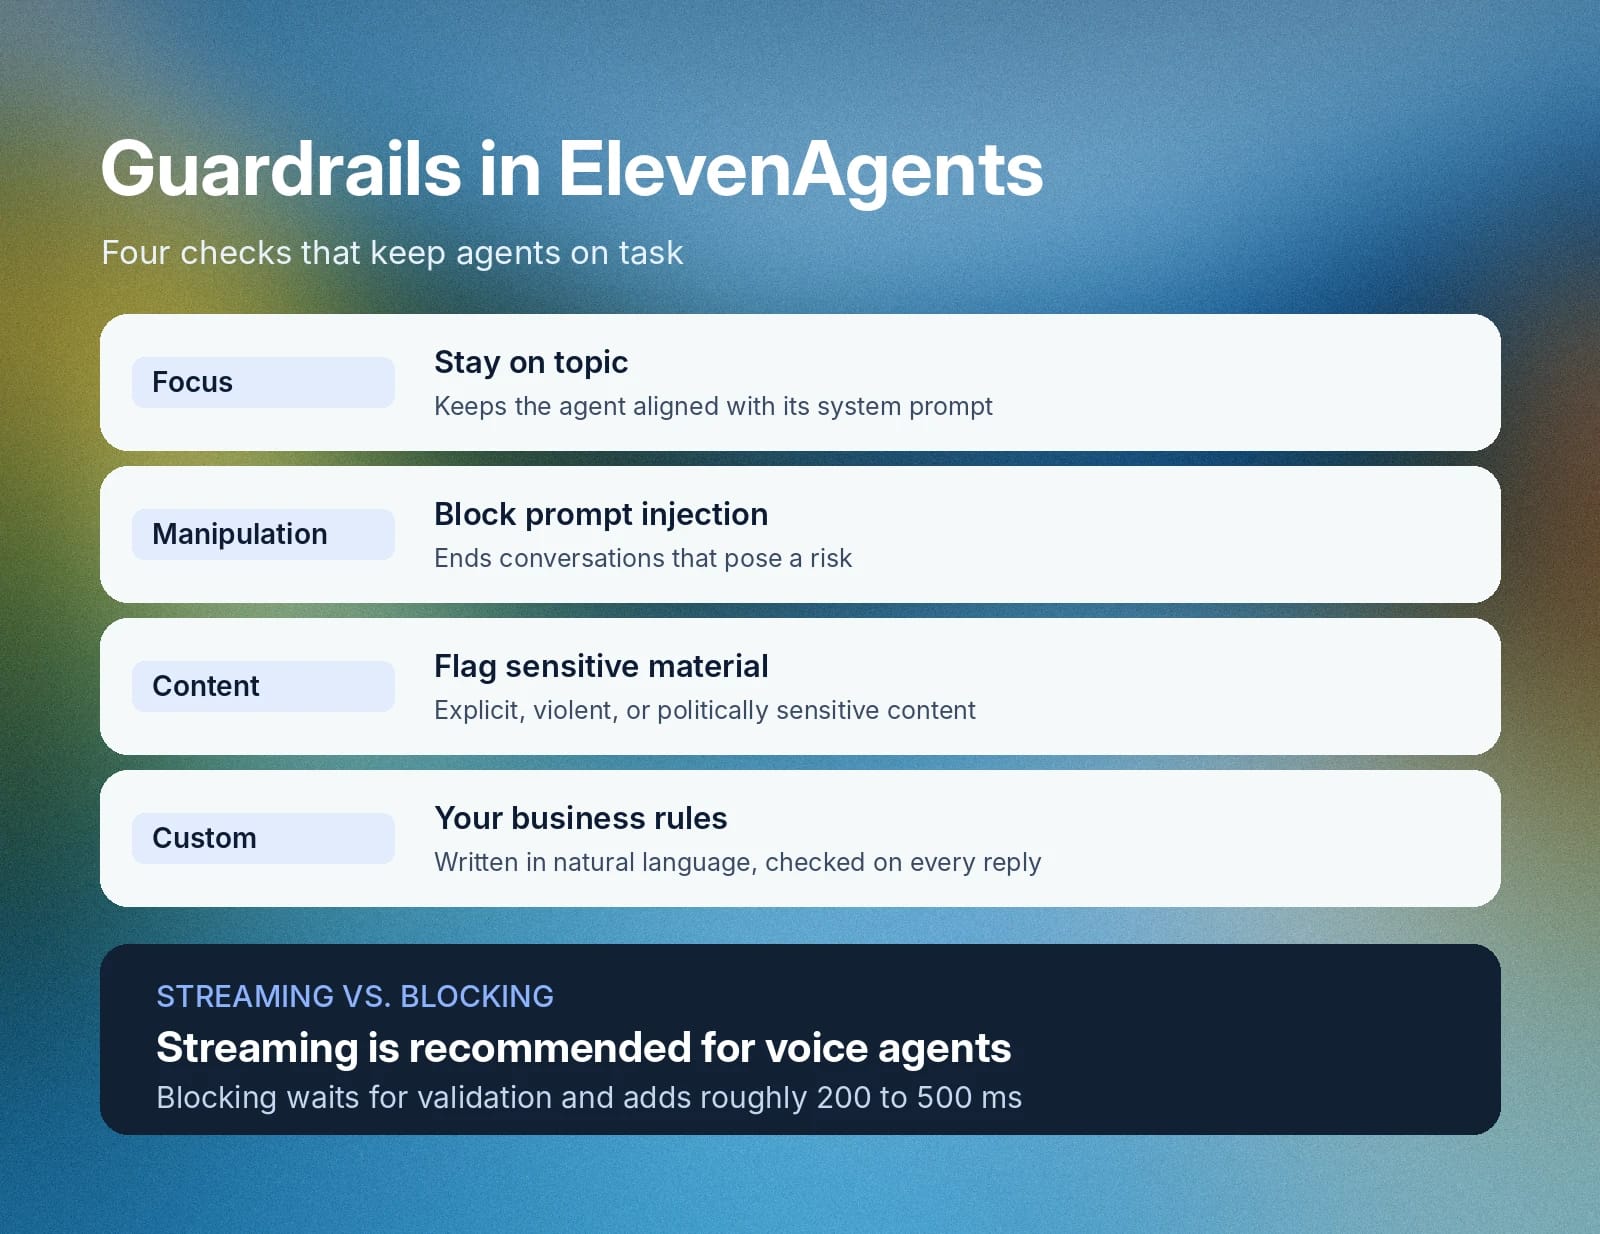
ElevenAgents a introduit Guardrails 2.0 en septembre 2026. Ce nouveau système comprend notamment les configurations suivantes pour garantir l’efficacité des garde-fous :
- Focus : Maintient l’agent dans le sujet et aligné sur son prompt système.
- Manipulation : Détecte l’injection de prompt et met fin aux conversations présentant un risque.
- Content : Signale des catégories telles que les contenus sexuellement explicites, violents ou politiquement sensibles.
- Custom : Règles métier que vous rédigez en langage naturel et qui sont évaluées à chaque réponse.
Le mode d’exécution détermine le compromis de latence. Le mode streaming permet à la réponse de commencer avant la fin de la vérification : moins de 500 ms d’audio peuvent ainsi être lus avant qu’un blocage mette fin à l’appel. ElevenLabs le recommande pour les agents vocaux. Le mode blocking attend la validation et ajoute environ 200 à 500 ms.
Lorsqu’un garde-fou personnalisé se déclenche, l’action met fin à l’appel ou réessaie la réponse jusqu’à trois fois avec le retour que vous rédigez. Votre client peut écouter l’événement guardrail_triggered.
Des garde-fous multicouches avec un profil de latence choisi rendent le comportement prévisible sans ralentir chaque réponse.
Tests et expériences : prouver que l’agent fonctionne
Les tests vérifient un agent avant son lancement. Les expériences vérifient les modifications sur le trafic réel après le lancement.
Son rôle
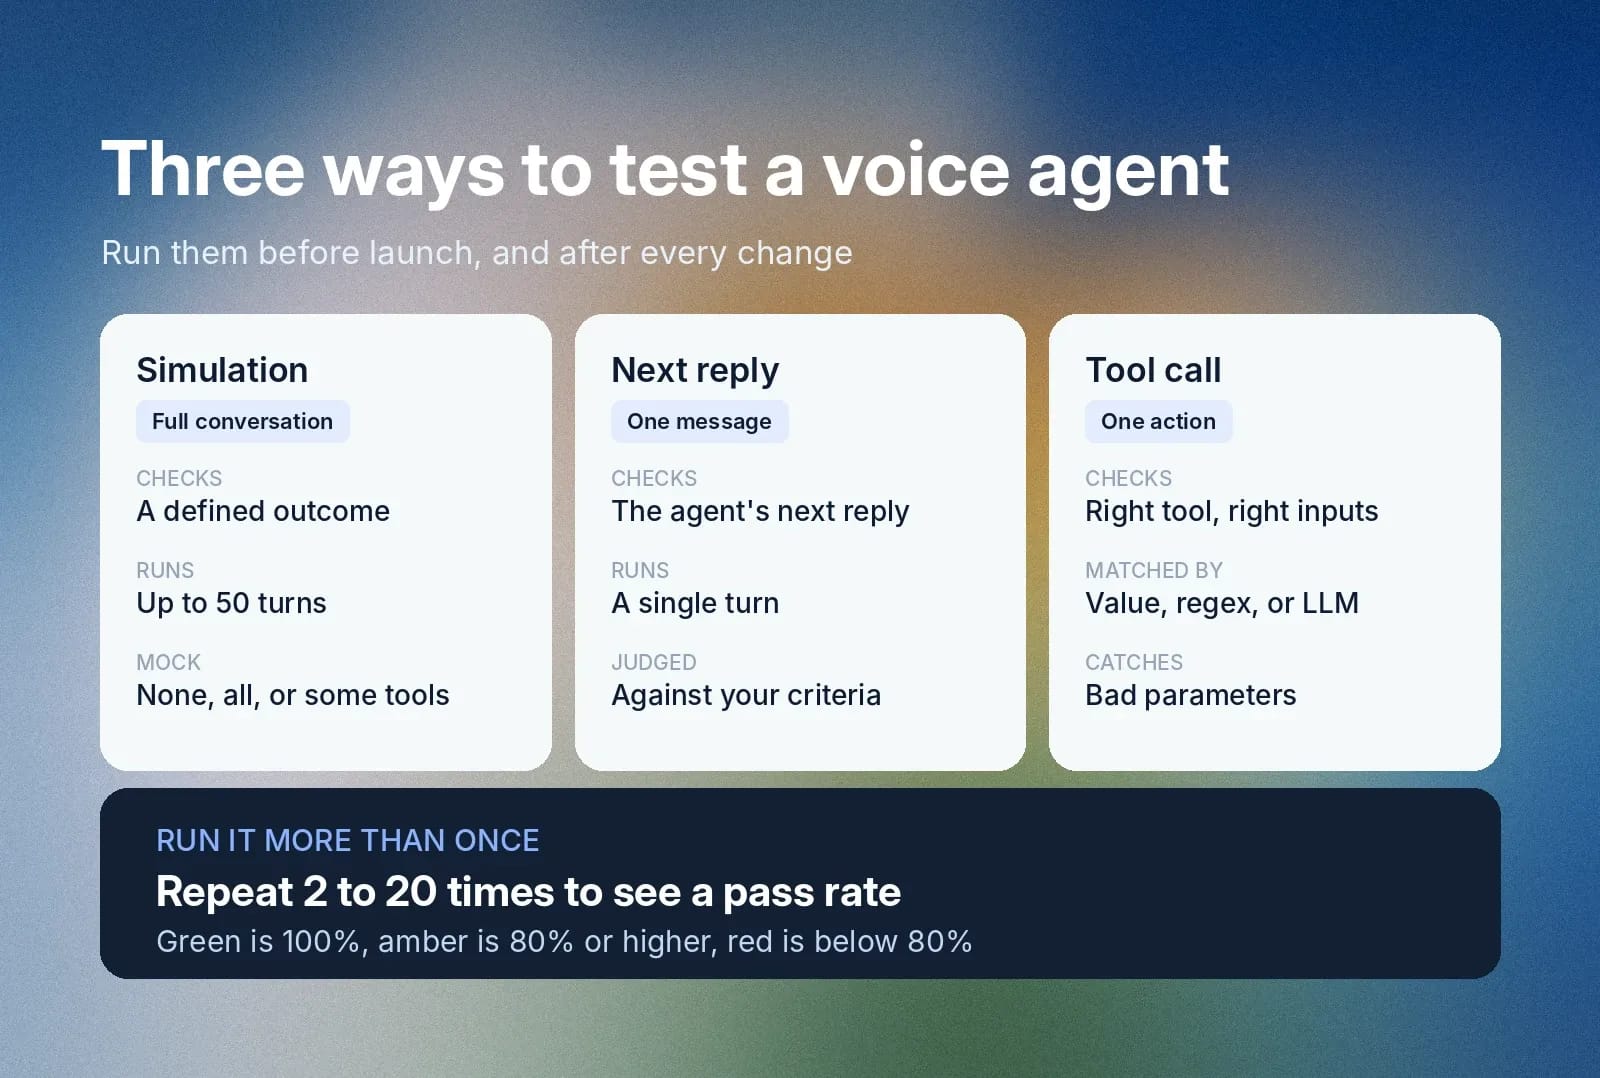
ElevenAgents propose trois types de tests d’agent. Simulation exécute une conversation complète face à un utilisateur simulé et vérifie l’atteinte d’un résultat défini, sur 50 tours maximum, 5 par défaut. Les tests Next Reply évaluent uniquement le prochain message de l’agent selon vos critères. Les tests Tool Call vérifient que l’agent utilise le bon outil avec les bons paramètres, par valeur exacte, regex ou évaluation LLM. Dans les simulations, vous pouvez simuler aucun outil, tous les outils ou certains d’entre eux.
Pourquoi c’est important
Une seule exécution réussie montre qu’un agent peut réussir. Répéter les tests montre à quelle fréquence il y parvient. L’API accepte repeat_count de 2 à 20 et les résultats affichent un taux de réussite. Le vert signifie 100 %, l’ambre 80 % ou plus et le rouge moins de 80 %. Les échecs sont regroupés par motif. Prompts, modèles, workflows et intégrations modifient tous le comportement : les tests se poursuivent donc après le lancement.
Fonctionnement des expériences
Les expériences sont des tests A/B reposant sur le versioning des agents. Vous créez une branche de votre configuration, modifiez une variable, telle que le prompt système, le workflow, la voix, les outils, la base de connaissances ou les paramètres LLM, puis orientez une part du trafic réel vers cette variante. ElevenLabs recommande de commencer entre 5 et 10 %.
Le routage est déterministe selon l’ID de conversation : un utilisateur donné reste donc sur la même branche, et les pourcentages doivent totaliser 100 %. CARS24, client d’ElevenLabs, a fait progresser le trafic à 5 %, 10 %, 20 %, 50 % et 100 %, avec un palier de deux jours à chaque étape, comme décrit dans le rapport.
Les tests avant lancement et les expériences sur trafic réel transforment ensemble les changements en améliorations mesurées.
Observabilité : mesurer ce qui se passe en production
L’observabilité est la capacité à voir ce que l’agent a fait, ses performances et, le cas échéant, où il a échoué. Un agent qui fonctionne dans un test peut se comporter différemment avec de vrais appelants : une observabilité complète et des enregistrements auditables sont donc indispensables.
Son rôle
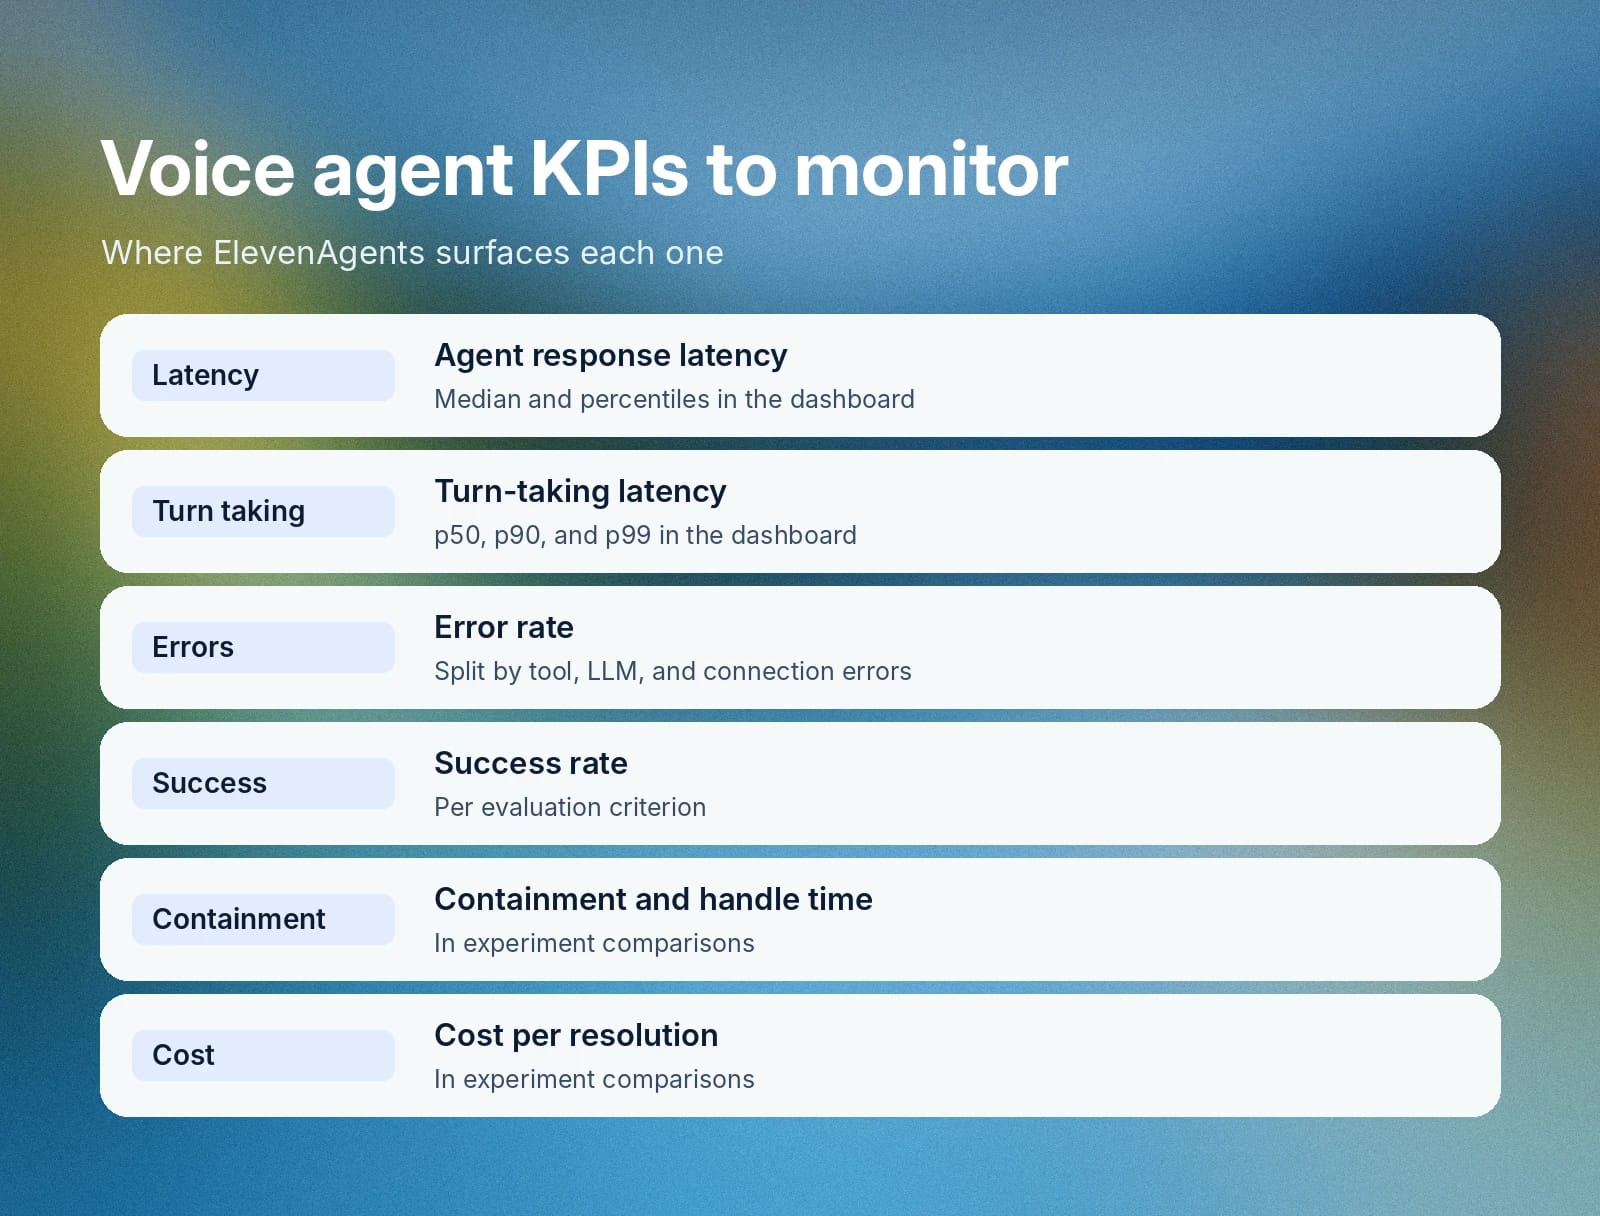
L’analyse des conversations évalue chaque appel. L’évaluation de la réussite applique des critères que vous définissez pour l’atteinte de l’objectif et la qualité, tandis que la collecte de données extrait des champs structurés tels que les coordonnées et le type de problème. Le Dashboard des analytics ajoute le volume, la durée et le coût des appels, les taux d’erreur et la latence. Les appels actifs sont mis à jour en temps réel et des alertes se déclenchent lorsque les taux d’erreur augmentent.
Pourquoi c’est important
Sans monitoring, un mauvais appel reste une anecdote. Avec lui, vous pouvez identifier le nœud, l’outil ou le modèle à l’origine du problème.
KPI
Ce qu’il indique
Où ElevenAgents l’affiche
Latence de réponse de l’agent
Temps d’attente des appelants avant une réponse
Dashboard des analytics, médiane et percentiles
Latence de gestion des tours
Vitesse à laquelle l’agent prend son tour
Dashboard des analytics, p50, p90 et p99
Taux d’erreur
Part des conversations comportant des erreurs
Dashboard, ventilé par erreurs d’outil, de LLM et de connexion
Taux de réussite
Atteinte de l’objectif par critère
Critères d’évaluation, avec taux de réussite, d’échec et inconnu
Taux de résolution autonome et temps de traitement
Appels résolus sans intervenant humain et durée des appels
Comparaisons d’expériences
Coût par résolution
Coût de chaque conversation résolue
Comparaisons d’expériences
Choisissez les métriques les plus utiles pour la tâche envisagée. Un agent de support s’appuie sur la résolution et l’escalade, tandis qu’un agent sortant se concentre surtout sur la connexion et la finalisation.
Passage à l’échelle, fiabilité et transfert à un intervenant humain
L’infrastructure d’IA vocale doit fonctionner aussi bien avec 5 clients qu’avec 500 000. Même à grande échelle, ces composants doivent résister et pouvoir transférer les appels à des intervenants humains lorsque nécessaire.
Son rôle
Le passage à l’échelle consiste à prendre en charge de nombreuses conversations simultanées pour la reconnaissance vocale, l’inférence LLM, la synthèse vocale, les intégrations et la téléphonie. La fiabilité signifie que chaque dépendance dispose d’un chemin d’échec défini. Le transfert implique une voie claire vers un intervenant humain.
Sans être strictement des composants de l’infrastructure d’IA vocale, ces éléments sont tous essentiels au bon fonctionnement d’un système en pratique.
Pourquoi c’est important
Un système qui gère dix appels de test peut se comporter différemment à dix mille. Un outil de réservation qui expire ne doit pas conduire l’agent à confirmer une réservation qui n’a jamais eu lieu. Un appelant demandant à parler à quelqu’un doit y parvenir avec son contexte intact, généralement via un transfert assisté.
Comment ElevenAgents l’implémente
Les limites de requêtes simultanées dépendent du forfait, et la mise en file d’attente maintient les appelants en attente lorsqu’une limite est atteinte. Le chaînage de LLM couvre les pannes de modèles. Les nœuds Transfer to number, l’outil système Transfer to number et Agent transfer assurent le transfert, et les critères d’évaluation peuvent décider d’une escalade. Les périodes de silence sont facturées à 5 % du tarif habituel par minute.
ElevenLabs communique des résultats de production à grande échelle. ElevenAgents alimente plus de 10 millions de conversations par semaine. Meesho automatise environ 90 % des demandes de support sur plus de 60 000 appels par jour, selon le rapport Building Enterprise-grade Voice Agents. En République tchèque, les agents propulsés par ElevenLabs gèrent environ 5 000 appels quotidiens sur les lignes d’assistance nationales aux prestations et résolvent seuls 85 % des demandes, selon le rapport State of Conversational Agents in Government.
Prévoir dès le départ la charge, les défaillances et les transferts est ce qui distingue une démo d’un déploiement.
Ce qu’il faut rechercher dans une infrastructure d’IA vocale prête pour la production en 2026
Utilisez cette liste de contrôle pour évaluer toute plateforme d’IA vocale selon vos exigences.
- Reconnaissance vocale : transcriptions précises pour vos langues, vos accents et votre qualité audio, y compris les noms et identifiants.
- Gestion des tours de parole : comportement de fin de tour configurable, barge-in et temps de réponse aux interruptions mesuré.
- Choix du modèle : LLM sélectionnable par agent ou sous-agent, option de LLM personnalisé et basculement automatique.
- Orchestration : workflows à plusieurs étapes et routage entre agents spécialisés.
- Outils : webhooks, outils client, prise en charge MCP et contrôles d’approbation.
- Connaissances : vos propres documents, avec une latence de récupération mesurable.
- Personnalisation : données de l’appelant disponibles avant le premier mot.
- Voix : faible délai avant la première parole et contrôle de la prononciation et de l’expression.
- Canaux : téléphone, web, mobile et messagerie, avec SDK et API.
- Garde-fous : limites de comportement configurables, avec un coût de latence connu.
- Tests : conversations simulées, vérifications d’appels d’outils et exécutions répétées.
- Expériences et analytics : tests A/B, latence par percentile et répartition des erreurs.
- Échelle et transfert : requêtes simultanées, mise en file d’attente et escalade vers des intervenants humains documentées.
Les principaux systèmes d’agents vocaux IA, comme ElevenAgents, réunissent tous ces composants sur une seule plateforme.
Commencez dès aujourd’hui en contactant l’équipe, ou concevez vos propres systèmes d’agents IA en vous inscrivant pour créer un compte.
Questions fréquentes sur l’infrastructure d’IA vocale

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.