Qu’est-ce que la gestion des tours de parole en IA conversationnelle : guide pour des échanges fluides
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Un bon service client exige d’excellentes compétences conversationnelles. Parmi les plus importantes : savoir écouter et savoir quand prendre la parole. Sans cela, les conseillers risquent de couper des clients déjà frustrés, qui ont peut-être appelé plusieurs fois pour expliquer leur problème.
Cette même exigence s’applique à la gestion des tours de parole en IA conversationnelle. Les agents doivent trouver le juste équilibre : rester silencieux assez longtemps pour laisser parler la personne, sans attendre au point que la latence et les silences nuisent à la qualité de l’échange.
C’est pourquoi la gestion moderne des tours de parole exige que les modèles évaluent rapidement l’intention exprimée, plutôt que de s’appuyer sur des minuteurs de silence stricts. Notre architecture unifiée chez ElevenLabs analyse en continu le ton, le rythme et le contexte des mots afin de maintenir les échanges sur la bonne voie et fluides.
En résumé
- Les équipes de service client déploient des agents vocaux formés à la gestion des tours de parole pour résoudre rapidement les problèmes avec moins de friction.
- La gestion des tours de parole permet aux modèles de déterminer quand répondre ou intervenir, conserver la parole, écouter ou rester silencieux.
- Les agents IA s’appuient sur une temporisation adaptative, la détection d’activité vocale et l’analyse sémantique pour préserver la fluidité des conversations.
- Les équipes d’ingénierie suivent la latence de réponse et les taux d’interruption afin de mesurer la fluidité des échanges et d’optimiser les workflows.
Qu’est-ce que la gestion des tours de parole en IA conversationnelle ?
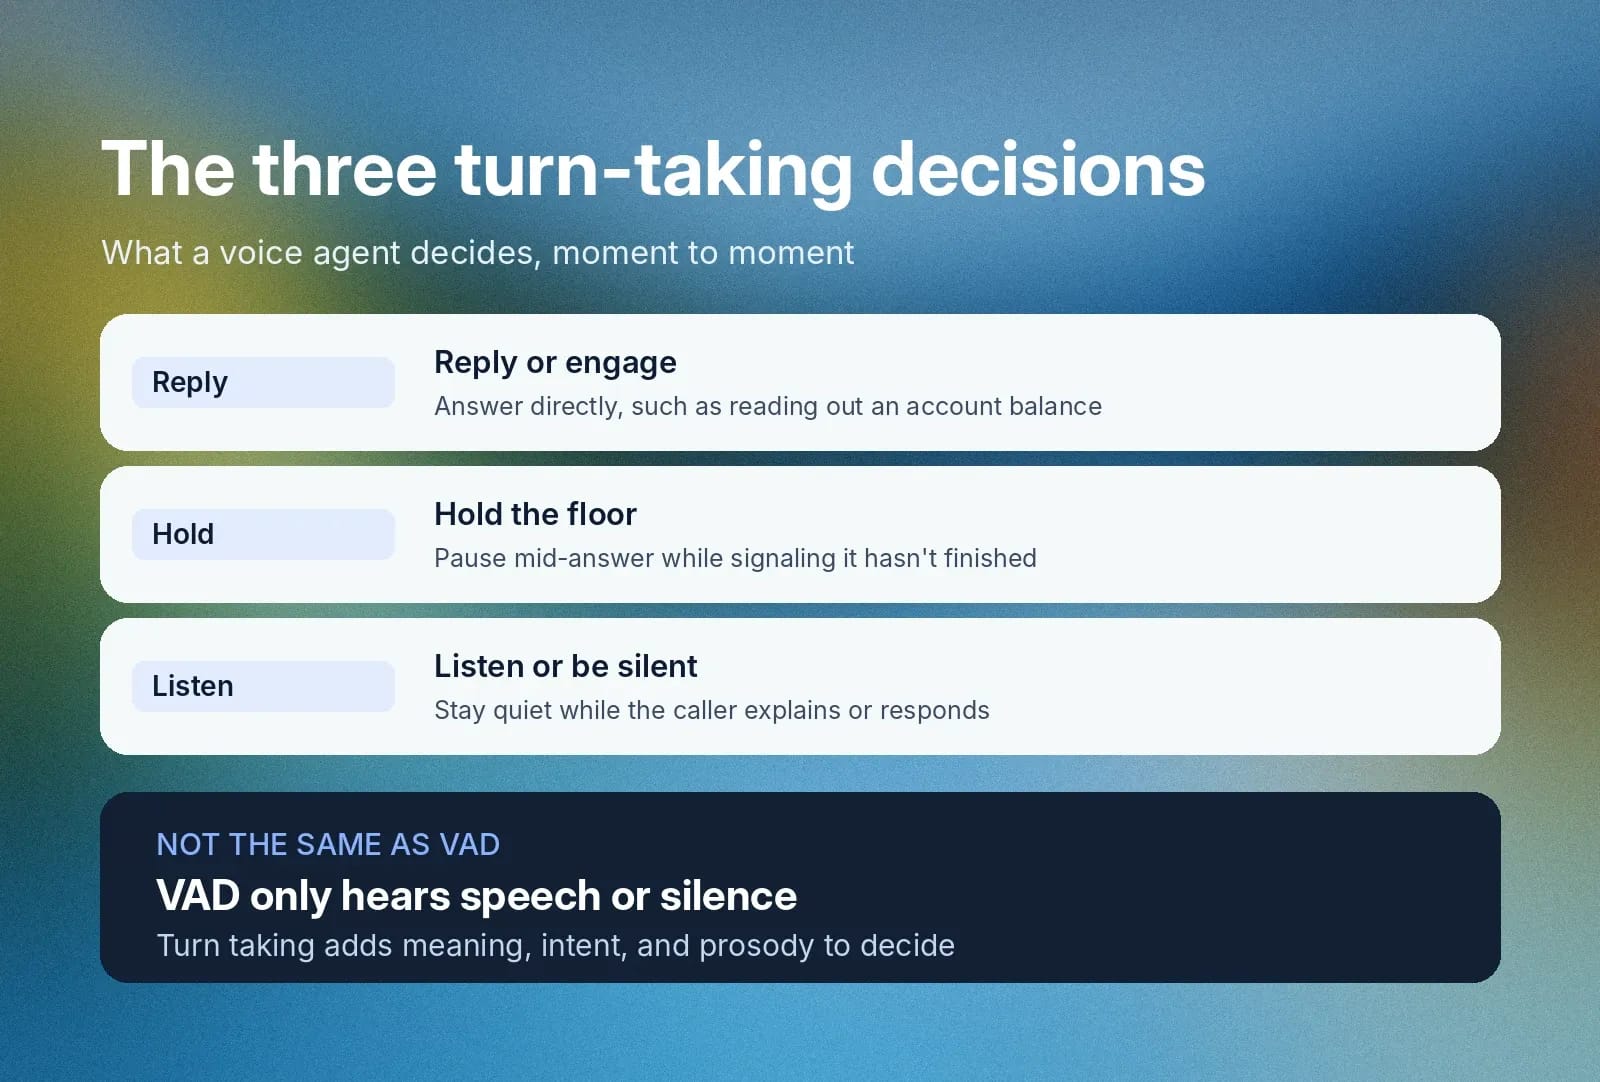
Lorsque des modèles d’IA conversationnelle gèrent les tours de parole, ils suivent un ensemble de règles qui déterminent le meilleur moment pour :
- Répondre ou intervenir : l’agent IA répond directement à la question. Par exemple, un client demande le solde de son compte et le système répond : « Le solde de votre compte est de 57,34 $. »
- Conserver la parole : le modèle continue de parler et indique qu’il n’a pas terminé, même lorsqu’il marque une pause. Par exemple, un client demande le solde de son compte et le système répond : « Je vais d’abord utiliser les informations que vous avez fournies pour retrouver votre compte… [pause]. Le solde de votre compte est de 57,34 $, mais… [pause] je vois également un paiement en attente de ce montant. Appelez-vous pour savoir quand ce paiement sera effectué, sans frais de retard ? »
- Écouter ou rester silencieux : l’agent reste silencieux en attendant que le client explique sa situation ou réponde. Par exemple, le client confirme qu’il souhaite savoir si le paiement a été effectué, car plusieurs jours se sont écoulés depuis son envoi. Le modèle IA répond : « Oui, je vois que vous avez effectué le paiement il y a deux jours. Son traitement prend généralement trois jours, il devrait donc être effectué demain matin. Aucun frais de retard ne vous sera facturé. Puis-je vous aider sur un autre point ? »
Dans la documentation destinée aux développeurs, on parle souvent de détection de tour ou de détection de fin de tour. Les systèmes qui associent détection d’activité vocale et compréhension du langage pour déterminer si un interlocuteur a terminé sont souvent décrits comme une VAD sémantique.
Cette manière fluide de maintenir le dialogue avec un client élimine les échanges rigides façon talkie-walkie et permet aux agents vocaux de tenir des conversations naturelles.
Il est également important de noter que cette couche décisionnelle à trois niveaux de l’IA conversationnelle diffère de la détection brute d’activité vocale (VAD). Alors que la VAD classe l’audio comme parole ou silence, la gestion des tours de parole tient compte du contexte sémantique, de l’intention et de la prosodie, en plus du signal brut. Consultez notre guide sur la VAD pour mieux comprendre le fonctionnement des algorithmes de détection de la parole et leur utilité.
Pourquoi une gestion naturelle des tours de parole est essentielle aux agents vocaux
Une mauvaise gestion des tours de parole est le moyen le plus rapide d’irriter un client, surtout s’il est déjà réticent à l’idée de parler à des bots moins avancés. Les agents d’IA conversationnelle obsolètes coupent la parole aux appelants, marquent des pauses longues et gênantes, ou ne suivent pas le rythme de la conversation.
ElevenAgents utilise une temporisation adaptative pour que vos agents automatisés maintiennent un rythme d’échange naturel. Cette précision renforce la confiance des clients dans les capacités du modèle, mais aussi dans la technologie que vous avez déployée et dans l’engagement de votre marque envers la satisfaction client.
Avec Eleven v4 Turbo avec ElevenAgents, les agents atteignent un délai médian de 142 ms entre la requête et la parole audible.
De plus, une gestion des tours de parole bien calibrée maintient l’engagement des clients suffisamment longtemps pour résoudre le problème dès le premier contact, sans transfert vers un intervenant humain.
Comment fonctionne la gestion des tours de parole en temps réel
La gestion des tours de parole en temps réel s’appuie sur un pipeline multicouche qui analyse continuellement l’audio en direct. Les modèles s’appuient aussi sur un ensemble de règles pour déterminer les meilleures actions à mener afin de préserver la fluidité des conversations. ElevenAgents gère ces éléments en trois étapes distinctes pour que chaque échange reste réactif et naturel.
Détecter la parole, le silence et l’intention
La détection d’activité vocale interprète et classe les flux audio entrants comme de la parole ou du silence, plusieurs dizaines de fois par seconde. Après que la VAD a fourni le signal brut, la détection d’intention détermine si l’interlocuteur humain a réellement fini de parler ou s’il fait simplement une pause pour réfléchir. Parmi les facteurs confirmant la fin d’un tour figurent une intonation descendante ou une phrase syntaxiquement complète. À l’inverse, une intonation suspendue ou des mots de remplissage comme « euh… » ou « genre… » peuvent signaler une pause temporaire.
Décider quand répondre
Les délais de réponse pouvant pousser les appelants à abandonner la conversation, le moment où le modèle décide de répondre est l’un des principaux facteurs de réussite. Les architectures vocales traditionnelles s’appuient souvent sur des minuteurs restrictifs pour déterminer si une personne a réellement fini de parler. Elles risquent alors de couper les appelants lorsqu’ils reprennent la parole ou de créer des silences gênants. La gestion moderne des tours de parole en IA conversationnelle utilise le deep learning pour comprendre pleinement des signaux tels que la prosodie, le rythme de parole et les mots de remplissage.
Gérer la latence de réponse entre l’écoute et la restitution vocale
Selon une étude linguistique publiée dans le Journal of Cognition, les intervalles entre les tours de parole de locuteurs humains sont en moyenne de près de 200 ms dans toutes les cultures. Les modèles qui mettent nettement plus de temps à répondre créent donc des pauses gênantes. Cela alimente l’impatience et augmente le taux d’abandon des appels.
Gérer les interruptions, les signaux d’écoute et les chevauchements de parole
La capacité des agents à gérer les interruptions, les signaux d’écoute et les chevauchements de parole dépend des fournisseurs et de la manière dont ils programment leurs modèles d’IA conversationnelle.
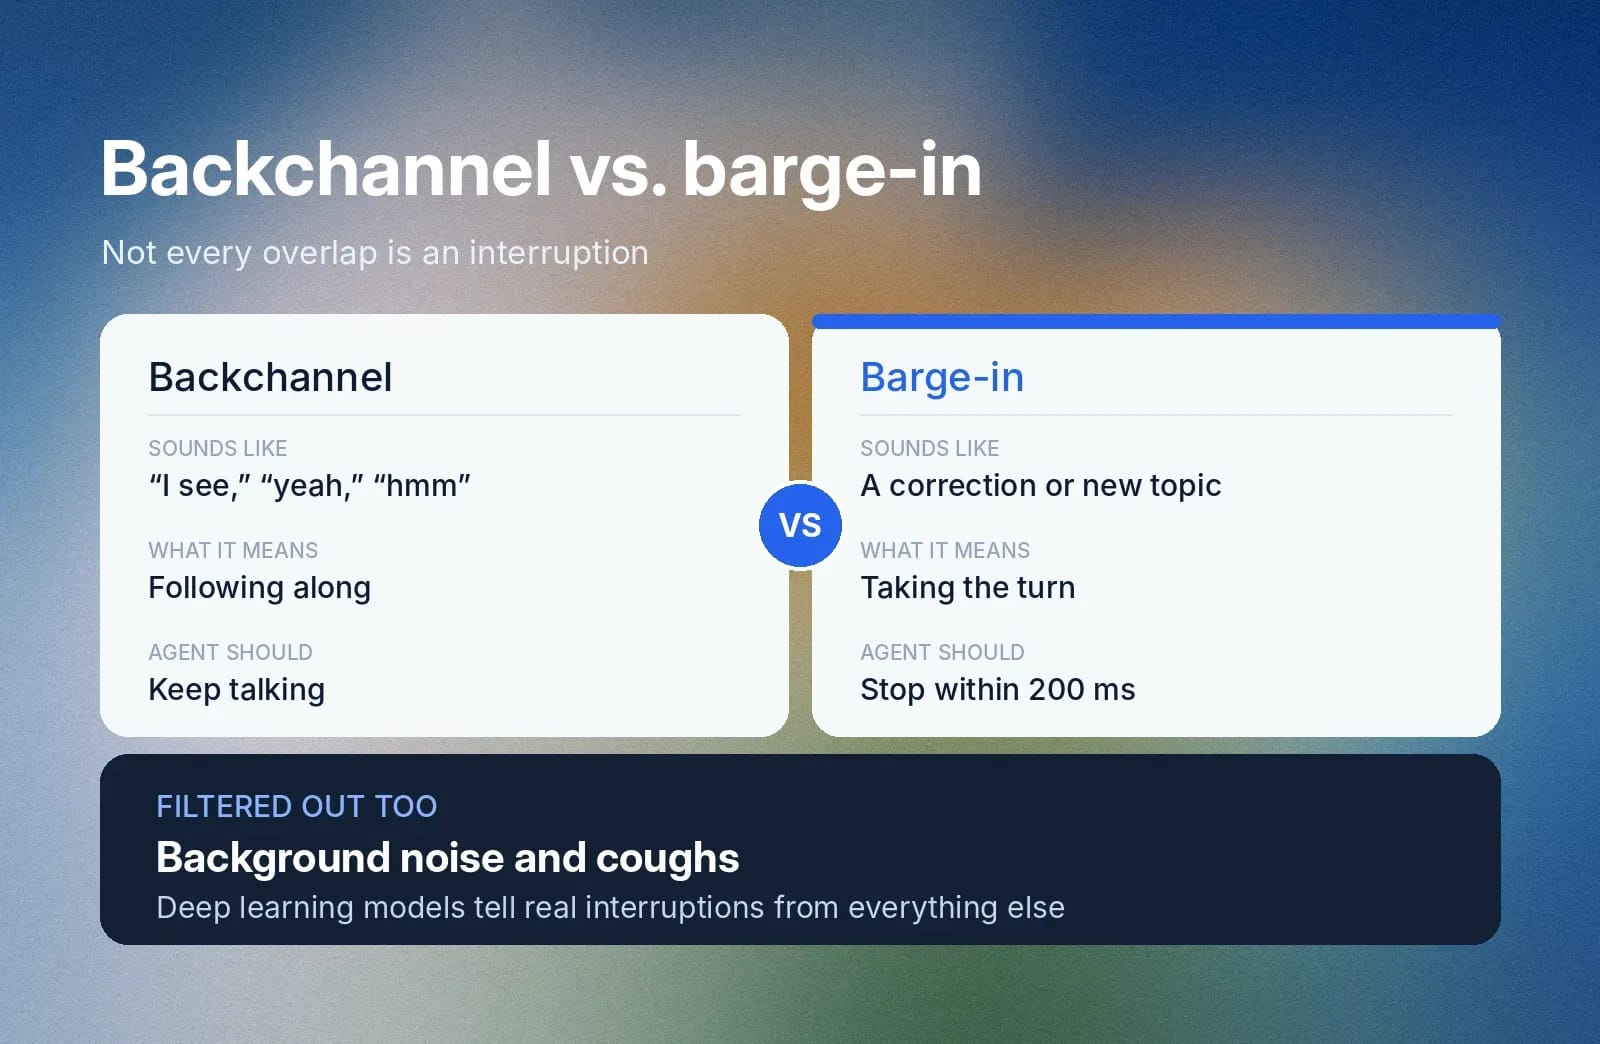
Les signaux d’écoute désignent les sons ou mots brefs d’acquiescement qu’un interlocuteur utilise, comme « je vois » ou « oui », pour montrer qu’il suit la conversation sans prendre la parole. Un agent vocal doit comprendre ces signaux et continuer à parler, plutôt que de les interpréter comme une interruption.
ElevenAgents gère les chevauchements en direct en cédant immédiatement la parole lorsqu’un appelant interrompt réellement l’agent. Lorsqu’un appelant coupe la parole, par exemple pour corriger une information de compte ou changer de sujet, ElevenAgents envoie un signal d’arrêt en moins de 200 ms. L’agent cesse alors de parler en plein milieu de phrase, plutôt que de terminer la phrase qu’il avait prévue.
Nos modèles de deep learning filtrent aussi continuellement le bruit de fond et distinguent les véritables interruptions des mots de remplissage exprimant l’acquiescement ou la réflexion. Par exemple, un utilisateur qui dit « je vois… » ou « hmmm… » pendant qu’un agent parle crée un chevauchement de parole, mais ne cherche pas à intervenir.
Ces fonctionnalités permettent à nos agents vocaux de maintenir des temps de réponse précis et un échange fluide, même lors d’interruptions à forte intention.
Erreurs courantes de gestion des tours de parole et comment les éviter
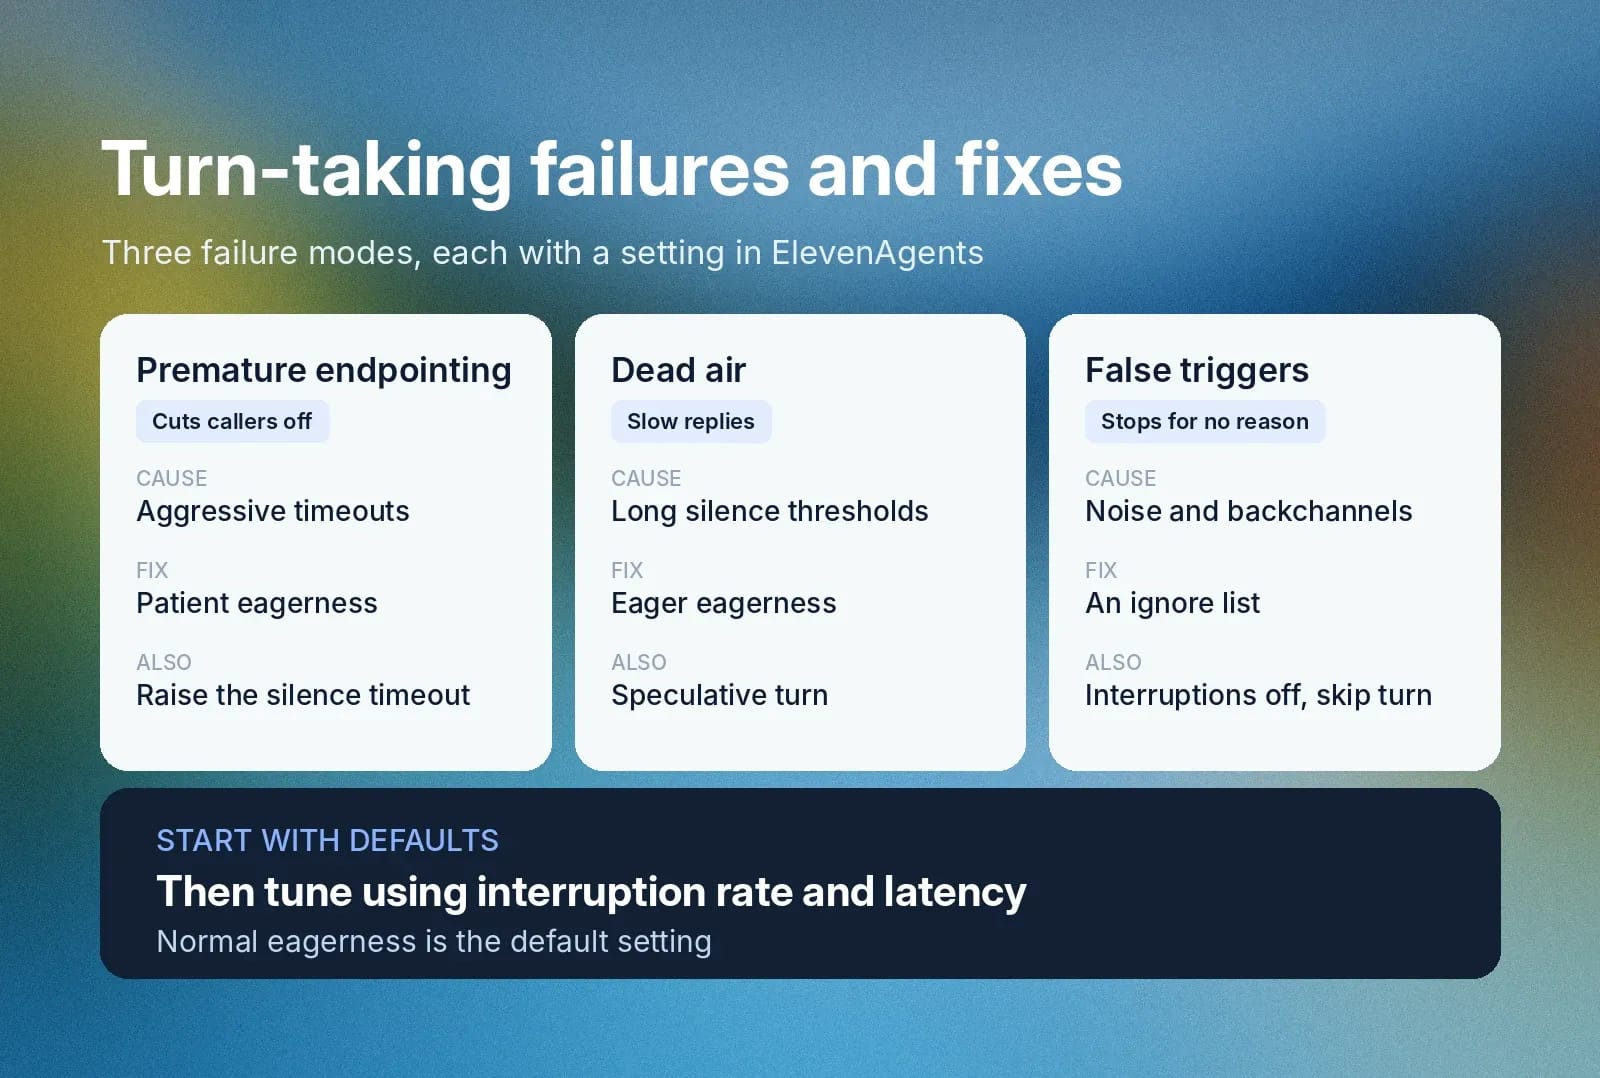
Les modèles d’IA conversationnelle présentent trois principaux modes de défaillance que les équipes d’ingénierie doivent prendre en compte lors de la configuration d’agents vocaux :
- Détection prématurée de fin de tour : des délais d’expiration trop agressifs peuvent conduire les modèles à confondre des pauses au milieu d’une phrase, durant lesquelles l’appelant cherche ses mots ou une information, avec une fin de tour. L’agent vocal interrompt alors fréquemment les clients et les frustre.
- Silence et réponses tardives : des seuils de silence excessifs provoquent des pauses longues et gênantes, susceptibles d’augmenter les taux d’abandon. Ces délais donnent l’impression que les agents vocaux sont lents et peu réactifs, ce qui nuit à l’expérience client et à l’image de votre marque.
- Faux déclenchements liés aux mots de remplissage et au bruit : des modèles mal réglés peuvent aussi interpréter le bruit ambiant, la toux et les signaux d’écoute comme de véritables interruptions. Le modèle fait alors une pause ou s’arrête inutilement lorsque le client écoute simplement sans chercher à l’interrompre.
Les ingénieurs peuvent éviter ces problèmes en déployant ElevenAgents avec des modèles de langage contextuels. Cette approche adaptative, associée à la VAD, élimine les coupures erronées, les réponses trop lentes et une sensibilité excessive au bruit de fond.
Comment configurer la gestion des tours de parole dans ElevenAgents
Les réglages adaptés à la gestion des tours de parole dépendent du cas d’usage et des appels habituels que votre agent recevra. ElevenAgents permet aux équipes d’ajuster précisément chacun des modes de défaillance ci-dessus dans les paramètres de l’agent.
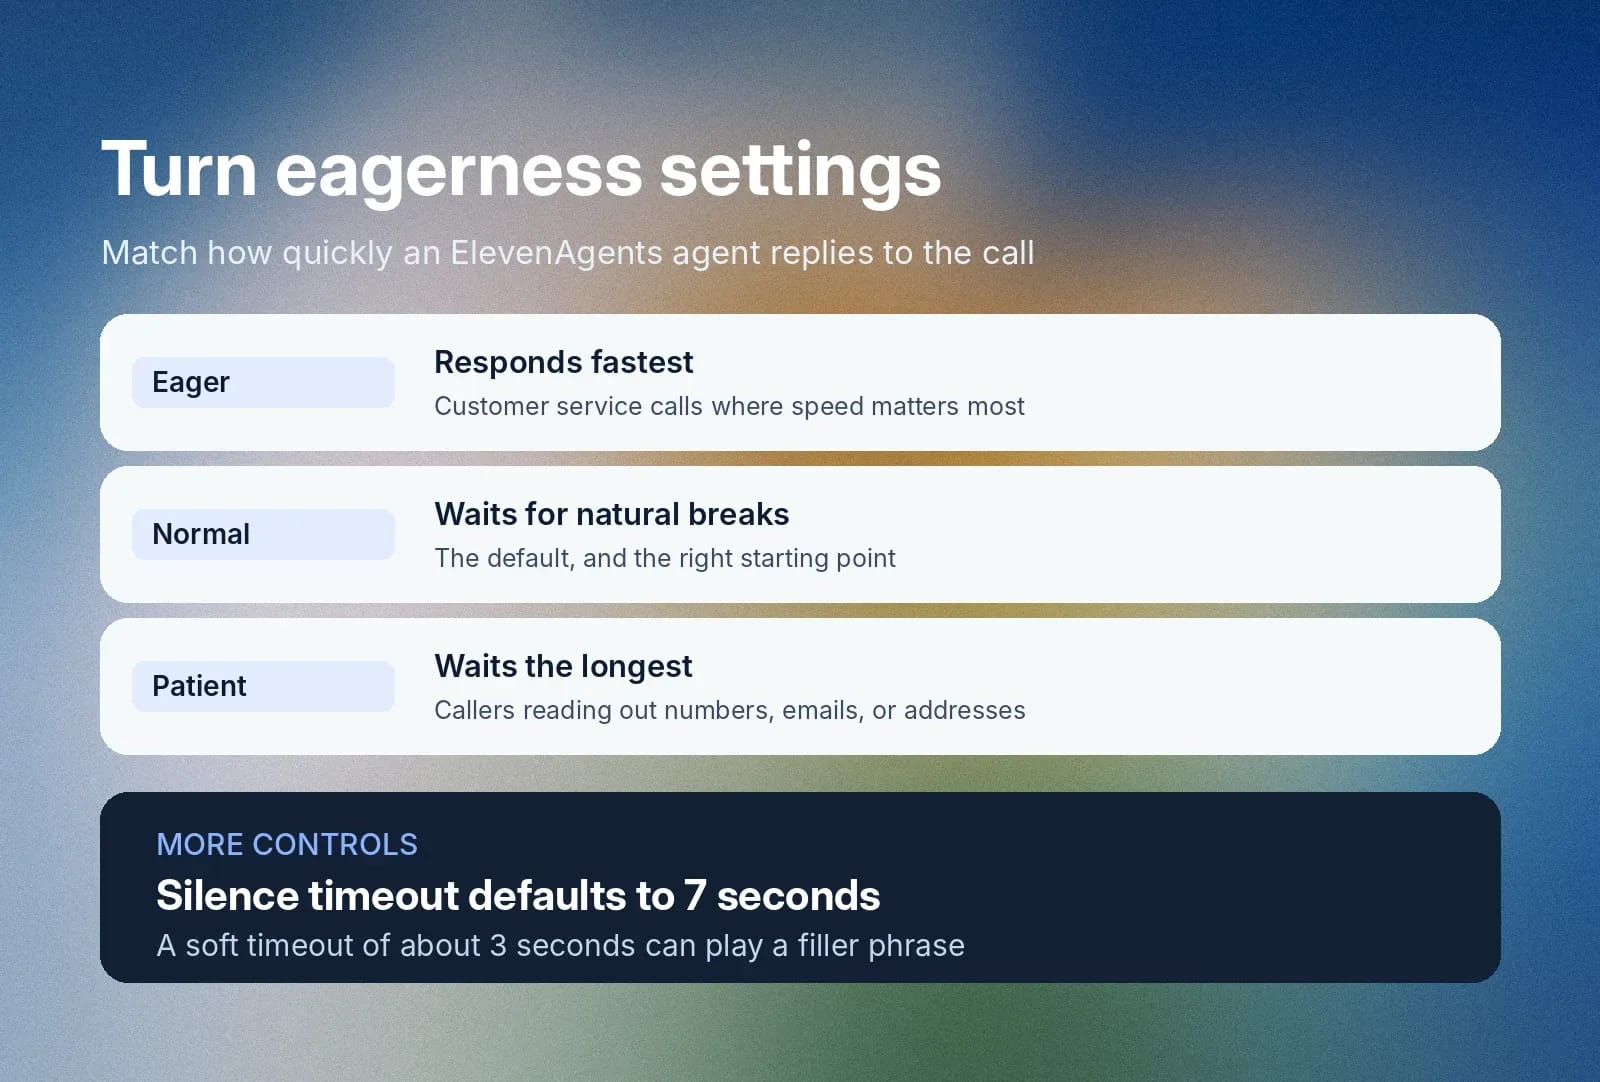
- Détection prématurée de fin de tour : réglez l’empressement du tour sur Patient lorsque les appelants énoncent des numéros de téléphone, des emails, des adresses ou d’autres informations sensibles. L’empressement comporte trois niveaux distincts. Eager répond plus rapidement, Normal (par défaut) attend les pauses naturelles et Patient attend le plus longtemps. Vous pouvez aussi ajuster le délai d’expiration du silence selon le cas d’usage, par exemple de 5 à 10 secondes pour un service client réactif ou de 15 à 30 secondes pour les mentions légales. Les valeurs par défaut et les plages recommandées varient selon le canal et le scénario.
- Silence et réponses tardives : utilisez l’empressement Eager pour les appels de service client où la rapidité est essentielle. Speculative turn lance la réponse du modèle de langage avant que l’agent soit certain que l’appelant a terminé, ce qui réduit la latence mais peut également augmenter les coûts liés aux LLM. Un délai d’expiration souple peut aussi diffuser une courte phrase de remplissage lorsque le modèle est lent. Trois secondes sont recommandées.
- Faux déclenchements et interruptions indésirables : ajoutez des mots d’acquiescement, tels que « d’accord », à une liste d’exclusion afin qu’ils n’interrompent pas l’agent. Désactivez les interruptions lorsque chaque mot doit être entendu, par exemple lors de la lecture d’une mention légale. L’agent peut toujours transcrire les propos de l’appelant et les transmettre au tour suivant. Pour des phrases telles que « donnez-moi une minute », l’outil skip-turn maintient l’agent silencieux et peut relancer l’appelant après un délai défini.
La meilleure façon d’utiliser ces réglages est de les associer à Workflows, qui permet à l’agent de modifier dynamiquement son empressement, par exemple de Normal durant une conversation informelle à Patient lorsqu’il atteint une étape de collecte d’un numéro de téléphone. Commencez avec les réglages par défaut, puis ajustez l’empressement et les délais d’expiration selon les métriques de taux d’interruption et de latence de réponse ci-dessous.
Comment mesurer la qualité de la gestion des tours de parole en IA conversationnelle
Les équipes d’assurance qualité ont besoin de métriques opérationnelles concrètes pour évaluer la gestion des tours de parole en IA conversationnelle. Elles doivent passer de la technologie et des configurations à l’impact réel. En d’autres termes, elles doivent mesurer plus que ce qui paraît naturel ou non.
Le taux d’interruption et la latence de réponse sont les deux principales métriques à considérer. Le taux d’interruption mesure la fréquence à laquelle le modèle coupe incorrectement la parole à un appelant, tandis que la latence de réponse mesure le temps que met le modèle à répondre lorsqu’une personne cesse de parler et attend une réponse. ElevenAgents enregistre ces deux métriques pour chaque appel, afin que les équipes puissent utiliser les données pour optimiser les seuils de détection d’activité vocale sans dépendre d’examens manuels des transcriptions. Consultez notre guide sur la mesure de l’IA conversationnelle pour une présentation complète des cadres d’évaluation.
Les équipes d’assurance qualité maintiennent un haut niveau de précision en mettant en place une cadence structurée d’évaluation du modèle. Voici un exemple de calendrier utilisé par une équipe type.
Activité d’évaluation
Fréquence
Objectif d’assurance qualité
Suivi opérationnel
Hebdomadaire
Suit les performances en temps réel et détecte les problèmes de temporisation sur les agents vocaux en direct
Évaluations de satisfaction utilisateur
Mensuelle
Analyse le ressenti des appelants pour ajuster précisément les configurations de gestion des tours de parole
Évaluations complètes du système
Trimestrielle
Évalue la précision de bout en bout, la gestion des tours de parole et les seuils de latence de réponse
Enfin, même si des métriques automatisées sont disponibles, les équipes d’assurance qualité doivent continuer à prélever certaines données pour les examiner manuellement. Elles obtiennent des données plus précises en examinant les fichiers audio bruts plutôt que les seules transcriptions textuelles. Les transcriptions ajoutent en effet une couche d’automatisation supplémentaire et peuvent manquer des erreurs de l’outil de transcription, notamment lorsque la parole se chevauche.

Essayez ElevenAgents dès aujourd’hui pour des conversations vocales naturelles
Des agents vocaux aux échanges humains, capables de résoudre rapidement les problèmes, réduisent les coûts tout en améliorant l’efficacité opérationnelle. Pour profiter de ces avantages, vous devez utiliser des modèles IA avancés que vous pouvez ajuster précisément afin de gérer correctement les tours de parole. Les équipes d’ingénierie y parviennent en déployant ElevenAgents. Notre architecture unifiée associe détection d’activité vocale et compréhension sémantique pour maintenir une conversation naturelle et réduire la latence.
Consultez notre documentation sur la détection de tour d’ElevenAgents pour configurer une gestion naturelle des tours de parole dans votre équipe de service client ou inscrivez-vous pour commencer.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.