
API Speech to Text
Transcrivez la parole avec ElevenLabs Scribe v3
Notre modèle Speech to Text le plus précis. Transcrivez vos réunions, appels et entretiens, avec des étiquettes d'intervenants et un contrôle des mots qui comptent.
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
L’API Speech to Text la plus précise pour les traitements par lots
Créez des sous-titres, des transcriptions éditables et des légendes pour podcasts, vidéos, interviews et autres contenus enregistrés – tout cela avec une précision inégalée via l’API.
Une précision de transcription inédite
Scribe v3 commet 27 % d'erreurs de mots en moins que Scribe v2 dans 102 langues, et moins que tous les autres modèles de traitement par lots que nous avons testés.
Conçu pour tous les scénarios
Une transcription efficace dans les environnements bruyants, avec musique de fond, accents marqués et audio de faible qualité.
Contrôle précis du timing, des locuteurs et des événements non vocaux.
L’API de transcription ElevenLabs peut détecter les rires, les émotions et les effets sonores. Utilisez le keyterm prompting pour orienter la transcription avec des termes propres à votre domaine.
Transcrivez des fichiers audio et vidéo
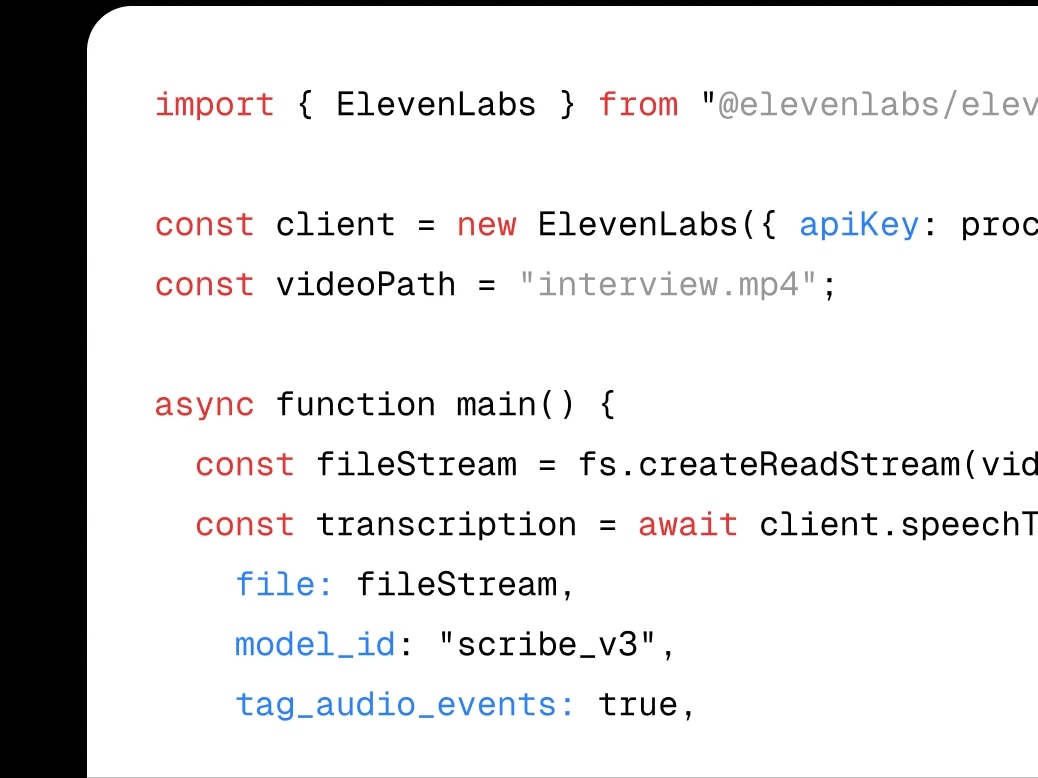
Des transcriptions propres et modifiables

Guidage par termes clés

Balisage audio dynamique
Capturez les événements non vocaux tels que les rires, les applaudissements, la musique et le bruit de fond. Les transcriptions restituent tout le contexte de votre audio, pas seulement les mots.
Diarisation intelligente des locuteurs
Identifiez et étiquetez automatiquement jusqu'à 32 intervenants. Une attribution claire de chaque intervention, organisée dans des transcriptions faciles à lire.
Détection d’entités
Identifiez et étiquetez automatiquement 56 types d’entités, dont les noms, dates, lieux et organisations présents dans vos transcriptions.
Transcrivez l’audio clinique avec Scribe v2 Medical
Un modèle Speech to Text optimisé pour la transcription médicale et les flux de travail cliniques, avec une reconnaissance renforcée des noms de médicaments et des termes d’anatomie et de pathologie.
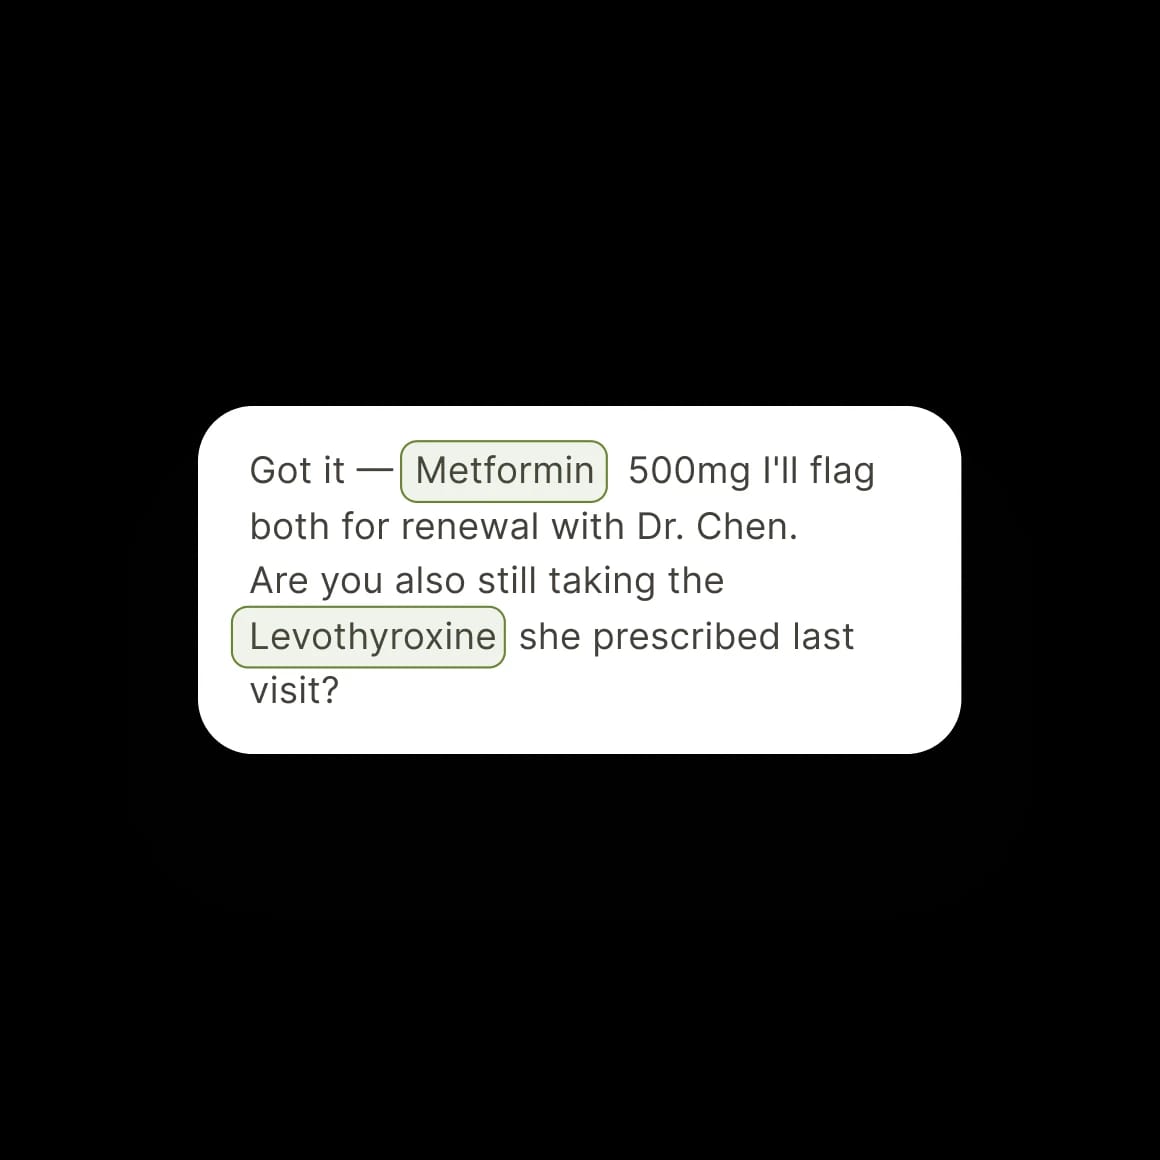
Transcrivez la parole clinique
Convertissez les échanges entre soignants et patients, les dictées médicales et les informations recueillies auprès des patients en texte précis, prêt à être vérifié par les cliniciens et utilisé dans les notes, le codage et les flux de documentation en aval.
Moins d’erreurs sur les termes médicaux
Sur le term-WER, Scribe v2 Medical commet 15 % d’erreurs en moins que Scribe v2 sur la partition de test Eka Medical ASR, avec une meilleure reconnaissance vocale du vocabulaire clinique.
Scribe v3
Précision élevée, conçu pour les charges de travail par lots.
- 27 % d'erreurs en moins que Scribe v2
- Taux d'erreur de diarisation le plus bas parmi les modèles testés
- Formatage des nombres et indications de langue
- Détection d'entités et keyterm prompting
- Plus de 90 langues prises en charge
Scribe v3 Live
Latence réduite, pour les charges de travail en temps réel.
- Latence inférieure à 150 ms
- 43 % d'erreurs en moins que v2 Realtime
- Bibliothèque de termes clés et mode multilingue
- Détection des tours de parole améliorée
- Plus de 90 langues prises en charge
Scribe v2 Medical
Affinage médical, pour la transcription clinique.
- Vocabulaire médical adapté
- Transcription dans plus de 90 langues
- Même niveau que Scribe v2 pour la parole courante
- Meilleure reconnaissance des noms de médicaments
- Éligible à la conformité HIPAA pour les clients Enterprise
Transcrivez la parole dans plus de 90 langues et une grande variété d’accents
Une précision remarquable, quels que soient les accents, les dialectes et les conditions d’enregistrement.
Modifiez languageCode pour prévisualiser les langues
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // Définir la langue
diarize: true
});
console.log(transcription);


Au service des plus grandes entreprises et marques mondiales
“Du doublage de Reels dans les langues locales à la génération de musique et de voix de personnages dans Horizon, la plateforme ElevenLabs permet aux créateurs, aux entreprises et aux grandes organisations du monde entier de concevoir à grande échelle avec la voix, la musique et le son.”

“La précision de Scribe dans un si grand nombre de langues permet à Fieldy de comprendre chaque conversation quotidienne et de se développer facilement sur tous les continents. Depuis son passage à ElevenLabs Scribe, Fieldy a augmenté la rétention de ses utilisateurs de 50 %.”

“ElevenLabs nous a permis d’intégrer rapidement de puissantes fonctionnalités de synthèse vocale à notre SDK, afin que les Agents puissent répondre en temps réel aux questions des utilisateurs avec des voix expressives ou réagir à ce qu’ils perçoivent.”
“Twilio a intégré la technologie de voix IA générative d’ElevenLabs à son CPaaS afin d’améliorer ConversationRelay. Cette intégration permet aux entreprises et aux développeurs de créer, directement depuis la plateforme CPaaS de Twilio, des interactions vocales avec une IA conversationnelle au rendu humain, expressif et réactif en temps réel. Chez ElevenLabs, nous sommes ravis que Twilio ait choisi ElevenLabs pour enrichir ConversationRelay de voix parmi les plus expressives et naturelles disponibles. ”

Des API prêtes pour la production

Les données sont chiffrées en transit et au repos, avec une prise en charge de la conformité SOC 2, HIPAA et RGPD. L’hébergement des données en Europe et les modes Zero Retention sont disponibles pour un contrôle plus strict des données.
Les données sont chiffrées en transit et au repos, avec une prise en charge de la conformité SOC 2, HIPAA et RGPD. L’hébergement des données en Europe et les modes Zero Retention sont disponibles pour un contrôle plus strict des données.
SDK Python et TypeScript officiels, avec sécurité de typage, prise en charge du streaming et exemples clairs.
Notre équipe assure un déploiement fluide et la fiabilité de vos opérations, pour des performances constantes en toute sérénité.
