
Qu’est-ce que la prosodie et comment façonne-t-elle la langue parlée ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
La prosodie désigne le rythme, l’accentuation et l’intonation de la parole, ces schémas qui donnent à nos mots un sens au-delà de leur définition littérale. La hauteur de notre voix, notre débit et l’endroit où nous accentuons les mots contribuent tous à la manière dont le langage est communiqué et compris.
Auparavant utilisée uniquement pour décrire la parole humaine, la prosodie devient tout aussi pertinente pour les outils de voix IA conçus pour la générer. Elle joue un rôle majeur dans la façon dont l’IA paraît humaine, en allant au-delà du choix et de l’ordre des mots pour y ajouter les légères inflexions qui transmettent le sens. C’est particulièrement vrai dans des contextes comme le service client ou la narration audio, où un mot prononcé de la mauvaise façon peut compromettre tout le message.
Cet article définit la prosodie, en donne des exemples et explique son importance pour les modèles de Text to Speech (TTS), afin de vous aider à comprendre ce qui permet à l’IA de paraître plus humaine, à l’écoute comme dans son expression.
En résumé
- En lecture, la prosodie reflète la compréhension d’un texte par le lecteur et contribue à sa fluidité.
- La prosodie permet aux modèles Text to Speech de transformer un texte brut en audio naturel à la voix humaine.
- Vous pouvez ajouter de la prosodie aux voix IA grâce à des outils tels que le choix de voix, les balises audio et la ponctuation.
Qu’est-ce que la prosodie ?
La prosodie désigne les schémas de hauteur, de rythme et d’accentuation dans la parole. Elle comprend la manière dont quelque chose sonne, comme les phonèmes, ainsi que l’intention émotionnelle des mots : donner un ordre, poser une question, faire une affirmation ou être sarcastique.
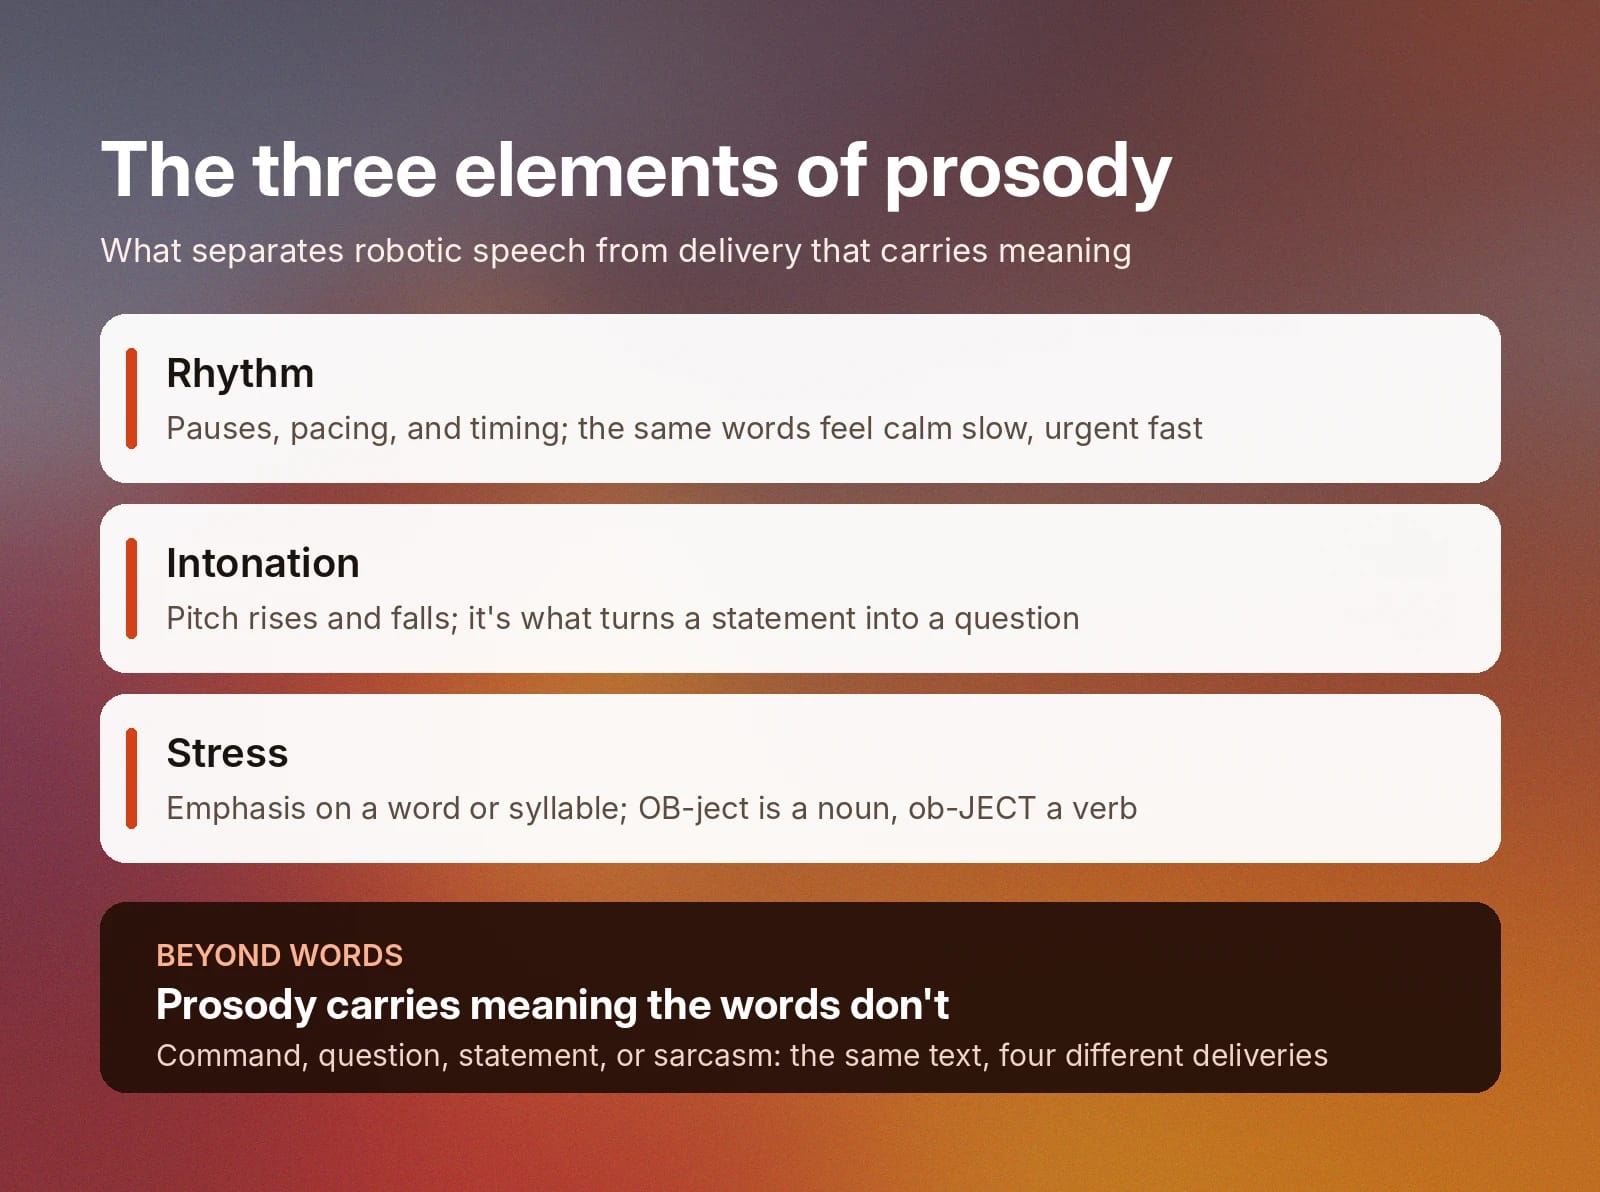
Pour évaluer la prosodie, on examine généralement trois éléments :
- Rythme : la manière dont le timing et le débit de la parole créent des schémas.
- Intonation : la manière dont la hauteur monte et descend au fil d’une phrase.
- Accentuation : la manière dont certains mots ou syllabes sont mis en valeur par la hauteur, le volume ou la durée.
La capacité à maîtriser ces trois éléments distingue une parole ====--ic d’une élocution qui transmet un sens au-delà des mots eux-mêmes.
Comprendre la prosodie dans la parole : rythme, intonation et accentuation
Même s’ils semblent simples, le rythme, l’intonation et l’accentuation mobilisent de nombreux éléments pour transmettre les émotions qui se cachent derrière nos mots.
Examinons de plus près l’influence de ces trois éléments essentiels sur la parole.
Rythme
Le rythme façonne les pauses, le débit et le timing qui structurent la parole. Les langues romanes, comme le français et l’espagnol, tendent à accorder un temps égal à chaque syllabe, tandis que l’anglais et l’allemand présentent davantage de variations dans le timing et le débit des mots.
Le rythme peut aussi changer la manière dont une phrase est perçue. Dire lentement et régulièrement « Nous sommes en route » rend la phrase rassurante. Dites-la rapidement, et les mêmes mots semblent s’enchaîner, créant un sentiment d’urgence.
Débit plus lent
Intonation
L’intonation désigne la façon dont la hauteur de la voix monte et descend. Elle permet souvent de distinguer une question d’une affirmation.
Prenez cette phrase : « Jim a gagné le match. » Lorsqu’elle se termine par un point, « match » se prononce sur la même hauteur que le reste des mots. Mais pour indiquer qu’il s’agit d’une question (« Jim a gagné le match ? »), votre voix monterait à la fin.
Elle peut aussi exprimer des émotions. Un « Bonjour ! » enthousiaste n’aura pas la même hauteur qu’un « Bonjour. » déçu ou désintéressé.
Jim a gagné le match
Accentuation
L’accentuation désigne la manière dont un mot ou une partie d’un mot est mis en valeur.
Le mot anglais « object », par exemple, a deux sens. Lorsque l’accent porte sur la première partie (« OB-ject »), le locuteur désigne le nom. Lorsqu’il porte sur la seconde (« ob-JECT »), le mot devient un verbe.
Dans une phrase, l’accentuation met l’accent sur un mot. Mettre l’accent sur « Je » dans « Je voyais Jim au match » indique à l’auditeur qu’il est important de savoir qui a vu Jim au match. À l’inverse, mettre l’accent sur « match » indique à l’auditeur où il a vu Jim.
Comment la prosodie influence-t-elle la lecture ?
En lecture, la prosodie donne du contexte aux mots. Pensez à la façon dont vous lisez une histoire à voix haute à un enfant : sans varier les voix et les intonations, il aurait plus de mal à comprendre ce que ressent un personnage ou ce qu’exprime une scène.
La prosodie est également un indicateur fiable de la fluidité de lecture. Les personnes qui maîtrisent une langue peuvent prendre des mots écrits et y ajouter une accentuation prosodique, montrant qu’elles comprennent non seulement le sens des mots, mais aussi le sens implicite qui n’est pas écrit sur la page.
Globalement, la prosodie améliore l’alphabétisation et la maîtrise d’une langue en donnant du contexte aux mots et aux expressions. Elle réduit aussi les malentendus en reliant le sens des mots au public ou à la situation dans laquelle ils sont prononcés.
Pourquoi la prosodie est-elle importante pour les modèles Text to Speech ?
Les mots qu’un modèle Text to Speech transforme en audio, qu’ils proviennent d’un script ou soient générés par un LLM, commencent sous la forme de texte brut. Ces mots peuvent être parfaitement justes, mais le texte seul ne véhicule ni ton, ni accentuation, ni émotion.
Pensez à un bot SVI classique qui vous dit : « Je suis désolé. Je n’ai pas compris. » Cette phrase est généralement prononcée avec une prosodie plate, et la plupart des auditeurs n’auront donc pas l’impression que le bot est réellement désolé du désagrément causé.
Comparez ce scénario à un agent vocal IA chargé de gérer un client frustré dont le vol a été annulé.
La réponse paraît humaine lorsque l’agent IA dit : « Je comprends, et je suis vraiment désolé », car elle n’est pas monocorde. Elle comprend un léger gémissement, une pause au début et un ton grave, autant d’éléments qui transmettent des excuses au même titre que les mots.
En maîtrisant ces éléments prosodiques, l’agent peut désamorcer un moment de tension au lieu d’ajouter à la frustration.
Les modèles Text to Speech ne servent pas uniquement aux agents IA. Ils alimentent aussi les outils d’ElevenCreative pour les voix off, la narration et les contenus marketing. Une voix IA qui utilise correctement la prosodie peut vous aider à :
- Voix off : créez des publicités, des vidéos explicatives et des contenus pour les réseaux sociaux réellement captivants.
- Livres audio : narrez avec la nuance émotionnelle appropriée, afin de restituer la peur, la joie ou le sarcasme d’un personnage comme le ferait un narrateur humain.
- Localisation : préservez l’intention émotionnelle du contenu original dans toutes les langues.
- Marketing et messages de marque : conservez le ton approprié dans l’audio, en évitant une élocution solennelle lorsqu’un ton dynamique s’impose, et inversement.
La prosodie rend tout cela possible. Voyons maintenant comment les modèles Text to Speech la produisent concrètement.
Comment les modèles TTS génèrent la prosodie
Les modèles neuronaux de Text to Speech (TTS neuronal) actuels génèrent la prosodie grâce à des modèles de deep learning entraînés sur de véritables paroles humaines. Au lieu de suivre des règles phonétiques écrites à la main, le modèle apprend la relation entre le texte et ce qu’il donne réellement lorsqu’il est prononcé à voix haute.
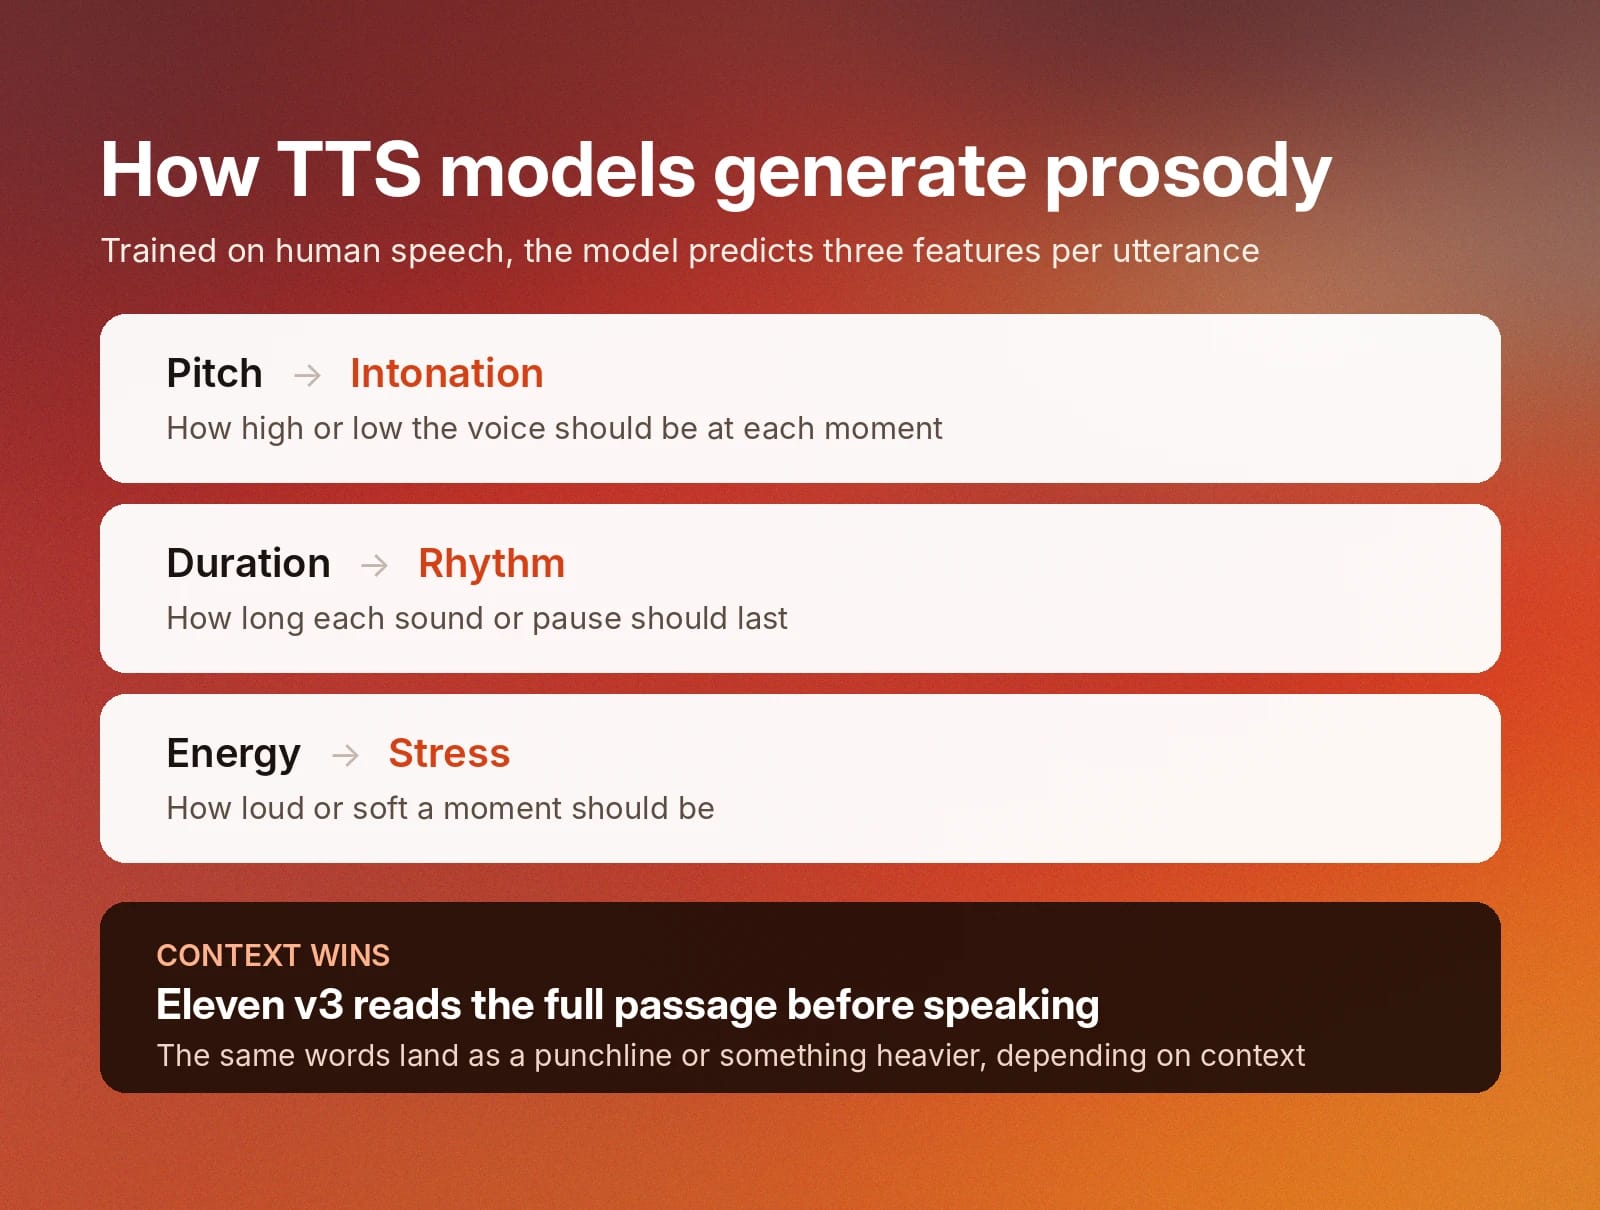
Ce processus d’entraînement permet au modèle TTS de prédire trois caractéristiques sur l’ensemble d’un énoncé :
- Hauteur : le niveau, grave ou aigu, que doit prendre la voix, ce qui produit l’intonation.
- Durée : le temps que doit durer chaque son ou pause, ce qui produit le rythme.
- Énergie : le volume, fort ou doux, d’un moment donné, ce qui produit l’accentuation et l’emphase.
Par exemple, un modèle entraîné sur des milliers d’heures de parole humaine aura entendu d’innombrables questions exprimant l’incrédulité, comme « Attends, tu as fait quoi ? », prononcées avec une forte montée de la voix et un surcroît d’énergie sur le dernier mot. Il apprend ce schéma par exposition répétée et applique la même élocution lorsqu’il rencontre ensuite une phrase exprimant le même type d’incrédulité.
Toutefois, la quantité de contexte dont un modèle peut tenir compte pour générer cette élocution dépend aussi de l’architecture qui effectue la prédiction.
Les anciens modèles TTS fonctionnaient selon un pipeline : ils traitaient le texte une phrase à la fois et transmettaient les prédictions entre réseaux distincts avant de produire l’audio. Les modèles plus récents, fondés sur les transformeurs, regroupent ce pipeline dans un seul processus de bout en bout.
Au lieu de lire une phrase isolément, le modèle lit d’abord l’intégralité du passage, puis utilise ce contexte plus large pour déterminer comment une ligne doit sonner. Les mêmes mots peuvent faire office de chute ou revêtir un sens bien plus lourd selon ce qui les entoure.
Des modèles comme Eleven v3 lisent l’intégralité du passage avant de générer l’audio afin que l’intonation reflète le contexte du texte environnant.
Comment les utilisateurs contrôlent la prosodie en TTS
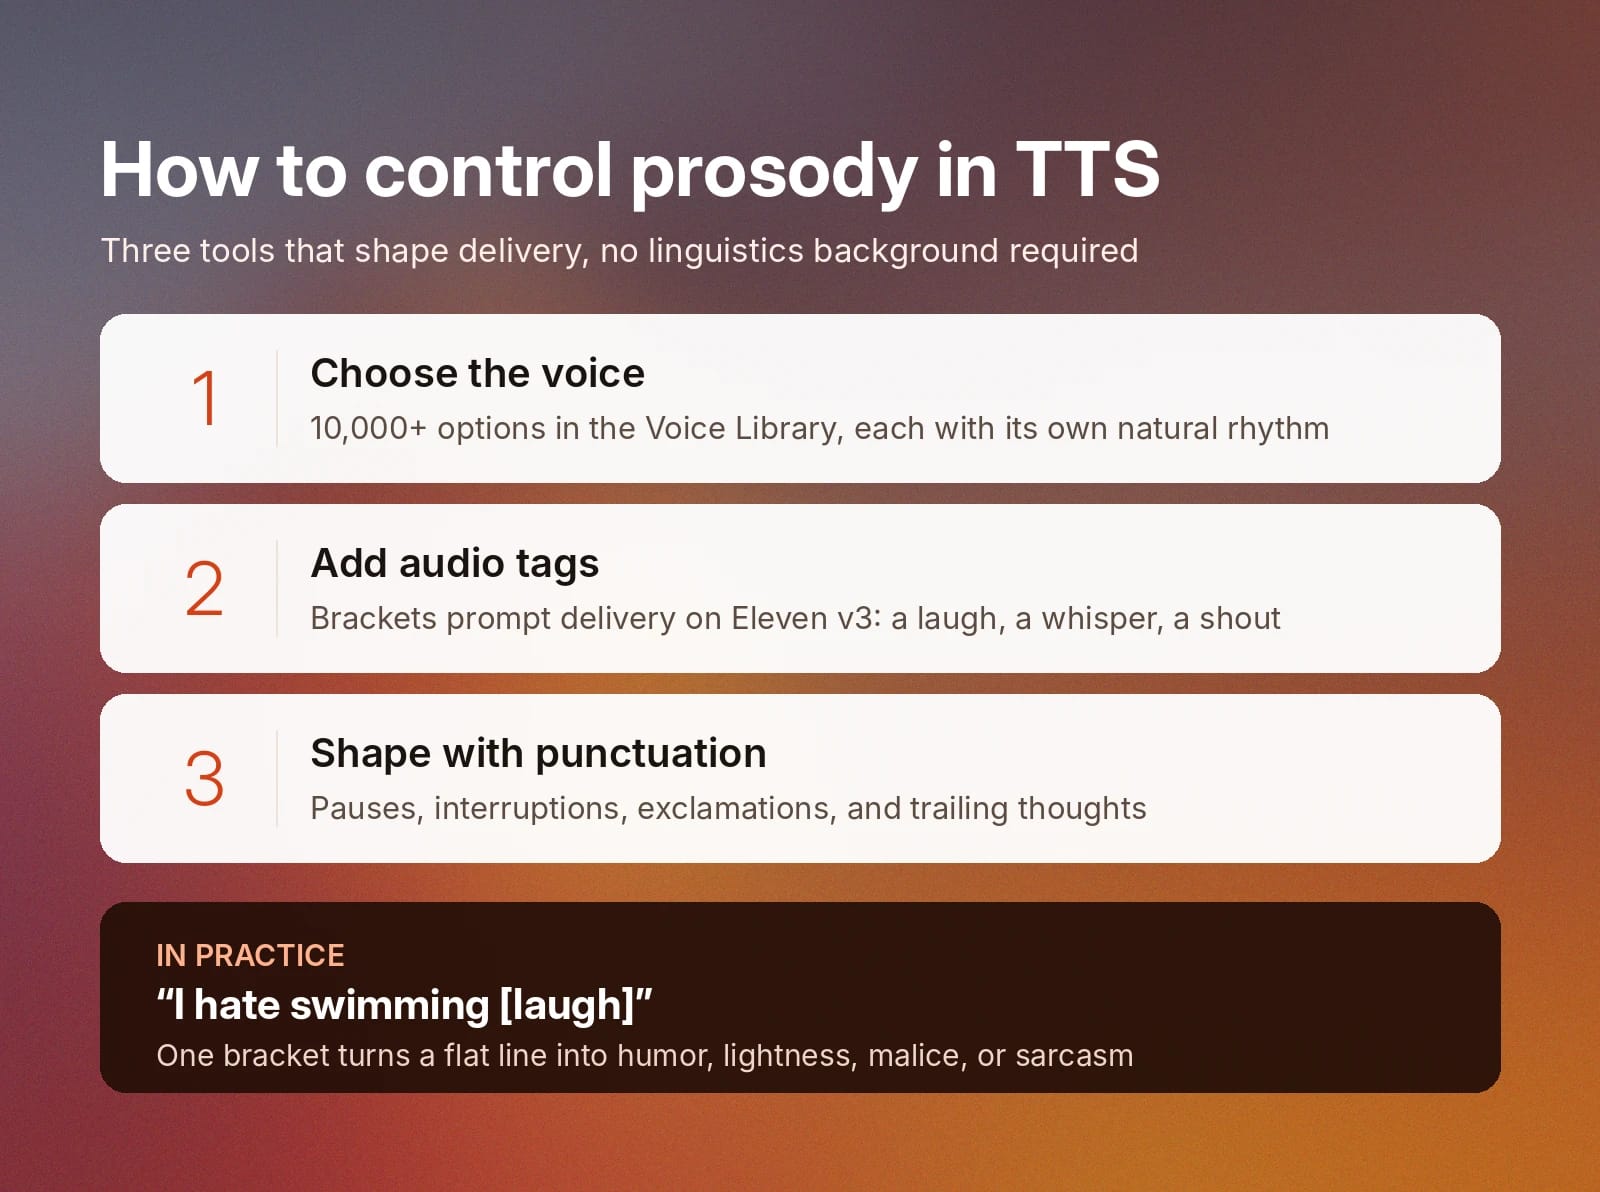
Les utilisateurs peuvent contrôler la prosodie en TTS en choisissant des voix IA distinctives et en insérant des balises émotionnelles dans leurs scripts. ElevenCreative, par exemple, vous donne accès à la Voice Library, où vous pouvez choisir parmi plus de 10 000 voix pour trouver celle qui possède le rythme et l’intonation naturels que vous recherchez.
Eleven v3, notre modèle TTS le plus expressif, vous offre également la possibilité d’ajouter des balises audio entre crochets dans le texte, afin d’indiquer au modèle un élément prosodique précis à restituer. Vous pouvez vouloir insérer un rire entre deux phrases pour exprimer l’humour, la légèreté, la malveillance ou le sarcasme, ou demander au modèle vocal de chuchoter ou de crier un mot pour le mettre en valeur. La ponctuation peut également créer des pauses, des interruptions, des exclamations, des questions ou des fins de phrase en suspens.
Voici à quoi cela peut ressembler :
- « [laughing] Je déteste nager. »
- « [surprised] Je n’arrive pas à croire qu’il ait fait ça ! Je suis choqué… et impressionné. »
- « [annoyed] Ne fais pas ça ! »
Voyons-les en action :
Grâce à ces outils, vous n’avez pas besoin de connaissances en linguistique ou en production audio pour contrôler la prosodie. Chacun peut façonner le rendu d’une voix IA, simplement en choisissant une voix, en ajoutant une balise ou en ajustant la ponctuation.
Améliorez l’expressivité des voix IA avec ElevenCreative
Que vous diffusiez des publicités, publiiez sur les réseaux sociaux ou créiez des vidéos, vous voulez qu’elles sonnent comme si une vraie personne les avait créées et interprétées.
ElevenCreative vous permet de générer de l’audio et des visuels à grande échelle en quelques minutes. Sa plateforme native IA peut transformer un texte écrit en une parole humaine adaptée au contexte, à l’émotion et à l’intention du locuteur. Avec plus de 70 langues disponibles dans Eleven v3 et une vaste bibliothèque de voix, vous avez l’assurance d’adopter le ton juste auprès de votre public.
Découvrez le TTS sur ElevenCreative ou inscrivez-vous pour commencer et découvrir comment une voix IA à la prosodie naturelle peut transformer vos contenus.
FAQ sur la prosodie

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.

