
Guide du dictionnaire de prononciation : corrigez n’importe quel mot en TTS avec Eleven v4
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Eleven v4 établit une nouvelle référence en matière de prononciation pour les modèles Text to Speech, en traitant les abréviations, les termes techniques, les noms et les textes multilingues avec une précision inédite. Chaque marque possède toutefois son propre vocabulaire, des noms de produits uniques au jargon sectoriel, et vous devez pouvoir contrôler entièrement la façon dont ces termes sont prononcés.
Eleven v4 propose plusieurs moyens de corriger la prononciation et vous offre un contrôle précis de la façon dont le modèle parle. Créez un dictionnaire de prononciation complet qui s'applique à tous les scripts que vous rédigez dans l'application TTS. Ou intégrez directement l'API dans votre texte pour une correction ponctuelle.
Voici un bref exemple d'Eleven v4 traitant un script rempli de termes complexes :
Ce guide explique comment créer et utiliser un dictionnaire de prononciation TTS, ainsi que toutes les stratégies complémentaires pour que votre audio corresponde au plus près à ce que vous aviez imaginé.
En résumé
- Un dictionnaire de prononciation est un ensemble de règles que vous rédigez pour indiquer à un modèle Text to Speech comment prononcer certains mots ou certaines expressions.
- Les règles de prononciation TTS reposent soit sur des alias, qui remplacent le texte, soit sur des phonèmes, qui utilisent une transcription phonétique.
- Eleven v4 prend en charge les règles par phonèmes et l'API en ligne (Alphabet phonétique international).
- Les balises phonème et pause SSML ne fonctionnent pas avec Eleven v4, mais vous pouvez utiliser un dictionnaire de prononciation ou les Audio Tags comme alternative en langage naturel.
- Vous pouvez appliquer jusqu'à trois dictionnaires de prononciation par requête via ElevenAPI.
Qu'est-ce qu'un dictionnaire de prononciation ?
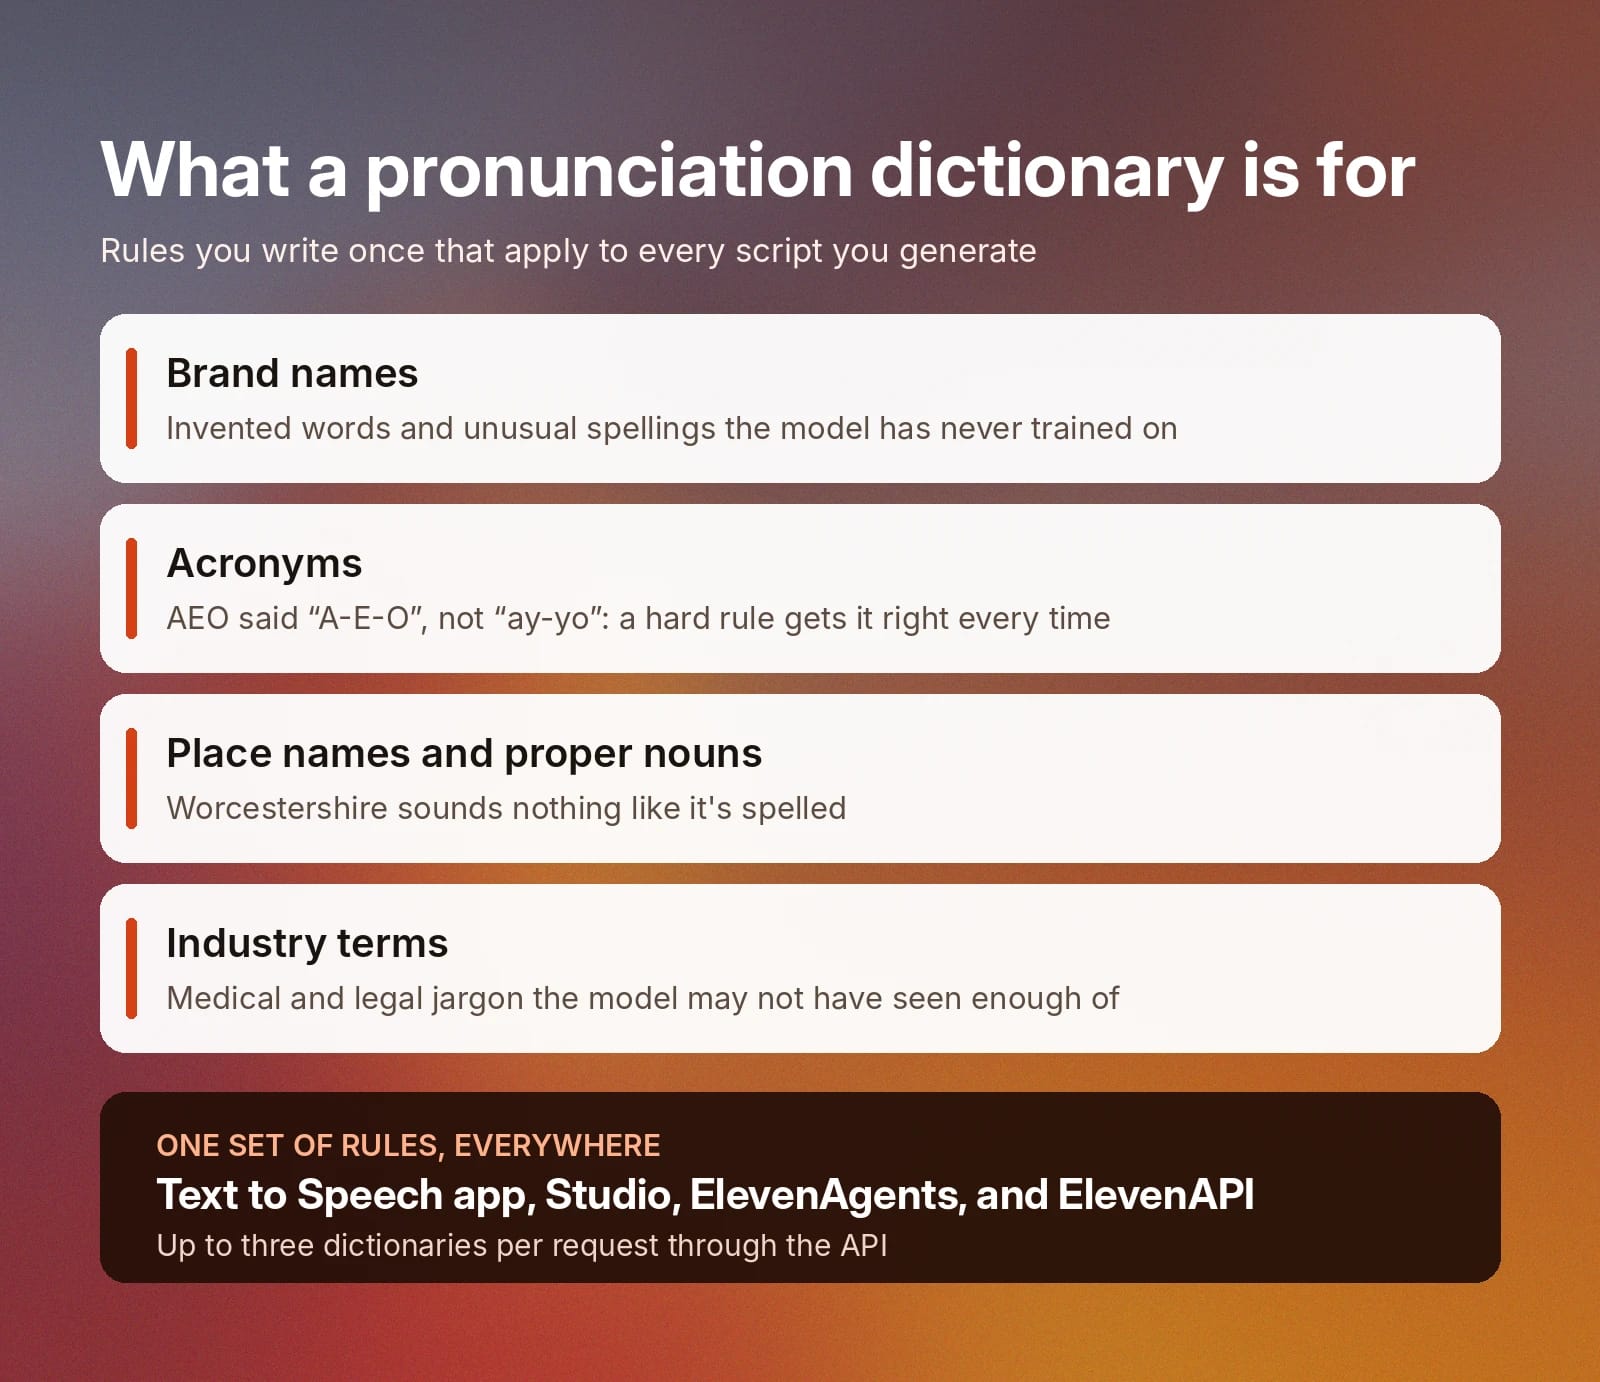
Un dictionnaire de prononciation est un outil qui vous permet de configurer précisément la façon dont un modèle Text to Speech prononce certains mots. En ajoutant des mots ou des expressions à un dictionnaire de prononciation, vous définissez leur prononciation chaque fois qu'ils apparaissent dans un script TTS.
Les dictionnaires de prononciation sont généralement utilisés pour :
- Noms de marques : les noms de marques figurent fréquemment dans les dictionnaires de prononciation, surtout lorsqu'ils présentent une orthographe unique ou inhabituelle.
- Acronymes : certains acronymes doivent être prononcés d'une manière précise. Par exemple, AEO doit se prononcer /ˌeɪ.iːˈoʊ/ (« A-E-O »), et non /eɪˈjoʊ/ (« ay-yo »). Une règle stricte du dictionnaire garantit que le modèle le prononce correctement chaque fois que vous l'écrivez.
- Noms de lieux et autres noms propres : certains noms de lieux peuvent se prononcer très différemment de ce que leur orthographe laisse imaginer. Worcestershire est un exemple célèbre pour lequel un guide de prononciation peut éviter tout problème.
- Termes sectoriels : le jargon professionnel ou des termes spécialisés, notamment dans les domaines médical et juridique, peuvent bénéficier d'un dictionnaire de prononciation si le modèle n'a pas été explicitement entraîné sur des données issues de ces secteurs.
En dehors du Text to Speech, les dictionnaires de prononciation sont généralement des répertoires participatifs d'extraits audio enregistrés par des locuteurs natifs, que les apprenants utilisent pour écouter la prononciation de certains mots.
Comment contrôler la prononciation TTS avec Eleven v4
Eleven v4 est classé comme le modèle Text to Speech de la plus haute qualité par Provider Voice Arena d'Artificial Analysis.1 La capacité du modèle à traiter des textes complexes tout en produisant un rendu naturel contribue à faire d'Eleven v4 une référence sur le marché.
Pour offrir aux utilisateurs la meilleure expérience possible avec Eleven v4, le modèle propose plusieurs options de personnalisation de la prononciation afin que chaque rendu réponde à vos exigences de précision.
Voici comment contrôler la prononciation avec Eleven v4 :
- API en ligne : vous pouvez insérer l'API dans vos scripts, entre barres obliques, pour guider la prononciation sans utiliser de dictionnaire. Nous aborderons bientôt la marche à suivre en détail.
- Règles de phonèmes dans les dictionnaires : ajoutez des règles basées sur les phonèmes à vos dictionnaires de prononciation pour contrôler la prononciation phonétique de mots récurrents.
- Prononciation fluide dans toutes les langues : Eleven v4 peut générer une parole naturelle dans plus de 90 langues. Préservez la prononciation native dans chaque langue tout en utilisant la même voix, pour une expérience de branding sonore cohérente.
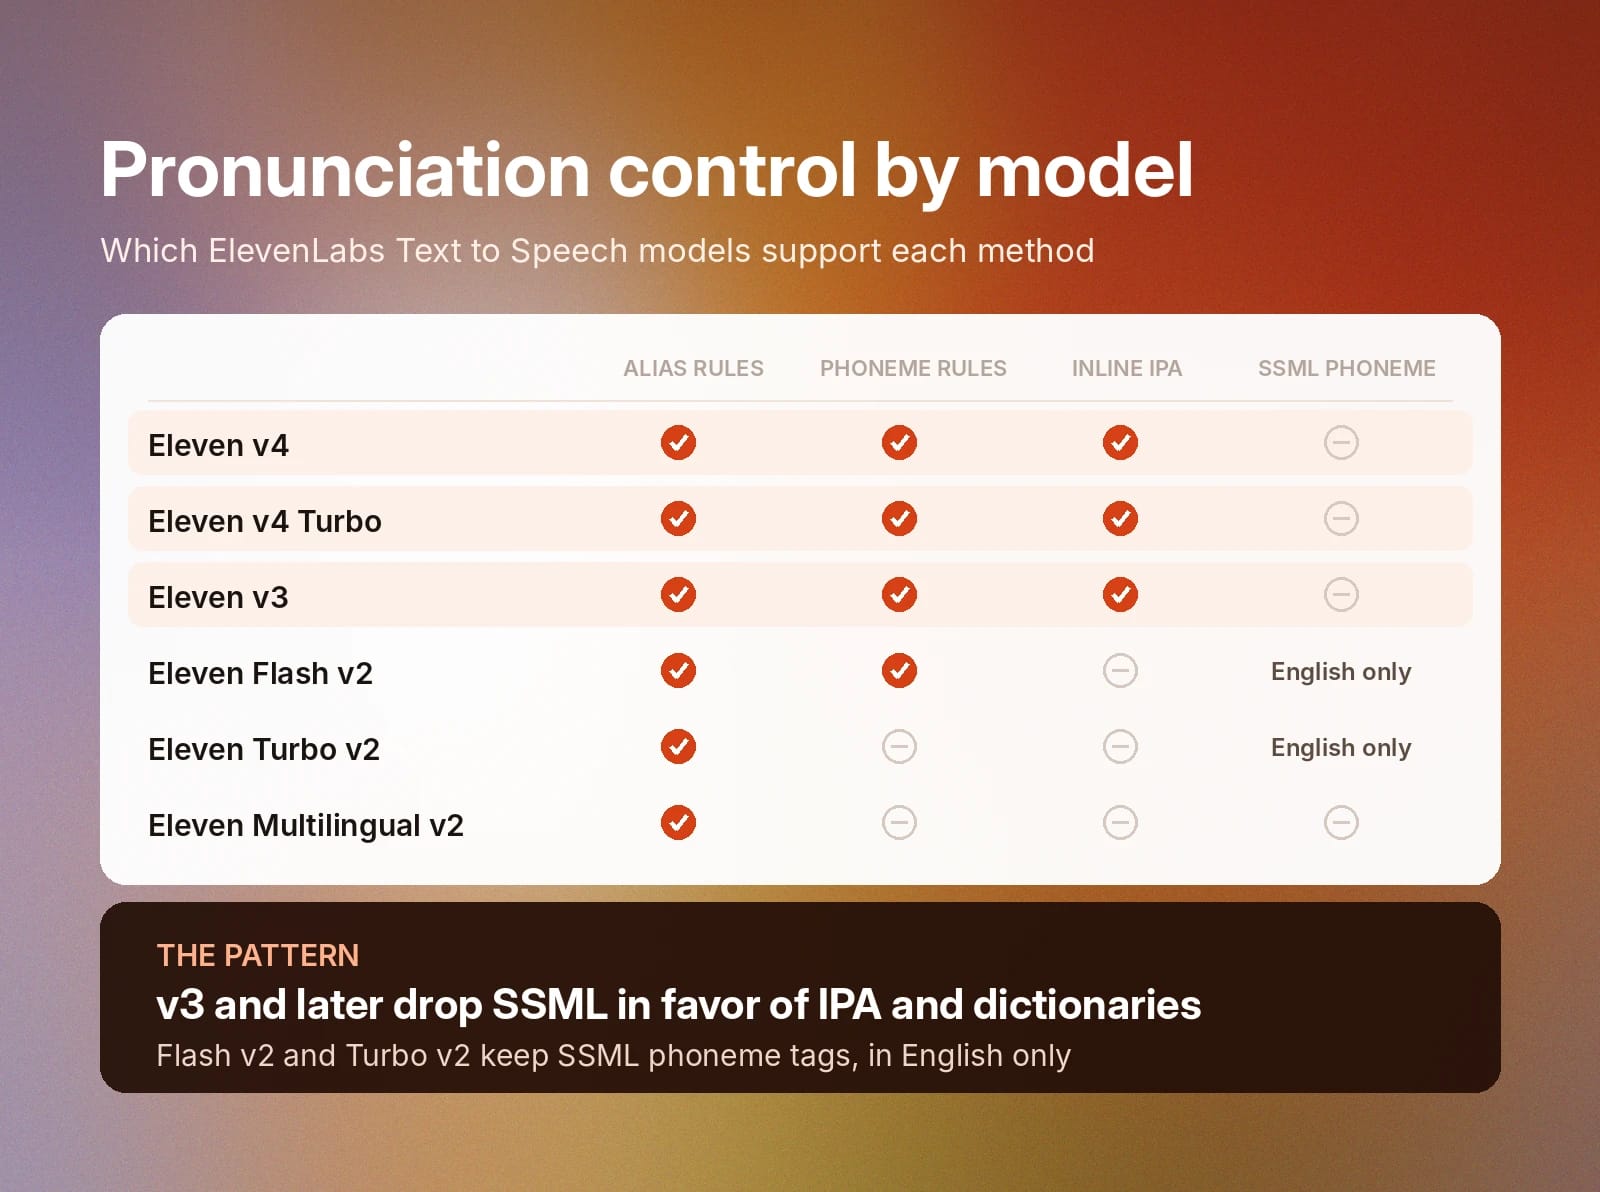
Voici comment les différents modèles TTS d'ElevenLabs se comparent en matière de contrôle de la prononciation :
Modèle
Règles d'alias (dictionnaire)
Règles de phonèmes (dictionnaire)
API en ligne (/.../)
Balises de phonèmes SSML (<phoneme>)
Eleven v4
Oui
Oui
Oui
Non
Eleven v4 Turbo
Oui
Oui
Oui
Non
Eleven v3
Oui
Oui
Oui
Non
Eleven Flash v2
Oui
Oui
Non
Oui (anglais uniquement)
Eleven Turbo v2
Oui
Non
Non
Oui (anglais uniquement)
Eleven Multilingual v2
Oui
Non
Non
Non
Quelle est la différence entre les règles d'alias et de phonèmes dans un dictionnaire de prononciation ?
Les règles de prononciation par alias remplacent un texte par un autre avant que le modèle ne prononce le mot. Cette opération s'effectue en arrière-plan chaque fois qu'un modèle génère de l'audio, en remplaçant la prononciation d'un mot ou d'une expression par celle définie dans votre dictionnaire de prononciation.
Voici quelques exemples de règles de prononciation par alias :
- « SaaS » devient « sass »
- « UN » devient « United Nations »
- « OAuth » devient « oh auth »
À l'inverse, les règles de phonèmes fournissent au modèle une transcription phonétique précise à utiliser. Elles sont plus difficiles à créer, car vous devez rédiger ou générer vous-même la transcription API, puis l'ajouter à votre dictionnaire. Par exemple, « Kubernetes » devient /ˌkuː.bərˈnɛt.iːz/.
Comment corriger la prononciation d'un nom de marque dans un modèle TTS
Les noms de marques sont parmi les entrées les plus courantes dans les dictionnaires de prononciation, car ce ne sont pas toujours de vrais mots. Si votre entreprise a inventé un mot ou une orthographe propre à votre marque, les modèles TTS peuvent avoir du mal à le prononcer correctement, faute de données d'entraînement accessibles incluant cette prononciation précise.
Voici comment corriger la prononciation d'un nom de marque dans Eleven v4 :
- Testez le rendu par défaut : ouvrez l'application Text to Speech et saisissez le nom de votre marque. Générez un extrait et écoutez son rendu. En cas d'erreur de prononciation, passez à l'étape suivante.
- Essayez une règle d'alias : le moyen le plus simple de corriger une erreur de prononciation de marque consiste à créer une règle d'alias. Elles sont rapides à rédiger et intuitives.
- Passez à une règle de phonèmes : si votre règle d'alias ne fonctionne pas parfaitement, utilisez l'API. Transcrivez le nom de votre marque en API, puis créez une règle dans le dictionnaire de prononciation Text to Speech afin de corriger sa prononciation.
- Couvrez toutes les casses : veillez à inclure la transcription API des versions en minuscules comme en majuscules du nom de votre marque, si vous utilisez les deux.
- Utilisez l'API en ligne pour les modifications ponctuelles : si vous souhaitez seulement une correction rapide pour une génération ponctuelle, ajoutez simplement l'API directement dans votre script au lieu de configurer une entrée de dictionnaire.
Après avoir défini une règle pour un nom de marque, elle sera disponible dans tous les projets partagés, que ce soit dans votre agent IA ou via une API.
Comment créer un dictionnaire de prononciation avec ElevenLabs
Vous pouvez créer un dictionnaire de prononciation en ajoutant des règles dans l'application Text to Speech, en important un fichier .pls ou via ElevenAPI. Dans ce guide, nous abordons la première option, qui ne demande que quelques étapes.
Voici les étapes à suivre pour créer un dictionnaire de prononciation :
- Ouvrez le panneau des dictionnaires de prononciation : depuis la page Text to Speech, cliquez sur la barre de recherche en haut, saisissez « Pronunciation dictionary », puis sélectionnez Pronunciation dictionaries dans Actions.
- Créez ou choisissez un dictionnaire : cliquez sur New pour créer un dictionnaire ou sélectionnez-en un existant dans la liste à gauche.
- Ajoutez une règle : cliquez sur Add rule pour créer une ligne. Saisissez le mot à corriger. Dans le champ Input, entrez le mot ou l'expression exactement tel qu'il apparaît dans vos scripts. Les règles sont sensibles à la casse, reproduisez donc la capitalisation utilisée.
- Choisissez le type de règle : sélectionnez Alias pour remplacer le texte, ou Phoneme pour saisir une transcription API ou CMU.
- Saisissez le remplacement : saisissez l'alias ou la transcription phonétique dans le champ Output. Utilisez le sélecteur de voix en haut du panneau pour écouter la règle avec la voix utilisée.
- Enregistrez vos modifications : cliquez sur Save changes en bas du panneau.
Pour associer un guide de prononciation à un agent ou en appliquer un via l'API, consultez notre documentation sur les dictionnaires de prononciation.
Comment utiliser l'API dans le Text to Speech avec Eleven v4
Pour de petites modifications ou des mots peu courants, il n'est pas nécessaire de créer une nouvelle entrée dans votre dictionnaire de prononciation TTS pour corriger une erreur. Utilisez plutôt l'API en ligne pour indiquer précisément comment le modèle doit prononcer un mot.
Dans Eleven v4, vous pouvez activer l'API en ligne à l'aide de barres obliques. Comme les Audio Tags, elle s'insère directement dans votre script afin de simplifier au maximum le processus. Voici quelques exemples d'API dans Eleven v4 :
- Termes techniques : le terme « /ˌbaɪoʊˈkemɪstri/ » désigne l'étude des processus chimiques.
- Vocabulaire médical : « /ɡluːˈkoʊs/ » et « /ˈɪnsjəlɪn/ » sont couramment utilisés pour traiter des maladies telles que « /ˌdaɪəˈbiːtiːz/ ».
- Noms de marques et de produits : nos serveurs fonctionnent avec « /ˌɛndʒɪnˈɛks/ » pour gérer les pics de trafic.
À noter : pour les personnes sans formation en linguistique, un convertisseur API vous aidera à obtenir la bonne transcription API à coller dans votre script à partir d'un texte en langage naturel.
Pourquoi les balises de phonèmes SSML ne fonctionnent pas avec Eleven v4
Eleven v4 ne prend pas en charge le SSML et privilégie plutôt des fonctionnalités plus flexibles, telles que les Audio Tags et les dictionnaires de prononciation, qui vous donnent davantage de contrôle sur la production audio finale.
Chaque fonctionnalité proposée par SSML possède un équivalent direct dans v4 :
Balise SSML
Fonction
Équivalent dans Eleven v4
<phoneme>
Définissait une prononciation phonétique
API en ligne (/…/) ou règle de phonèmes dans le dictionnaire
<sub alias>
Remplaçait le texte avant la prononciation
Règle d'alias dans le dictionnaire
<break>
Ajoutait une pause
Audio Tags tels que [pause], points de suspension ou sauts de ligne
<prosody rate>
Modifiait la vitesse de parole
Audio Tags de rythme tels que [slowly] ou [rushed]
<emphasis>
Accentuation d'un mot
Lettres majuscules ou Audio Tag de delivery
Utilisez dès aujourd'hui la prononciation Text to Speech naturelle avec Eleven v4
Grâce à plusieurs outils permettant d'affiner la précision des prononciations dans Eleven v4, vous pouvez rédiger des scripts détaillés et laisser le modèle les interpréter comme vous l'aviez imaginé.
Créez des dictionnaires de prononciation dans l'application Text to Speech d'ElevenLabs et appliquez-les à grande échelle avec ElevenAPI.
S'inscrire pour commencer ou en savoir plus sur Eleven v4 dès aujourd'hui.
FAQ
- Artificial Analysis, Provider Voice Arena Preference Elo, 30 septembre 2026

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


