Que sont les audio tags ? Le guide complet du TTS émotionnel
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
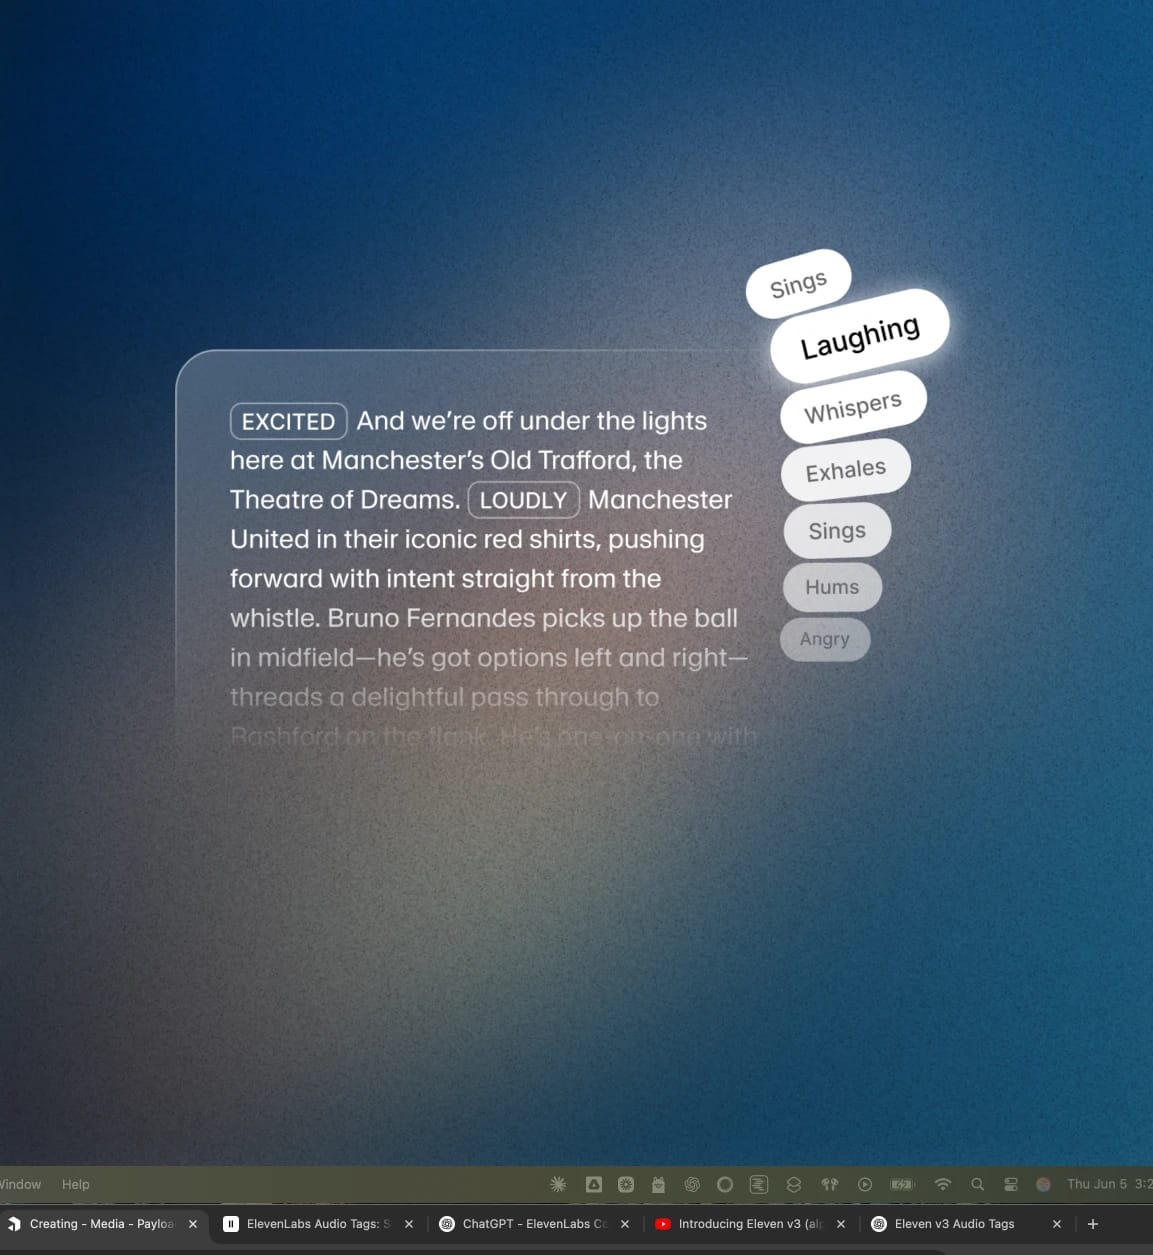
Les Audio Tags sont des indications entre crochets, formulées en langage naturel, telles que [laughs], [gasps], [excited] et [worried], qu’Eleven v3 et Eleven v4 interprètent comme des directives d’interprétation plutôt que comme des mots à prononcer. Lorsque vous rédigez un script pour un modèle de synthèse vocale, l’ajout de ces Audio Tags vous offre un contrôle précis sur son interprétation émotionnelle.
Eleven v3 est devenu accessible au public en mars 2026. Avant v3, obtenir une interprétation émotionnelle précise d’un modèle Text to Speech nécessitait de régénérer le contenu en espérant obtenir le bon résultat. Les Audio Tags éliminent cette part d’incertitude et vous donnent un contrôle total sur l’interprétation émotionnelle de votre synthèse vocale. Eleven v4 va encore plus loin en vous offrant un contrôle émotionnel précis.
Ce guide explique ce que sont les Audio Tags, leur fonctionnement, toutes les catégories de tags disponibles et leur comparaison avec le SSML (Speech Synthesis Markup Language). Nous aborderons également des cas d’usage courants, chacun accompagné de son guide dédié.
En résumé
- Les Audio Tags sont des indications entre crochets, comme [shouts] ou [excited], qui orientent l’émotion, le rythme, l’interprétation et le ton de la synthèse vocale dans Eleven v3 et Eleven v4.
- Eleven v3 et Eleven v4 ne prennent pas en charge le SSML, mais le remplacent par les Audio Tags pour une expérience d’écriture plus naturelle.
- Les tags couvrent plusieurs catégories, notamment les émotions, l’interprétation et le rythme, les réactions humaines, les accents et les effets sonores.
- La ponctuation et les majuscules de votre texte vous permettent de modeler le rythme d’une interprétation par une voix IA.
- Vous pouvez accéder aux Audio Tags dans l’interface ElevenLabs ou via l’API.
Comment fonctionnent les Audio Tags ?
Les Audio Tags s’insèrent directement dans votre transcription et sont placés entre crochets. Chaque fois que vous souhaitez modifier l’interprétation, par exemple passer d’un ton normal à [worried], il vous suffit d’ajouter un audio tag.
Vous pouvez également utiliser plusieurs tags dans une même phrase et les combiner pour une interprétation plus nuancée, par exemple : [tired] La journée a été longue… [upset] Combien de jours encore vais-je tenir ?
L’architecture d’Eleven v4 permet au modèle de comprendre le contexte plus profondément que les modèles précédents. Il peut ainsi suivre les indices émotionnels, les changements de ton, les transitions entre intervenants et les éléments de contexte, sans paramètre ni réglage distinct. Indiquez simplement au modèle ce que requiert le moment, et il interprétera la réplique comme vous l’avez prévu.
Eleven v4 gère également les dialogues entre plusieurs intervenants avec naturel, y compris les interruptions, les changements d’humeur et les échanges spontanés d’une vraie conversation, uniquement grâce aux tags et à la structure du script.
Audio Tags ou SSML
Si vous avez travaillé avec d’autres systèmes de synthèse vocale, vous avez probablement rencontré le Speech Synthesis Markup Language. Des plateformes comme Amazon Polly et Microsoft Azure Speech utilisent des tags SSML comme <break> ou <emphasis> pour apporter davantage de contexte à un script de synthèse vocale.
Eleven v4 ne prend pas en charge les tags de pause SSML ni le reste du jeu de tags SSML. À la place, les Audio Tags, la ponctuation et la structure même du texte remplissent ce rôle, tout en offrant un contrôle précis de l’interprétation.
Le tableau ci-dessous vous permet d’associer les tags SSML courants à leur équivalent dans Eleven v4.
Pour un rédacteur, ajouter [whispers] à une réplique demande bien moins d’efforts que de configurer un débit de prosodie.
Les catégories d’Audio Tags dans v3 : diriger l’interprétation avec les Audio Tags
Vous pouvez placer des Audio Tags n’importe où dans votre script pour façonner l’interprétation en temps réel. Vous pouvez aussi combiner des tags dans un script ou même dans une phrase.
Les tags se répartissent dans les principales catégories suivantes.
Émotions
Ces tags vous aident à définir le ton émotionnel de la voix, qu’il soit sombre, intense ou enjoué. Vous pouvez, par exemple, utiliser un ou plusieurs tags parmi [sad], [angry], [happily] et [sorrowful].
Interprétation et rythme
Ces tags concernent davantage le ton et l’interprétation. Ils permettent d’ajuster le volume et l’énergie des scènes qui exigent de la retenue ou de l’intensité. Citons notamment [whispers], [shouts] et [softly].
Réactions humaines
Une parole véritablement naturelle inclut des réactions. Vous pouvez ainsi gagner en réalisme en intégrant des moments naturels et non scénarisés à la parole. Des tags comme [laughs], [clears throat] et [sighs] contribuent à créer un modèle de synthèse vocale capable d’exprimer des émotions humaines.
Voici d’autres exemples de catégories d’audio tags :
- Accents et voix de personnages : Les tags d’accent font adopter à la voix une région ou une personnalité précise sans changer de modèle, par exemple [French accent], [British accent] ou [pirate voice]. Ils permettent de transformer une seule voix en une distribution flexible, plutôt qu’en une interprétation unique et figée.
- Effets sonores : Les tags d’effets sonores ajoutent directement des sons non verbaux à la génération, comme [gunshot], [explosion] et [clapping]. Ils sont particulièrement adaptés aux expériences audio immersives, aux jeux et aux narrations dramatisées où la scène requiert plus qu’une voix. Vous pouvez également utiliser le générateur d’effets sonores IA ElevenCreative.
Si les tags vous offrent un haut degré de contrôle, vous pouvez aussi utiliser la ponctuation pour modeler le rythme et l’accentuation. Ajoutez par exemple des points de suspension pour une pause naturelle, ou des virgules pour créer des respirations naturelles. Écrivez un mot entièrement en majuscules pour le mettre en valeur : « Je le veux MAINTENANT. »
Que pouvez-vous faire avec les Audio Tags ?
Les Audio Tags donnent accès à toute la complexité émotionnelle des scripts, de manière intuitive. Écrivez naturellement et ajoutez des tags au fil du texte.
Voici un aperçu de quelques cas d’usage de la synthèse vocale émotionnelle avec les Audio Tags.
Conscience situationnelle dans l’audio IA
Des tags tels que [whisper] ou [shouting] permettent à Eleven v4 de réagir au moment. Qu’il s’agisse d’adoucir un avertissement ou de maintenir une pause prolongée pour créer du suspense, vous pouvez intégrer une conscience situationnelle dynamique à votre script.
Pour une analyse complète, consultez notre guide sur la conscience situationnelle dans l’audio IA.
Diriger l’interprétation des personnages
Lorsque vous élaborez un script avec plusieurs personnages, vous devez clairement montrer ce qui distingue chaque voix. De l’ajustement de leur personnalité avec [sarcastically] à la définition de leur façon de parler avec [British accent], notre moteur de synthèse vocale vous permet de restituer toute une palette d’émotions.
Découvrez comment diriger l’interprétation des personnages dans la parole IA.
Exprimer le contexte émotionnel dans la parole
Les Audio Tags vous permettent de façonner l’interprétation émotionnelle d’une réplique au fil de son déroulement. Vous pouvez faire évoluer les émotions tout au long d’un discours jusqu’au crescendo correspondant au moment où votre personnage atteint son plein potentiel. Des tags comme [awe], [booming] et [big laugh] permettent d’intégrer toute une palette émotionnelle à l’interprétation de votre voix IA.
Retrouvez de plus amples informations sur l’utilisation du contexte émotionnel dans la parole IA.
Donner vie aux dialogues entre plusieurs personnages
Pour les dialogues entre plusieurs personnages, vous pouvez commencer chaque réplique par un audio tag afin de créer des échanges riches entre les personnages.
Prenons l’exemple suivant : Tom : [coughing] [beginning to speak] désolé, je suis un peu malade aujourd’hui— Emma : [interrupting] —Malade ? Tu sais à quel point je déteste la toux, Tom ! Tom : [surprised] Ce n’est qu’une petite toux, rien de grave. Que dirais-tu si— Emma : [overlapping] [annoyed] —Je pense que tu devrais rentrer chez toi.
Découvrez ce que vous pouvez encore faire avec les dialogues entre plusieurs personnages dans Eleven v3.
Contrôle précis de l’interprétation de la parole IA
Avec Eleven v3 et Eleven v4, vous pouvez contrôler le rythme de la parole grâce aux Audio Tags ou à la ponctuation. Des tags comme [pause], [rushed] ou [drawn out] vous permettent de façonner activement chaque réplique avec précision. Vous pouvez aussi ajouter des points de suspension, des points et des points d’exclamation pour intégrer naturellement l’émotion à votre interprétation de synthèse vocale.
Nous avons rédigé un guide approfondi sur le contrôle précis de l’interprétation dans Eleven v3.
La synthèse vocale émotionnelle est disponible via l’API
Les Audio Tags fonctionnent de la même manière via l’API Text to Speech que dans l’interface ElevenLabs. Insérez le tag directement dans le texte du script, et l’API renverra l’interprétation balisée dans l’audio généré, des pipelines de livres audio aux voix off publicitaires.
En savoir plus sur Eleven v4 ou Nous contacter pour commencer dès aujourd’hui.
FAQ sur les Audio Tags et la synthèse vocale émotionnelle

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.