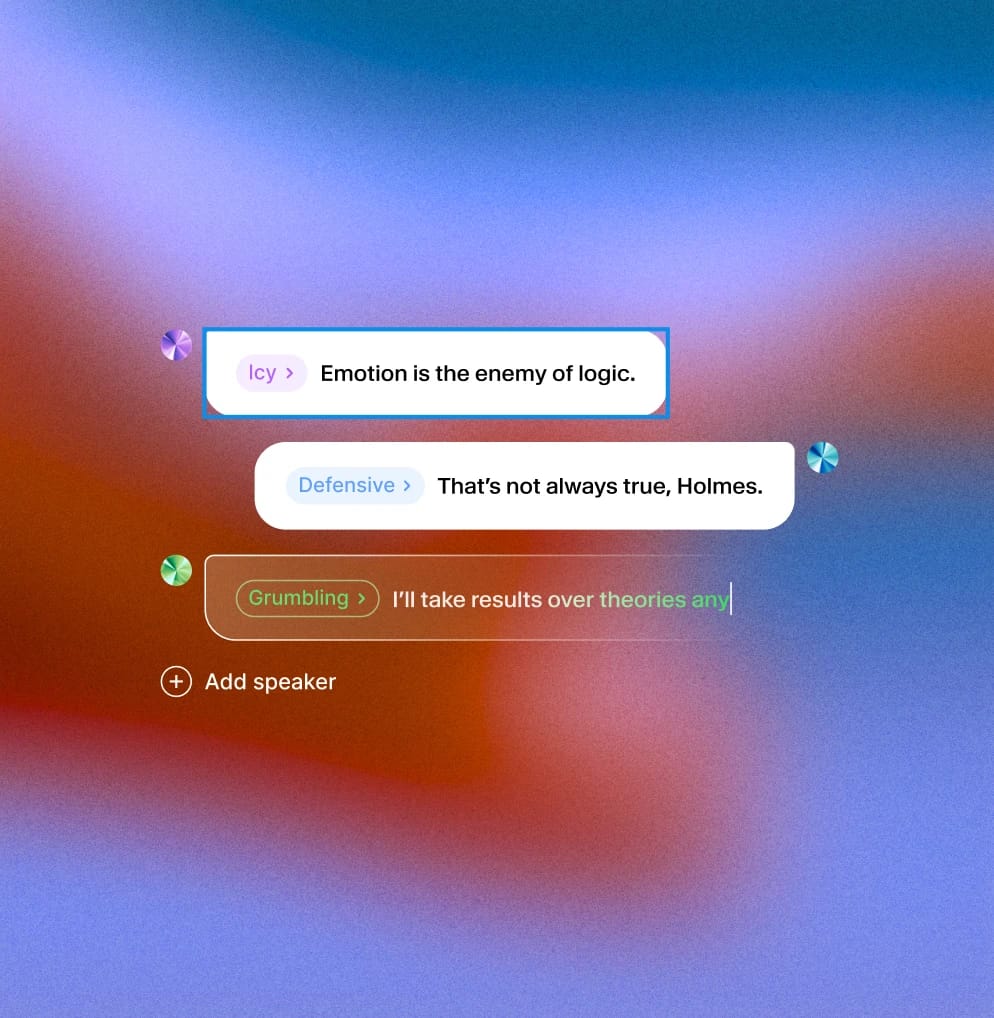
Étiquettes Audio Eleven v3 : Donner une conscience situationnelle à l'audio IA
- Rédigé par
- Ryan Morrison
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les Audio Tags font partie intégrante du nouveau modèle Eleven v3 (alpha) Text to Speech. Ils vous permettent de contrôler la façon dont les répliques sont prononcées, en adaptant le ton, l'émotion et le rythme au contexte réel.
Dans leur forme la plus simple, les Audio Tags sont des mots entre crochets. Le modèle les interprète comme des indications de jeu. Vous pouvez ainsi ajuster l'interprétation au milieu d'une phrase pour refléter les temps forts émotionnels ou les changements de situation, et donner à l'IA une certaine conscience du contexte.
Qu'est-ce que la conscience du contexte dans la parole générée par l'IA ?
La conscience du contexte permet à l'IA d'adapter son interprétation au moment. Avec les Audio Tags, vous contrôlez non seulement ce que dit le modèle, mais aussi sa façon de réagir.
Qu'il s'agisse d'ajouter de l'urgence avec le tag [SHOUTING], d'adoucir un avertissement avec [WHISPER] ou de signaler une hésitation avec [SIGH], les tags transforment une narration en interprétation. Ils sont particulièrement utiles dans les scènes riches en contexte ou dynamiques.
Une interprétation, pas une simple lecture
Imaginez que vous écrivez le script d'une vidéo des temps forts Veo 3 d'un match de football entre 11 United et 12 United. Vous voulez que l'intensité monte avec l'action : « Il élimine un défenseur, [EXCITED] voici le centre, [SHOUTING] BUUUUT ! »
Ou que vous donnez voix à un moment de suspense dans un livre audio : « [WHISPERING] Je crois qu'il y a quelqu'un dans la maison. [PAUSE] Restez silencieux. »
Ce ne sont pas de simples ajouts stylistiques. Ils définissent le moment et l'émotion qu'il suscite. Le modèle ne lit pas, il interprète.
Tags courants pour contextualiser une interprétation
Les Audio Tags vous permettent de simuler diverses expressions émotionnelles et physiques :
- Ton émotionnel : [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- Réactions : [GASP], [SIGH], [LAUGHS], [GULPS]
- Volume et énergie : [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- Rythme et débit : [PAUSES], [STAMMERS], [RUSHED]
Vous pouvez combiner les tags pour plus de nuance : « [NERVOUSLY] Je... je ne suis pas sûr que ça marche. [GULPS] Mais essayons quand même. »
Une interprétation que vous dirigez
Eleven v3 prend en charge ces tags grâce à un modèle contextuel plus approfondi. Il peut modifier le ton au milieu d'une réplique, gérer les interruptions et préserver la fluidité, pour une interprétation plus naturelle sans réécrire le script.
Pour les concepteurs de voix, les développeurs de jeux et les créateurs d'histoires, cela ouvre une nouvelle dimension créative. Vous ne vous contentez pas d'écrire des répliques. Vous les dirigez.
Choisir la bonne voix
Les clonages de voix professionnels (PVC) ne sont actuellement pas entièrement optimisés pour Eleven v3, ce qui peut entraîner une qualité de clonage inférieure à celle des modèles précédents. Durant cette phase d'aperçu de la recherche, il est préférable de choisir un clonage instantané Clonage de voix (IVC) ou une voix conçue pour votre projet si vous devez utiliser les fonctionnalités de v3. L'optimisation des PVC pour v3 arrivera prochainement.