
Balises SSML expliquées : contrôler les pauses, la prononciation et le rythme en synthèse vocale
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Le Speech Synthesis Markup Language (SSML) est un langage de balisage fondé sur XML qui encadre le texte de balises afin d'indiquer à un modèle de synthèse vocale comment le prononcer, notamment où faire une pause, comment prononcer un mot et quelle expression accentuer.
Cette couche de contrôle est à l'origine d'une grande partie de la parole IA que vous entendez déjà. Un système de réponse vocale interactive (SVI) qui répète un numéro de confirmation et le narrateur d'un livre audio IA qui fait une pause à la fin d'un chapitre reposent tous deux sur une forme de cette technologie. Si vous avez déjà personnalisé de la parole générée par IA, vous avez probablement rencontré le SSML.
Le SSML fait partie des technologies de TTS depuis plus de deux décennies et reste central dans la manière dont de nombreux fournisseurs proposent le TTS. Ce guide explique ce qu'est le SSML et où il s'applique exactement dans la gamme de modèles d'ElevenLabs, ainsi que le système amélioré d'Audio Tags qu'Eleven v3 et Eleven v4 utilisent pour offrir une synthèse vocale au rendu naturel.
Découvrez Eleven v4 en action avec les Audio Tags
Découvrir Eleven v4En résumé
- Le SSML est un langage de balisage issu du W3C permettant de contrôler les pauses vocales, l'accentuation, la prononciation et le rythme de la parole synthétisée.
- Les modèles ElevenLabs, à l'exception d'Eleven v3 et d'Eleven v4, prennent en charge la balise SSML <break> pour des pauses allant jusqu'à 3 secondes.
- Eleven Flash v2 et Eleven Turbo v2 prennent en charge la balise <phonème> pour personnaliser la prononciation en anglais.
- Eleven v3 et Eleven v4 ne prennent pas du tout en charge le SSML. Ils utilisent à la place les Audio Tags : des instructions entre crochets, en langage naturel, telles que [whispering] et [sighs], qui contrôlent le déroulement de la parole synthétisée.
- L'API WebSocket contrôle l'analyse du SSML via le paramètre enable_ssml_parsing et envoie les balises SSML sous forme de messages complets afin d'éviter toute latence supplémentaire.
- Les balises telles que <prosody>, <say-as>, <sub>, <lang>, <voice> et <audio> ne sont pas prises en charge par les modèles ElevenLabs, mais chacune possède un équivalent : réglages de voix, normalisation du texte, dictionnaires de prononciation, modèles multilingues, voix distinctes et effets sonores.
Qu'est-ce que le SSML ?
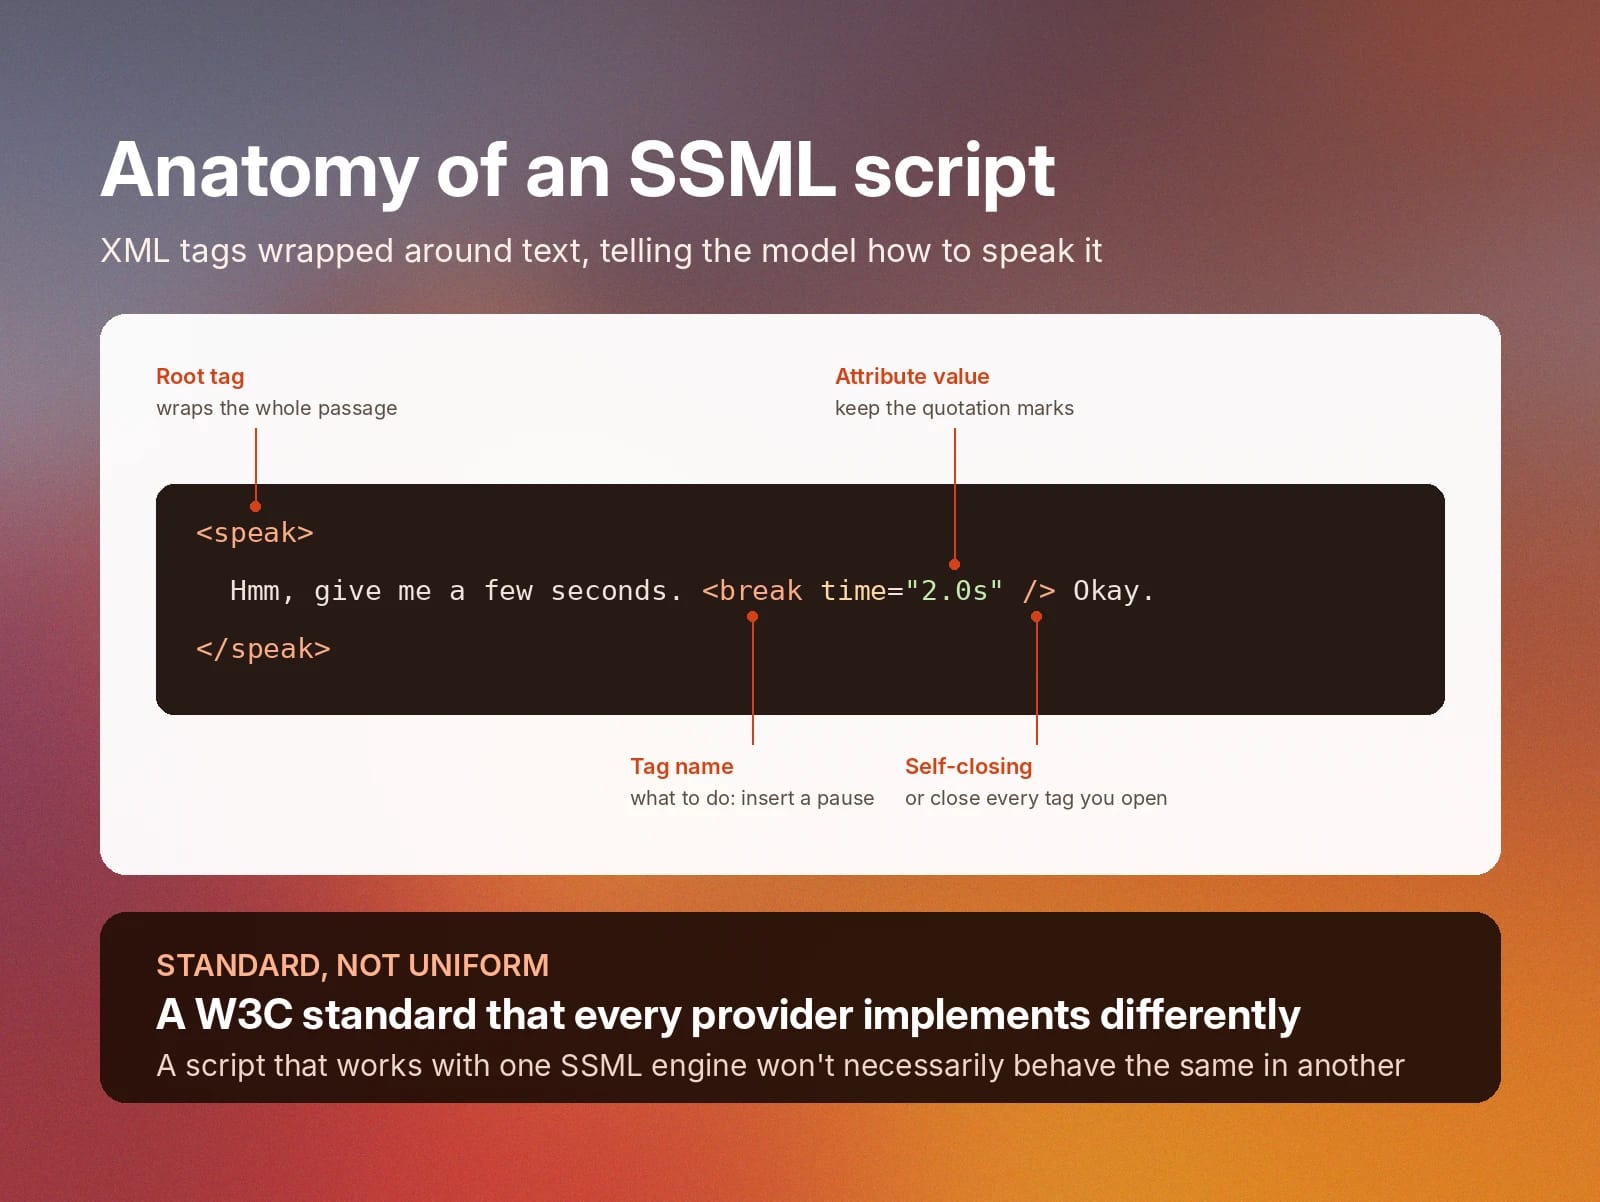
Le SSML est un langage de balisage qui permet d'annoter un texte écrit avec des instructions indiquant comment un moteur de synthèse doit le prononcer. Le World Wide Web Consortium (W3C) l'a conçu comme norme pour aller au-delà des modèles de synthèse vocale à partir de texte brut. Le SSML fournit des instructions explicites et lisibles par machine sur la prononciation d'un passage, plutôt que de s'appuyer sur des modèles d'interprétation de texte brut.
Le SSML n'est pas un balisage propre à un fournisseur donné. Amazon Polly et Microsoft Azure Speech utilisent tous deux des balises SSML, comme <break> et <emphasis>, comme principal mécanisme de contrôle. La plupart des plateformes cloud de synthèse vocale acceptent une version de cette norme. Le SSML était la méthode par défaut pour annoter la parole bien avant l'apparition des modèles vocaux génératifs.
Le SSML demeure une norme fondamentale, tandis que des contrôles plus récents et spécifiques aux modèles se développent avec les technologies vocales génératives modernes. Cette spécification neutre vis-à-vis des fournisseurs permet d'implémenter un ensemble de balises de base communes, auquel les fournisseurs peuvent ensuite ajouter leurs propres extensions et restrictions.
Balises SSML courantes et leur rôle
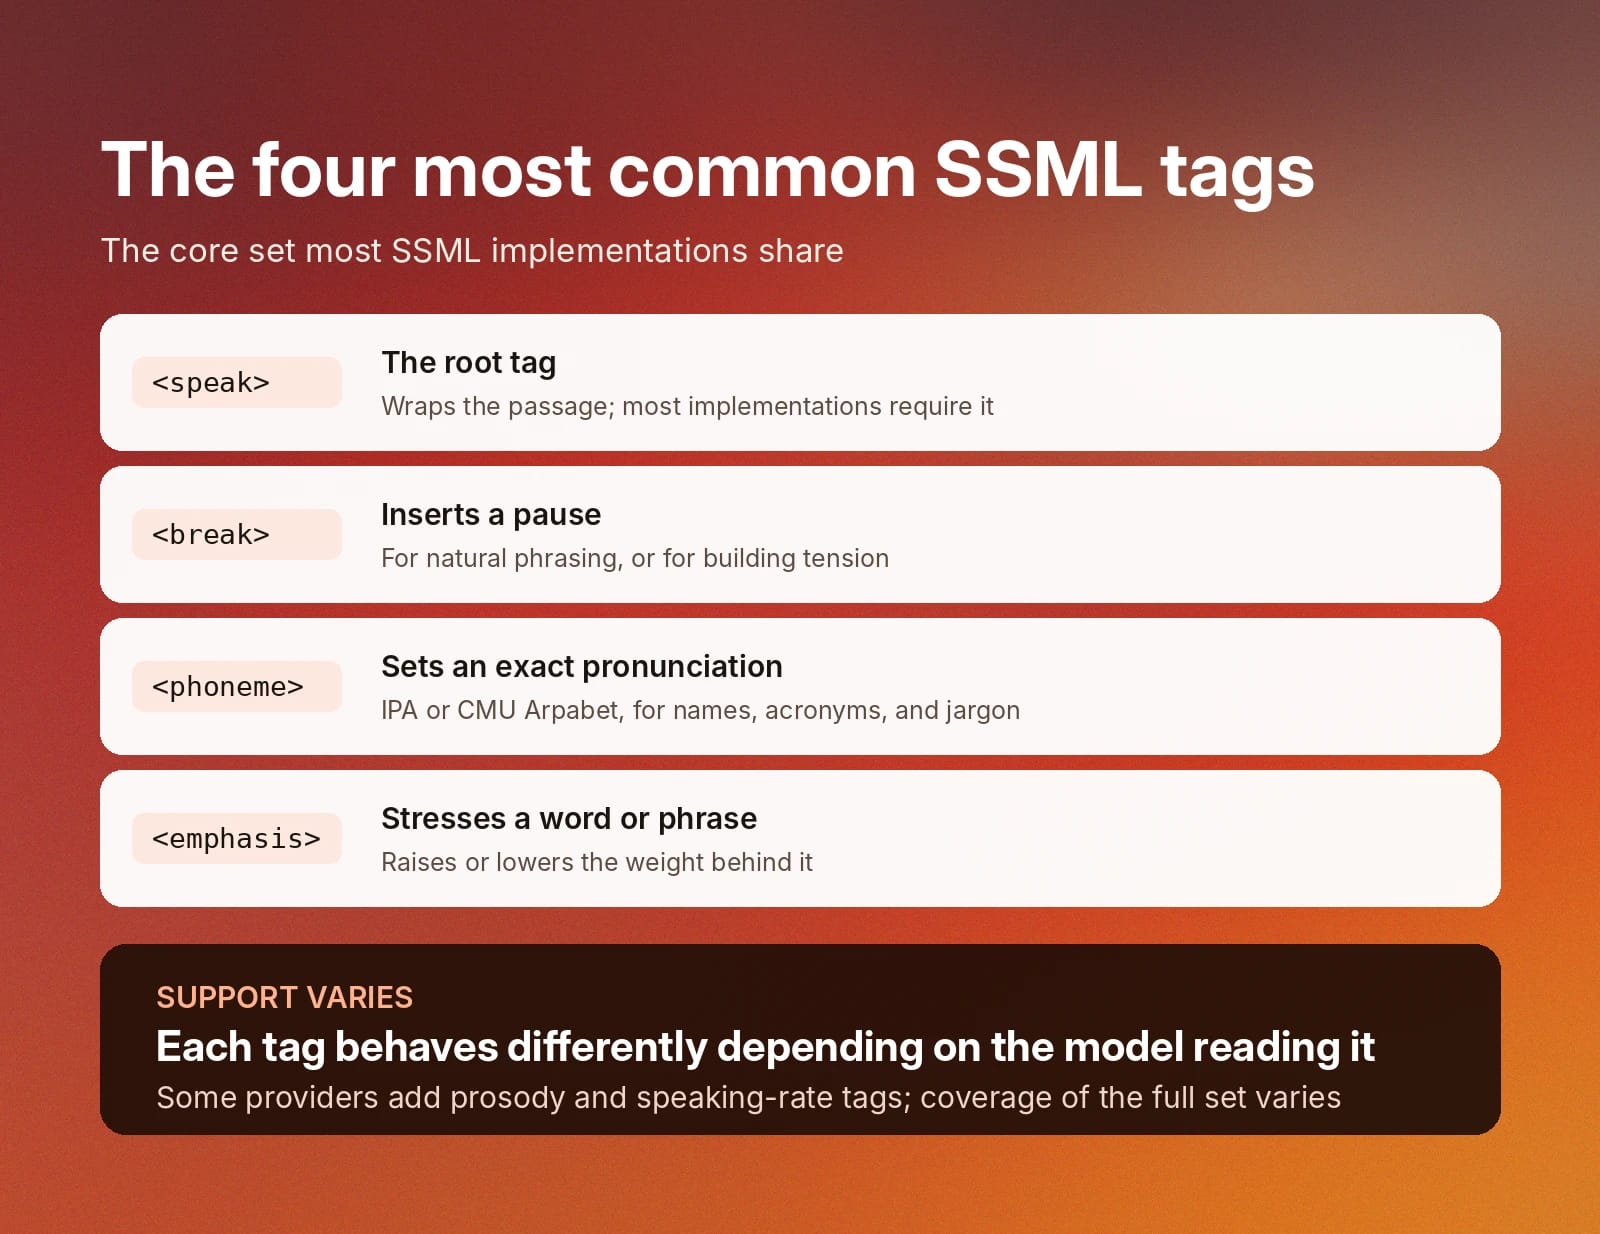
Les implémentations SSML partagent un ensemble de balises essentielles que la plupart des utilisateurs recherchent pour contrôler la parole synthétisée.
Voici ces balises SSML courantes :
- <speak> : balise racine qui englobe l'intégralité du passage. La plupart des implémentations l'exigent pour reconnaître le contenu inclus comme du SSML.
- <break> : insère une pause d'une durée définie, utile pour créer une formulation naturelle entre des propositions ou des phrases, ou pour instaurer une tension dans un texte.
- <phoneme> : indique la prononciation exacte d'un mot à l'aide d'un alphabet phonétique tel que l'API ou le CMU Arpabet, ce qui est utile pour les acronymes, les noms ou les termes techniques.
- <emphasis> : accentue un mot ou une expression, en reproduisant la façon dont un locuteur augmente ou réduit naturellement l'importance qu'il lui accorde.
Ces quatre balises se comportent différemment selon le modèle de TTS qui les lit. Certains fournisseurs prennent en charge des balises supplémentaires pour la prosodie ou le débit. Un script écrit pour un fournisseur de TTS ne se comportera pas de la même manière chez un autre, même si les deux annoncent une prise en charge du SSML, car la couverture de l'ensemble des balises varie.
Ce qui varie le plus est l'ensemble des balises réellement traitées par un modèle de synthèse vocale donné. C'est là que l'implémentation d'ElevenLabs se distingue.
Utiliser le SSML avec ElevenLabs
La prise en charge du SSML par ElevenLabs n'est pas entièrement uniforme. Elle dépend du modèle choisi pour générer l'audio. La balise <break> est l'élément le plus largement pris en charge, tandis que <phoneme> est disponible sur un ensemble plus restreint de modèles.
Les anciens modèles TTS d'ElevenLabs, comme Multilingual v2, prennent en charge la balise <break> pour des pauses allant jusqu'à trois secondes. Par exemple, un agent IA peut dire « Attendez, je réfléchis », puis utiliser <break time="2.0s" /> pour créer une pause audible avant de poursuivre par « D'accord, je sais comment vous aider. » C'est la balise la plus courante dans de nombreux workflows, car elle permet de simuler un style de conversation plus naturel.
Lorsque vous utilisez des balises SSML, mieux vaut vous en tenir à un petit nombre à la fois. En utiliser beaucoup dans une même phrase ou un même paragraphe peut modifier le débit d'un modèle de façon inattendue ou produire divers artefacts audio. Les voix gèrent aussi les pauses différemment, en particulier celles entraînées sur des échantillons comportant des hésitations comme « euh ».
Le SSML en pratique avec ElevenLabs
Les modèles Flash v2 et Turbo v2 d'ElevenLabs vont plus loin en prenant aussi en charge la balise <phoneme> pour les prononciations personnalisées, uniquement en anglais. Cette balise est donc utile pour corriger la façon dont un modèle prononce un nom, un acronyme, un terme technique ou tout autre libellé professionnel, à condition que le script s'exécute sur l'un de ces deux modèles.
À l'inverse, Eleven v3 et Eleven v4 s'écartent entièrement de ce modèle. Ils utilisent les Audio Tags pour contrôler l'interprétation. Eleven v4 introduit également la prise en charge native de l'API en ligne, ce qui permet de lire directement dans votre texte les symboles API placés entre barres obliques. Nous verrons ci-dessous ce qui remplace la balise break et les contrôles d'interprétation.
Pour une présentation complète des contrôles de synthèse vocale d'ElevenLabs, dont les dictionnaires de prononciation et la normalisation du texte, consultez le guide des bonnes pratiques.
Exemples de code SSML avec ElevenLabs
Les exemples ci-dessous présentent le SSML dans un script et dans un appel d'API. Rappelez-vous que <break> fonctionne avec tous les modèles sauf Eleven v4 et Eleven v3, et que <phoneme> ne fonctionne qu'avec Flash v2 et Turbo v2, uniquement en anglais.
Un script SSML simple avec une pause
Encadrez le texte et la balise dans un bloc <speak>, et conservez les guillemets autour de la valeur de l'attribut :
Retrouvez de plus amples informations sur les pauses et les balises phoneme SSML via ElevenAPI.
Corriger une prononciation avec <phoneme>
Utilisez l'API ou le CMU Arpabet pour indiquer précisément la prononciation d'un mot. Ici, le nom « Siobhan » est guidé par l'API, tandis que « Madison » est indiqué avec le CMU Arpabet :
Générer de la parole avec SSML en Python
Cet appel envoie un script contenant une balise break à un modèle qui la prend en charge :
Générer de la parole avec SSML en JavaScript
Voici un exemple similaire de génération de parole avec SSML, écrit en JavaScript.
SSML et l'API WebSocket
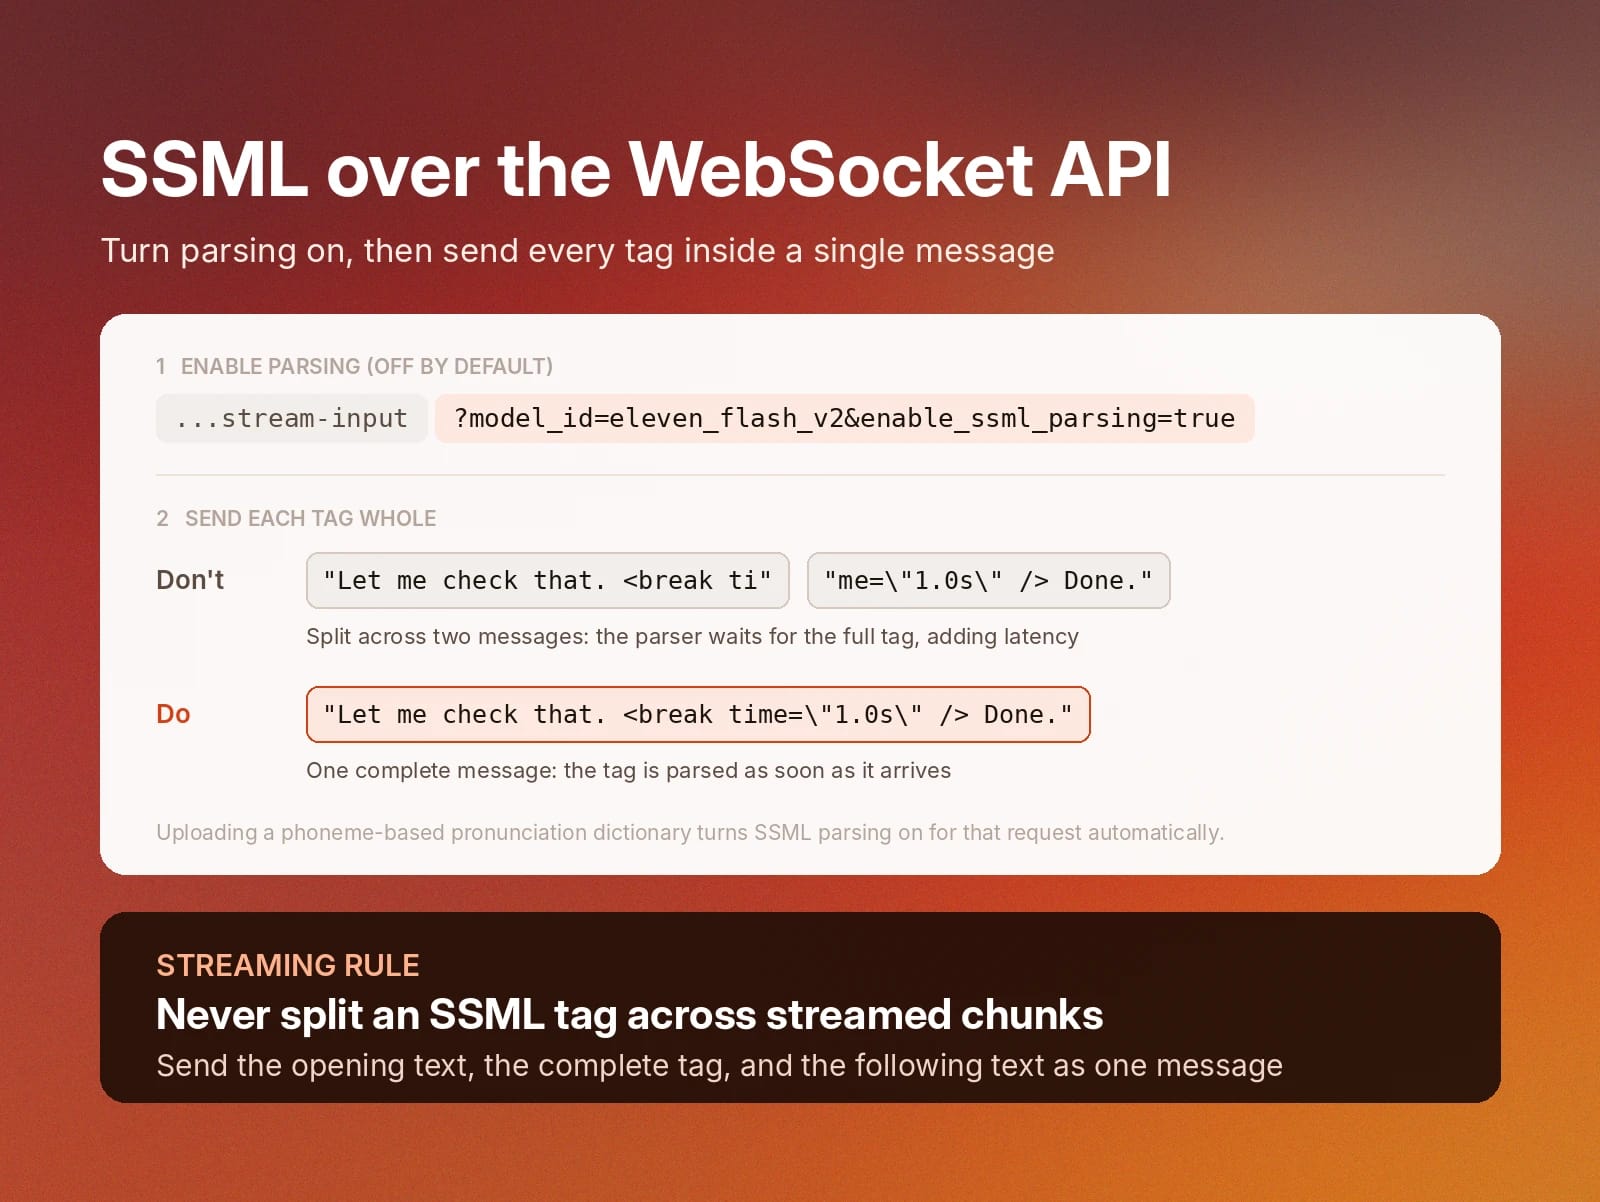
Le streaming audio via l'API WebSocket d'ElevenLabs, plutôt qu'une requête HTTP standard, exige d'activer explicitement l'analyse du SSML. Celle-ci est désactivée par défaut et se contrôle avec le paramètre enable_ssml_parsing.
Pour des résultats optimaux, il est recommandé d'envoyer chaque balise SSML comme un message entièrement autonome plutôt que de la répartir sur plusieurs fragments diffusés. Diviser une balise au milieu d'un message ajoute de la latence, car l'analyseur a besoin de la balise complète avant de pouvoir l'interpréter.
L'importation d'un dictionnaire de prononciation fondé sur des phonèmes active automatiquement l'analyse du SSML pour la requête, même si le paramètre enable_ssml_parsing n'a pas été défini explicitement. Pour connaître tous les paramètres et formats de messages disponibles dans l'API WebSocket, consultez ce guide de documentation sur la génération audio en temps réel.
L'exemple ci-dessous active l'analyse du SSML dans l'URL de connexion et envoie la balise break complète dans un seul message :
Balises SSML non prises en charge par ElevenLabs et alternatives
Balises SSML non prises en charge par ElevenLabs et alternatives
Si vous utilisez un ancien modèle ElevenLabs, il peut être utile de connaître les balises SSML prises en charge. Grâce aux nombreuses alternatives disponibles, les premiers modèles ElevenLabs ne traitent désormais que <break> et <phoneme>, les autres balises SSML étant couvertes par d'autres méthodes.
Les autres balises SSML que vous connaissez peut-être grâce à la spécification du W3C ne sont pas lues comme du balisage et nécessitent donc chacune une approche différente. Voici par quoi remplacer les autres balises SSML sur ElevenLabs :
Balise SSML
Fonction
Alternative
<prosody>
Définit la hauteur, le débit et le volume
Les paramètres de voix speed et stability. Sur Eleven v3 et Eleven v4, des Audio Tags d'interprétation tels que [slowly] ou [rushed]
<emphasis>
Accentue un mot ou une expression
Les majuscules ou la ponctuation pour marquer l'accentuation. Sur Eleven v3 et Eleven v4, des balises telles que [shouts]
<say-as>
Contrôle la lecture des nombres, dates et acronymes
La normalisation du texte, écrire la valeur en toutes lettres ou une règle de dictionnaire de prononciation
<sub>
Remplace la forme orale d'un mot écrit
Une règle d'alias dans un dictionnaire de prononciation
<lang>
Change la langue d'une expression
Un modèle multilingue, avec l'expression écrite dans la langue cible
<voice>
Change de locuteur au milieu du script
Une génération distincte par voix, ou un dialogue à plusieurs locuteurs sur Eleven v3 et Eleven v4
<audio>
Insère un fichier ou un son enregistré
Des Audio Tags d'effets sonores sur Eleven v3 et v4, l'outil d'effets sonores d'ElevenLabs, ou le mixage audio après génération
Prosodie : hauteur, débit et volume avec SSML
Prosodie : hauteur, débit et volume avec SSML
Pour modifier le rythme au sein d'un script, divisez le texte en générations distinctes ou ajoutez des balises <break> entre les phrases. Sur Eleven v3 et v4, utilisez les Audio Tags du tableau ci-dessus, comme [slowly], [rushed] et [whispers], directement dans la ligne.
Pour modifier le rythme au sein d'un script, divisez le texte en générations distinctes ou ajoutez des balises <break> entre les phrases. Sur Eleven v3 et v4, utilisez les Audio Tags du tableau ci-dessus, comme [slowly], [rushed] et [whispers], directement dans la ligne.
Prononciation : <phoneme>, <say-as> et <sub> avec SSML
Voici les principales méthodes à votre disposition :
- Utilisez <phoneme> pour une correction ponctuelle sur Flash v2 ou Turbo v2, comme dans l'exemple ci-dessus.
- Utilisez un dictionnaire de prononciation pour les termes qui reviennent dans de nombreux scripts. Un dictionnaire peut contenir des règles de phonèmes et des règles d'alias qui se comportent comme <sub>, par exemple en associant « UN » à « United Nations ».
- Pour les éléments traités par <say-as>, comme les nombres, les dates, les devises et les numéros de téléphone, utilisez la normalisation du texte, qui convertit les valeurs écrites en mots prononcés. Lorsqu'une valeur doit être lue d'une seule manière, comme un numéro de confirmation, écrivez-la en toutes lettres ou espacez les chiffres dans le script.
Langue et paramètres régionaux
Langue et paramètres régionaux
Flash v2 et Turbo v2 sont disponibles uniquement en anglais. Les scripts mêlant plusieurs langues nécessitent donc un modèle multilingue tel que Multilingual v2, Flash v2.5, Eleven v3 ou Eleven v4. Eleven v4 et v3 prennent également en charge les balises d'accent telles que [French accent] et la transcription API dans plus de 70 langues.
Flash v2 et Turbo v2 sont uniquement disponibles en anglais. Les scripts mêlant plusieurs langues nécessitent donc un modèle multilingue comme Multilingual v2,
Audio et effets sonores
Pour ajouter un son directement dans la parole, écrivez simplement la balise d'effet sonore, comme [applause] ou [door slamming], et laissez Eleven v4 et Eleven v3 lui donner vie. Pour une conception sonore plus longue ou plus précise, générez l'effet sonore séparément et mixez-le avec la piste vocale dans votre éditeur ou workflow de production.
Pour ajouter un son dans la parole elle-même, écrivez simplement une balise d'effet sonore, telle que [applause] ou [door slamming], et laissez Eleven v4 et Eleven v3 lui donner vie. Pour une conception sonore plus longue ou plus précise,
Bonnes pratiques SSML avec ElevenLabs
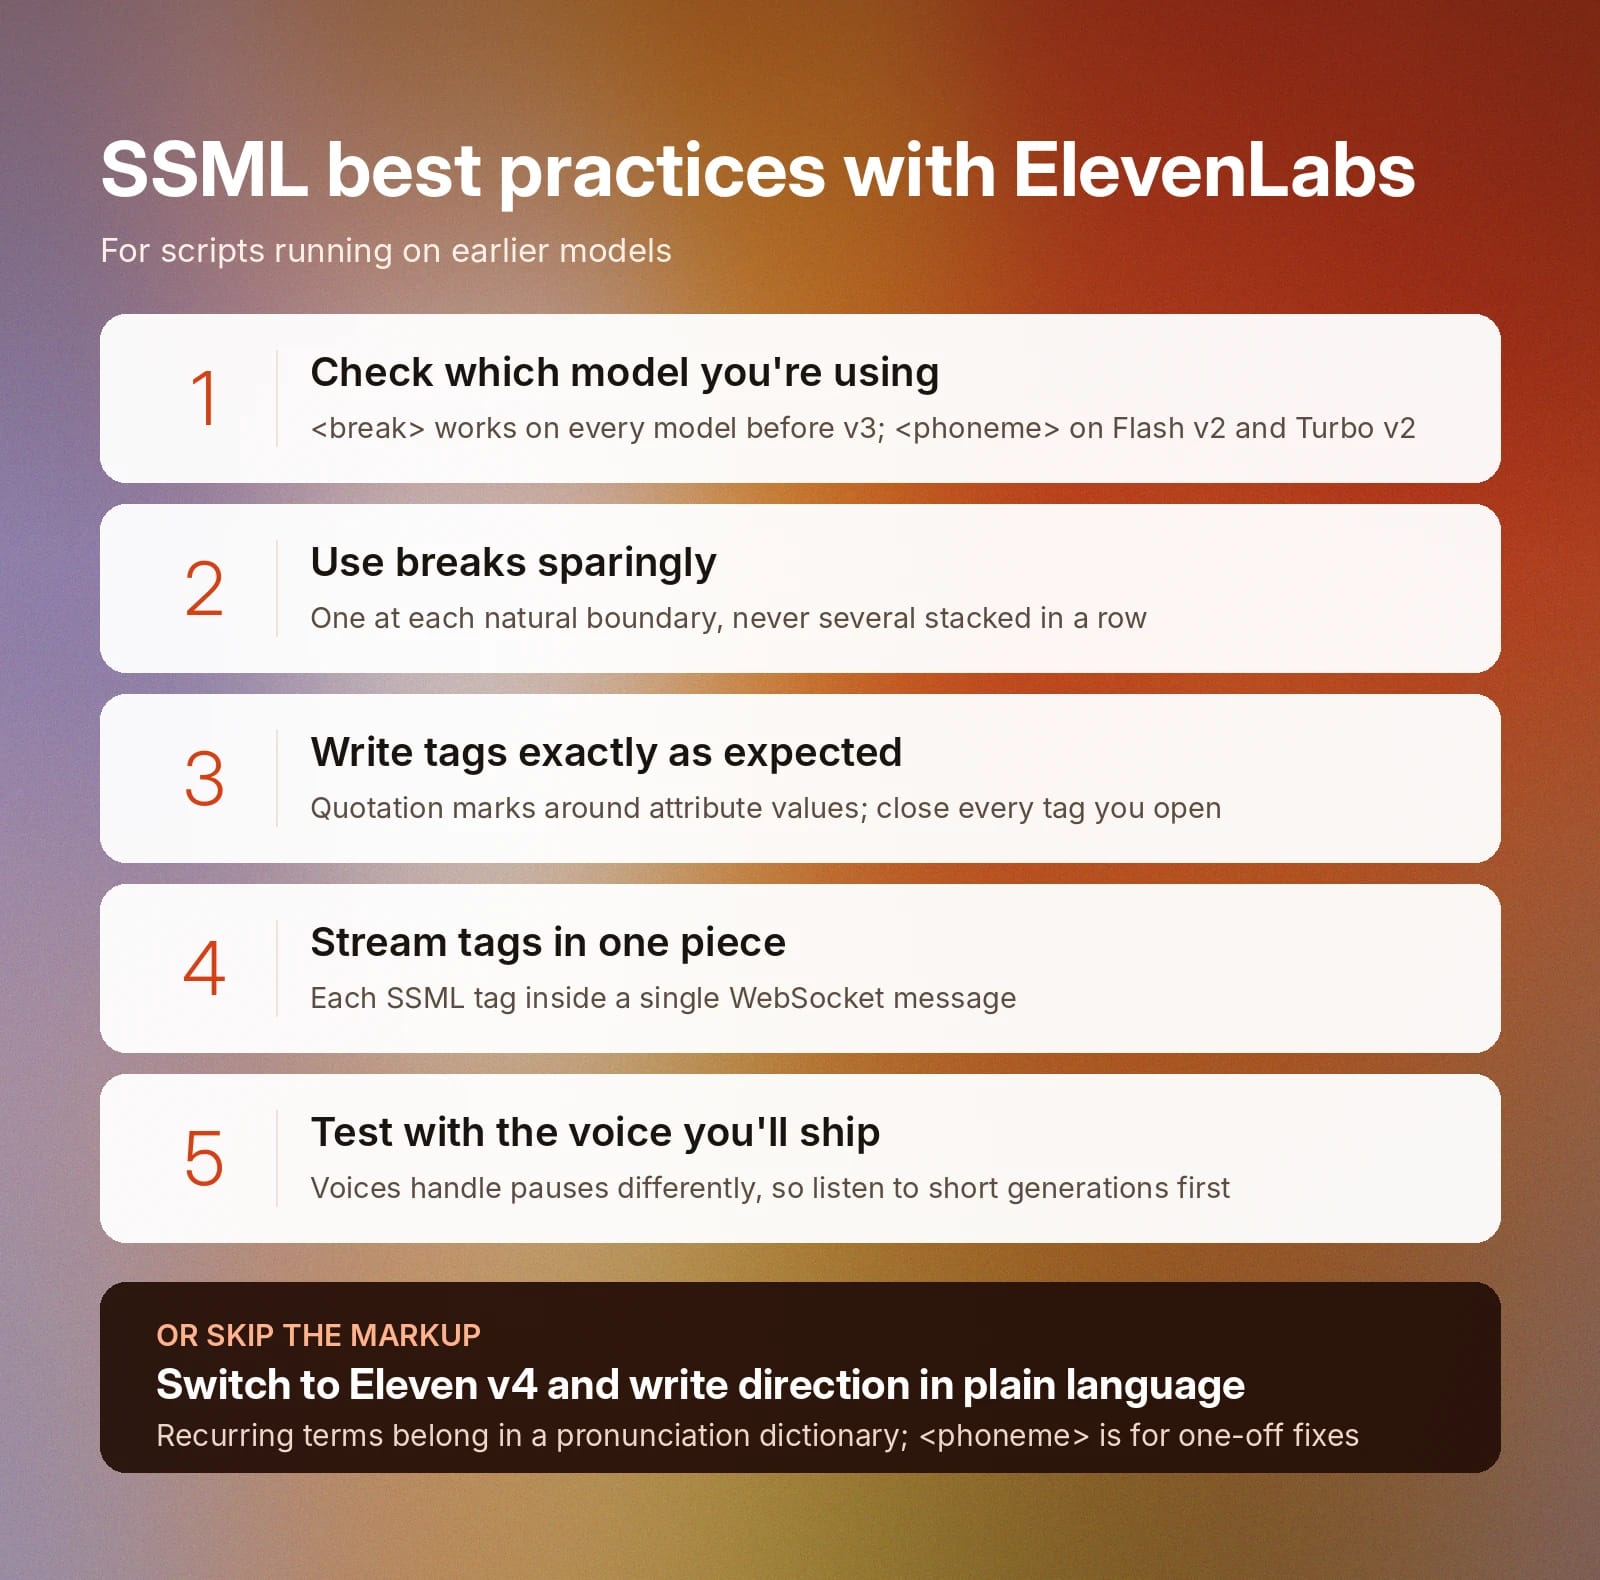
Lorsque vous utilisez SSML dans ElevenLabs, voici quelques conseils pour bien démarrer :
- Vérifiez le modèle utilisé : <break> fonctionne sur tous les modèles sauf Eleven v3, <phoneme> fonctionne uniquement sur Flash v2 et Turbo v2, et les Audio Tags ne fonctionnent que sur les modèles plus récents, comme Eleven v4 et Eleven v3.
- Utilisez les pauses avec parcimonie : placez-en une à chaque limite naturelle plutôt que d'en empiler plusieurs.
- Écrivez les balises SSML correctement : conservez les guillemets autour des valeurs d'attribut, par exemple <break time="2.0s" />, et fermez chaque balise ouverte.
- Diffusez les balises en un seul bloc : envoyez chaque balise SSML dans un seul message WebSocket.
- Testez avec la voix que vous publierez : les voix gèrent les pauses différemment. Écoutez donc de courtes générations avant d'exécuter un script complet. ElevenLabs compte plus de 17 500 voix dans notre Voice Library.
Au-delà de ces bonnes pratiques SSML, il est recommandé d'utiliser un dictionnaire de prononciation pour tout terme appelé à revenir fréquemment. Pour des corrections ponctuelles, <phoneme> est la meilleure option.
Quels sont les principaux cas d'usage de SSML ?
Quels sont les principaux cas d'usage du SSML ?prosodie dans une parole générée par IA.
Voici quelques cas d'usage où cette norme SSML s'avère utile :
- Systèmes de réponse vocale interactive (SVI) : utiles lorsqu'un système SVI doit marquer une pause entre une invite et un menu, ou lire clairement des nombres.
- Agents conversationnels agents : ajouter une courte pause avant une réponse afin que l'échange paraisse naturel.
- Livres audio et narration longue : marquer une pause à la fin des chapitres et entre les scènes pour signaler clairement le passage d'un moment à un autre.
- E-learning et formation : corriger la prononciation de noms de produits, de termes techniques, d'acronymes et de termes propres à l'entreprise.
- Notifications et alertes : contrôler la lecture des dates, des heures et des codes de référence.
Bien que SSML offre de nombreux cas d'usage, tous peuvent être couverts avec les Audio Tags, sans devoir mémoriser ni insérer dans vos scripts des balises SSML souvent complexes. Eleven v4 et Eleven v3 ont créé le système Audio Tags afin de donner aux utilisateurs un contrôle total de leurs sorties vocales générées par IA, sans les contraintes de SSML.
Bien que le SSML offre de nombreux cas d'usage, tous peuvent être couverts grâce aux Audio Tags, sans devoir mémoriser ni insérer dans vos scripts des balises SSML souvent complexes. Eleven v4 et Eleven v3 ont créé le système Audio Tags afin de donner aux utilisateurs un contrôle complet de leurs sorties vocales générées par IA, sans les contraintes du SSML.
Pourquoi Eleven v4 utilise des Audio Tags plutôt que le SSML
- Les émotions ou sentiments, comme [sad] ou [excited]
- L'interprétation et le rythme, comme [whispers] ou [rushed]
- Les réactions humaines, comme [sighs] ou [laughs]
- Les accents et les voix de personnages, comme [French accent]
- Les effets sonores, notamment [applause] ou [door shutting]
Ce choix de conception repose sur la manière dont ce modèle lit le contexte d'une conversation. L'architecture d'Eleven v4 interprète le contexte plus en profondeur que les modèles antérieurs, ce qui lui permet de suivre les indices émotionnels, les variations de ton, les transitions entre locuteurs et les indices contextuels sans paramètres ni réglages distincts.
SSML fournit des instructions précises à un point fixe du texte, ce qui peut rendre l'interprétation rigide et hachée. SSML est l'une des principales raisons pour lesquelles un texte IA paraît robotique, malgré la qualité des modèles sous-jacents.
Une indication telle que [whisper] donne à Eleven v4 une consigne d'interprétation appliquée à toute la ligne environnante, façonnée par la prosodie de l'ensemble du contexte.
La plupart des éléments SSML disposent d'un équivalent direct dans v4 :
Balise SSML
Fonction
Équivalents dans Eleven v4
<break time="1s">
Insère une pause
[pause], des points de suspension ou un saut de ligne
<prosody rate="slow">
Ralentit la parole
[drawn out] ou [slowly]
<prosody rate="fast">
Accélère la parole
[rushed]
<emphasis>
Accentue un mot précis
[shouts] ou mettre un mot en majuscules
<prosody pitch="high">
Augmente la hauteur
Des balises émotionnelles telles que [excited]
<prosody pitch="low">
Abaisse la hauteur
Des balises émotionnelles telles que [sorrowful]
La prononciation suit le même principe de remplacement. L'API est prise en charge nativement par Eleven v4, avec une transcription dans plus de 90 langues. Les équipes peuvent ainsi contrôler la prononciation sans les balises XML requises en ajoutant directement la transcription entre barres obliques dans le texte.
La prononciation suit le même modèle de remplacement. L'API est prise en charge nativement par Eleven v4, avec une transcription dans plus de 90 langues. Les équipes peuvent ainsi contrôler la prononciation sans les balises XML requises, en ajoutant directement une transcription entre barres obliques dans le texte.
Utilisez ElevenCreative dès aujourd'hui pour une parole au rendu naturel
Découvrez comment les Audio Tags se transforment en audio finalisé avec Eleven v4 ou créez un compte gratuit pour expérimenter SSML et les Audio Tags sur vos propres scripts dès aujourd'hui.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.



