Découvrez Flash
- Publié
ÉcouterÉcouter cet article
Découvrez Flash. Notre tout dernier modèle génère de la parole en 75 ms, auxquels s’ajoutent la latence de l’application et du réseau.
Flash est notre modèle recommandé pour les agents vocaux et conversationnels nécessitant une faible latence. Vous pouvez utiliser Flash dès aujourd’hui sur notre plateforme d’IA conversationnelle.
Vous pouvez aussi concevoir directement via l’API avec les identifiants de modèle « eleven_flash_v2 » et « eleven_flash_v2_5 » : https://elevenlabs.io/docs/api-reference/text-to-speech/convert
Flash v2 est disponible uniquement en anglais, tandis que Flash v2.5 prend en charge 32 langues. Tous deux coûtent 1 crédit pour 2 caractères
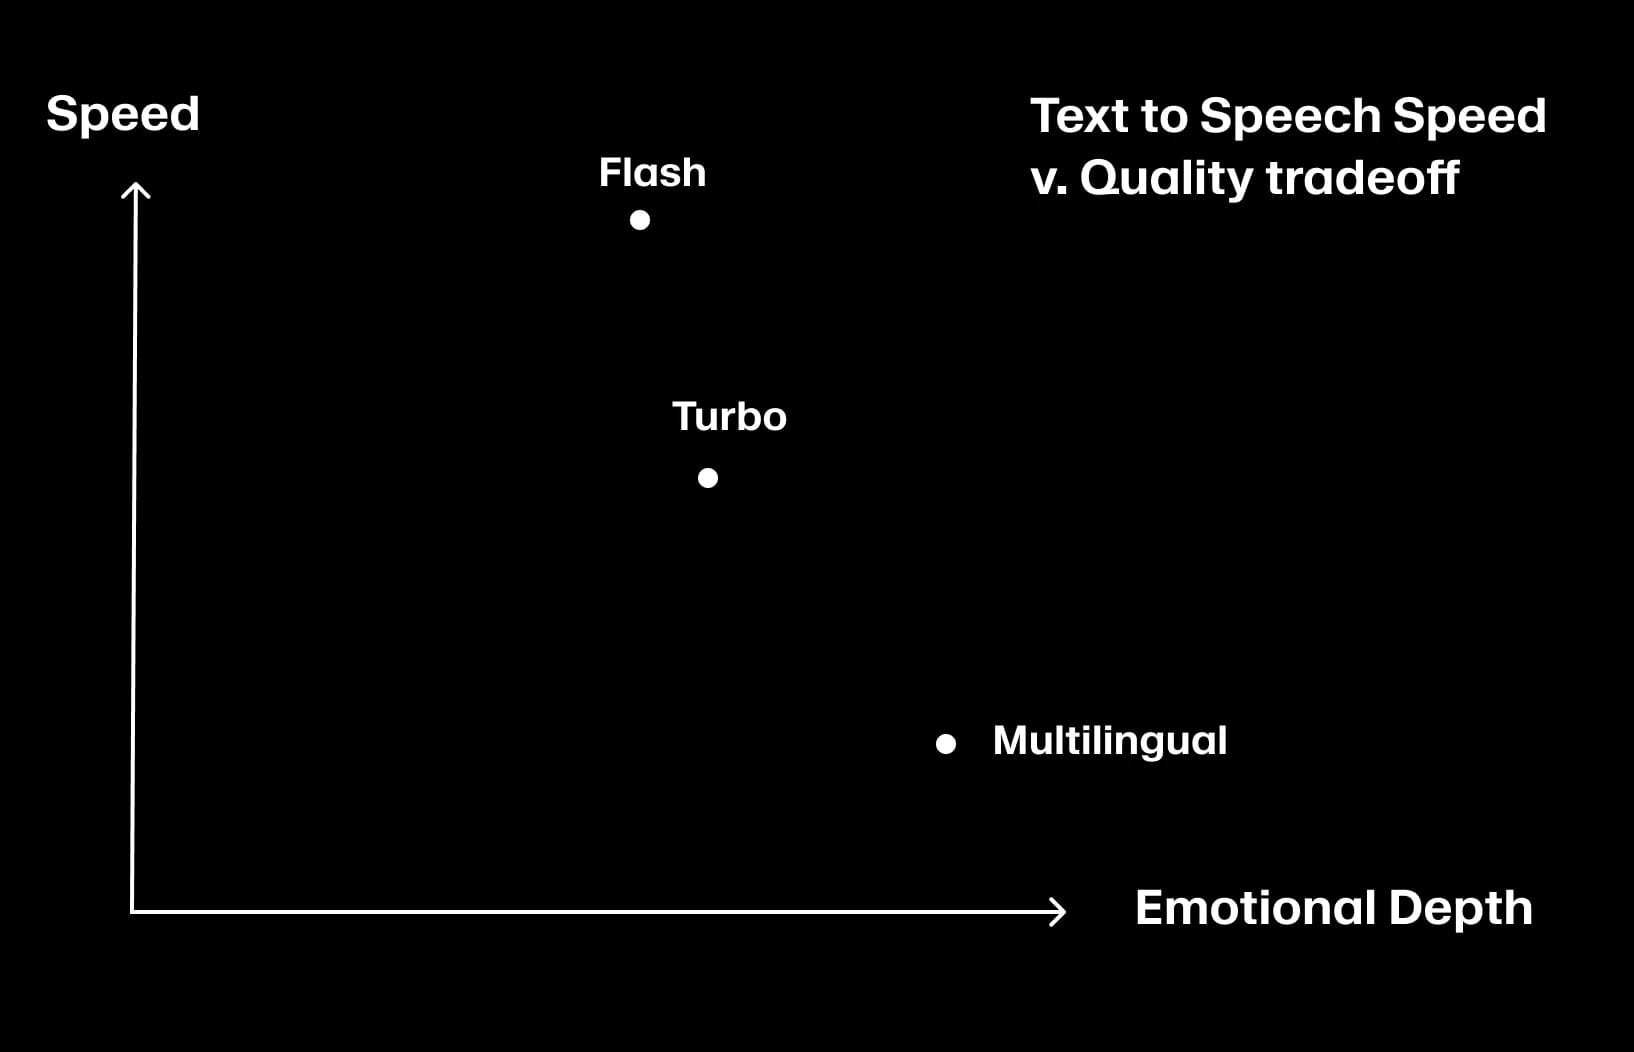
Sa qualité et sa profondeur émotionnelle sont légèrement inférieures à celles des modèles Turbo, mais sa latence est nettement plus faible. Lors de tests à l’aveugle menés par nos évaluateurs humains, Eleven Flash a systématiquement surpassé des modèles comparables à très faible latence, ce qui en fait le modèle le plus rapide de sa catégorie à ce niveau de qualité.
Consultez notre guide des modèles pour trouver celui qui convient le mieux à votre cas d’usage : https://elevenlabs.io/docs/developer-guides/models
Nous avons hâte de découvrir toutes les interactions conversationnelles naturelles et à faible latence que Flash permettra.