Présentation d’Eleven v4, notre modèle le plus expressif
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Une même phrase peut prendre un sens très différent selon la manière dont elle est prononcée. « J’ai besoin que vous restiez calme » ne sonnera pas de la même façon selon la personne qui le dit, qu’il s’agisse d’un médecin s’adressant avec douceur à un patient effrayé ou d’un personnage de jeu vidéo criant ces mots à son escouade avant de partir au combat.
Aujourd’hui, nous lançons Eleven v4, notre modèle de synthèse vocale le plus expressif à ce jour, ainsi que sa variante à faible latence, Eleven v4 Turbo.
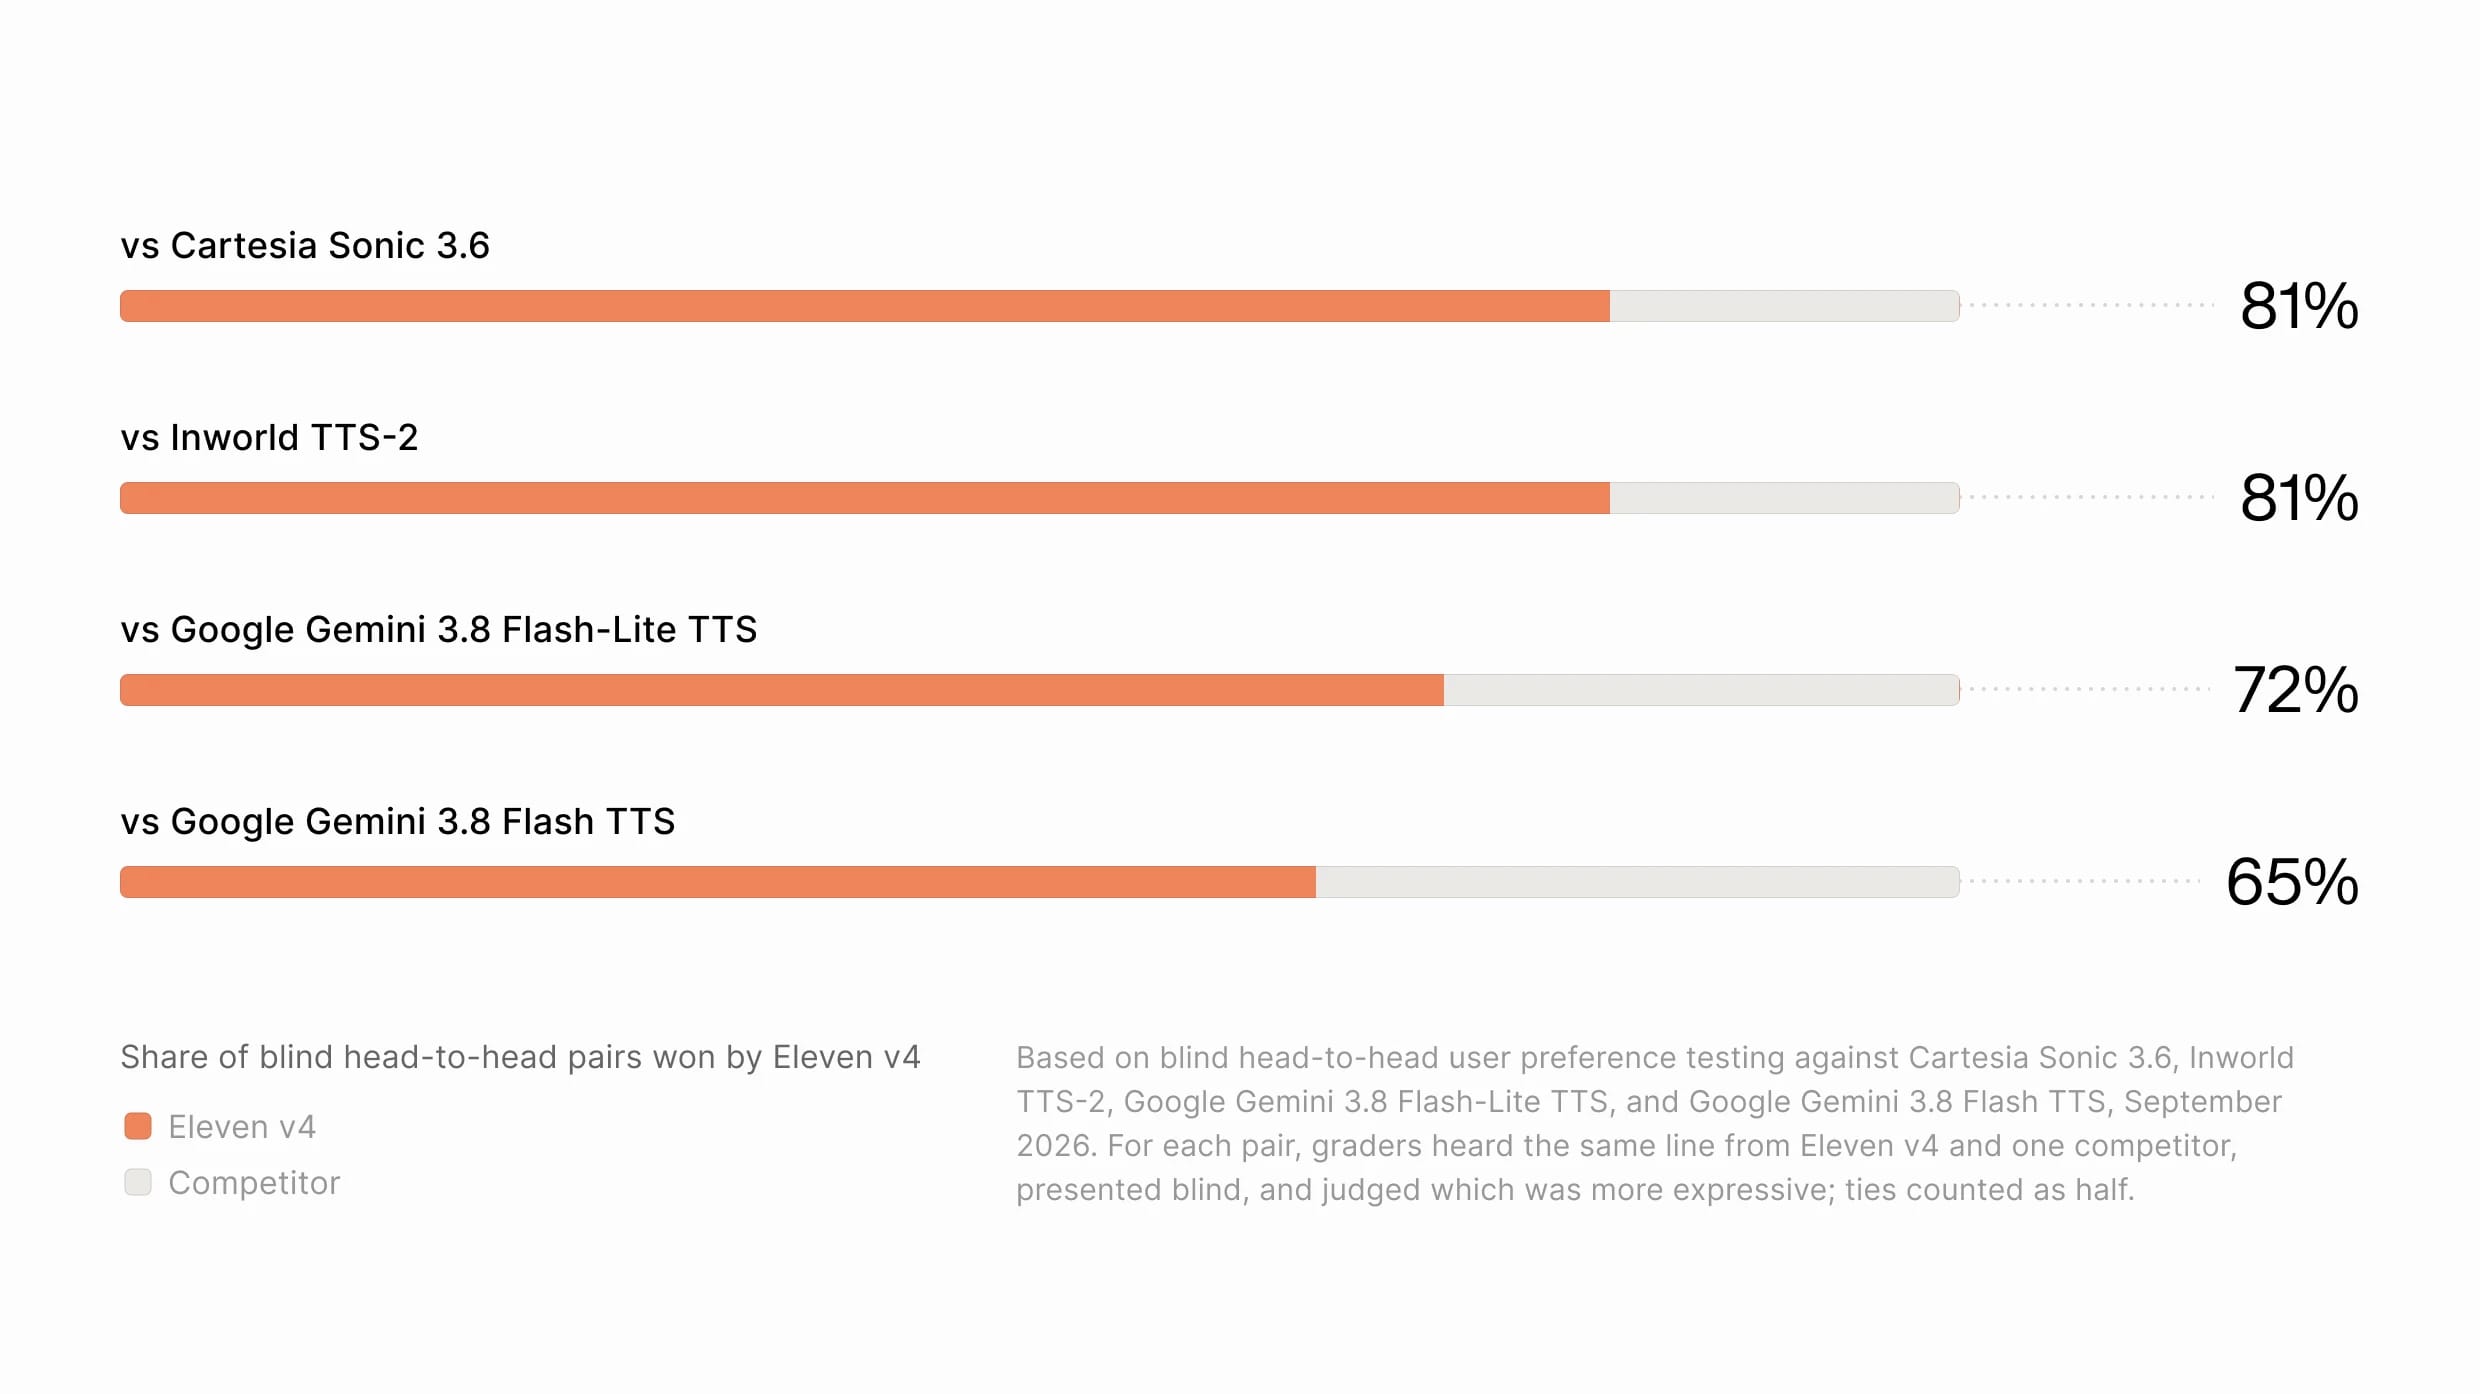
Classé n° 1 par Artificial Analysis1, et préféré par environ 75 % des auditeurs lors de tests comparatifs à l’aveugle face à des modèles concurrents2, Eleven v4 a été conçu pour interpréter le ton, le rythme, l’émotion, le personnage et le contexte. Il génère une parole dramatique, tendre, urgente, comique ou conversationnelle, tout en préservant l’identité du locuteur. Grâce à des dynamiques plus naturelles entre plusieurs locuteurs, les conversations paraissent réactives plutôt que composées de répliques juxtaposées. Les locuteurs réagissent au contexte de la conversation, pour produire des dialogues et des interactions entre personnages plus naturels.
Une nouvelle architecture conçue pour la performance
Fondé sur une architecture entièrement nouvelle, Eleven v4 est un modèle Text to Speech classé n° 1 par Artificial Analysis1. Eleven v4 Turbo adapte cette même technologie aux cas d’usage à faible latence, comme les agents. Avec une latence d’inférence médiane d’environ 100 ms, il peut répondre plus vite que la pause moyenne entre deux personnes qui se parlent.
Les deux modèles génèrent une parole expressive plutôt que mécanique. La fidélité audio est également supérieure à tous les niveaux, pour un rendu plus net et plus naturel.
Les générations précédentes de modèles de synthèse vocale savent lire un texte à voix haute, mais Eleven v4 apporte une profondeur émotionnelle bien plus naturelle à la parole. Le modèle interprète le ton recherché, le rythme à adopter, le caractère de l’écriture et le contexte du texte afin de produire une parole chargée d’émotion.
Les utilisateurs bénéficient également d’un contrôle précis sur les résultats et peuvent décrire en langage naturel la manière dont une réplique doit être interprétée. Ils peuvent aussi ajouter des instructions précises sur la prononciation de certaines expressions, l’émotion qu’elles doivent transmettre, ou même des effets sonores, grâce à des balises intégrées comme [laughs], [said angrily in French accent], [light rain] ou [phone buzzing]. Eleven v4 suit ces balises audio et ces instructions de mise en scène avec plus de précision que les modèles précédents, pour restituer l’interprétation que vous décrivez. Il devient ainsi plus simple de diriger une narration, de développer des personnages ou leurs dialogues, et tous les contenus où l’interprétation compte.
La documentation destinée aux développeurs d’ElevenLabs présente la syntaxe complète des balises et explique comment les appliquer via l’API. La prise en charge des phonèmes de l’Alphabet phonétique international (API) a également été considérablement améliorée, pour des prononciations personnalisées plus fiables.
Eleven v4 améliore également la cohérence et le dynamisme des conversations entre plusieurs locuteurs. Grâce à une nouvelle méthode de capture de l’identité des locuteurs, Eleven v4 préserve les caractéristiques uniques de chaque voix. Il maintient une parole cohérente au fil des conversations d’agents, des livres audio ou des publicités. Comme le modèle comprend le contexte d’une scène entière, il génère des dialogues naturels où les locuteurs réagissent à ce qui vient d’être dit, plutôt que d’assembler des répliques isolées.
Un modèle Turbo pour les cas d’usage à faible latence
Les modèles vocaux de haute qualité ont tendance à générer la parole plus lentement, ce qui oblige les utilisateurs à choisir entre des agents vocaux rapides ou expressifs. Beaucoup ont choisi des agents compétents, mais monotones, qui peuvent sembler robotiques à un client désemparé cherchant simplement à résoudre son problème.
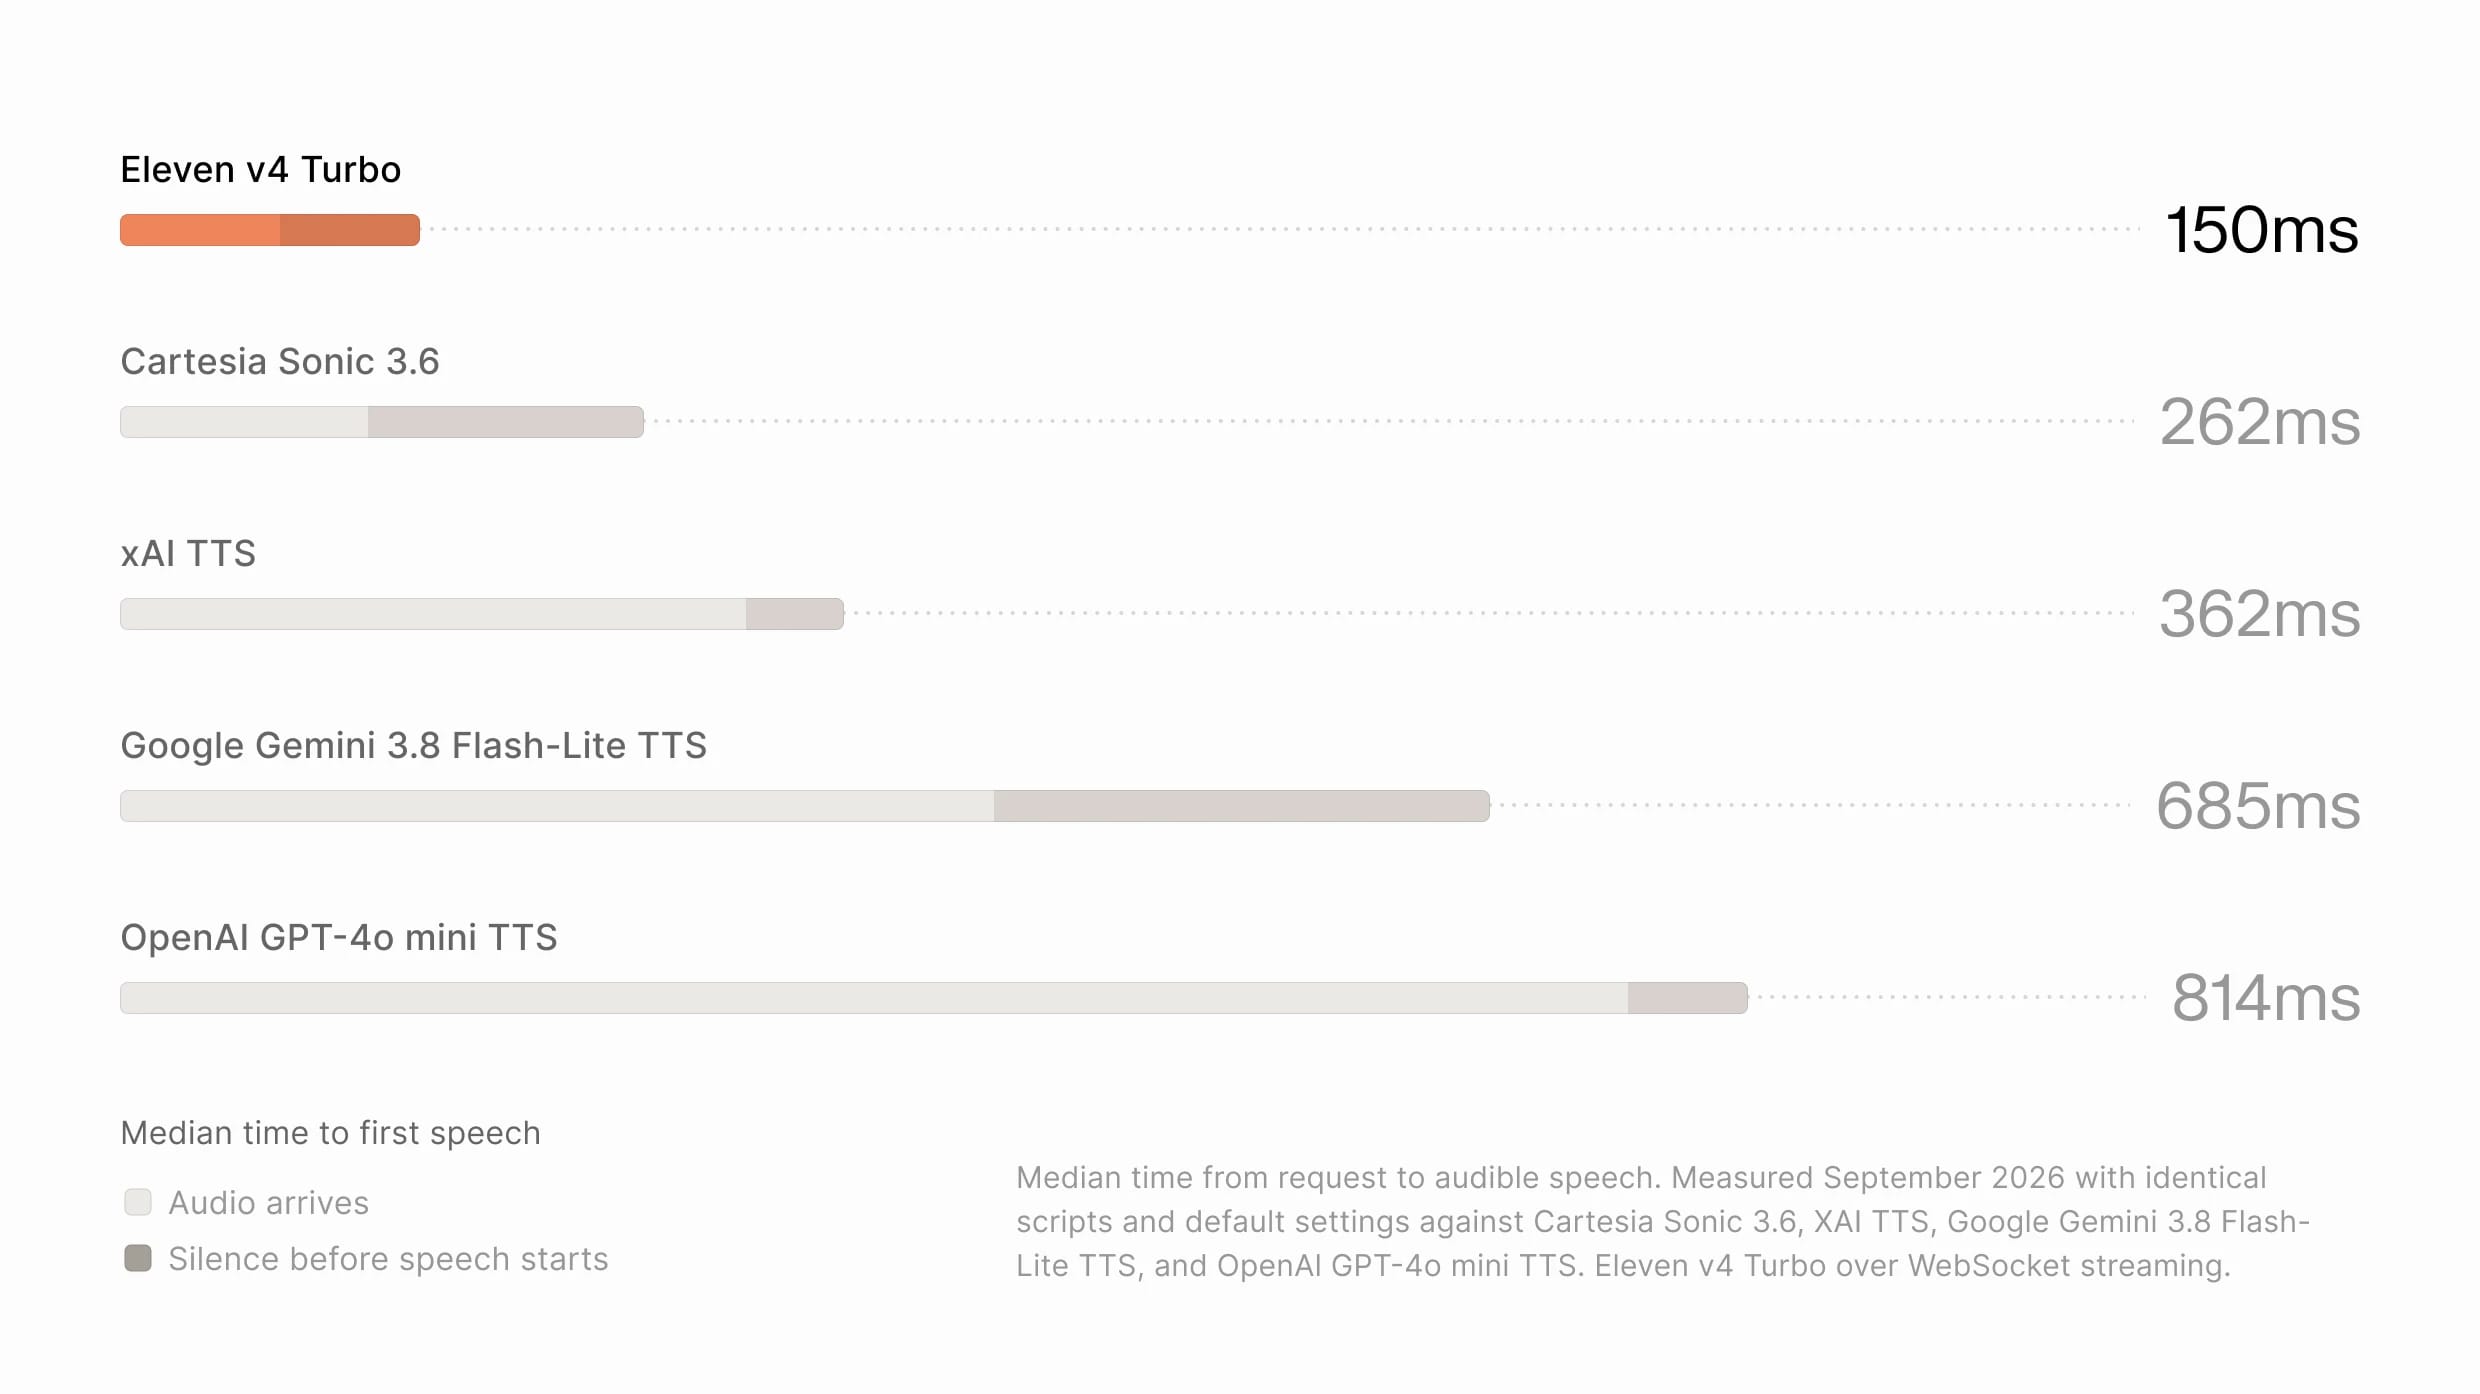
Eleven v4 Turbo associe vitesse et émotion, avec un délai médian avant la première parole d’environ 150 ms3, ce qui permet de déployer des agents performants dans de nombreux secteurs, des agents chaleureux et rassurants capables de prononcer correctement les termes médicaux dans la santé aux agents au débit rapide maîtrisant l’argot pour divertir les joueurs dans le gaming.
Le modèle Eleven v4 Turbo est conçu pour fonctionner avec la plateforme d’agents conversationnels d’ElevenLabs, ElevenAgents. D’autres outils de conception d’agents assemblent des modèles et des logiciels provenant de différents fournisseurs, sans laisser aux utilisateurs de moyen d’affiner ou d’améliorer les résultats du modèle pour leurs cas d’usage spécifiques. Les équipes de recherche et d’ingénierie d’ElevenLabs ont optimisé ensemble Eleven v4 Turbo et ElevenAgents comme un système unique, pour offrir des agents plus expressifs, plus fiables et à faible latence.
Une voix, une multitude de langues
Notre manière de communiquer varie selon le contexte, le lieu et même le moment de la journée. Créer une parole expressive qui reflète ces variations, dans toutes les langues, reste l’un des défis les plus complexes de l’IA audio.
Eleven v4 progresse sur tous ces aspects, et ses améliorations vont bien au-delà de la simple prononciation des phrases. Eleven v4 restitue mieux le rythme, l’émotion et l’interprétation dans toutes les langues, afin d’aider les créateurs à produire une parole naturelle pour chaque langue et chaque contexte. Par exemple, vous ne vous adresseriez pas à une personne âgée inconnue au Japon de la même manière qu’en Italie.
Eleven v4 et Eleven v4 Turbo prennent tous deux en charge plus de 90 langues. Désormais, une voix enregistrée dans une langue peut aussi parler couramment toute autre langue, en adoptant l’accent d’un locuteur natif tout en conservant l’identité de la voix d’origine. Cette fidélité à l’accent est sensiblement meilleure qu’auparavant : la voix ne revient plus progressivement vers son accent d’origine au fil d’une génération.
Catalan
Espagnol
Pour le doublage et la localisation, cela signifie que la voix de marque que vous avez choisie, qu’il s’agisse d’un acteur célèbre avec lequel vous travaillez ou d’un ton correspondant au style de votre entreprise, sera excellente dans toutes les langues prises en charge par Eleven v4.
Un clonage de voix plus authentique et cohérent
Le clonage de voix est plus authentique, plus performant et plus cohérent avec Eleven v4 et Eleven v4 Turbo, avec une similarité nettement supérieure entre le locuteur et la voix source originale. Les Instant Voice Clones peuvent désormais capturer des voix en haute fidélité avec seulement 10 secondes d’audio.
Voix réelle
Eleven v4
Eleven v4 préserve aussi l’identité du locuteur de manière plus fiable entre les générations, les dialogues, les narrations et les répliques régénérées. Pour les projets longs, les personnages, les narrateurs et les voix clonées restent ainsi cohérents tout au long de la production. Eleven v4 prend également en charge les Professional Voice Clones (PVC), pour les cas d’usage de clonage exigeant la plus haute fidélité.
L’enchaînement des requêtes, qui relie plusieurs générations pour créer des contenus longs, est aussi nettement plus fiable dans Eleven v4. Cela améliore l’expérience de travail dans ElevenLabs Studio et l’application ElevenLabs Reader.
Écoutez la différence par vous-même
Eleven v4 et Eleven v4 Turbo sont l’aboutissement de nos dernières recherches en génération de parole expressive. Ils sont conçus pour les contenus où l’interprétation compte autant que les mots eux-mêmes, qu’il s’agisse de livres audio, de performances de personnages, de voix off, de doublage ou de localisation d’agents conversationnels.
Les deux modèles sont désormais disponibles dans ElevenAgents, ElevenCreative et via ElevenAPI. Créez un compte gratuit pour commencer dès aujourd’hui à générer du contenu avec Eleven v4 ou Eleven v4 Turbo.
- Artificial Analysis, classement Provider Voice Arena, septembre 2026
- Fondé sur des tests comparatifs à l’aveugle des préférences utilisateurs face à Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS et Google Gemini 3.8 Flash TTS, en septembre 2026. Pour chaque paire, les évaluateurs ont écouté la même réplique générée par Eleven v4 et par un concurrent, présentées à l’aveugle, puis ont déterminé laquelle était la plus expressive et laquelle paraissait la plus naturelle ; les égalités comptaient pour moitié.
- Délai médian entre la requête et une parole audible. Mesuré en septembre 2026 avec des scripts identiques et les paramètres par défaut face à Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS et OpenAI GPT-4o mini TTS ; la latence réseau a été mesurée puis retirée pour tous les systèmes. Eleven v4 Turbo en streaming via WebSocket.