Comment créer des voix synthétiques au rendu naturel ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les modèles IA sophistiqués d'aujourd'hui créent des voix synthétiques au rendu naturel. Entraînés sur d'immenses jeux de données de voix humaines réelles, ces modèles utilisent des réseaux neuronaux avancés pour identifier et reproduire les schémas authentiques de la parole. La création d'une voix synthétique est aussi appelée synthèse vocale, tandis que l'audio produit est appelé parole synthétique.
Pour créer une nouvelle voix synthétique, un utilisateur s'enregistre en train de parler. Le modèle IA analyse alors ses schémas phonétiques et son intonation uniques, puis exploite ces données pour reproduire sa voix. L'utilisateur peut ensuite ajuster des caractéristiques vocales telles que l'accent, le ton et le débit afin d'obtenir le résultat final. Certaines voix synthétiques sont le clone direct de la parole d'une personne, tandis que d'autres combinent plusieurs voix. Il est également possible de concevoir des voix à partir d'une description textuelle, sans aucun enregistrement.
Les voix synthétiques ouvrent de nombreuses possibilités créatives pour les podcasts, les livres audio, les jeux vidéo et la publicité. Dans cet article, nous expliquons comment les voix synthétiques sont créées, ce qui leur donne un rendu naturel et comment concevoir votre propre voix synthétique avec ElevenLabs.
En résumé
- Les voix synthétiques sont créées à l'aide de modèles IA neuronaux qui analysent et reproduisent les schémas de la parole humaine.
- Les voix synthétiques permettent de narrer des livres audio, de générer des dialogues de jeux vidéo, de créer des podcasts et des voix off à grande échelle, de concevoir des agents IA pour le service client, ou encore de préserver des voix menacées de disparition.
- Le clonage de voix analyse les enregistrements de la voix d'une personne donnée et en reproduit l'accent ainsi que les schémas de parole uniques.
- Les voix IA modernes ont un rendu naturel, car elles reproduisent la prosodie humaine et tiennent compte du contexte, au lieu de simplement reproduire des mots ou des syllabes isolés.
Création d'une voix synthétique, étape par étape
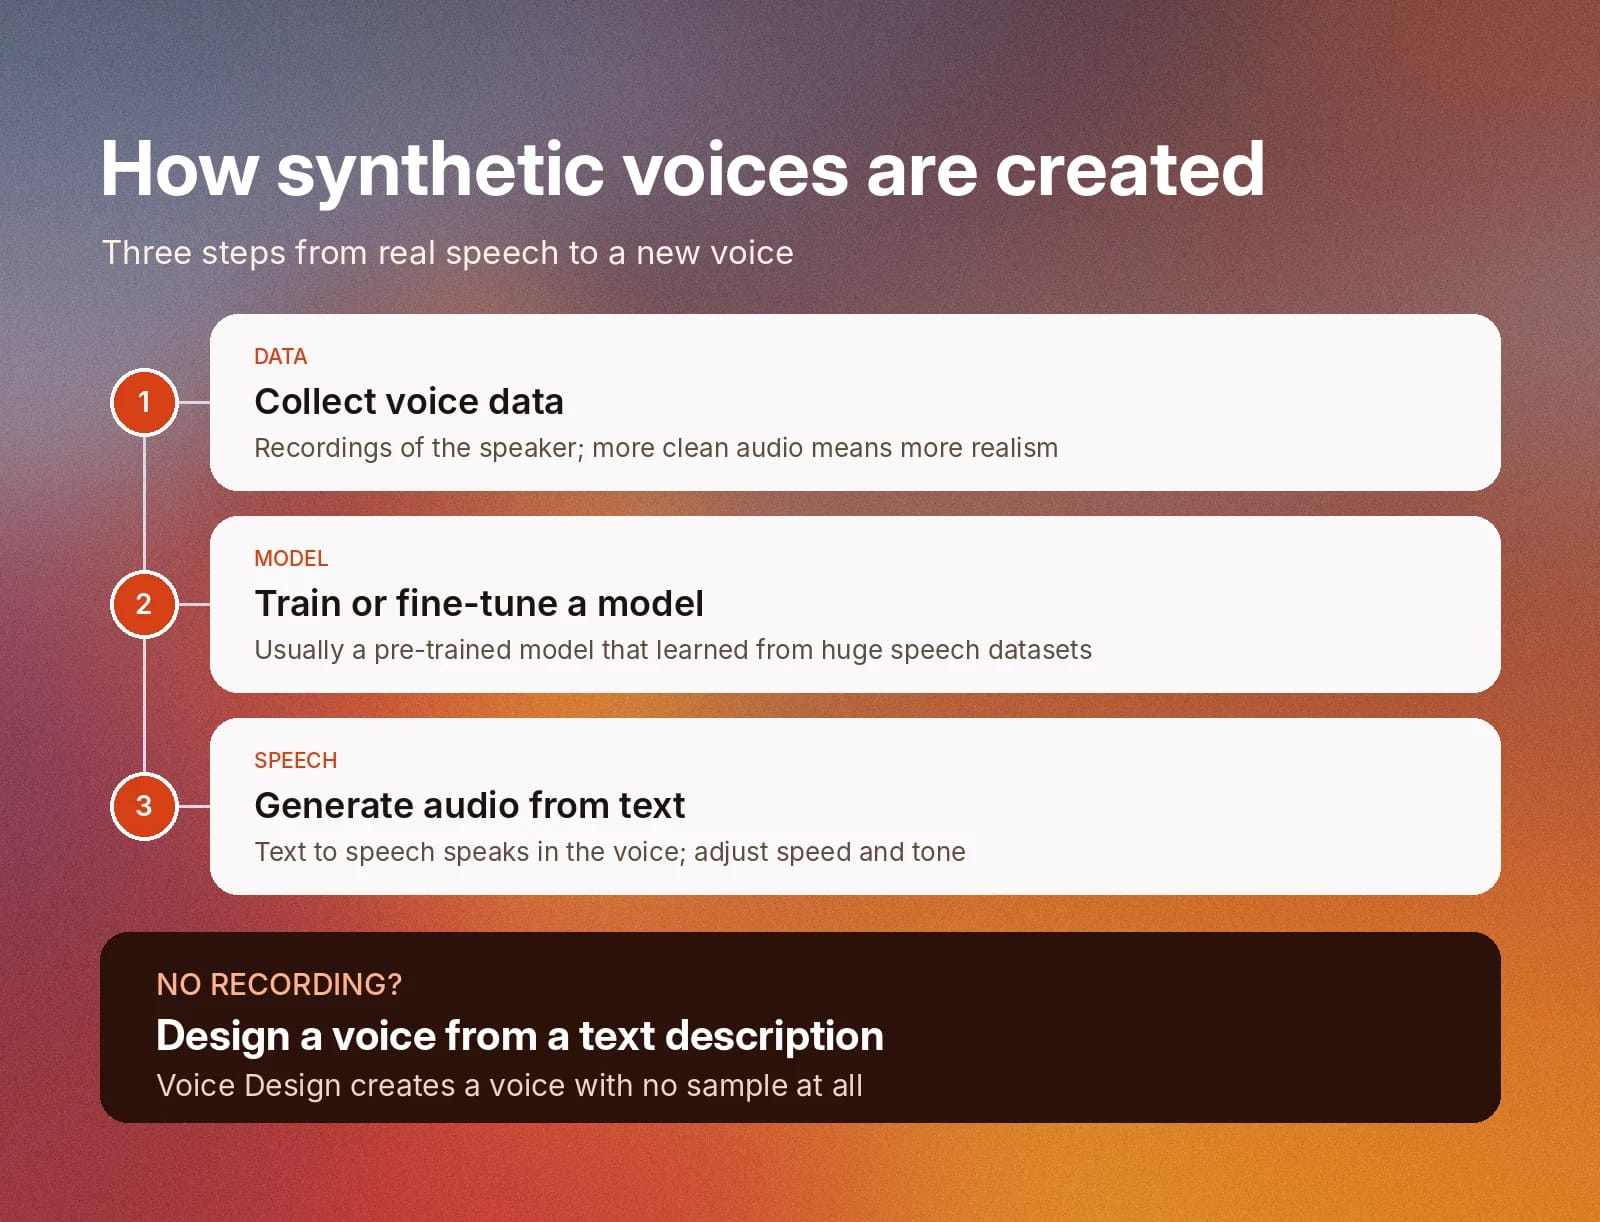
La création d'une voix synthétique suit un processus en trois étapes.
Voici comment cela se déroule concrètement :
- Étape 1 : collecter des données vocales : Les voix synthétiques commencent par de la parole humaine réelle. Pour créer une nouvelle voix, vous aurez besoin d'enregistrements audio des locuteurs que vous souhaitez reproduire. Plus vous fournissez de données, plus la voix finale sera précise et réaliste. Voici quelques bonnes pratiques pour le clonage de voix.
- Étape 2 : entraîner ou affiner un modèle IA : Pour créer des voix synthétiques, les modèles IA analysent d'abord de vastes jeux de données contenant une grande diversité d'enregistrements vocaux. Ils utilisent ces données pour comprendre les schémas de la parole humaine. Une fois entraîné, un modèle IA peut cloner des voix réelles à partir d'un seul enregistrement vocal. Dans la plupart des cas, vous utiliserez un modèle préentraîné plutôt que d'en concevoir un vous-même de A à Z.
- Étape 3 : générer de l’audio à partir de texte : Les voix synthétiques utilisent la synthèse vocale pour générer de l’audio. Vous pouvez ajuster des paramètres tels que la vitesse et le ton selon vos préférences. Pour aller plus loin, consultez notre guide sur le fonctionnement de la technologie de synthèse vocale.
Des données vocales au text to speech neuronal
Les modèles neuronaux de synthèse vocale sont entraînés sur de nombreux jeux de données d’enregistrements de voix réelles. Ces jeux de données comprennent des enregistrements dans différentes langues, avec divers accents, émotions et hauteurs de voix. La synthèse vocale neuronale est aujourd’hui une forme largement utilisée de synthèse de la parole.
Les modèles traditionnels assemblaient des enregistrements existants de mots, de syllabes et de phonèmes. Le résultat était très robotique, car ils ne pouvaient pas reproduire les variations de hauteur, de rythme et d'expression qui rendent la parole humaine.
Au lieu de seulement apprendre le son des lettres et des syllabes, les modèles neuronaux modernes de text to speech apprennent les schémas naturels de prononciation et les rythmes de la parole humaine. Lorsqu'ils convertissent du texte en parole, ces modèles analysent le texte, le transforment en caractéristiques acoustiques, puis utilisent celles-ci pour générer des formes d'onde.
Les caractéristiques acoustiques telles que la hauteur, le rythme et le ton étant intégrées aux modèles IA neuronaux, la parole produite offre un rendu bien plus naturel et authentique que celui des modèles précédents.
Les résultats sont également personnalisables : vous pouvez modifier des paramètres tels que la vitesse, l'émotion et même l'accent pour obtenir exactement la voix recherchée. Par exemple, votre marque peut utiliser la même voix synthétique sur l'ensemble de votre site web, mais adopter l'enthousiasme et l'urgence pour les contenus marketing, et le calme pour les interactions avec le service client.
Text to speech standard, neuronal et génératif
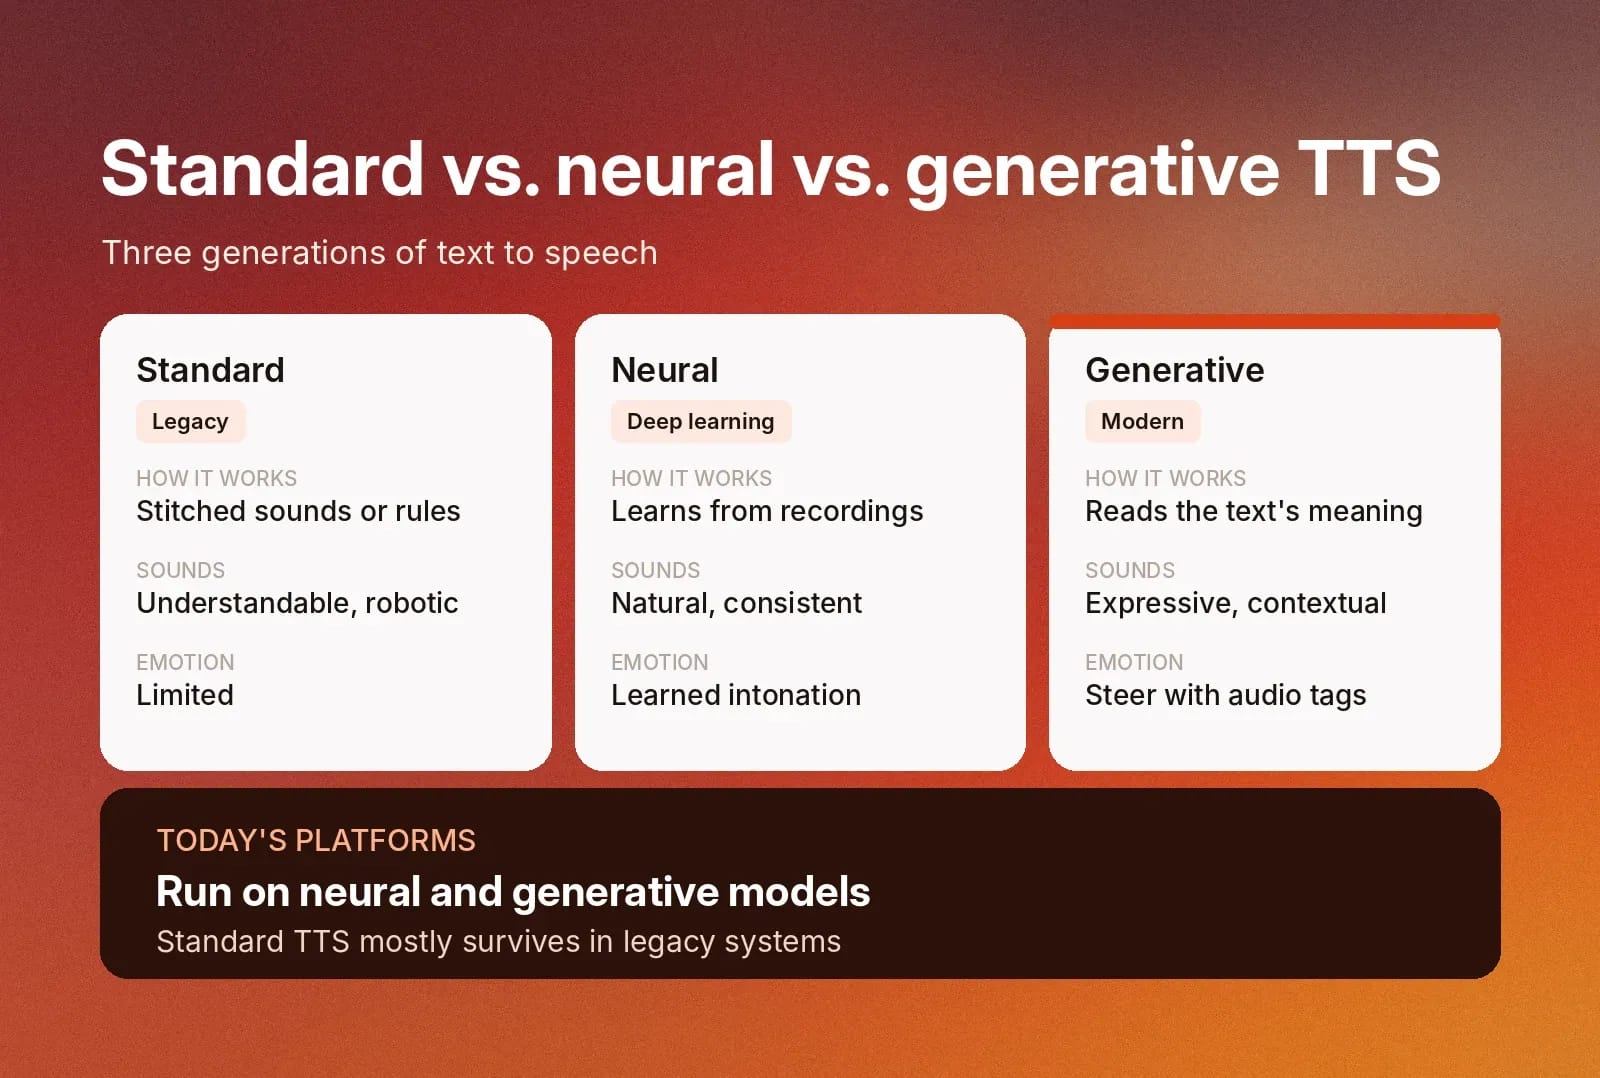
Les modèles de text to speech se répartissent en trois grandes générations.
Comprendre leurs différences permet de saisir pourquoi les modèles modernes, comme ElevenLabs Text to Speech, peuvent avoir un rendu si naturel.
- Text to speech standard : ces systèmes assemblent des sons préenregistrés ou suivent des règles et des modèles statistiques pour prononcer le texte. Le résultat est compréhensible, mais robotique et peu expressif.
- Text to speech neuronal : les modèles d'apprentissage profond apprennent la prononciation, le rythme et l'intonation à partir de vastes ensembles d'enregistrements, puis génèrent une parole bien plus naturelle et cohérente.
- Text to speech génératif : les modèles génératifs sont entraînés sur des données vocales encore plus vastes et variées. Ils utilisent le sens du texte pour définir l'émotion, le débit et l'accentuation. Vous pouvez orienter leur interprétation avec des instructions, telles que des balises audio.
Les plateformes vocales modernes reposent sur des modèles neuronaux et génératifs, tandis que le text to speech standard subsiste surtout dans les systèmes existants.
Qu'est-ce qui donne un rendu naturel à la génération de voix par IA ?
Les voix synthétiques générées par IA ressemblent beaucoup aux voix humaines. En réalité, il peut être difficile de les distinguer si vous n'écoutez pas attentivement.
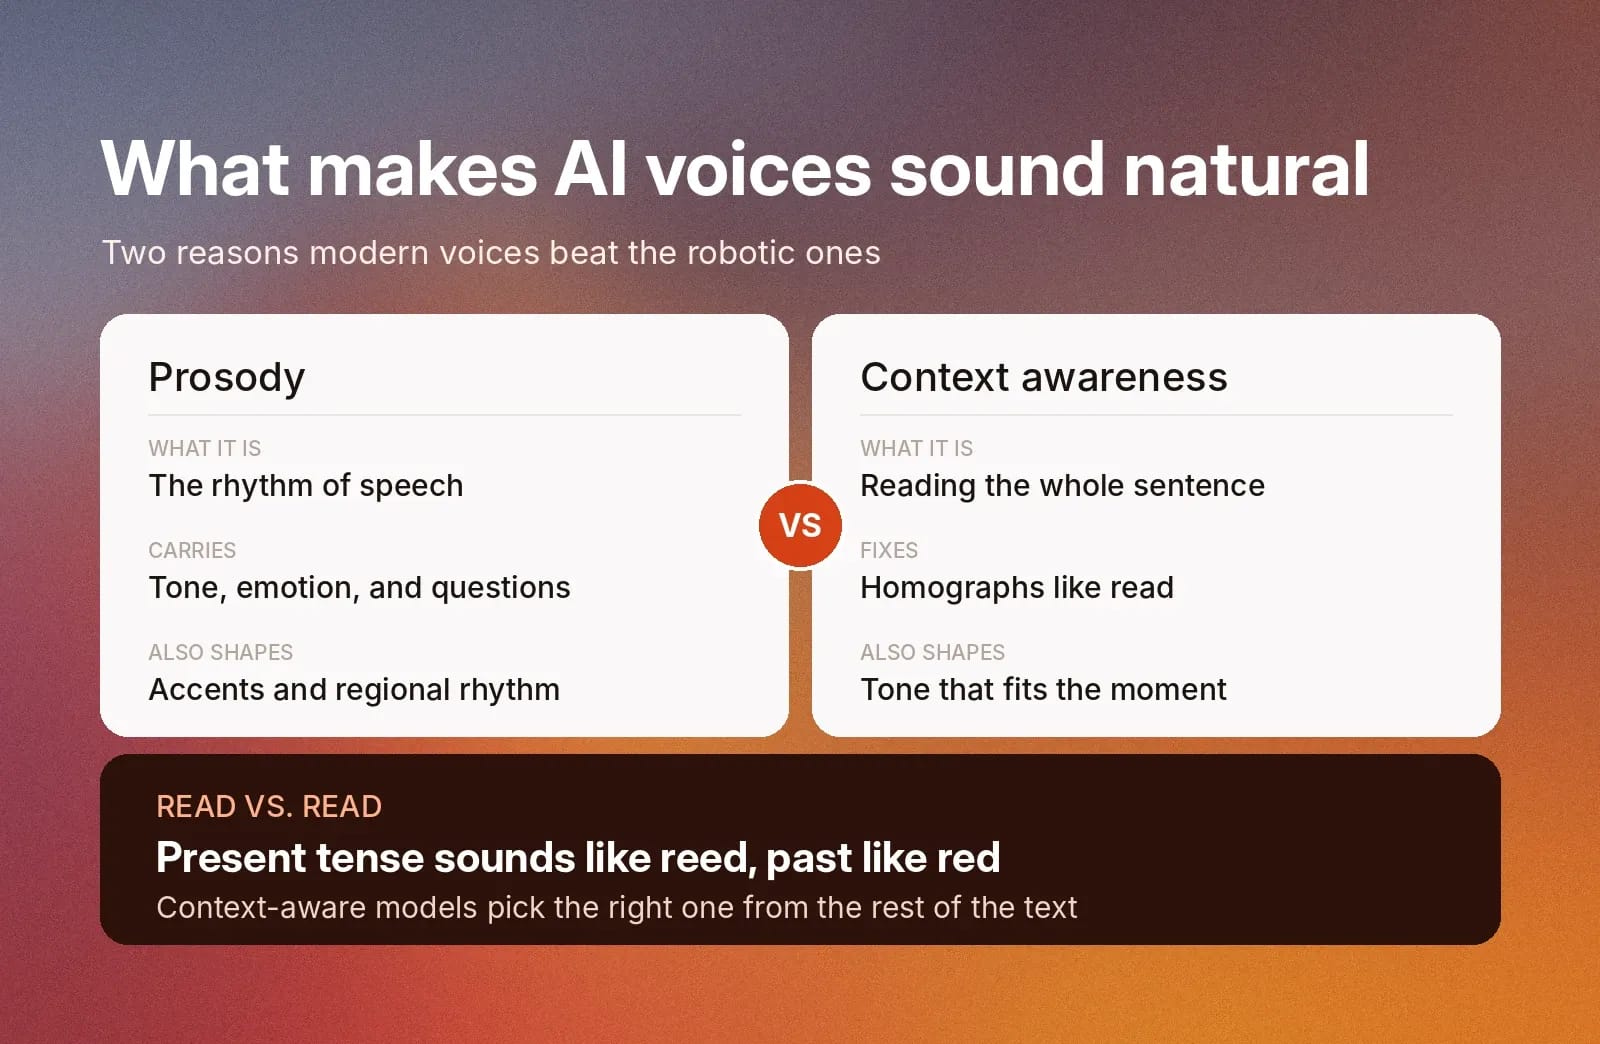
Les voix générées par IA ont un rendu plus naturel que les voix robotiques d'autrefois pour deux raisons : la prosodie et la prise en compte du contexte.
Prosodie
La prosodie correspond au rythme naturel de la parole humaine. De légères variations d'intonation et de vitesse transmettent le ton et l'émotion lorsque nous parlons. Par exemple, parler vite peut traduire du stress ou de l'enthousiasme, tandis que monter dans les aigus à la fin d'une phrase transforme une affirmation en question.
Les modèles actuels de voix IA sont entraînés à comprendre et à reproduire la prosodie. Leur production reflète ainsi le flux naturel de la conversation humaine, plutôt que de paraître rigide ou monotone.
Si vous utilisez une voix synthétique pour narrer un livre audio ou créer des dialogues de jeux vidéo, elle s'appuiera sur la prosodie pour refléter les émotions du personnage. Si vous créez une voix off pour un contenu éducatif ou un agent IA pour le service client, le modèle IA ajustera la prosodie pour une interprétation calme et empathique.
En comprenant la prosodie, les modèles IA peuvent aussi reproduire des accents spécifiques. Par exemple, le rythme d'un accent anglais nord-américain diffère nettement de celui d'un accent anglais britannique, écossais ou irlandais, même si la langue parlée est la même.
Prise en compte du contexte
Au lieu de traiter chaque mot isolément, les modèles TTS propulsés par l'IA analysent l'ensemble de la phrase, de la proposition ou de la conversation, puis adaptent l'interprétation au contexte.
Par exemple, de nombreux mots s'écrivent de la même façon mais se prononcent différemment selon le temps et le contexte. En anglais, par exemple, le mot « read » se prononce comme « reed » au présent, mais comme « red » au passé.
Comme les voix IA tiennent compte du contexte, elles identifient la prononciation appropriée à partir du reste du texte. Elles adaptent également leur interprétation afin que le ton et l'émotion conviennent à la situation.
Comment fonctionne le clonage de voix ?
Le clonage de voix utilise l'IA pour analyser la voix d'une personne réelle, puis appliquer ses caractéristiques vocales à une parole synthétique.
La personne qui clone sa voix doit d'abord fournir un court échantillon audio. Le modèle IA utilise cet échantillon pour identifier son accent, sa hauteur, son ton et sa cadence. Il se sert ensuite de ces caractéristiques pour créer une réplique numérique de sa voix. Les utilisateurs peuvent générer de nouvelles paroles avec cette voix grâce à la technologie text to speech.
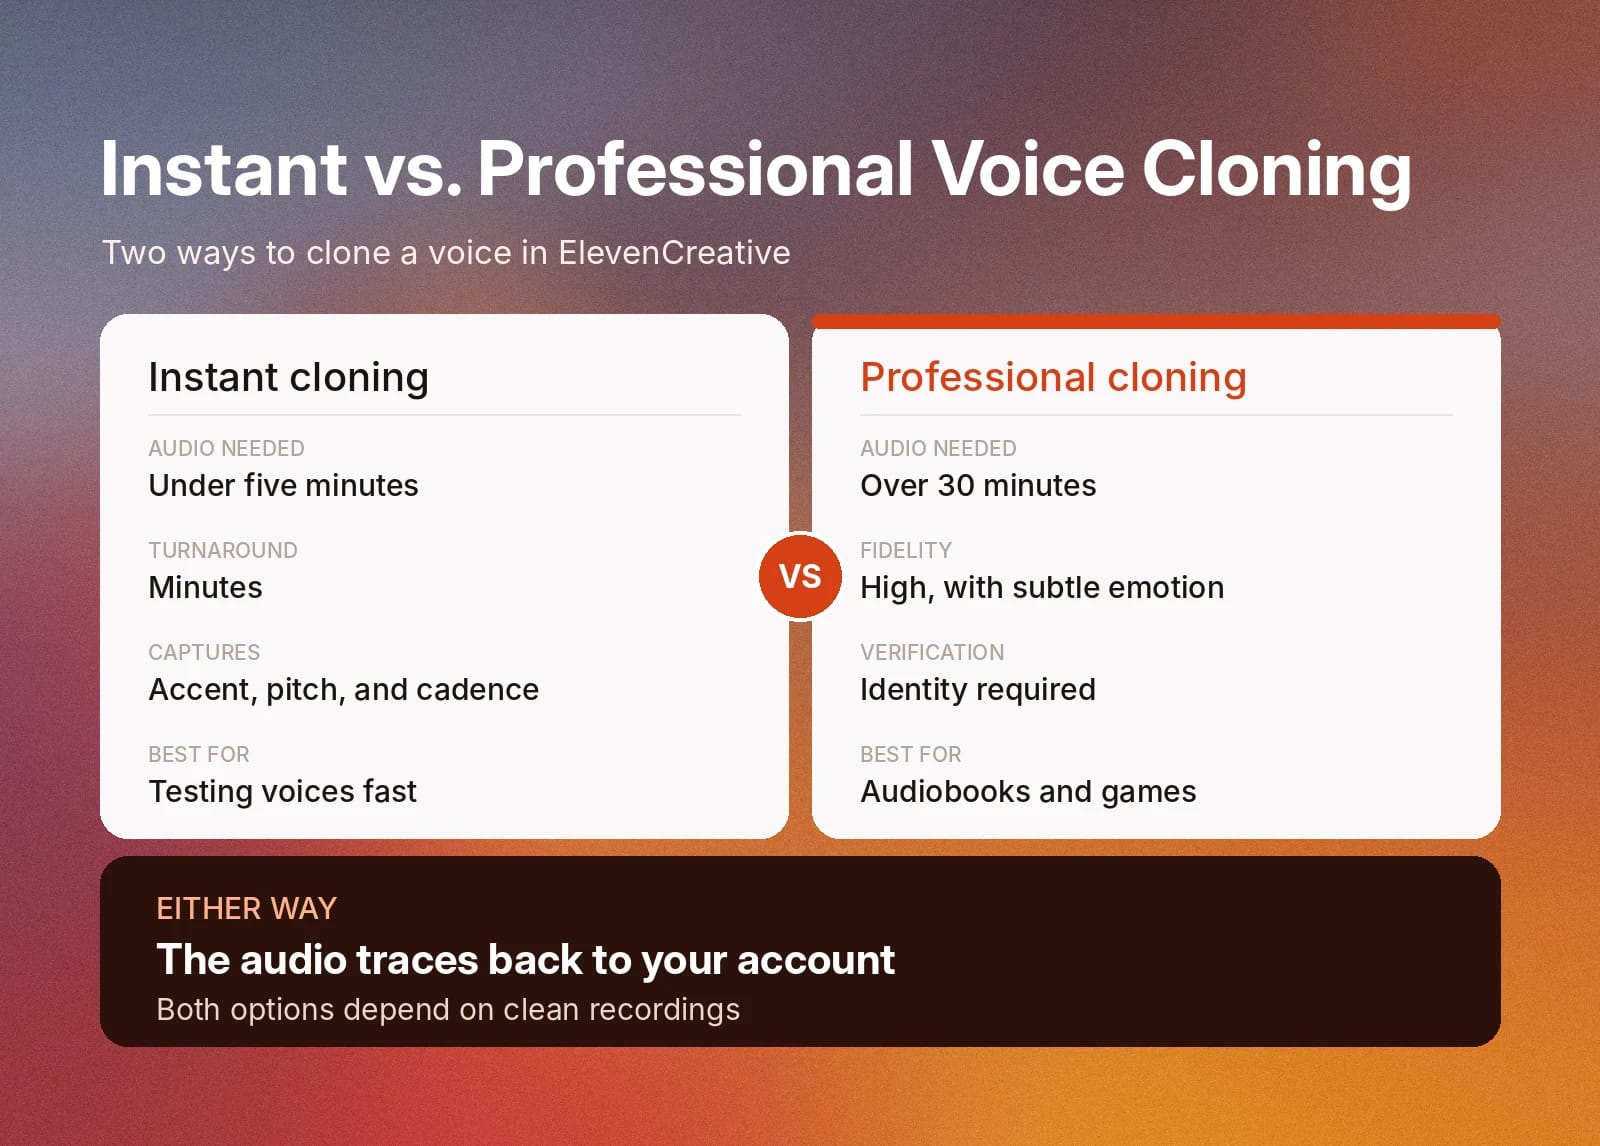
Il existe deux types de clonage de voix : instantané et professionnel. Le clonage instantané crée une réplique vocale à partir de moins de deux minutes d'échantillon audio. Il permet ainsi de tester facilement des options vocales avant de s'engager dans un projet plus ambitieux.
Le clonage professionnel utilise entre 30 minutes et trois heures d'échantillons audio pour créer un clone vocal haute fidélité. Les clones vocaux professionnels préservent des détails subtils, tels que l'émotion et l'intonation, absents des clones instantanés. Ils nécessitent également une vérification d'identité.
Le clonage de voix offre de nombreux cas d'usage, de la génération rapide de voix off à la préservation de voix qui pourraient autrement disparaître.
Comment enregistrer de bons échantillons vocaux pour la synthèse vocale
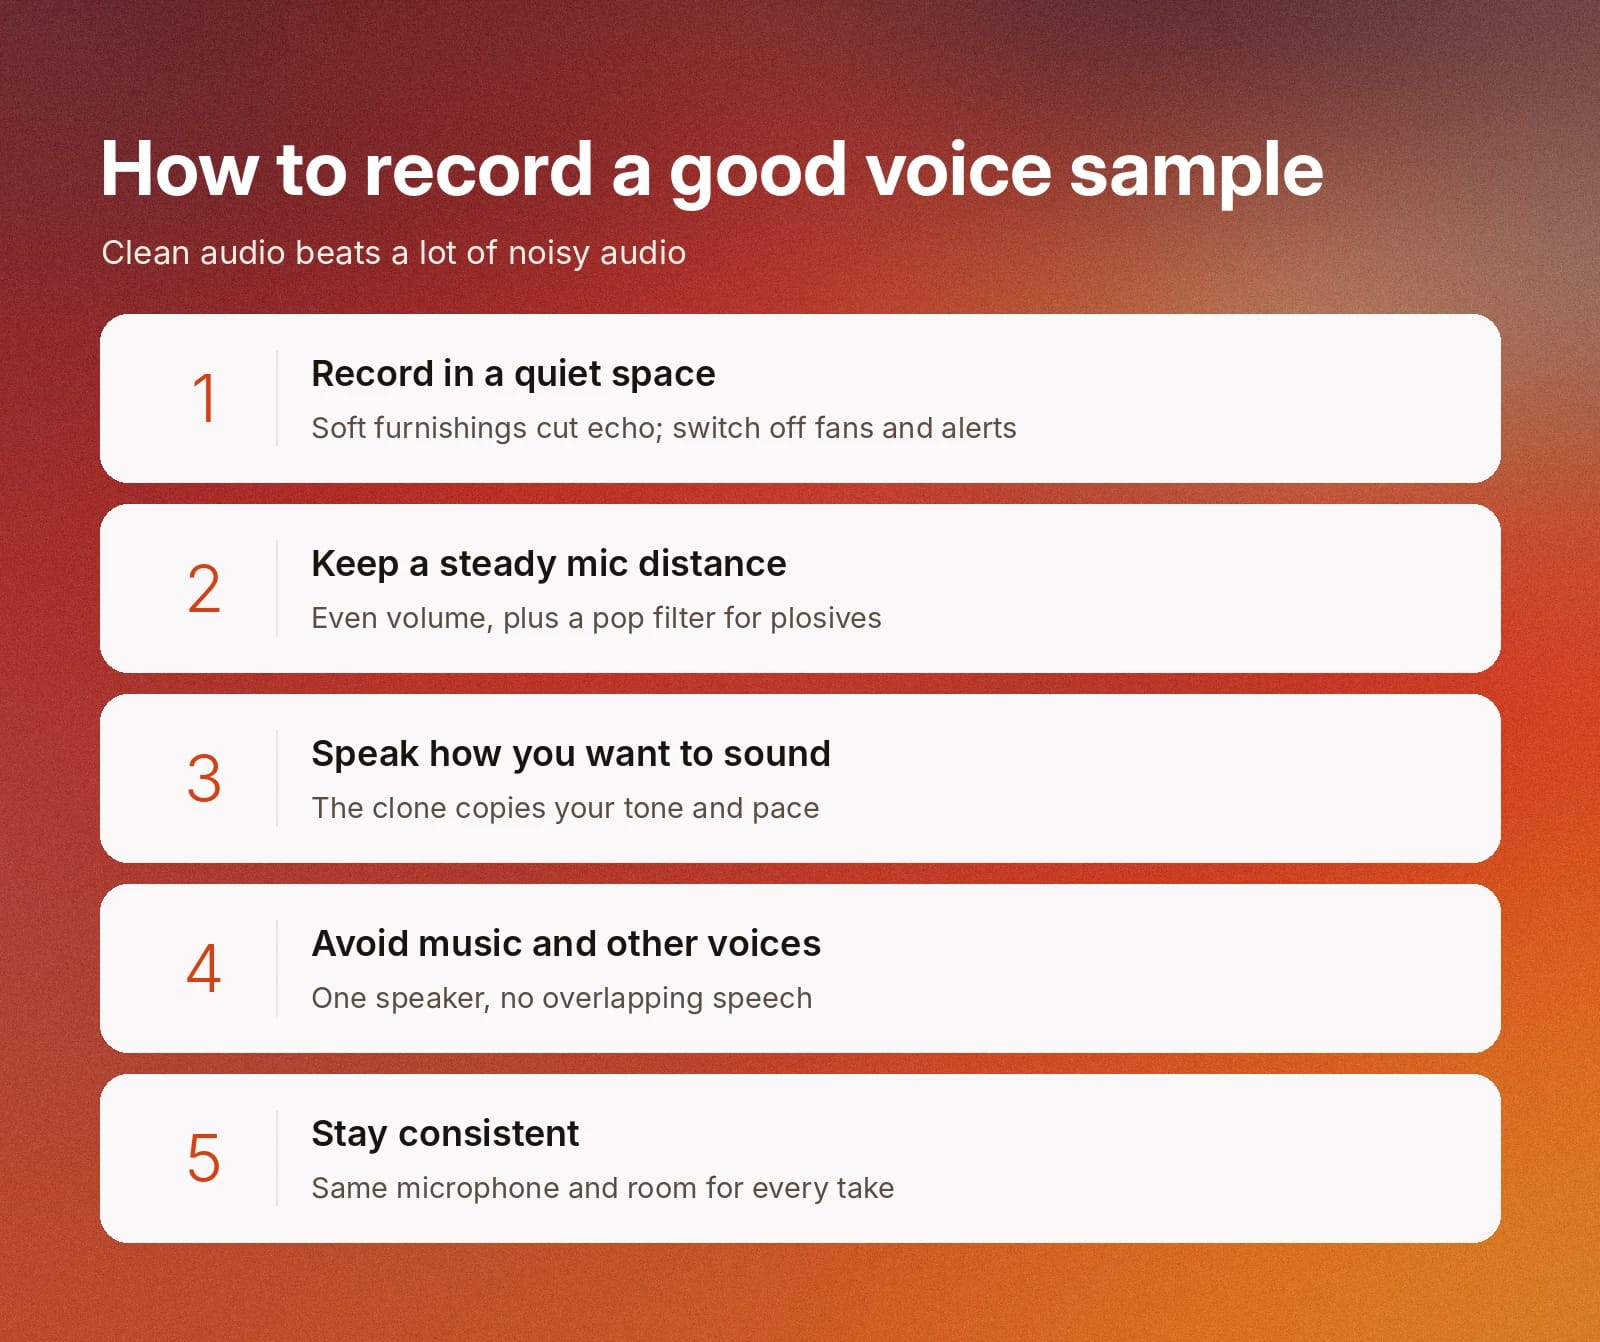
La qualité d'un clone vocal dépend de celle de l'enregistrement. Même sans équipement d'enregistrement coûteux, de nombreux petits gestes peuvent améliorer le rendu de votre clone vocal.
Ces habitudes vous aideront à capturer des échantillons nets :
- Enregistrez dans un lieu calme : les tissus d'ameublement, comme les rideaux et les tapis, réduisent l'écho, et couper les ventilateurs ainsi que les notifications élimine les bruits de fond.
- Maintenez le microphone à une distance constante : une distance régulière maintient un volume homogène, et un filtre antipop réduit les sons plosifs agressifs.
- Parlez comme vous souhaitez que le clone s'exprime : le clone reproduit votre interprétation. Enregistrez avec le ton et le débit que vous comptez utiliser.
- Évitez la musique et les autres voix : utilisez un seul locuteur, sans musique de fond ni paroles qui se chevauchent.
- Restez cohérent : utilisez le même microphone et la même pièce pour tous vos enregistrements.
Le clonage instantané nécessite moins d'audio et le clonage professionnel davantage, mais tous deux dépendent d'enregistrements nets. Un audio propre de la bonne durée donne de meilleurs résultats qu'un grand volume d'audio bruité.
Comment créer une voix sans enregistrement : Voice Design
Toutes les voix synthétiques ne commencent pas par un enregistrement. Avec Voice Design, vous décrivez par écrit la voix recherchée, notamment son âge, son genre, son accent, son ton et son débit, puis le modèle IA génère des options vocales correspondant à votre description. Vous pouvez écouter ces options, choisir celle qui vous plaît et l'enregistrer dans votre bibliothèque vocale.
Voice Design est utile lorsque vous avez besoin d'une voix pour un personnage, une marque ou un produit, sans disposer d'une personne réelle à cloner. Consultez la documentation Voice Design pour apprendre à rédiger des descriptions vocales efficaces.
Comment savoir si une voix est générée par IA
Aucun signe unique ne permet de prouver qu'une voix est générée par IA. Une écoute attentive, des outils de détection et la vérification de l'origine de l'audio sont plus fiables que l'un de ces éléments pris isolément.
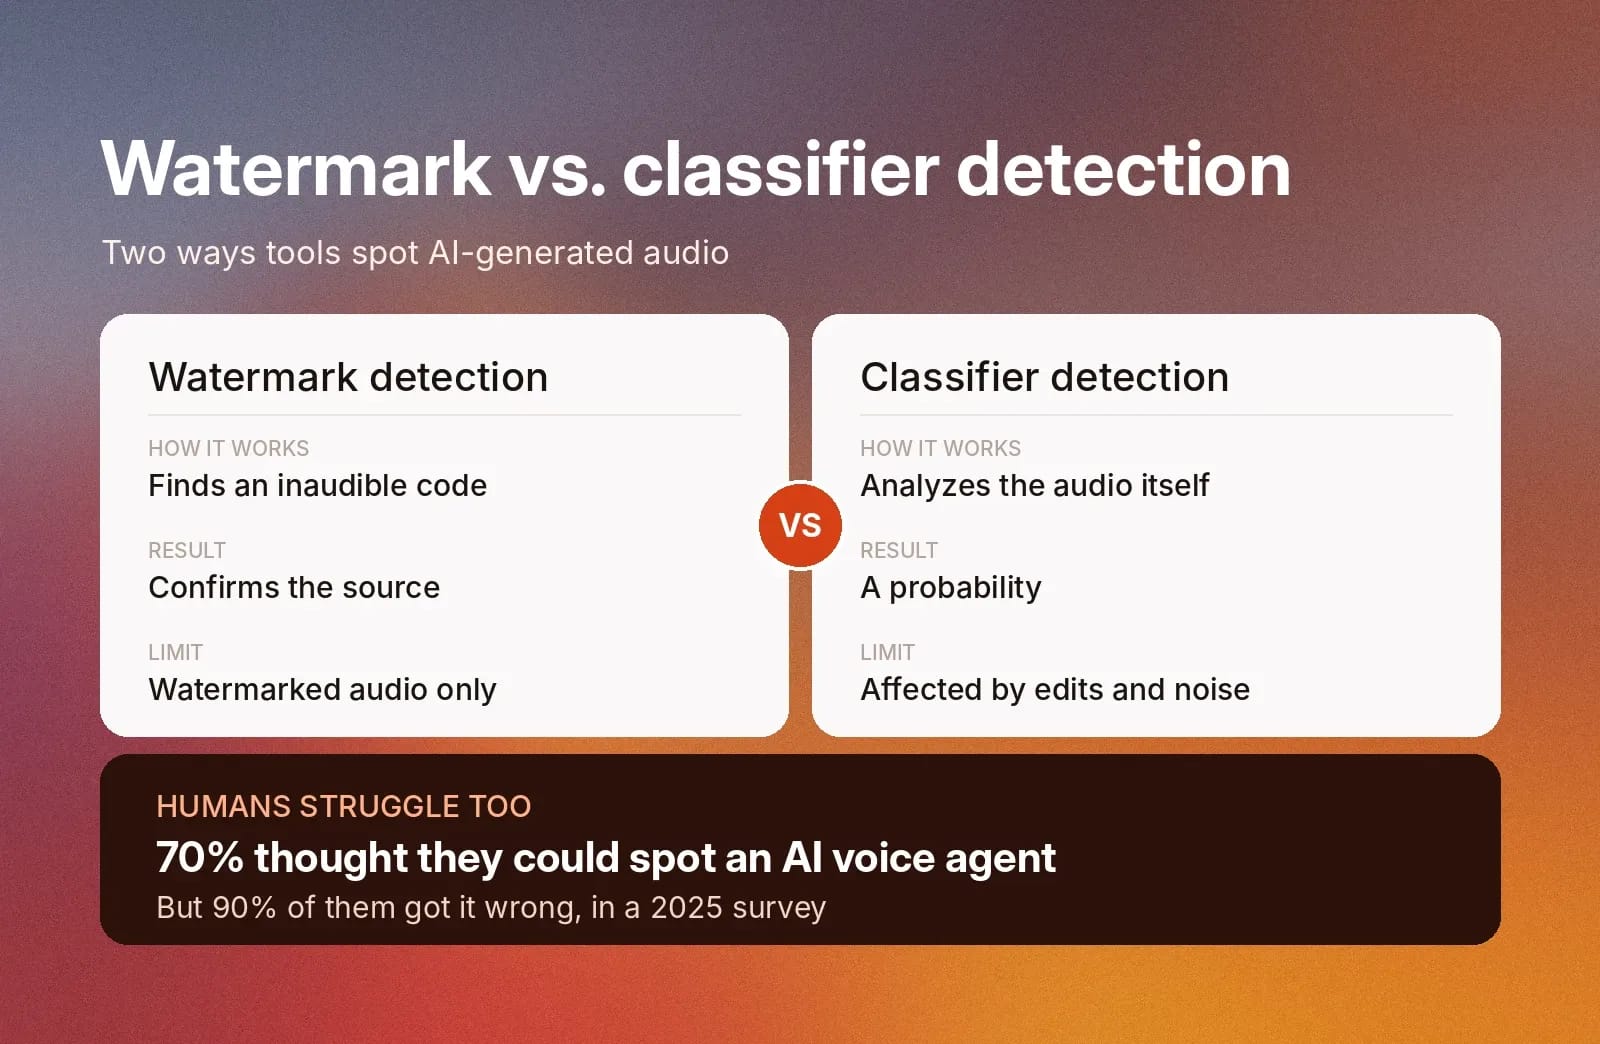
Nombreuses sont les personnes qui pensent pouvoir distinguer une vraie voix d'une voix générée par IA, mais elles ne se trompent pas toujours moins. Une enquête de 2025 a révélé que 70 % des consommateurs pensaient pouvoir identifier correctement un agent vocal IA, mais 90 % d'entre eux n'y sont pas parvenus.
Au lieu de vous fier à l'oreille humaine, vous pouvez utiliser un outil de détection. Ces outils fonctionnent principalement de deux façons :
- Détection de filigrane : certains fournisseurs d'IA intègrent un filigrane, un code inaudible pour l'humain, dans l'audio qu'ils génèrent. Un détecteur peut retrouver ce filigrane et confirmer l'origine de l'audio. Cette méthode ne fonctionne que sur les fichiers audio portant un filigrane.
- Détection par classificateur : un classificateur analyse l'audio et estime la probabilité qu'il ait été généré par IA. Il peut signaler un audio sans filigrane, mais le résultat reste une probabilité et peut être affecté par la compression, le bruit de fond ou le montage.
Aucune de ces méthodes n'est parfaite. Considérez le résultat d'une détection comme un élément de preuve parmi d'autres et confrontez-le à ce que vous savez de la source. Nous avons rédigé un guide sur la détection des deepfakes audio, qui approfondit le sujet.
ElevenLabs Speech Classifier est un outil qui détermine la probabilité qu'un échantillon audio ait été généré avec les modèles de voix IA d'ElevenLabs. ElevenLabs s'est également associé à Reality Defender dans le cadre d'initiatives de détection des deepfakes pour identifier et prévenir la fraude vocale.
Les signes à écouter
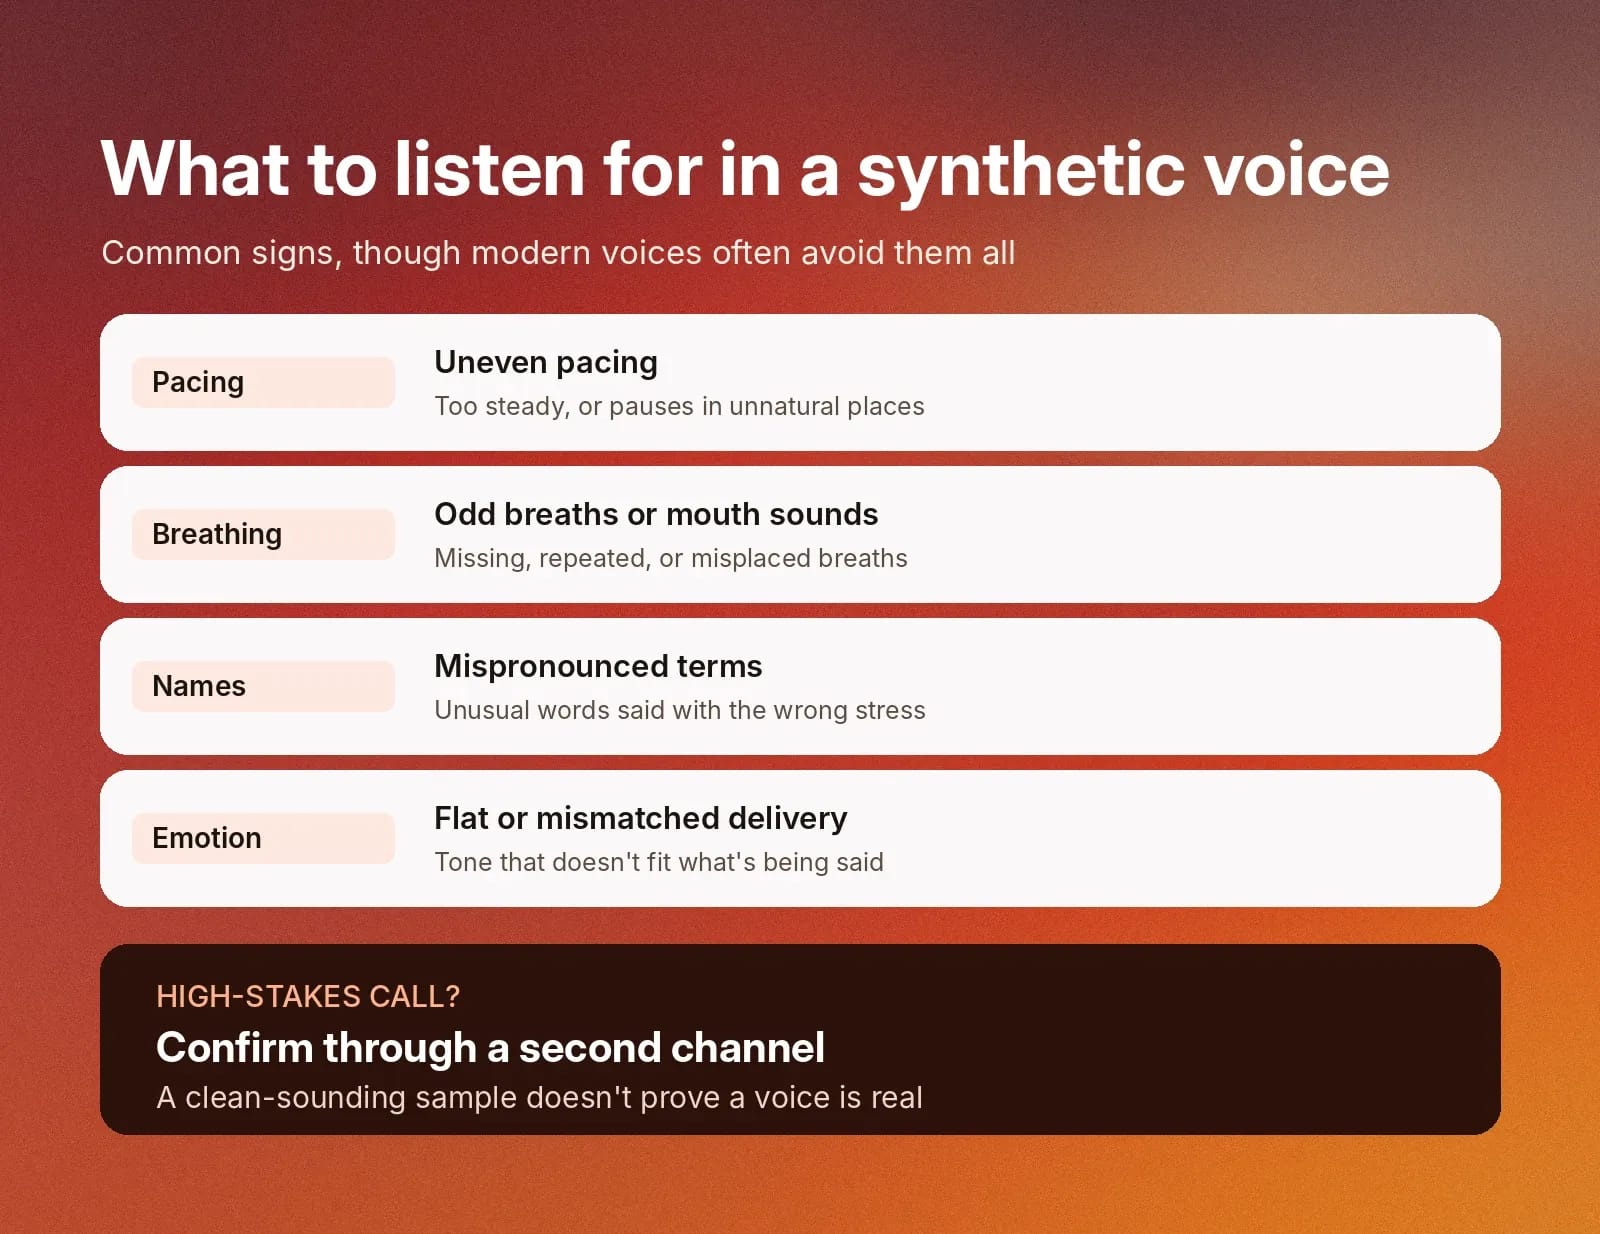
Les outils de détection ne sont pas toujours disponibles : il est donc utile de connaître les signes courants d'une voix synthétique.
Soyez attentif aux éléments suivants :
- Débit irrégulier : une parole trop régulière ou qui marque des pauses à des endroits inhabituels.
- Respiration ou bruits de bouche inhabituels : des respirations absentes, répétées ou mal placées. Ils peuvent indiquer des artefacts audio générés involontairement par un modèle.
- Noms ou termes mal prononcés : des mots inhabituels prononcés avec un accent tonique erroné. C'est encore plus fréquent dans les langues qui utilisent des signes diacritiques pour accentuer certaines syllabes, comme l'espagnol.
- Émotion plate ou inadaptée : une interprétation qui ne correspond pas au sens des mots. Cela révèle une absence de compréhension du texte lui-même, un problème fréquent avec les anciens modèles TTS.
Les voix synthétiques modernes évitent souvent tous ces défauts. Un échantillon au rendu net ne prouve pas qu'une voix est réelle. Pour toute situation à enjeu, comme un appel demandant de l'argent, vérifiez par un second canal.
Concevez des expériences vocales sur mesure avec ElevenCreative
ElevenCreative vous aide à concevoir des expériences vocales sur mesure pour vos projets créatifs. Choisissez parmi une vaste bibliothèque de plus de 20 000 voix prêtes à l'emploi ou créez la vôtre grâce à un clonage de voix précis et sécurisé.
Utilisez ElevenCreative pour reproduire votre voix avec Instant Voice Cloning ou Professional Voice Cloning. Instant Voice Cloning fonctionne en quelques minutes et vous aide à tester des options vocales ou à lancer rapidement des projets personnels. Professional Voice Cloning utilise des échantillons audio plus longs afin de créer des voix de haute qualité, idéales pour des projets de longue durée tels que les livres audio, les jeux vidéo ou les podcasts. Quelle que soit l'option choisie, l'audio reste traçable jusqu'à votre compte pour garantir la sécurité.
La Voice Library personnalisable et les outils de clonage de voix d’ElevenCreative vous aident à donner vie à vos projets créatifs. S'inscrire à ElevenCreative pour découvrir des voix emblématiques ou créer la vôtre.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.