Détection des deepfakes audio : fonctionnement et vérification des contenus audio ElevenLabs
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
La détection des deepfakes audio consiste à analyser des contenus vocaux afin de déterminer si la parole est authentique. Les synthétiseurs vocaux IA capables de générer des deepfakes sont de plus en plus accessibles. Dans la vie publique comme en entreprise, il est devenu essentiel d’identifier rapidement si la parole entendue est authentique ou manipulée par un acteur malveillant.
Dans cet article, nous examinons le fonctionnement de la détection des deepfakes audio, les différents types de détection, leurs forces et leurs limites, ainsi que l’intégration de cette détection dans des dispositifs de lutte contre la fraude à grande échelle.
En résumé
- La parole synthétisée par deepfake devient plus difficile à détecter à l’oreille seule. Elle présente un risque important dans la vie publique comme en entreprise.
- Il existe plusieurs types de logiciels de détection des deepfakes. Les outils classiques utilisent une analyse statistique pour évaluer la probabilité qu’un échantillon audio soit généré par IA.
- Les nouvelles technologies de filigrane permettent de déterminer avec certitude si un échantillon vocal a été synthétisé.
- Le filigrane est très précis, mais les détecteurs ne fonctionnent que sur les contenus audio de leur propre fournisseur. Par exemple, Audio Detector d’ElevenLabs peut identifier avec une grande précision les filigranes générés par ses propres produits, mais pas ceux d’autres entreprises.
- Le filigrane est une ressource importante pour les organisations qui doivent détecter les deepfakes à grande échelle, mais il ne doit être qu’un outil parmi d’autres dans leur dispositif de détection.
Qu’est-ce que la détection des deepfakes audio ?
La détection des deepfakes audio consiste à déterminer si un contenu vocal a été généré ou manipulé par intelligence artificielle.
Un deepfake est toute forme de média, le plus souvent une image, une vidéo ou un contenu audio, créée par une application d’IA générative afin de déformer les propos ou les actions d’une personne. Les deepfakes audio ont de nombreux usages malveillants. Ils peuvent servir à commettre des fraudes, à tenter d’accéder à des comptes personnels, à diffuser de la propagande politique ou à usurper secrètement l’identité d’un conjoint ou d’un membre de la famille lors de conflits domestiques.
D’après les tendances actuelles, les victimes d’arnaques utilisant des deepfakes audio sont le plus souvent :
- Responsables politiques et autres personnalités publiques : les personnes dont de nombreux échantillons vocaux sont disponibles en ligne pour l’entraînement peuvent voir leur voix imitée par deepfake par des opposants ou des tiers afin de tromper le public.
- Membres de la famille : un acteur malveillant peut tenter d’utiliser des enregistrements vocaux trouvés pour escroquer des proches âgés au moyen de demandes d’argent falsifiées par deepfake.
- Dirigeants d’entreprise : de faux entretiens, présentations ou conférences téléphoniques sur les résultats financiers peuvent nuire à la marque d’une entreprise.
- Équipes de service client : des fraudeurs peuvent utiliser des échantillons vocaux recueillis pour inciter les équipes de service client à accorder l’accès à des comptes privés.
Malheureusement, les humains ne détectent pas les deepfakes de façon fiable. Dans des conditions de recherche contrôlées, la capacité des personnes à les identifier n’est pas meilleure que le hasard, et cette étude date de 2024. Depuis, les médias génératifs sont devenus nettement plus sophistiqués.
L’éducation et la législation contribueront largement à protéger la société contre l’influence des deepfakes, mais des méthodes de détection fiables restent nécessaires.
Comment fonctionne la détection des deepfakes audio ?
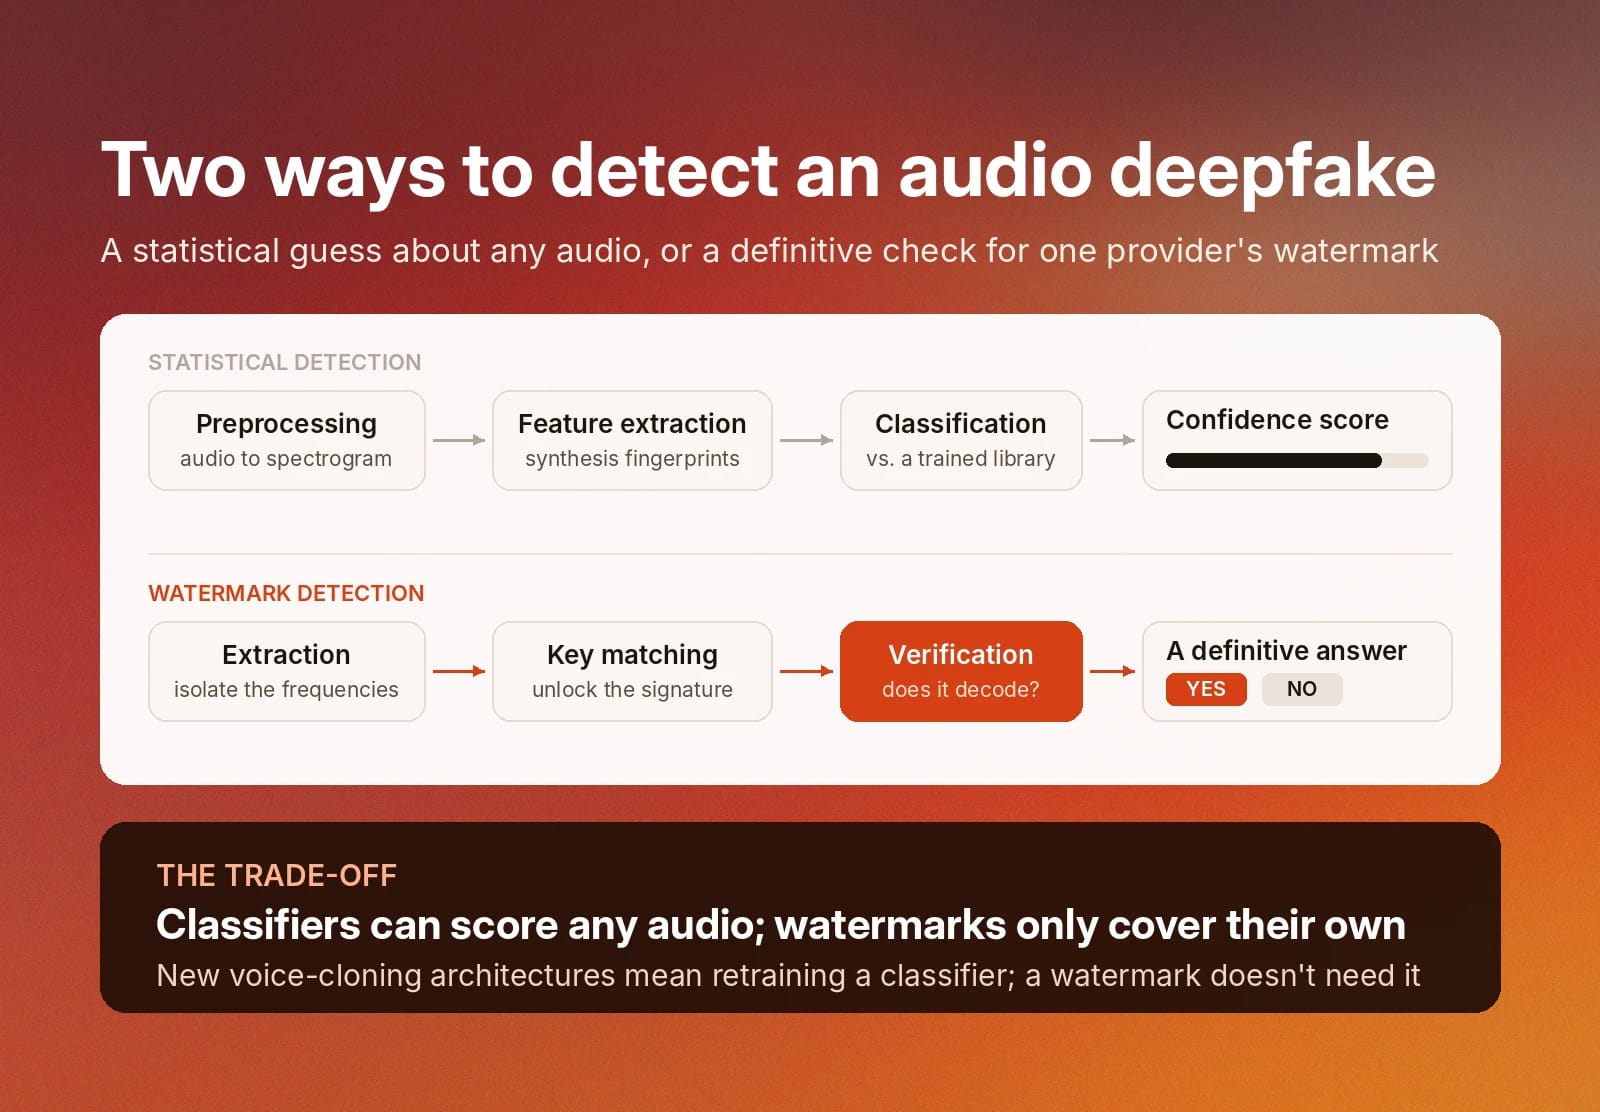
La détection classique des deepfakes utilise une analyse statistique pour mesurer la probabilité qu’un média ait été généré par une IA. Un outil de détection s’appuie sur des techniques d’apprentissage automatique pour reconnaître les motifs sous-jacents de différents types de parole synthétisée.
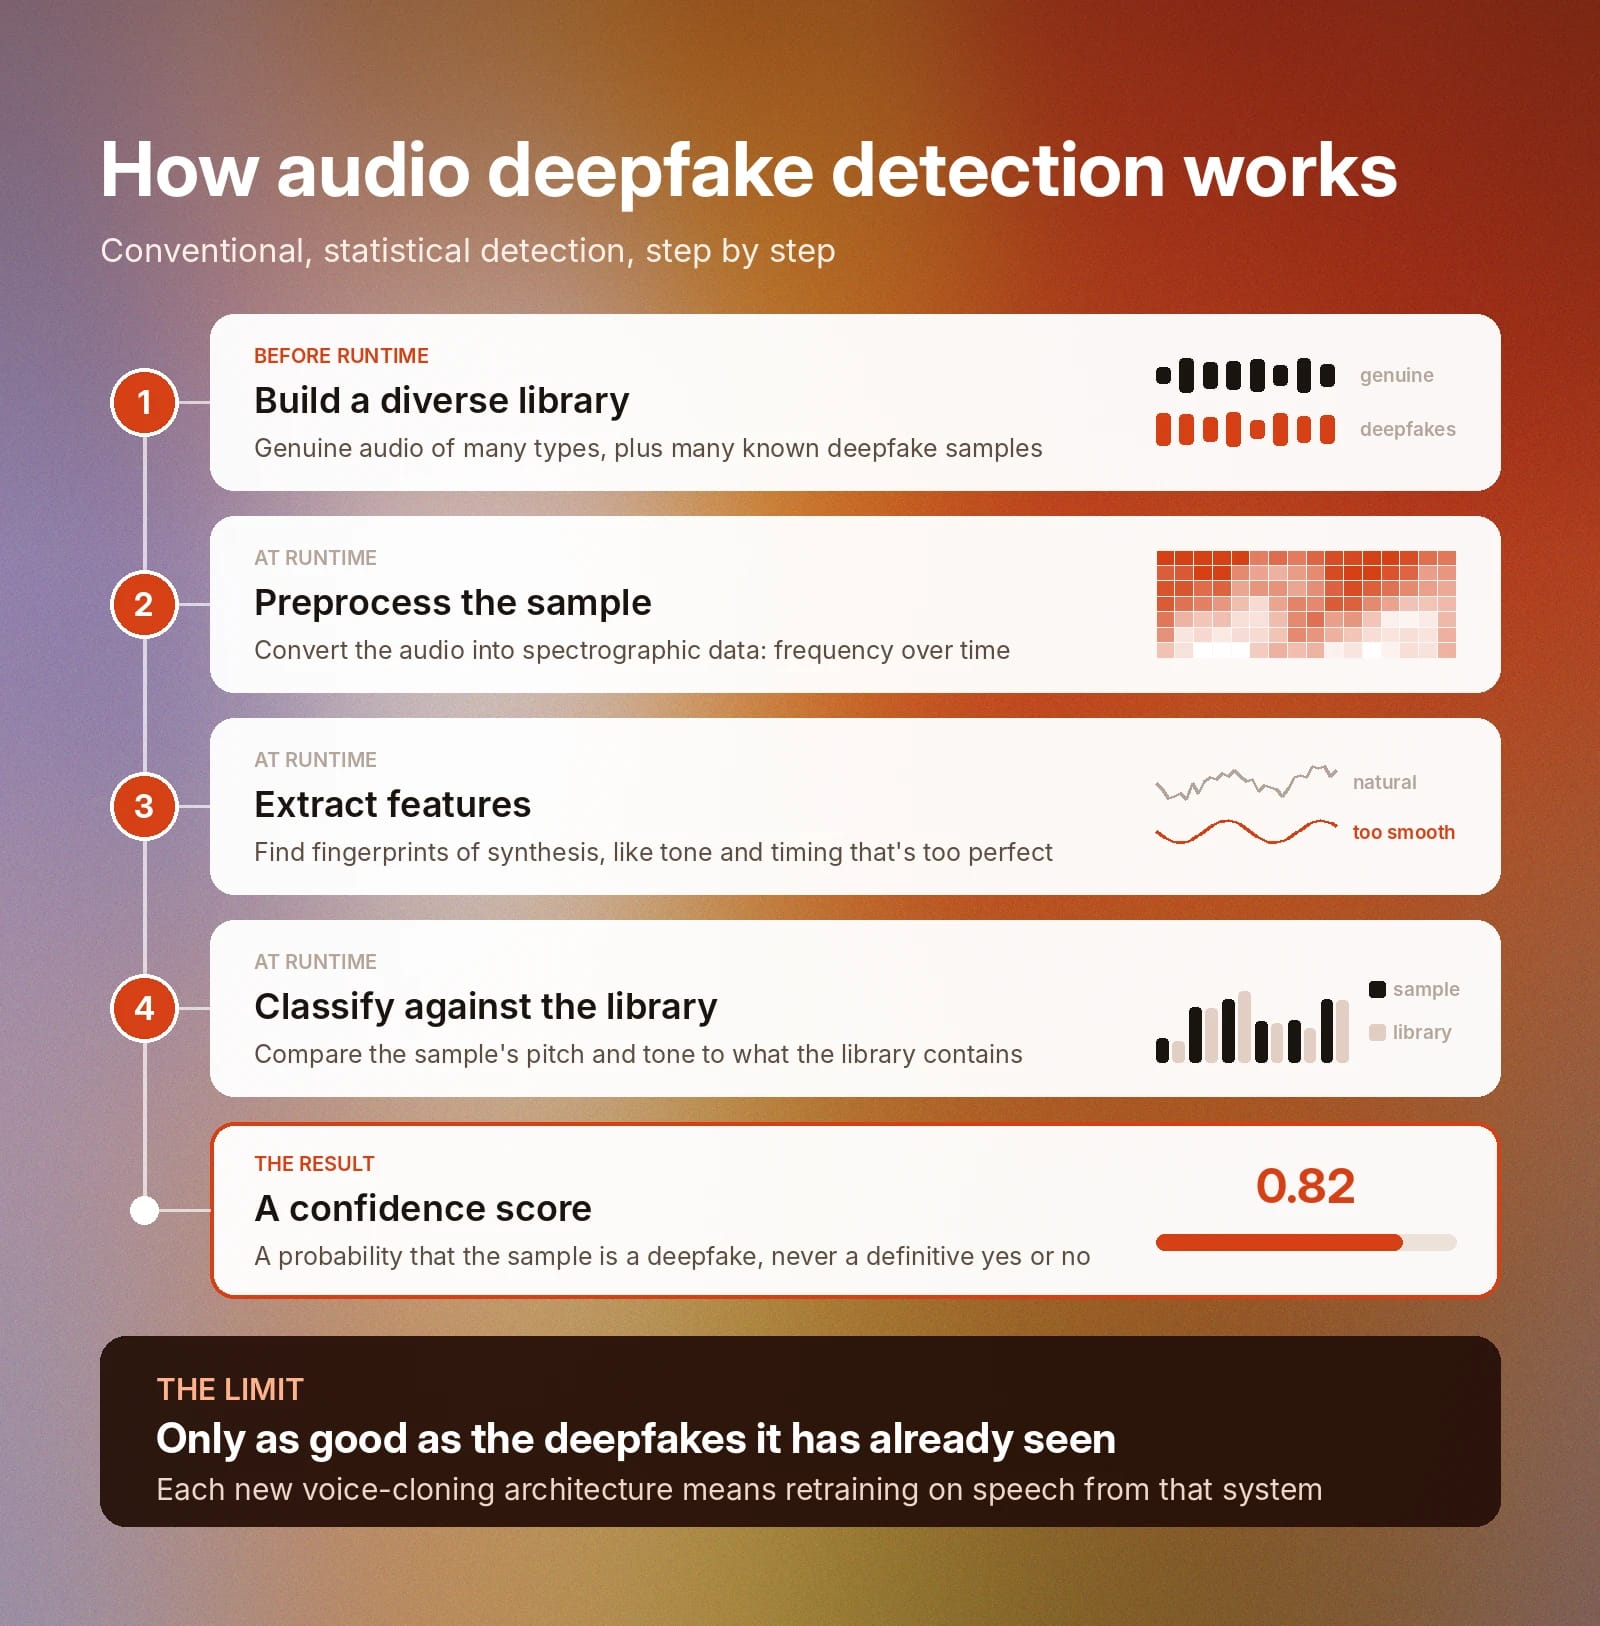
La première étape consiste à constituer une bibliothèque de contenus audio avec laquelle comparer les deepfakes suspects. Cet ensemble doit être diversifié : il doit inclure des échantillons audio authentiques de nombreux types, ainsi que de nombreux exemples connus de deepfakes pour faciliter les détections positives.
Lors de son exécution, le processus suit trois étapes : prétraitement, extraction de caractéristiques et classification.
Prétraitement audio
Lorsque vous soumettez un échantillon audio à un outil de détection entraîné, il le convertit en données spectrographiques, c’est-à-dire une représentation mathématique des variations de fréquence au fil du temps.
Extraction de caractéristiques
L’outil de détection extrait ensuite des caractéristiques des données de l’échantillon, comparables à des empreintes de parole synthétisée. Par exemple, la parole générée par IA est parfois trop parfaite et ne présente pas les irrégularités de tonalité et de rythme propres à la parole naturelle. La comparaison de la hauteur et du timbre de la voix du locuteur à sa bibliothèque aide également l’outil à repérer d’autres signaux d’alerte.
Classification
Comme la détection classique des deepfakes repose sur une analyse statistique, elle ne peut pas répondre définitivement « oui » ou « non » à la question de savoir si un échantillon est un deepfake. Elle génère plutôt un score de confiance, ou une probabilité, que l’échantillon soit un deepfake.
Parce qu’ils mesurent les similitudes entre un échantillon et une bibliothèque audio existante, les outils classiques sont limités par les exemples de deepfakes connus dont ils disposent. Chaque fois qu’une nouvelle architecture de clonage de voix est publiée, vous devez réentraîner votre outil de détection sur de la parole synthétisée par ce nouveau système pour la détecter avec précision.
Quelle est la différence entre le filigrane et la détection statistique ?
Le filigrane constitue une approche entièrement différente de la classification de la parole. Un classificateur d’apprentissage automatique émet une estimation probabiliste de l’authenticité d’un échantillon, d’après ce que ses données d’entraînement lui apprennent sur la parole naturelle, par exemple l’apparence d’une véritable charge émotionnelle et d’une véritable insistance dans les données spectrographiques, ou les types de variations de tonalité et de rythme qui sont naturels.
Le filigrane est déterministe. Il s’agit d’une signature mathématique intégrée aux données audio par le synthétiseur, à des niveaux inaudibles pour l’oreille humaine. Un détecteur de filigrane vérifie, par oui ou par non, s’il trouve cette signature cachée.
Un détecteur fonctionne en trois étapes simples :
- Extraction : l’outil extrait les données spectrographiques et isole les fréquences où il s’attend à trouver un filigrane.
- Correspondance de clé : il tente de déverrouiller la signature à l’aide d’une clé.
- Vérification : si le signal est correctement décodé, l’outil confirme que le générateur de voix IA concerné a généré le contenu audio.
Processus de détection des filigranes d’ElevenLabs
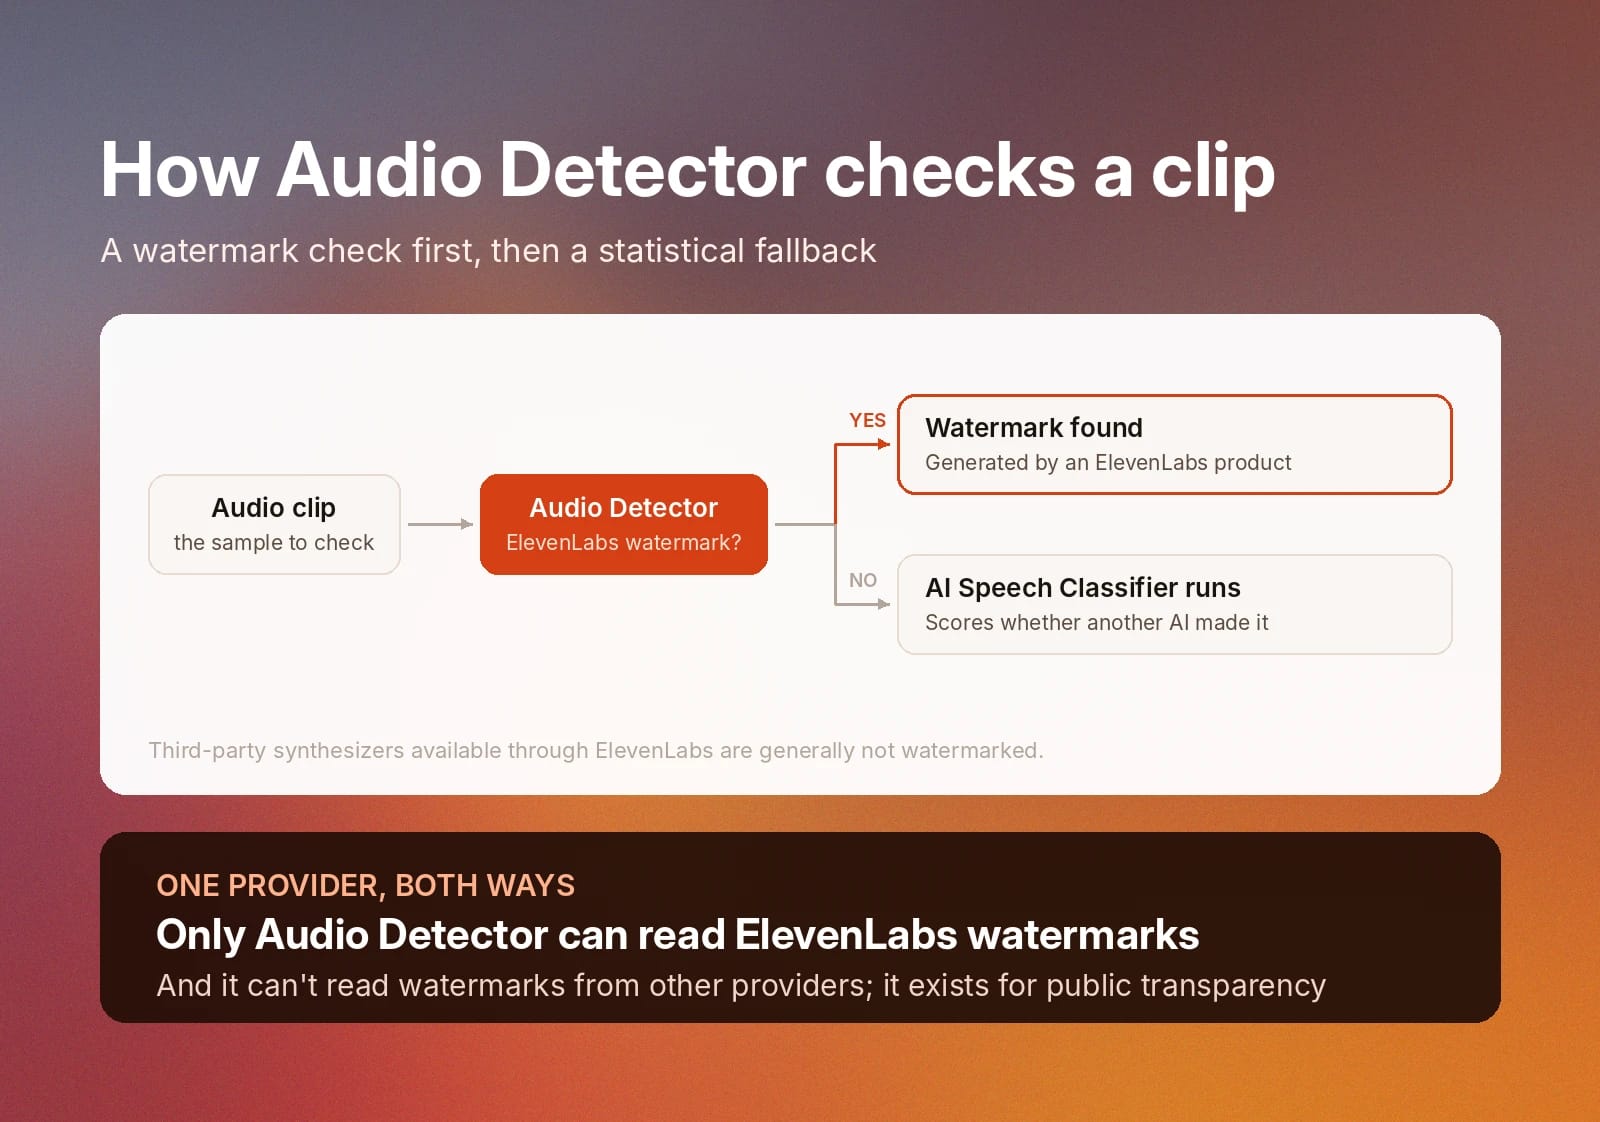
L’outil de filigrane d’ElevenLabs est Audio Detector. Il analyse des échantillons audio et vérifie si le contenu a été généré par un produit ElevenLabs. S’il ne trouve pas de filigrane, il exécute ensuite le AI Speech Classifier statistique pour déterminer si le contenu audio a été généré par IA à partir d’une autre source.
En raison du fonctionnement du filigrane, Audio Detector d’ElevenLabs ne détecte que les contenus audio générés par ElevenLabs. Il ne peut actuellement pas identifier les filigranes d’autres fournisseurs de voix IA.
À l’inverse, seul Audio Detector d’ElevenLabs peut détecter les filigranes ElevenLabs.
Notez également que les contenus générés par des synthétiseurs tiers disponibles via ElevenLabs ne sont généralement pas filigranés.
Autres options pour détecter les contenus audio générés par ElevenLabs
Le ElevenCreative AI Speech Classifier est disponible gratuitement et sans connexion. Il analyse la première minute d’un échantillon audio et fournit un score de confiance indiquant la probabilité que le contenu ait été généré par un modèle ElevenLabs.
Notez qu’il ne peut pas classifier de manière fiable les contenus audio d’Eleven v3. Il est particulièrement efficace pour classifier les contenus audio générés par les anciens modèles TTS d’ElevenLabs. Sa précision diminue également lors de l’analyse de contenus vocaux fortement compressés ou modifiés.
Comment détecter les voix synthétiques à grande échelle ?
Certaines équipes en entreprise doivent pouvoir détecter les deepfakes à grande échelle et en quasi-temps réel. Prenons l’exemple de l’équipe de service client d’une banque nationale. Ses représentants interagissent avec des milliers de clients chaque jour. Les membres de l’équipe doivent régulièrement partager et mettre à jour les données de comptes privés.
La direction de cette équipe accorde une grande importance à la rapidité avec laquelle elle peut identifier un appelant frauduleux et répondre aux clients légitimes. Elle a besoin d’un dispositif de détection vocale capable d’identifier en direct, pendant les appels clients, les contenus audio provenant de tous les principaux moteurs de génération vocale.
Constituer un dispositif complet de détection vocale
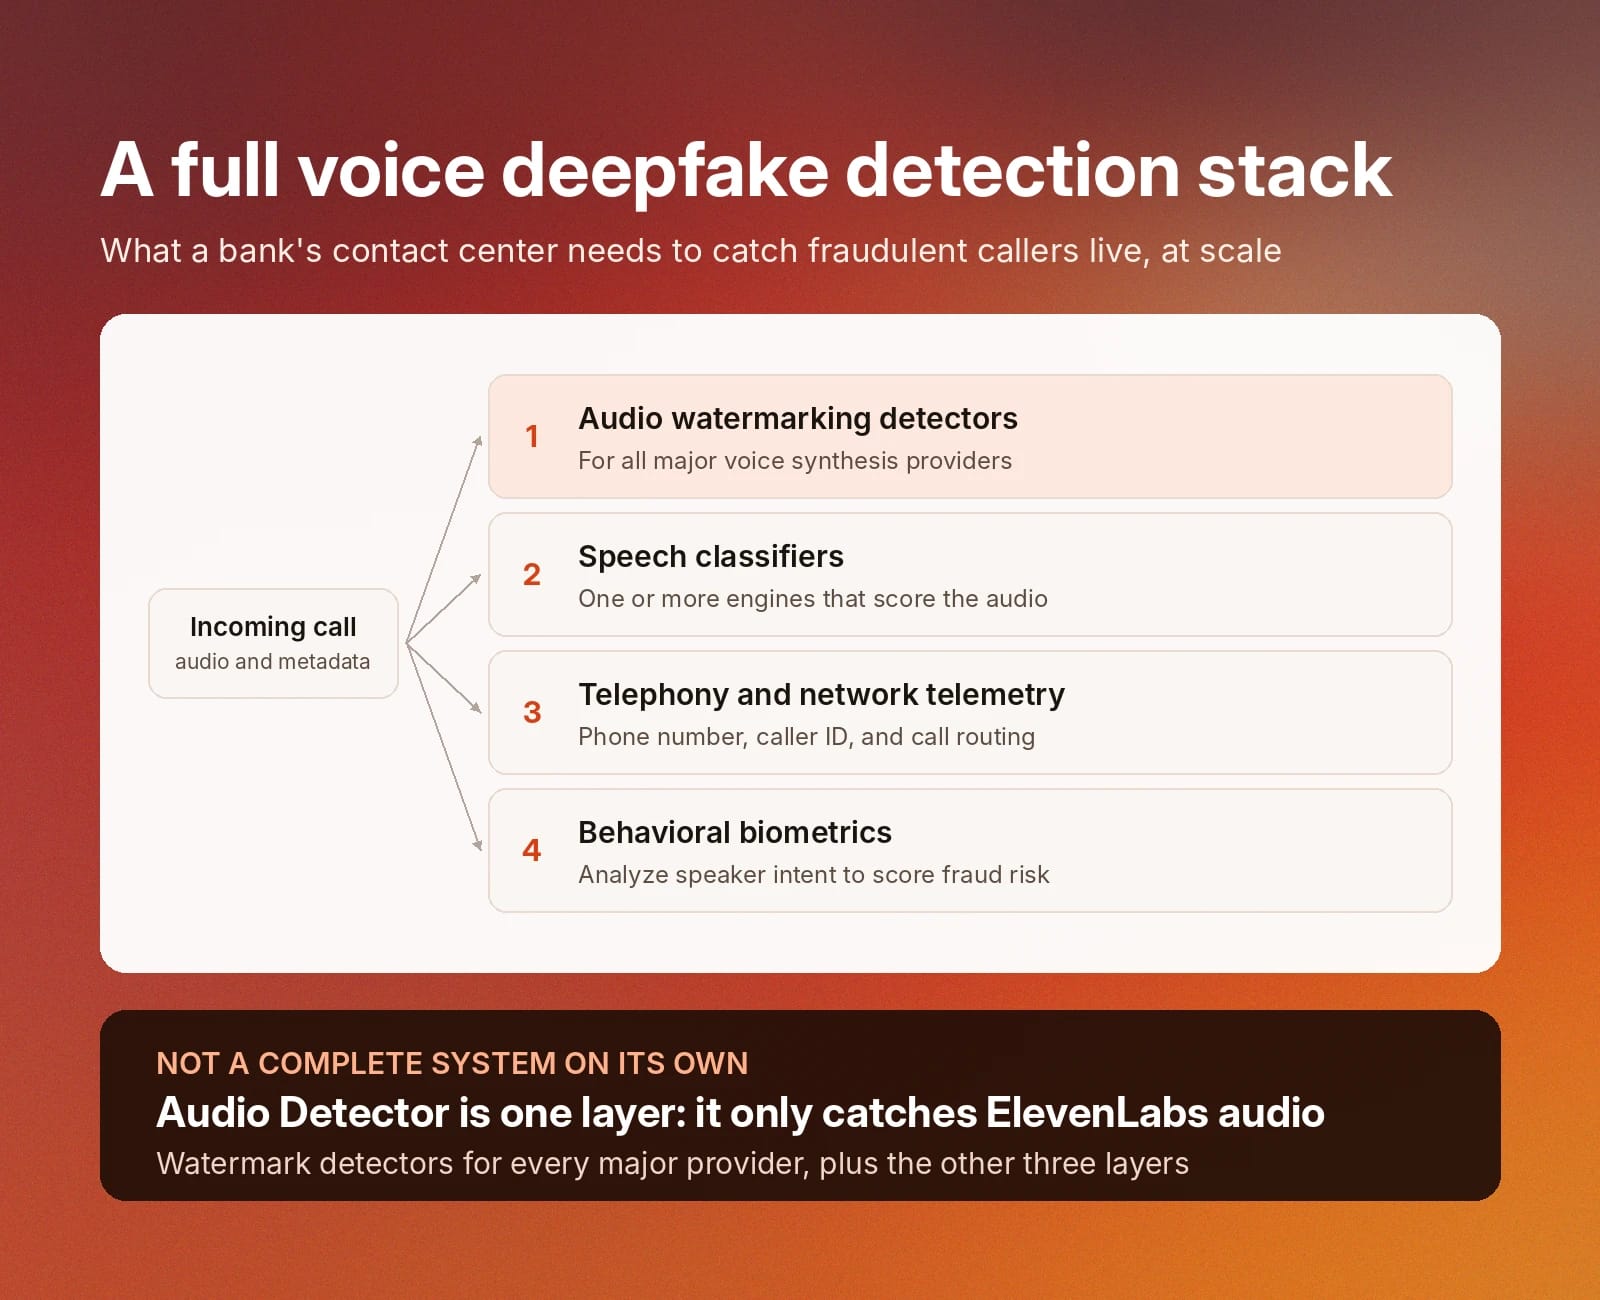
Audio Detector d’ElevenLabs joue ici un rôle important, mais rappelons qu’il ne détecte que les contenus audio portant un filigrane ElevenLabs. Il ne constitue pas à lui seul un système complet de détection vocale. Les organisations qui souhaitent disposer de capacités complètes de détection vocale doivent réunir plusieurs types d’outils :
- Détecteurs de filigranes audio : pour tous les principaux fournisseurs de synthèse vocale.
- Classificateurs de parole : un ou plusieurs moteurs de classification capables d’attribuer un score aux données audio.
- Télémétrie téléphonique et réseau : analyses des métadonnées d’appel, telles que le numéro de téléphone, l’identifiant de l’appelant et le routage des appels.
- Biométrie comportementale : logiciel analysant l’intention du locuteur afin d’évaluer le risque de fraude.
Essayez dès aujourd’hui la détection des deepfakes d’ElevenLabs
ElevenLabs s’engage à contribuer positivement à la vie publique, à la fois grâce à des services de génération vocale utiles et en fournissant au public les outils nécessaires pour identifier les deepfakes et d’autres usages malveillants de l’audio généré par IA.
Vous avez un extrait audio à tester pour détecter d’éventuels deepfakes ? Inscrivez-vous pour essayer ElevenLabs Audio Detector ou utilisez AI Speech Classifier dès aujourd’hui.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.