Fonctionnement de la technologie Text to Speech : du texte à une voix naturelle
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
La technologie Text to Speech (TTS) transforme les mots écrits en audio parlé. Le système détermine d’abord ce que dit le texte et comment il doit sonner, puis un modèle IA génère l’audio.
Un moteur TTS commence par normaliser le texte saisi et le convertit en jetons mathématiques et en représentations vectorielles exploitables par un système informatique. Le modèle transforme ensuite ces constructions mathématiques en représentations numériques du son, puis en sortie audio.
Dans cet article, nous verrons comment fonctionnent les différents outils de Text to Speech et comment la dernière génération de synthèse vocale neuronale par IA générative produit une parole plus naturelle que jamais.
Résumé
- Les systèmes Text to Speech convertissent les mots écrits en audio en deux étapes. Ils transforment le texte en jetons, c’est-à-dire en représentations mathématiques du langage, puis ces jetons en représentation acoustique restituée sous forme de son.
- Les moteurs TTS neuronaux récents utilisent des modèles IA pour produire une parole naturelle. Les équipes utilisent ces outils pour créer du contenu, réaliser du sous-titrage et alimenter des agents de service client.
- Les dictionnaires de prononciation et le balisage phonétique permettent d’affiner la sortie TTS afin d’obtenir une parole aussi naturelle que possible et de prononcer correctement les termes techniques et les noms.
- Une API Text to Speech permet de connecter vos applications métier à une génération vocale de haute qualité.
Qu’est-ce que le TTS ? Fonctionnement de la technologie Text to Speech
Le Text to Speech analyse le texte écrit, détermine comment chaque mot doit sonner, puis utilise un modèle neuronal et un vocodeur pour générer l’audio parlé.
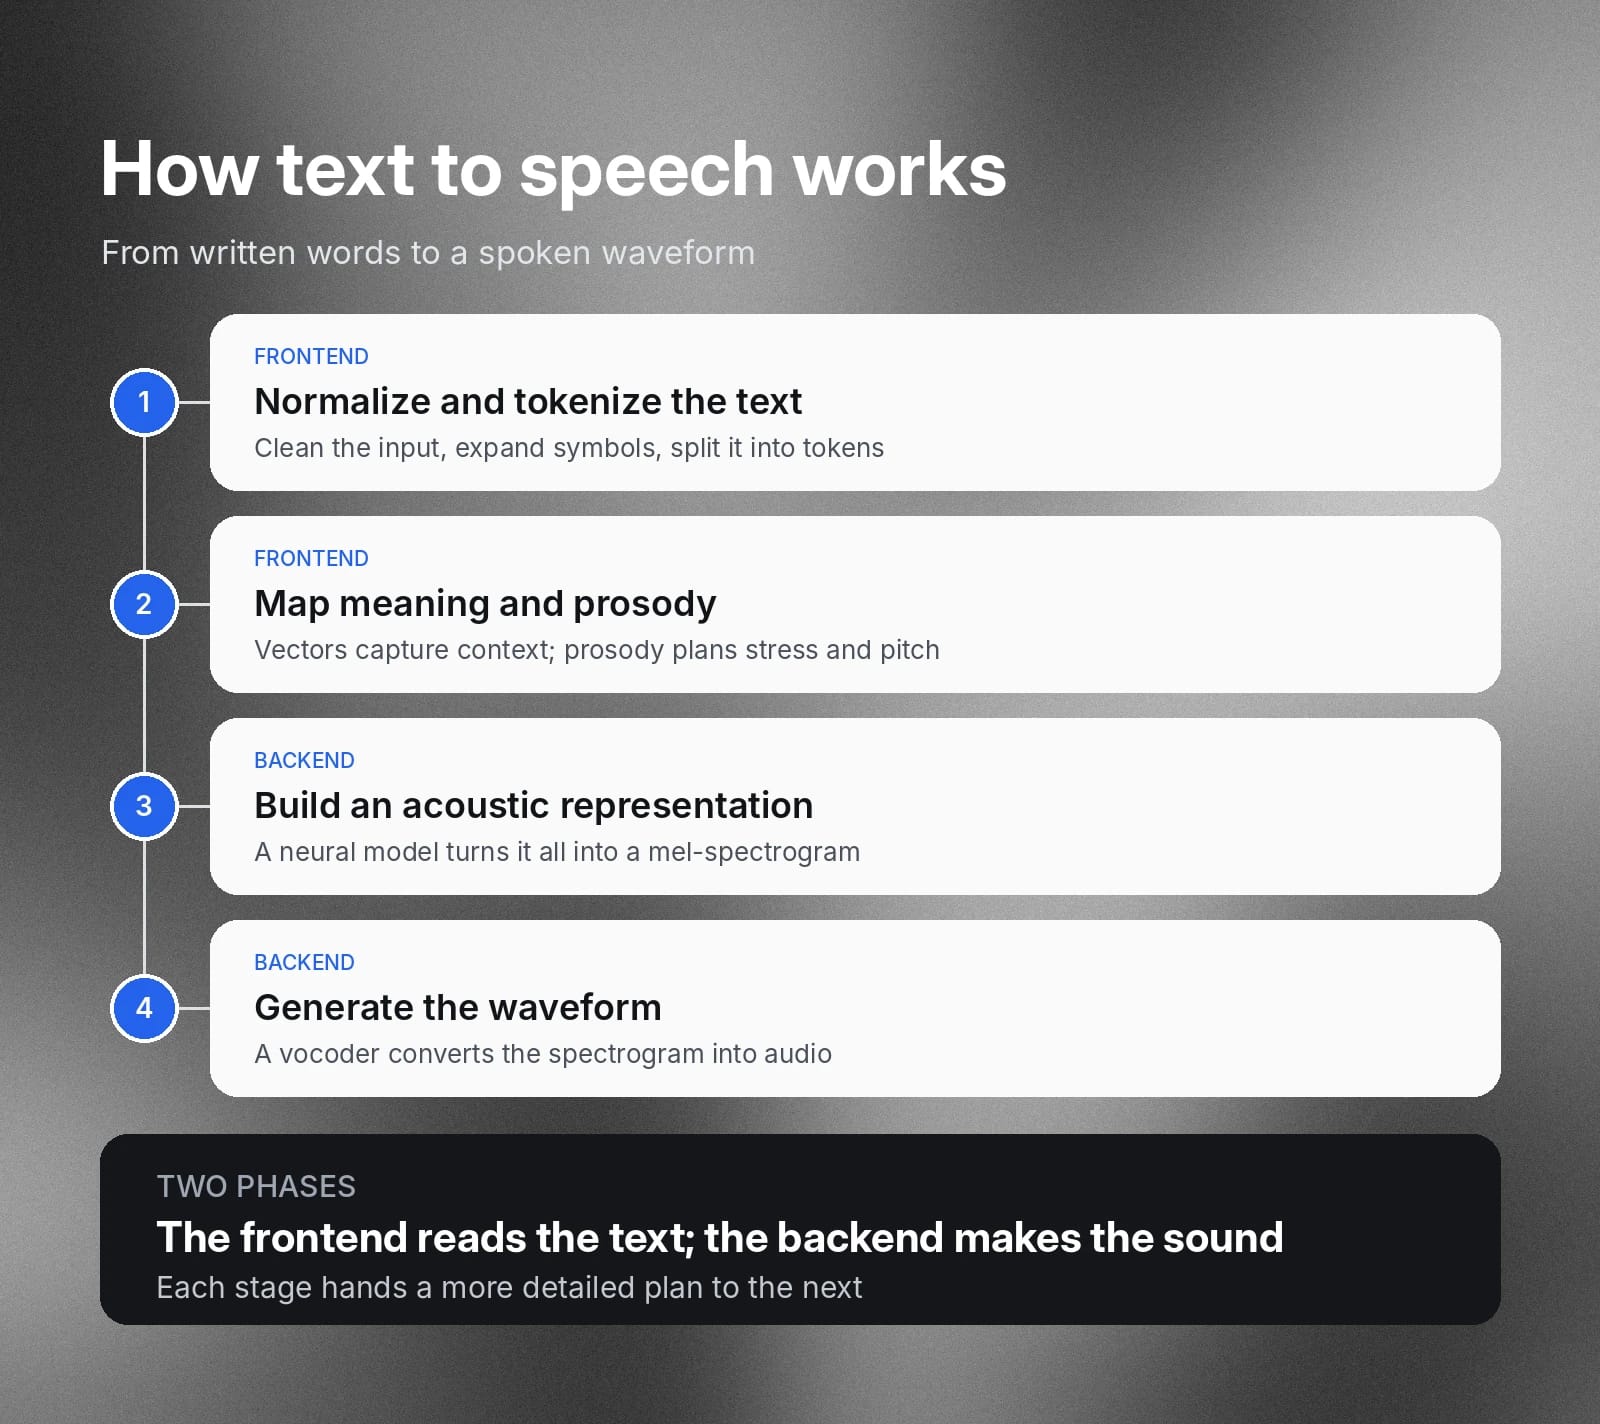
Le TTS se décompose généralement en deux phases :
- Frontend : le système convertit le texte dans une forme mathématique exploitable par le moteur TTS.
- Backend : le système traite le résultat de la première phase et le transforme en formes d’onde modélisant la parole.
Examinons plus en détail les composants du TTS.
Normalisation du texte et analyse linguistique
La première étape d’un processus TTS est le traitement automatique du langage naturel (TALN) : nettoyage, segmentation et désambiguïsation du texte brut. Le texte est décomposé en jetons, des unités individuelles de langage écrit qu’un moteur TTS peut manipuler. Un jeton peut être un mot entier, une unité « sous-mot » ou un signe de ponctuation.
Le texte contient souvent des éléments autres que des mots entiers, comme des abréviations et des nombres. Un moteur TTS doit aussi déterminer comment les prononcer. Par exemple, il lit « $11 » et le convertit en sons correspondant à « onze dollars ».
Sens sémantique et prosodie
La prosodie désigne la hauteur et le rythme de la parole, qui rendent le TTS naturel. Lors du traitement du texte, le moteur génère aussi une couche d’informations prosodiques qui associe les variations d’accentuation et d’intonation au texte.
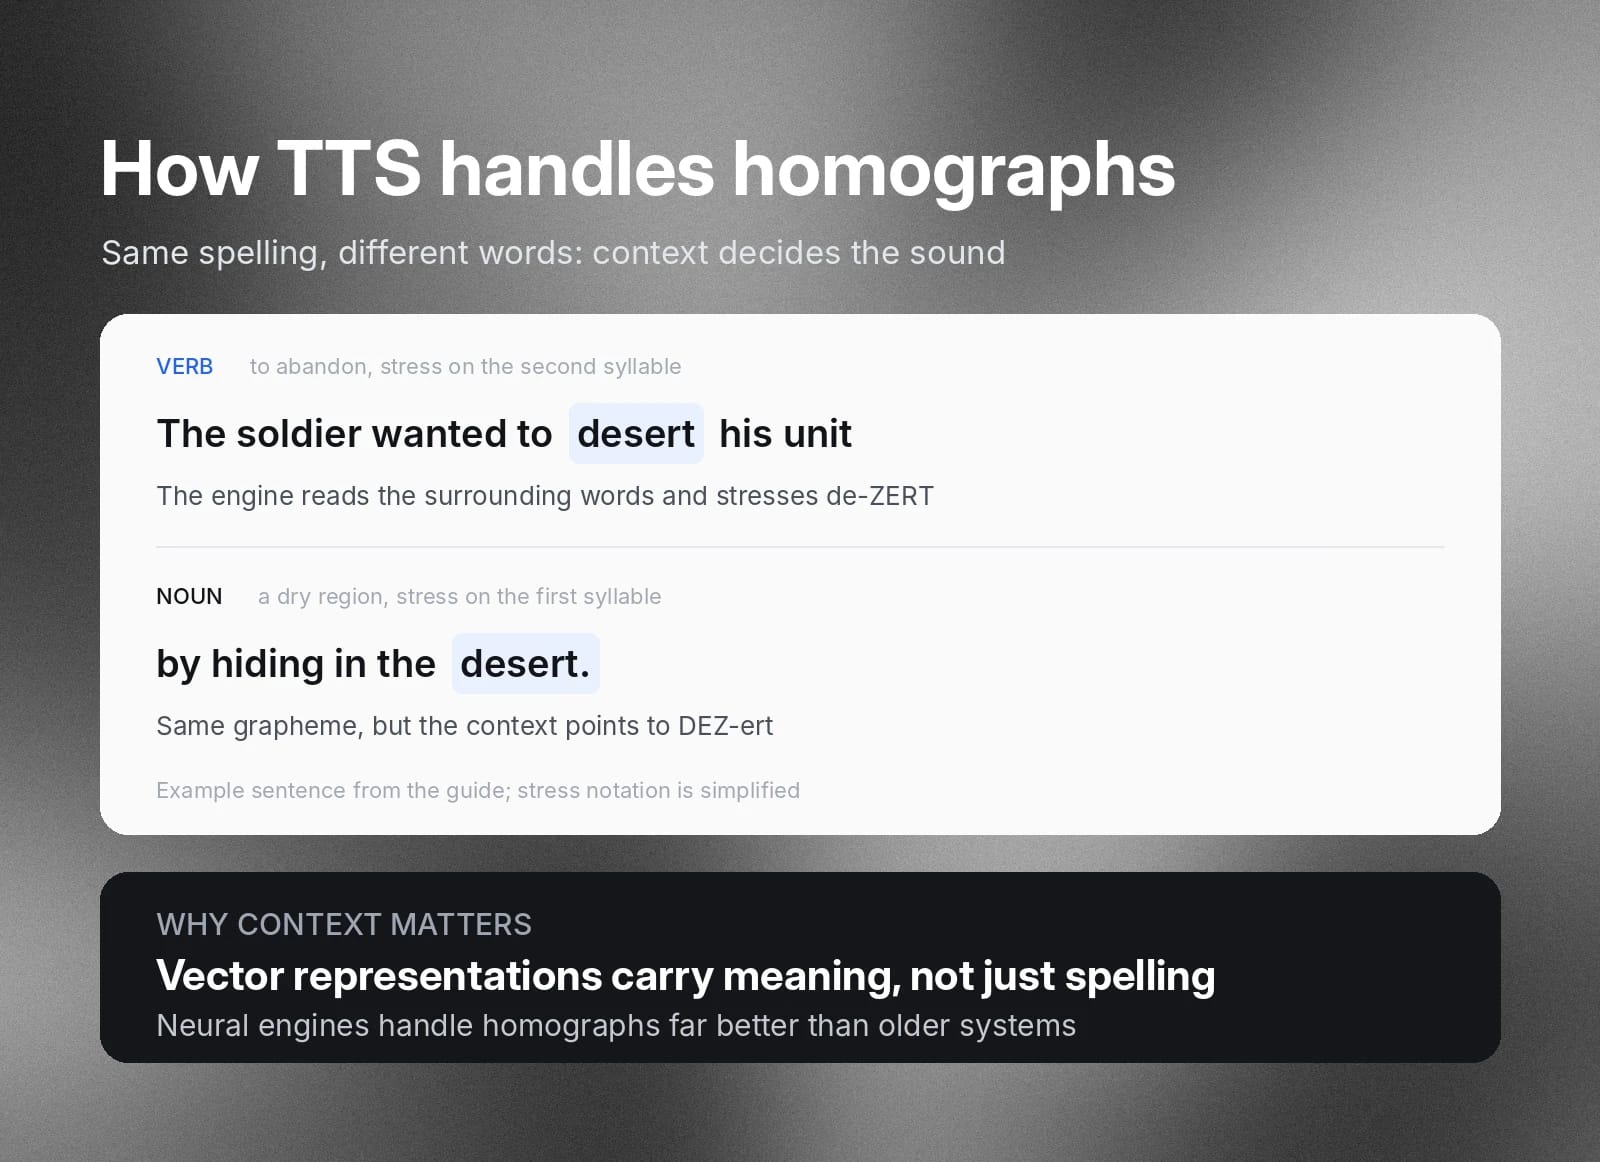
Un moteur TTS doit également adapter sa prononciation au contexte. Il rassemble ces informations sous forme de représentations vectorielles, des données numériques qui modélisent la similarité sémantique entre les mots et les phrases. Imaginez un graphique X-Y où une ligne passe par différents points, mais dans bien plus de deux dimensions.
Les homographes en sont un exemple précis. Ces mots ayant la même orthographe doivent parfois être prononcés différemment. Le moteur TTS doit identifier l’intonation et l’accentuation à appliquer à chacun. Par exemple, comment prononcer le graphème « desert » dans la phrase « The soldier wanted to desert his unit by hiding in the desert. »
Regardez Eleven v4 donner vie à cet exemple.
Modélisation acoustique et synthèse de formes d’onde vocales
Le moteur TTS prend les informations segmentées et les vecteurs contextuels, désormais tous sous forme de données numériques, et les convertit en représentation acoustique, telle qu’un spectrogramme de Mel. Celle-ci comprend différentes fréquences, niveaux d’énergie et sons que le cerveau interprète comme des émotions. De nombreux systèmes ont assuré cette fonction par le passé, mais les modèles neuronaux comptent aujourd’hui parmi les plus efficaces.
La dernière étape utilise un vocodeur pour convertir ces spectrogrammes en audio que les auditeurs reconnaissent comme de la parole. Ce processus s’appelle la génération de formes d’onde.
Le TTS en pratique : exemple détaillé
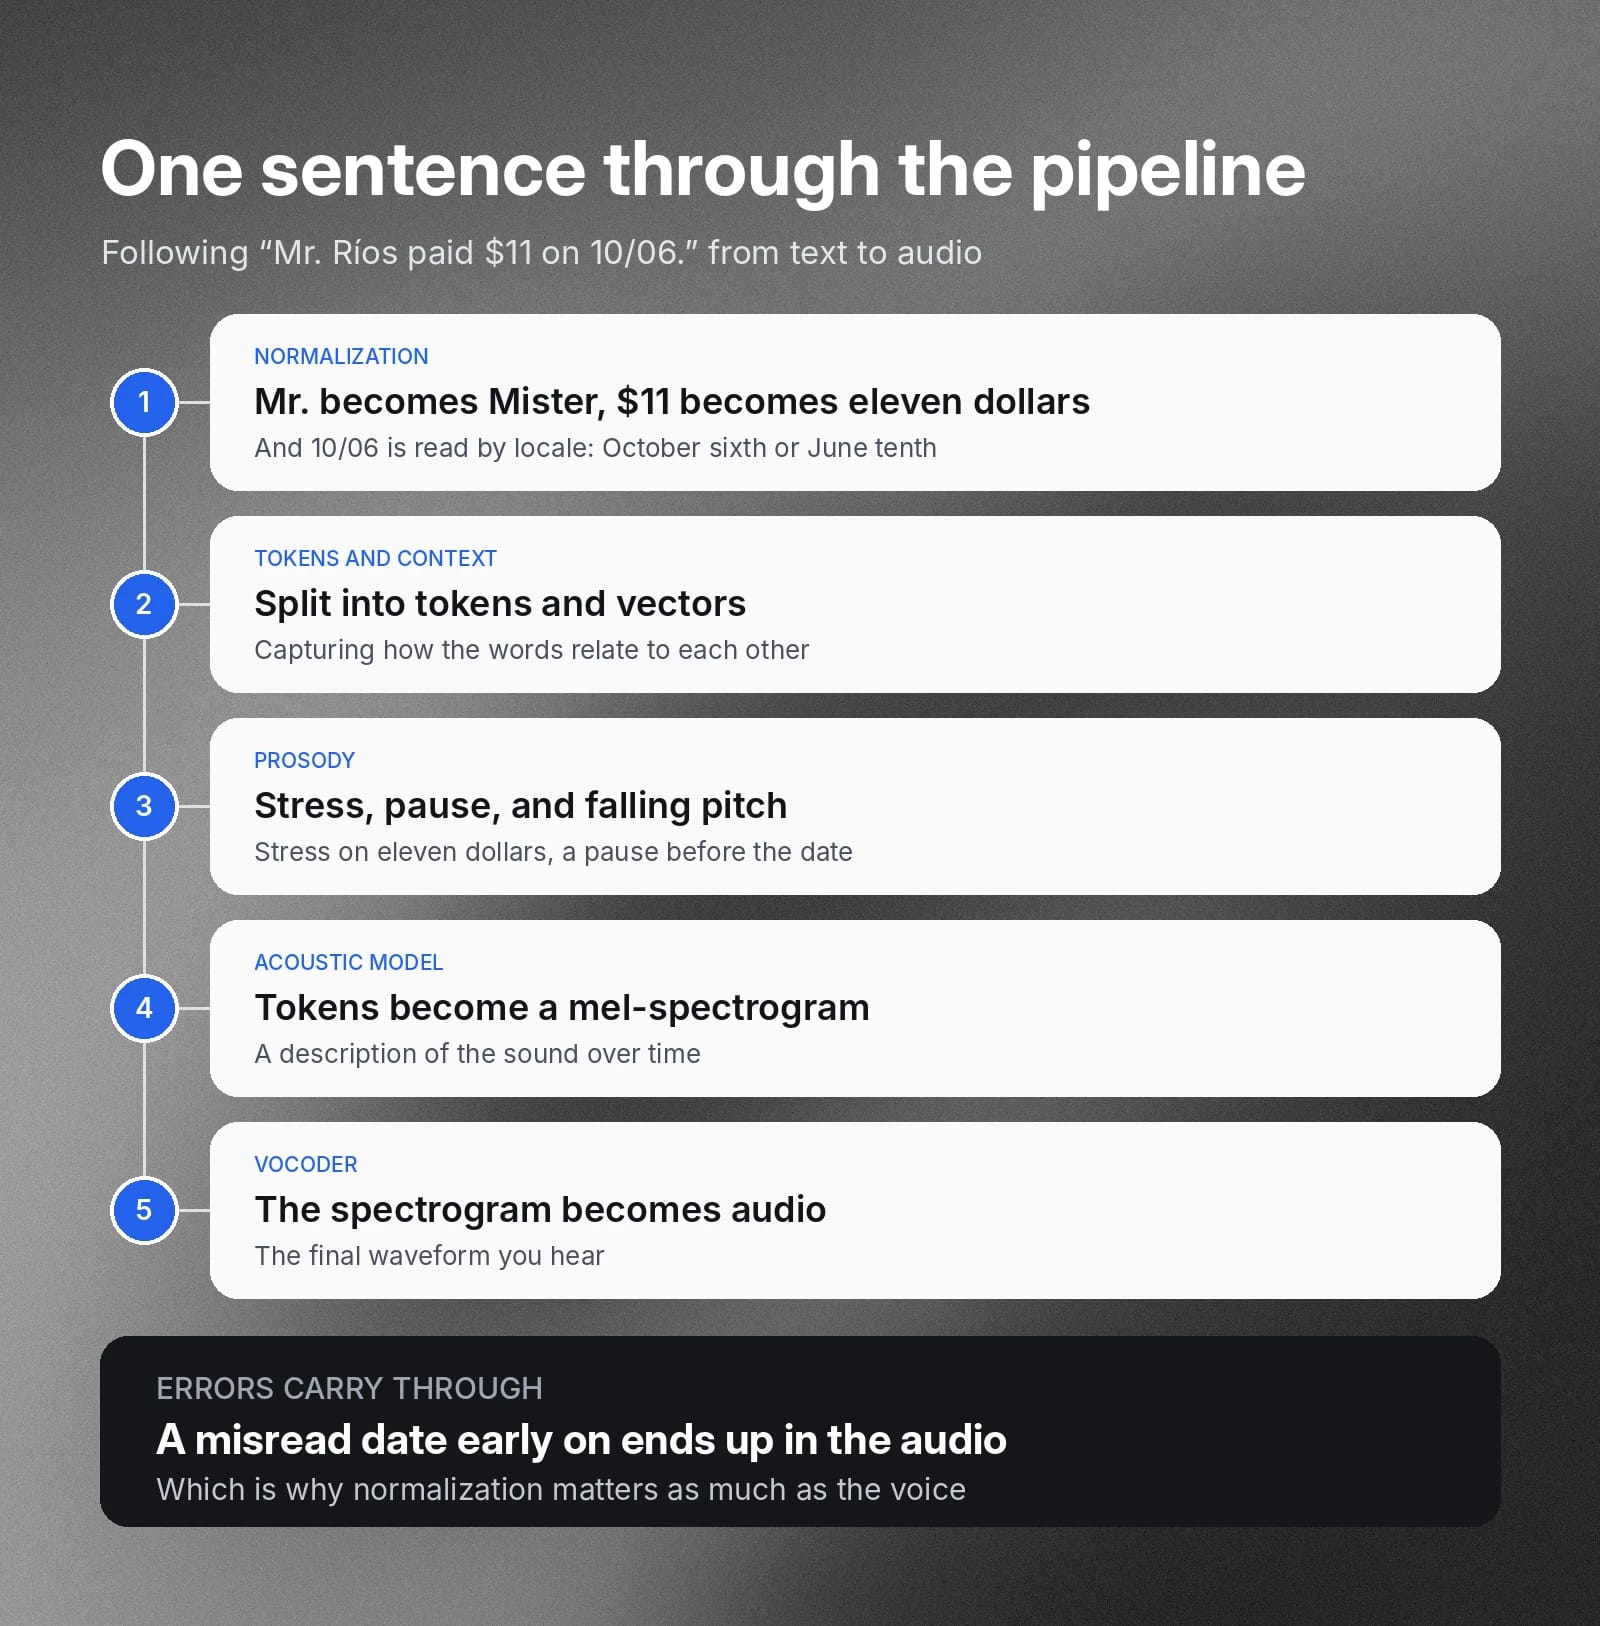
La façon la plus simple de comprendre comment les étapes du TTS s’articulent consiste à suivre une seule phrase dans le pipeline.
Prenez le texte « M. Ríos a payé 11 $ le 10/06. »
- Normalisation : le moteur développe « M. » en « Monsieur », lit « 11 $ » comme « onze dollars » et détermine si « 10/06 » signifie « le 10 juin » ou « le 6 octobre », selon les paramètres régionaux et le contexte.
- Segmentation et contexte : le texte nettoyé est divisé en jetons et converti en vecteurs qui capturent les relations entre les mots.
- Prosodie : le moteur accentue « onze dollars », ajoute une courte pause avant la date et fait baisser la hauteur de voix en fin de phrase.
- Modèle acoustique : le modèle neuronal transforme les jetons et le plan prosodique en spectrogramme de Mel décrivant le son au fil du temps.
- Vocodeur : le vocodeur convertit le spectrogramme en forme d’onde audio finale que vous entendez.
Chaque étape transmet un plan plus détaillé à la suivante. C’est pourquoi les erreurs commises au début du pipeline, comme une date mal lue, se répercutent dans l’audio final.
Pourquoi le Text to Speech neuronal sonne-t-il plus humain ?
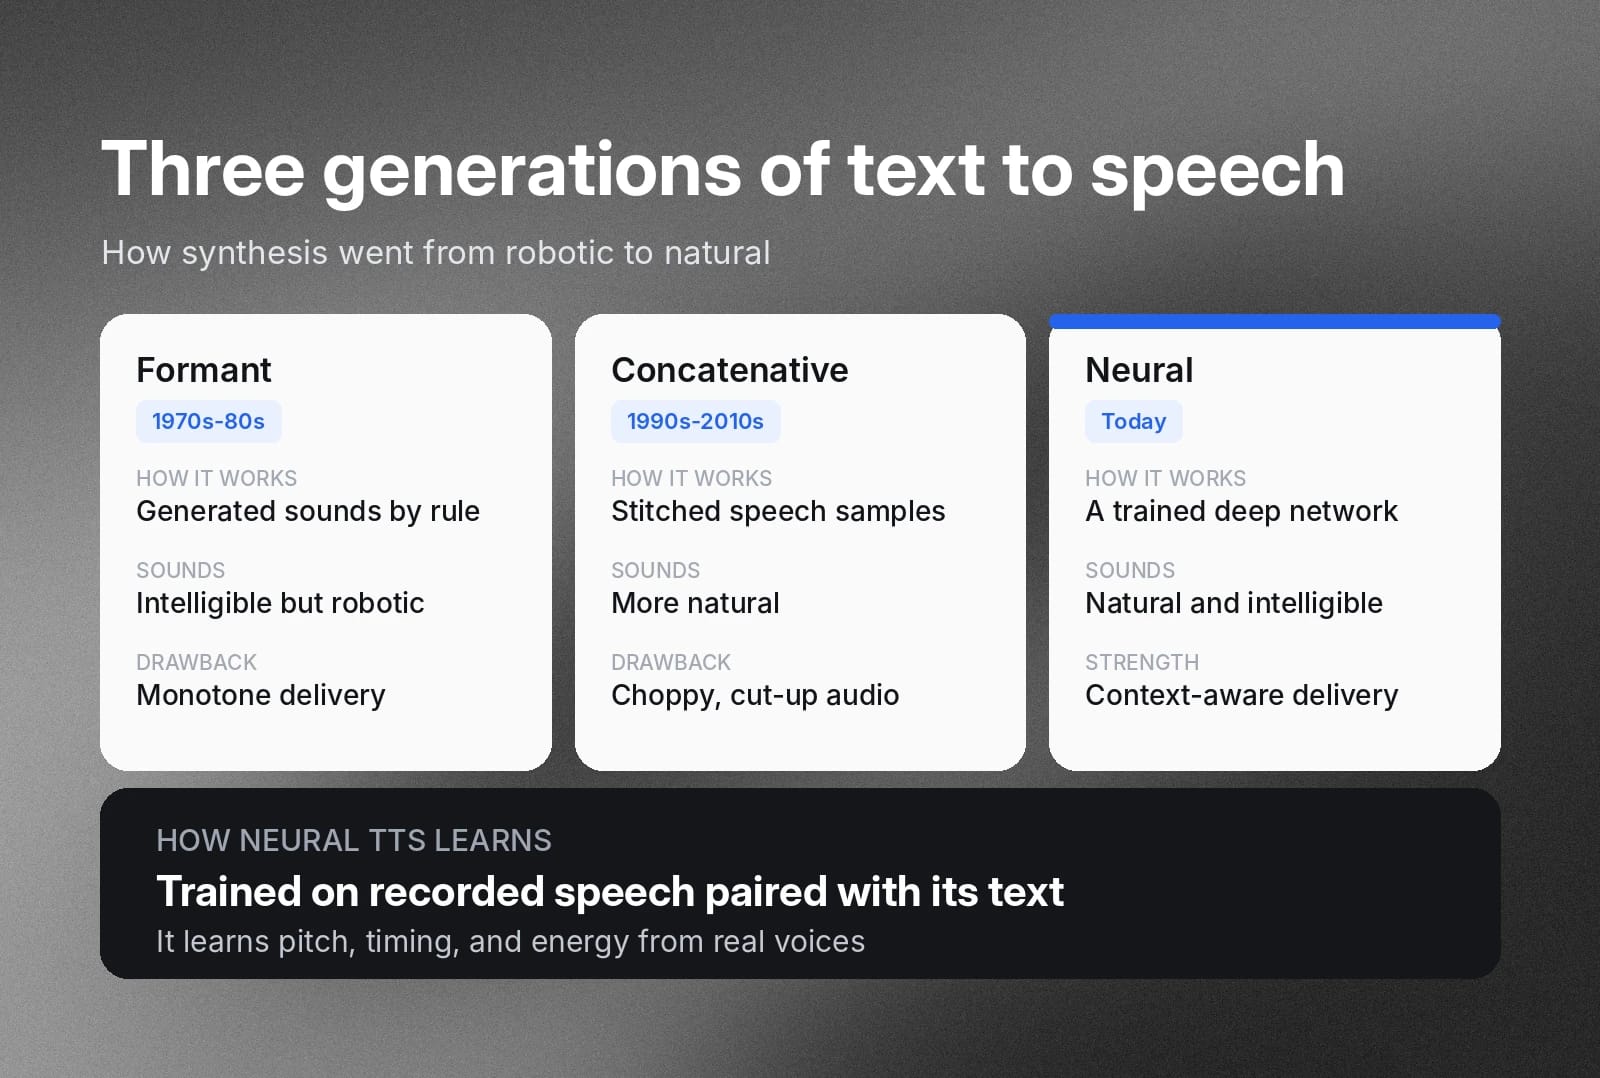
La synthèse vocale neuronale excelle dans la production d’une parole naturelle et intelligible, les deux critères utilisés par les ingénieurs pour évaluer les moteurs TTS. Le TTS neuronal entraîne un réseau neuronal profond (DNN) à produire de la parole à partir d’un texte. Le DNN est entraîné sur de grands volumes de parole enregistrée associée aux textes correspondants.
Les moteurs de synthèse vocale neuronale ne sont que la dernière évolution du TTS professionnel. Ils ont été précédés par deux générations de technologies de synthèse commerciale.
La synthèse par formants a dominé dans les années 1970 et 1980. Au lieu d’échantillonner la parole humaine pour produire une sortie en temps réel, elle générait des sons synthétiques modélisant la parole. Elle était intelligible, mais monotone et robotique.
La synthèse concaténative a dominé des années 1990 aux années 2010 et produisait une parole plus naturelle que les anciens systèmes à formants. Au lieu de générer des sons à partir de règles mathématiques, elle assemblait de petits échantillons de parole humaine. Ces systèmes utilisaient des tables de recherche linguistiques pour associer le texte normalisé aux sons, puis restituaient de petites unités audio concaténées issues d’une vaste bibliothèque, ou « corpus ». Bien que plus naturelle que la parole générée par un moteur à formants, la concaténation peut encore produire une parole hachée.
Quelle différence entre un générateur de voix IA et le Text to Speech ?
« Générateur de voix IA » est un terme souvent employé en marketing pour désigner un large éventail de technologies vocales, dont le Text to Speech. Le Text to Speech désigne précisément les systèmes qui prennent un texte écrit en entrée, modélisent sa sémantique et sa prosodie, puis produisent des formes d’onde audio.
Les générateurs de voix IA forment un écosystème complet de technologies vocales interdépendantes, comprenant le TTS et d’autres systèmes génératifs pour la conception de voix, le clonage de voix et le transfert de style vocal. Bien qu’il soit souvent employé comme synonyme de Text to Speech en marketing, le terme « générateur de voix IA » désigne plus justement la catégorie plus vaste d’outils vocaux génératifs dont fait partie le TTS.
Utiliser le Text to Speech pour le contenu, l’accessibilité et l’assistance
Les modèles Text to Speech occupent désormais une place centrale dans les workflows personnels comme professionnels à travers le monde.
Voici quelques-uns des principaux cas d’usage du Text to Speech.
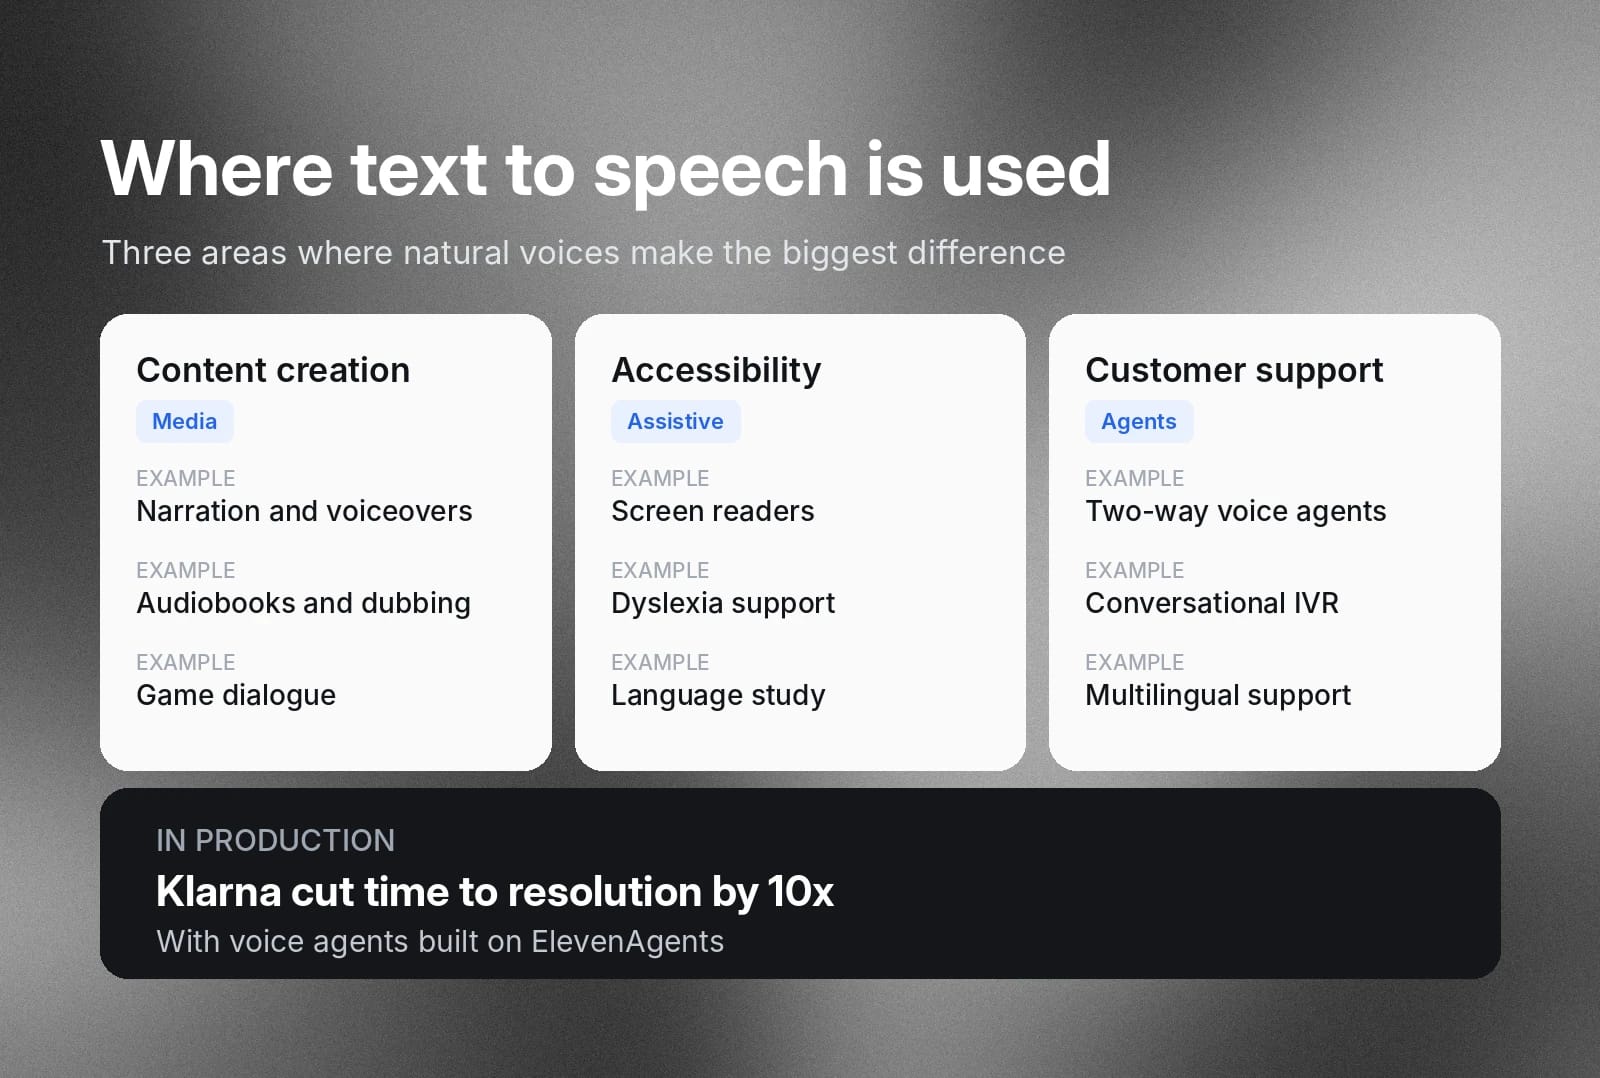
Création de contenu
Les outils Text to Speech peuvent réduire les coûts de production multimédia à grande échelle ainsi que le temps passé en studio pour la narration et les retouches de post-production.
Exemples de cas d’usage :
- Narration
- Voix off
- Doublage
- Production de livres audio
- Dialogues de jeux vidéo
Par exemple, TAP a utilisé ElevenLabs TTS pour développer ses contenus éducatifs dans des écoles partout en Inde.
Accessibilité
Le Text to Speech est l’une des technologies d’assistance les plus utilisées, car il permet d’accéder aux contenus écrits par l’écoute. Une parole naturelle améliore l’engagement des auditeurs et réduit la fatigue mentale lors de l’écoute de contenus longs.
Les usages courants du TTS pour l’accessibilité incluent :
- Lecteurs d’écran : lisent des pages entières à voix haute grâce à un lecteur d’écran et au TTS.
- Dyslexie et soutien à la lecture : réduisent l’effort de lecture en accompagnant les sessions de lecture d’une voix TTS.
- Malvoyance et cécité : les lecteurs d’écran énoncent les éléments de l’interface et le contenu des pages afin de permettre la navigation dans les logiciels et sur les sites web sans voir l’écran.
- Différences cognitives et attentionnelles : écouter le texte peut réduire l’effort nécessaire pour lire de longs documents et faciliter la concentration.
- Apprentissage et étude des langues : les étudiants entendent la prononciation correcte de nouveaux mots et peuvent écouter des manuels pendant leurs trajets ou leurs études.
Les lecteurs d’écran sont des outils d’accessibilité complets qui décrivent tout ce qui apparaît à l’écran, y compris les boutons et les menus. Les outils de lecture à voix haute se concentrent sur le contenu lui-même, généralement avec une mise en surbrillance qui suit la lecture. Ils bénéficient de voix plus naturelles, car les utilisateurs les emploient sur de longues durées.
Service client
La synthèse vocale neuronale peut offrir une expérience client de qualité lorsqu’elle est associée à un LLM capable d’interactions agentiques. Des plateformes comme ElevenAgents associent la couche vocale à la reconnaissance vocale, à un LLM et à des outils connectés qui permettent à un agent de comprendre les besoins d’un appelant et de répondre avec une voix naturelle.
Les agents conçus avec ElevenAgents fonctionnent par téléphone, sur le web, sur WhatsApp, par email et par texto, permettant aux clients de poursuivre une conversation entre les canaux sans avoir à se répéter. Exemples de cas d’usage :
- Agents vocaux IA bidirectionnels : gèrent des conversations en direct en répondant aux questions à partir d’une base de connaissances ou en orientant les clients vers des parcours précis, comme les remboursements ou les achats.
- Systèmes de réponse vocale interactive (SVI) : remplacent les arborescences de menus obsolètes du type « Appuyez sur 3 pour les ventes » par des conversations dans lesquelles vos clients peuvent s’exprimer naturellement.
- Assistance multilingue : servez vos clients dans leur propre langue depuis une configuration d’agent unique.
Klarna, par exemple, a réduit son délai de résolution par 10 avec ElevenAgents
Comment les moteurs Text to Speech contrôlent-ils la prononciation ?
Les moteurs modernes de synthèse vocale neuronale peuvent générer une parole très naturelle, mais il existera toujours des cas limites dans un domaine aussi vaste, profond et dynamique que le langage humain. Vous souhaiterez peut-être conserver des accents, de l’argot ou des prononciations régionales dans votre parole générée. Vous produisez peut-être de l’audio dans un secteur où les termes techniques ont des prononciations spécifiques. Vous souhaitez peut-être simplement que votre nom de marque soit prononcé d’une manière très précise et constante.
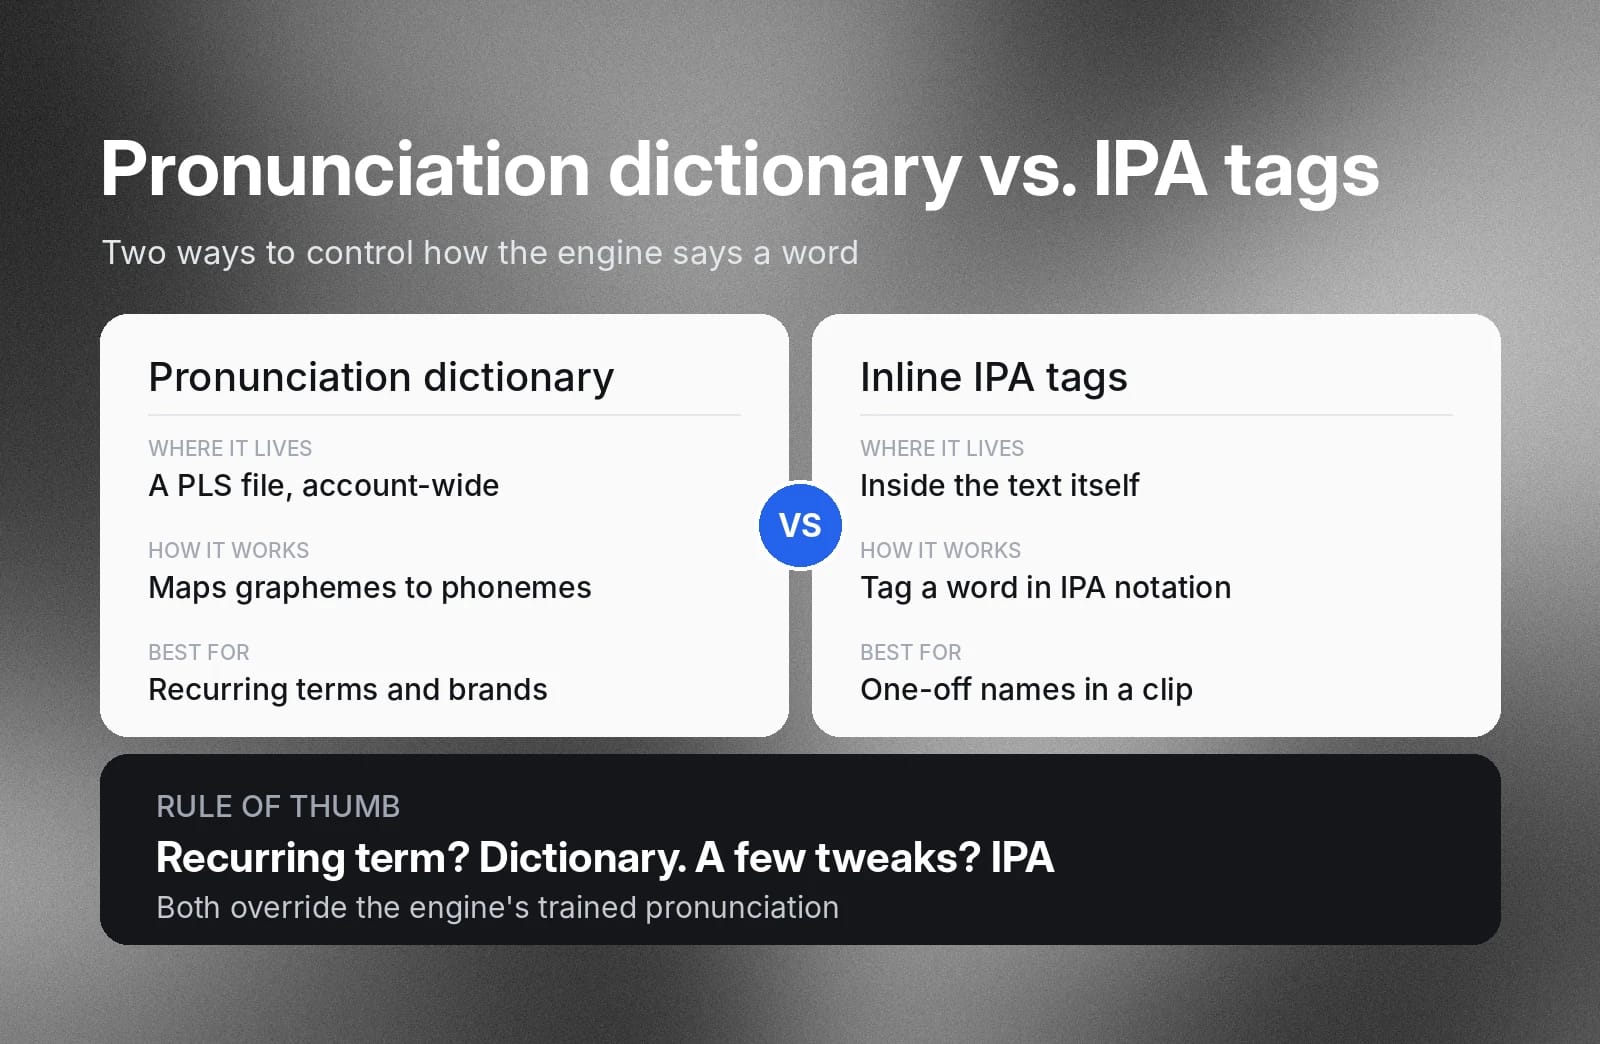
Dictionnaires de prononciation et substitutions de phonèmes
ElevenAPI d’ElevenLabs inclut un dictionnaire de prononciation qui vous permet de personnaliser la façon dont le moteur parle. Vous créez un dictionnaire dans un fichier Pronunciation Lexicon Specification (PLS) conforme à la norme W3C, qui associe les graphèmes, c’est-à-dire les symboles du texte, aux phonèmes (des mots parlés décomposés en sons). Lorsqu’il rencontre l’un des graphèmes répertoriés, le moteur TTS remplace sa prononciation apprise par celle indiquée dans le dictionnaire.
Découvrez comment créer un dictionnaire de prononciation dans ElevenAPI dans la documentation Utiliser les dictionnaires de prononciation.
API phonétique internationale native et prompting phonétique
Certains modèles TTS peuvent aussi reconnaître des balises de prononciation intégrées directement au texte saisi. Ainsi, au lieu de créer un dictionnaire pour l’ensemble du compte, vous pouvez baliser les mots dans le texte à l’aide de la notation API standard si vous souhaitez seulement modifier la prononciation dans un ou deux extraits audio. Par exemple, lorsque vous enregistrez un livre audio et souhaitez qu’un personnage fictif soit prononcé d’une manière précise.
Défis courants du Text to Speech et comment les résoudre
Même les modèles TTS les plus performants peuvent rencontrer des difficultés avec les nuances du langage humain. Deux des problèmes les plus fréquents sont la mauvaise prononciation de mots nouveaux et une diction monotone. Voici comment les résoudre.
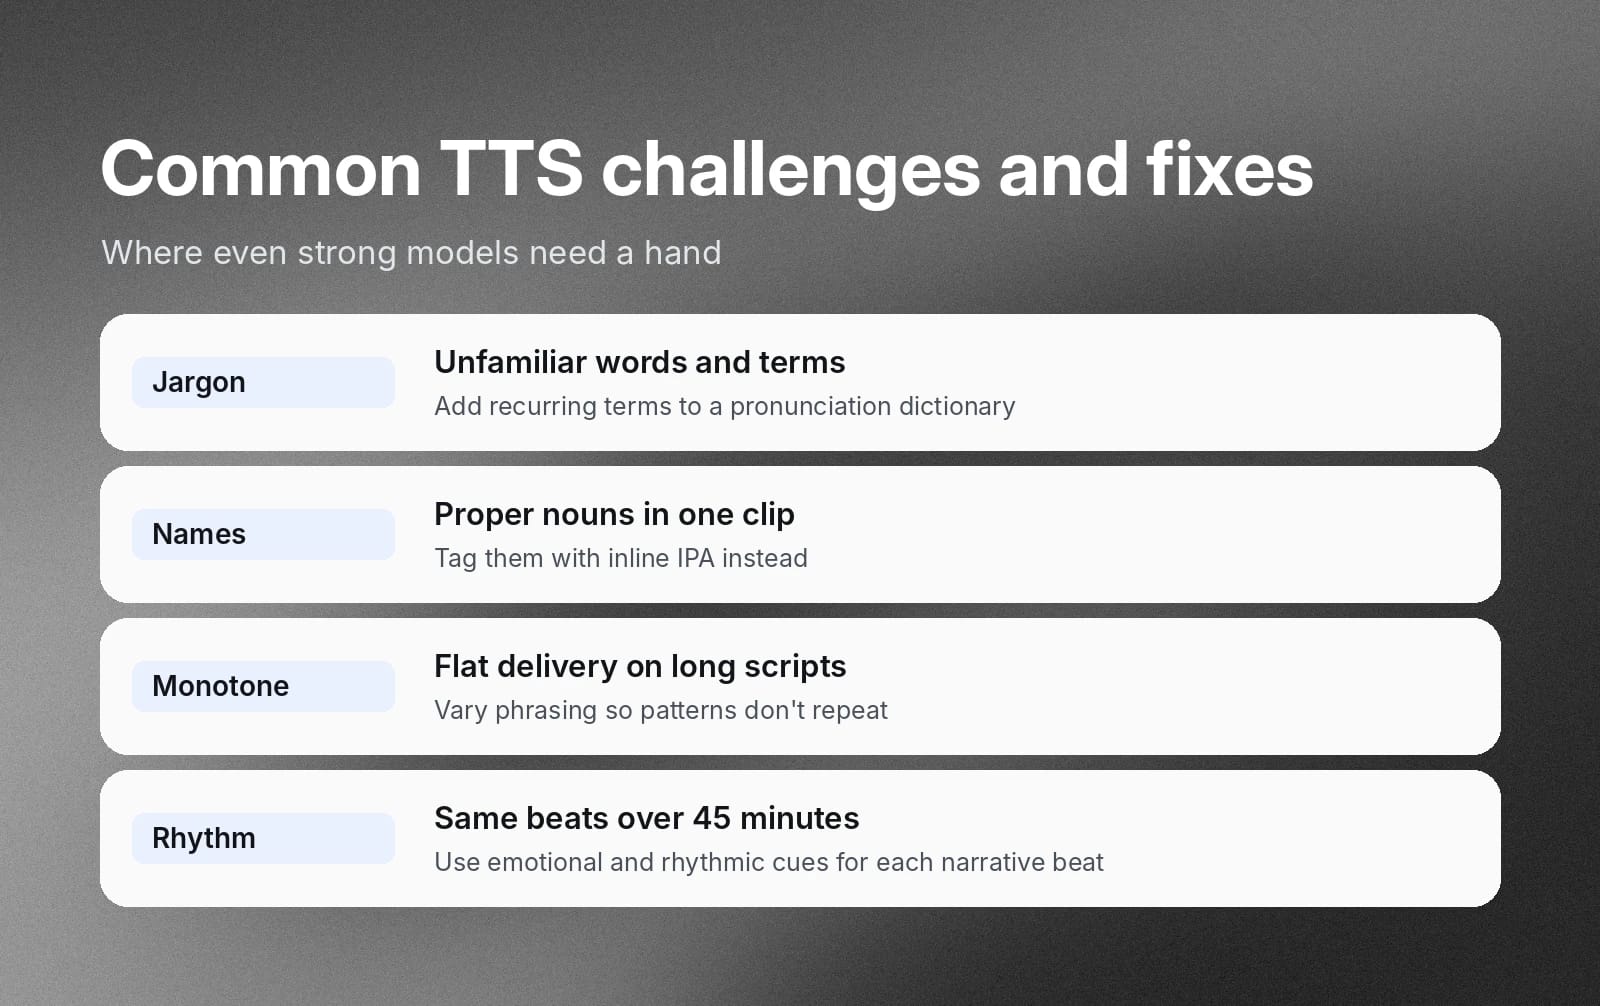
Mauvaise prononciation de mots inconnus, de jargon et de noms propres
Les moteurs TTS utilisent des algorithmes pour prédire la prononciation d’un texte normalisé selon la correspondance entre graphèmes et phonèmes dans leurs données d’entraînement. Ils font leur meilleure estimation à partir du texte et du contexte qu’ils ont ingérés. Mais, comme nous l’avons vu dans la section précédente, de nombreux cas limites exigeront une prononciation très spécifique.
Les dictionnaires de prononciation ou les balises API ciblées sont vos meilleurs outils pour ces cas limites. Si un terme récurrent doit être prononcé de manière cohérente, le dictionnaire est la meilleure solution. Pour des ajustements ciblés sur quelques termes, utilisez des balises API phonétiques.
Diction monotone
Ces problèmes sont plus fréquents lors du traitement de scripts longs, lorsque les mêmes mots ou phrases sont répétés. La parole synthétisée par un moteur peut être excellente dans des extraits de 10 secondes, mais entendre les mêmes prononciations mécaniques et les mêmes rythmes pendant un cours de 45 minutes fatigue rapidement l’auditeur.
Variez les formulations de vos scripts et utilisez judicieusement les balises phonétiques pour modifier ponctuellement les prononciations. Utilisez des indices émotionnels et rythmiques afin de rendre la sortie vocale plus dynamique, avec des variations de hauteur selon les temps forts du récit.
Concevez des expériences vocales naturelles avec une API Text to Speech
Les outils web légers conviennent parfaitement à la production de petits extraits audio, mais répondent moins bien aux besoins métier plus importants. Pour gérer des milliers d’interactions client par minute ou générer du contenu audio long et de haute qualité, vous aurez besoin d’outils TTS plus robustes.
Une API Text to Speech comme ElevenAPI permet de connecter directement vos logiciels à des modèles de synthèse vocale neuronale. Vous pouvez utiliser des requêtes REST ou des WebSockets permanents pour générer de l’audio à la demande, à grande échelle, pour des agents ou d’autres usages.
Fonctionnement d’une requête API Text to Speech
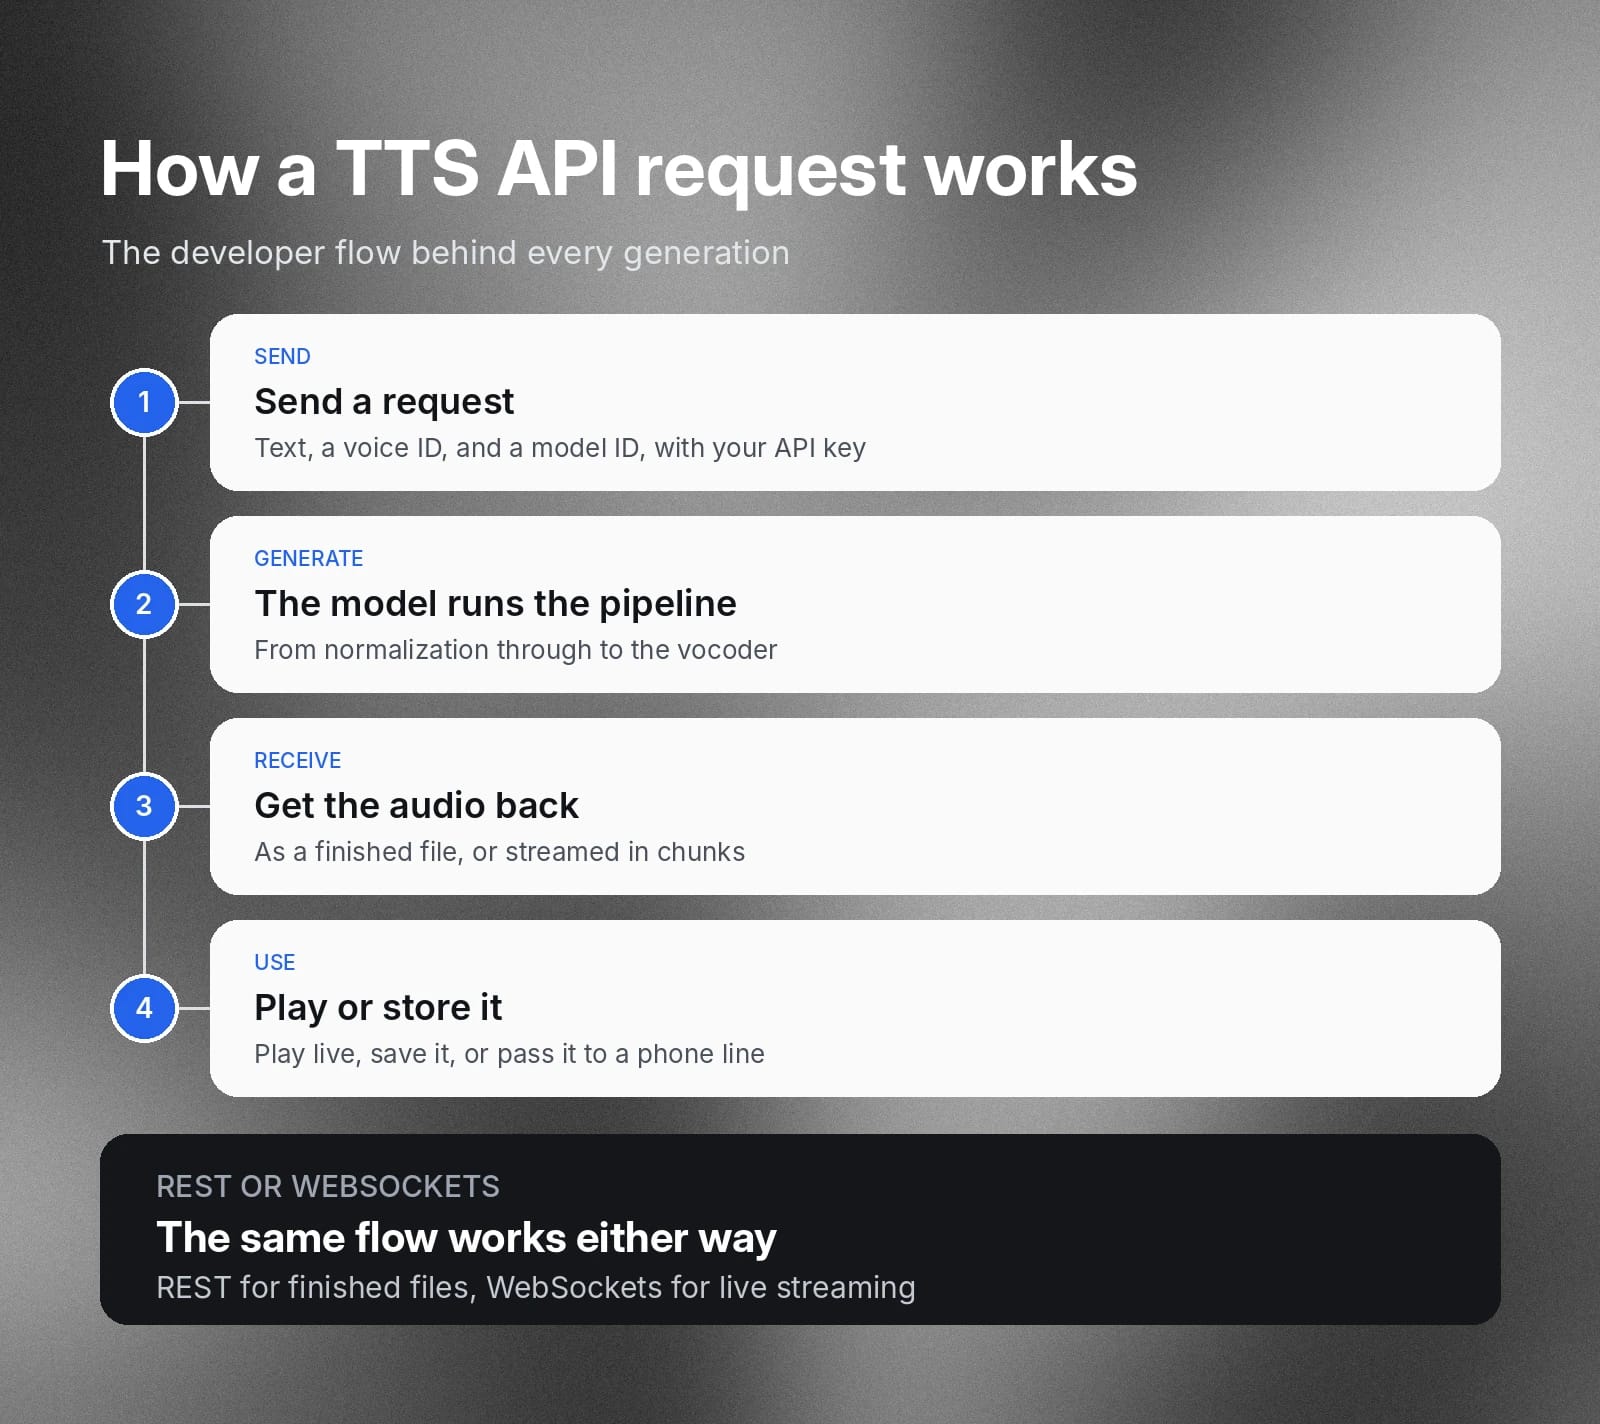
Même si les modèles sont complexes, le workflow pour les développeurs est facile à comprendre et à prendre en main.
Avec ElevenAPI, vous pouvez intégrer Text to Speech à vos applications en quelques minutes :
- Envoyer une requête : votre application envoie le texte, un identifiant de voix et un identifiant de modèle à l’API avec votre clé API.
- Générer : le modèle exécute le pipeline décrit plus haut, de la normalisation au vocodeur.
- Recevoir l’audio : l’API renvoie le fichier audio final ou le diffuse par segments afin que la lecture commence avant la fin de la génération.
- Lire ou stocker : votre application lit l’audio en direct, l’enregistre ou le transmet à un autre système, comme une ligne téléphonique.
Le même workflow s’applique que vous utilisiez REST pour des fichiers finalisés ou WebSockets pour le streaming en direct, et les SDK décrits ci-dessous encapsulent ces appels.
Considérations architecturales pour les développeurs
Selon votre cas d’usage, vous devrez peut-être arbitrer entre vitesse de traitement, fidélité audio, latence et protocoles réseau, ainsi que capacités d’intégration.
Latence et fidélité
Pour que les agents conversationnels paraissent naturels, visez environ 100 ms avant le premier audio, ce qui implique de réduire la latence sur le réseau et vers le moteur TTS. L’enjeu est la qualité audio que l’architecture de votre agent peut produire dans cette contrainte.
À l’inverse, la latence importe moins lorsque vous produisez de l’audio long, comme un podcast ou un cours. Plutôt que de réduire la latence, cherchez à maximiser la fidélité de la sortie.
Protocoles de streaming
Les protocoles utilisés pour votre connexion API peuvent aussi affecter la latence et les performances. Les WebSockets permettent un véritable streaming audio bidirectionnel, ce qui permet de traiter des segments de texte au fil de l’eau plutôt que d’attendre le rendu d’un flux entier. La lecture peut commencer dès les premiers segments tandis que le moteur TTS traite les suivants.
SDK
Les API Text to Speech professionnelles, comme ElevenAPI, proposent des kits de développement logiciel (SDK) complets pour Python et TypeScript/JavaScript, ainsi que des API REST, pour déployer rapidement une nouvelle architecture. Utilisez-les pour réduire les efforts d’intégration de votre équipe de développement.
Utilisez ElevenAPI pour le Text to Speech dès aujourd’hui
La synthèse TTS naturelle d’un modèle vocal de référence produit la sortie audio de haute qualité dont vos agents et vos productions audio ont besoin pour maintenir l’engagement des auditeurs. Que vous recherchiez un agent conversationnel performant pour accompagner les workflows client ou souhaitiez intégrer le TTS à votre application, ElevenLabs propose une solution.
Produisez dès aujourd’hui votre propre audio haute fidélité avec ElevenAPI, ou découvrez ElevenAgents.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.