
Tutoriel de reconnaissance vocale en JavaScript : créer une UX vocale
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Intégrer la reconnaissance vocale aux sites web et applications basées sur navigateur est désormais plus simple grâce aux API de conversion de la parole en texte (STT) natives du navigateur, comme la Web Speech API. Les développeurs peuvent facilement diffuser l'entrée du microphone, analyser les données audio et traiter les transcriptions en effectuant des appels API, sans créer de serveur local de reconnaissance automatique de la parole.
La Web Speech API est une API courante de reconnaissance vocale permettant d'implémenter des commandes vocales en JavaScript. Elle expose des méthodes, arguments et propriétés permettant d'exécuter une transcription en temps réel dans un navigateur web. Toutefois, les développeurs peuvent trouver la Web Speech API limitée pour les clients web complexes.
Ce guide explique comment configurer une application web simple de reconnaissance vocale en JavaScript avec la Web Speech API, ses limites et les alternatives pour créer des clients de transcription en temps réel plus robustes.
En résumé
- La Web Speech API est une API de conversion de la parole en texte native du navigateur qui envoie l'audio du microphone à un service cloud backend pour traitement.
- Les développeurs utilisent la classe API SpeechRecognition pour créer des applications de commandes vocales en JavaScript.
- Lors de la création d'une application de reconnaissance vocale, prenez en compte la confidentialité des utilisateurs en indiquant qu'un enregistrement audio est en cours.
- La Web Speech API présente plusieurs limites, notamment une transcription incohérente, une dépendance au navigateur et l'absence de compréhension des intentions.
- ElevenLabs propose des API de conversion de la parole en texte très précises et adaptées à la production, compatibles avec le streaming côté client et côté serveur.
Fonctionnement de la Web Speech API
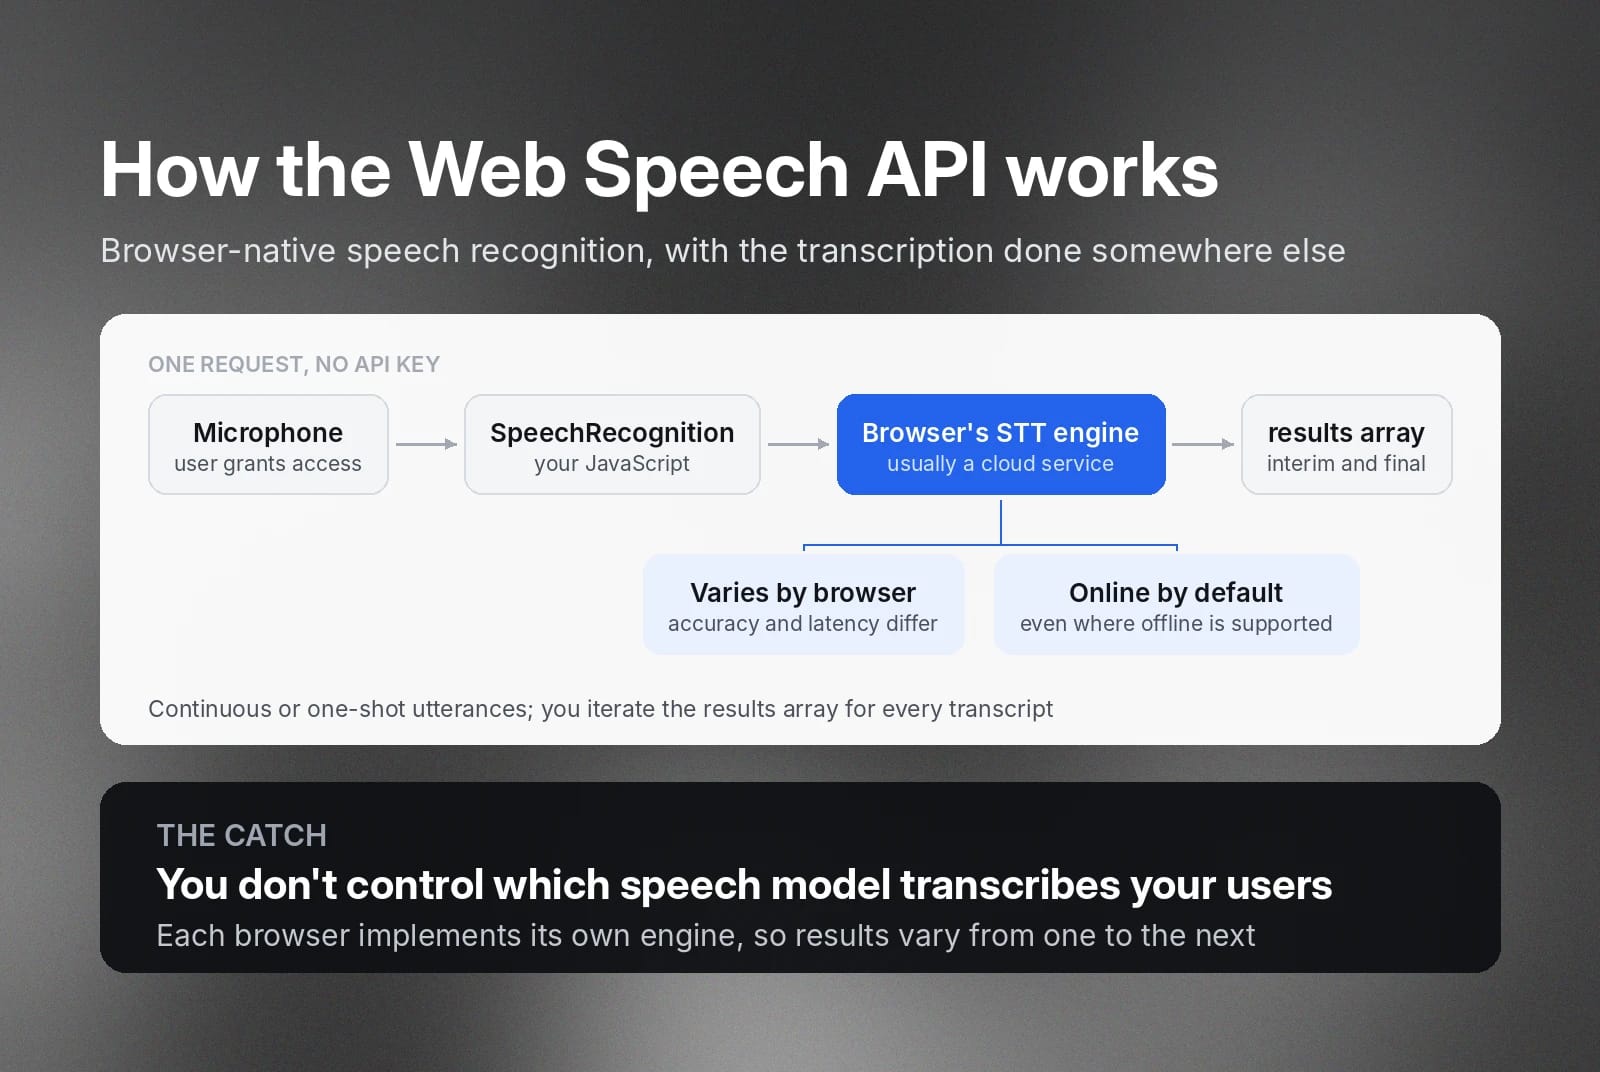
La Web Speech API offre aux développeurs web une reconnaissance vocale native du navigateur, sans serveur local. Elle envoie essentiellement un flux audio depuis votre navigateur web vers un service cloud backend afin de le traiter, l'analyser et le convertir en transcriptions. Comme elle s'appuie sur le moteur backend du navigateur pour effectuer la transcription, les résultats varient selon les navigateurs.
En règle générale, la Web Speech API requiert une connexion Internet active pour transcrire les flux audio, surtout si vous développez pour Chrome et Safari. Certains navigateurs prennent toutefois désormais en charge la transcription hors ligne. Dans ce cas, le navigateur agit comme moteur de conversion de la parole en texte, identifie les phonèmes et les transforme en texte cohérent.
Quel que soit le navigateur utilisé, les principes fondamentaux de l'API restent les mêmes.
- Vous n'avez pas besoin de clé API pour effectuer une requête API.
- La Web Speech API prend en charge les énoncés continus ou ponctuels.
- Elle renvoie des transcriptions provisoires et finales.
Toutefois, comme chaque navigateur peut implémenter le moteur STT différemment, la précision et la latence peuvent varier.
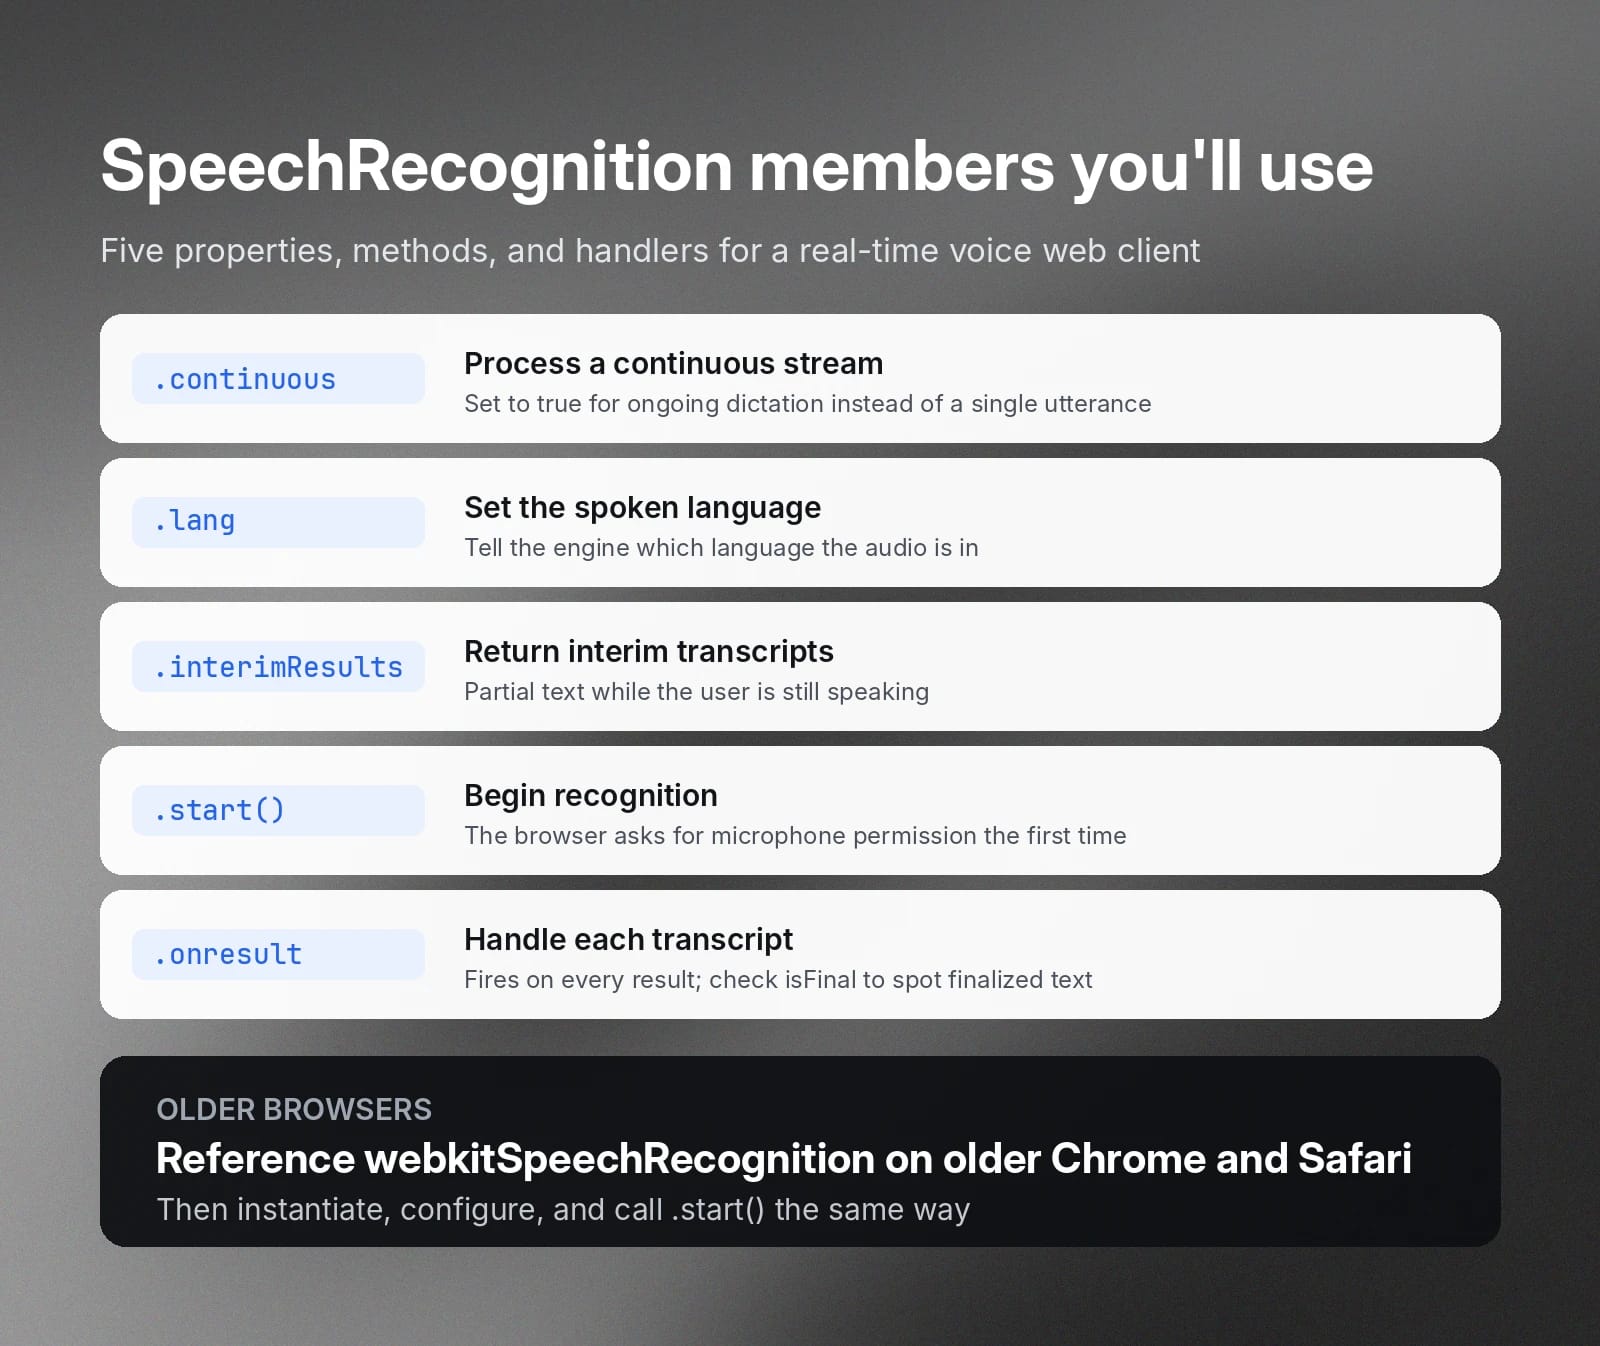
Pour utiliser la Web Speech API, initialisez l'interface SpeechRecognition dans votre code JavaScript. Vous accédez ensuite aux méthodes, attributs et gestionnaires d'événements au fil du développement. Voici ceux que vous utiliserez pour créer un client web de recherche vocale.
- SpeechRecognition.continuous : Permet au moteur vocal de traiter un flux continu lorsqu'il est défini sur true.
- SpeechRecognition.lang : Définit la langue de l'audio.
- SpeechRecognition.interimResults : Indique au moteur de renvoyer des transcriptions provisoires.
- SpeechRecognition.start() : Lance le processus de reconnaissance vocale.
- SpeechRecognition.onresult : Accepte un gestionnaire d'événements, déclenché par l'API lorsqu'elle termine la transcription.
La Web Speech API renvoie la transcription dans un tableau de chaînes de caractères. Lorsque le moteur STT renvoie une transcription, provisoire ou finale, vous la trouvez dans le tableau results. Il peut renvoyer une ou plusieurs chaînes. Vous devez donc parcourir les chaînes de résultat pour récupérer tout le texte transcrit.
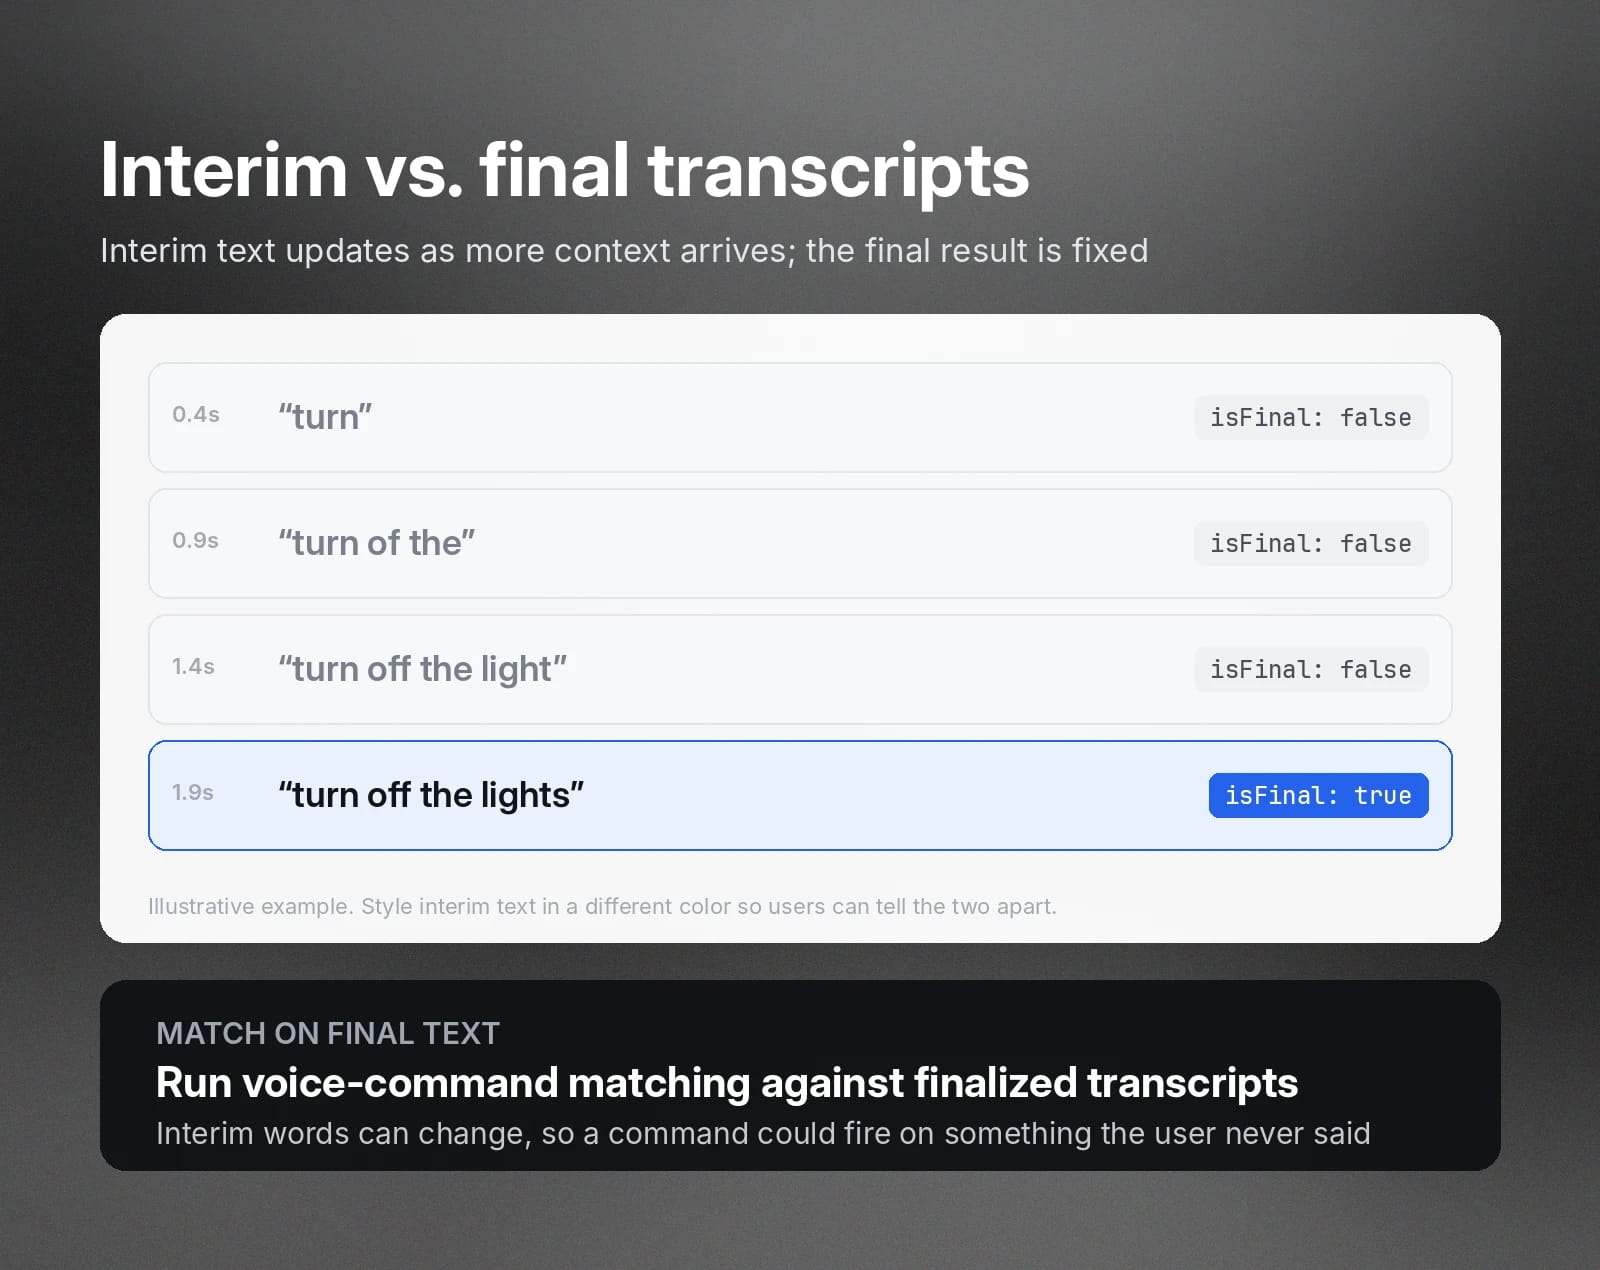
Remarque : Si vous avez activé la transcription provisoire, vérifiez la propriété isFinal pour déterminer si le texte constitue une transcription finalisée.
Créer un exemple de reconnaissance vocale en JavaScript
Cet exemple utilise l'interface JavaScript SpeechRecognition pour créer une application web de transcription en temps réel. La capture d'écran ci-dessous présente la page finale.
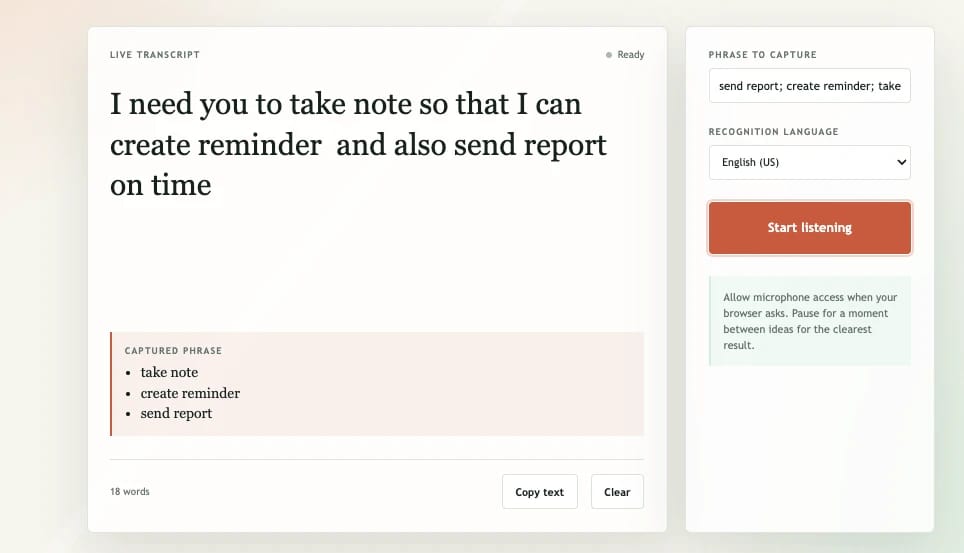
Dans l'exemple, un bouton « Commencer l'écoute » lance l'enregistrement. Lorsque l'utilisateur parle, le navigateur envoie l'audio au moteur STT, attend la transcription et affiche le texte provisoire comme final.
L'exemple comprend également une fonctionnalité de commandes vocales qui capture les termes spécifiques listés par l'utilisateur. Elle compare la transcription à une liste prédéfinie de phrases dans votre code, ce qui diffère de l'invite par termes clés dans une API de conversion de la parole en texte.
Les extraits ci-dessous montrent les principales parties de cet exemple.
Configurer l'API SpeechRecognition et demander l'accès au microphone
Pour l'utiliser dans votre code, vous devez d'abord instancier la classe SpeechRecognition. Si vous utilisez une ancienne version de Chrome ou Safari, référencez webkitSpeechRecognition.
Créez ensuite une instance SpeechRecognition et configurez le mode de streaming, la prise en charge de la transcription provisoire et la langue parlée.
Vous pouvez ensuite lancer la transcription en appelant la méthode .start().
Lors du premier lancement du processus de reconnaissance vocale, le navigateur demandera l'autorisation à l'utilisateur. Celui-ci doit cliquer sur « Autoriser » pour commencer la transcription. Sinon, l'API renverra la valeur « not-allowed » dans le gestionnaire SpeechRecognitionErrorEvent handler.
Afficher les transcriptions en direct et les résultats finaux
Dans cet exemple, nous affichons la transcription à mesure que l'utilisateur parle dans le microphone. Pour cela, nous ajoutons une fonction à l'événement onresult.
Les transcriptions provisoires ne sont pas finalisées. Le texte affiché peut donc ne pas correspondre exactement aux mots prononcés. À mesure que le moteur STT reçoit davantage de contexte à partir des mots suivants, il corrige la transcription et la renvoie dans la chaîne.
Vous pouvez aussi afficher le texte provisoire dans une autre couleur afin de le distinguer de la transcription finale. Ce code CSS le permet :
Ajouter des commandes vocales en JavaScript
Ajoutez un champ de texte dans lequel les utilisateurs saisissent les phrases à détecter, séparées par des points-virgules. Vous pouvez aussi stocker ces phrases dans un fichier JSON et les charger dans votre code.
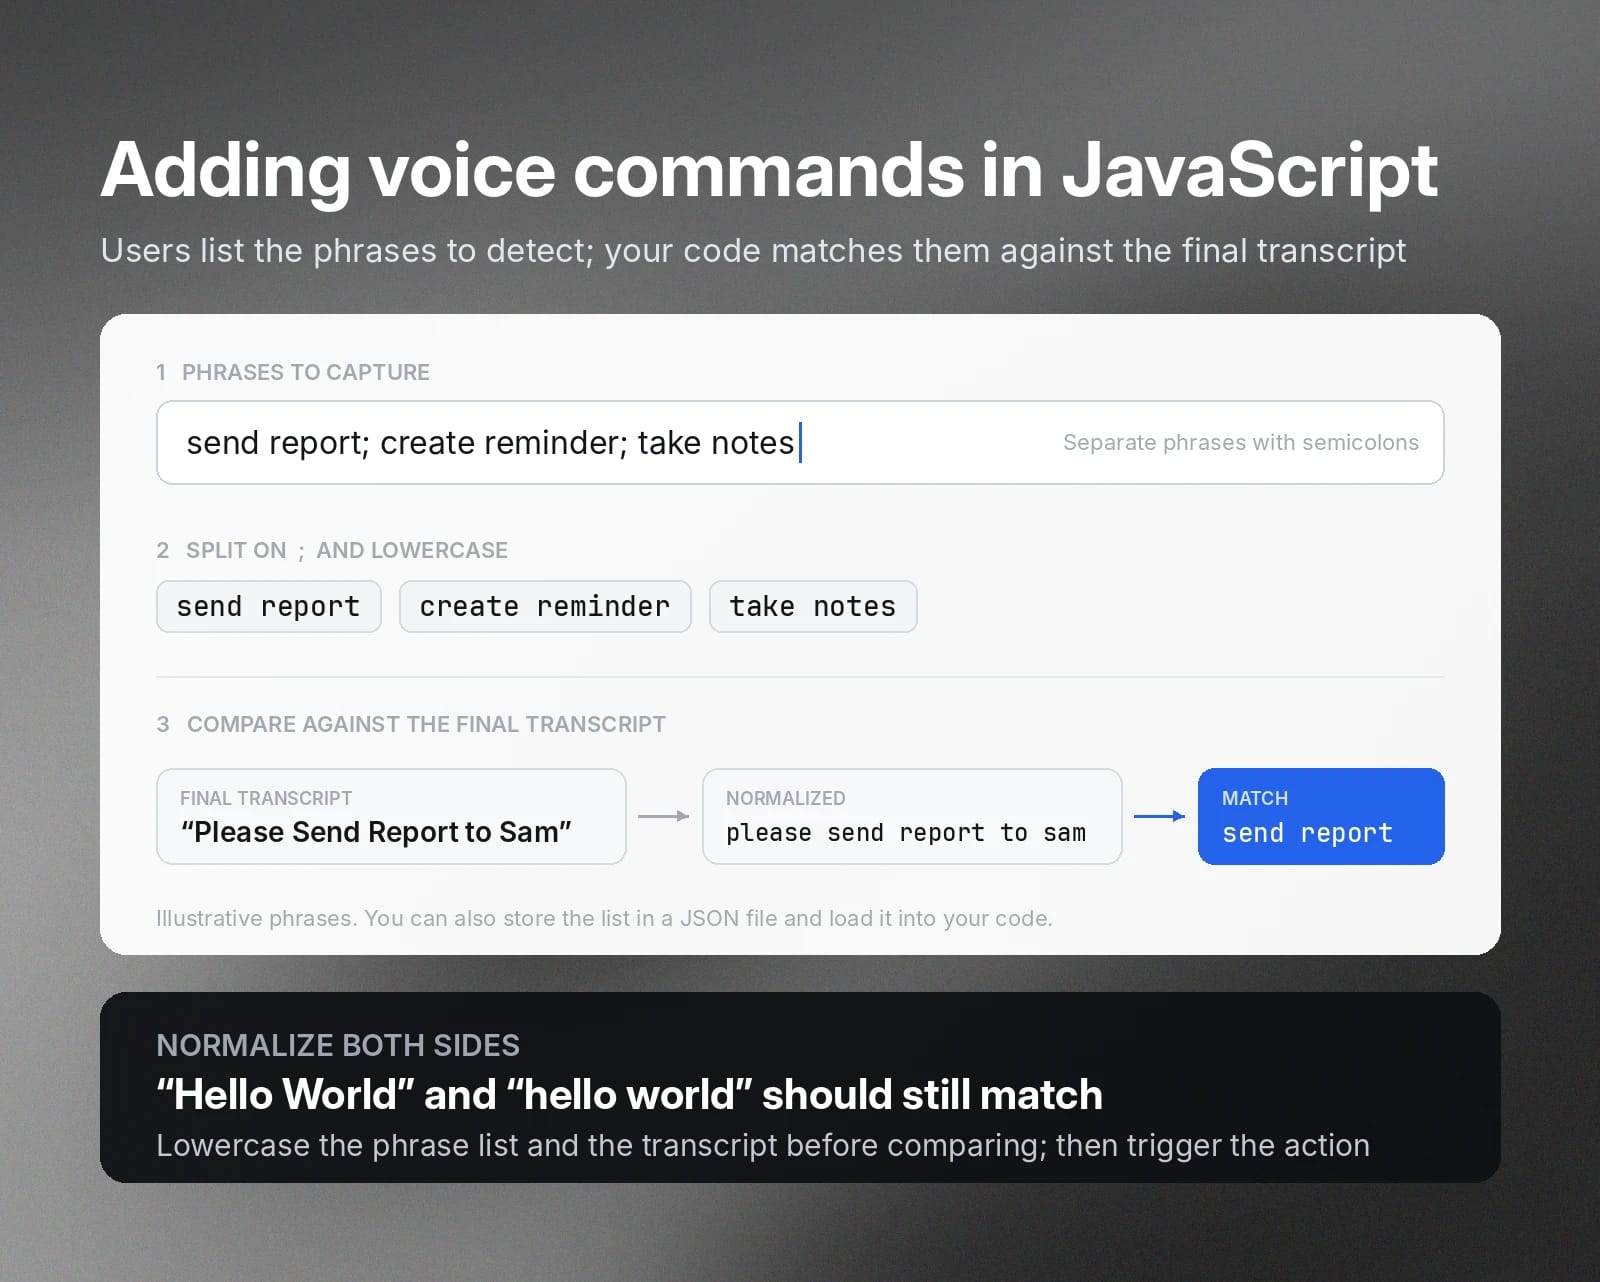
Créez ensuite une fonction qui compare la transcription finale à la liste de phrases. Lors de la correspondance de texte, normalisez les deux listes en les convertissant en minuscules. Les utilisateurs peuvent en effet mettre des mots en majuscule, ce qui risque d'empêcher une correspondance même s'il s'agit du même mot. Par exemple, « Hello World » et « hello world » doivent correspondre, même si l'une comporte des majuscules.
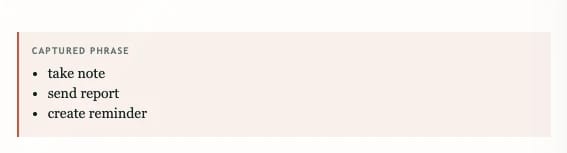
Chaque fois que le code reçoit une transcription, il parcourt la liste de phrases. En cas de correspondance, vous déclenchez une action, par exemple lancer une application ou, ici, afficher la phrase correspondante dans un panneau distinct.
Gérer la prise en charge des navigateurs, les autorisations et les erreurs de reconnaissance
La Web Speech API rend la reconnaissance de la parole en texte en JavaScript accessible, mais elle n'est pas toujours exempte de problèmes. Les utilisateurs peuvent employer un navigateur dont la prise en charge backend de l'API SpeechRecognition est limitée ou inexistante. Dans certains cas, des problèmes réseau font échouer la transcription.
Votre code doit donc gérer ces conditions et en informer les utilisateurs.
Par exemple, indiquez aux utilisateurs d'employer Chrome ou Edge, pour lesquels le fonctionnement de l'API SpeechRecognition est avéré.
Pour gérer les erreurs, associez une fonction de gestion des erreurs au gestionnaire d'événements onerror et traitez le code d'erreur correspondant.
Par exemple,
Code d'erreur | Action |
not-allowed | Affichez un texte indiquant à l'utilisateur de vérifier les paramètres du navigateur. |
no-speech | Demandez à l'utilisateur de parler plus près du microphone |
network | Demandez à l'utilisateur de vérifier sa connexion Internet |
aborted | Informez l'utilisateur que le processus de reconnaissance vocale a été arrêté. |
Rendre la reconnaissance vocale JavaScript accessible et respectueuse de la confidentialité
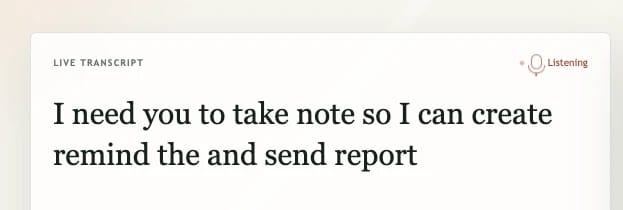
Lors de l'intégration de la Web Speech API, gardez la confidentialité à l'esprit. Affichez toujours un indicateur visuel ou verbal avant que le client web commence l'enregistrement. Par exemple, affichez une icône d'écoute lorsque le code de reconnaissance vocale JavaScript envoie activement le signal du microphone au moteur de conversion de la parole en texte.
La confidentialité des données mérite également l'attention des développeurs. Lorsque vous transcrivez avec l'API SpeechRecognition, l'API effectue la transcription en ligne par défaut. Même si le navigateur prend en charge la conversion de la parole en texte hors ligne, l'API essaiera d'abord la transcription en ligne.
Ces spécifications techniques sont essentielles lorsque vous créez des services de transcription soumis à une réglementation stricte en matière d'hébergement des données en Europe, de gouvernance et de conformité.
Savoir quand la reconnaissance vocale du navigateur ne suffit plus en production
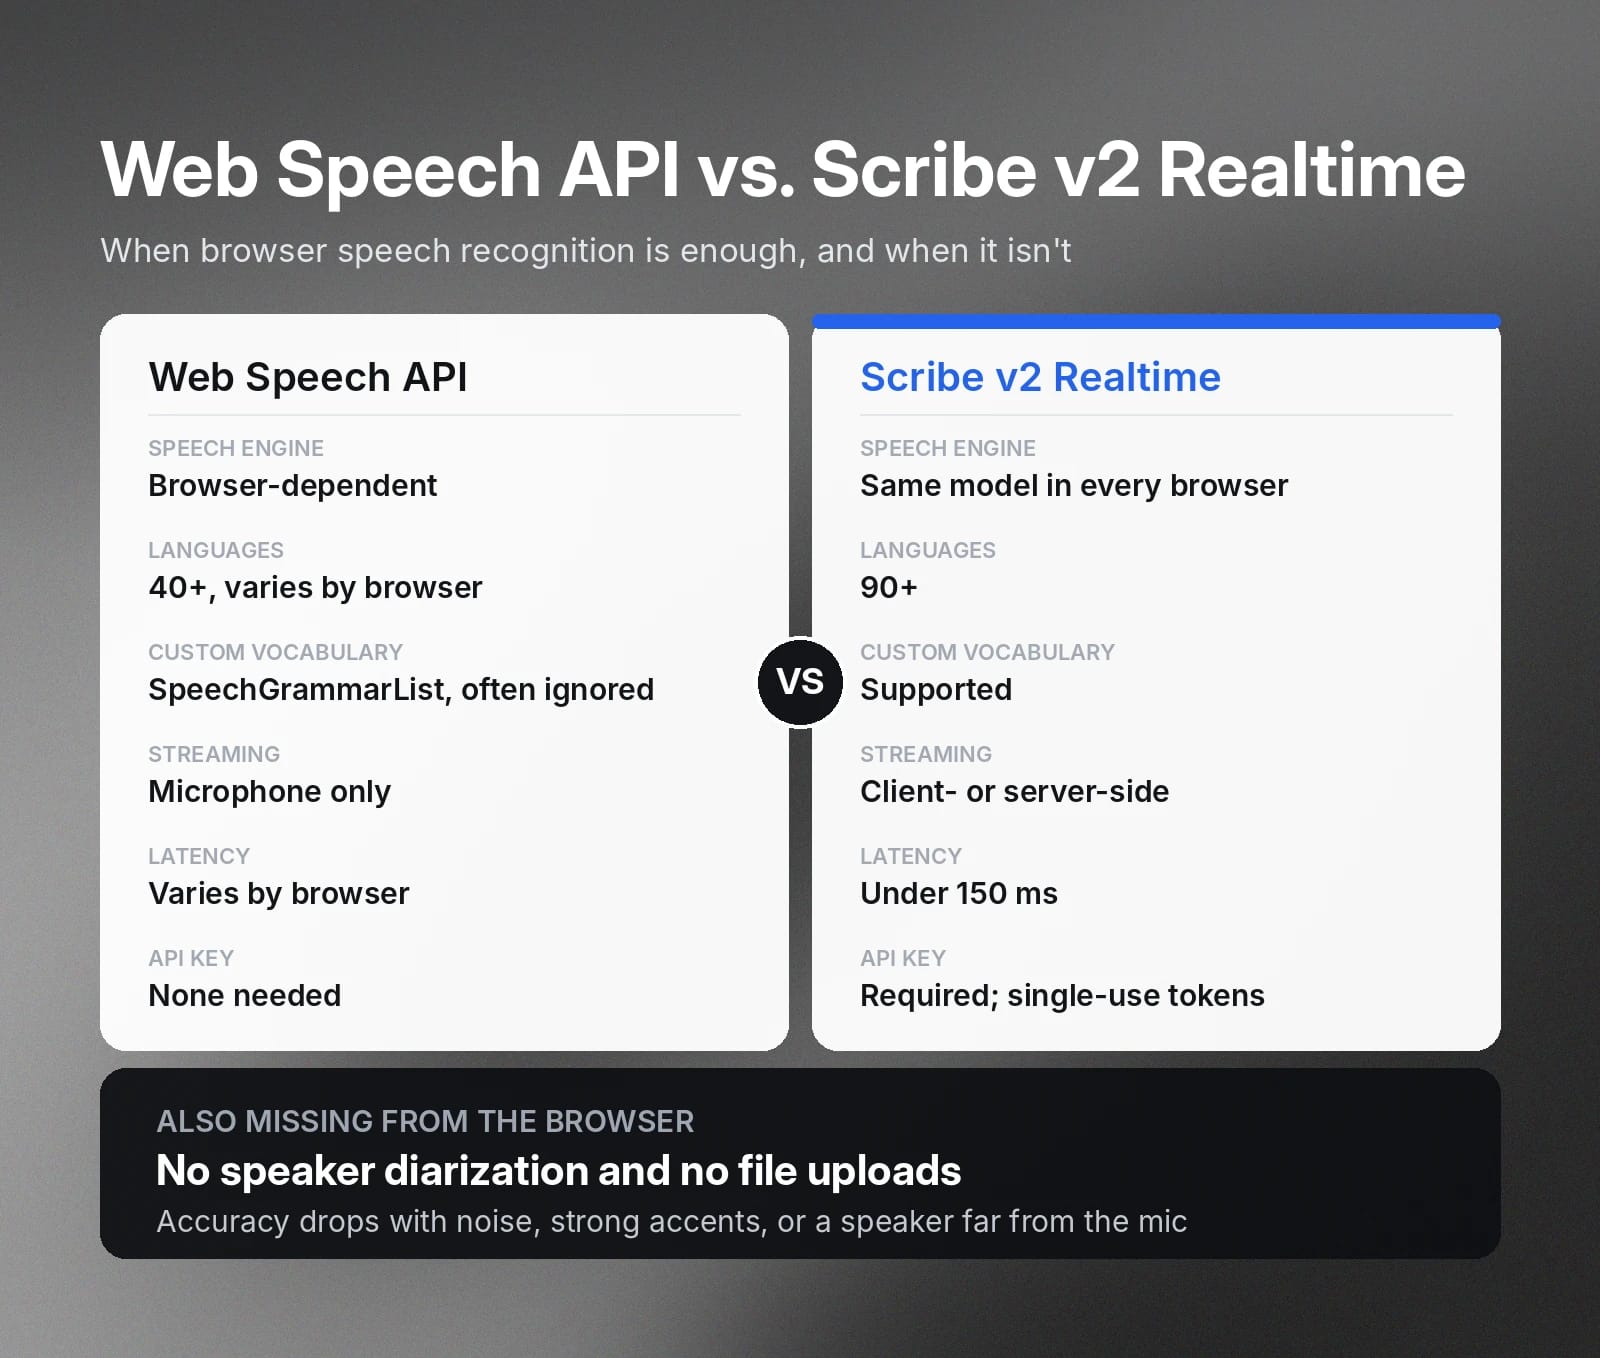
Nous avons présenté les étapes pour créer une reconnaissance automatique de la parole pour des applications vocales basées sur navigateur avec la Web Speech API. L'API rend les capacités de conversion de la parole en texte accessibles aux développeurs JavaScript. Toutefois, plusieurs limites restreignent les cas d'utilisation, en particulier pour les produits web commerciaux.
- Dépendance au navigateur : La transcription dépend fortement du navigateur de l'utilisateur. Les développeurs ne contrôlent pas les modèles vocaux spécifiques utilisés, ce qui entraîne des performances de transcription incohérentes.
- Prise en charge linguistique limitée : L'API prend en charge plus de 40 langues, mais le nombre exact peut varier selon les navigateurs.
- Diarisation des locuteurs : Vous ne pouvez pas identifier la personne qui parle ni refléter les différents locuteurs dans la transcription.
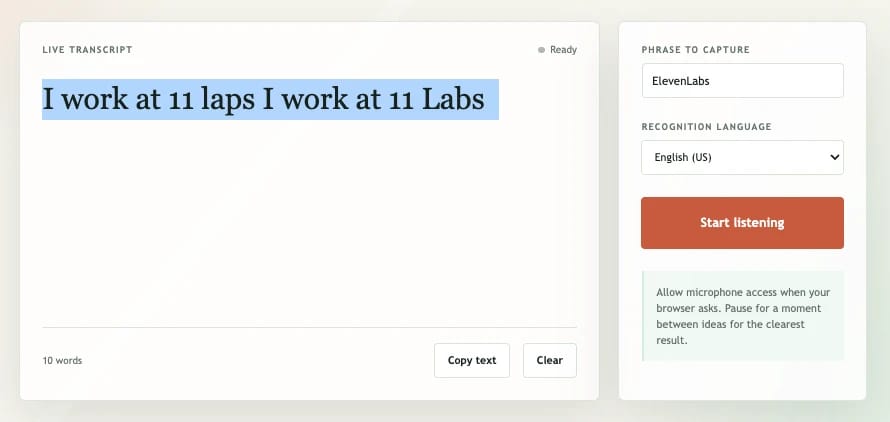
- Vocabulaires personnalisés : L'API SpeechRecognition ne prend pas en charge les vocabulaires personnalisés de manière fiable. Par exemple, elle ne peut pas transcrire précisément « ElevenLabs ». L'API officielle SpeechRecognition fournit une interface de vocabulaire personnalisé via SpeechGrammarList, mais les navigateurs modernes l'ignorent souvent.
- Précision : La précision de transcription diminue lorsque le locuteur se trouve dans un environnement bruyant, a un fort accent ou est éloigné du microphone.
- Streaming côté serveur : Vous pouvez uniquement diffuser depuis le microphone, car la Web Speech API ne prend pas en charge le streaming serveur ni le chargement manuel de fichiers audio.
Si ces limites vous empêchent de commercialiser votre produit de reconnaissance vocale, nous vous recommandons d'utiliser ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime est un modèle de reconnaissance vocale offrant une transcription en temps réel très précise avec une latence inférieure à 150 ms. Il prend en charge plus de 90 langues, une cohérence indépendante du navigateur et les vocabulaires personnalisés. Avec ElevenLabs Scribe v2 Realtime, vous pouvez exécuter un streaming côté client ou côté serveur selon l'architecture de votre application web.
Tutoriel de reconnaissance vocale JavaScript avec ElevenLabs Scribe v2 Realtime
Créer une commande vocale en JavaScript avec ElevenLabs suit une approche similaire. Toutefois, vous devez créer une clé API ElevenLabs pour autoriser les requêtes API. Voici les étapes rapides pour créer un client web qui diffuse depuis un microphone.
- Installer le SDK ElevenLabs
- Créer un jeton à usage unique pour transmettre la clé API sans l'exposer
- Configurer et connecter le modèle Scribe v2 Realtime avec les paramètres souhaités
- Créer des gestionnaires d'événements pour traiter les transcriptions et gérer les exceptions
Pour obtenir des conseils détaillés sur Scribe v2 Realtime, consultez notre documentation officielle.
Utiliser ElevenAPI pour la conversion de la parole en texte en production
ElevenAPI propose des modèles de conversion de la parole en texte adaptés à la production pour le développement de clients web et de serveurs. Au-delà de la reconnaissance vocale en temps réel, les développeurs utilisent les modèles de conversion de la parole en texte d'ElevenAPI pour activer la transcription par lots avec diarisation des locuteurs, horodatage au niveau du mot et traitement asynchrone.
Au lieu d'interroger continuellement le moteur de conversion de la parole en texte, vous pouvez créer un webhook dans le Dashboard ElevenLabs et fournir une URL de rappel à laquelle l'API transmet la transcription terminée.
Que vous souhaitiez créer un client web ou une application serveur avec reconnaissance automatique de la parole, ElevenAPI propose des modèles audio faciles à intégrer à votre code.
Obtenez votre clé API ElevenLabs et consultez la documentation de l'API pour commencer à développer.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


