Transcription en temps réel ou par lots : principales différences
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Vous avez deux options pour choisir un modèle de transcription propulsé par l’IA : la transcription en temps réel ou par lots. Toutes deux convertissent la parole en texte, mais leurs approches diffèrent.
La transcription en temps réel traite l’audio au fur et à mesure, tandis que la transcription par lots traite l’intégralité d’un enregistrement une fois terminé. La première offre des résultats instantanés, mais la seconde est souvent plus précise.
Dans ce guide, nous comparons la transcription en temps réel et par lots afin de vous aider à choisir le bon modèle pour votre prochain projet. Nous expliquons le fonctionnement de chaque modèle, leurs avantages, leurs limites et leurs cas d’usage courants.
En résumé
- La transcription en temps réel traite l’audio au fur et à mesure.
- La transcription par lots traite un fichier audio entier en une seule fois.
- La transcription en temps réel est plus rapide, mais la transcription par lots est plus précise, car le modèle dispose d’un contexte bidirectionnel sur l’ensemble du fichier audio.
- La transcription en temps réel convient particulièrement aux applications telles que les agents vocaux en direct, les sous-titres vidéo en direct ou les comptes rendus de réunion, où la vitesse importe davantage que la précision.
- La transcription par lots est plus précise et plus économique pour transcrire de grands volumes d’audio après leur enregistrement.
Qu’est-ce que la transcription en temps réel en STT ?
La transcription en temps réel consiste pour un modèle de reconnaissance vocale (STT) à convertir l’audio en texte au fur et à mesure. On l’appelle aussi parfois transcription en streaming.
Avec la transcription en temps réel, le modèle STT traite l’audio par petits segments. Le texte devient disponible quelques millisecondes après que les mots sont prononcés. À mesure que la conversation avance, le modèle STT recueille davantage de données et de contexte afin d’affiner la transcription.
Cette forme de transcription est idéale lorsque la vitesse compte davantage que la précision. Par exemple, ces modèles rendent les flux audio et vidéo plus accessibles grâce aux sous-titres en temps réel. Les plateformes de prise de notes en temps réel constituent un autre cas d’usage courant.
Qu’est-ce que la transcription par lots en STT ?
La transcription par lots convertit un enregistrement audio entier de la parole en texte en une seule fois, une fois l’enregistrement terminé. Le processus dure de quelques secondes à plus de 10 minutes, selon la durée et la complexité de l’enregistrement.
Les modèles de transcription par lots exploitent le contexte de l’enregistrement entier pendant son traitement. Ce contexte complet aide le modèle à interpréter précisément les passages comportant un langage complexe, du bruit de fond ou des interruptions. Les modèles par lots ajoutent aussi la ponctuation et la mise en forme, des éléments avec lesquels certains modèles en temps réel peuvent rencontrer des difficultés.
La transcription par lots convient lorsque la précision est la priorité absolue. De nombreuses organisations l’utilisent pour transcrire de longs entretiens, réunions ou podcasts destinés à leurs archives.
Comment les architectures par lots et en streaming façonnent la transcription
En comparant le traitement par lots et en streaming pour la transcription, les deux modèles reposent sur des processus fondamentalement différents, qui influencent le résultat final.
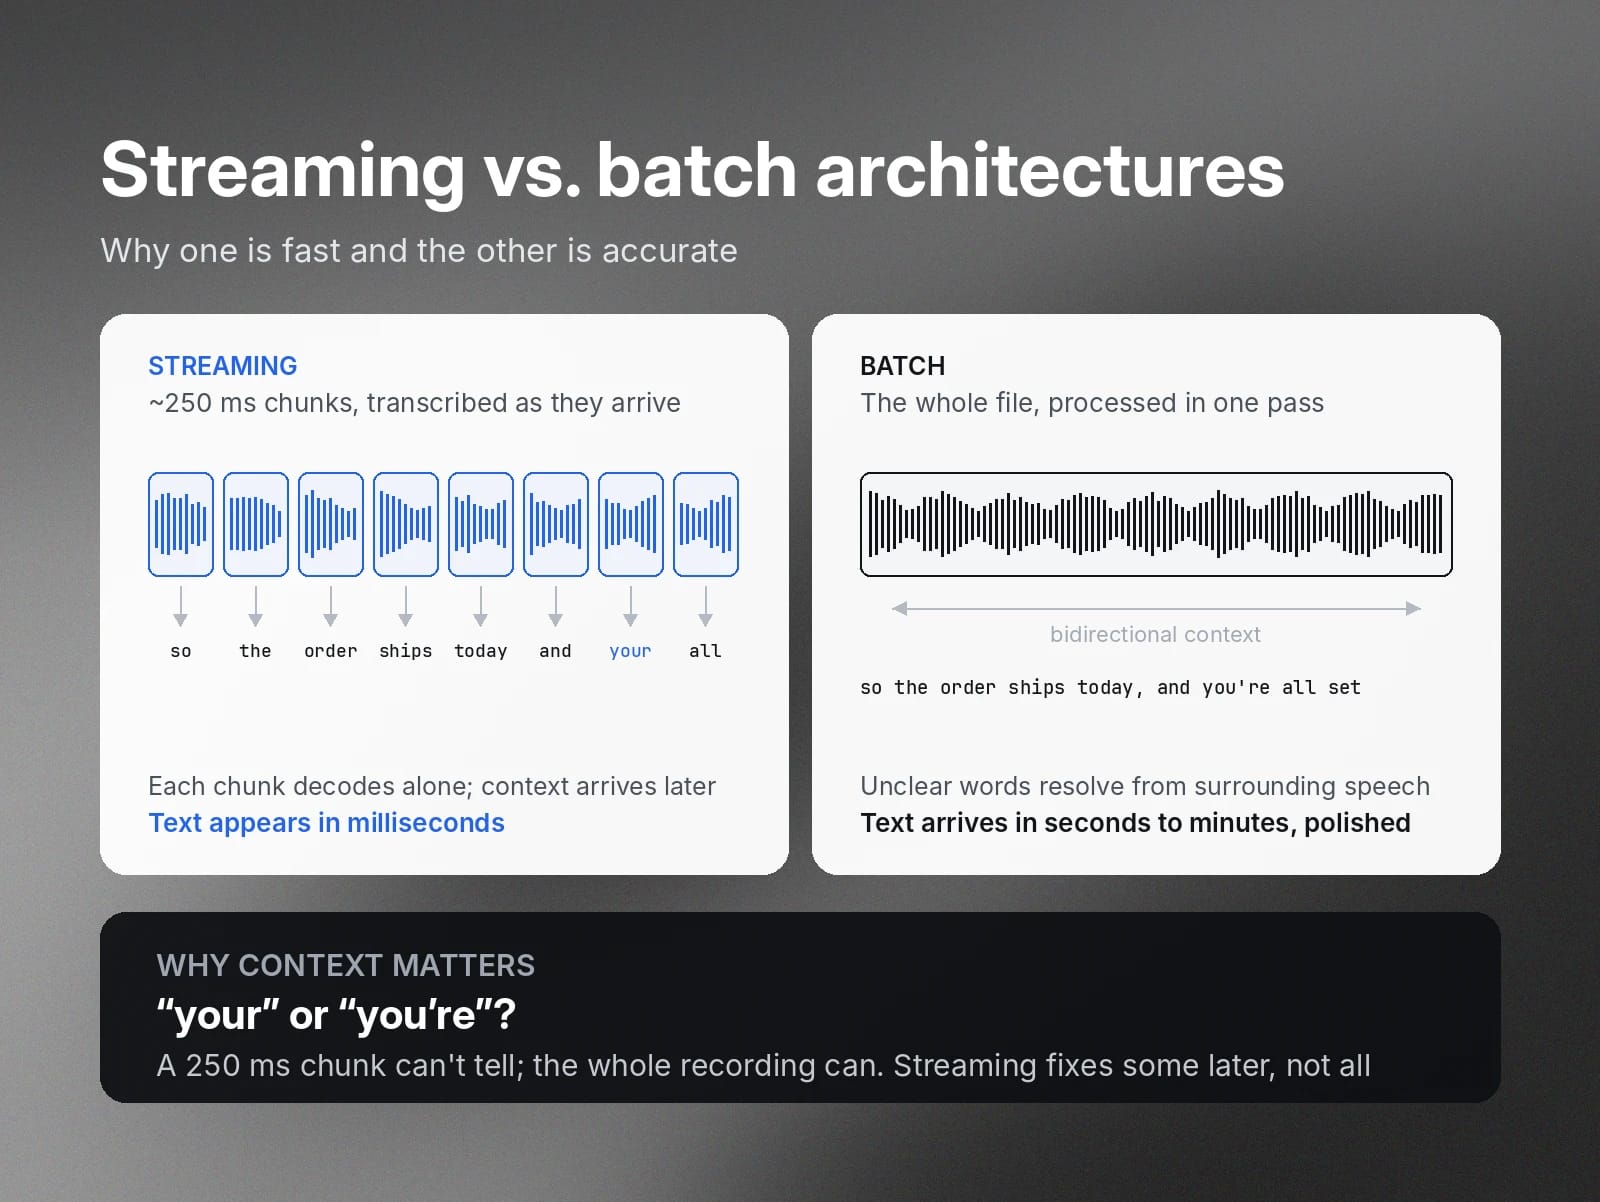
Les modèles de transcription en streaming découpent l’audio en segments et transcrivent chacun d’eux au fur et à mesure. Ces segments sont très courts, généralement de 250 millisecondes ou moins. Ce format permet au modèle de transcription de fonctionner rapidement et d’afficher le texte quelques secondes après l’audio.
Ces segments audio étant très courts, le modèle Speech to Text ne dispose pas du contexte complet de la conversation, ce qui peut entraîner des erreurs. Par exemple, le modèle peut choisir un homophone incorrect.
Un modèle de transcription en temps réel corrige certaines de ces erreurs à mesure que la conversation se poursuit et que le contexte s’éclaircit. Cependant, le temps ou le contexte manquent généralement pour corriger chaque erreur : la transcription finale n’est donc pas toujours exacte à 100 %.
À l’inverse, les modèles de transcription par lots traitent le fichier audio entier en une seule fois. Le modèle dispose ainsi d’un contexte bidirectionnel pour la conversation, qu’il utilise pour lever les ambiguïtés sur les mots ou expressions. Lorsqu’un élément est peu clair dans le fichier audio, le modèle analyse les mots qui le précèdent et le suivent afin de déterminer ce qui a été dit et de le transcrire avec précision.
Ce contexte supplémentaire rend les modèles de transcription par lots plus lents que les modèles en temps réel. En revanche, le résultat final est beaucoup plus précis et soigné.
Caractéristiques clés des modèles de transcription en temps réel et par lots : latence, précision et coût
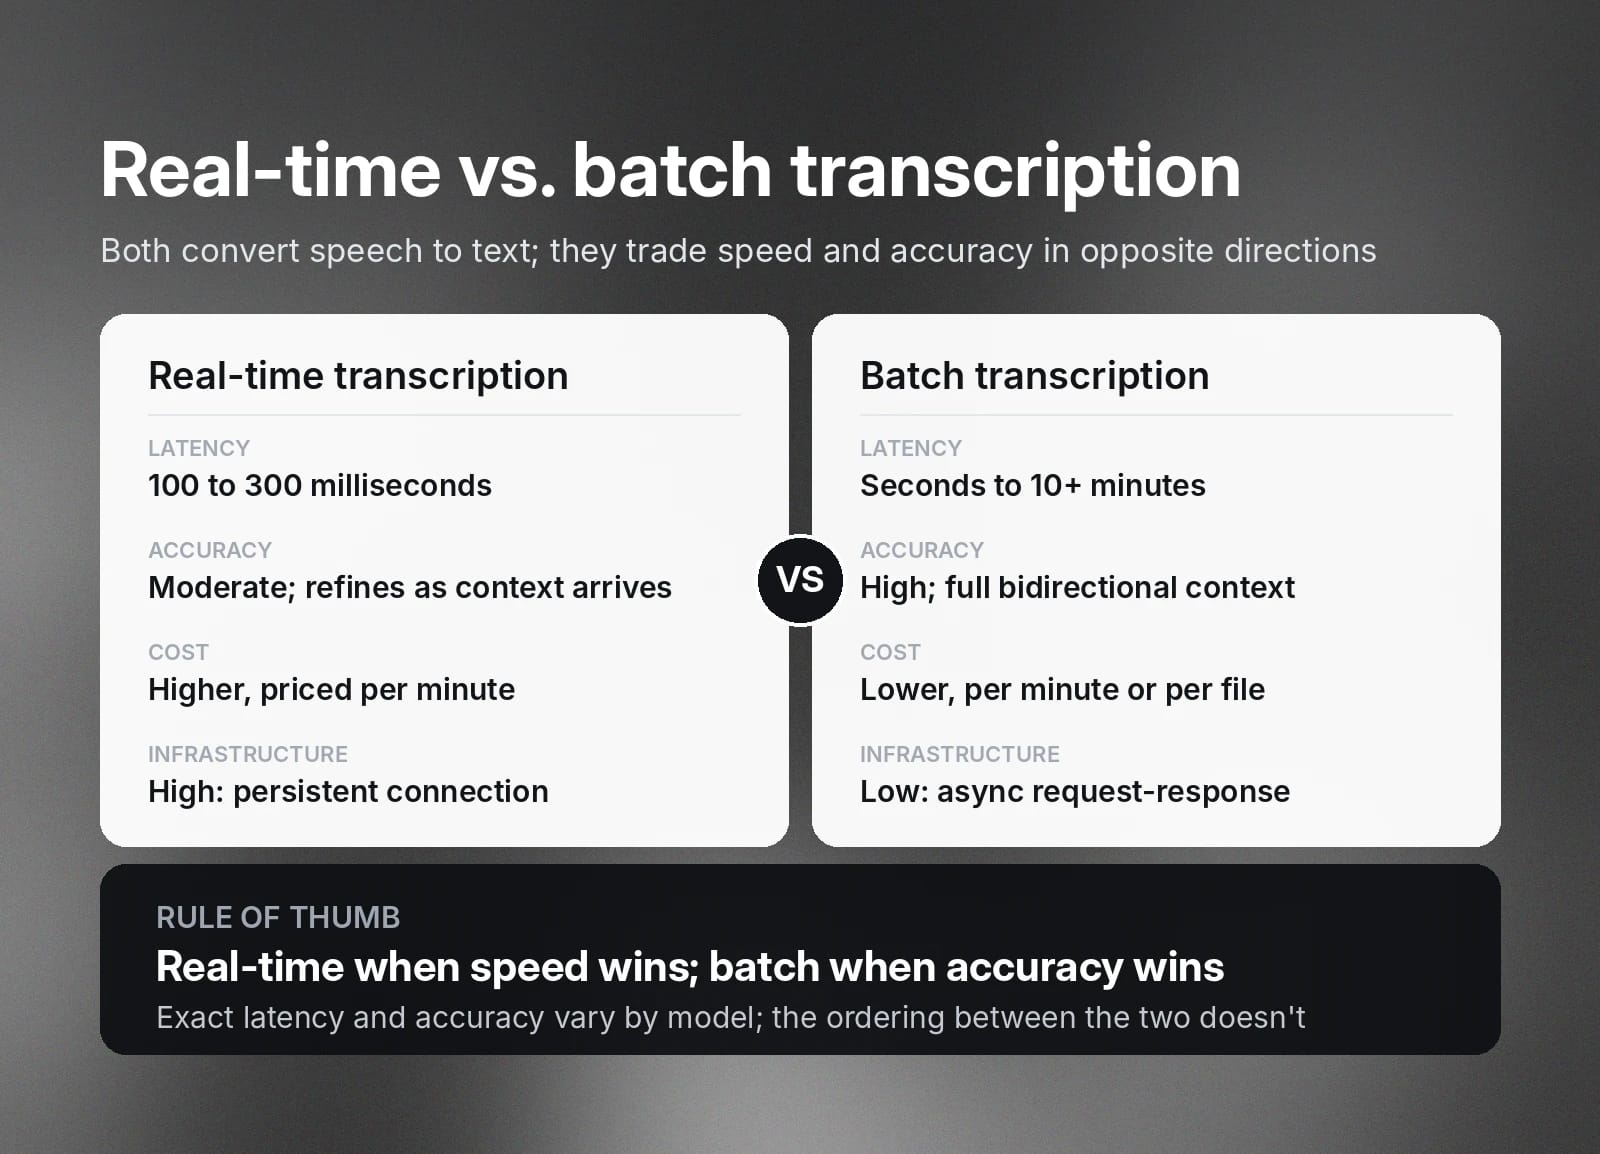
Les modèles en temps réel comme par lots sont efficaces pour la transcription : tout dépend du type de projet. Certains exigent des résultats instantanés, tandis que d’autres requièrent une grande précision.
Voici les facteurs à prendre en compte pour choisir entre transcription en temps réel et par lots :
Transcription en temps réel | Transcription par lots | |
Latence | 100 à 300 millisecondes | De quelques secondes à plus de 10 minutes, selon la durée du fichier |
Précision | Modérée | Élevée |
Coût | Élevé, facturé à la minute | Modéré, facturé à la minute ou au fichier |
Complexité de l’infrastructure | Élevée, nécessite une connexion stable et un équilibrage de charge | Faible, repose sur une structure asynchrone de requête-réponse |
Les niveaux exacts de latence et de précision varient selon le modèle de transcription utilisé. Toutefois, la transcription en temps réel est systématiquement plus rapide, tandis que la transcription par lots est plus précise.
La transcription en temps réel coûte plus cher que la transcription par lots, car elle exige une infrastructure plus complexe et implique davantage de coûts opérationnels. Les modèles en temps réel nécessitent une connexion stable pour maintenir leur vitesse et demandent plus de temps à configurer et à maintenir que les modèles par lots.
Les modèles en temps réel justifient l’investissement pour l’accessibilité lors de conversations en direct. En revanche, la transcription par lots réduit les coûts et le temps de configuration pour les projets où la vitesse n’est pas prioritaire.
Comparaison des API de transcription en temps réel et par lots : choisir la solution adaptée à votre projet
Avant de lancer un projet de transcription, évaluez les avantages et les limites des modèles par lots et en temps réel afin d’identifier celui qui correspond le mieux à vos objectifs. Voici à quoi ressemble cette décision dans trois scénarios réels.
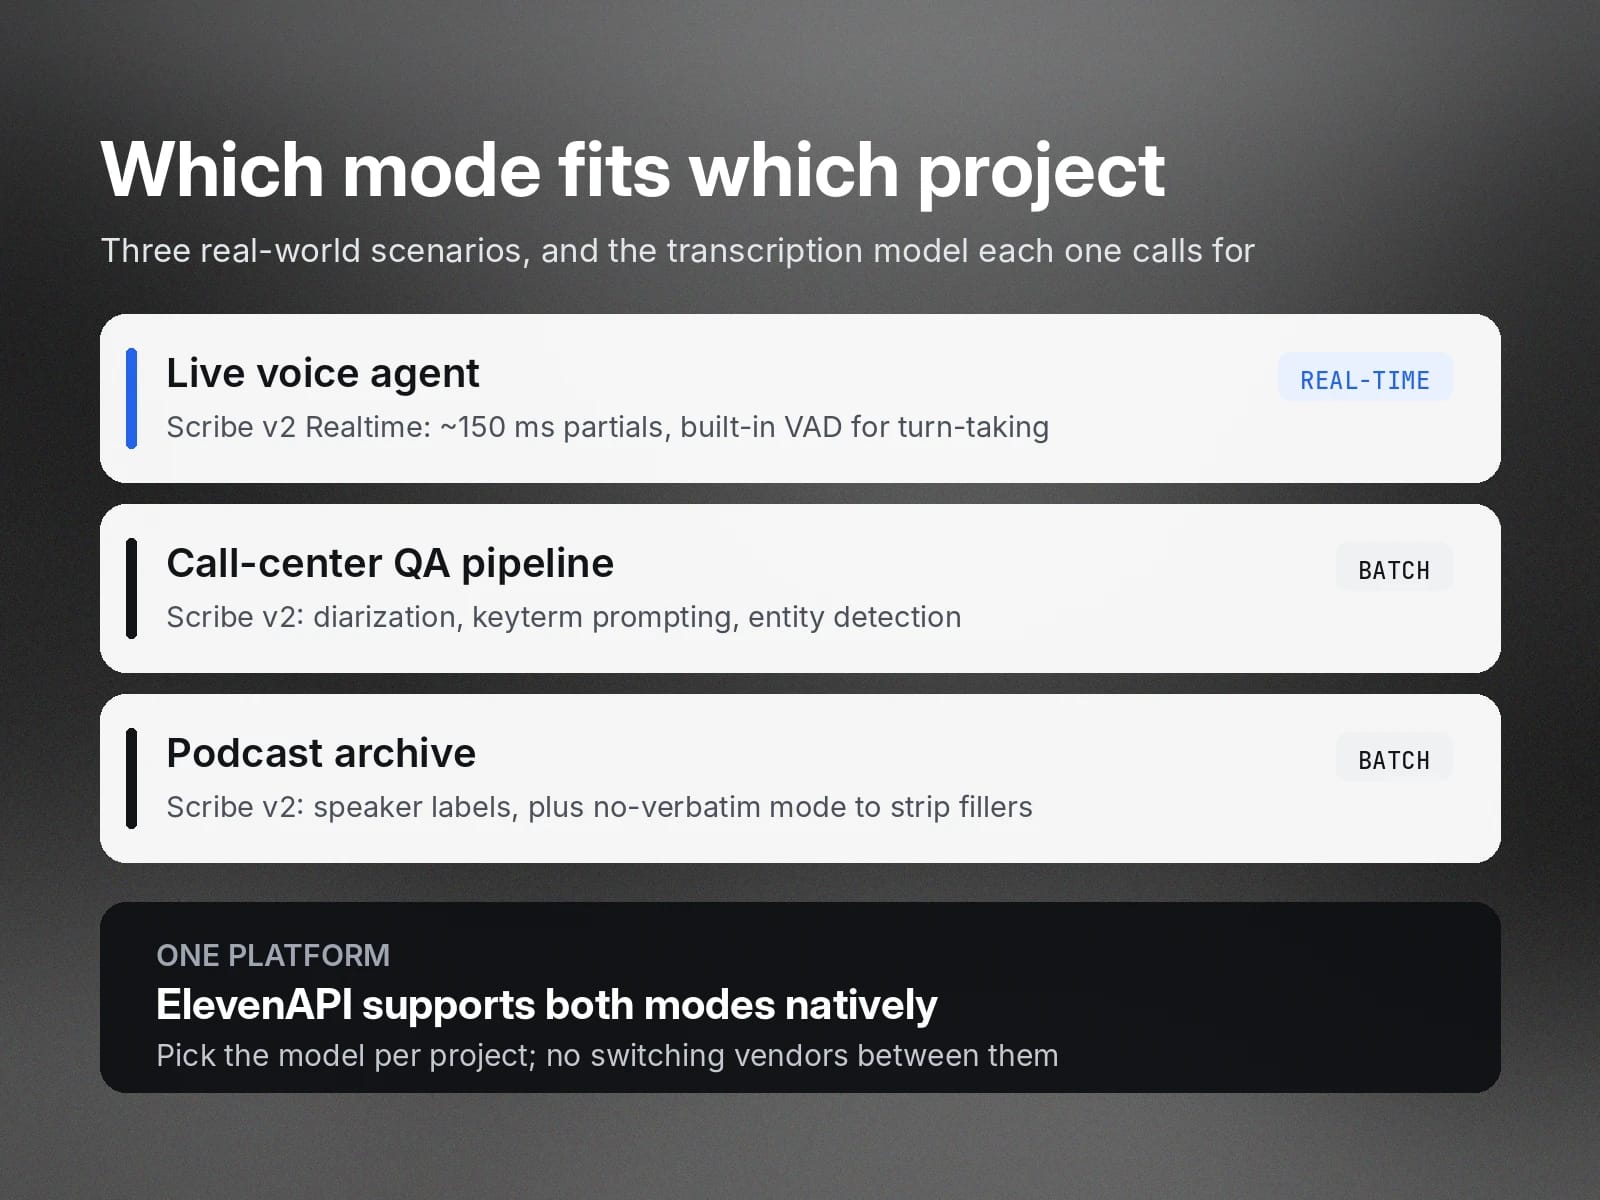
Agent vocal en direct : Transcription en temps réel
Les modèles d’IA conversationnelle en direct requièrent une transcription quasi instantanée pour garantir l’accessibilité, en particulier lorsqu’ils traitent des enjeux opérationnels ou de service client complexes.
Un modèle en temps réel tel que Scribe v2 Realtime offre la faible latence nécessaire à des conversations fluides et naturelles. Scribe v2 Realtime fournit des transcriptions partielles en environ 150 millisecondes.
Les modèles de transcription pour agents vocaux en direct doivent aussi gérer précisément les tours de parole. Ils doivent pouvoir détecter quand un utilisateur commence ou termine de parler et répondre immédiatement. Une gestion efficace des tours de parole et des interruptions évite que la transcription ne prenne du retard sur la conversation.
Les modèles de transcription en temps réel privilégient une gestion précise des tours de parole pour fournir des résultats rapides. Par exemple, Scribe v2 Realtime intègre la détection d’activité vocale, et segmente donc automatiquement la transcription lorsqu’il détecte un silence entre les interlocuteurs.
Pipeline d’assurance qualité de centre d’appels : Transcription par lots
La précision est essentielle pour l’assurance qualité. Un modèle de transcription par lots comme Scribe v2 est donc le choix le plus pertinent dans ce scénario.
Les transcriptions de centre d’appels contiennent souvent des noms propres et des détails propres à un secteur. S’ils ne sont pas correctement transcrits, les analystes peinent à déterminer si un appel a réellement été concluant. Comme les modèles par lots traitent l’enregistrement entier en une seule fois, ils disposent du contexte nécessaire à une transcription et une mise en forme précises.
Scribe v2 propose plusieurs fonctionnalités pour améliorer la précision des transcriptions. La diarisation des locuteurs garantit que les agents et les clients sont toujours correctement identifiés, même lorsqu’ils parlent simultanément. L’amorçage par termes clés fournit au modèle les noms de marques et les termes sectoriels en amont afin qu’ils soient transcrits avec précision.
Les transcriptions de centre d’appels peuvent aussi contenir des informations sensibles à masquer, telles que des numéros de sécurité sociale ou de carte bancaire. Scribe v2 intègre la détection d’entités pour identifier et horodater ces informations sensibles afin que vous puissiez les supprimer.
Archive de podcasts : Transcription par lots
Pour constituer une archive de podcasts, vous avez besoin de transcriptions soignées auxquelles votre équipe et votre audience peuvent se référer à tout moment. La précision et une mise en forme claire sont essentielles : la transcription par lots est donc le bon choix.
Avec la transcription par lots, vous obtenez des transcriptions précises avec identification des locuteurs et diarisation pour tous vos fichiers de podcast. Scribe v2 propose également le mode non-verbatim, qui supprime automatiquement les tics de langage, les bégaiements et les répétitions. Vous consacrez ainsi moins de temps à l’édition manuelle et créez votre archive de podcasts plus rapidement.
ElevenAPI prend en charge nativement les modes en temps réel et par lots. Si vous gérez plusieurs projets de transcription simultanément, ElevenAPI vous permet de tous les piloter sur une même plateforme. Choisissez simplement le modèle adapté à chaque projet, sans devoir alterner entre différents fournisseurs de services.
Modèles de transcription hybrides : concilier temps réel et traitement par lots
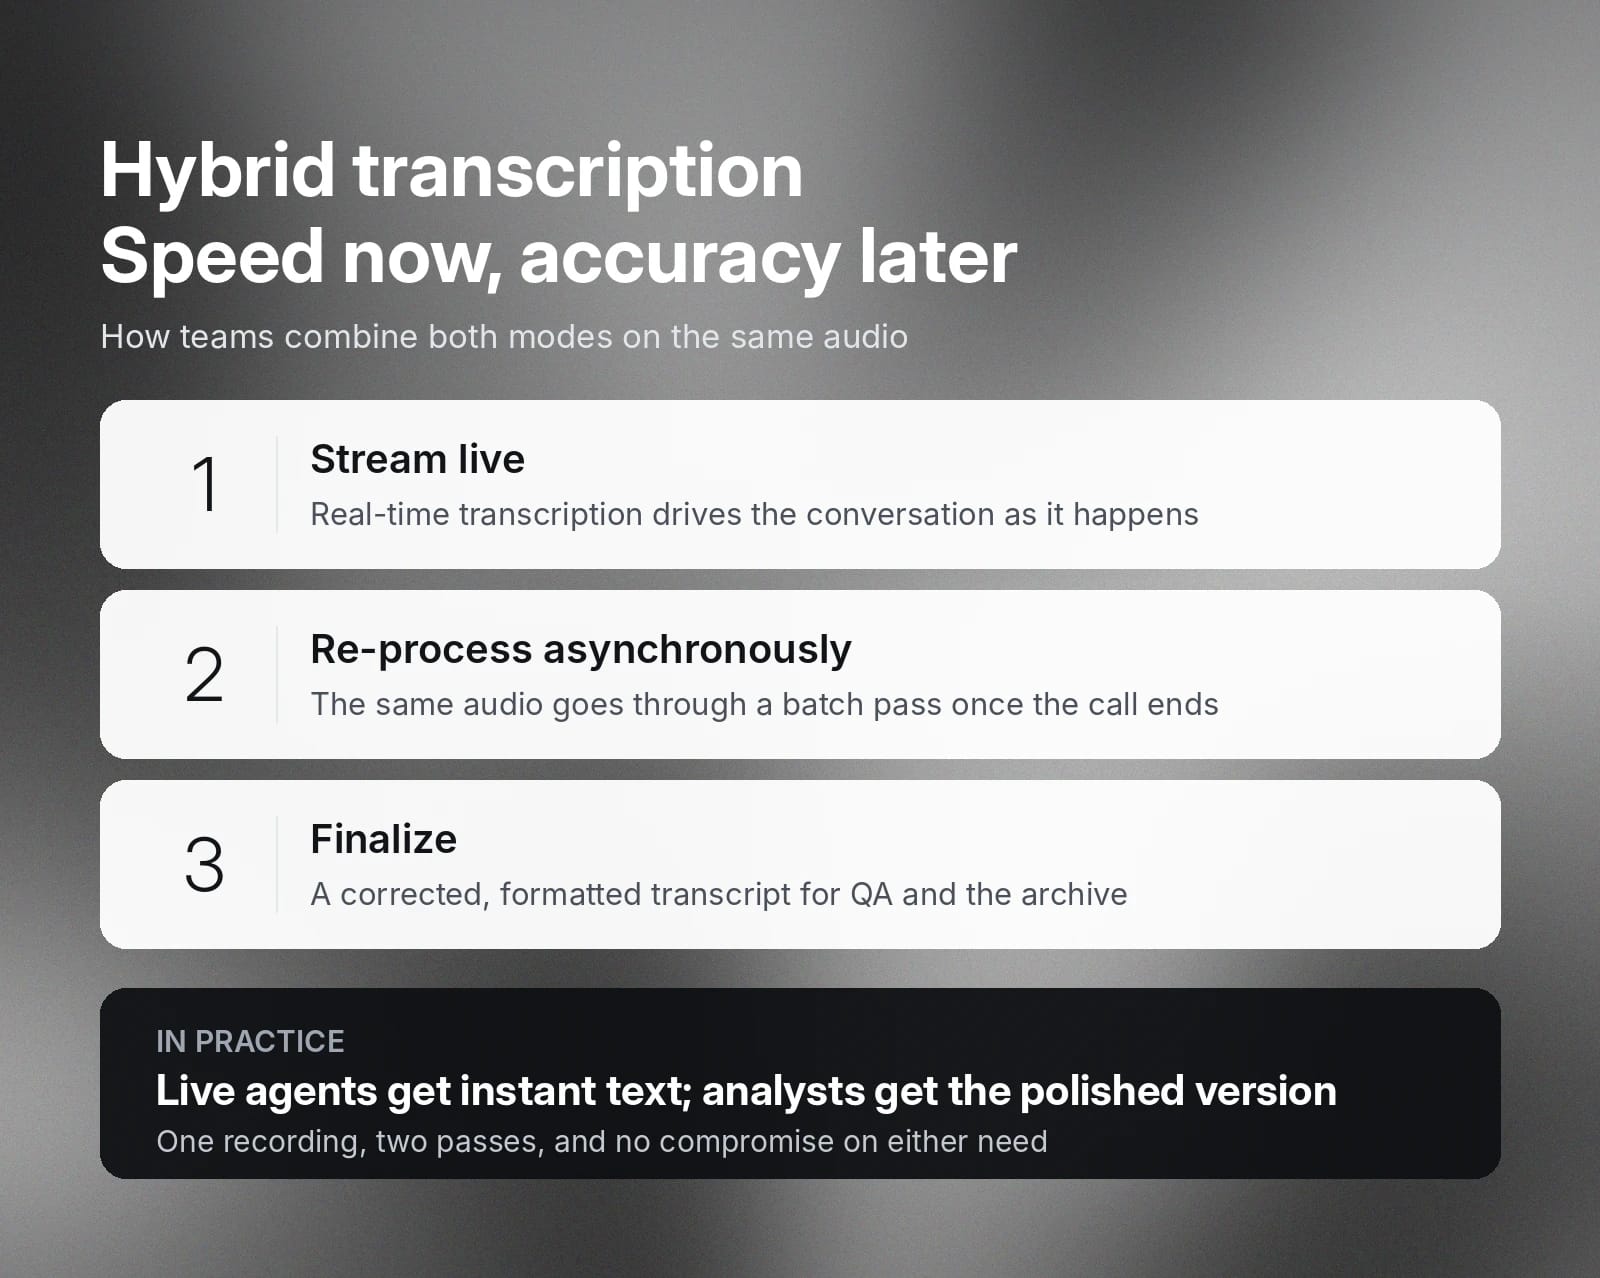
Les architectures de transcription hybrides combinent des modèles en temps réel et par lots afin d’équilibrer vitesse et précision.
Par exemple, une équipe de service client peut utiliser un modèle hybride pour obtenir un résultat immédiat lors de conversations en direct, puis améliorer la transcription pour l’assurance qualité et l’archivage. Les agents en direct utilisent la transcription en temps réel, puis envoient la transcription initiale à un modèle par lots pour un retraitement asynchrone.
Voici comment fonctionne ce flux :
Démarrez avec ElevenAPI pour des solutions de transcription flexibles
ElevenAPI propose des modèles en temps réel et par lots pour des transcriptions rapides et précises dans plus de 90 langues. Ses modèles de transcription offrent des résultats précis, même avec un audio de faible qualité, du bruit de fond ou des accents prononcés.
ElevenAPI propose des modèles en temps réel et par lots pour des transcriptions rapides et précises dans plus de 90 langues. Scribe v2 offre une grande précision de transcription, tandis que Scribe v2 Realtime garantit une précision remarquable pour les cas d’usage en direct. Tous deux fournissent des résultats fiables, même avec un audio de faible qualité, du bruit de fond ou des accents prononcés.
Les deux modèles sont disponibles sur une même plateforme pratique, afin de vous aider à construire une architecture de transcription adaptée à vos besoins. Découvrez l’API Speech to Text d’ElevenLabs en action ou créez une clé API pour commencer.



