
Tutoriel de reconnaissance vocale en Python : du fichier audio à la transcription
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Intégrer la reconnaissance vocale à une application Python était autrefois complexe. Les développeurs Python devaient coder eux-mêmes le processus de transcription, notamment le prétraitement audio, l’extraction de caractéristiques et l’intégration du modèle. À cela s’ajoutaient la gestion audio de bas niveau, une qualité de transcription insuffisante et les décalages entre les paroles et les sous-titres en direct.
Les progrès des modèles audio et des SDK de reconnaissance vocale changent la donne.
Dans ce tutoriel sur la reconnaissance vocale avec Python, vous apprendrez à intégrer les modèles audio ElevenLabs Speech to Text à votre projet Python pour créer des applications de transcription prêtes pour un usage commercial.
En résumé
- Les modèles Speech to Text commerciaux offrent des fonctionnalités telles que la diarisation des locuteurs, les horodatages au niveau des mots et l’orientation par termes clés, absentes des modèles de reconnaissance vocale de base.
- ElevenAPI apporte des capacités de reconnaissance vocale à votre code Python avec Scribe v2 et Scribe v2 Realtime.
- Les développeurs peuvent installer les skills ElevenLabs sur une plateforme de codage IA afin de générer du code Python précis à partir de la documentation officielle de l’API.
- Vous pouvez essayer gratuitement l’API ElevenLabs avant de souscrire un forfait payant pour le développement commercial.
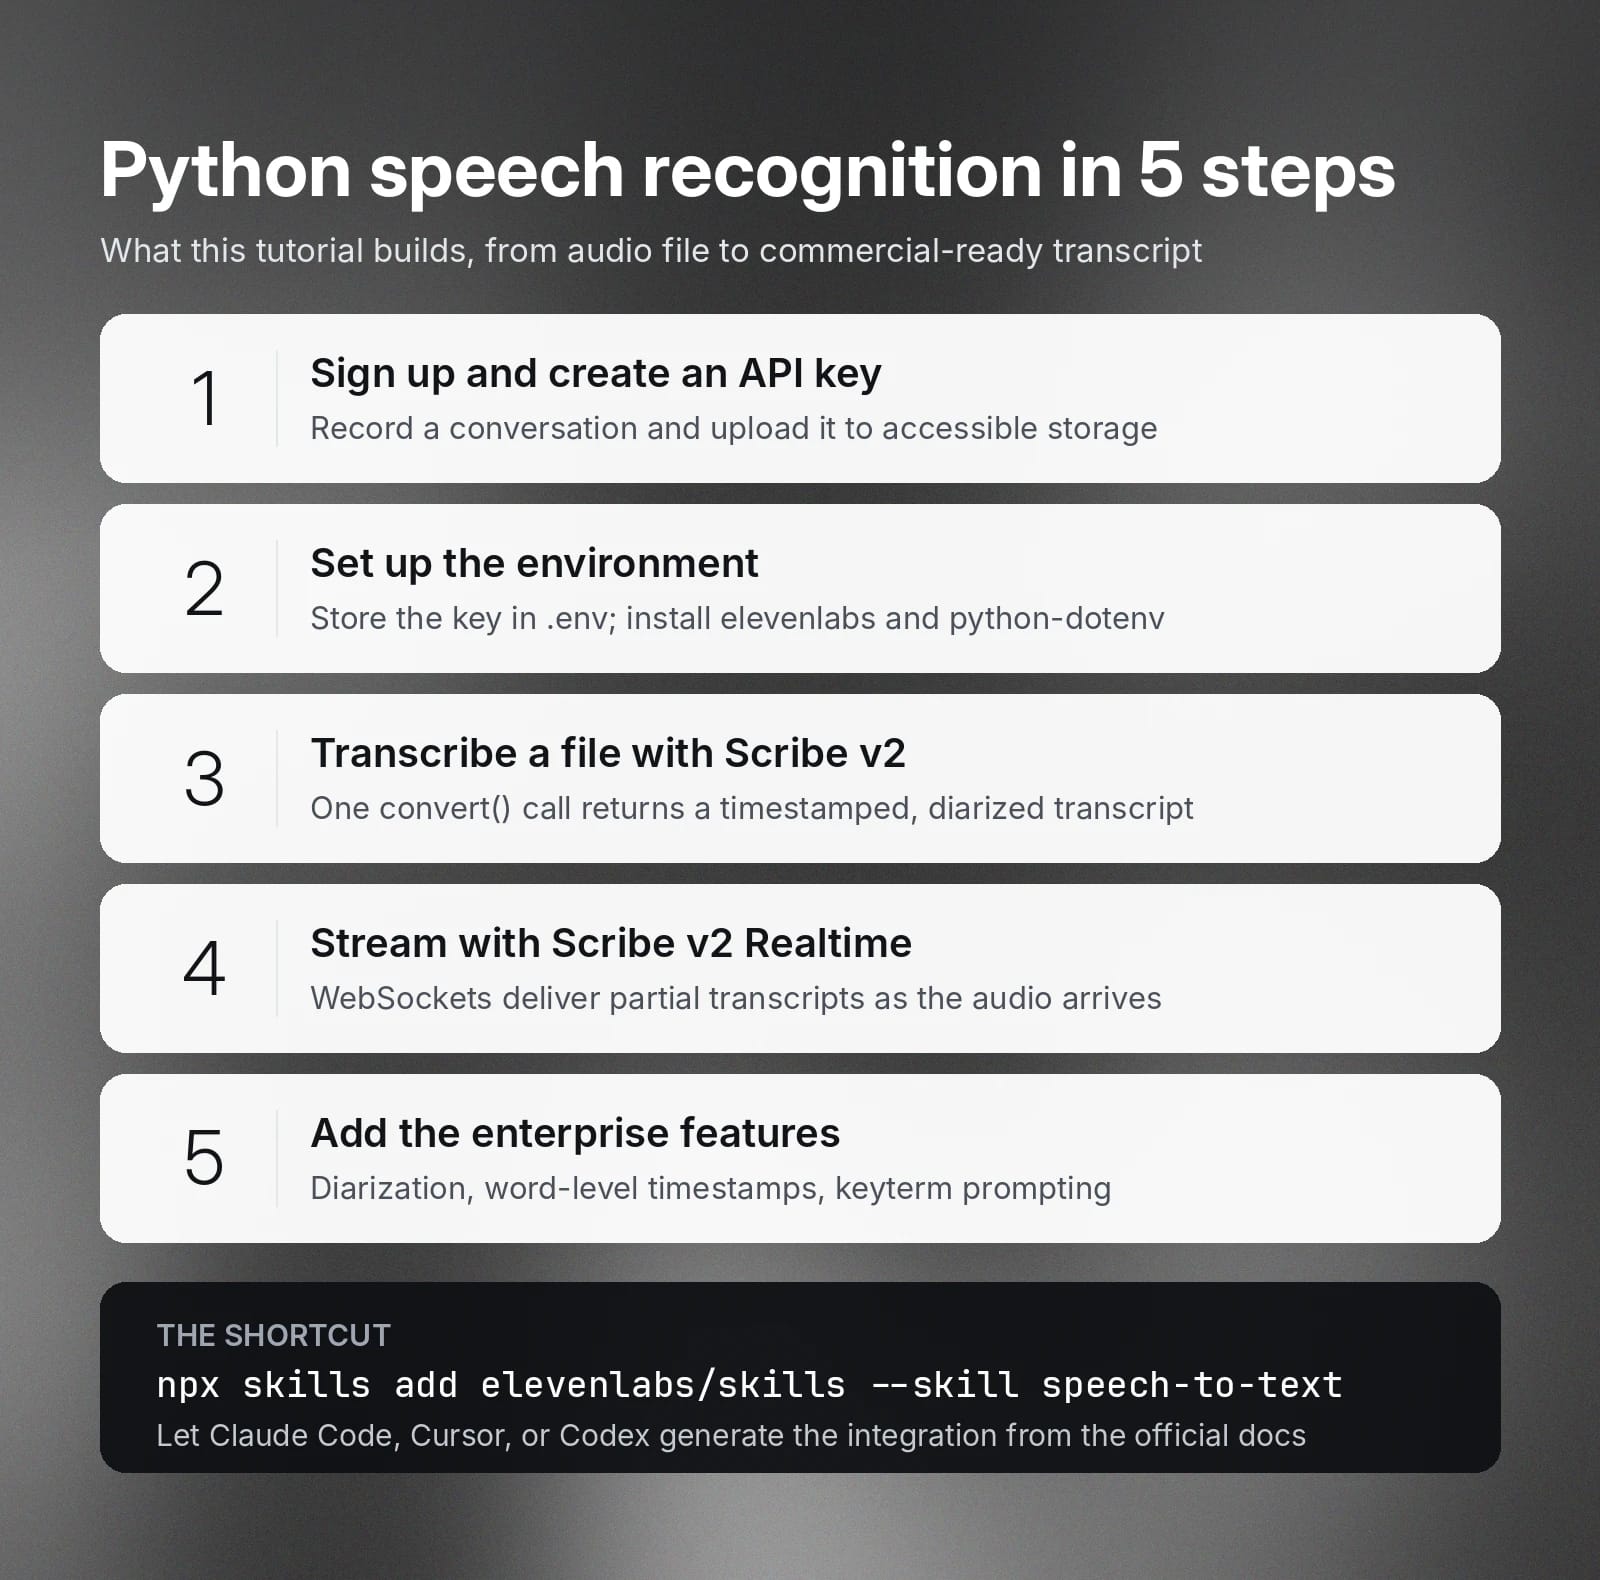
Ce que couvre ce tutoriel sur la reconnaissance vocale avec Python
Ce tutoriel présente les prérequis, l’intégration de l’API et des fonctions de transcription avancées pour créer une application Python de reconnaissance vocale adaptée aux cas d’usage en entreprise.
La reconnaissance vocale a beaucoup évolué ces dernières années, notamment grâce aux grands modèles de langage et aux réseaux neuronaux de deep learning, qui ont transformé l’utilisation des SDK de transcription par les développeurs Python. De nombreux tutoriels expliquent comment créer des applications de transcription basiques, mais peu abordent les fonctionnalités nécessaires à un produit prêt pour un usage commercial.
Nous avons rédigé ce tutoriel pour combler ce manque.
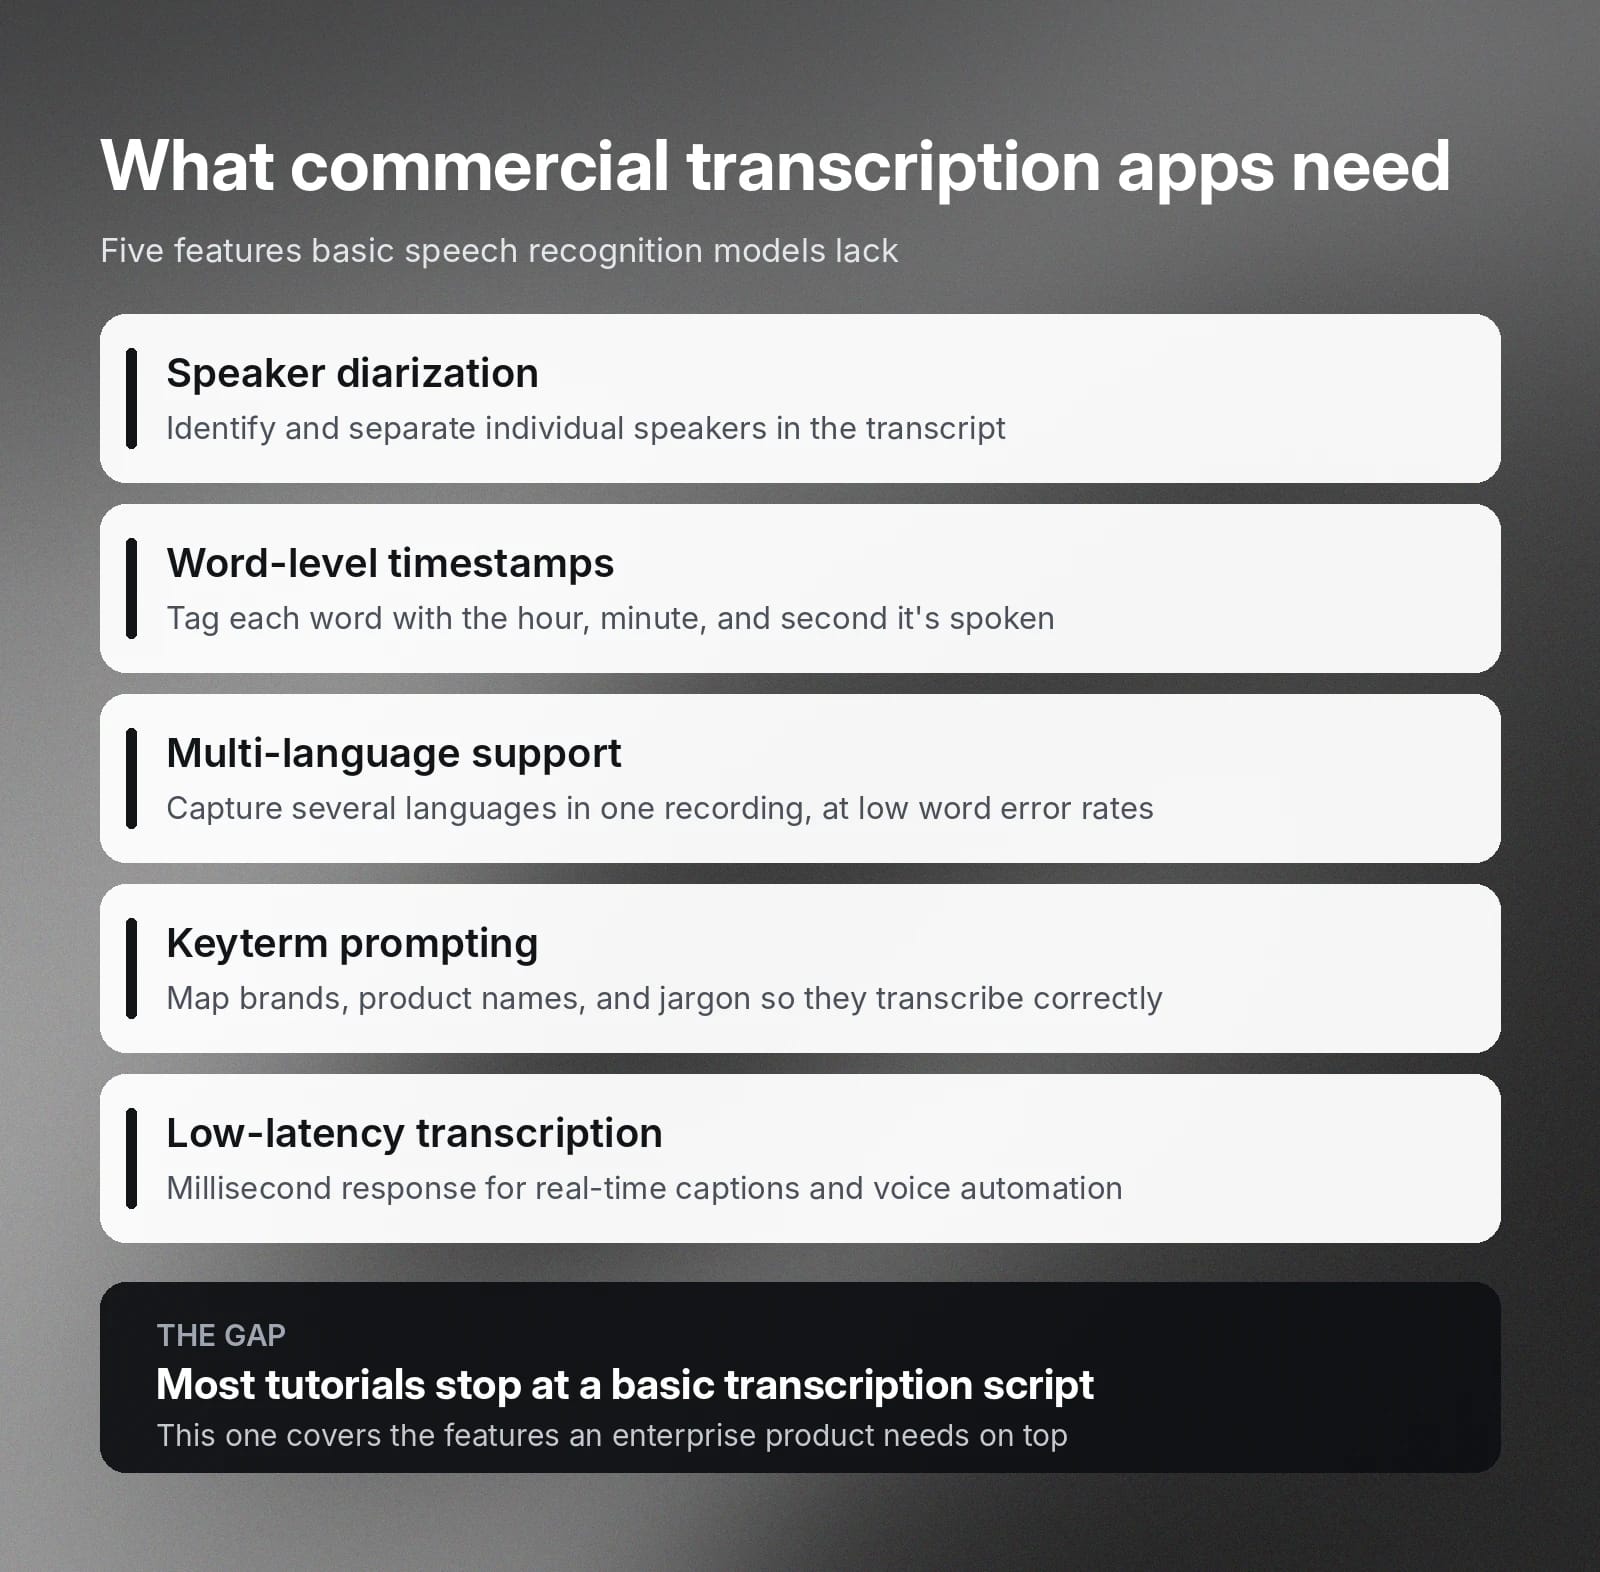
Par exemple, de nombreuses solutions de transcription en entreprise nécessitent les fonctionnalités suivantes :
- Diarisation des locuteurs : la capacité à identifier et séparer les différents locuteurs dans la transcription.
- Horodatage : l’attribution précise à chaque mot des heures, minutes et secondes auxquelles il est prononcé.
- Prise en charge multilingue : capture les paroles dans différentes langues au sein d’un même enregistrement ou flux en direct, avec un faible taux d’erreur sur les mots.
- Orientation par termes clés : l’indication de mots spécifiques, comme des marques, des noms de produits et des termes techniques, afin d’éviter les erreurs d’orthographe dans les transcriptions.
- Transcription à faible latence : une réponse de la parole au texte en quelques millisecondes pour alimenter des applications de transcription en temps réel.
Remarque : ce tutoriel ne se limite pas à générer de simples scripts personnels, destinés aux loisirs ou à des projets individuels. Il ne couvre pas la logique applicative construite sur l’intégration de l’API Speech to Text, car elle varie selon les entreprises.
Prérequis pour intégrer la reconnaissance vocale à Python
Ce tutoriel s’appuie sur ElevenAPI, une API ElevenLabs prête pour la production qui simplifie l’interaction avec les modèles vocaux dans votre code. Avec ElevenAPI, vous accédez à Scribe v2 et Scribe v2 Realtime, nos principaux modèles vocaux pour la transcription par lots et en direct.
Au lieu d’accéder directement aux modèles ElevenLabs Speech to Text, vous transmettez enregistrements audio, flux en direct et arguments par des appels API. Le modèle audio convertit alors les données audio en texte. Une fois l’opération terminée, vous recevez les transcriptions dans le code ou via un webhook.
Pour commencer, suivez ces étapes de préparation.
- S’inscrire à ElevenLabs.
- Créez votre clé API.
- Enregistrez une conversation et chargez-la dans un espace de stockage accessible publiquement.
Lorsque vous êtes prêt, passez à la section suivante.
Configurer votre environnement
Avant d’intégrer les modèles ElevenLabs, configurez votre environnement Python pour sécuriser votre clé API ElevenLabs. Comme pour toutes les clés API, nous recommandons de la stocker en tant que variable d’environnement, un secret géré, dans le fichier .env.
Lors d’un appel API, vous transmettez la variable d’environnement. Vous évitez ainsi d’exposer accidentellement la clé API lors de requêtes API effectuées sur un réseau public.
Exécutez ensuite une commande Bash pour installer elevenlabs, le SDK ElevenLabs, dans votre environnement Python. Le SDK vous permet d’accéder à différents modèles vocaux. Dans ce cas, vous choisissez entre Scribe v2 et Scribe v2 Realtime.
Vous devrez également installer python-dotenv, qui permet à votre code Python d’accéder aux variables d’environnement stockées dans le fichier .env.
Écrire votre premier script de transcription
Une fois l’environnement Python configuré, vous pouvez transcrire le fichier audio avec ElevenLabs Scribe v2.
ElevenLabs Scribe v2 est un modèle de reconnaissance vocale de référence qui vous permet de transcrire des fichiers audio à grande échelle. Il détecte les phonèmes avec une grande précision, même lorsque l’enregistrement audio contient beaucoup de bruit de fond. Pour transcrire l’audio, envoyez l’enregistrement au modèle via l’API ElevenLabs, puis récupérez la transcription terminée.
Voici un extrait de code Python qui convertit un fichier audio en transcription horodatée et avec diarisation.
Le code charge les bibliothèques nécessaires, qui fournissent les fonctions dont il a besoin. Il charge également les variables d’environnement que vous avez déclarées dans l’environnement du programme.
Il crée ensuite un client ElevenLabs à l’aide de la clé API stockée dans la variable d’environnement. Puis il télécharge le fichier audio et le convertit en données binaires.
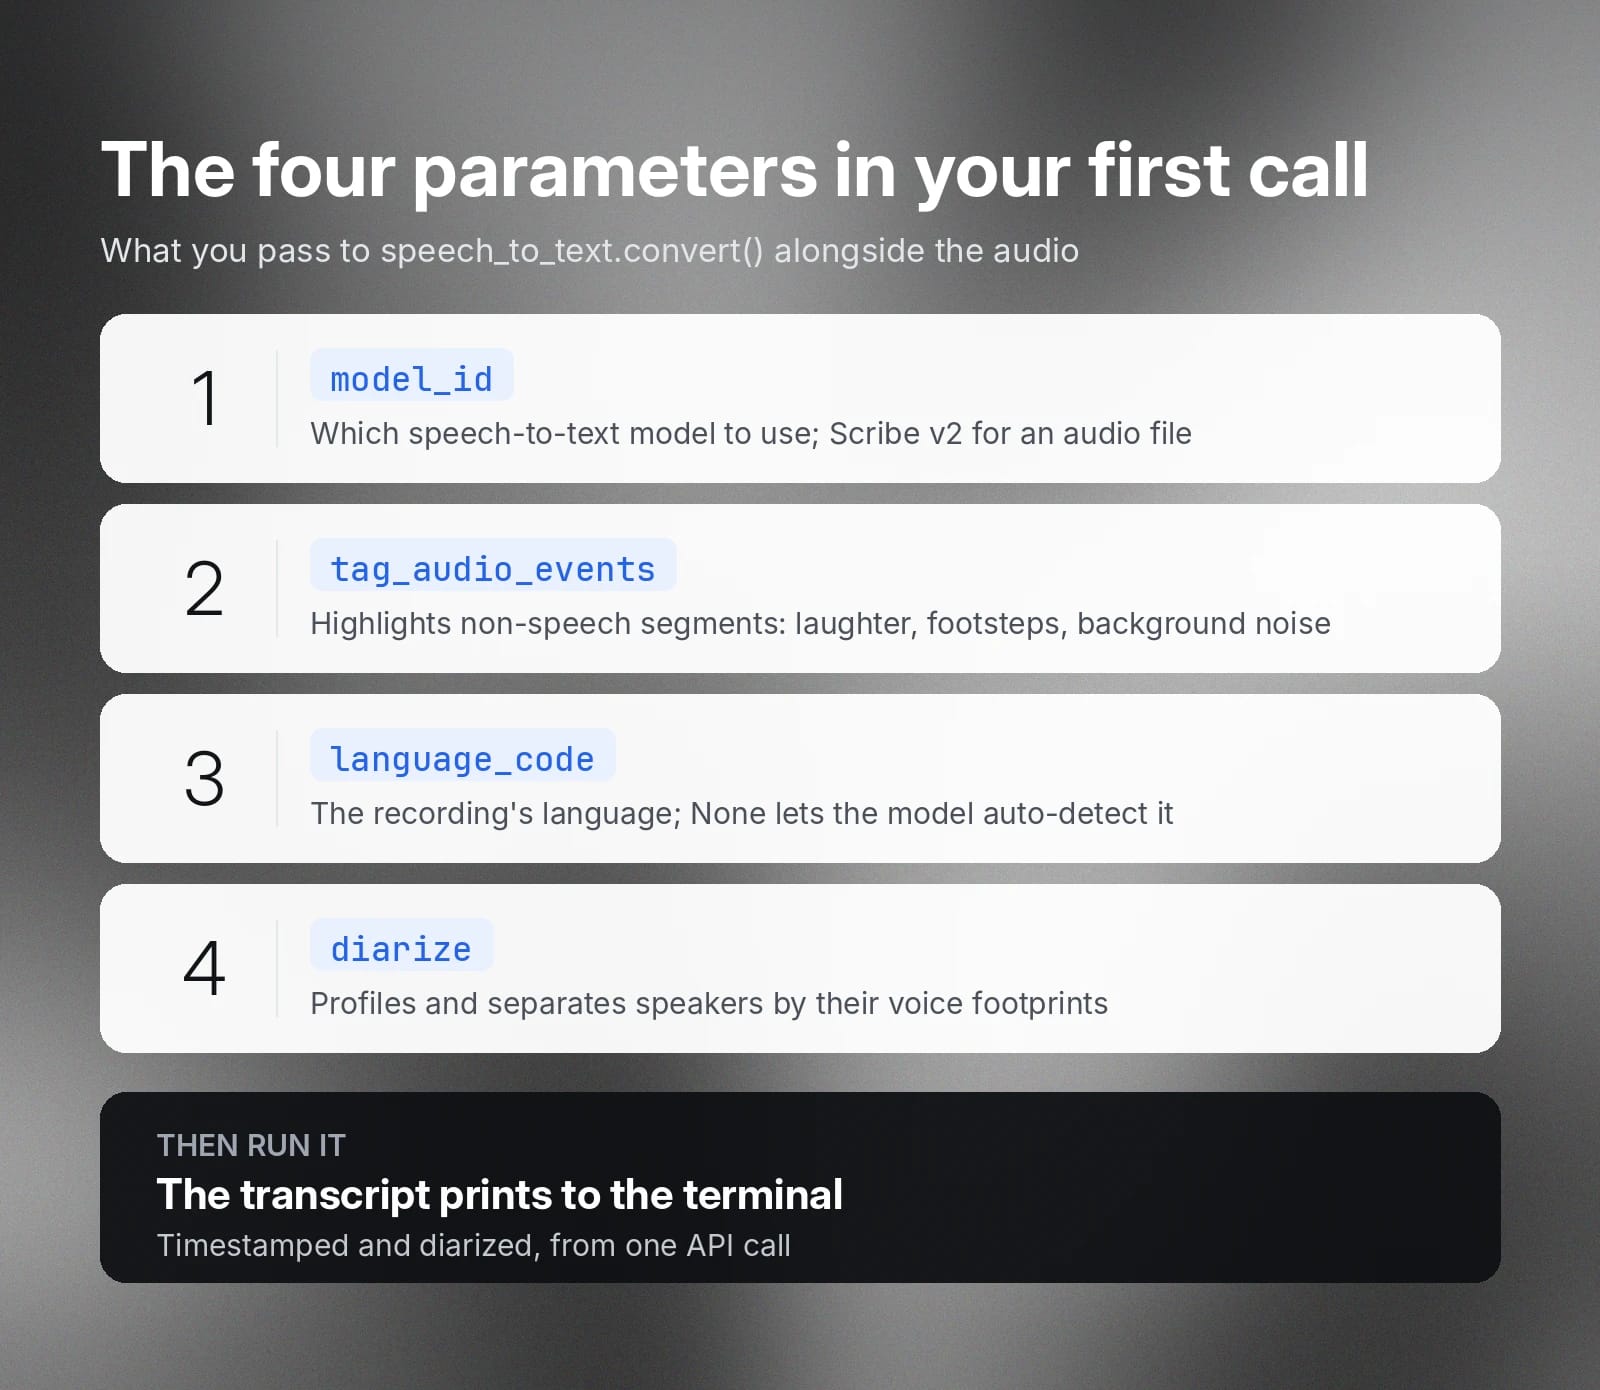
Une fois les données audio brutes obtenues, vous les envoyez à l’API ElevenLabs avec plusieurs paramètres.
- model_id indique le modèle de conversion de la parole en texte à utiliser. Comme vous transmettez un fichier audio, Scribe v2 est la meilleure option.
- tag_audio_events permet de signaler les segments sans parole, tels que les rires, les bruits de pas et les autres bruits de fond.
- language_code représente la langue des conversations du fichier d’enregistrement. Lorsqu’il est défini sur None, le modèle détecte automatiquement la langue.
- diarize indique si vous souhaitez que le modèle identifie et sépare les différents locuteurs d’après leurs empreintes vocales.
Enfin, exécutez le code pour afficher l’audio transcrit dans le terminal.
Reconnaissance vocale en streaming avec Python
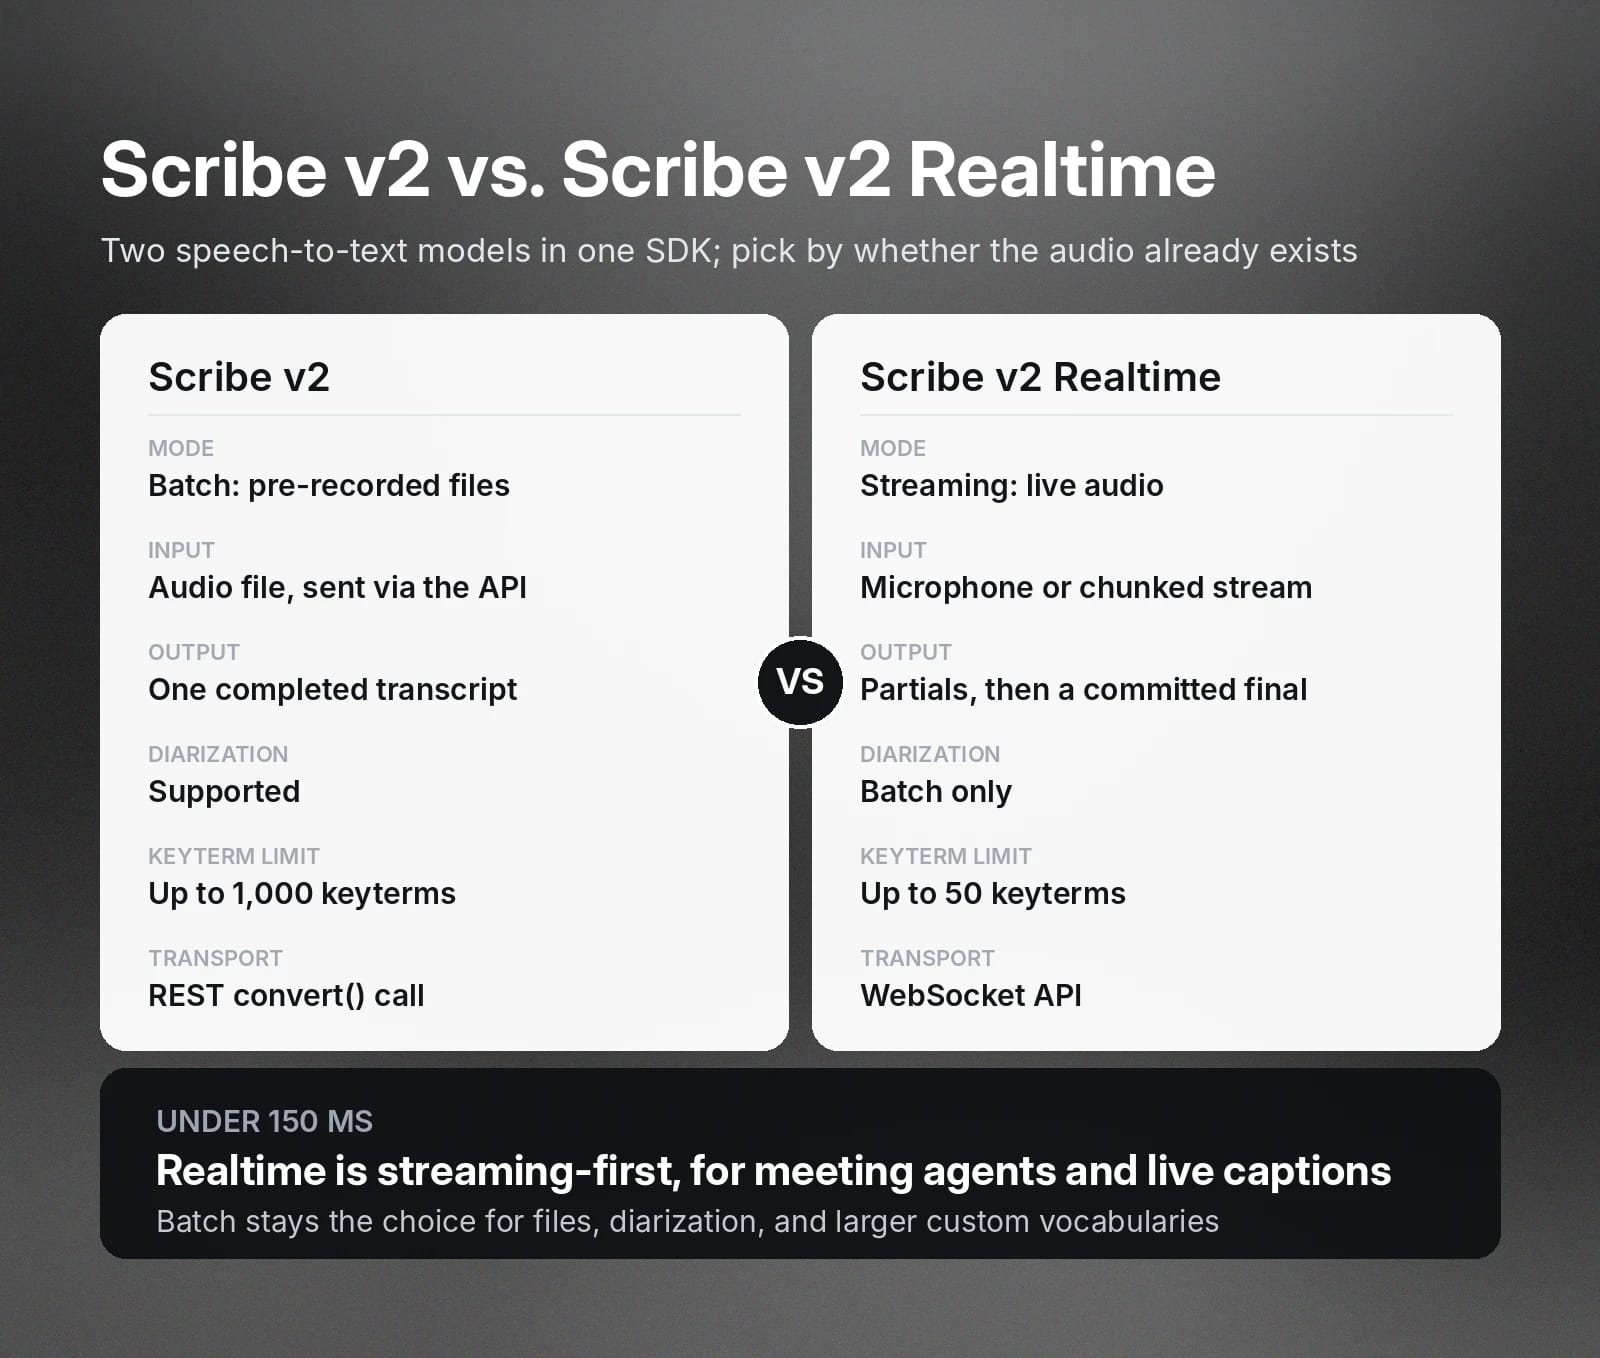
L’exemple ci-dessus couvre la transcription par lots, adaptée aux fichiers préenregistrés. Cependant, ElevenLabs fournit également des API pour créer une reconnaissance vocale en streaming. Contrairement au traitement par lots, ce mode exécute la reconnaissance vocale en temps réel afin de générer les transcriptions au fil de la conversation.
Pour cela, connectez votre code Python au modèle Scribe v2 Realtime via l’API WebSocket.
Scribe v2 Realtime offre une architecture pensée pour le streaming, avec une latence de transcription inférieure à 150 ms. Utilisez Scribe v2 Realtime pour créer des applications telles que des agents de réunion, des outils d’accessibilité et des automatisations activées par la voix. Le modèle renvoie une transcription partielle à mesure qu’il traite le flux audio. Il ne renvoie la transcription finale que lorsque le code valide un segment audio, automatiquement ou manuellement.
Selon votre source audio et le type d’application, vous intégrez la reconnaissance vocale à l’API ElevenLabs côté serveur ou côté client.
- Streaming côté client permet de diffuser l’audio directement depuis le microphone ou via des flux audio découpés manuellement.
- Streaming côté serveur achemine les données audio d’une URL ou d’une source audio vers le modèle vocal.
Le streaming côté client comme côté serveur vous permet d’utiliser un flux de travail asynchrone. Au lieu d’interroger continuellement l’API, utilisez des WebSockets pour traiter les résultats. Dans votre code, créez des gestionnaires qui reçoivent les transcriptions partielles et finalisées.
Aller plus loin : diarisation, horodatages et vocabulaire personnalisé
Au-delà de la reconnaissance automatique de la parole, les modèles ElevenLabs Speech to Text prennent en charge la diarisation, les horodatages et le vocabulaire personnalisé.
- Diarisation : seule la transcription par lots prend en charge la diarisation des locuteurs. Activez la diarisation en définissant l’argument diarize. En revanche, la transcription multicanale, un mode de transcription par lots, ne prend pas en charge la diarisation.
- Horodatages : lors d’une transcription par lots, vous pouvez choisir des horodatages au niveau des mots ou des caractères. Pour cela, définissez le paramètre timestamps_granularity lors de l’utilisation de la méthode convert.
- Vocabulaire personnalisé : la transcription en temps réel et par lots prend en charge l’orientation par termes clés. Cette fonctionnalité oriente le modèle vers la transcription de termes clés précis inclus dans une liste. Scribe v2 Realtime prend en charge jusqu’à 50 termes clés, contre 1 000 pour Scribe v2.
Utiliser le skill ElevenLabs dans les assistants de codage IA
Les assistants de codage IA accélèrent le développement. Si vous utilisez des outils tels que Claude Code, Cursor, Codex ou des outils de codage IA similaires, vous pouvez ajouter des skills ElevenLabs à votre environnement de développement.
Il vous suffit d’exécuter cette commande dans le terminal de votre plateforme :
L’agent de codage IA téléchargera le skill de conversion de la parole en texte depuis le dépôt GitHub d’ElevenLabs et l’installera dans le répertoire local des skills. Vous pourrez ainsi générer automatiquement du code Python pour la reconnaissance vocale à partir de la documentation officielle d’ElevenLabs, au lieu d’écrire toute l’intégration API depuis zéro.
Une fois installé, vous pouvez générer du code Python de reconnaissance vocale en décrivant simplement son fonctionnement en langage naturel. À partir de cette description, l’assistant de codage génère automatiquement le code avec le skill de conversion de la parole en texte, le bon modèle et les paramètres appropriés.
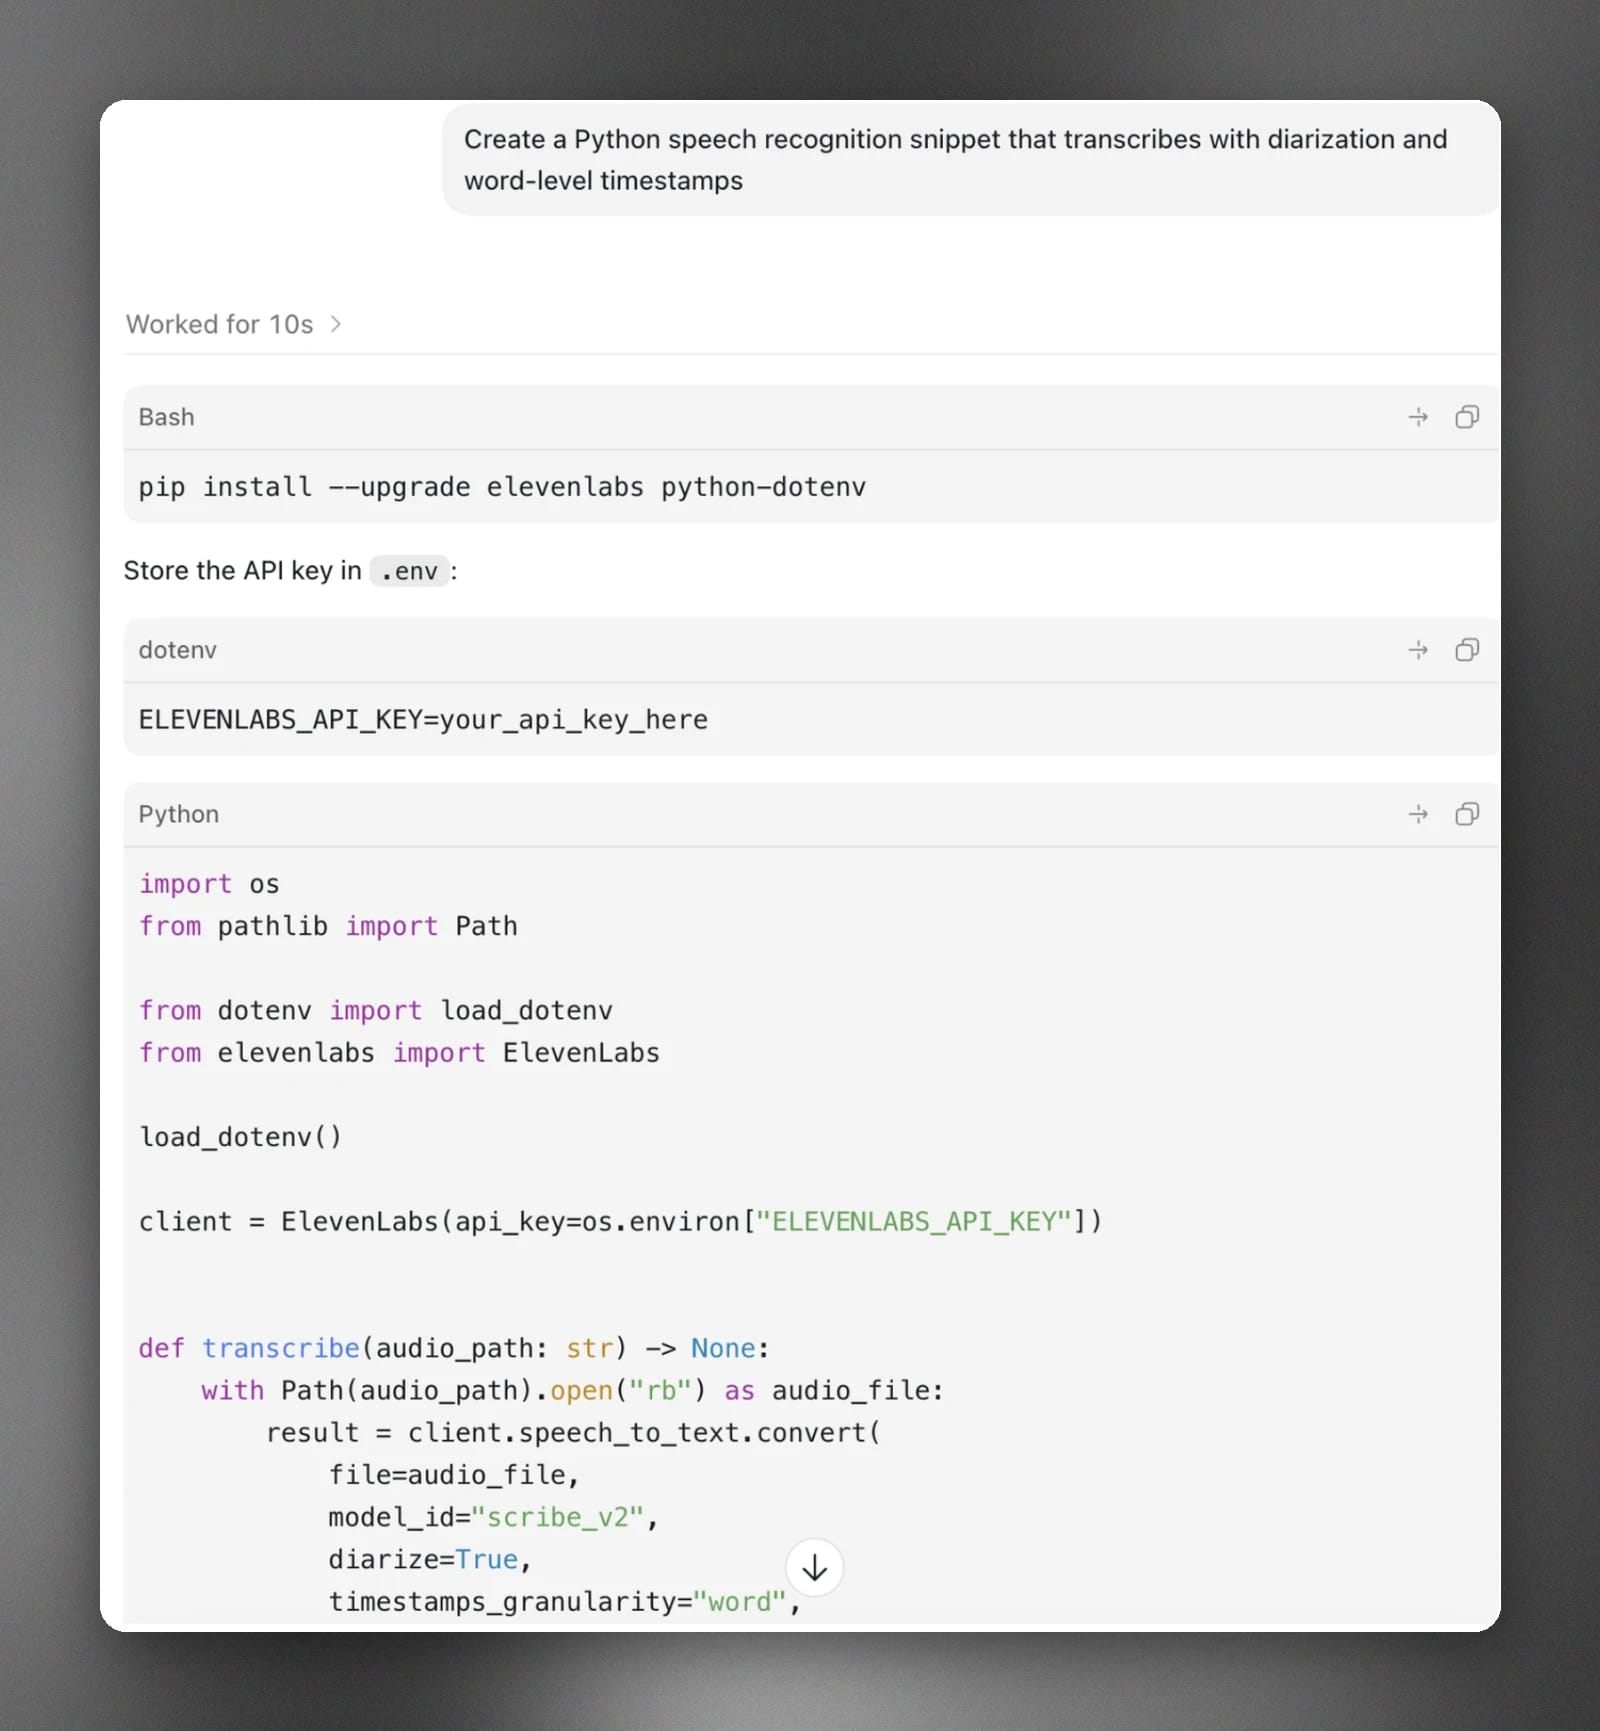
Par exemple, si vous saisissez dans Codex « Créez un extrait Python de reconnaissance vocale qui transcrit avec diarisation et horodatages au niveau des mots », vous obtiendrez un extrait similaire à celui ci-dessous.
Démarrer avec ElevenAPI pour la reconnaissance vocale
ElevenAPI vous permet d’accéder à des modèles Speech to Text avancés afin de créer des applications de reconnaissance vocale en Python.
Avec ElevenAPI, vous évitez d’écrire le code d’intégration depuis zéro, ce qui retarde l’innovation produit. Vous utilisez à la place des SDK qui exposent des services Speech to Text répondant aux exigences commerciales, notamment l’orientation par termes clés, la diarisation et les horodatages.
Obtenez votre clé API ElevenLabs dès maintenant et consultez notre documentation officielle pour comprendre le fonctionnement de l’API.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


