Qu’est-ce que la reconnaissance automatique de la parole (ASR) ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
En 1952, le système de reconnaissance vocale le plus avancé au monde comprenait exactement 9 mots.
Environ 75 ans plus tard, la reconnaissance automatique de la parole (ASR) transcrit des dizaines de langues en temps réel, des assistants vocaux de votre téléphone aux sous-titres qui s'affichent dans les vidéos en direct.
Ce guide explore la technologie qui a comblé l'écart entre les versions de 1952 et d'aujourd'hui : ce qu'est l'ASR, comment elle convertit la parole en texte et comment elle continue d'évoluer.
En résumé :
- ASR signifie reconnaissance automatique de la parole, la technologie qui convertit l'audio parlé en texte écrit.
- La première forme d'ASR est apparue en 1952 ; les systèmes de deep learning ont atteint les références humaines à la fin des années 2010.
- L'ASR moderne utilise des réseaux neuronaux de bout en bout entraînés sur des millions d'heures d'audio.
- Le taux d'erreur sur les mots (WER) est la mesure de précision standard, mais la latence, la qualité de la diarisation et la compréhension du contexte jouent également un rôle pour l'ASR en production.
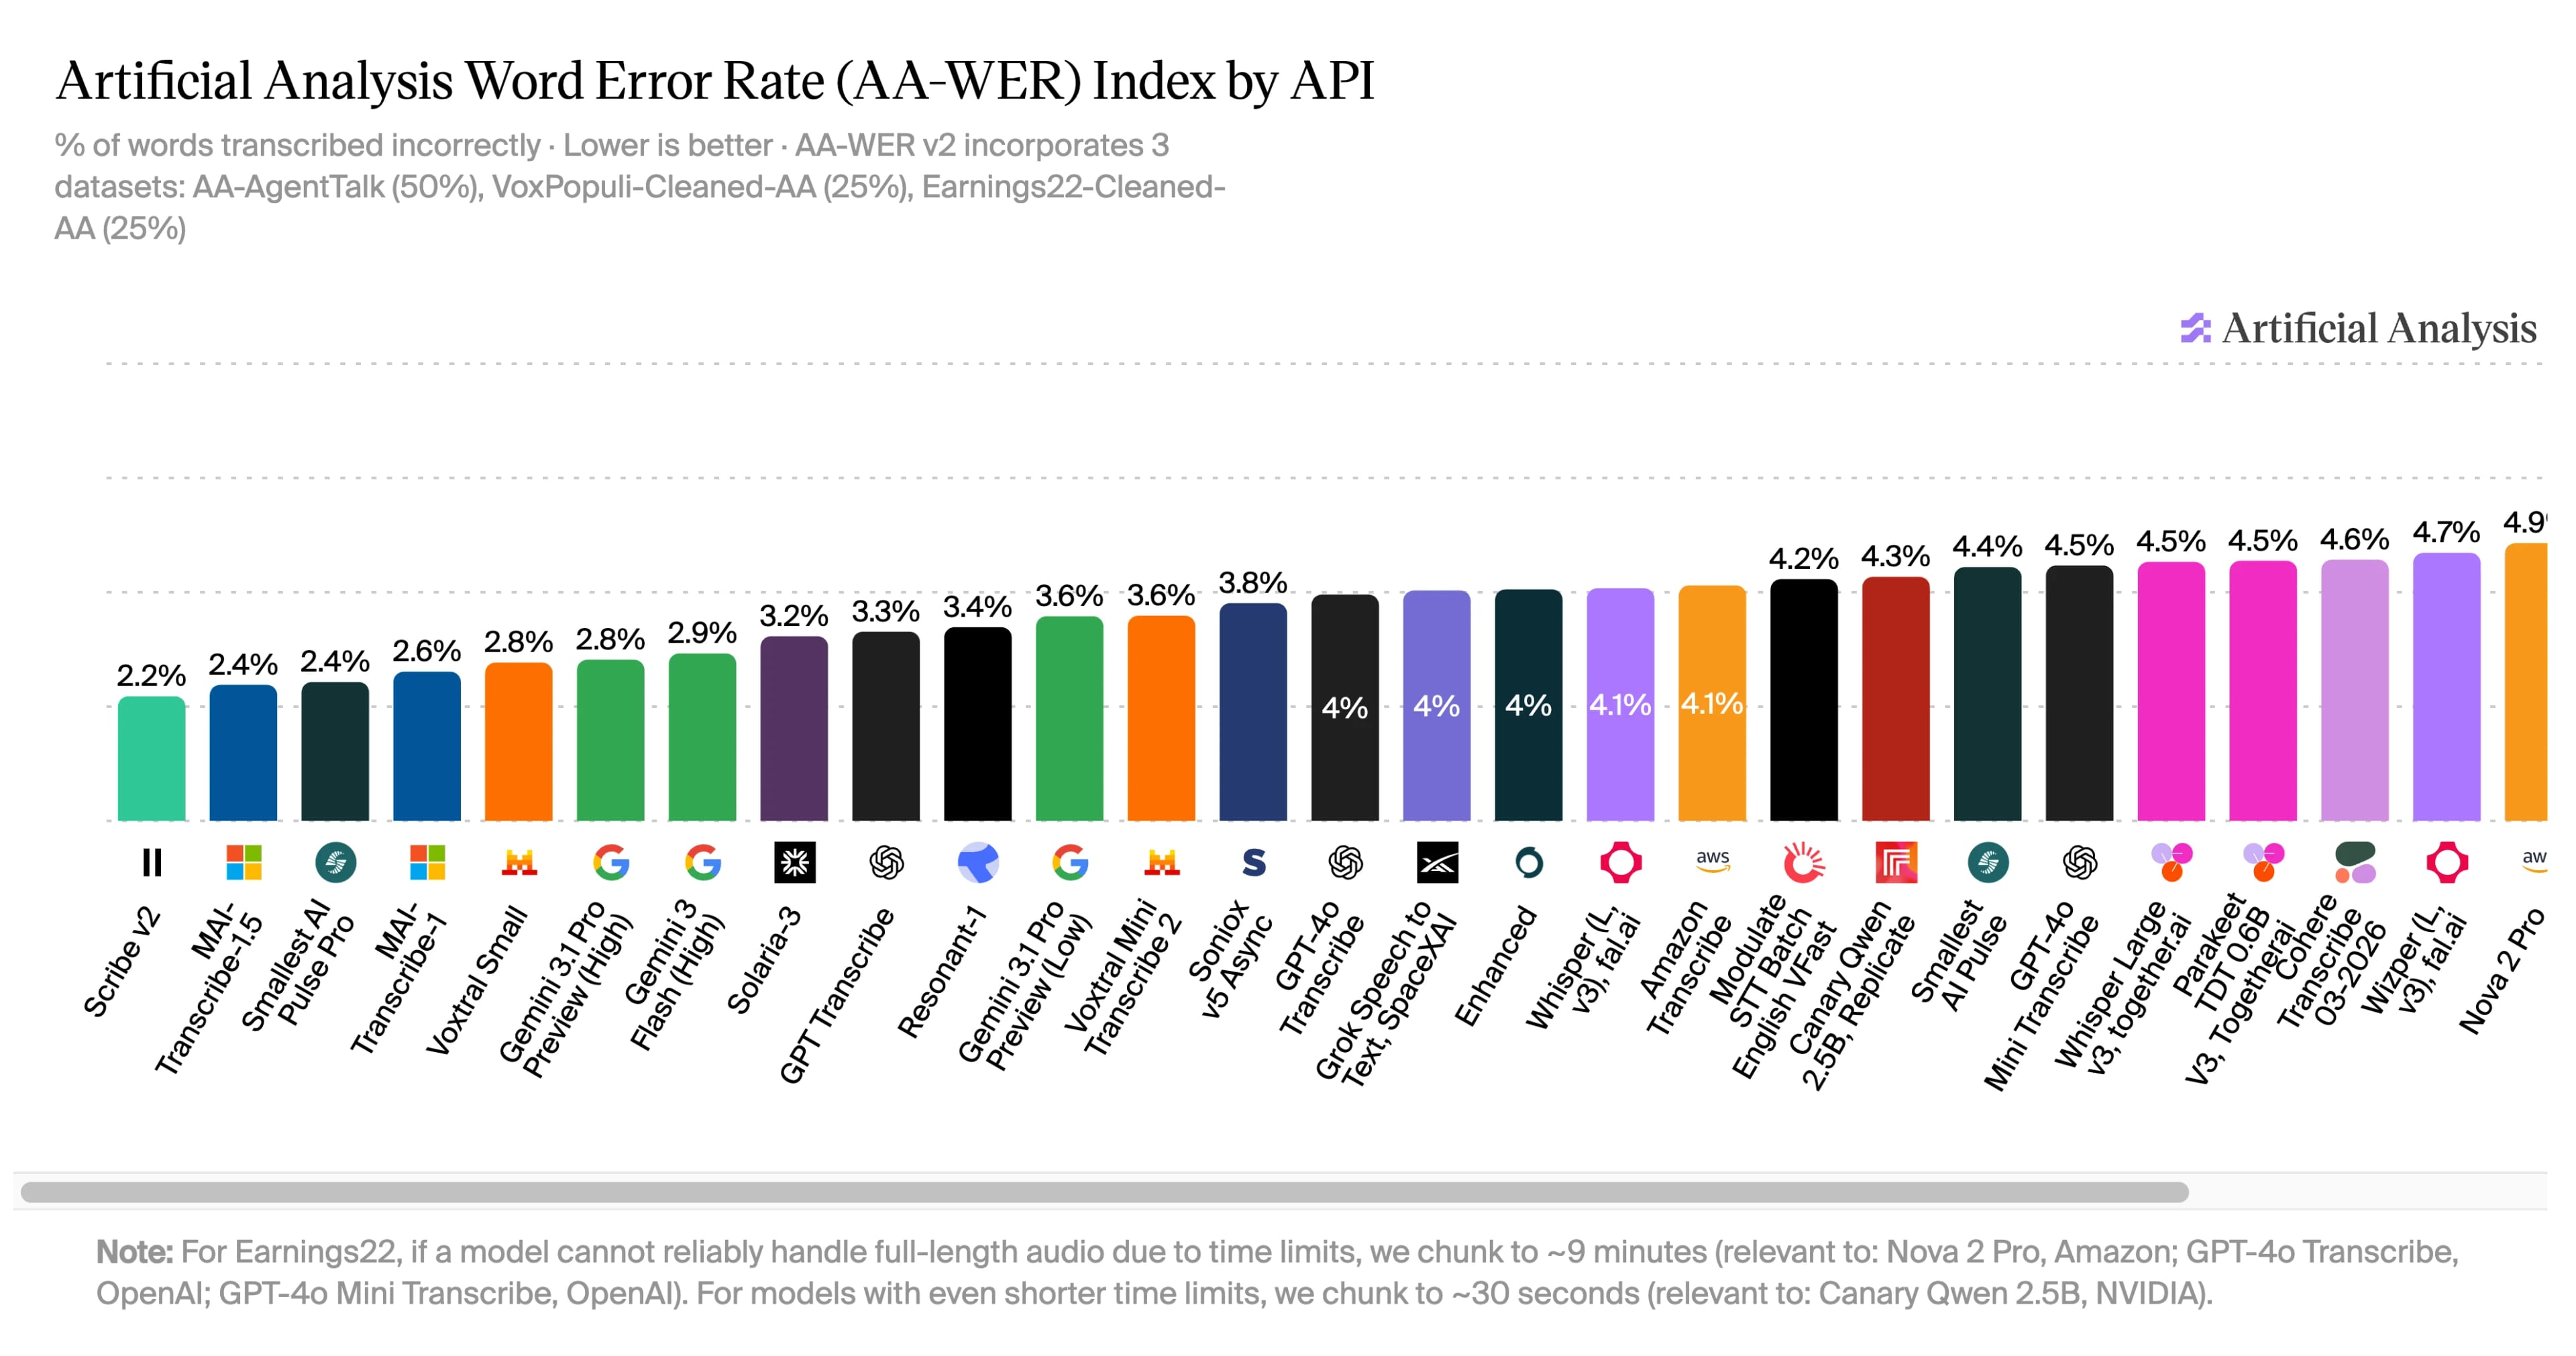
- ElevenAPI fournit aux développeurs une ASR prête pour la production, évaluée indépendamment par Artificial Analysis avec un taux d'erreur sur les mots de 2,2 %, le plus faible de son indice (juillet 2026).
Qu'est-ce que la reconnaissance automatique de la parole (ASR) ?
La reconnaissance automatique de la parole, souvent désignée par son seul acronyme ASR, décrit un logiciel qui écoute la parole humaine et la transforme en texte précis et exploitable par une machine. On l'appelle aussi couramment speech to text et reconnaissance de la parole, voire parfois reconnaissance vocale par ordinateur.
L'ASR est devenue si omniprésente que vous interagissez peut-être avec elle chaque jour sans même vous en rendre compte. Chaque fois que vous dictez un message, posez une question à un assistant vocal, lisez des sous-titres durant une vidéo en direct ou naviguez dans un système de réponse vocale interactive par téléphone, vous utilisez l'ASR.
Si speech to text et ASR sont souvent employés comme synonymes, et sont étroitement liés, ils ne désignent pas exactement la même chose. L'ASR est la technologie qui identifie ce qui est dit, tandis que le STT est l'application de cette technologie sous forme d'outil. Les logiciels de reconnaissance vocale s'appuient sur l'ASR pour identifier qui a prononcé un mot donné, ce qui constitue la base des capacités de diarisation des locuteurs.
Ces distinctions sont mineures, mais utiles à comprendre si vous souhaitez intégrer des systèmes d'ASR, de STT ou de reconnaissance vocale à vos applications ou votre site web.
Brève histoire de la reconnaissance automatique de la parole
La technologie de reconnaissance automatique de la parole est bien plus ancienne que la plupart des gens ne l'imaginent, ses premières versions remontant aux années 1950. En plus de 70 ans d'existence, l'ASR a traversé plusieurs étapes importantes qui ont largement posé les fondations de ses progrès historiques.
Voici les principales périodes traversées par la technologie ASR :
- 1952 et la première ASR : En 1952, l'Automatic Digit Recognizer, connu sous le nom de AUDREY, a été conçu par Bell Laboratories pour comprendre les chiffres de un à neuf. L'outil n'était précis qu'à environ 90 % et ne fonctionnait que s'il était utilisé par son inventeur, ce qui le limitait considérablement. Bien loin des capacités actuelles, le simple fait de reconnaître les chiffres de 1 à 9 restait une prouesse impressionnante.
- Des années 1960 aux années 1970 et l'élargissement du vocabulaire ASR : Au cours des décennies suivantes, des laboratoires du monde entier, notamment chez IBM, à l'University College London et chez NEC au Japon, ont produit des modèles semblables à AUDREY dans différents contextes. Raj Reddy, étudiant indien en doctorat à Stanford, a créé un système de reconnaissance des voyelles pour son projet de thèse, posant les bases de la reconnaissance continue de la parole sans pause entre les mots. La DARPA (Defense Advanced Research Projects Agency) a financé des recherches qui ont conduit à Beam Search, une méthode de construction et de décodage de phrases essentielle à la reconnaissance de plus de 1 000 mots en 1976.
- Des années 1980 au début des années 2010 et les avancées statistiques : En 1987, un étudiant de Raj Reddy, alors professeur, a combiné les modèles de Markov cachés à Beam Search, ouvrant la voie à des systèmes ASR ne nécessitant pas d'entraînement sur un locuteur spécifique. Cette avancée a considérablement réduit le temps d'entraînement des systèmes de reconnaissance de la parole. Dragon Systems a lancé en 1997 le premier système ASR commercial, NaturallySpeaking Preferred. Il pouvait reconnaître 100 mots par minute et s'est bien vendu.
- L'ère moderne et le deep learning : Dans les années 2010, des chercheurs ont démontré qu'un unique réseau neuronal entraîné de bout en bout sur des fichiers audio et leurs transcriptions surpassait une chaîne de traitement purement statistique. Avec l'arrivée des réseaux neuronaux profonds, les systèmes ASR ont atteint des performances proches de celles des humains, avec un taux d'erreur compris entre 5 % et 10 %. C'est alors que les assistants vocaux tels qu'Alexa et Siri sont arrivés sur le marché.
Depuis, l'ASR n'a cessé de gagner en précision et en adoption. En juillet 2026, une étude indépendante d'Artificial Analysis a identifié Scribe v2 d'ElevenLabs comme affichant un taux d'erreur sur les mots (WER) de seulement 2,2 %, le plus faible du secteur.
Comment fonctionne l'ASR ? Les bases de la technologie speech to text
L'ASR capture un échantillon audio, le convertit en représentation numérique, puis utilise un modèle entraîné pour prédire la séquence de mots la plus probable correspondant à ces données. L'ASR moderne réalise l'ensemble de ce processus de bout en bout en temps réel, en moins d'une seconde.
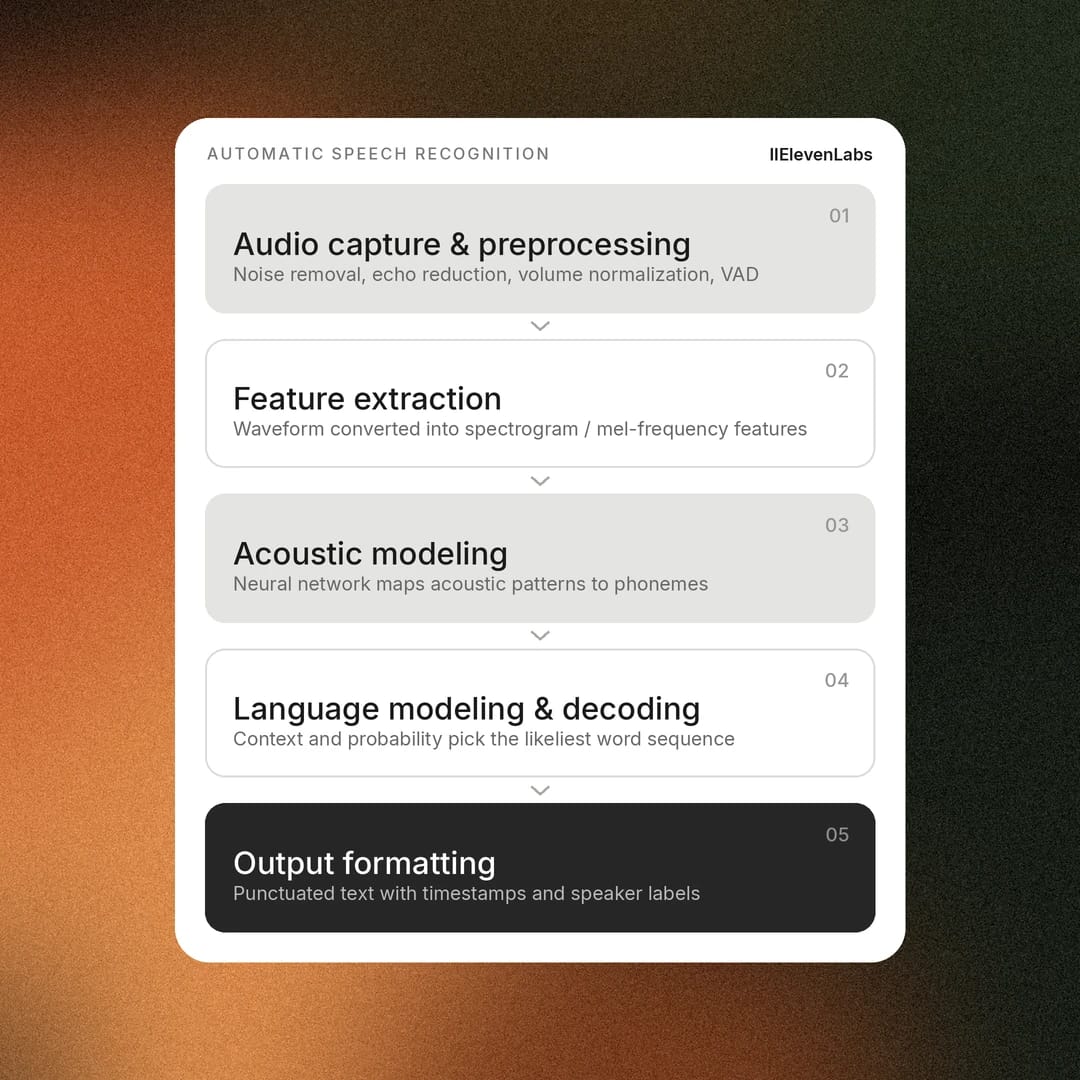
Une chaîne de traitement ASR comporte cinq étapes principales :
- Capture et prétraitement audio : Le système enregistre le signal audio, élimine le bruit de fond, réduit l'écho et normalise les niveaux de volume afin d'améliorer la cohérence. Selon le modèle, il peut utiliser la détection d'activité vocale (VAD) pour distinguer la parole du silence ou des sons de fond avant le début de la transcription.
- Extraction de caractéristiques : L'audio est converti en une représentation numérique, généralement un spectrogramme ou des caractéristiques de fréquence Mel, qui mettent précisément en évidence les fréquences et les motifs de la parole humaine. Cette étape transforme essentiellement une forme d'onde brute en données qu'un modèle de machine learning peut traiter efficacement.
- Modélisation acoustique : Un réseau neuronal analyse les caractéristiques de l'étape précédente et prédit des phonèmes ou d'autres unités de parole, en apprenant la relation entre les motifs acoustiques et la langue parlée. Les modèles modernes de bout en bout réalisent souvent cette étape conjointement avec la compréhension du langage, plutôt que comme une phase entièrement distincte.
- Modélisation et décodage du langage : Le système évalue ensuite les séquences de mots les plus probables à partir de règles telles que la grammaire, le contexte et la probabilité mathématique. Les deux derniers éléments sont essentiels : la transcription en API (Alphabet phonétique international) de deux phrases peut être similaire, alors que leur contexte est totalement différent. Par exemple, « Recognize Speech » et « Wreck a nice peach » peuvent sonner de la même façon, mais avoir des sens complètement différents. Le contexte aide le système à déterminer la bonne interprétation si sa précision ne suffit pas à trancher.
- Mise en forme de la sortie : Après avoir déterminé le contenu de la parole, le texte final est transcrit avec sa ponctuation et ses majuscules. Des métadonnées supplémentaires, telles que des horodatages au niveau des mots et des étiquettes de locuteurs, permettent de produire des transcriptions plus détaillées.
Tout au long de ces étapes, le modèle transforme les données audio entrantes en transcription écrite.
Systèmes hybrides traditionnels et ASR par deep learning de bout en bout
Si la chaîne ci-dessus décrit le fonctionnement de l'ASR, deux approches technologiques sont possibles pour sa partie centrale.
Les systèmes historiques enchaînent plusieurs composants : un modèle lexical qui encode la prononciation des mots, un modèle acoustique qui associe l'audio à des phonèmes et un modèle de langage qui prédit les séquences de mots probables. Chacun exige une expertise humaine, des linguistes qui élaborent les dictionnaires de prononciation aux annotateurs qui alignent chaque mot sur sa position exacte dans l'audio.
Le deep learning de bout en bout réunit tous ces composants dans un unique réseau neuronal. Le réseau associe directement l'audio au texte et comprend implicitement la prononciation, l'acoustique et les statistiques de probabilité du langage grâce à des millions d'heures d'audio et de transcriptions associés.
Examinons les différences entre les approches traditionnelles et modernes de la technologie ASR.
Comment mesurer la précision de l'ASR : références du taux d'erreur sur les mots (WER)
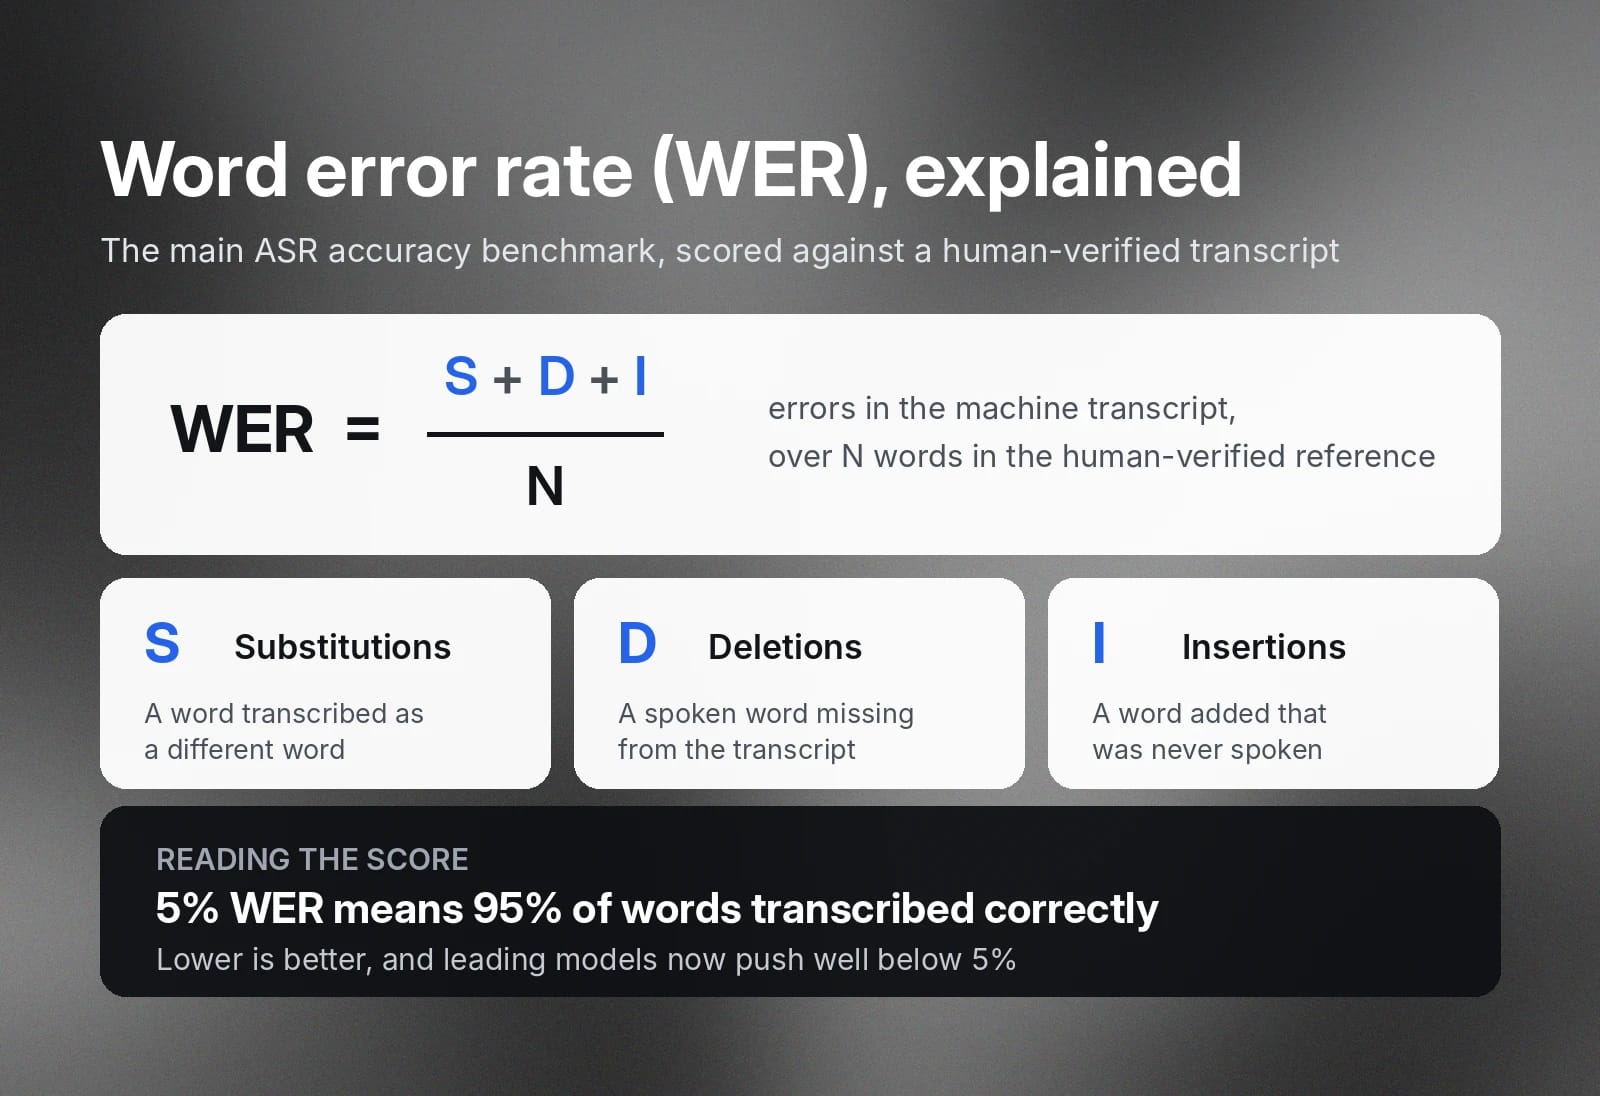
Pour tous les flux de travail speech to text et ASR, le taux d'erreur sur les mots (WER) est la principale mesure de précision utilisée par les entreprises. Il compare une transcription générée par machine avec une version vérifiée par un humain. Trois types d'erreurs sont pris en compte : les substitutions, les suppressions et les insertions.
La formule du WER divise le nombre total d'erreurs par le nombre de mots de la transcription de référence. Un WER de 5 % signifie que le système a transcrit correctement 95 % du texte, les principaux modèles passant désormais largement sous les 5 % pour se rapprocher de la perfection.
Si le WER est une référence utile, d'autres facteurs doivent aussi être pris en compte pour déterminer l'efficacité d'un outil ASR :
- Précision de la mise en forme : Le système peut-il mettre correctement en forme des chaînes non standard ? Par exemple, un montant comme 1 225 $ s'affiche-t-il ainsi ou est-il écrit « mille deux cent vingt-cinq dollars » ?
- Latence : La précision est importante, mais un outil qui met plusieurs minutes à produire une simple transcription devient inutilisable. Même s'il est extrêmement précis, il doit conjuguer cette précision avec une faible latence pour rester utile.
- Robustesse : Même des cas d'usage tels que des accents marqués ou des environnements bruyants ne devraient pas réduire significativement la précision du modèle.
- Qualité de la diarisation : Les cas d'usage avec plusieurs locuteurs dépendent de l'attribution correcte de chaque mot à la bonne personne. La capacité à identifier les différents locuteurs et à les étiqueter correctement contribue aux performances de l'ASR, en particulier dans les secteurs comptant de nombreux intervenants, comme les tribunaux.
Pour en savoir plus, consultez notre guide complet sur le taux d'erreur sur les mots.
Principaux avantages de l'ASR pour les entreprises modernes
Le marché mondial de la reconnaissance de la parole et de la voix devrait dépasser 23,11 milliards de dollars d'ici 2030. Son taux de croissance annuel composé de 19,1 % reflète l'adoption généralisée de cette technologie dans les appareils commerciaux. Tous les téléphones mobiles modernes disposent d'un clavier de dictée et d'un assistant vocal, la plupart des voitures neuves répondent aux commandes vocales, et les enceintes ou assistants intelligents sont désormais présents dans les foyers du monde entier.
Interagir avec la technologie par la voix est désormais une option par défaut pour les clients. Pour les entreprises, l'ASR couvre aussi bien la transcription des appels clients que l'assistance par agent vocal, s'intègre aux processus et stimule la productivité.
Voici quelques-uns des principaux avantages de l'ASR pour les entreprises modernes :
- Saisie et documentation plus rapides : Il y a déjà plus de 10 ans, Stanford a publié une étude démontrant que la reconnaissance de la parole était presque trois fois plus rapide que la saisie au clavier, tout en affichant un taux d'erreur inférieur. Pour la grande majorité des personnes, l'ASR accélère la documentation des flux de transcription et la prise de notes par la voix.
- Réduction des coûts opérationnels : Dans de nombreux cas d'usage qui exigeaient autrefois des heures de prise de notes manuelle, l'ASR réduit considérablement le coût d'une transcription de haute qualité. Les affaires judiciaires, centres de contact, cliniques et réunions professionnelles peuvent désormais s'appuyer sur des systèmes ASR précis pour créer des notes détaillées et des transcriptions complètes avec diarisation.
- Accessibilité accrue : L'Organisation mondiale de la Santé prévoit que 2,5 milliards de personnes vivront avec une forme de perte auditive d'ici 2050. Les sous-titres en temps réel fournis par des outils ASR avancés peuvent rendre les réunions et médias numériques accessibles aux utilisateurs.
- Données vocales consultables : Lorsque vous transcrivez automatiquement la parole avec l'ASR, chaque interaction entre client et entreprise est intégralement enregistrée. Chaque appel commercial, ticket de support, appel de prospect ou réunion devient un texte consultable et auditable. À l'ère de l'IA, faire émerger le contexte dans un format exploitable par une machine peut aider à constituer de vastes bases de connaissances. Que ce soit pour la fonctionnalité ou la conformité, les informations restent ainsi visibles.
- Expériences client disponibles en continu : L'ASR fournit l'une des technologies fondamentales des agents vocaux, permettant des cas d'usage de support automatisé qui résolvent les appels clients 24 h/24, 7 j/7, 365 jours par an.
La reconnaissance automatique de la parole est si répandue dans la technologie en raison de ses nombreux avantages et de l'étendue des cas d'usage qu'elle prend en charge. Que vous exerciez dans le secteur médical ou souhaitiez transcrire des appels clients pour analyser les sentiments, l'ASR est une technologie fondamentale que vous intégrerez à vos activités.
Applications courantes de l'ASR dans tous les secteurs
La reconnaissance automatique de la parole est une technologie centrale dans d'innombrables flux de travail et produits. Elle est devenue si omniprésente que les utilisateurs ne pensent souvent même pas à la façon dont elle s'intègre à la technologie qu'ils utilisent.
Voici un aperçu rapide de quelques cas d'usage courants de l'ASR dans le monde.
Service client et centres de contact
Les centres de contact ont adopté l'ASR très tôt pour transcrire les appels à des fins d'assurance qualité et de conformité. Aujourd'hui, l'ASR peut fonctionner en temps réel, fournir des suggestions aux agents en pleine conversation et transformer des milliers d'interactions clients en données analysables par les équipes.
Médias et divertissement
Les diffuseurs et plateformes de streaming peuvent utiliser l'ASR pour générer des sous-titres et légendes de conversations humaines à une échelle que les transcripteurs humains ne pourraient jamais atteindre. Elle permet la transcription en temps réel tout en rendant les bibliothèques vidéo et audio entièrement consultables.
Santé
Le personnel clinique consacre une part étonnamment importante de sa journée à la documentation et à la saisie de dossiers. L'ASR permet de récupérer ce temps, en donnant aux médecins une plateforme de STT médical à laquelle ils peuvent dicter leurs notes en temps réel.
Réunions virtuelles
Les plateformes de réunion proposent souvent une forme de prise de notes numérique pour transcrire les conversations au fil de l'eau, afin que personne n'ait à choisir entre participer et prendre des notes. Des services comme Google Meet envoient même ces transcriptions après chaque réunion, avec les actions à réaliser mises en évidence, ce qui aide à créer un index d'informations consultable.
Droit et conformité
Dans le domaine juridique, enregistrer avec précision ce qui a été dit et par qui est une exigence fondamentale au tribunal. Les cabinets d'avocats utilisent des plateformes ASR pour transcrire leurs réunions, audiences, appels clients et sessions judiciaires avec des horodatages précis, afin de pouvoir s'y référer ultérieurement.
Éducation
Les enseignants universitaires peuvent fournir une transcription enregistrée de leurs cours afin d'aider les étudiants à conserver une trace des enseignements suivis. Pour comprendre et mémoriser les informations, les étudiants disposent ainsi d'une ressource complète.
La place de l'ASR dans la chaîne de traitement d'un agent vocal
L'ASR est un composant standard de nombreux déploiements technologiques. Dans la technologie des agents vocaux, elle constitue la première de trois grandes étapes qui s'exécutent en boucle continue.
- Écouter (ASR) : L'agent capture les flux audio entrants et convertit la parole en texte en temps réel. L'ASR moderne traite continuellement l'audio à son arrivée, filtre le bruit de fond, gère les interruptions, produit des transcriptions partielles et identifie le moment où chaque personne parle.
- Réfléchir (modèle de langage) : Un grand modèle de langage interprète la transcription, comprend l'intention de l'utilisateur, récupère des informations depuis des outils et bases de connaissances connectés, maintient le contexte conversationnel et détermine la réponse ou l'action la plus appropriée.
- Parler (text to speech) : Un modèle de text to speech convertit la réponse générée par le LLM en audio naturel et expressif. Les systèmes TTS modernes peuvent ensuite ajuster le rythme, l'intonation, l'émotion et l'accentuation tout en diffusant l'audio généré à l'appelant, sans attendre la réponse complète.
La latence conversationnelle s'accumule à chacune de ces étapes. L'ASR en streaming commence à produire les mots dès qu'ils sont prononcés, sans attendre la fin d'une énonciation, afin de réduire la latence. ElevenAgents applique cette approche comme standard pour les agents vocaux en temps réel, afin de créer une expérience agent très efficace.
Défis de l'ASR et évolution de la technologie
Si la technologie ASR a beaucoup progressé depuis ses origines en 1952, plusieurs défis susceptibles de réduire sa précision subsistent.
Voici quelques problèmes que les outils ASR rencontrent encore aujourd'hui :
- Accents et dialectes : Les données d'entraînement disponibles se concentrent généralement sur un petit nombre de langues et d'accents, ce qui complique la tâche des outils ASR face aux accents moins courants ou aux langues moins parlées. Des jeux de données riches et diversifiés constituent la solution.
- Bruit de fond et chevauchement des locuteurs : Les environnements aux volumes variables ou au bruit de fond intense rendent plus difficile l'identification de chaque mot dans un enregistrement. Le chevauchement des locuteurs peut avoir un effet similaire et réduire la précision d'une transcription ASR.
- Vocabulaire spécialisé : Les domaines qui utilisent un jargon ou des acronymes spécifiques ont besoin de dictionnaires et de références spécialisés pour améliorer la précision. La médecine et le droit sont deux domaines dans lesquels les outils ASR nécessitent une aide supplémentaire ou un entraînement spécialisé.
- Confidentialité et sécurité : Dans de nombreuses juridictions, les données vocales sont considérées comme des données personnelles. Les entreprises ont besoin de politiques de conservation claires et de garde-fous pour protéger le traitement des données vocales et assurer la conformité aux réglementations applicables.
Lors du travail avec la technologie ASR, la latence par rapport à la précision constitue une autre considération majeure. Certains cas d'usage exigent un équilibre entre les deux, tandis que des domaines comme la médecine privilégieront probablement la précision avant tout.
Commencez avec ElevenAPI pour intégrer une ASR prête pour la production
ElevenAPI apporte la reconnaissance automatique de la parole prête pour la production à votre produit grâce à Scribe v2, le modèle Speech to Text d'ElevenLabs. Scribe v2 fournit des horodatages au niveau des mots, la diarisation des locuteurs, le balisage des événements audio, ainsi que la précision et la fiabilité nécessaires aux applications en temps réel.
Découvrez la page ElevenLabs Speech to Text pour en savoir plus ou créez un compte gratuit pour faire fonctionner une API en quelques minutes.
FAQ sur l'ASR

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.