Taux d’erreur sur les mots (WER) : concepts clés, formule et usages
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
En théorie, le taux d’erreur sur les mots (WER) est une métrique permettant de déterminer la précision d’un outil de reconnaissance vocale automatique (ASR). Un WER faible indique que votre transcription finale est plus précise, tandis qu’un taux d’erreur élevé révèle des informations mal transcrites.
En pratique, le WER peut faire la différence entre un logiciel de transcription médicale qui indique qu’un patient doit prendre « quinze milligrammes » plutôt que « cinquante milligrammes » d’un médicament. C’est aussi la différence entre un outil d’assistance qui transcrit fidèlement les besoins d’un client et un autre qui laisse vos utilisateurs frustrés.
Dans cet article, nous expliquons ce qu’est le WER, comment le calculer et comment l’utiliser pour évaluer votre propre fournisseur ASR.
En résumé
- Le taux d’erreur sur les mots comptabilise trois types d’erreurs, substitutions, suppressions et insertions, puis les divise par le nombre de mots de la transcription de référence.
- La formule du WER est : WER = (S + D + I) / N.
- Plus le WER est faible, plus le résultat final est précis.
- Un WER inférieur à 5 % constitue une bonne référence, même si les transcriptions juridiques ou médicales peuvent exiger un taux d’erreur sur les mots encore plus faible.
- Le WER considère toutes les erreurs comme équivalentes. Ce n’est donc pas une métrique parfaite pour évaluer le contexte. Des métriques émergentes, comme le taux d’erreur sémantique sur les mots (SWER), cherchent à y remédier en mesurant si le sens d’un énoncé a été préservé.
Qu’est-ce que le taux d’erreur sur les mots ?
Le taux d’erreur sur les mots (WER) est la métrique standard pour mesurer la précision de la reconnaissance vocale dans les modèles de Speech to Text. Exprimé sur une échelle de 0 à 1, 0,8 représentant un taux d’erreur de 80 %, il indique ce qu’un système STT transcrit incorrectement, selon ses substitutions, suppressions et insertions.
Une substitution se produit lorsqu’un mot est remplacé par un autre mot incorrect. Une suppression correspond à un mot entièrement omis. Enfin, une insertion correspond à un mot ajouté à la transcription alors qu’il n’a jamais été prononcé. Le WER utilise ces trois composantes, puis les divise par le nombre de mots de la transcription correcte afin d’obtenir un chiffre comparable à celui d’autres fournisseurs.
Voici la formule du WER :
WER = (S + D + I) / N
Où :
- S : substitutions (mot incorrect)
- D : suppressions (mot manquant)
- I : insertions (mot supplémentaire présent)
- N : nombre total de mots dans la transcription de référence
Vous pouvez exprimer le WER sous forme décimale ou en pourcentage. Plus le WER est faible, meilleur est votre score, car le modèle a commis moins d’erreurs lors de la transcription.
En pratique, un WER de 10 % signifie qu’environ 1 mot sur 10 dans la transcription de votre réunion doit être vérifié.
Pourquoi le taux d’erreur sur les mots est-il important dans les systèmes de reconnaissance vocale ?
Le taux d’erreur sur les mots fournit une métrique objective que les équipes peuvent utiliser pour comparer différents fournisseurs. Il permet de dépasser les promesses marketing et de visualiser clairement la précision d’un modèle de reconnaissance vocale. En s’appuyant sur des données probantes, toute entreprise qui évalue ses options peut identifier clairement les modèles actuellement les plus performants dans ce domaine.
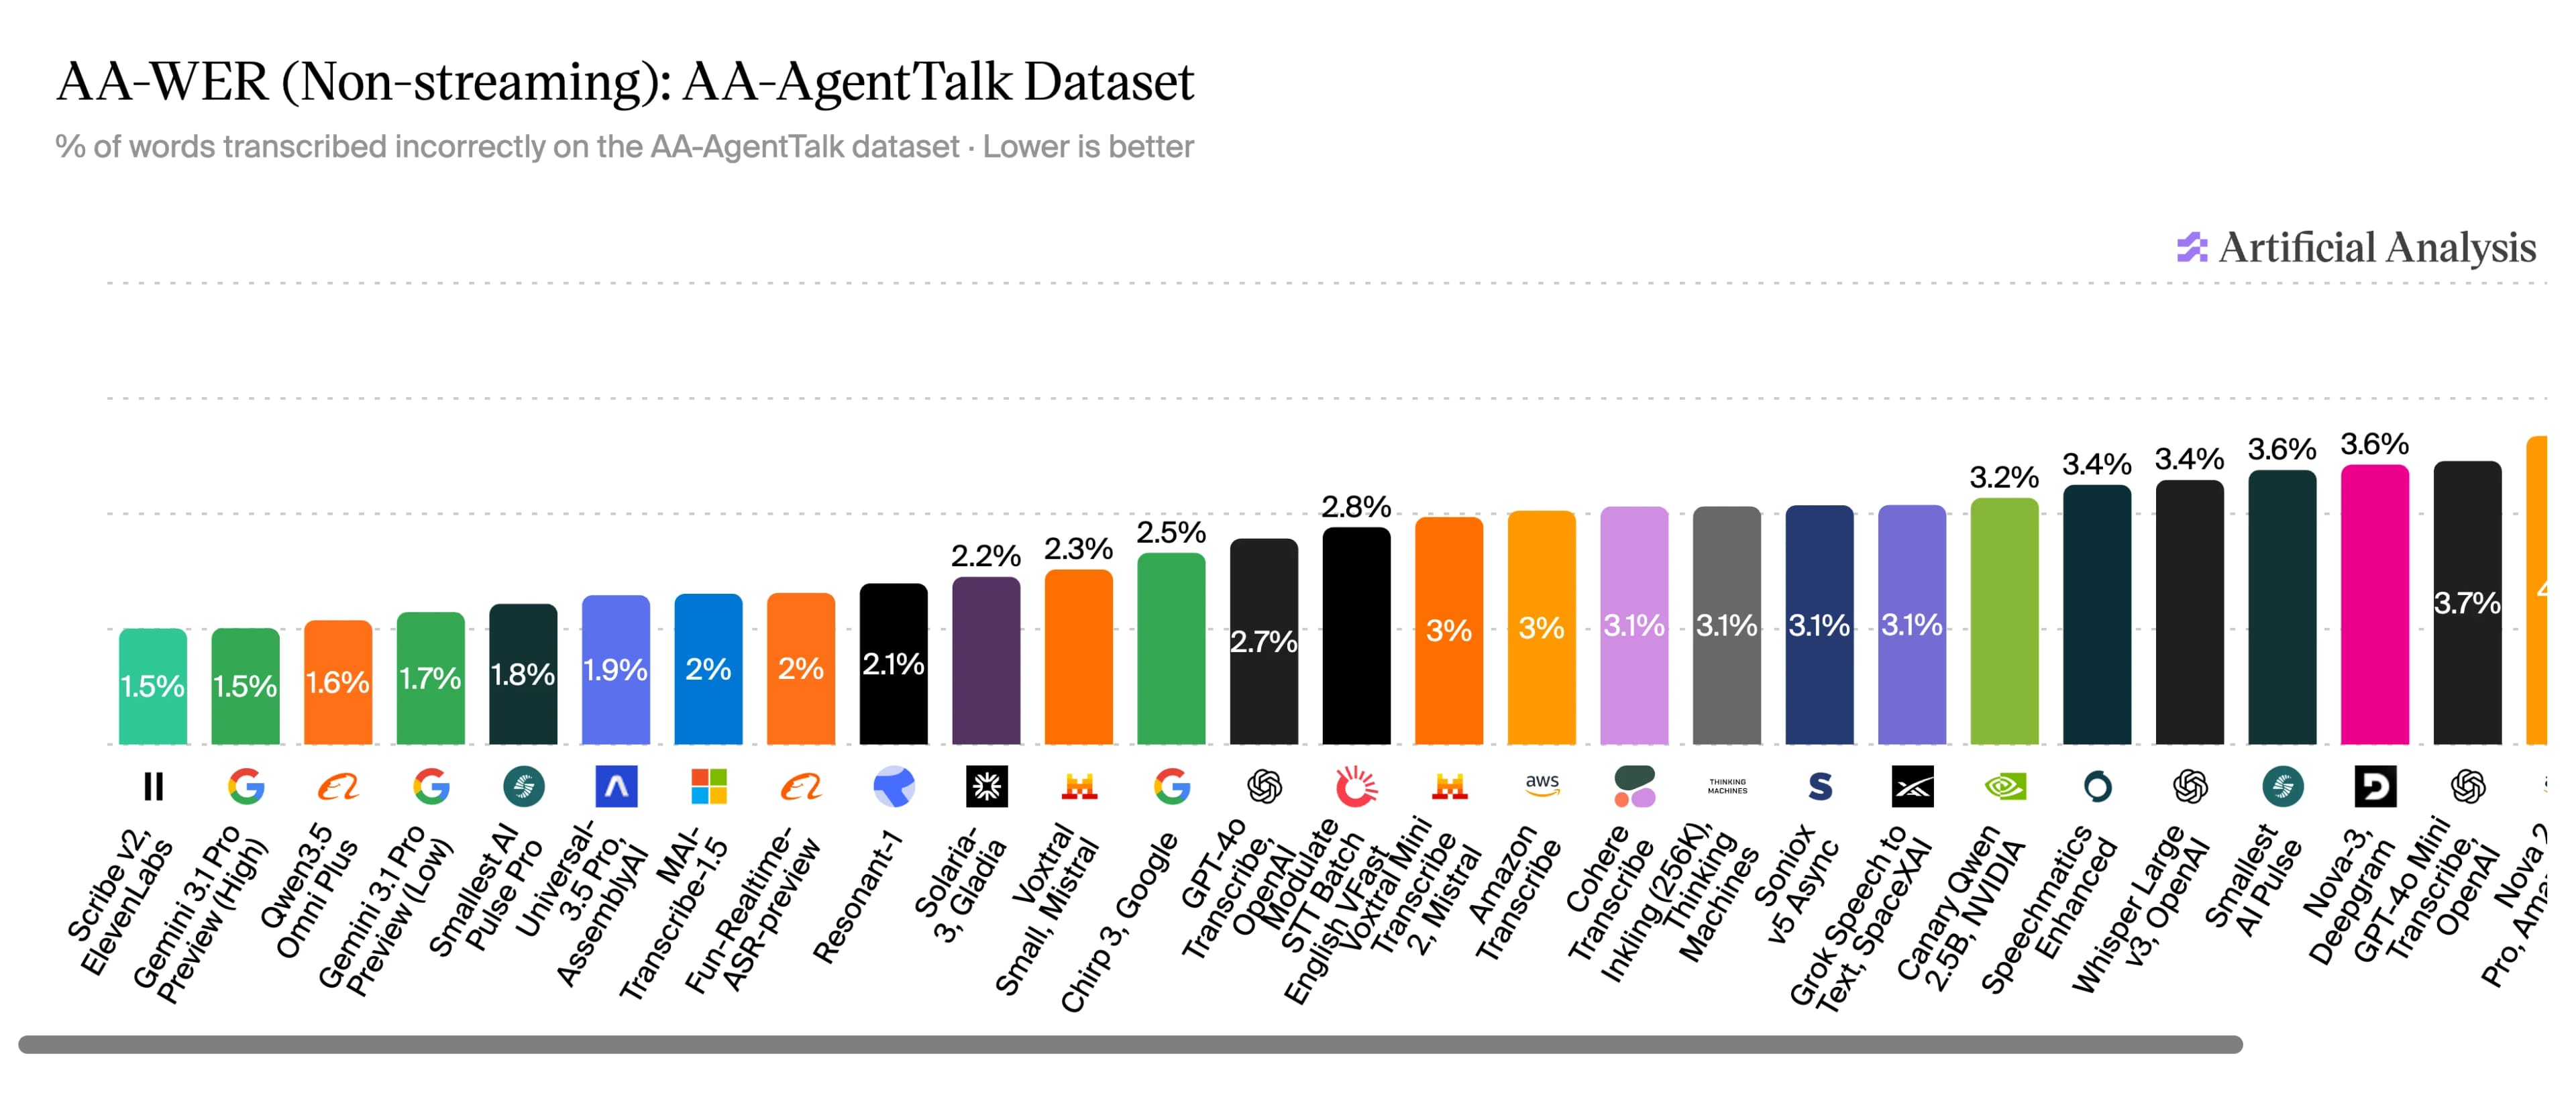
Source : Artificial Analysis consulté le 10 juillet 2026.
En juillet 2026, une étude indépendante d’Artificial Analysis classe Scribe v2 d’ElevenLabs au premier rang du secteur pour le WER sur le jeu de données AA-AgentTalk, parmi les modèles de transcription non temps réel, avec un WER de 1,5 %.
Au-delà de l’évaluation des fournisseurs, le WER a un impact concret au niveau du produit. Un logiciel de transcription médicale affichant un WER de 12 % pourrait introduire des erreurs critiques dans les dossiers patients. Des erreurs de transcription lors d’un appel de service client peuvent entraîner des défaillances en aval, comme une analyse des sentiments imprécise ou une mauvaise catégorisation.
Au-delà de ces problèmes propres à certains cas d’usage, lorsque les systèmes ASR échouent, les personnes les plus touchées sont souvent celles pour qui la transcription est le seul moyen d’accéder au contenu oral. Le World Wide Web Consortium propose une documentation détaillée sur les normes minimales attendues par les initiatives d’accessibilité.
Comment calculer le taux d’erreur sur les mots : formule et exemple
Calculer le taux d’erreur sur les mots est simple lorsque vous en connaissez les étapes. Comme indiqué plus haut, la formule est WER = (S + D + I) / N. Tous les termes sont décrits ci-dessus : substitutions, suppressions, insertions, et N pour le nombre total de mots de la transcription.
Voici comment calculer le WER :
- Créez une transcription de référence : utilisez une transcription et une vérification humaines pour produire une transcription précise d’un extrait audio.
- Utilisez votre outil STT : utilisez une plateforme ASR pour transcrire l’extrait audio et produire une transcription IA qui servira de test.
- Alignez les deux versions : utilisez la programmation dynamique, notamment l’algorithme de Levenshtein, pour trouver le nombre minimal de modifications. Nous détaillerons cet algorithme dans une section ultérieure.
- Appliquez la formule : comptez le nombre total d’erreurs dans la version générée par l’IA par rapport à la version vérifiée par un humain, puis utilisez WER = (S + D + I) / N pour calculer le WER exact.
Cela peut sembler technique sur le papier, mais c’est bien plus simple en pratique. Voici un exemple pour illustrer le principe.
Transcription de référence : Mrs. Dalloway said she would buy the flowers herself.
Résultat ASR : Miss Dalloway said she would buy flowers herself.
En calculant le total des erreurs, nous obtenons 1 S et 1 D sur 9 mots au total.
En appliquant la formule, on obtient : WER = 2 / 9 = 0,222 = 22,2 %.
Calculer le taux d’erreur sur les mots avec Python
Bien que la méthode manuelle soit efficace, vous pouvez gagner du temps en calculant le WER avec Python. La bibliothèque jiwer gère tout cela automatiquement.
La documentation de jiwer vous permet d’installer ce package, spécialement conçu pour évaluer un système ASR et produire des métriques essentielles comme le WER. Une fois téléchargé, vous pouvez utiliser le code suivant pour calculer rapidement le WER avec Python :
Dans cet exemple, le résultat ASR diffère de la référence originale à deux endroits. Le mot « jumps » a été incorrectement transcrit par « leaps » (une substitution) et « last » a été inséré avant « lazy » (une insertion). Avec deux erreurs sur les neuf mots de la transcription de référence, le taux d’erreur sur les mots (WER) est de 0,222, soit 22,2 %.
Comparer le taux d’erreur sur les mots et d’autres métriques de reconnaissance
Si le WER est la métrique standard pour calculer la précision d’un système ASR, d’autres outils sont également disponibles. Par exemple :
- Taux d’erreur de caractères (CER) : comme le WER, il mesure la précision de la transcription au niveau des caractères plutôt qu’au niveau des mots. Il est particulièrement adapté aux langues sans frontières de mots clairement définies (scriptio continua) ou aux tâches sensibles à l’orthographe.
- Taux d’erreur de correspondance (MER) : mesure la proportion d’erreurs de transcription en traitant les substitutions, insertions et suppressions légèrement différemment du WER. Il se concentre sur la proportion d’erreurs dans une phrase.
- Perte d’information des mots (WIL) : estime la quantité d’informations originales perdue lors de la transcription, en mesurant l’intelligibilité plutôt que le nombre direct d’erreurs du WER.
- Taux d’erreur d’incorporation (EmbER) : fournit une analyse sémantique entre les transcriptions. Il va au-delà du WER en renseignant sur la distance sémantique entre le mot correct et la transcription incorrecte.
Chacune de ces métriques est adaptée à un scénario différent. Voici un tableau de référence :
Exemples de distance de Levenshtein : les mathématiques derrière le WER
Le taux d’erreur sur les mots mesure en réalité la distance entre l’original et le résultat hypothétique. Pour comprendre cette différence mathématiquement, on utilise la distance de Levenshtein.
La distance de Levenshtein compte le nombre minimal de modifications unitaires nécessaires pour transformer une séquence en une autre. Dans le cas du WER, il s’agit précisément de substitutions, d’insertions et de suppressions. Par exemple, pour transformer Cat en Mat, il faut remplacer la lettre « C » par « M », ce qui donne une distance de Levenshtein de 1.
Si ce principe apparaît davantage dans les calculs de CER, le WER applique la distance de Levenshtein au niveau des mots. Chaque unité est un mot entier plutôt qu’un caractère, la distance réelle mesurant le nombre de modifications de mots nécessaires pour transformer notre résultat ASR en original exact.
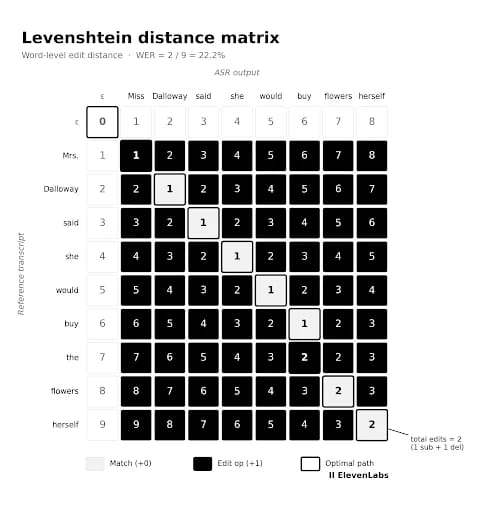
Nous construisons une matrice dans laquelle chaque cellule représente la distance totale entre la transcription originale et la transcription ASR. La distance de Levenshtein remplit ensuite la matrice du coin supérieur gauche au coin inférieur droit, la cellule finale indiquant le nombre total de modifications au niveau des mots. En divisant ce nombre par N, vous obtenez votre WER.
Cette matrice est généralement calculée avec des caractères individuels, mais voici une version adaptée de notre exemple précédent, par souci de simplicité.
Erreurs courantes et idées reçues sur le taux d’erreur sur les mots
À mesure que les API STT deviennent plus accessibles et que les logiciels ASR s’intègrent couramment à des stacks d’agents plus larges, les comparaisons entre outils vont se multiplier.
Avant de calculer vos propres taux d’erreur sur les mots, vous devez comprendre quelques problèmes et idées reçues fréquents.
- Toutes les erreurs se valent : le WER considère chaque erreur comme tout aussi importante. Si cela peut convenir dans de nombreux contextes, certains cas d’usage le rendent inacceptable. Dans un hôpital, par exemple, un taux d’erreur de 5 %, considéré comme un bon WER, peut rester incompréhensible, car une ou deux erreurs suffisent à mettre un patient en danger. Cette limite a conduit au développement de métriques plus récentes, comme le taux d’erreur sémantique sur les mots (SWER), qui cherche à déterminer si le sens d’une phrase a été préservé plutôt que si chaque mot correspond exactement.
- Le WER peut dépasser 100 % : bien que nous ayons indiqué que le WER se situe entre 0 et 1, il peut dépasser 100 %. Cela s’explique par les erreurs d’insertion, qui peuvent produire plus de mots que la transcription originale n’en contient. Un exemple courant consiste à transcrire « I’m » par « I am », où un mot devient deux.
- Un WER plus faible n’est pas toujours meilleur, techniquement : un WER de 5 % est, sur le papier, meilleur qu’un WER de 10 %. Cependant, si les erreurs ayant contribué à ces 5 % modifient fortement le contexte d’une phrase, contrairement à celles des 10 %, le tableau d’ensemble n’est pas représenté. Le contexte reste déterminant, et des métriques comme le SWER sont développées spécifiquement pour capter cet impact sémantique.
En 2024, Apple a publié une étude intéressante explorant ce dernier point. Lorsque des humains ont évalué un calcul de WER de 9,4 % pour déterminer si le résultat ASR était lisible, ils ont attribué au même passage un WER de seulement 2,2 %. Dans l’exemple testé, les humains ont considéré les « erreurs » comme insignifiantes dans de nombreux cas, produisant un WER humain plus de 4 fois plus tolérant que celui des machines.
Références sectorielles pour le WER
Le WER idéal dépend fortement du secteur ou du cas d’usage dans lequel vous utilisez la technologie ASR. Bien qu’un WER inférieur à 5 % soit une référence du secteur, certains domaines, comme la transcription médicale ou juridique, exigent un taux bien plus faible.
Dans l’étude d’Artificial Analysis de juillet 2026, Scribe v2 d’ElevenLabs a obtenu un WER de 1,5 %. Il est toutefois important de rappeler que ces statistiques sont généralement établies pour l’anglais comme langue principale. La technologie STT peut être moins efficace dans d’autres langues.
La documentation ElevenLabs présente les plages générales de WER pour toutes les langues prises en charge par Scribe v1 et Scribe v2.
Commencez avec ElevenAPI pour améliorer la précision de la reconnaissance
Lorsque vous créez une application ou un produit où la qualité de transcription compte, l’écart entre une API ASR bien choisie et une API médiocre se manifeste d’abord dans votre WER, puis dans l’expérience de vos utilisateurs.
ElevenLabs Scribe est la couche Speech to Text accessible via ElevenAPI. Avec plus de 90 langues prises en charge et un WER parmi les plus faibles du secteur, elle propose des fonctionnalités comme la diarisation des locuteurs, les horodatages au niveau des mots, l’invite de termes clés et la détection d’entités.
Consultez la documentation ElevenLabs pour en savoir plus sur ElevenAPI ou commencez dès aujourd’hui en vous inscrivant.
FAQ sur le taux d’erreur sur les mots

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.