
Comment fonctionne la transcription audio avec horodatage et marquage des événements ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Un modèle natif de transcription au niveau du mot prend en entrée un enregistrement audio ou un flux en temps réel et produit un tableau structuré d’objets token étiquetés et horodatés, représentant la parole et les sons non verbaux. Chaque token relève de l’un des trois types suivants : word, spacing ou audio_event. Les événements audio peuvent être des rires, des applaudissements ou d’autres sons de fond.
Dans cet article, nous expliquons le fonctionnement de la transcription audio horodatée et pourquoi elle est plus flexible et plus performante que la transcription conventionnelle reposant sur l’alignement forcé.
En résumé
- La transcription au niveau du mot produit directement des tableaux structurés et horodatés de données vocales et d’événements audio non verbaux.
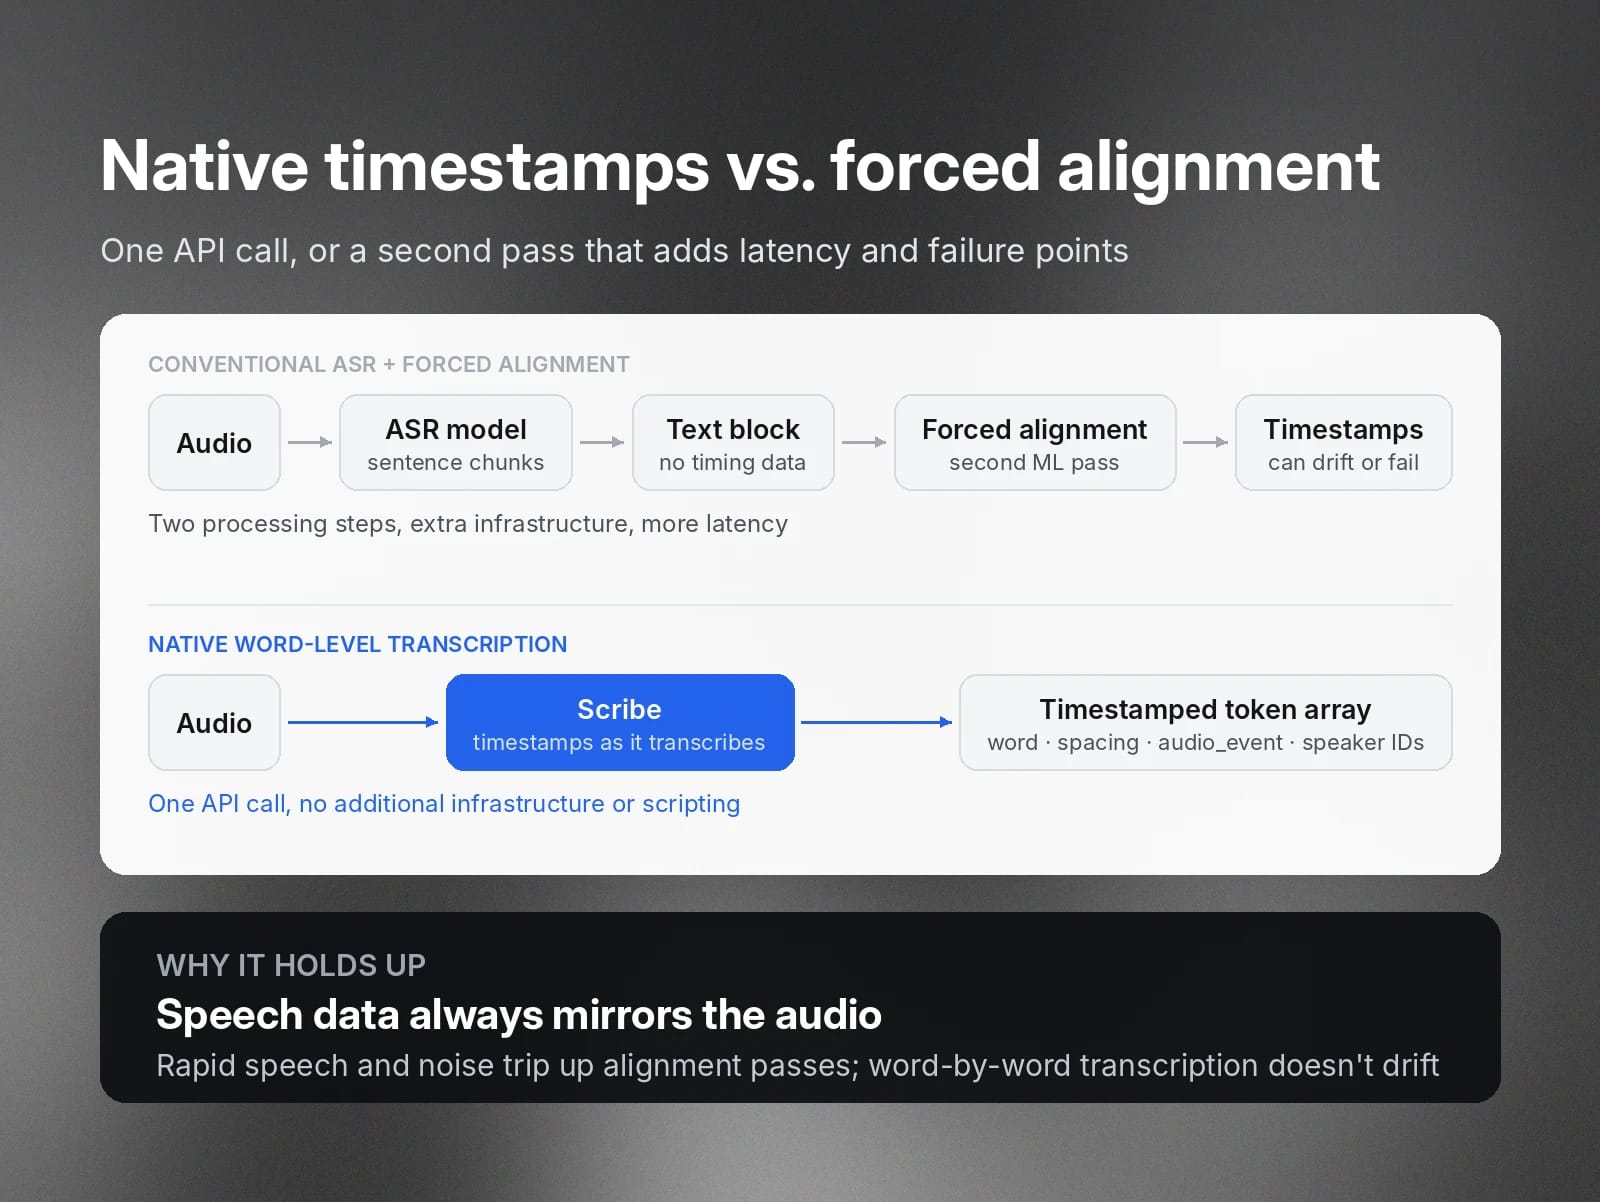
- Cela contraste avec les modèles conventionnels de reconnaissance automatique de la parole, qui produisent des blocs de texte complets. Pour les horodater par rapport à l’audio brut, vous devez effectuer un second processus d’alignement forcé, plus long et plus coûteux en ressources de calcul.
- Les balises d’événements vous aident à capturer du contenu non verbal, comme les rires ou les applaudissements. Comme ces données sont consultables, vous pouvez les utiliser pour identifier les temps forts ou les moments susceptibles de devenir viraux selon les réactions du public.
- Vous pouvez transmettre les données structurées produites à des applications pour de nombreux cas d’usage, notamment le sous-titrage de haute précision, les archives audio consultables et la création automatisée d’extraits pour les réseaux sociaux.
- La transcription au niveau du mot de Scribe prend en charge jusqu’à 5 canaux, chacun transcrit indépendamment.
Qu’est-ce que la transcription audio horodatée avec balises d’événements ?
La transcription horodatée est une forme de reconnaissance automatique de la parole (ASR) qui suit les points de début et de fin précis des mots et d’autres événements audio, comme les applaudissements, pendant la transcription. Elle produit des données entièrement structurées et navigables.
La transcription ASR conventionnelle analyse l’audio en grands blocs de texte lisible. Elle fournit des sous-titres et une transcription destinés aux lecteurs humains, mais reste peu exploitable en tant que donnée.
Pour la structurer avec des horodatages, vous devez la transmettre à un service secondaire de machine learning afin d’associer le texte à l’audio. Vous pouvez ainsi obtenir un résultat similaire, mais cela nécessite plusieurs étapes de traitement au lieu d’être fourni nativement par l’API, ce qui ajoute de la latence et une charge de calcul supplémentaire.
Rendre l’audio navigable
Le principal avantage de la transcription horodatée et balisée par événements est qu’elle est lisible à la fois par les humains et les machines. Elle offre plusieurs applications métier importantes :
- Audit de conformité : recherchez des mots-clés dans une transcription et obtenez l’horodatage exact de toute mention de données sensibles.
- Production et montage vidéo : les logiciels de production vidéo peuvent synchroniser les sous-titres à la milliseconde avec les propos à l’écran. Ils peuvent aussi étiqueter correctement les réactions du public.
- Archives consultables : les équipes de relations publiques, commerciales et de formation, entre autres, peuvent transcrire de grands volumes d’entretiens clients, de discours en salon professionnel, de webinaires ou de réunions publiques dans de vastes archives consultables.
- Analyses marketing et sentiment client : les balises d’événements peuvent identifier des réactions du public qui disparaîtraient d’une transcription textuelle basique.
Quels sont les avantages des horodatages natifs au niveau du mot ?
Les modèles standard de Speech to Text traitent la parole par segments, généralement des phrases ou des paragraphes entiers. Si vous souhaitez un horodatage mot à mot, vous devez concevoir une couche de traitement supplémentaire pour effectuer ce que l’on appelle un alignement forcé lors d’un second passage. Cela ajoute de l’infrastructure et de la latence, ainsi que davantage de points de défaillance potentiels. Par exemple, le traitement peut dériver ou échouer complètement face à une parole rapide ou noyée dans un bruit de fond important.
La transcription horodatée, comme celle réalisée par Scribe, évite ce problème en transcrivant à un niveau plus précis, mot par mot. Elle le fait en un seul appel API. Aucune infrastructure ou script supplémentaire n’est requis. Le modèle calcule les horodatages pendant la transcription, afin que les données vocales reflètent toujours fidèlement l’audio.
Comment fonctionne la transcription horodatée avec balises d’événements ?
Prenons Scribe comme exemple.
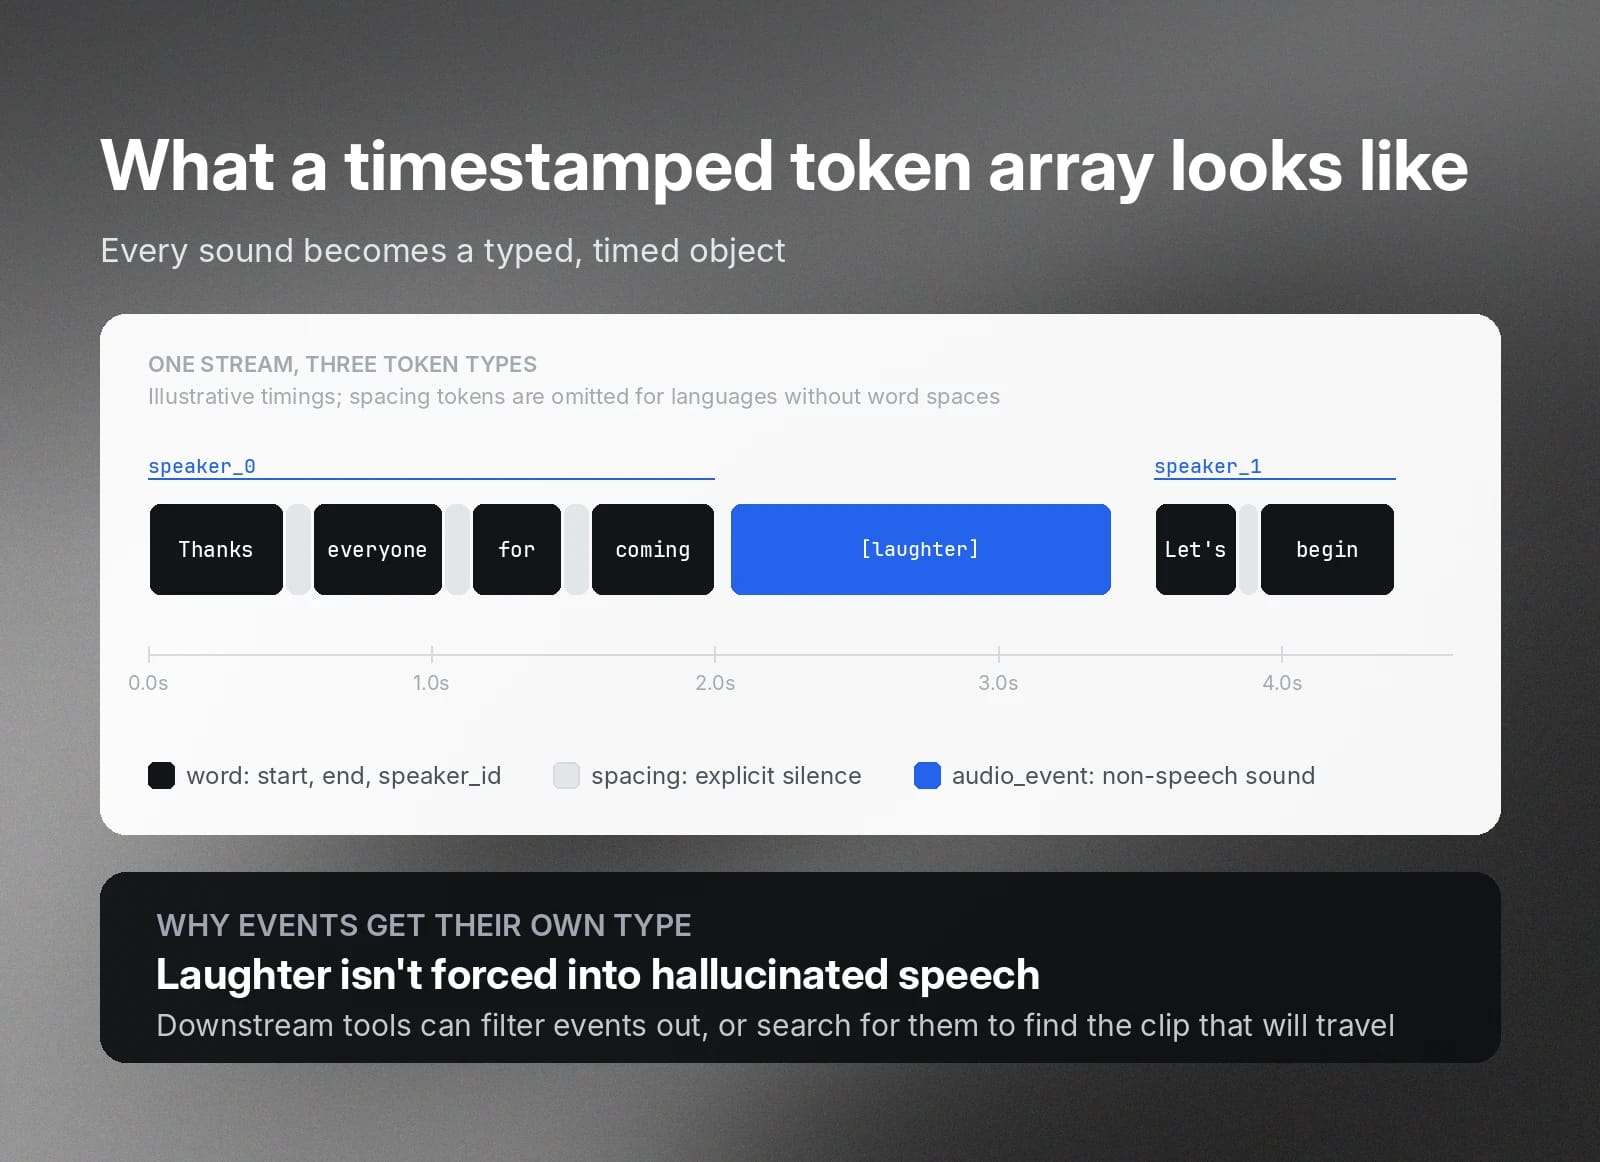
Un modèle natif de transcription au niveau du mot associe les sons de la parole d’un flux audio à un tableau structuré d’objets token. Il attribue à chaque token l’un des trois types suivants : word, spacing ou audio_event.
- word : un mot individuel prononcé et reconnu, avec ses heures de début et de fin, ainsi qu’une balise speaker_id.
- spacing : silence ou pause en cours de parole explicitement étiqueté. Utile pour aider les services de sous-titrage à respecter le bon rythme. Non utilisé pour les langues identifiées qui n’emploient pas d’espaces entre les mots, comme le japonais, le mandarin, le thaï, le lao, le birman et le cantonais.
- audio_event : contenu audio non verbal significatif, comme les rires ou les applaudissements. Le modèle sait les structurer comme un type d’événement distinct et ne force pas l’audio à devenir de la parole hallucinée.
Paramètres du streaming en temps réel
Les modèles de transcription au niveau du mot peuvent aussi inclure des fonctionnalités spécifiques pour prendre en charge la transcription audio WebSocket en direct. Par exemple :
- include_timestamps=true : ce paramètre demande à la connexion d’inclure des horodatages au niveau du mot dans les messages JSON committed_transcript_with_timestamps envoyés à la fin de chaque segment audio finalisé. Vous obtenez ainsi les horodatages pendant que le flux est encore actif. Les balises d’événements audio ne sont incluses que si tag_audio_events est également activé.
- include_language_detection=true : ce paramètre demande à la connexion d’étiqueter les différentes langues parlées détectées, accompagnées du score de confiance du modèle pour chaque détection. Il facilite le sous-titrage multilingue en direct.
Comment un modèle Speech to Text étiquette-t-il les événements non verbaux ?
Scribe étiquette les événements audio lorsque le paramètre tag_audio_events est activé. Il indique alors leurs heures de début et de fin précises, comme pour les mots. Il peut étiqueter diverses réactions, notamment les rires et les applaudissements, mais aussi d’autres sons ambiants pertinents selon le contexte, y compris des pas ou de la musique.
Concrètement, cela enrichit les transcriptions et le sous-titrage en ajoutant un contexte important. Le sarcasme peut être plus difficile à percevoir pour un lecteur face à un texte simple et plat. Une balise [laughter] enrichit la transcription et lui donne davantage de résonance émotionnelle.
De meilleures analyses
Le balisage des événements rend également les analyses ultérieures plus fiables, car les outils n’ont pas à analyser un unique bloc de texte non structuré. La transcription native au niveau du mot sépare les événements audio en données structurées : vos outils peuvent donc les filtrer lorsque nécessaire et travailler uniquement sur le contenu verbal.
Comme les tokens spacing rendent les pauses visibles, vous pouvez les analyser. Cela peut être utile pour l’analyse des sentiments et les cas d’usage d’assurance qualité, par exemple pour mesurer le temps de silence d’un agent de service client pendant un appel.
Recherche d’horodatages simplifiée
Vous pouvez aussi rechercher spécifiquement ces événements. Lors d’une analyse des sentiments sur un entretien de test produit, vous pouvez extraire les réactions émotionnelles significatives. Ou, si vous gérez un compte sur les réseaux sociaux, vous pouvez rechercher rapidement les rires dans un discours d’une heure afin de trouver les extraits les plus susceptibles de devenir viraux.
Quelles sont les applications pratiques des transcriptions horodatées structurées ?
L’obtention native de données structurées dans les transcriptions répond à plusieurs cas d’usage importants.
Génération de légendes et de sous-titres
Vous pouvez exporter directement les transcriptions horodatées dans des formats de sous-titrage de production, dont SRT et VTT, sans traitement intermédiaire. Votre outil de montage vidéo peut utiliser la durée de chaque mot pour les mettre en évidence dans les sous-titres au moment où ils sont prononcés.
Le modèle de transcription peut facilement analyser une parole rapide, car il la traite mot par mot. Là où un modèle conventionnel peut trébucher face à un débit très rapide ou à des voix qui se chevauchent, un modèle au niveau du mot comme Scribe produit une transcription propre et structurée.
Recherche audio et vidéo
La transcription conventionnelle permet de rechercher des mots-clés dans un bloc de texte, mais sans alignement forcé, vous ne pouvez pas accéder directement au moment où une phrase a été prononcée. Une recherche par mot-clé dans une transcription au niveau du mot est entièrement indexée et vous mène précisément à la seconde où la phrase a été prononcée dans l’audio. Votre archive audio devient ainsi un catalogue de référence entièrement consultable. Cette fonctionnalité est particulièrement utile pour gérer de grandes bibliothèques multimédias, des réseaux de podcasts et des archives d’entreprise.
Audit de conformité et des risques
Vous souhaiterez souvent enregistrer un contenu audio contenant des informations sensibles, par exemple des appels de service client à des fins d’assurance qualité. Ces appels sont aussi les plus susceptibles de contenir des informations personnelles sensibles ou réglementées.
Pour rester conforme tout en conservant des données audio à des fins d’analyse, vous avez besoin d’un moyen de masquer les données sensibles des transcriptions en temps réel. L’horodatage natif au niveau du mot vous permet de tirer parti de fonctionnalités telles que la détection d’entités d’ElevenLabs, qui signale les entités sensibles, comme les numéros de carte bancaire ou les noms, et renvoie leurs décalages et leurs horodatages afin que vous puissiez les masquer dans vos transcriptions au fil de leur réception.
Vous pouvez par exemple détecter et masquer un numéro de carte bancaire, le nom de jeune fille de la mère, la date de naissance et le nom du client au moment où ils sont prononcés lors d’un appel de vérification d’identité.
Création automatisée d’extraits pour les réseaux sociaux
Vous pouvez aussi automatiser par programmation les recherches par mots-clés pour identifier les temps forts de contenus longs. Vous pourriez, par exemple, mettre en avant les moments importants d’un discours de campagne ou d’un séminaire d’entreprise. Cela vous aide à transformer des contenus récents en extraits montés de manière professionnelle pour YouTube, LinkedIn ou TikTok.
Synchronisation multicanale et multi-intervenants
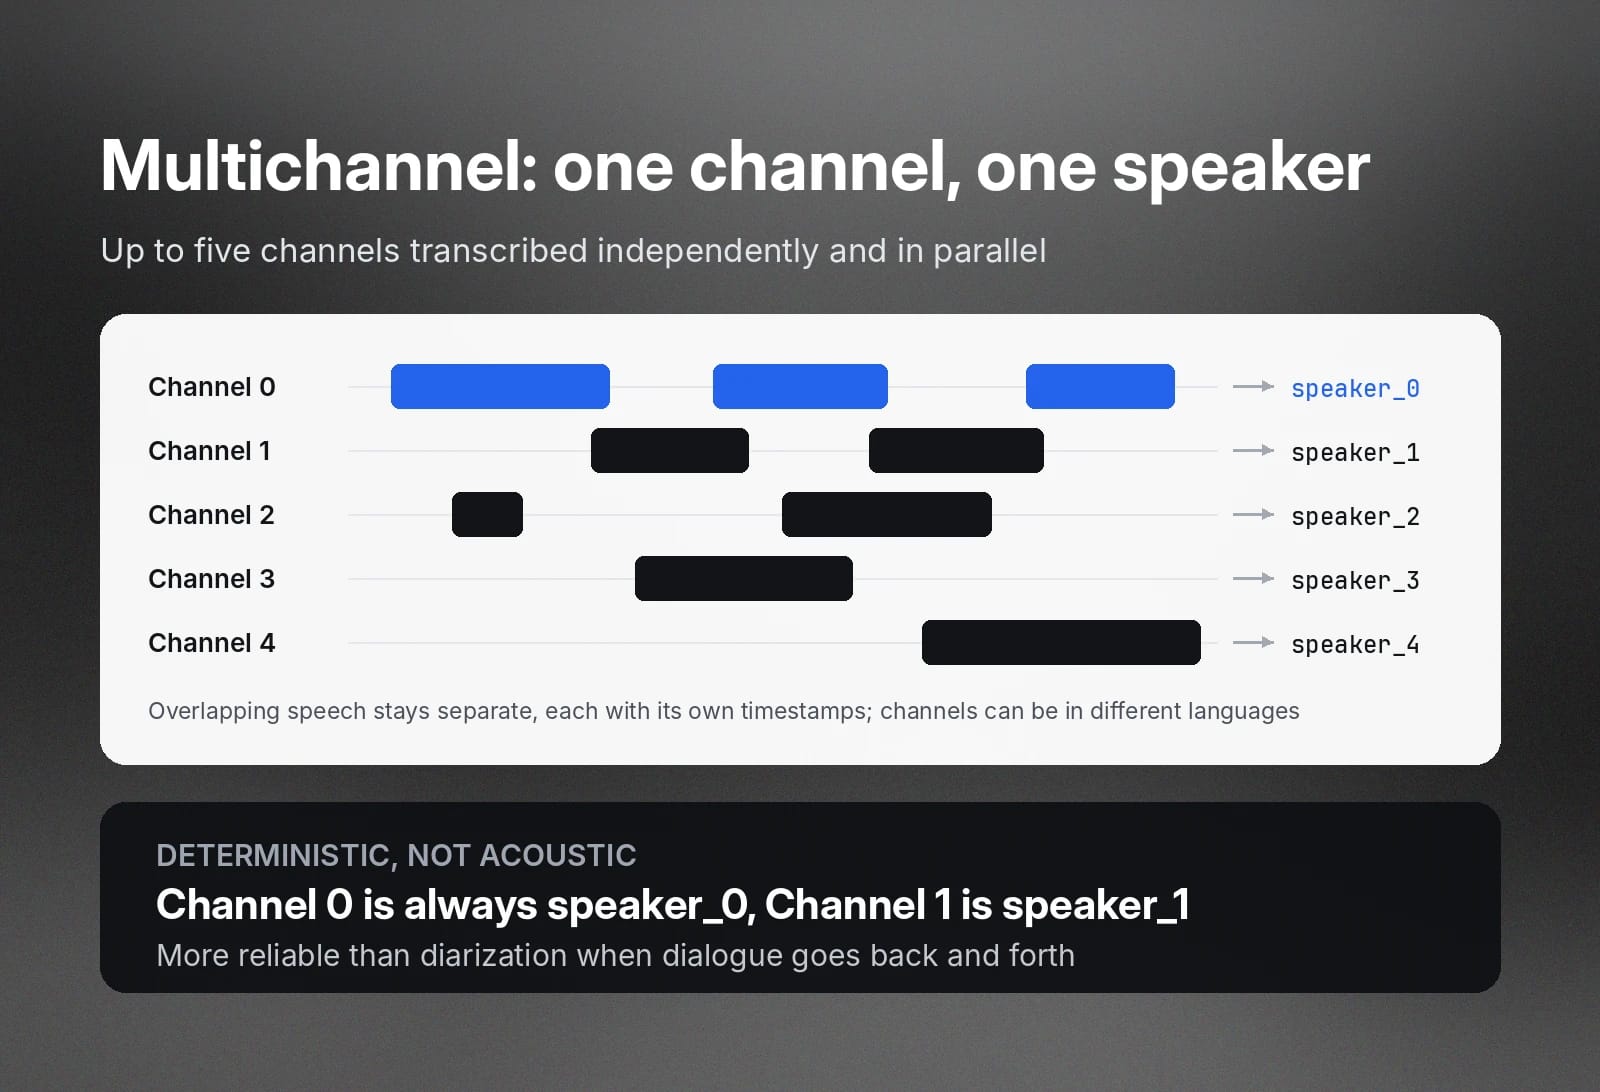
Scribe peut transcrire jusqu’à cinq canaux indépendamment et en parallèle. Chacun reçoit un ID de locuteur et des horodatages. Cette méthode est plus fiable que la diarisation des locuteurs acoustique standard, qui peine souvent avec les dialogues alternés. Pour les enregistrements multicanaux, l’attribution des locuteurs par Scribe est entièrement déterministe. Autrement dit, le canal 0 correspond à speaker_0, le canal 1 à speaker_1, et ainsi de suite.
Il peut reconnaître des locuteurs qui tentent de parler simultanément et générer malgré tout des horodatages indépendants pour leurs propos. Ils peuvent également parler dans différentes langues.
Exportez les données horodatées au format dont vous avez besoin
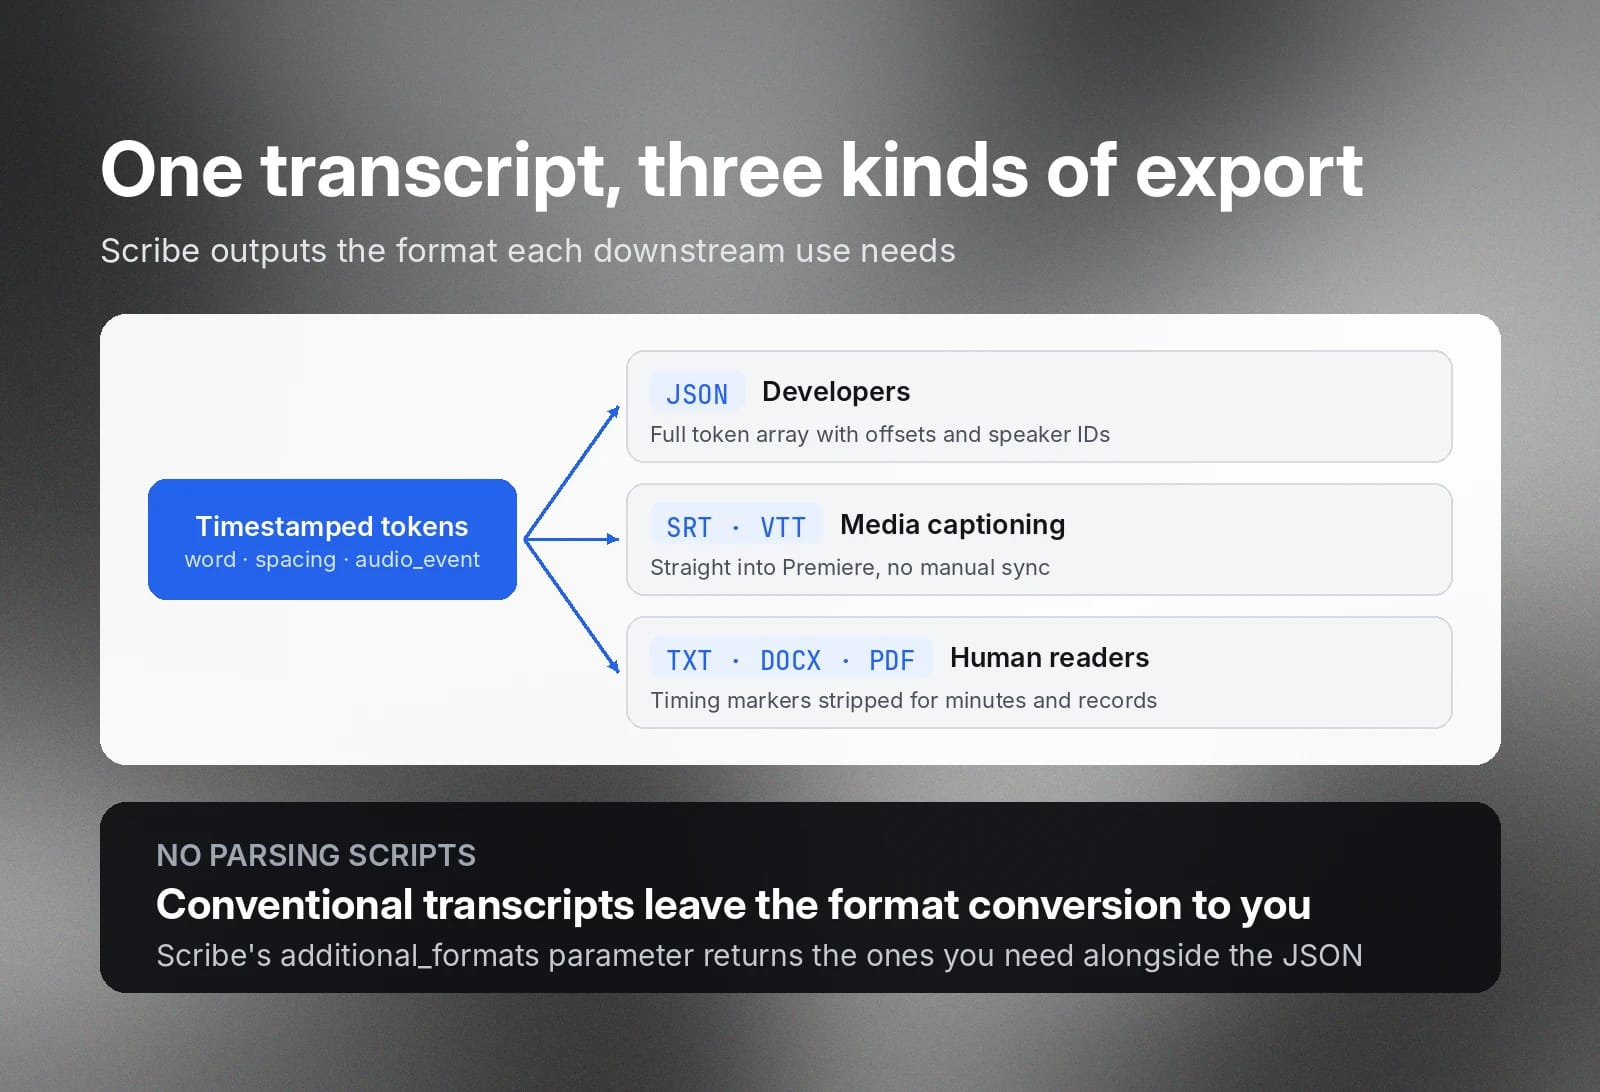
Si vous souhaitez distribuer des transcriptions conventionnelles dans plusieurs formats, vous devrez probablement écrire vous-même les scripts d’analyse. Scribe peut exporter les transcriptions dans plusieurs formats selon l’usage que vous en ferez. Vous trouverez les définitions complètes des schémas dans le Guide de l’API ElevenLabs Create Transcript.
Données structurées pour les développeurs : JSON
Scribe prend en charge l’export au format JSON pour les développeurs qui souhaitent obtenir des données dans un schéma transmissible à des applications en aval. Par exemple, les développeurs peuvent utiliser ces données JSON pour créer des médias interactifs ou une base de données de recherche sémantique pour leur organisation. Le tableau complet de tokens word, spacing et audio_event est produit avec les décalages de début et de fin, ainsi que les ID de locuteur.
Sous-titrage média : SRT et VTT
Scribe peut produire des transcriptions SRT et VTT que vous pouvez transmettre directement à Adobe Premiere ou à d’autres applications de production, sans synchronisation manuelle.
Lisible par les humains : TXT, DOCX et PDF
Il peut aussi produire des transcriptions dans des formats faciles à lire. Dans ces formats, Scribe supprime les marqueurs temporels de bas niveau pour rendre le texte plus lisible et adapté à la documentation juridique ou d’audit. C’est utile, par exemple, lorsque vous devez diffuser efficacement le procès-verbal d’une réunion du conseil juste après une séance, publier des transcriptions de podcasts pour le SEO ou archiver des dossiers juridiques.
Commencez à utiliser les transcriptions ElevenLabs horodatées et balisées par événements
La transcription native au niveau du mot vous fournit rapidement et efficacement les données structurées nécessaires à vos workflows.
Commencez dès aujourd’hui à transcrire votre audio avec Scribe dans ElevenAPI ou découvrez la transcription au niveau du mot.
FAQ sur les horodatages et la transcription avec balises d’événements

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


