Présentation de Scribe v2
- Publié
ÉcouterÉcouter cet article
Scribe v2 est conçu pour la transcription par lots, le sous-titrage et le sous-titrage codé à grande échelle. Il améliore la stabilité et la précision de Scribe v1, en gérant mieux les contenus audio longs, les pauses, les changements de ton et les silences prolongés.
Si Scribe v2 Realtime est optimisé pour une latence ultra-faible et les cas d’usage d’agents, Scribe v2 est optimisé pour les enregistrements longs et complexes, tout en maintenant sa précision auprès de locuteurs, d’accents et de styles d’élocution variés. Résultat : des transcriptions fiables dans un large éventail de conditions audio réelles.
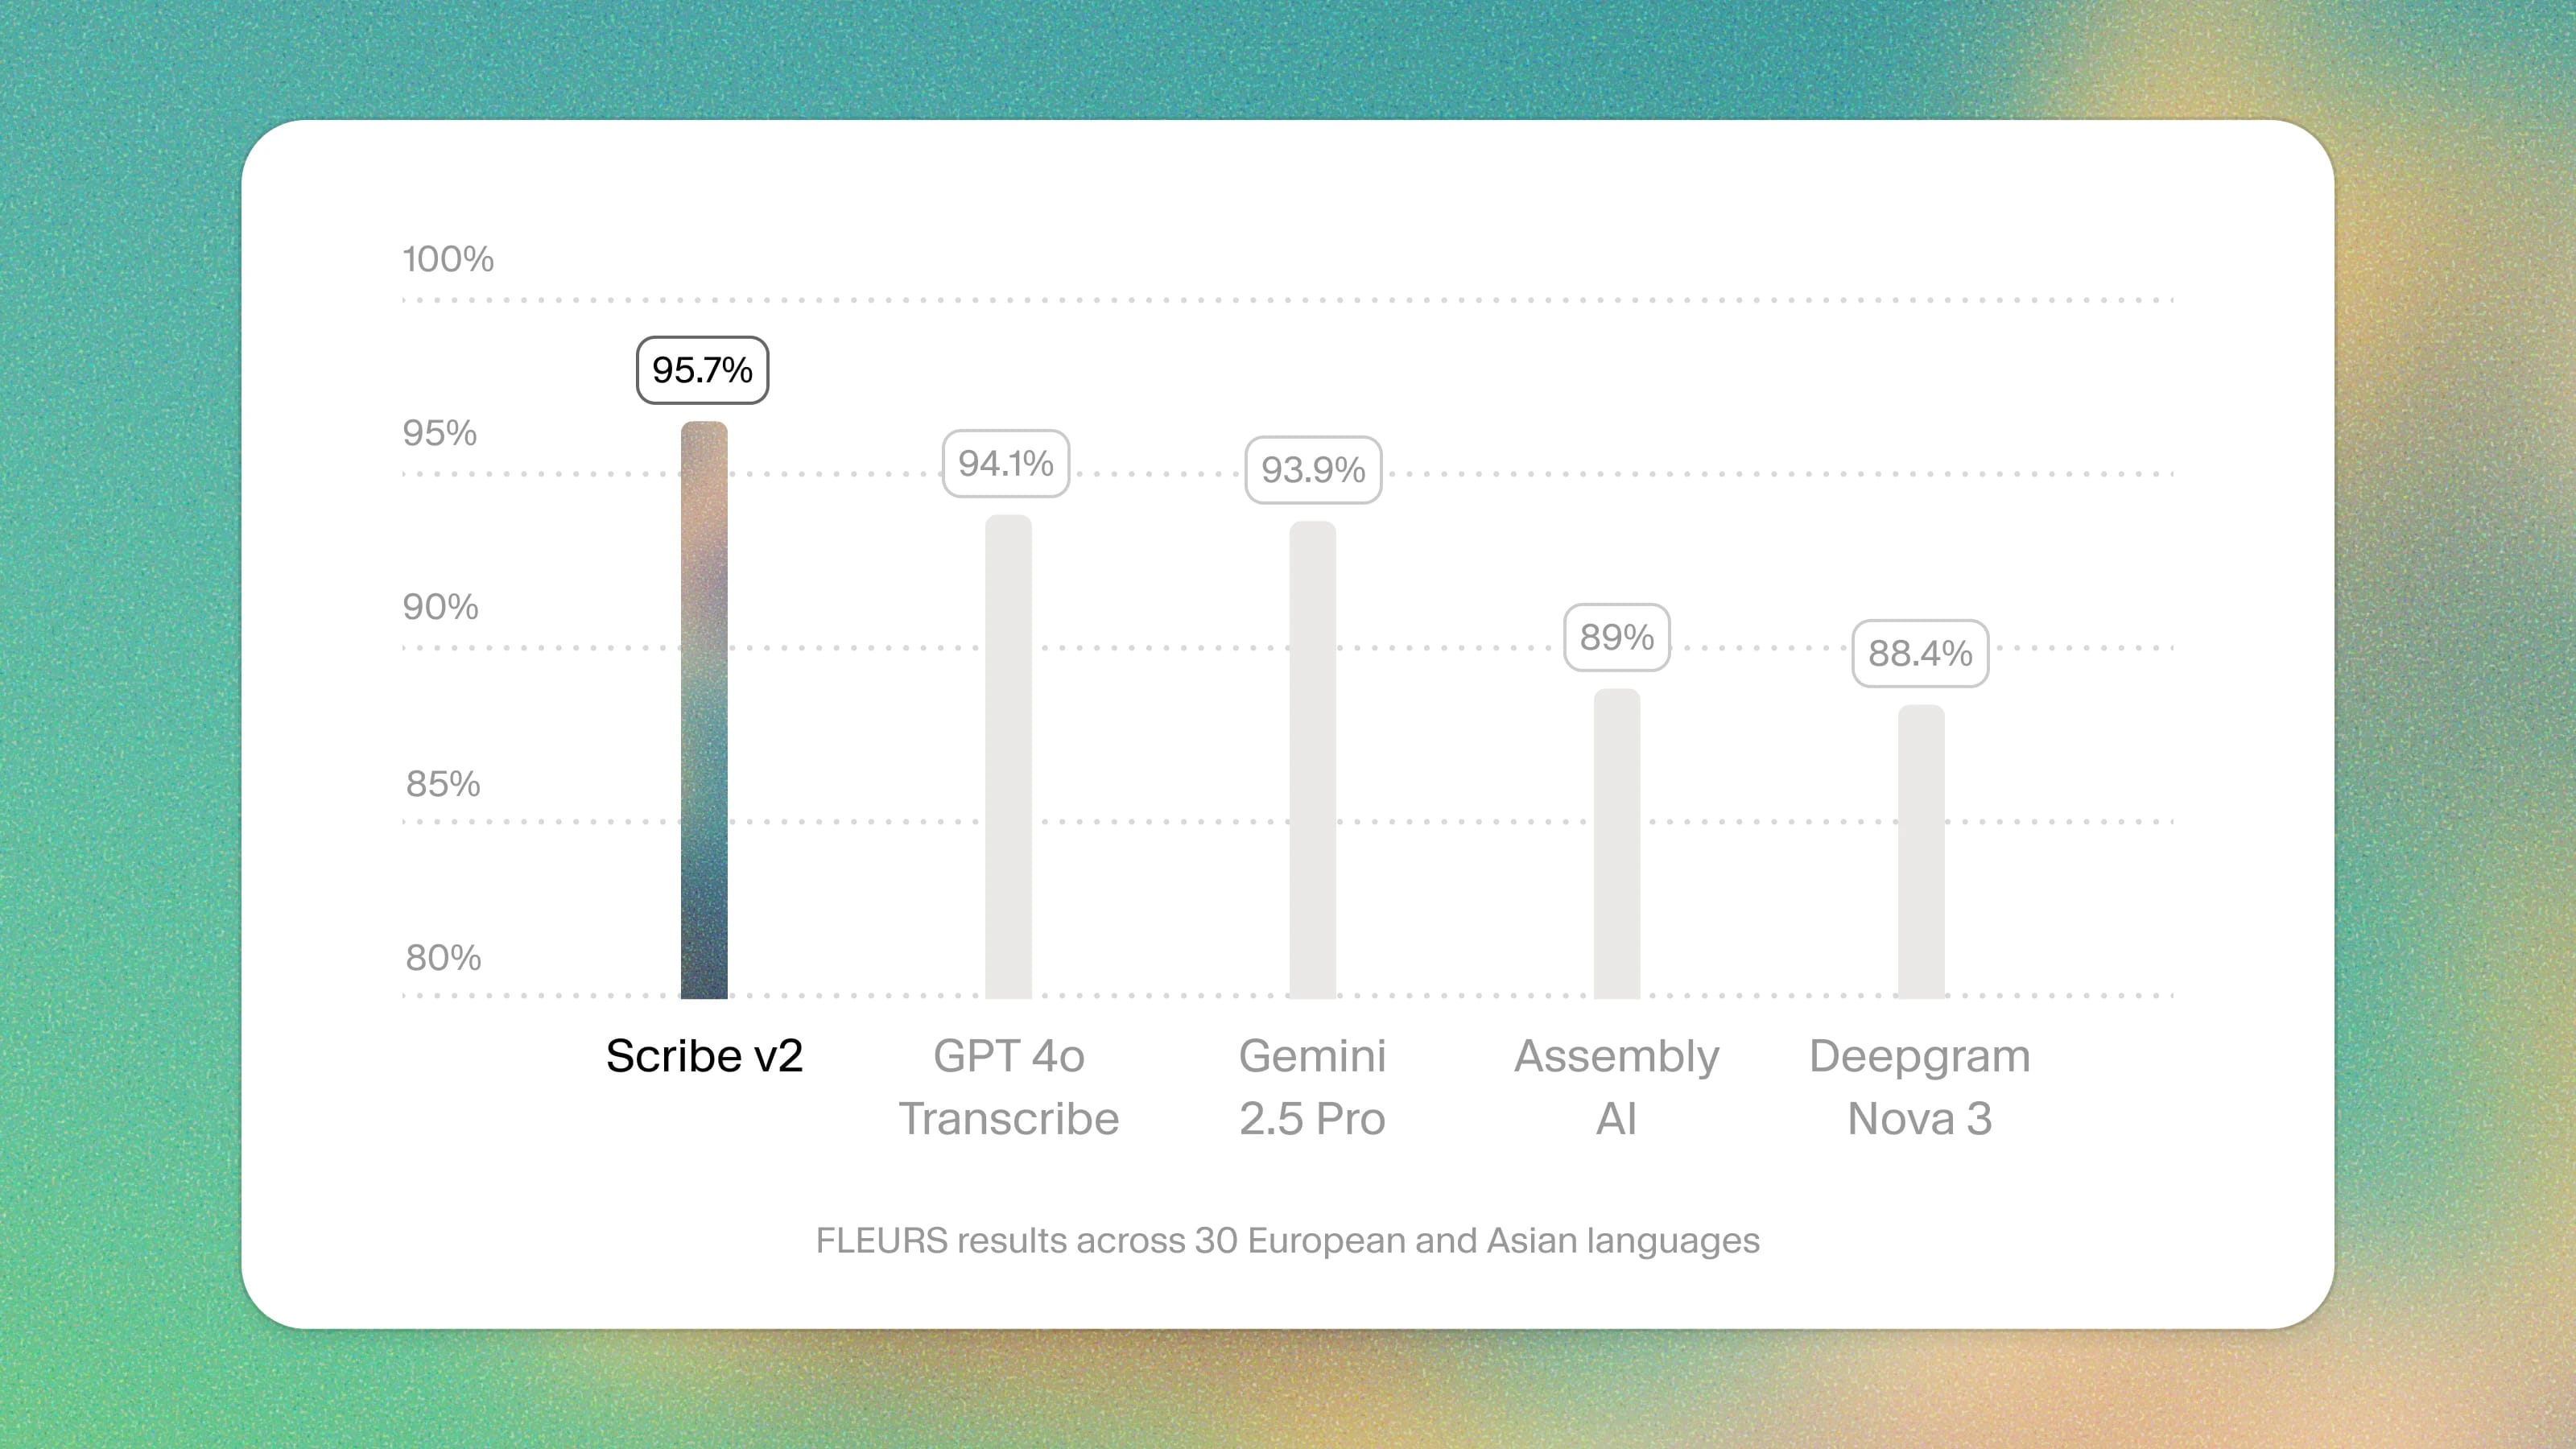
Scribe v2 atteint le taux d’erreur de mots le plus faible enregistré sur les benchmarks de référence du secteur.
Guidage par termes clés pour une transcription tenant compte du contexte
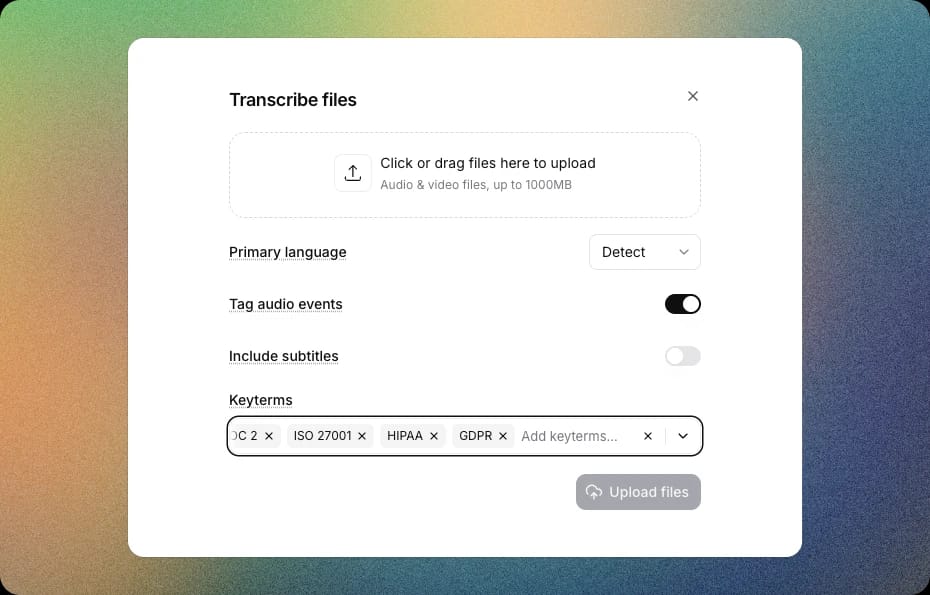
Le guidage par termes clés va au-delà du vocabulaire personnalisé standard en exploitant le contexte de la transcription. Sélectionnez jusqu’à 100 mots ou expressions, et Scribe v2 détermine précisément à quel moment les transcrire. Cette fonctionnalité convient particulièrement aux domaines techniques, aux noms de marques et au vocabulaire propre à chaque secteur.
Détection intégrée des entités avec horodatage précis
Scribe v2 intègre une détection native des entités pour l’analyse structurée de l’audio.
Vous pouvez sélectionner jusqu’à 56 catégories couvrant les informations personnelles identifiables, les données de santé et les informations de paiement. Scribe v2 détecte automatiquement ces éléments et leurs horodatages exacts dans votre transcription, ce qui facilite l’examen, le masquage ou le traitement d’informations sensibles à grande échelle.
Retrouvez de plus amples informations dans la documentation de l’API : https://elevenlabs.io/docs/developers/guides/cookbooks/speech-to-text/batch/entity-detection
Transcription automatique multilingue
Scribe v2 prend en charge nativement des flux de travail multilingues intelligents.
Vous pouvez envoyer un fichier audio contenant plusieurs langues. Le modèle détecte automatiquement chaque langue et la transcrit correctement, sans segmentation ni configuration manuelle.
Fonctionnalités supplémentaires pour les flux de travail de production
Scribe v2 propose un ensemble de fonctionnalités conçues pour les cas d’usage des entreprises et des développeurs :
- Diarisation intelligente des locuteurs pour une identification claire et intuitive
- Horodatage précis au niveau du mot pour un alignement exact des sous-titres et des expériences interactives
- Balisage audio dynamique détectant les événements non vocaux, comme les rires ou les bruits de pas
- Conçu pour les entreprises, avec conformité SOC 2, ISO 27001, PCI DSS L1, HIPAA et RGPD, hébergement des données en Europe et en Inde, et prise en charge du mode zéro rétention
Scribe v2, désormais dans ElevenLabs Studio
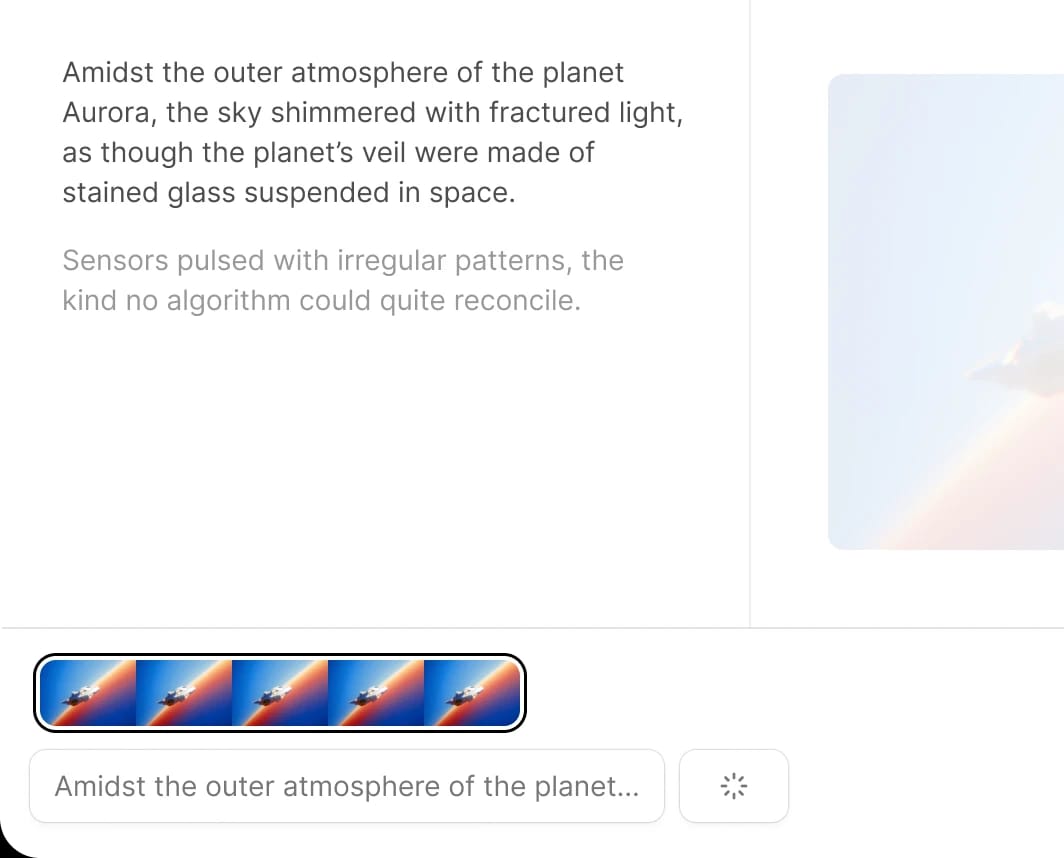
Scribe v2 est désormais utilisé dans ElevenLabs Studio pour des sous-titres, sous-titres codés et transcriptions plus précis. Il accompagne les équipes qui gèrent d’importantes bibliothèques audio et vidéo pour le marketing, les médias, la recherche, la formation et la conformité.
Essayer maintenant : https://elevenlabs.io/app/studio
Développer avec l’API
Avec Scribe v2, les développeurs et les entreprises peuvent automatiser des pipelines audio complexes, améliorer la précision des flux de contenu internationaux et évoluer en toute sécurité grâce à des contrôles complets de conformité et de résidence des données.
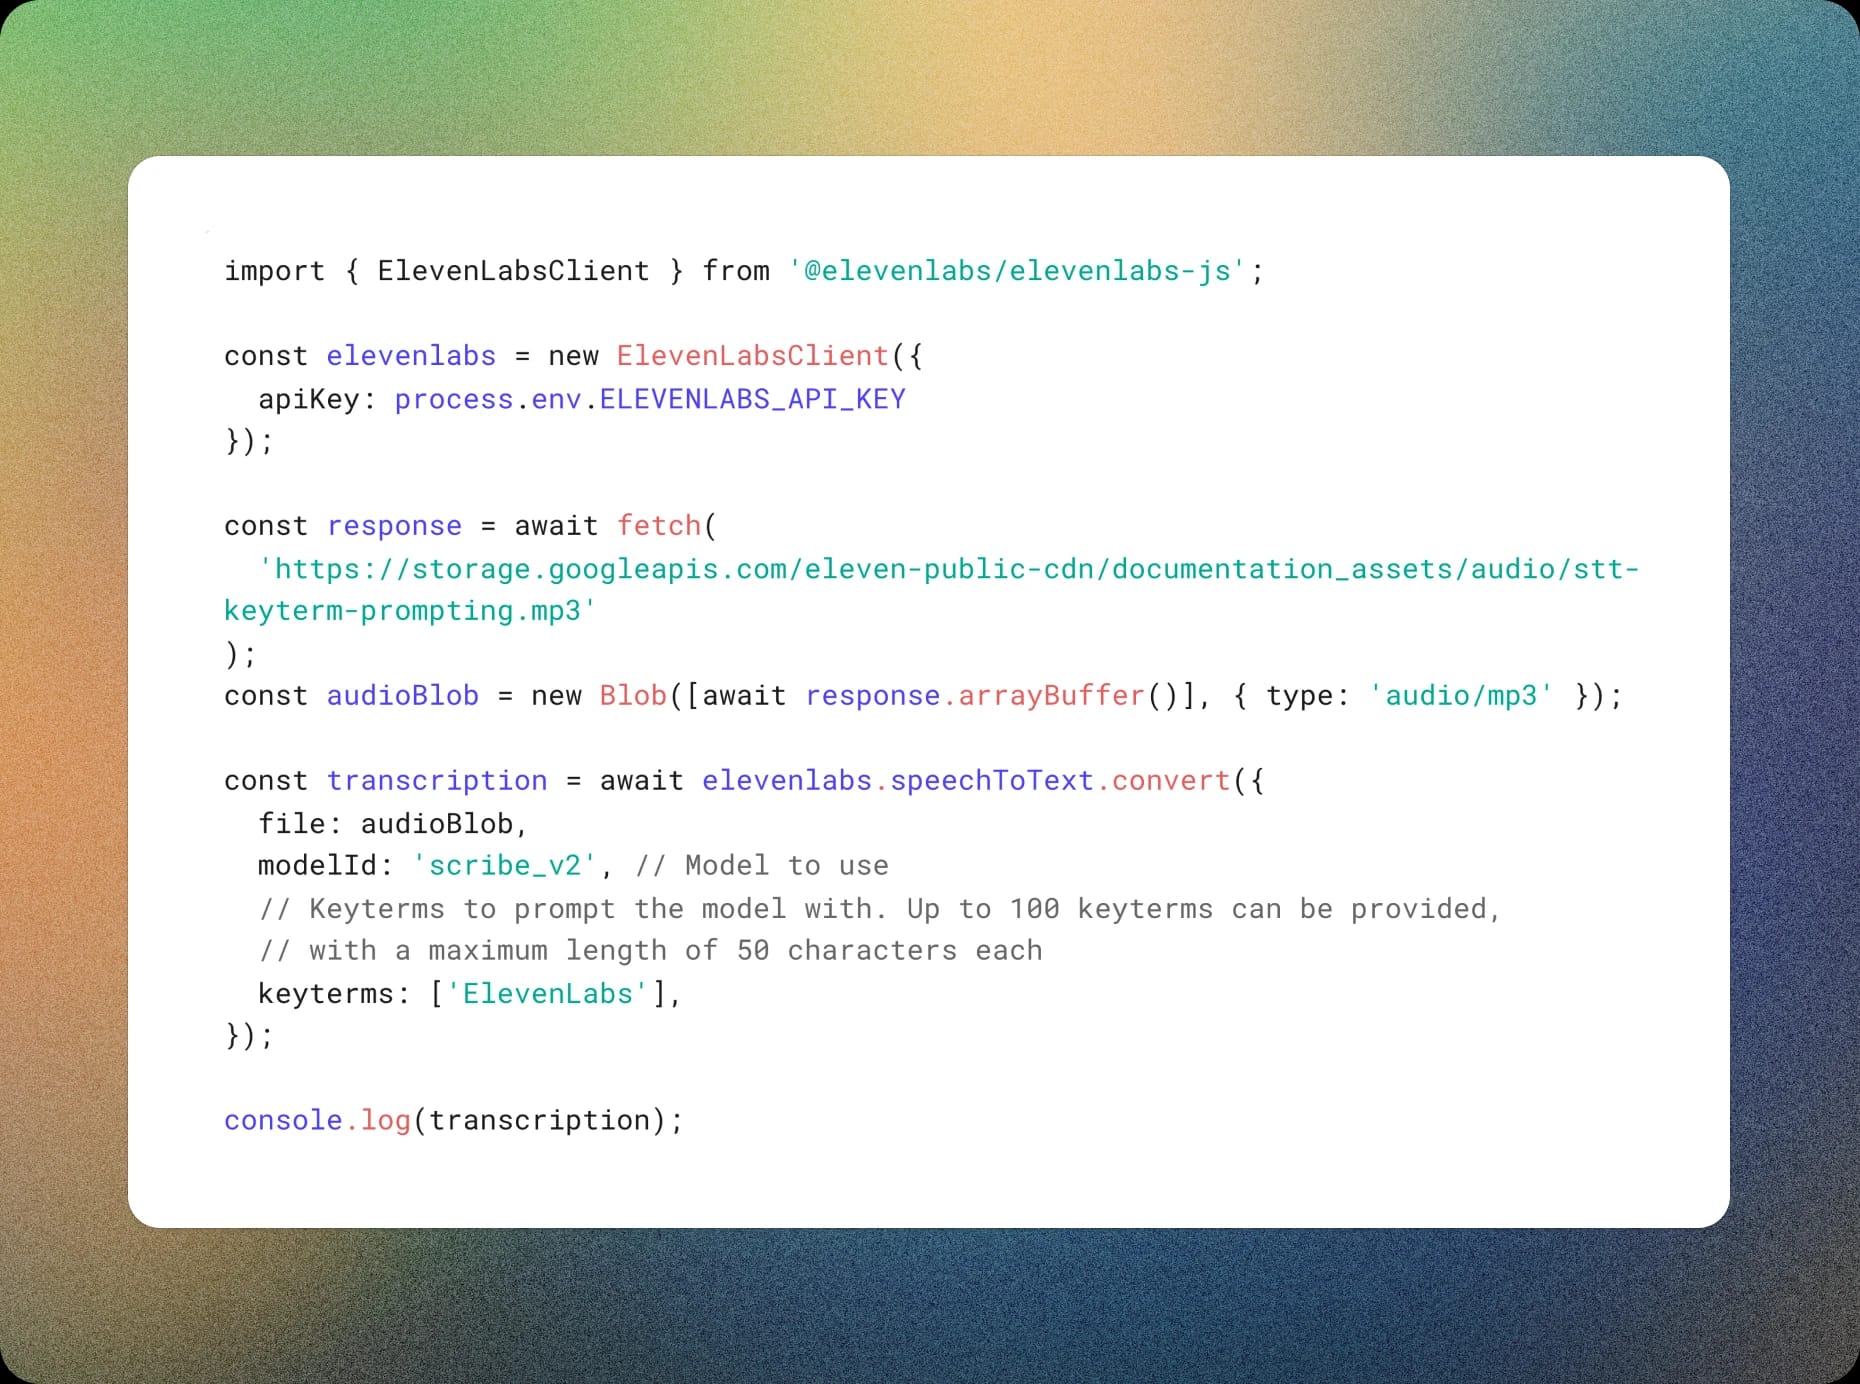
Scribe v2 est disponible dès aujourd’hui via notre API et notre plateforme Creative.
Essayer maintenant : https://elevenlabs.io/app/speech-to-text
En savoir plus : https://elevenlabs.io/docs/capabilities/speech-to-text
S’inscrire : https://elevenlabs.io/speech-to-text