Comment votre transcription sait où chaque mot est prononcé
- Rédigé par
- Mike Murphy
- Publié
ÉcouterÉcouter cet article
Si vous avez déjà regardé un film à la télévision avec un problème de diffusion, où les dialogues des acteurs sont complètement désynchronisés des sous-titres, vous savez à quel point cela peut distraire et vous sortir de l'histoire. Les vidéos et logiciels qui utilisent des modèles vocaux rencontrent le même problème : un sous-titre qui apparaît une seconde trop tard ou une transcription qui met en évidence le mauvais mot peut sembler tout aussi défaillant.
« Les humains savent assez bien synchroniser les médias, au moins au niveau des mots », explique Danila Kozlov, chercheur chez ElevenLabs spécialisé dans l'alignement. « Nous percevons souvent intuitivement le début d'un mot, mais au niveau des caractères et avec une précision inférieure à la milliseconde, c'est beaucoup plus difficile. »
Aujourd'hui, ElevenLabs vous en dit plus sur Cue, un modèle d'alignement forcé qui place chaque caractère d'un fichier audio sur une chronologie précise. Cue alimente la famille de modèles Scribe d'ElevenLabs et, sur des enregistrements réels, il est plus précis que tous les aligneurs testés par ElevenLabs, dans les 29 langues du benchmark. Il traite aussi des enregistrements de toute longueur en un seul passage et aligne une heure d'audio en moins d'une seconde.
Qu'est-ce que l'alignement forcé ?
Imaginez que quelqu'un vous donne une vidéo et une transcription, puis vous demande d'associer chaque mot au moment où il est prononcé. C'est cela, l'alignement forcé. Lorsque vous cliquez sur un mot dans une transcription ElevenLabs et que le lecteur se place précisément à cet endroit, un aligneur effectue ce travail.
L'alignement forcé diffère toutefois du concept plus vague d'alignement de l'IA. Ce dernier consiste à concevoir des systèmes d'IA dont le comportement correspond aux systèmes de valeurs et aux préférences commerciales des personnes. Avec l'alignement forcé, il s'agit simplement de faire correspondre le texte et le son.
Cue constitue la dernière étape du pipeline de Speech to Text. Scribe, le modèle Speech to Text d'ElevenLabs, transcrit l'audio, et l'aligneur en définit la synchronisation. Chaque requête Scribe y passe. Le même modèle alimente aussi les sous-titres, le doublage et la synchronisation des paroles musicales. Il est également disponible séparément via l'API Forced Alignment.
Comme de nombreux produits en dépendent, un aligneur doit être précis dans chaque langue prise en charge, extrêmement rapide et capable de traiter de nombreuses requêtes simultanément.
Les limites des aligneurs traditionnels
Avant ce nouveau modèle, l'équipe avait conçu l'aligneur utilisé jusqu'alors dans tous les produits ElevenLabs. Bien que performant, elle savait pouvoir renforcer cette nouvelle version. À son arrivée, Kozlov et l'équipe ont commencé par interroger des clients et des utilisateurs internes d'ElevenLabs sur ce qui les frustrait avec l'aligneur précédent. Leurs retours correspondaient aux limites des outils open source testés par l'équipe.
La durée constitue le premier problème majeur. Aujourd'hui, de nombreux aligneurs fonctionnent bien pour des extraits d'environ 30 secondes, mais les fichiers plus longs doivent être découpés en segments. Chaque nouveau segment risque d'ajouter une légère erreur de synchronisation, et leur raccordement peut en ajouter davantage. Sur des enregistrements complets, l'erreur de synchronisation moyenne de Cue n'est que de 179 millisecondes, contre 283 ms à plus de 6 000 ms pour les outils open source.
Les enregistrements audio réels sont encore plus difficiles à traiter. Le bruit de fond, les paroles qui se chevauchent et la musique d'ambiance font perdre à de nombreux outils leur repère lorsqu'ils font correspondre le texte à l'audio. Pourtant, ce sont précisément les types de fichiers que beaucoup souhaitent transcrire, car nous vivons rarement dans des environnements parfaitement silencieux. Sur des enregistrements en anglais affectés par des problèmes de fond, l'erreur moyenne de Cue est de 57 ms, contre 65 à 920 ms pour les autres outils.
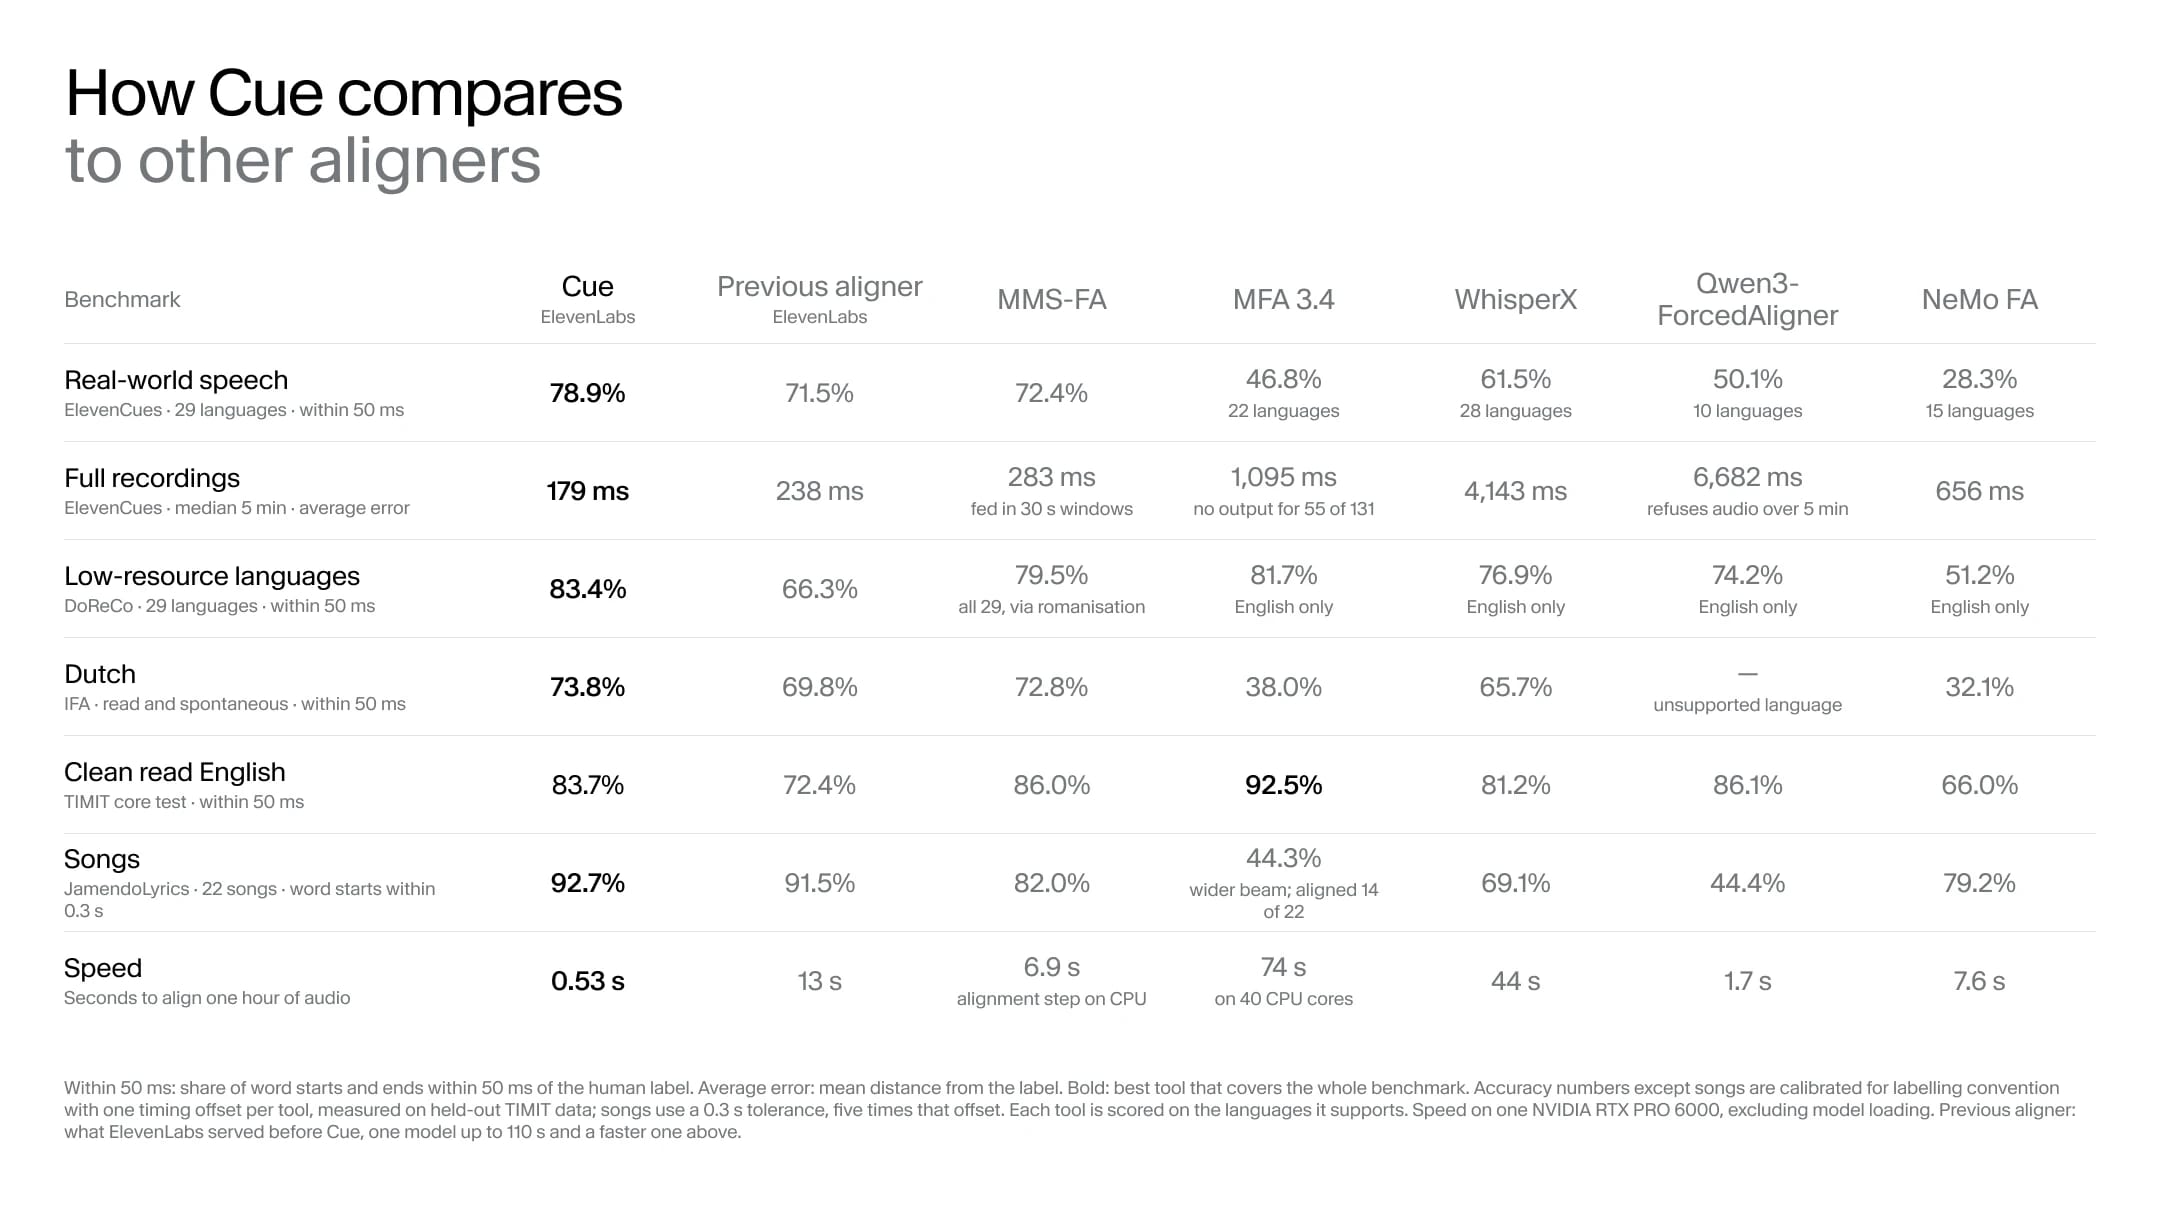
La prise en charge des langues constitue une autre contrainte. La plupart des aligneurs open source nécessitent un modèle distinct pour chaque langue prise en charge. Les langues disposant de moins de données d'entraînement sont donc souvent moins performantes, voire non prises en charge. MMS-FA est le seul autre outil qui prend en charge les 29 langues du benchmark. Dans l'ensemble, Cue identifie plus rapidement les frontières entre les mots.
La vitesse pose également problème pour ces modèles, car l'alignement de grands volumes d'audio peut vite devenir coûteux. Cue peut aligner une heure d'audio en environ une demi-seconde sur notre GPU de production. L'outil suivant le plus rapide, Qwen3-ForcedAligner, prend près de 2 secondes, tandis que le plus lent testé prend bien plus d'une minute.
Ce qui distingue Cue
Contrairement à la plupart de ses concurrents, Cue est un modèle unique qui couvre plus de 90 langues de benchmark. Il peut également traiter des enregistrements de toute durée en un seul passage, évitant ainsi le découpage qui accumule les erreurs de synchronisation dans les fichiers longs.
Pincez ou utilisez Ctrl avec la molette pour zoomer. Balayez horizontalement ou utilisez Maj avec la molette pour vous déplacer. Lorsqu’un mot est sélectionné, utilisez les touches plus et moins pour zoomer, ou Maj et les touches fléchées gauche ou droite pour vous déplacer.
Sélectionnez un mot pour voir ses caractères
Alors que la plupart des modèles ont grandi pour gagner en performances, Cue est plus petit que l'aligneur précédent d'ElevenLabs, indique Kozlov. Il fonctionne toujours sur un GPU, mais aligne une heure d'audio en environ une demi-seconde.
L'équipe a conçu Cue autour des types d'audio que les utilisateurs importent réellement. En utilisant l'aligneur précédent comme référence, elle a créé un benchmark à partir de requêtes réelles et évalué chaque outil de la même manière, en comptant comme erreur chaque mot qu'un outil ne parvenait pas à placer. Cue fonctionne au niveau des caractères, plus fin que les annotations au niveau des mots utilisées par la plupart des benchmarks. Ces scores sous-estiment donc probablement sa précision.
« À un certain stade, on atteint le niveau des capacités humaines », explique Kozlov à propos des modèles d'alignement. « Notre aligneur actuel dépasse ce niveau. Il devient donc beaucoup plus difficile de vérifier si le résultat est parfaitement correct ou simplement de mesurer sa précision, car il n'existe pas de benchmark de référence. Nous avons dû utiliser des benchmarks au niveau des mots pour évaluer un système au niveau des caractères, ce qui ne permet pas nécessairement de montrer tout le potentiel de Cue. »
La qualité de Cue reflète également la rapidité avec laquelle ElevenLabs peut agir à partir des retours des utilisateurs. Peu après le déploiement de Cue, un client a signalé à l'équipe que le géorgien et quelques autres langues disposant de moins de ressources affichaient des performances inférieures aux attentes. ElevenLabs maintient la recherche au plus près des équipes et des clients qui utilisent ses produits. L'équipe a ainsi pu identifier rapidement le problème, étudier des améliorations possibles du modèle, entraîner une nouvelle version et la publier, le tout moins de 24 heures après le premier signalement du client.
Aligner des chansons
La musique est difficile à traiter, car le chant étire et brouille les mots, et peu de modèles y parviennent efficacement. L'équipe ne s'attendait pas à ce que Cue s'en sorte aussi bien. Cue a pu aligner un sous-ensemble de chansons du jeu de données sous licence Creative Commons JamendoLyrics MultiLang. Il y est parvenu en anglais, en français, en espagnol et en allemand, en un seul passage, avec une précision surprenante. Il a placé 92,7 % des mots à moins de 0,3 seconde de l'annotation, contre 82,0 % pour l'outil suivant le plus performant.
L'erreur moyenne de Cue sur le début des mots était de 0,82 seconde, soit environ la moitié de celle de son concurrent le plus proche. Il s'est montré plus précis que tous les autres outils sur au moins 19 des 22 chansons. Le potentiel est considérable pour chanter vos nouvelles chansons préférées au karaoké dès le jour de leur sortie.
Essayez Cue dès aujourd'hui
Cue est déjà à l'origine de chaque transcription Speech to Text sur ElevenLabs. Pour l'utiliser directement, essayez l'API Forced Alignment.
Remerciements
Le travail sur les modèles d'alignement d'ElevenLabs n'aurait pas été possible sans de nombreuses personnes au sein de l'entreprise. L'équipe tient à remercier toutes celles et ceux qui ont travaillé sur la version précédente du modèle et sur la nouvelle, notamment le cofondateur et CTO Piotr Dąbkowski, les chercheurs Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel et Angelos Perivolaropoulos, ainsi qu'Ani Janelidze de l'équipe Data Operations, nos équipes Forward Deployed Engineer et Support, et Lorenzo Dossi pour son travail sur la visualisation de cet article.
Mike Murphy est rédacteur en chef et auteur pour le blog d’ElevenLabs, où il transforme des recherches et des technologies complexes en récits clairs et captivants. Avant de rejoindre ElevenLabs, il a travaillé pendant des années comme journaliste spécialisé dans les technologies, notamment chez Quartz, et a dirigé les contenus d’IBM Research. Il est titulaire d’un master en journalisme de Northwestern.