
Qu’est-ce que la diarisation des locuteurs ? Fonctionnement et cas d’usage
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
La diarisation des locuteurs prend un flux audio comportant un nombre inconnu de locuteurs et produit une chronologie de segments étiquetés : locuteur A de 0:00 à 0:42, locuteur B de 0:42 à 1:15, puis à nouveau le locuteur A à partir de 1:15. Le système ne sait pas qui sont les locuteurs, mais il sait qu’il s’agit de personnes différentes et conserve des étiquettes cohérentes tout au long de l’enregistrement.
Ce processus rend les contenus audio à plusieurs locuteurs exploitables. Les comptes rendus de réunion, l’analyse des centres d’appels, les transcriptions d’entretiens, le montage de podcasts et les dossiers juridiques exigent tous de savoir non seulement ce qui a été dit, mais aussi qui l’a dit.
Ce guide explique le fonctionnement de la diarisation, ses différences avec des techniques connexes comme la segmentation et l’identification, les outils open source qui la prennent en charge et comment mesurer les performances d’un système de diarisation.
Résumé
- La diarisation des locuteurs segmente un enregistrement audio selon la personne qui parle, en produisant des tours de parole étiquetés sans identifier qui que ce soit par son nom.
- La diarisation des locuteurs se distingue de la segmentation des locuteurs, qui détecte les changements de locuteur, et de l’identification des locuteurs, qui associe des voix à de véritables noms.
- Les performances de la diarisation se mesurent avec le taux d’erreur de diarisation (DER) pour la précision globale et le taux d’erreur de Jaccard (JER) afin de vérifier que cette précision se maintient pour chaque locuteur.
Qu’est-ce que la diarisation des locuteurs et comment fonctionne-t-elle ?
La diarisation des locuteurs consiste à partitionner un flux audio en segments selon la personne qui parle. Une transcription avec diarisation associe chaque segment audio à l’identité d’un locuteur. En bref, elle répond à la question : « Qui a parlé, et à quel moment ? »
La transcription brute d’une réunion vous donne les mots, tandis qu’une transcription avec diarisation indique que le locuteur 1 a posé la question, le locuteur 2 y a répondu et le locuteur 3 a interrompu l’échange à mi-chemin.
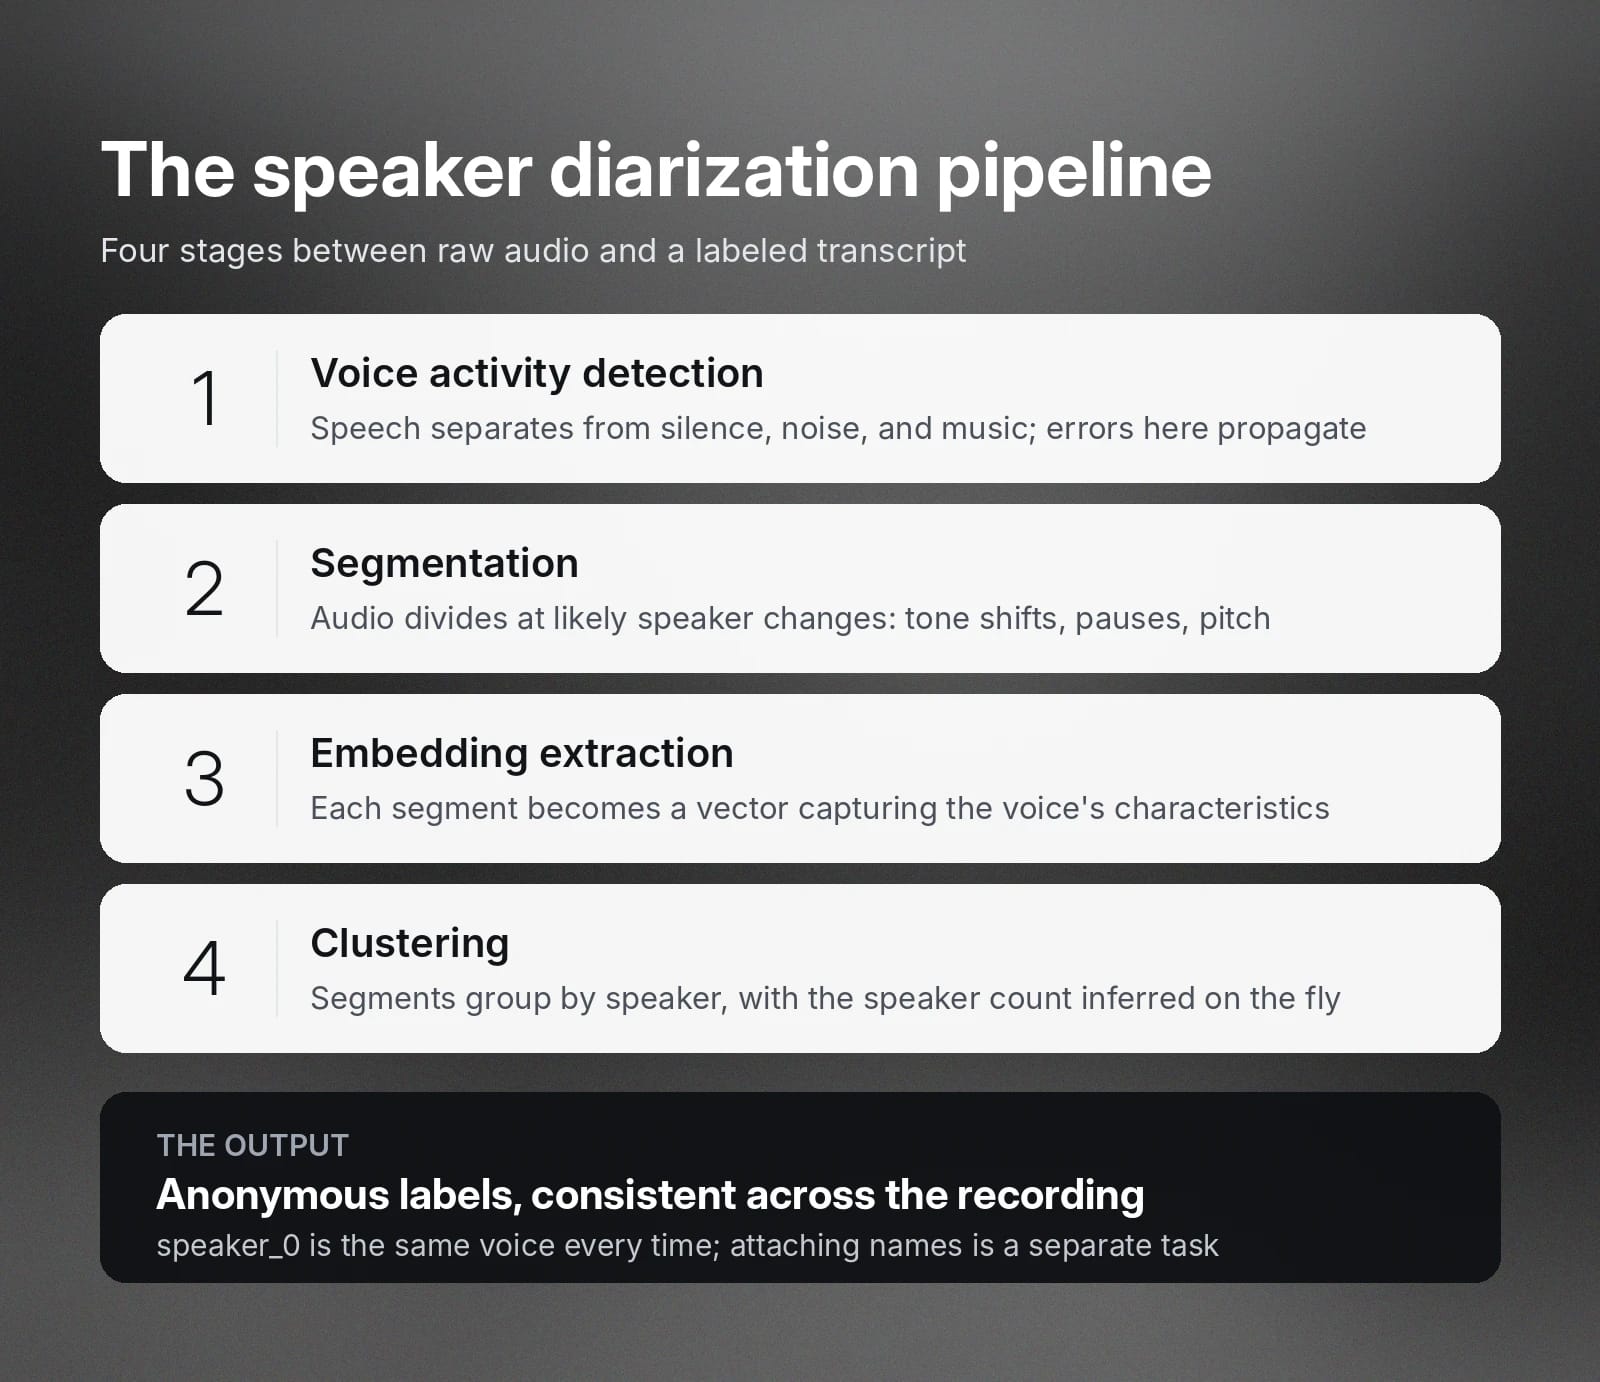
La plupart des systèmes de diarisation des locuteurs suivent un pipeline en quatre étapes :
Examinons ces étapes plus en détail.
Détection d’activité vocale (VAD)
La détection d’activité vocale sépare la parole de tout le reste : le silence, le bruit de fond, la musique ou les clics de clavier. Seuls les segments audio qui contiennent réellement de la parole passent à l’étape suivante.
Toute erreur à cette étape se propage aux étapes suivantes.
Segmentation
Ces segments contenant de la parole sont ensuite divisés aux points où le locuteur est susceptible de changer, par exemple lors d’une variation du ton de voix, d’une pause entre deux tours de parole ou d’un changement de hauteur. La plupart des systèmes détectent directement ces points de changement en comparant les caractéristiques acoustiques de chaque côté d’une frontière candidate.
Certains outils de segmentation découpent l’audio en courtes fenêtres uniformes, par exemple des segments de deux secondes, puis s’appuient sur l’étape de regroupement pour fusionner les fenêtres adjacentes appartenant au même locuteur.
Extraction d’embeddings
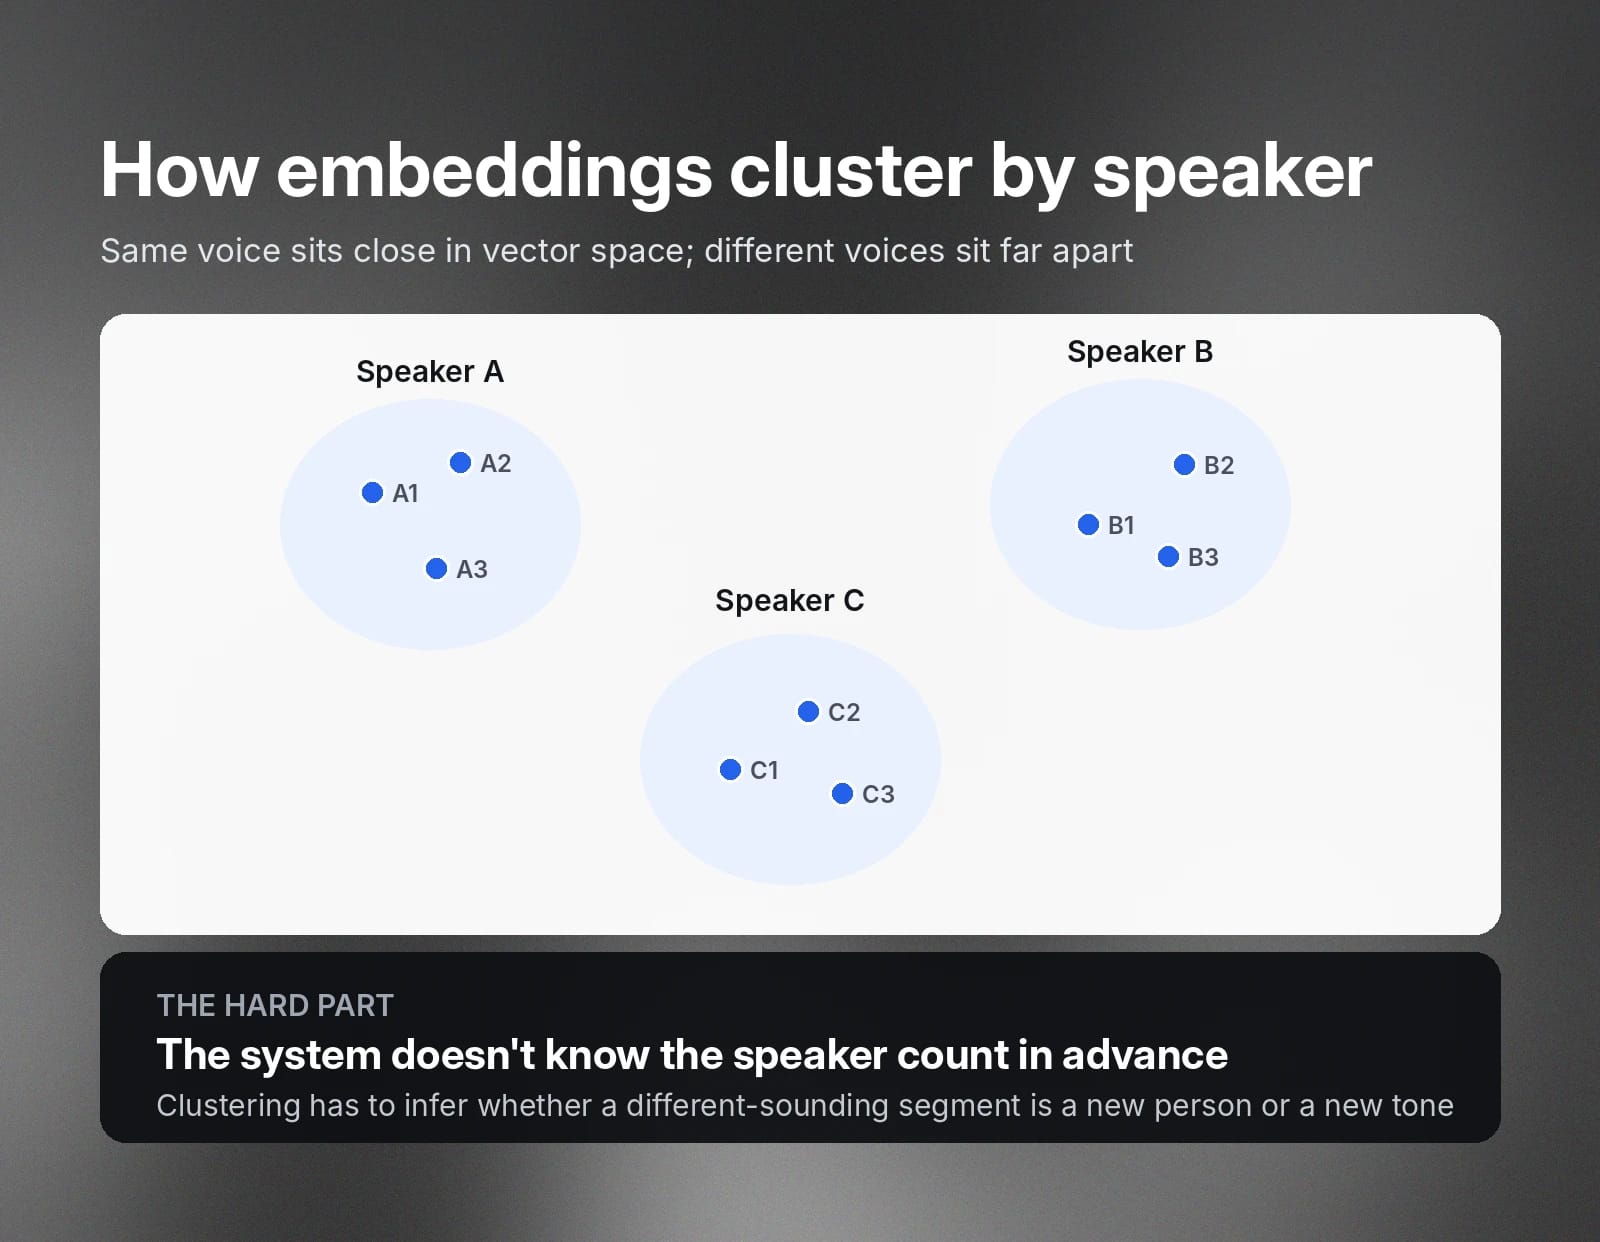
Chaque segment de parole est converti en embedding de locuteur, c’est-à-dire un vecteur numérique qui capture les caractéristiques vocales de la personne qui parle dans ce segment. Les embeddings d’un même locuteur se regroupent dans l’espace vectoriel, tandis que ceux de locuteurs différents sont plus éloignés.
Regroupement
Les embeddings sont ensuite regroupés afin que les segments du même locuteur partagent une même étiquette. Le système ne connaît généralement pas le nombre de locuteurs à l’avance ; l’algorithme de regroupement doit donc l’inférer et déterminer si un segment à la sonorité légèrement différente correspond à un nouveau locuteur ou à la même personne parlant sur un ton différent.
Le résultat est un ensemble d’étiquettes de locuteurs associées à des plages temporelles, généralement accompagné d’une transcription. Par exemple, une transcription avec diarisation d’un appel entre deux personnes se présente ainsi :
- [speaker_0] Merci de votre appel. Comment puis-je vous aider ?
- [speaker_1] Bonjour, j’appelle au sujet de ma facture du mois dernier.
- [speaker_0] Bien sûr, je vais regarder cela.
Les étiquettes sont anonymes et cohérentes en interne. Speaker_0 correspond à la même voix à chaque occurrence, mais le système ne sait pas que speaker_0 s’appelle Fergal. Associer de véritables identités est une tâche distincte, abordée ci-dessous.
Principales différences entre segmentation et identification des locuteurs
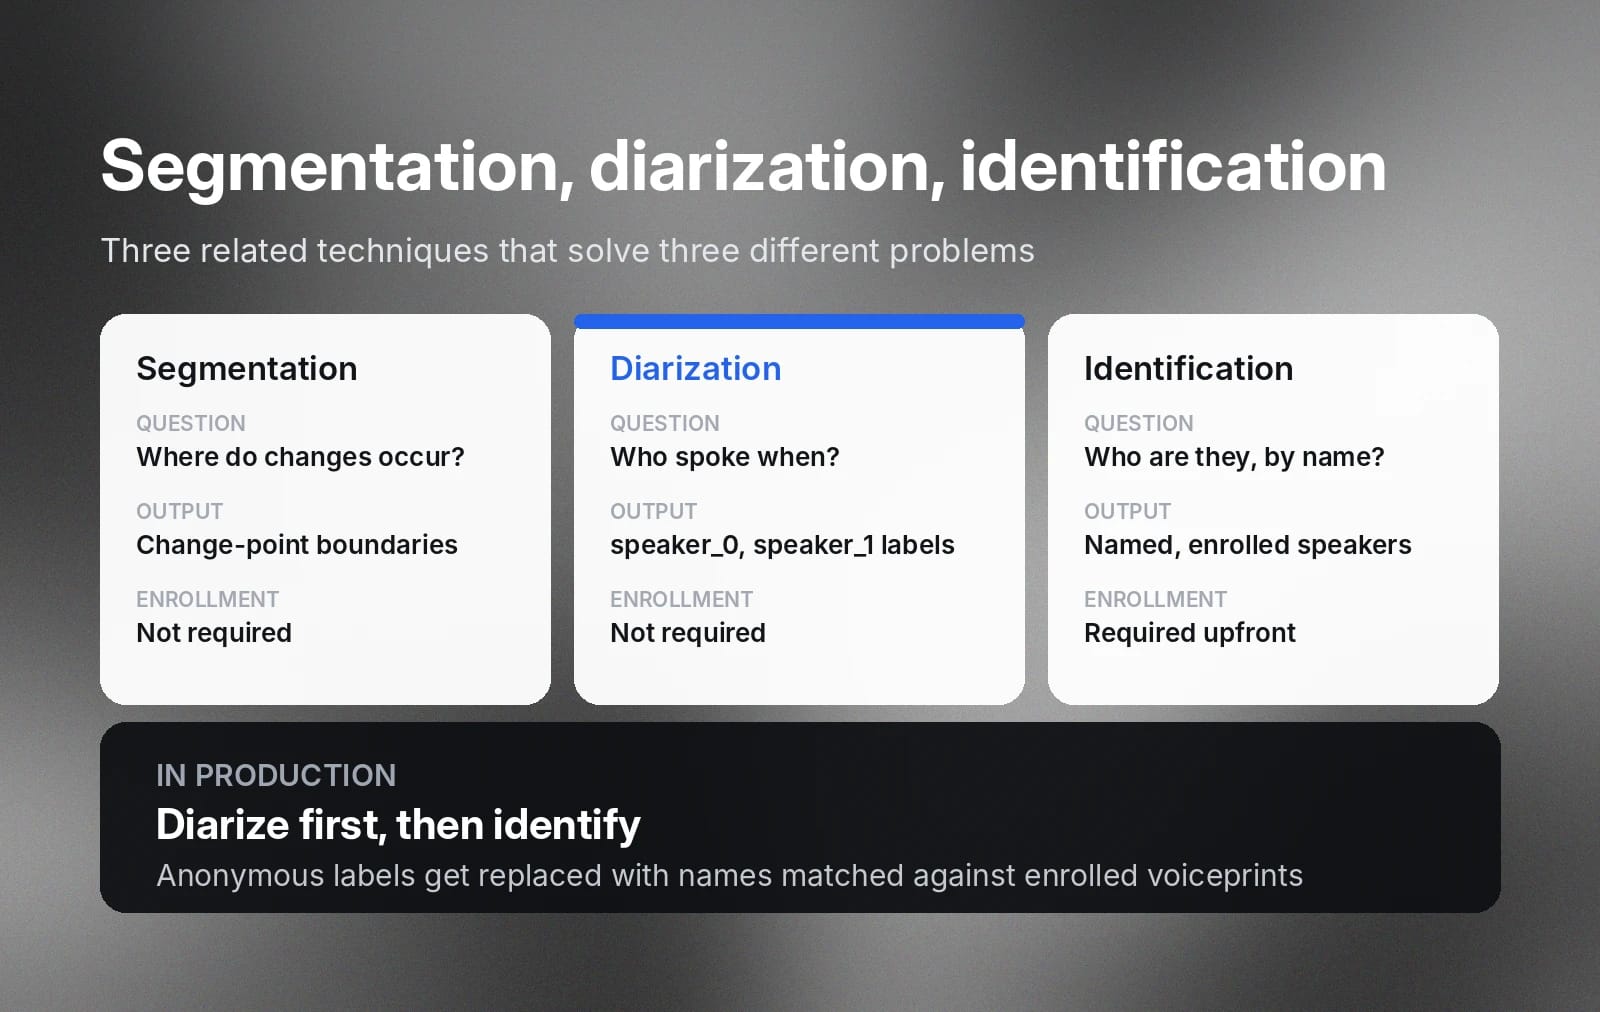
La segmentation et l’identification des locuteurs recoupent étroitement la diarisation, ce qui conduit souvent à confondre ces trois notions.
Chacune résout un problème légèrement différent ; il est donc important de comprendre cette distinction pour évaluer les outils.
Comme expliqué précédemment, la segmentation des locuteurs est une étape de la diarisation qui intervient tôt dans le pipeline. Elle détecte les frontières où l’on passe d’une voix à une autre, sans attribuer d’étiquettes. La segmentation vous indique qu’un changement a eu lieu à 0:42. La diarisation va plus loin en regroupant les segments obtenus et en produisant un résultat entièrement étiqueté : vous savez ainsi que la voix entendue à 1:15 est la même que celle du début de l’enregistrement.
L’identification des locuteurs est une capacité distincte de la diarisation, mais elle lui est fréquemment associée. L’identification détermine qui sont réellement ces locuteurs. Un système d’identification compare les voix à des empreintes vocales enregistrées et s’appuie sur une référence de locuteurs connus pour renvoyer des identités. Après identification, speaker_0 et speaker_1 deviennent « Fergal » et « Eric ».
De nombreux produits combinent ces outils pour produire une transcription finale plus complète. Un outil de réunion peut le faire automatiquement, éventuellement en récupérant des informations telles que le nom configuré par une personne dans Teams ou Meet, afin d’attribuer les contributions de chaque participant par son nom sans révision manuelle.
Outils et bibliothèques open source populaires pour la diarisation des locuteurs
Les outils open source de diarisation des locuteurs méritent d’être envisagés lorsque vous avez besoin de contrôle, de flexibilité ou d’un déploiement local. Le meilleur choix dépend du type d’audio que vous traitez, appels téléphoniques, réunions, podcasts ou diffusion, de vos exigences de latence et du temps d’ingénierie que vous pouvez y consacrer.
Voici quelques-unes des options les plus populaires.
Pyannote.audio
Pyannote.audio est une boîte à outils fondée sur PyTorch, conçue spécifiquement pour la diarisation des locuteurs et parmi les options open source les plus courantes. Elle fournit des pipelines préentraînés couvrant l’ensemble de la chaîne de diarisation, notamment la VAD, la segmentation, les embeddings et le regroupement, ainsi que les composants nécessaires pour entraîner ou affiner des modèles sur vos propres données.
Ses modèles préentraînés sont distribués via Hugging Face et couramment utilisés comme couche de diarisation dans des projets de transcription plus vastes.
WhisperX
WhisperX combine Whisper d’OpenAI ASR avec la diarisation et l’alignement forcé. Whisper produit à lui seul des transcriptions solides, mais n’attribue pas d’étiquettes de locuteurs et ses horodatages ne sont qu’approximatifs. WhisperX ajoute un alignement des horodatages au niveau des mots et intègre une diarisation fondée sur pyannote, produisant des transcriptions où chaque mot comporte à la fois un horodatage précis et une étiquette de locuteur.
NVIDIA NeMo
NVIDIA NeMo inclut la diarisation dans son cadre plus large d’IA conversationnelle. Il fournit des modèles de diarisation entraînables, y compris des approches de bout en bout qui gèrent la parole qui se chevauche, et est conçu pour les équipes qui développent des systèmes vocaux sur mesure à grande échelle sur une infrastructure GPU.
Chacun de ces outils exige de gérer l’infrastructure de diarisation, notamment le déploiement, la mise à l’échelle, le suivi et les mises à jour des modèles. Pour les équipes qui ne souhaitent pas cette charge opérationnelle, les API de diarisation de la parole gérées offrent une alternative plus simple. Elles peuvent s’intégrer aux workflows existants ou prendre en charge l’ensemble du pipeline de diarisation, ce qui les rend adaptées aux cas d’usage en production tels que l’analyse du support client, la transcription de réunions et le traitement de podcasts.
Diarisation en temps réel : défis et cas d’usage
La diarisation en temps réel est considérablement plus difficile que la diarisation sur un enregistrement terminé, car le système doit prendre des décisions avec un contexte incomplet.
Un système hors ligne voit l’intégralité de l’enregistrement avant de prendre une décision. Il peut comparer une voix à la deuxième minute à une voix à la quarantième minute et déterminer avec certitude qu’il s’agit du même locuteur, car ces deux moments sont disponibles simultanément. Un système en temps réel ne dispose jamais de ce luxe : il doit étiqueter la parole dès son arrivée, sans accès à ce qui sera dit ensuite et avec peu, voire aucune possibilité de réviser une décision une fois prise.
Cette absence de contexte futur rend trois problèmes particulièrement plus difficiles à résoudre en temps réel :
- Latence ou précision : sans la possibilité d’analyser l’ensemble de la conversation, respecter des délais de réponse plus stricts se fait directement au détriment de la précision.
- Parole qui se chevauche : lorsque plusieurs personnes parlent en même temps, un système capable de retraiter l’audio pourrait les distinguer. Un système en temps réel doit l’attribuer à une seule étiquette ou s’appuyer à la volée sur des modèles spécialisés dans les chevauchements.
- Énoncés courts : un simple « oui » ou « allez-y » donne à peine assez de voix au système pour analyser, et sans contexte environnant sur lequel s’appuyer, il doit malgré tout attribuer immédiatement une étiquette.
Malgré cette difficulté, certaines applications ne peuvent pas attendre la fin de l’enregistrement. Le sous-titrage en direct pour les réunions et les diffusions nécessite des étiquettes de locuteurs à mesure que les personnes parlent. Les logiciels pour centres d’appels qui fournissent des indications aux agents en cours d’appel doivent savoir quels mots le client utilise en temps réel. Les agents vocaux qui traitent des appels avec plusieurs participants doivent suivre qui demande quoi, sans délai. Dans chaque cas, un système légèrement moins précis mais immédiat est préférable à un système plus précis mais retardé.
Pour les charges de travail qui n’exigent pas réellement d’étiquettes en temps réel, comme l’analytique, la vérification de conformité et la génération de transcriptions, la diarisation par lots reste le meilleur choix, car elle est nettement plus précise.
Comment évaluer les performances de la diarisation des locuteurs
Deux métriques sont essentielles pour mesurer la précision de la diarisation : le taux d’erreur de diarisation (DER), qui reflète la précision globale, et le taux d’erreur de Jaccard (JER), qui vérifie que cette précision se maintient pour chaque locuteur.
Le DER calcule précisément la fraction du temps de parole total attribuée de manière incorrecte. Il combine trois types d’erreurs :
- Fausse alarme de parole : le système a étiqueté un segment comme de la parole alors que personne ne parlait.
- Parole manquée : une personne parlait, mais le système l’a étiquetée comme du silence.
- Confusion entre locuteurs : la parole a été détectée, mais attribuée au mauvais locuteur.
DER = (fausse alarme + parole manquée + confusion entre locuteurs) / durée totale de parole
Un DER de 10 % signifie que les erreurs représentent un dixième du temps de parole total, pour ces trois types d’erreurs. Plus il est faible, mieux c’est ; les scores ne sont comparables que s’ils sont mesurés sur les mêmes données et dans les mêmes conditions. Le DER varie fortement selon la qualité audio, le nombre de locuteurs et l’ampleur des chevauchements dans l’enregistrement.
Le taux d’erreur de Jaccard (JER) mesure séparément la précision de la diarisation pour chaque locuteur, puis calcule la moyenne des résultats pour l’ensemble des locuteurs. Pour chaque locuteur de référence, l’évaluateur associe l’étiquette de locuteur la plus proche du système et compare leur durée de chevauchement correcte au temps total attribué à l’un ou l’autre locuteur.
Prenons l’exemple d’une réunion de 60 minutes où le locuteur A parle pendant 50 minutes et le locuteur B pendant 10 minutes. Un système de diarisation étiquette correctement 48 des 50 minutes du locuteur A, mais seulement 4 des 10 minutes du locuteur B. Son DER global peut sembler relativement bon, car la majeure partie de la réunion appartient au locuteur A. Le JER accorde autant de poids au faible résultat du locuteur B, car il évalue indépendamment les locuteurs A et B avant de faire la moyenne de leurs scores.
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
Le JER final correspond à la moyenne de ces taux d’erreur par locuteur :
JER = (1 / N) * Σ[JER_speaker_i] pour i = 1..N
Suivre à la fois le DER et le JER offre une vision plus complète de la précision de la diarisation : le DER pour la précision globale, le JER pour vérifier que cette précision se maintient pour chaque participant, y compris ceux qui parlent moins souvent.
Tests sur des contenus audio représentatifs de la production
Lorsque vous évaluez un système de diarisation des locuteurs, calculez le DER et le JER sur des contenus audio correspondant à vos conditions de déploiement réelles : vos nombres habituels de locuteurs, votre qualité audio et votre volume de conversations croisées.
Les scores de référence publiés peuvent être mesurés sur des jeux de données propres et contrôlés, comme des enregistrements en studio, qui correspondent rarement au son réel des enregistrements d’appels ou des réunions en direct. Un système performant sur les benchmarks peut tout de même être nettement moins performant sur des contenus audio réels, bruyants et avec chevauchements. Testez vos propres données avant de vous engager sur un produit de diarisation.
Démarrez avec ElevenAPI pour la diarisation des locuteurs
Si vous êtes prêt à créer une fonctionnalité de transcription compatible avec plusieurs locuteurs, Scribe v2 d’ElevenLabs rend la diarisation des locuteurs disponible via une seule API Speech to Text. Envoyez l’audio au point de terminaison avec diarize=true, et la réponse JSON étiquette chaque mot avec un ID de locuteur, pour un maximum de 32 locuteurs, dans plus de 90 langues et sur des fichiers d’une durée maximale de 10 heures.
Deux options étendent la sortie de diarisation standard. Pour les enregistrements d’appels, detect_speaker_roles=true étiquette les locuteurs comme agent et client plutôt qu’avec des numéros anonymes. Si votre Workspace comporte des profils de locuteurs enregistrés, use_speaker_library=true peut associer les locuteurs détectés à des voix enregistrées, réunissant diarisation et identification dans une seule requête.
Un paramètre de seuil de diarisation vous permet d’ajuster le compromis entre une segmentation excessive et la fusion de locuteurs. Lorsque vos locuteurs sont déjà isolés sur des canaux audio distincts, comme dans des enregistrements d’appels stéréo, la transcription multicanale attribue les locuteurs par canal et évite entièrement la diarisation.
Le guide de démarrage rapide Speech to Text vous accompagne pas à pas dans la première intégration. Pour les déploiements réglementés, la plateforme est conforme aux normes SOC 2, ISO 27001, PCI DSS L1 et HIPAA, avec hébergement des données en Europe et mode zéro rétention disponibles.
Prêt à intégrer la diarisation des locuteurs à vos systèmes ? Commencez par obtenir votre clé API ou consultez la documentation ElevenLabs pour en savoir plus.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


