Text to Speech vs Speech to Text : quelle est la différence ?
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Imaginez : vous vous rendez au travail en voiture et votre smartphone lit vos emails non lus grâce à un logiciel de synthèse vocale (TTS). Mieux encore, vous envoyez vos réponses sans même toucher votre téléphone ni quitter la route des yeux, grâce au logiciel de reconnaissance vocale (STT).
Ces technologies ne sont pas de simples concepts futuristes amusants. Elles s'intègrent rapidement à notre quotidien, simplifient les tâches courantes et améliorent l'accessibilité.
Plongeons dans l'univers des TTS et STT propulsés par l'intelligence artificielle : découvrons ce qu'ils sont, leurs différences, leur fonctionnement, les critères à prendre en compte chez les fournisseurs de TTS et STT, ainsi que leurs nombreuses applications dans tous les secteurs.
Différences entre le TTS et la reconnaissance vocale
Il existe plusieurs différences clés entre le TTS et la technologie de reconnaissance vocale. Les voici.
Fonctionnement
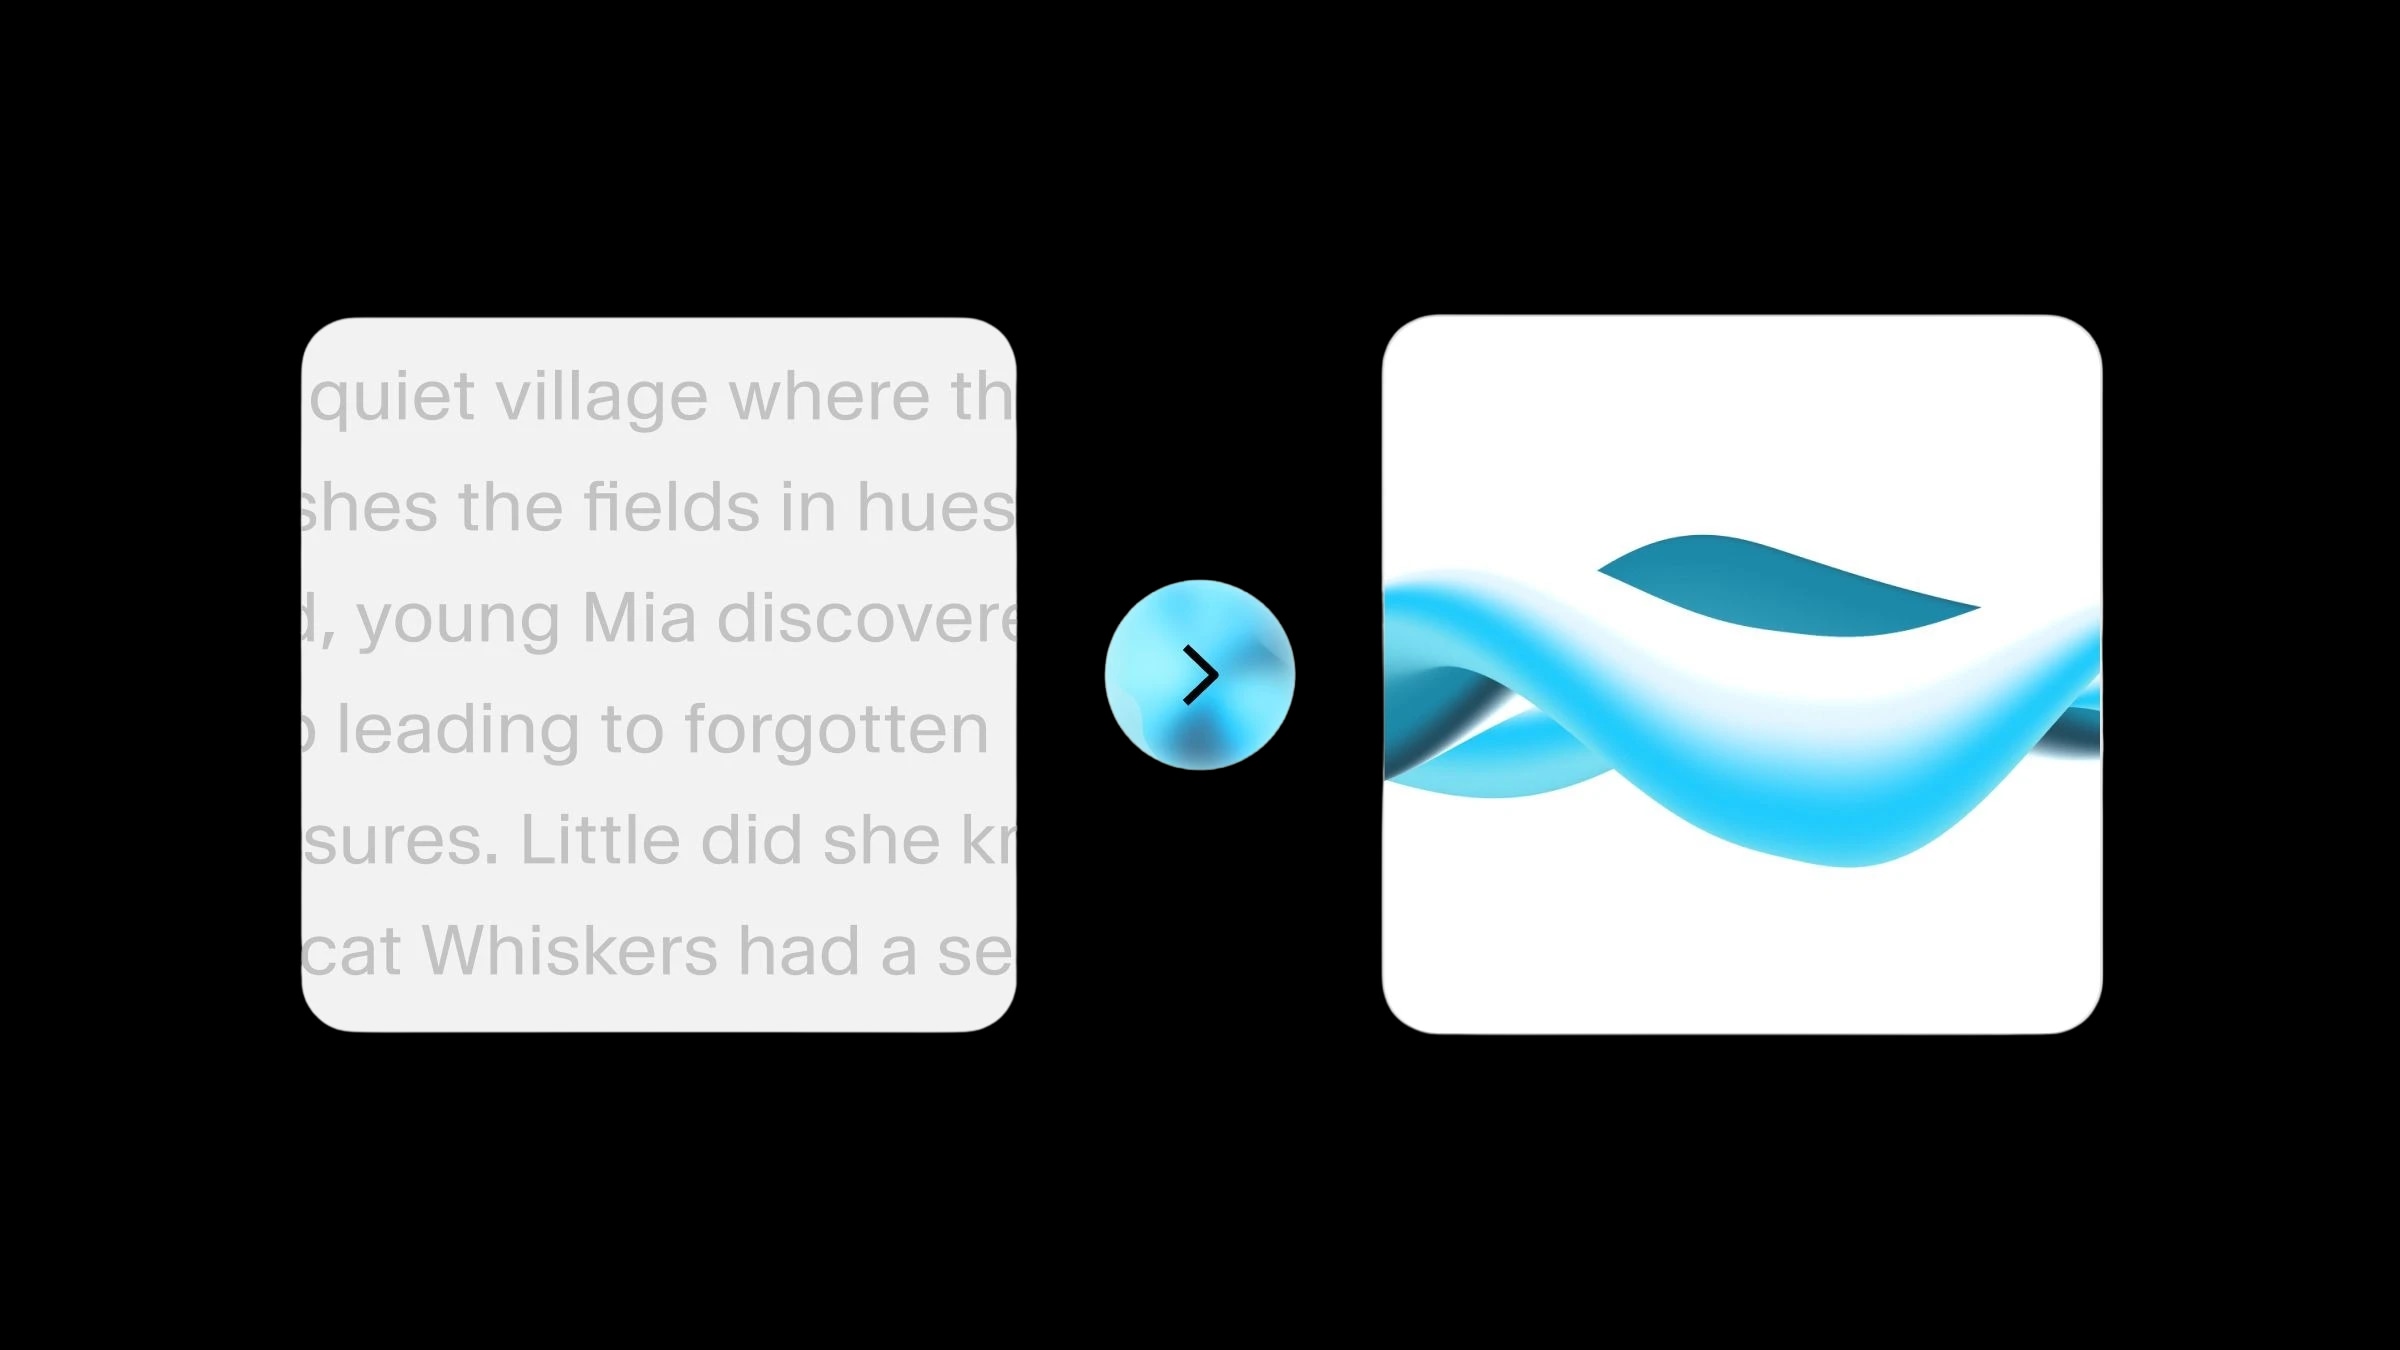
Le TTS (Text to Speech) convertit un texte écrit en paroles, tandis que la reconnaissance vocale (STT) fait l'inverse en transcrivant les paroles en texte. Le TTS rend les contenus écrits audibles et agit comme un assistant vocal pour les personnes malvoyantes ou ayant des difficultés d'apprentissage. À l'inverse, le STT capte la langue parlée et la transforme en transcription écrite, utile pour la dictée et les commandes vocales.
Contexte d'utilisation
Le TTS est couramment intégré aux liseuses, aux systèmes d'annonces publiques et aux assistants virtuels pour fournir une restitution audio. Le STT est utilisé dans les services de transcription, les applications contrôlées par la voix et le sous-titrage en temps réel pour les personnes malentendantes. Le TTS est principalement orienté vers la restitution d'informations audibles. À l'inverse, le STT est centré sur la capture et le traitement de la langue parlée.
Approche technologique
La technologie TTS implique l'analyse de texte, le traitement du langage et la synthèse vocale. Elle doit restituer avec précision les nuances de la langue parlée, notamment l'intonation et le rythme. Le STT exige des capacités avancées de reconnaissance vocale pour transcrire fidèlement différents accents, dialectes et modes d'élocution, souvent en temps réel.
Qu'est-ce que le TTS (Text to Speech) ?
Le TTS (Text to Speech) est une technologie qui convertit un texte écrit en paroles. Au cœur de son fonctionnement, le TTS permet aux ordinateurs de lire à voix haute et de transformer tout texte en voix synthétique. Cette technologie est largement utilisée, des assistants virtuels aux outils d'accessibilité destinés aux personnes ayant des difficultés de lecture.
Un exemple notable de technologie TTS avancée réside dans les capacités TTS d'ElevenLabs. Le TTS d'ElevenLabs se distingue par sa capacité à produire des voix exceptionnellement naturelles et humaines. Il s'appuie sur des algorithmes d'IA sophistiqués qui imitent non seulement le son de la parole humaine, mais comprennent et reproduisent aussi les nuances et inflexions caractéristiques des modes d'élocution naturels.
Ce niveau de réalisme fait du TTS d'ElevenLabs une solution idéale pour créer des contenus audio captivants pour différents médias, enrichir les interfaces utilisateur de retours vocaux et proposer une alternative de lecture accessible aux utilisateurs malvoyants.
Qu'est-ce que la reconnaissance vocale (Speech to Text, STT) ?
La reconnaissance vocale, aussi appelée Speech to Text (STT), est le processus de conversion de la langue parlée en texte écrit. Cette technologie de reconnaissance vocale est essentielle pour créer des transcriptions à partir d'enregistrements audio, activer les commandes vocales et faciliter le sous-titrage en temps réel à des fins d'accessibilité.
ElevenLabs a réalisé des avancées majeures dans la technologie STT. Notre modèle Scribe convertit efficacement l'audio et la vidéo en texte dans 99 langues. Son interface intuitive le rend idéal pour retranscrire des réunions, des cours et des entretiens à partir de fichiers audio et vidéo.
Comment fonctionne le TTS ?
La technologie TTS (Text to Speech) transforme un texte écrit en parole audible au moyen de plusieurs étapes complexes.
Tout d'abord, le système de TTS analyse le texte et le segmente en phonèmes, les plus petites unités sonores d'une langue. Cette segmentation est essentielle pour que le système puisse prononcer correctement les différents mots.
Après cette segmentation phonémique, le système convertit ces sons en parole numérique. L'intelligence artificielle (IA) joue ici un rôle crucial. Grâce à des algorithmes d'IA entraînés sur d'importants jeux de données de langue parlée, le système peut produire une parole aux tons et rythmes proches de ceux des humains. Cette parole générée est ensuite alignée sur les phonèmes identifiés pour obtenir un rendu naturel.
Grâce aux avancées de l'IA et du machine learning, les technologies TTS modernes ont considérablement évolué. Elles peuvent désormais comprendre les nuances contextuelles, prendre en charge plusieurs langues et reproduire dans une certaine mesure les inflexions émotionnelles. Ces améliorations ont rendu la parole synthétique bien plus humaine, pour des interactions plus naturelles et engageantes avec les appareils numériques.
Quels sont les meilleurs fournisseurs de TTS ?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Comment fonctionne la reconnaissance vocale ?
La technologie de reconnaissance vocale (STT) transforme la langue parlée en texte écrit selon un processus complexe en plusieurs étapes.
Elle commence par la capture des paroles, généralement à l'aide d'un microphone. Cette entrée audio est ensuite convertie dans un format numérique que le système peut traiter. Le STT repose sur sa capacité à analyser cet audio numérique. Il utilise des algorithmes sophistiqués pour décomposer la parole en segments plus petits et reconnaissables.
Ces segments sont des phonèmes, les plus petites unités sonores de la parole. Le système STT compare ces phonèmes à un modèle linguistique prédéfini afin d'identifier les mots et les expressions. Cette étape est cruciale pour comprendre les différents accents, dialectes et variations de la parole.
Le système applique ensuite des techniques de traitement automatique du langage naturel (TLN). Le TLN aide à comprendre le contexte et la syntaxe de la langue parlée, ce qui permet une transcription plus précise. Il permet également au système de gérer des structures de phrase complexes et le jargon propre à certains secteurs.
Les systèmes STT avancés utilisent des algorithmes de machine learning et de deep learning qui s'améliorent avec les données et l'utilisation. Ces technologies permettent au système d'apprendre au fil du temps de nouveaux modes d'élocution, accents et même langues, améliorant ainsi sa précision et son efficacité.
En résumé, la technologie STT associe la capture audio, l'analyse phonémique, la modélisation linguistique et le TLN, le tout soutenu par le machine learning, pour convertir efficacement la parole en texte.
Quels sont les meilleurs fournisseurs de reconnaissance vocale ?
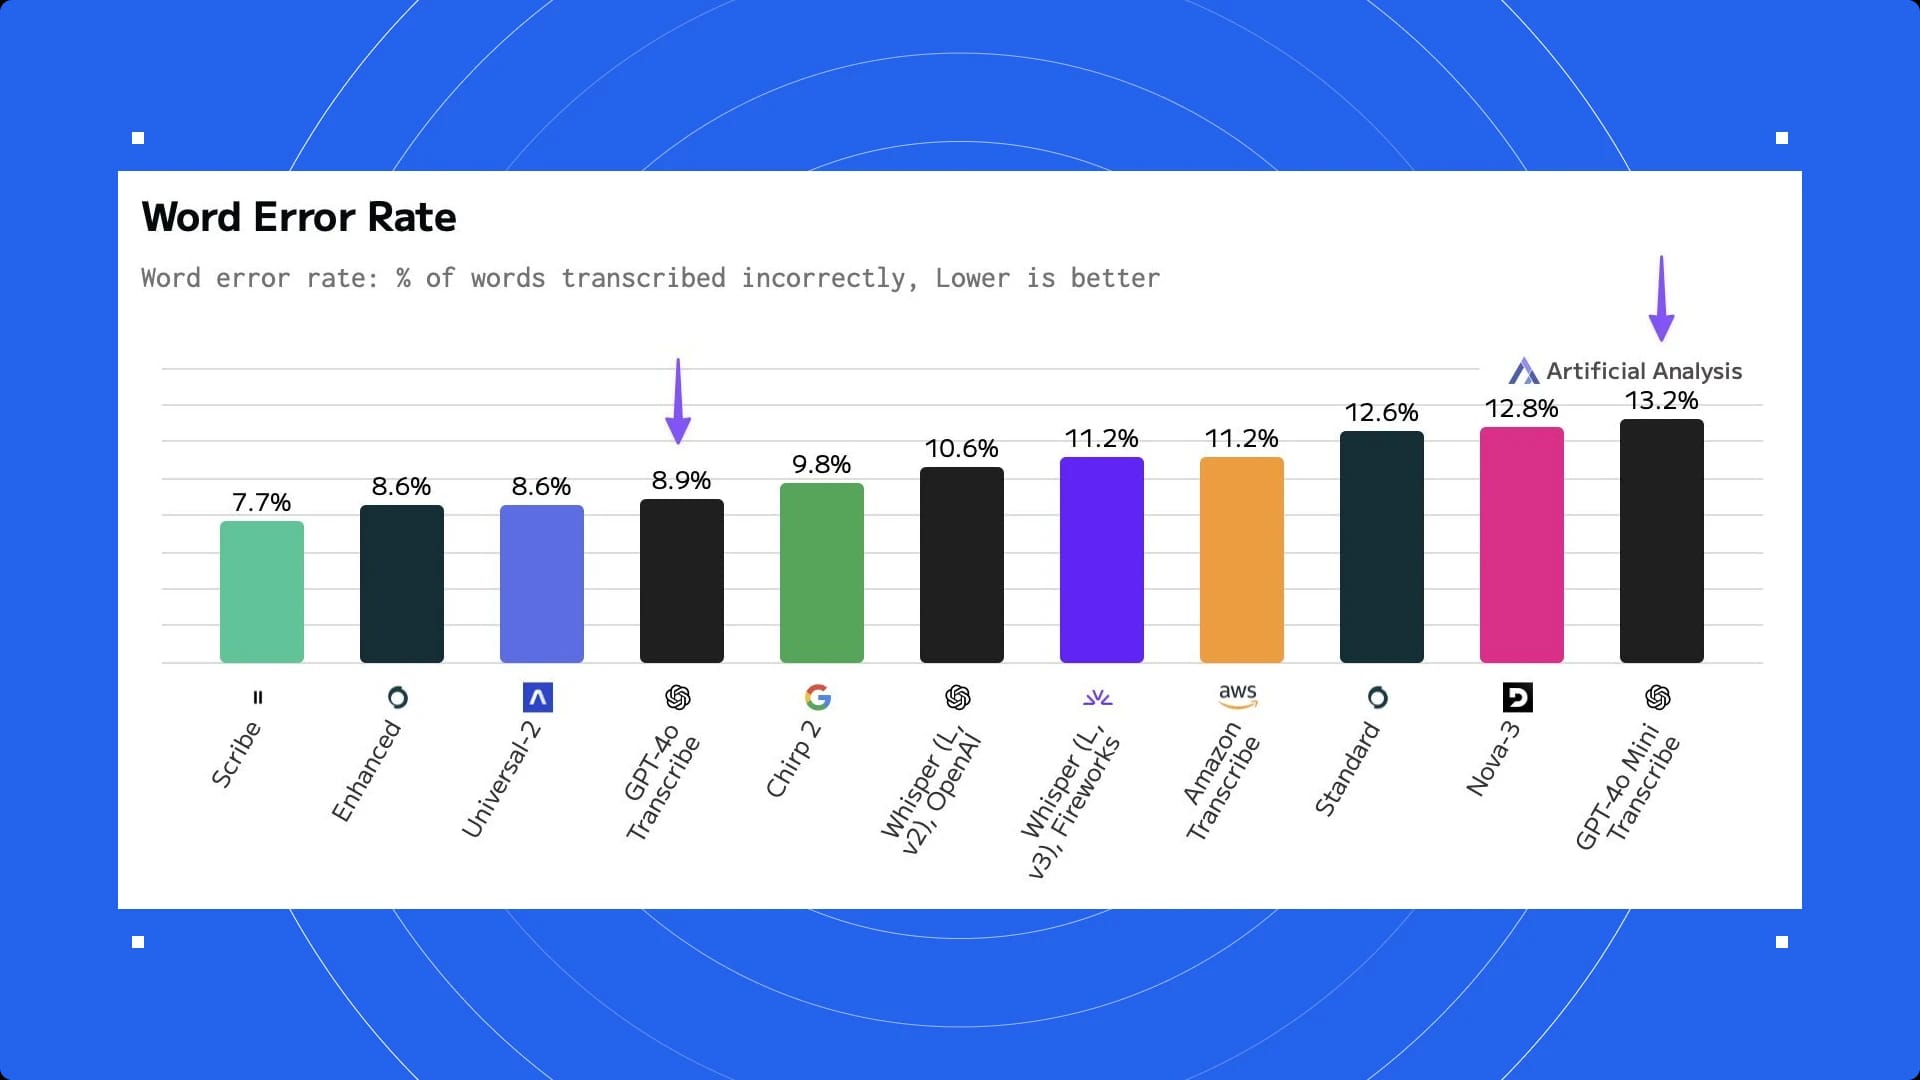
Les meilleurs fournisseurs de reconnaissance vocale sont Scribe d'ElevenLabs, suivi d'OpenAI et d'autres fournisseurs tels que Google.
TTS et STT : précision et défis
Les technologies TTS et Speech to Text visent une précision proche de celle des humains. Leur précision s'améliore constamment, sans pour autant être parfaite. Voici ce que vous pouvez attendre de ces deux technologies en matière de précision et de défis.
Précision et défis du TTS
La technologie de TTS à voix IA a beaucoup évolué, mais elle reste confrontée à certains défis. Le principal consiste à produire des voix humaines naturelles. Si les systèmes TTS modernes peuvent générer un audio clair et compréhensible, leur insuffler des inflexions et des émotions humaines reste difficile. Le TTS peine aussi à interpréter le contexte et peut parfois mal prononcer des mots selon leur contexte. Un autre défi est la personnalisation des voix pour répondre à des besoins variés, tels que différents accents et modes d'élocution, essentielle à l'accessibilité mondiale.
Précision et défis de la reconnaissance vocale (STT)
La technologie STT a beaucoup progressé en précision, notamment avec l'avènement du deep learning. Elle rencontre toutefois des difficultés dans les environnements bruyants, où les sons de fond peuvent perturber la reconnaissance vocale. La capture et la transcription précises de différents accents et dialectes constituent également un défi important. En outre, les systèmes STT peinent souvent avec les homophones, des mots qui se prononcent de la même façon mais ont des sens différents, ainsi qu'avec la compréhension d'une syntaxe complexe ou de l'argot, ce qui réduit leur efficacité globale dans les applications concrètes.
Applications dans différents secteurs
Les technologies TTS et Speech to Text ont trouvé des cas d'usage innovants dans de nombreux secteurs, transformant notre interaction avec l'information et améliorant l'accessibilité.
Applications du TTS dans les secteurs d'activité
La technologie TTS est utilisée dans divers secteurs. Dans l'éducation, elle aide à créer des supports d'apprentissage accessibles aux élèves ayant des difficultés de lecture ou des déficiences visuelles. Par exemple, en transformant les manuels en livres audio.
Dans l'industrie automobile, le TTS alimente les réponses vocales des systèmes de navigation. Le secteur du service client utilise le TTS pour automatiser les réponses dans les centres d'appels et gagner en efficacité. Le TTS joue également un rôle important dans le divertissement, notamment les jeux vidéo et les assistants virtuels, où il offre des expériences utilisateur interactives.
Applications du STT dans les secteurs d'activité
La technologie STT a de nombreuses applications dans plusieurs secteurs. Dans la santé, elle aide à transcrire les échanges entre médecins et patients ainsi qu'à dicter la documentation clinique, ce qui améliore l'efficacité. Dans le domaine juridique, le STT sert à transcrire les procédures judiciaires et les documents juridiques. La technologie joue aussi un rôle clé dans les médias en facilitant le sous-titrage en temps réel des diffusions pour les personnes malentendantes. Dans les entreprises, le STT facilite la transcription efficace des réunions, améliorant l'archivage et l'accessibilité des informations.
En conclusion
Les technologies TTS (Text to Speech) et Speech to Text (STT), bien qu'apparemment similaires, remplissent des fonctions distinctes. Le TTS transforme un texte écrit en paroles et donne vie aux contenus écrits avec des voix proches de celles des humains. À l'inverse, le STT convertit les paroles en texte écrit, en capturant les nuances de la langue parlée sous forme textuelle.
Ces deux technologies s'appuient sur une IA avancée, mais répondent à des besoins différents : le TTS pour écouter des contenus écrits, et le STT pour créer des traces écrites de contenus parlés.
Prêt à vous lancer ? Essayez Eleven v4, notre modèle Text to Speech le plus expressif.
Pour découvrir une technologie TTS de pointe, inscrivez-vous à ElevenLabs dès aujourd'hui. Vous ne serez pas déçu.