
Qu’est-ce que la latence de l’IA conversationnelle et quels facteurs l’influencent ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Pour l’IA conversationnelle, la latence distingue les bonnes applications des excellentes.
Par nature, l’IA conversationnelle est ambitieuse. Elle cherche à reproduire la sensation d’une conversation humaine, avec la même palette émotionnelle, la même intonation et le même rythme. Ajoutez un délai « naturel » entre le moment où vous cessez de parler et celui où un agent IA commence à répondre, et vous obtenez un objectif de latence fondé sur la façon dont les humains communiquent réellement.
Les entreprises qui souhaitent déployer des agents d’IA conversationnelle à grande échelle doivent réduire cette latence autant que possible pour créer cette illusion naturelle. Cet article explique ce qu’est la latence de l’IA conversationnelle, ce qui provoque des délais dans l’ensemble du pipeline et comment les réduire.
En résumé
- La latence de l’IA conversationnelle correspond au délai total de bout en bout entre le moment où un utilisateur cesse de parler et celui où il entend le premier mot de l’agent.
- Les agents dont la latence dépasse 700 ms peuvent sembler peu naturels, et ceux au-delà de 1 200 ms affichent des taux d’abandon élevés.
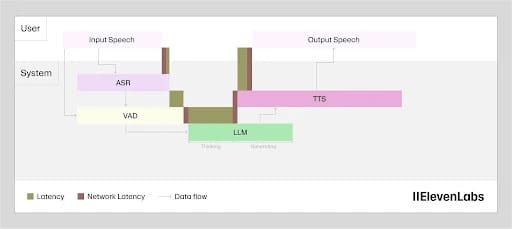
- La latence s’accumule à chaque étape du pipeline d’IA conversationnelle.
- ElevenAgents gère l’ensemble du pipeline dans une architecture unifiée, rendant l’IA conversationnelle à faible latence accessible à votre entreprise.
Qu’est-ce que la latence de l’IA conversationnelle ?
La latence de l’IA conversationnelle désigne le temps total nécessaire à un système pour répondre après votre prise de parole. Pour les modèles IA modernes, elle se mesure en ms. En coulisses, cette valeur totale se compose de plusieurs processus distincts, chacun contribuant au pipeline de bout en bout.
Un pipeline d’IA conversationnelle type se présente ainsi :
- Un utilisateur parle
- L’audio est transcrit par un modèle Speech to Text
- La transcription est transmise à un modèle LLM, qui génère une réponse
- Le texte du LLM est ensuite synthétisé en audio par un modèle de Text to Speech
- L’audio est ensuite diffusé à l’utilisateur
Chacune de ces étapes ajoute de la latence à un système d’IA conversationnelle. Il est donc utile de clarifier plusieurs acronymes lorsque l’on parle de latence.
Latence d’inférence du modèle
La latence d’inférence d’un modèle est le temps qu’il consacre à générer une sortie, mesuré en interne et hors facteurs externes. C’est la mesure propre au modèle de la vitesse à laquelle votre moteur traite des entrées typiques. Par exemple, Flash v2.5 affiche une latence d’inférence d’environ 75 ms. Vous pouvez ainsi comparer la vitesse des modèles entre différents fournisseurs.
Gardez toutefois à l’esprit qu’il ne s’agit pas de la latence réellement perçue par l’utilisateur. Elle correspond uniquement au temps total passé par un modèle à générer une sortie.
Délai jusqu’au premier token du LLM
Le délai jusqu’au premier token (TTFT) d’un grand modèle de langage (LLM) correspond au temps total nécessaire pour traiter un prompt et générer le premier token de sortie exploitable.
La génération TTS commence lorsque le premier token arrive de votre LLM. Cette mesure indique donc le temps nécessaire au LLM pour commencer à solliciter votre modèle TTS. Dans la plupart des systèmes d’IA conversationnelle de bout en bout, le TTFT du LLM représente une part importante de la latence totale.
Délai TTS jusqu’au premier audio (TTFA)
Le délai TTS jusqu’au premier audio (TTFA) mesure le temps entre la première requête TTS et le moment où le premier fragment audio quitte réellement le modèle. Il décrit la latence d’inférence, spécifiquement pour les moteurs TTS.
Délai de bout en bout jusqu’au premier audio (TTFA)
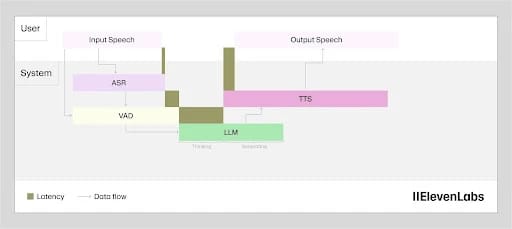
Le TTFA de bout en bout correspond à la latence totale de l’IA conversationnelle. Il additionne toutes les parties du pipeline, de la reconnaissance vocale, au TTFT du LLM, au TTS, au TTFA et à toutes les transmissions réseau entre les étapes. Lorsqu’on parle de la latence globale de l’IA conversationnelle, c’est cette mesure que perçoit l’utilisateur.
Lorsqu’il parle, il attend le TTFA de bout en bout avant d’entendre une réponse de votre agent. C’est une mesure globale : améliorer n’importe quelle partie du pipeline l’améliore.
Pourquoi la latence de l’IA conversationnelle est importante
Lorsqu’un utilisateur parle à votre agent IA, la latence devient un facteur central de son expérience. Une faible latence réduit l’attente avant une réponse, rend la conversation plus naturelle et l’agent plus compétent.
Les agents à forte latence paraissent artificiels et moins compétents, même si la qualité de leurs réponses reste identique. Pour une entreprise, quelques centaines de ms peuvent sembler une éternité et donner à votre agent de support client un aspect lourd et inefficace.
Voici plusieurs scénarios qui montrent concrètement l’importance de la latence de l’IA conversationnelle :
- Moins de 500 ms : un agent conversationnel semble réactif et fluide. Les utilisateurs peuvent ne pas percevoir le délai entre la fin de leur prise de parole et la première réponse, ce qui permet à la conversation de se dérouler naturellement.
- De 500 ms à 1 000 ms : le délai entre le moment où un utilisateur cesse de parler et celui où il reçoit une réponse peut devenir perceptible. Il est légèrement trop long, ce qui peut pousser les utilisateurs à se répéter ou à faire une pause pour vérifier si l’agent les a réellement compris.
- Au-delà de 1 000 ms : les délais commencent à sembler lents, avec des silences qui donnent à certains utilisateurs l’impression que l’agent IA ne suit pas pleinement la conversation. Les transcriptions peuvent révéler des interruptions occasionnelles ou des demandes pour parler à un agent humain. Dans certains cas, les utilisateurs peuvent abandonner l’appel.
Chacun de ces seuils a des conséquences concrètes pour l’entreprise.
Dans la partie basse du spectre de latence, votre agent de service client peut traiter naturellement les questions entrantes et aider les utilisateurs à résoudre leurs demandes sans assistance supplémentaire. Il allège la charge de vos agents humains et maintient une satisfaction client élevée. Dans la partie haute du spectre, vous frustrez vos clients avec un agent qui semble hésiter bien trop longtemps.
Nous avons défini les références de budget de latence pour les agents vocaux dans un autre article afin de montrer à quoi ressemble une bonne latence aux valeurs P50 comme P95.
Quelles sont les causes de la latence de l’IA conversationnelle ?
La latence de l’IA conversationnelle est un terme qui résume plusieurs processus, chaque segment contribuant à l’ensemble. Le principal obstacle à une faible latence relève donc davantage d’un problème au niveau du système que d’un simple choix de meilleur modèle. Après tout, plusieurs modèles interagissent dans le pipeline.
Pour les développeurs, nous avons rédigé un guide technique approfondi sur l’optimisation de la latence des agents vocaux que vous pouvez utiliser pour améliorer chaque étape du délai de bout en bout jusqu’au premier audio (TTFA).
Au-delà du pipeline principal, d’autres facteurs comme la téléphonie et les appels de fonction ajoutent également de la latence, bien qu’ils ne relèvent pas de l’infrastructure du modèle.
Voici un aperçu de tous les facteurs qui contribuent à la latence de l’IA conversationnelle.
Reconnaissance automatique de la parole
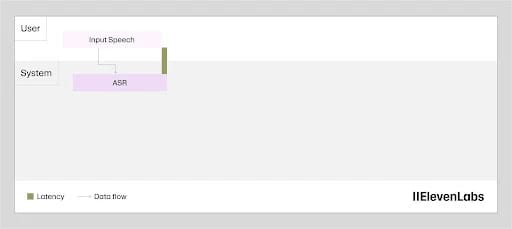
La latence de la reconnaissance vocale ne correspond pas au temps nécessaire pour générer une transcription. Le processus de transcription s’exécute en arrière-plan pendant que l’utilisateur parle, si bien qu’à la fin de la prise de parole, le texte est déjà largement prêt.
La latence correspond ici au délai entre la fin de la prise de parole et le moment où la transcription est finalisée puis transmise à l’étape suivante. Scribe v2 Realtime réduit cet écart à environ 150 ms, en diffusant continuellement la sortie afin qu’elle soit prête dès la fin du tour de parole.
Prise de tour et détection de fin de parole
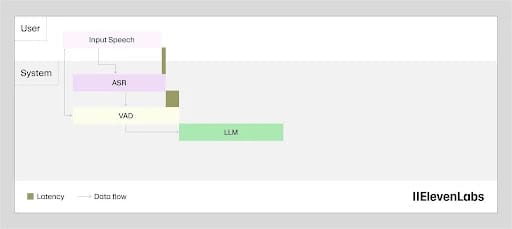
Un détecteur d’activité vocale (VAD) se situe entre la reconnaissance vocale et le modèle de langage. Il détermine si l’utilisateur a réellement fini de parler.
Pour éviter les erreurs, le VAD attend un seuil de silence continu avant de déclarer le tour terminé. Cette attente ajoute de la latence avant que le modèle de langage ne traite le moindre mot. Ce léger délai s’ajoute au total, mais il évite aussi que le système commence à répondre alors que l’utilisateur parle encore.
Techniquement, si tous les autres composants de l’IA conversationnelle avaient une latence nulle, la latence attribuée à la prise de tour serait bénéfique. Les humains marquent un temps avant de répondre. Une machine qui fait une pause similaire rend l’interaction plus réaliste. Toutefois, comme les autres composants de l’IA conversationnelle ajoutent déjà de la latence, une latence minimale est idéale.
Traitement du modèle de langage
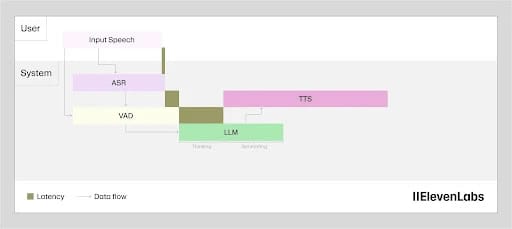
Une fois la transcription prête depuis le moteur de Speech to Text (STT), le modèle de langage génère une réponse. La latence correspond ici au temps nécessaire pour commencer à générer des tokens, et non pour produire la réponse complète. Ces tokens sont transmis directement à l’étape TTS à mesure qu’ils arrivent, c’est donc le TTFT qui compte le plus.
Au-delà du choix du modèle, la longueur du prompt et la taille de la base de connaissances influent toutes deux sur cette étape. Plus le LLM doit prendre de contexte en compte, plus cela prend du temps. Lors de la conception de ces systèmes à grande échelle, trouvez le juste équilibre entre une base de connaissances utile et un prompt concis pour préserver la rapidité.
Synthèse vocale
La latence TTS est le temps entre la réception des premiers tokens du modèle de langage et le début de l’audio. Les tokens arrivant plus vite que la parole humaine n’est diffusée, le modèle de synthèse n’attend jamais la réponse complète. La latence TTS correspond strictement au délai jusqu’au premier fragment audio.
Cette étape était autrefois le principal facteur de latence de l’IA conversationnelle, les anciens modèles mettant 2 à 3 secondes à commencer à générer la parole. Flash v2.5 d’ElevenLabs répond directement à ce défi, avec une synthèse vocale à environ 75 ms de latence, ramenant ce goulot d’étranglement de plusieurs secondes à une fraction de seconde.
Latence réseau
L’envoi de données d’un lieu à un autre ajoute toujours de la latence, la distance géographique ne faisant qu’accentuer la latence aller-retour du réseau.
Comme plusieurs composants collaborent pour produire une réponse de bout en bout, une latence importante peut s’accumuler au fil de plusieurs sauts réseau.
Appels de fonction
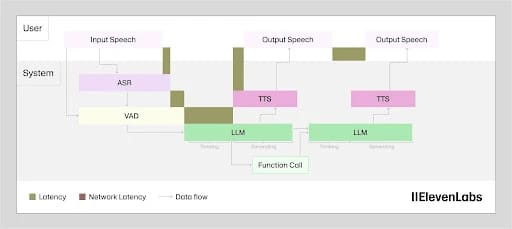
Les appels de fonction ajoutent des allers-retours d’API à l’étape du LLM. Une recherche interne rapide ajoute quelques dizaines de millisecondes, tandis qu’un prestataire de paiement ou un système de gestion des stocks peut ajouter plusieurs secondes. La latence dépend entièrement du service appelé, ce qui en fait l’étape la plus difficile à optimiser directement.
Le schéma le plus efficace consiste à inviter le LLM à répondre avant la fin de l’appel d’outil. Une phrase telle que « Je vérifie cela pour vous » maintient l’utilisateur engagé pendant que l’appel externe est traité, plutôt que de laisser un silence. La réponse vocale démarre pendant que l’outil s’exécute en parallèle.
Comment réduire la latence de l’IA conversationnelle
Réduire la latence de l’IA conversationnelle exige d’agir sur chaque étape du pipeline selon son impact. Chaque amélioration a un effet sur la latence, mais c’est en travaillant sur l’ensemble du pipeline que vous obtiendrez le changement le plus significatif.
Voici quelques principes pour réduire globalement la latence de l’IA conversationnelle :
- Choix du modèle TTS : les modèles TTS optimisés pour la vitesse, comme Flash v2.5, reposent sur des architectures différentes de celles des modèles optimisés pour la qualité, comme Eleven v3. Pour les agents vocaux en temps réel, le bon choix est le modèle de meilleure qualité qui respecte votre objectif de latence, presque toujours un modèle optimisé pour la vitesse.
- Choix du modèle LLM : les LLM plus petits et rapides produisent généralement un délai jusqu’au premier token inférieur à celui des modèles plus grands. Sélectionner le LLM le plus rapide qui répond toujours à vos exigences de qualité pour la tâche compte autant que le choix du modèle TTS.
- Streaming : le streaming TTS renvoie l’audio par fragments au fur et à mesure de la synthèse. L’utilisateur entend donc le premier mot alors que le modèle génère encore la suite. Ce principe s’applique aussi à la sortie du LLM : commencer la synthèse TTS dès la première phrase pendant que le modèle de langage génère les suivantes permet de récupérer de la latence dans le pipeline.
- Prompt système : les utilisateurs peuvent rationaliser les prompts système en déplaçant les instructions vers des procédures ou des workflows, plutôt que de les conserver dans chaque étape de décision. Cela réduit la quantité de contexte sur laquelle le modèle doit raisonner à chaque tour.
- Garde-fous : exécuter les garde-fous dans le modèle de streaming permet de lancer la lecture de la sortie avant la fin de leur vérification, plutôt que de bloquer la lecture jusqu’à la fin du contrôle.
- Colocalisation des modèles : l’utilisation de modèles colocalisés lorsque possible, comme dans la stack ElevenLabs Agents, rapproche les composants et évite d’ajouter de la latence due aux sauts entre modèles hébergés séparément.
- Géographie : la proximité entre vos serveurs et vos utilisateurs peut réduire considérablement la latence, car elle diminue directement la contribution du réseau au TTFA de bout en bout.
Au-delà de ces facteurs, consultez ce guide technique d’optimisation de la latence pour plus de détails.
Démarrez avec l’IA conversationnelle à faible latence sur ElevenAgents
La latence de l’IA conversationnelle est un enjeu majeur à prendre en compte lors de la création et du déploiement d’agents. Avec ElevenAgents, l’optimisation de la latence est intégrée au processus. Des techniques de chevauchement pour gagner du temps à la faible latence d’inférence des composants individuels, ElevenAgents conçoit des stacks d’IA conversationnelle à faible latence pour votre entreprise.
En définitive, l’objectif est de créer du réalisme. Un utilisateur doit ressentir la simplicité d’un échange avec un humain tout en bénéficiant des avantages d’un programme informatique. En optimisant les sous-processus, cela est désormais possible.
Découvrez plus d’informations sur ElevenAgents ou Réserver une démo pour démarrer dès aujourd’hui.




