
Modèles d’interaction : Créer un dialogue naturel entre humains et IA
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Quiconque a déjà tenté d'interrompre un agent vocal IA en pleine phrase sait ce que l'on ressent lorsqu'un système n'est pas conçu pour la conversation humaine. Le rythme est mauvais, la voix est dissociée du contenu et, même lorsque les informations sont exactes, l'interaction paraît étrange : ce n'est pas comme parler à une personne compétente, mais comme naviguer dans un logiciel qui utilise des mots par hasard.
L’origine de cette impression artificielle est structurelle. De nombreux systèmes d’IA vocale ont été conçus pour gérer des tours de parole plutôt que le véritable déroulement d’une conversation. Ils écoutent, traitent et répondent à un échange à la fois. Cela fonctionne pour de simples démos, mais montre ses limites lorsque la conversation devient émotionnelle et imprévisible.
Les modèles d'interaction sont des systèmes d'IA conçus pour communiquer en temps réel par audio et par texte. Ils perçoivent non seulement ce qui est dit, mais aussi le moment où cela est dit et le type de réponse émotionnelle que la situation exige. Cet article explique ce qui distingue un modèle d'interaction, son importance pour les entreprises qui déploient l'IA vocale et comment ElevenLabs progresse dans cette direction.
En résumé
- La plupart des systèmes d'IA vocale échouent dans les conversations réelles, car ils ne savent pas gérer les interruptions, les silences ou le contexte qui se prolonge d'un tour de parole à l'autre.
- La stack d'interaction d'ElevenLabs est conçue pour gérer les interruptions, les pauses et les paroles simultanées, sans perdre le contexte ni rompre le fil de la conversation.
- ElevenLabs développe de véritables modèles d'interaction grâce à une architecture en cascade avancée, à des modèles Speech to Text (STT) et Text to Speech (TTS) développés en interne, ainsi qu'à une stack optimisée pour une faible latence et des conversations naturelles et fluides.
Pourquoi la communication vocale entre humains et IA paraît rarement naturelle
La plupart des systèmes d'IA vocale considèrent une conversation comme une série d'entrées et de sorties distinctes : le système attend un segment de parole, le convertit en texte, traite ce texte, puis répond. Cette approche fonctionne pour des interactions de type commande-réponse, mais une conversation réelle n'est pas une simple succession d'échanges textuels. C'est un va-et-vient continu, fait de pauses et d'interjections.
Supprimer le flux entre les tours de parole et le contexte qui les relie entraîne trois défaillances précises :
- Il vous interrompt ou vous fait attendre : le système ne distingue pas une pause de réflexion d'un tour de parole terminé. Il intervient alors que vous parlez encore ou reste silencieux après votre arrêt. Prenez le temps de réfléchir au milieu d'une phrase, et il vous coupe ; terminez votre idée, et vous attendez dans un silence pesant.
- Il ne réagit plus une fois qu'il a commencé à parler : dès que le système commence à répondre, il cesse d'écouter. Si vous l'interrompez pour le rediriger, il continue de répondre à une question qui n'est plus d'actualité, car il ne détecte pas le changement.
- Il oublie au fil de la conversation : chaque tour de parole est traité isolément, de sorte que le contexte d'il y a cinq échanges ne se prolonge pas. Vous finissez par vous répéter, ou le système répond comme si la conversation venait de commencer.
Il en résulte une conversation qui peut être fonctionnellement correcte tout en paraissant inadaptée.
Ce que les modèles d'interaction font, contrairement à l'IA vocale traditionnelle
Alors que l’IA vocale traditionnelle traite un tour de parole à la fois, un modèle d’interaction gère l’ensemble de la conversation, en tenant compte simultanément de ce qui est dit et de ce qui doit se produire ensuite. La différence fonctionnelle est qu’un modèle d’interaction répond à l’état réel de l’échange.
Les modèles d'interaction offrent :
- Une réponse en temps réel : le système est conçu pour répondre à une vitesse conversationnelle, avec un cycle de bout en bout pouvant s'exécuter en moins d'une seconde selon la configuration.
- Une gestion naturelle des interruptions, des silences et des chevauchements : il distingue une pause de réflexion d'un tour de parole terminé, afin de ne pas couper la parole ni laisser de silence. Et lorsqu'un client parle en même temps que lui pour le rediriger, il gère ce chevauchement sans perdre le contexte ni désorganiser la conversation.
- Une continuité sur l'ensemble de l'échange : au lieu de réinitialiser le contexte à chaque tour de parole, le système conserve l'historique de la conversation. Ainsi, ce qu'il dit au dixième tour reflète tout ce qui s'est passé depuis le premier.
- Une expression adaptative : la voix peut être programmée pour s'adapter, plus calme, plus directe ou plus rassurante, selon la tâche qu'elle exécute.
- L'exécution parallèle des tâches : le système récupère des informations, exécute des appels d'outils et continue de parler simultanément, plutôt que de se taire pendant qu'il recherche une information.
Le véritable test d'un modèle d'interaction est un appel qui se passe mal. Dans l'enregistrement ci-dessous, un client appelle au sujet de l'annulation d'un vol. Il est tendu et a besoin d'une solution rapide.
L'agent détecte immédiatement l'urgence et la frustration du client à partir des mots qu'il emploie. Il adapte son ton, gère l'interruption sans perdre le fil et utilise ses outils connectés pour proposer de vraies solutions concernant le vol annulé. Au final, le client obtient une solution sans avoir besoin d'un intervenant humain.
Comparez cela aux agents classiques fondés sur les tours de parole, utilisés aujourd'hui. Ces systèmes attendraient chaque pause, répondraient sur un ton neutre et passeraient entièrement à côté de la frustration du client. Après quelques échanges qui ne répondent pas à ce que ressent réellement l'appelant, l'appel devrait probablement être transféré à un intervenant humain, laissant le client encore plus frustré qu'au départ.
Comment ElevenLabs développe des modèles d'interaction
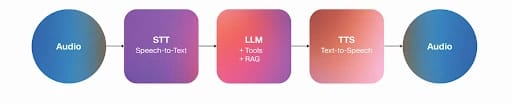
Notre pipeline conversationnel repose sur une architecture en cascade avancée plutôt que sur une architecture fusionnée. Au lieu qu'un seul modèle gère l'ensemble, chaque étape repose sur son propre composant spécialisé.
L’avantage de cette approche est que nous pouvons optimiser chaque étape du pipeline indépendamment et intégrer un meilleur modèle pour n’importe quel composant, sans reconstruire l’ensemble du système. Et comme nous développons ces composants en interne, ils sont co-optimisés pour se transmettre un contexte riche. Le pipeline se comporte ainsi comme une conversation cohérente, plutôt que comme une chaîne d’outils distincts.
Structure d'un modèle en cascade
Structure d'un modèle fusionné
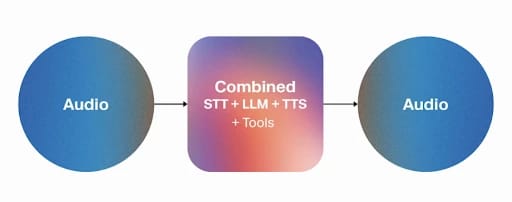
Images : modèles en cascade et fusionnés
Voici les technologies qui composent actuellement le pipeline :
- Scribe v2 Realtime : notre modèle STT développé en interne transcrit la parole en environ 150 ms dans plus de 90 langues, même en présence de bruit de fond, d'accents, d'interruptions et d'événements non verbaux comme les rires et les pauses. Il est également conçu pour traiter le vocabulaire propre à chaque domaine, des termes médicaux au jargon financier.
- Gestion spéculative des tours de parole : ce système décide quand parler, faire une pause ou attendre, en interprétant le flux de la conversation plutôt qu'en s'appuyant sur un seuil de silence strict. Les améliorations apportées à notre modèle de détection d'activité vocale l'aident à mieux filtrer les paroles en arrière-plan et les réponses courtes, pour des tours de parole plus naturels.
- Eleven v3 Conversational : l'un de nos modèles TTS les plus expressifs, conçu pour les dialogues en direct et fluides. Il conserve la tonalité émotionnelle de la conversation d’un tour à l’autre, afin que la manière dont l’agent s’exprime au dixième tour reflète tout ce qui l’a précédé.
- Expressive Mode : conçu à partir d'Eleven v3 Conversational et du système de gestion des tours de parole, Mode expressif contrôle la manière dont l'agent s'exprime selon la situation. Il désamorce les tensions lorsque les clients sont frustrés, les rassure lorsqu'ils sont désorientés et adopte un ton direct lorsque la clarté est nécessaire. Il interprète également les balises expressives, afin que le modèle puisse agir à partir d'indications comme [laughs], [whispers] ou [sighs] et façonner des moments précis de l'expression.
- Flash v2.5 : Notre modèle TTS à faible latence prend en charge 32 langues et génère la parole en moins de 75 ms. Lorsque la latence est prioritaire, il maintient le temps de réponse dans le rythme naturel d'une conversation humaine.
- Speech Engine : la couche de liaison qui unifie la stack et connecte votre serveur à notre ElevenAPI via WebSocket, avec une connexion par conversation. Nous gérons le STT et le TTS, tandis que votre serveur exécute le LLM. Les équipes techniques peuvent ainsi apporter leur propre modèle et conserver la logique conversationnelle sur leur propre infrastructure.
Ces modèles sont continuellement améliorés, et de nouvelles versions sont publiées régulièrement. Chaque nouvelle version réduit l'écart entre parler à un logiciel et parler à une personne, avec des réponses plus rapides, une reconnaissance émotionnelle plus fine, davantage de langues et une expression plus fluide.
Parler tout en réfléchissant
Toutes les composantes d'un modèle d'interaction ne doivent pas nécessairement s'exécuter dans un ordre strict. ElevenAgents peut continuer de travailler en arrière-plan pendant que la conversation se poursuit, au lieu de laisser un silence entre une question et une réponse.
Plusieurs systèmes essentiels travaillent de concert pour permettre de parler et de réfléchir simultanément :
- Appels d'outils parallèles : l'agent peut interroger une base de données, exécuter un outil ou vérifier le statut d'une commande tout en parlant, pour que la récupération d'informations ne ressemble jamais à une pause dans la conversation.
- Délai d'attente souple : si un LLM met plus de temps que prévu à générer une réponse, l'agent prononce une brève formule de remplissage, comme « Laissez-moi réfléchir » ou « hmmm », plutôt que de laisser un silence gênant. Délai d'attente souple aide à préserver un flux conversationnel naturel et réduit le risque d'interruptions.
- Termes à ignorer lors des interruptions : plutôt que d'utiliser un seuil de silence fixe, le système cherche à interpréter le sens de ce qui est dit pour déterminer intuitivement si un tour de parole est réellement terminé. De même, de brèves confirmations comme « d'accord » ou « hum-hum » peuvent être configurées pour passer sans déclencher une interruption complète, ce qui permet à l'agent de ne pas perdre le fil à chaque interjection de l'appelant.
Ensemble, ces systèmes évitent que l'agent donne l'impression de mettre une réponse en mémoire tampon ou de la charger. Ils forment un moteur conversationnel rationalisé qui comble naturellement les silences comme le ferait une personne, tout en traitant les informations et en réfléchissant en arrière-plan.
Comment fonctionne réellement une conversation avec ElevenLabs
Les composants ci-dessus ne s'exécutent pas les uns après les autres dans une séquence ordonnée. Ils se chevauchent. Voici comment un agent ElevenLabs traiterait la demande d'un appelant qui demande : « Ma commande a-t-elle déjà été expédiée ou est-elle encore en cours de traitement ? », au milieu d'un appel au support.
- L'appelant parle : l'audio est transmis à ElevenLabs via la connexion WebSocket, et Scribe commence la transcription en temps réel, avec environ 150 ms de décalage sur la voix.
- Le système interprète le flux : tandis que Scribe transcrit encore, le système spéculatif de gestion des tours de parole détermine déjà si l'appelant a terminé ou s'il est en pleine réflexion. La fin « ou est-elle encore en cours de traitement ? » est interprétée comme un passage de relais plutôt que comme une pause. Elle déclenche donc l'étape suivante au lieu de laisser un silence.
- Le LLM rassemble le contexte et répond : la question transcrite est envoyée au LLM avec l'historique de la conversation, le dossier de commande récupéré depuis les propres systèmes de l'entreprise grâce au RAG, les résultats des outils utilisés plus tôt dans l’appel et le prompt système. Il s’appuie sur l’ensemble de ces éléments pour générer une réponse fondée sur la commande de l’appelant.
- Le modèle TTS synthétise la réponse : le texte devient un audio à la sonorité naturelle. Si Expressive Mode est actif, la réponse intègre des indications d'expression adaptées au moment, afin qu'une mise à jour de routine paraisse simple et posée plutôt que plate. Lorsque la latence est prioritaire, Flash assure la synthèse en moins de 75 ms.
- La réponse est diffusée : l'audio commence à être lu avant la fin de la synthèse, de sorte que l'appelant entend le début de la réponse pendant que le reste est encore généré.
- Le cycle se répète : chaque nouveau tour de parole prolonge le ton, le contexte et l'historique de la conversation.
Tout au long de ce processus rapide, la conversation paraît naturelle. L'appelant cesse de s'adapter à la machine : il ne ralentit pas, n'articule pas excessivement et n'attend pas de signal sonore. Il parle simplement, comme il le ferait avec une personne.
Déployez des agents vocaux naturels dans toute votre entreprise
Tout ce qui est décrit ici est déjà en production. De l’architecture en cascade au pipeline inférieur à la seconde, entreprises du monde entier utilisent déjà ElevenAgents pour gérer à grande échelle de véritables conversations clients.
Cela inclut les environnements réglementés et à forts enjeux, car notre architecture d'agents prend en charge les garde-fous, les journaux d'audit et les contrôles de conformité. ElevenLabs est certifié SOC 2 Type II, ISO 27001, HIPAA et PCI DSS niveau 1, et propose le mode zéro rétention ainsi que des options de résidence des données pour les équipes qui doivent conserver leurs données dans un périmètre précis.
Prêt à mettre un agent au travail ? Vous pouvez concevoir un agent et commencer à le développer dans la console, ou nous contacter pour un déploiement adapté à votre environnement.
FAQ sur les modèles d'interaction

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


