Modèles en cascade vs fusionnés : Comment l’architecture détermine si votre agent vocal est prêt pour l’entreprise
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
La plupart des gens pensent que les agents vocaux reposent sur une architecture en cascade ou fusionnée. En pratique, les agents se situent sur un continuum entre les deux, cinq architectures étant généralement utilisées selon l’application.
L’architecture de l’agent détermine sa capacité à fonctionner de manière fiable en production, à s’adapter aux exigences métier spécifiques et à paraître naturelle en conversation. Une architecture fondée sur la fusion, telle que le modèle Realtime d’OpenAI, peut sembler remarquablement réaliste lors de brefs échanges. Mais lorsque les équipes doivent appliquer des garde-fous de conformité, diagnostiquer une réponse défaillante ou intégrer un LLM plus performant dès sa sortie le mois prochain, un réseau fusionné unique offre peu de possibilités.
Chez ElevenLabs, nous utilisons une architecture avancée fondée sur une cascade. Nous exploitons des composants spécialisés pour la reconnaissance vocale, le raisonnement et la génération de parole afin d’atteindre un haut niveau d’intelligence et de fiabilité. Nous y ajoutons une prosodie contextuelle, une optimisation de la faible latence et une gestion intelligente des tours de parole pour des conversations naturelles. Nous avons fait ce choix car les entreprises et les administrations avec lesquelles nous travaillons exigent des agents à la fois réalistes et fiables en production, y compris pour des tâches complexes.
Cet article présente les cinq principales architectures, leurs points forts, leurs limites et notre vision des fondations nécessaires aux agents déployés dans des workflows critiques.
Ce que les équipes évaluent lors du choix d’une architecture
Les questions que se posent les équipes se répartissent généralement en trois catégories.
Peut-elle gérer des tâches complexes ?
- Raisonnement et flexibilité des modèles : Pouvez-vous choisir les meilleurs modèles pour votre cas d’usage, y compris les LLM les plus performants disponibles, et les remplacer à mesure que de meilleures options apparaissent ?
- Logique de l’agent : Pouvez-vous définir et contrôler les flux de conversation, les règles de décision et les parcours d’escalade suivis par votre agent ?
- Utilisation d’outils : L’architecture peut-elle prendre en charge les appels d’outils en plusieurs étapes et les intégrations avec des systèmes externes ?
Sera-t-elle naturelle, à l’écoute comme à l’usage ?
- Prosodie : L’agent restitue-t-il un rythme, une intonation et une tonalité émotionnelle naturels ?
- Latence : Les réponses sont-elles suffisamment rapides pour donner l’impression d’une conversation ?
- Gestion des tours de parole : L’agent sait-il quand parler, marquer une pause ou laisser la parole ?
Puis-je lui faire confiance en production ?
- Fiabilité : L’agent se comporte-t-il de manière prévisible et cohérente, ou dérive-t-il avec le temps ?
- Garde-fous : L’architecture peut-elle appliquer des protections contre les réponses involontaires ou les utilisateurs malveillants ?
- Transparence : L’architecture produit-elle des résultats intermédiaires ou constitue-t-elle une boîte noire ?
Les compromis entre architectures en cascade et fusionnées
Les architectures fondées sur une cascade enchaînent des composants spécialisés : Speech to Text (STT), un grand modèle de langage et Text to Speech (TTS). Chaque étape peut être optimisée, testée et mise à niveau indépendamment.
Architecture en cascade
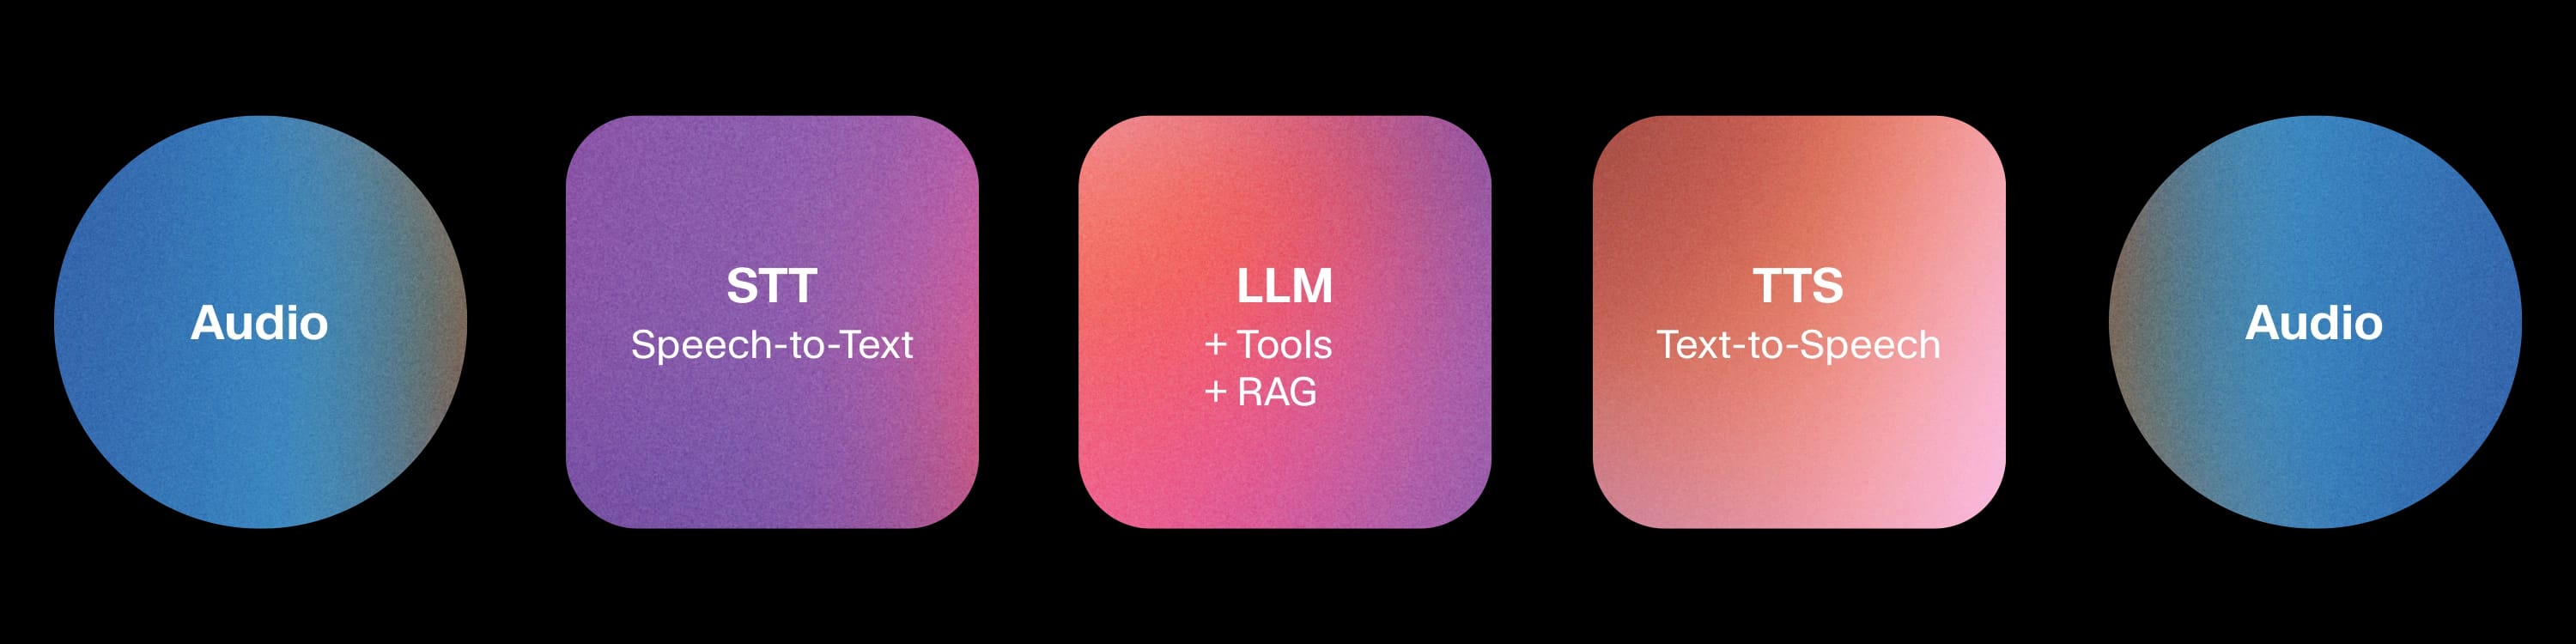
Cette modularité fait des architectures en cascade la base de la plupart des agents conçus pour les entreprises. Chaque étape produit des résultats inspectables : du texte lisible entre le STT et le LLM, puis entre le LLM et le TTS. Les garde-fous peuvent être appliqués au niveau du texte, les LLM de pointe les plus récents peuvent être intégrés sans modifier les modèles vocaux et, en cas d’échec, la source du problème est généralement identifiable.
La critique historique des architectures en cascade est qu’elles perdent les signaux prosodiques. La parole est réduite à du texte, puis l’intonation, le rythme et l’émotion doivent être reconstruits en sortie. Ces signaux peuvent être partiellement récupérés par une modélisation explicite, mais ils ne sont pas capturés aussi naturellement que dans les approches fusionnées. D’autres dimensions, comme la latence et la gestion des tours de parole, peuvent généralement être optimisées à des niveaux de performance comparables dans les deux approches.
Modèle fusionné
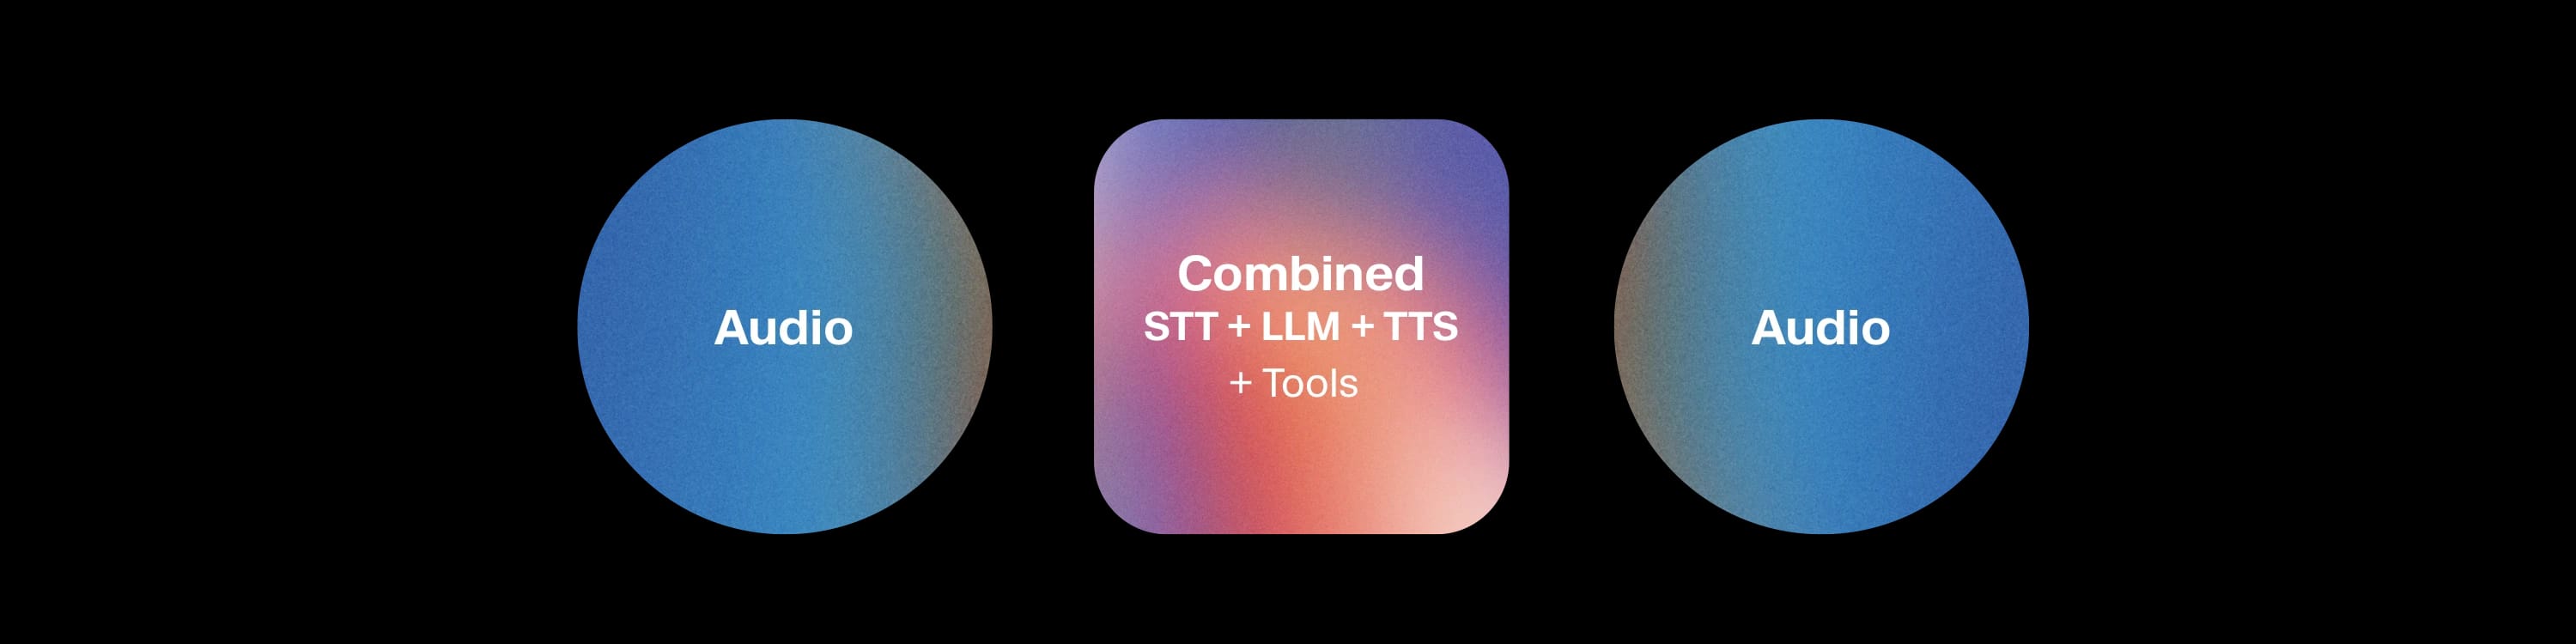
Les architectures fusionnées adoptent une approche fondamentalement différente. La reconnaissance, le raisonnement et la génération s’opèrent tous au sein d’un même réseau multimodal. L’audio entre, l’audio sort, sans couche intermédiaire inspectable.
Cette absence d’étapes intermédiaires est à la fois leur attrait et leur limite. L’architecture fusionnée peut préserver naturellement les signaux prosodiques, car la parole n’est jamais décomposée en texte. En revanche, les possibilités d’appliquer des garde-fous, de remplacer des composants individuels ou d’inspecter les résultats intermédiaires pour diagnostiquer les problèmes sont limitées. Des contraintes existent également pour l’ajustement du STT à une terminologie propre à un secteur ou l’intégration d’un LLM différent afin d’améliorer le raisonnement et les appels d’outils. Le système forme un seul réseau et les équipes dépendent des capacités de raisonnement avec lesquelles il est livré, c’est-à-dire aujourd’hui de noyaux plus légers qui ne peuvent rivaliser avec les LLM de pointe sur les tâches complexes.
Les cinq architectures
1. Cascade basique
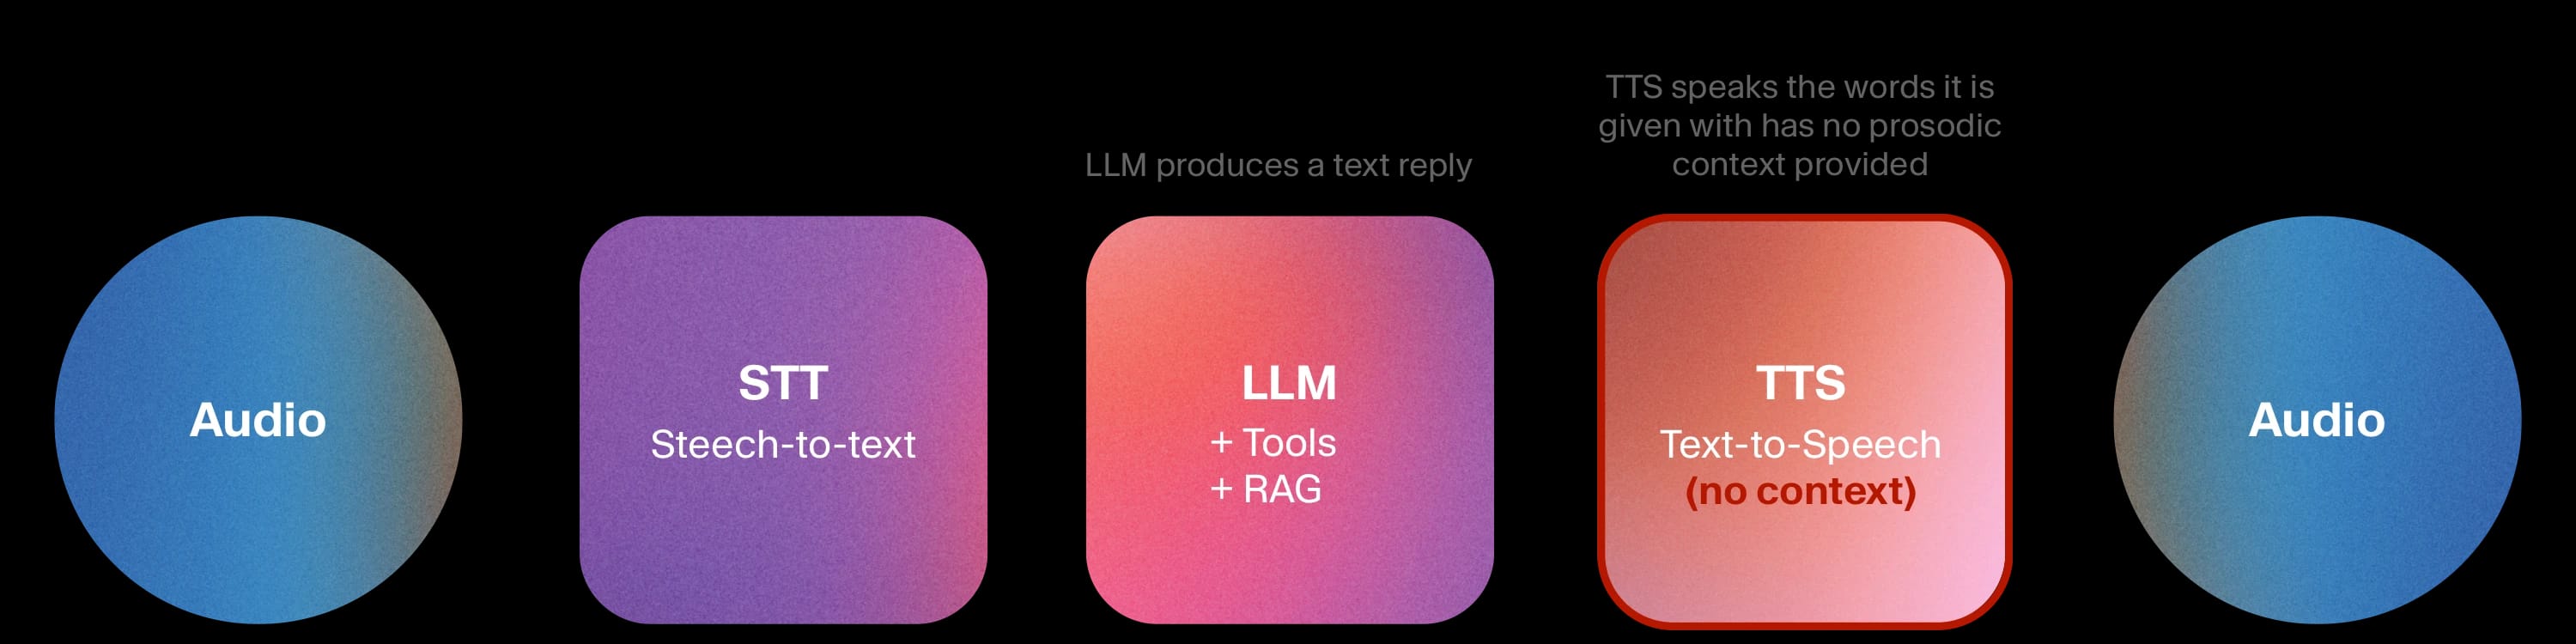
L’audio est transcrit, le LLM génère une réponse textuelle, puis le TTS la prononce. Chaque étape fonctionne en texte brut, ce qui vous permet de tout voir, tester et contrôler.
Les avantages en matière de confiance sont clairs : des garde-fous au niveau du texte, des flux de conversation déterministes et des pistes d’audit complètes. Le LLM étant un composant autonome, vous pouvez associer l’agent au modèle de pointe offrant les meilleures capacités de raisonnement ou d’appel d’outils, puis le mettre à niveau dès qu’un meilleur modèle est disponible. La faiblesse concerne la qualité conversationnelle : sans TTS contextuel, l’agent est fonctionnel, mais manque de relief. Il n’y a ni adaptation émotionnelle ni variation prosodique, ce qui convient pour restituer un solde de compte, mais pas pour gérer un client frustré.
Exemples de cas d’usage :
- Remplacement des SVI dans les télécommunications et les services publics
- Gestion des FAQ lors de l’onboarding SaaS
- Notifications sortantes, comme les confirmations de rendez-vous, les rappels de prescription et les alertes de livraison, lorsque la cohérence compte davantage que la chaleur humaine
2. Cascade avancée
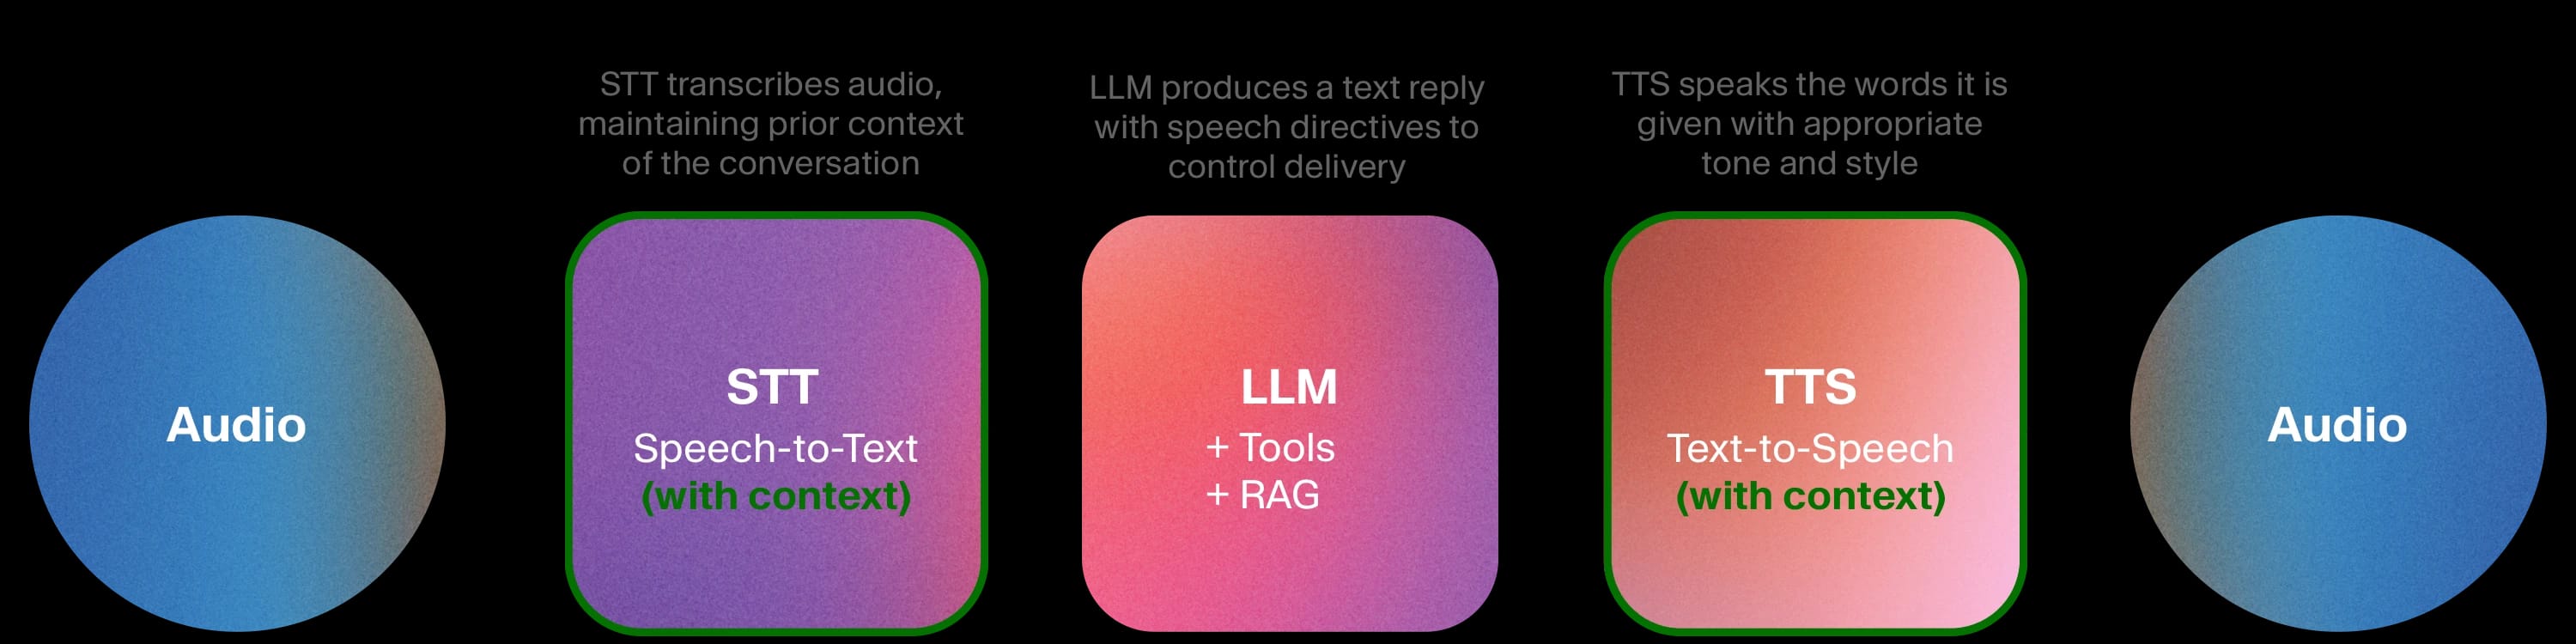
La même architecture modulaire, mais où plusieurs composants opèrent désormais avec un contexte plus riche. C’est ce que nous avons conçu avec Expressive Mode dans ElevenAgents.
Le modèle STT Scribe v2 Realtime produit une transcription rapide et précise en s’appuyant sur le contexte antérieur de la conversation. À partir du texte, le LLM indique au TTS comment restituer la parole, et pas seulement quoi dire, par exemple « de manière rassurante », « avec insistance », « avec urgence », en adaptant dynamiquement son ton tout au long de la conversation. Le système de gestion des tours de parole s’appuie sur les mêmes signaux, ce qui permet à l’agent de déterminer quand répondre et quand laisser la parole. Les modèles vocaux sont colocalisés dans une même pile, sans sauts réseau entre les composants, ce qui maintient une faible latence.
L’architecture conserve tous les atouts de la cascade basique : transparence totale, garde-fous au niveau du texte, composants interchangeables, ajustement au domaine et accès aux modèles de raisonnement et d’appel d’outils les plus performants disponibles. Elle améliore sensiblement la prosodie, la latence et la gestion des tours de parole. Les équipes peuvent intégrer un nouveau LLM de pointe dès sa sortie ou ajuster le STT pour le secteur de la santé à son vocabulaire, sans reconstruire aucun autre composant.
Exemples de cas d’usage :
- Support client dans les services financiers, où une réponse empathique lors d’un appel concernant un prélèvement contesté s’accompagne de garde-fous de conformité stricts et d’une journalisation complète des interactions
- Réceptionnistes dans le secteur de la santé, qui trient les appels de patients avec le degré d’urgence approprié, des flux conformes à HIPAA et une reconnaissance vocale adaptée à la terminologie médicale
- Assistants commerciaux qui conservent un ton chaleureux et convaincant tout en suivant un guide structuré et en transmettant les mises à jour au CRM
3. Cascade hybride et fusionnée
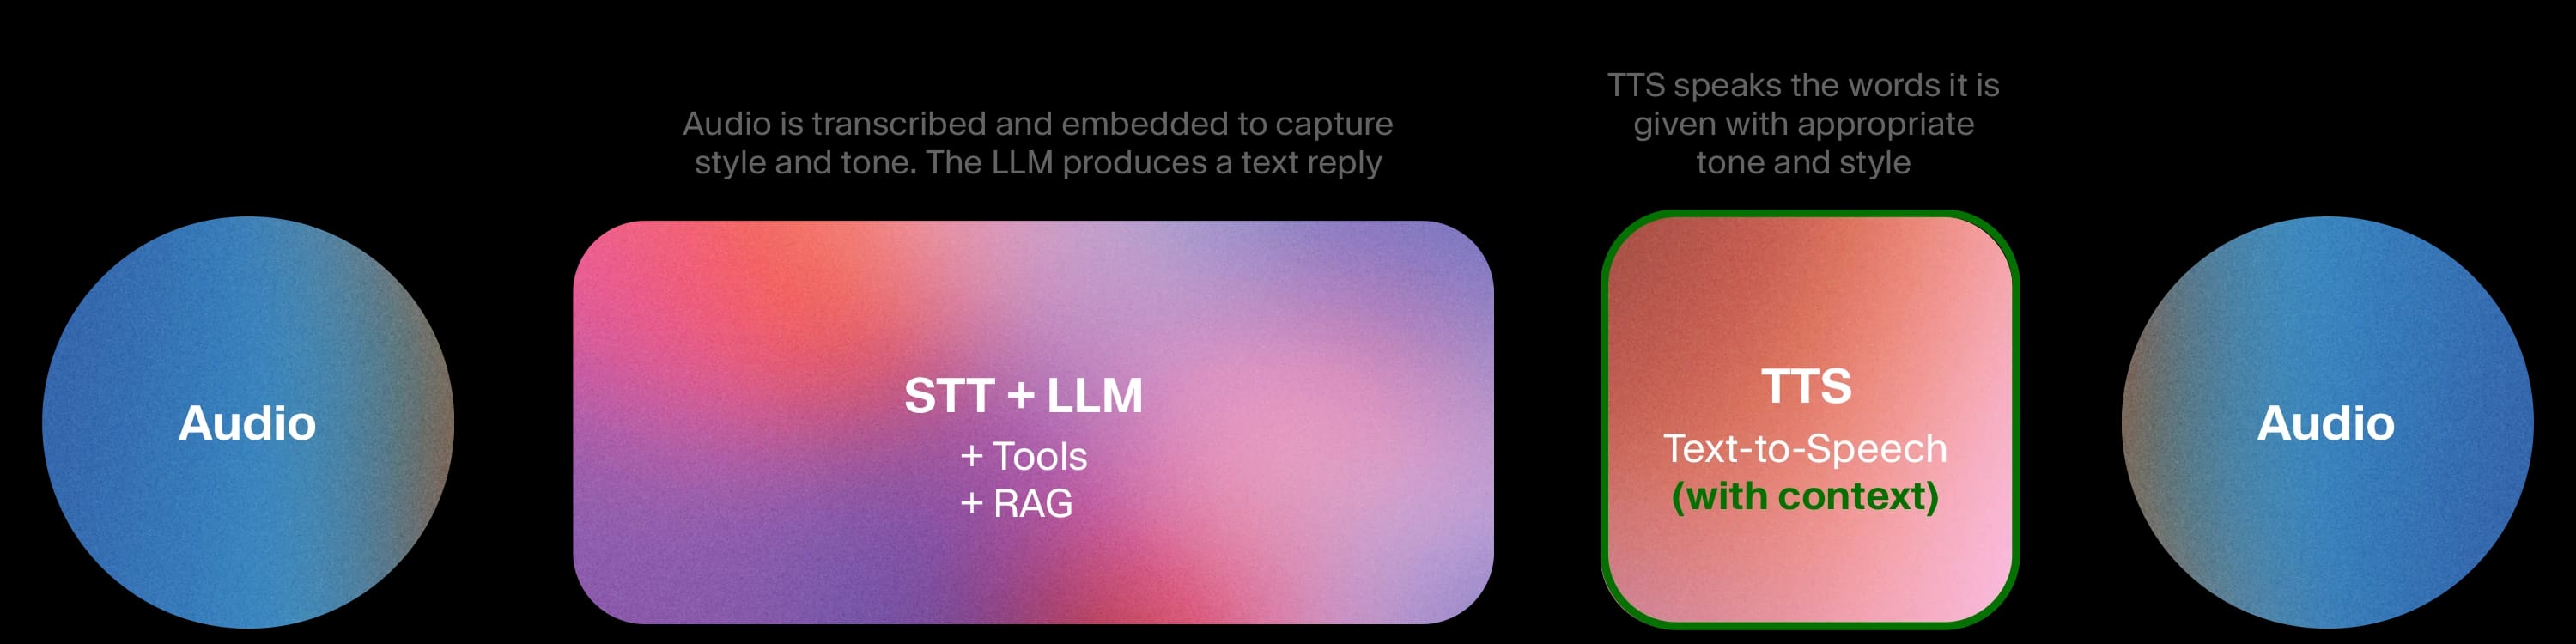
Certaines architectures transmettent directement au LLM, sous forme d’embeddings, les caractéristiques acoustiques de la parole d’entrée, comme la prononciation, l’émotion et le ton, plutôt que de les convertir d’abord en texte. Le TTS reste modulaire.
Cela fournit au LLM des informations plus riches sur la manière dont quelque chose a été dit, et pas seulement sur ce qui a été dit, ce qui est utile pour certaines applications. Le bloc ASR+LLM fusionné est plus difficile à auditer qu’un transfert de texte clair, car la représentation intermédiaire est un embedding, et non un élément lisible par un humain. Le LLM n’est plus non plus facilement interchangeable, ce qui limite vos capacités de raisonnement et d’appel d’outils au modèle sur lequel le bloc fusionné a été construit.
Exemples de cas d’usage :
- Apprentissage des langues et accompagnement de la prononciation, où entendre comment un élève s’exprime compte autant que ce qu’il dit
- Support sensible au ton et peu complexe, où détecter la frustration est important, mais où la tâche elle-même reste simple.
4. Fusionnée séquentielle
Un seul modèle multimodal gère la reconnaissance, le raisonnement et la génération en un seul passage, un tour de parole à la fois.
La prosodie peut être de grande qualité. Comme la parole n’est jamais décomposée en texte, le modèle préserve naturellement le rythme, l’intonation et les signaux émotionnels. Les conversations brèves peuvent sembler remarquablement fluides.
Mais sans couche de texte, les possibilités d’appliquer des garde-fous sont limitées, tout comme les résultats intermédiaires disponibles pour le débogage et la flexibilité nécessaire pour intégrer un meilleur LLM ou ajuster le STT à votre domaine. Les noyaux de raisonnement tendent à être plus légers que les LLM de pointe, ce qui pénalise les appels d’outils complexes et les tâches en plusieurs étapes. Lorsqu’une tâche exige de résoudre un problème complexe, la prosodie seule ne suffit pas.
Exemples de cas d’usage :
- Compagnons personnels, chatbots de divertissement et applications où l’expressivité stimule l’engagement et où les exigences de conformité sont limitées.
5. Fusionnée duplex
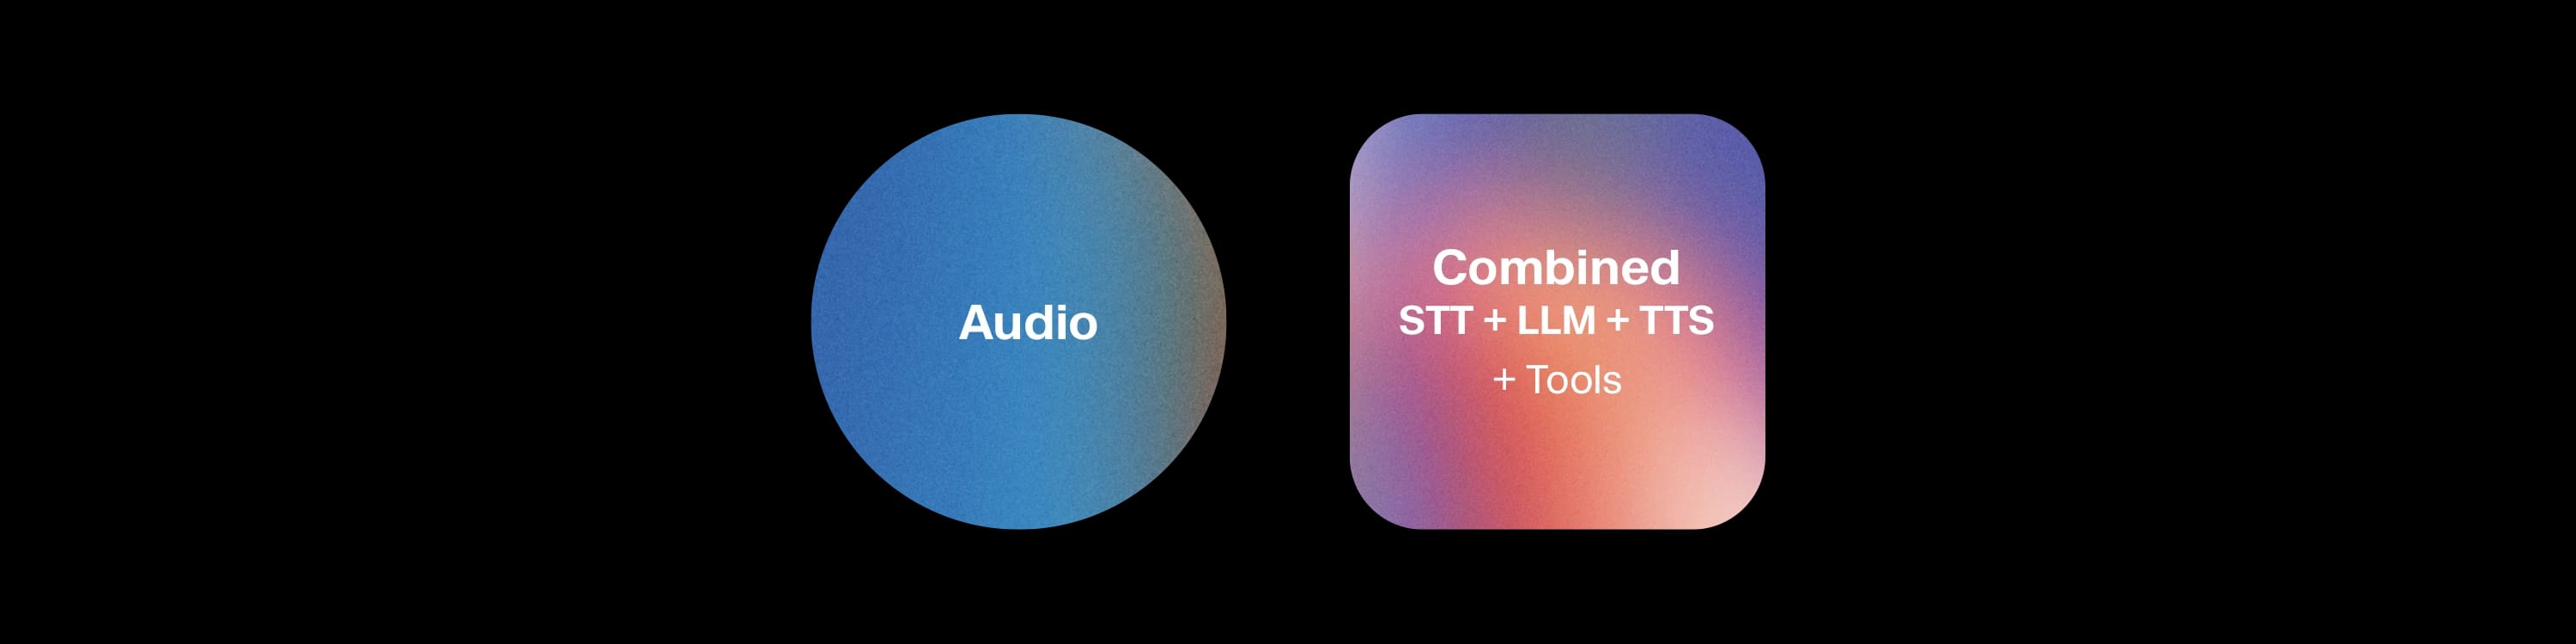
L’entrée et la sortie sont traitées simultanément : le modèle écoute et parle en même temps. Cela peut donner aux brefs échanges une impression de naturel saisissante, avec de véritables chevauchements de parole et des transitions fluides entre les tours de parole.
C’est aussi l’architecture la plus difficile à contrôler : les garde-fous sont très difficiles à appliquer et les interférences introduisent des erreurs imprévisibles. L’inspection, la journalisation et le débogage sont extrêmement difficiles, et le système est largement fermé, avec peu d’options pour remplacer des composants, l’ajuster à un domaine ou le personnaliser. Le raisonnement et l’utilisation d’outils sont encore plus limités que dans les modèles fusionnés séquentiels, car le traitement simultané laisse moins de capacité pour une logique complexe. Et le même traitement simultané qui rend les échanges courts naturels rend les conversations plus longues instables.
Exemples de cas d’usage :
- Applications expérimentales de compagnons, plateformes vocales sociales et démonstrations de recherche où un comportement imprévisible est acceptable.
Choisir l’architecture adaptée à votre cas d’usage
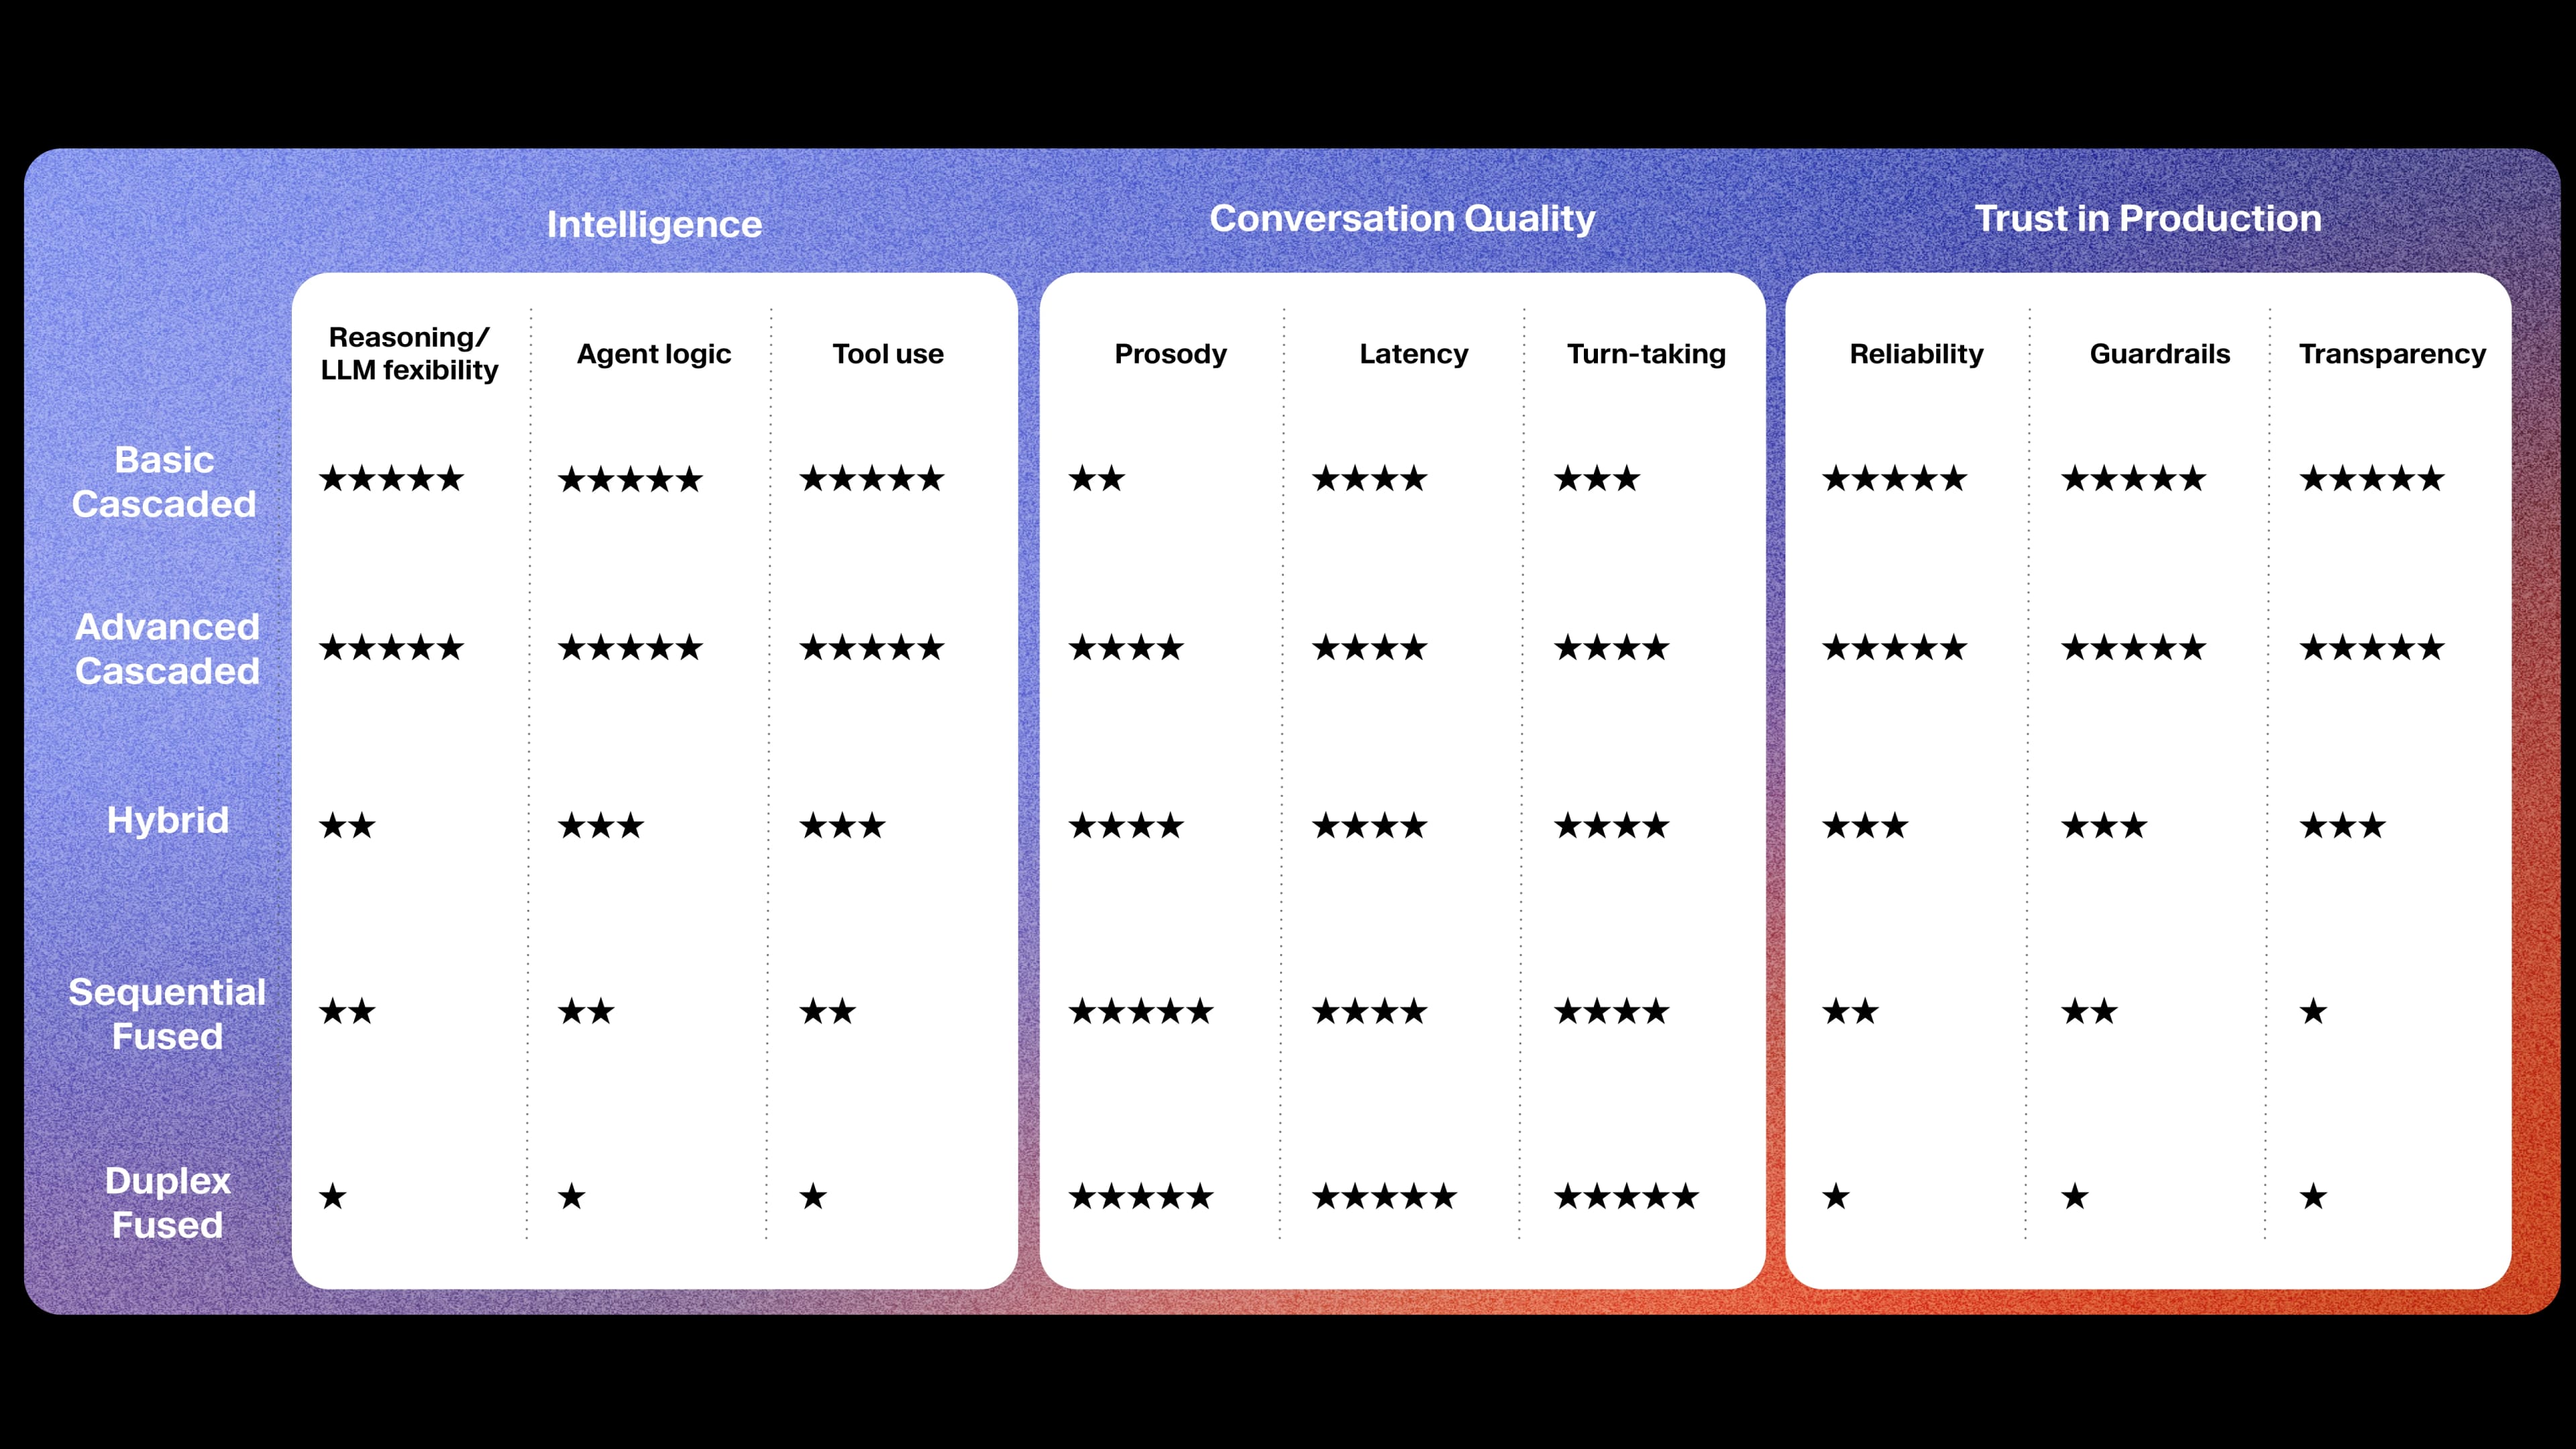
L’architecture adaptée dépend des besoins de chaque application. Si vous créez une expérience dont la parole naturelle est la principale fonctionnalité, les architectures fusionnées offrent de réels atouts, à condition d’accepter des compromis sur le raisonnement de pointe, les garde-fous et la transparence. Si les modèles fusionnés dominent en matière de prosodie, les systèmes avancés en cascade s’en rapprochent à chaque trimestre, tandis que les modèles fusionnés n’ont pas réalisé de progrès significatifs en raisonnement complexe ou en fiabilité, en raison de limites architecturales.
Pour la plupart des entreprises et des administrations, la meilleure architecture doit à la fois offrir une excellente qualité vocale et être performante, personnalisable, fiable et prête à être déployée à grande échelle. C’est pourquoi nous avons choisi de développer ElevenAgents avec une architecture avancée en cascade, en investissant dans Expressive Mode et dans des modèles co-optimisés de référence pour Speech to Text et Text to Speech. Les équipes peuvent ainsi créer des agents associant un haut niveau d’intelligence, de fiabilité et de contrôle à une parole naturelle, proche de l’humain.
À mesure que les agents IA se développent dans le support client, l’éducation, les assistants personnels et bien d’autres domaines, ceux qui réussiront reposeront sur des architectures adaptées à leurs applications spécifiques.