Comment nous avons rendu RAG 50% plus rapide
- Rédigé par
- Michal Korbela
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
RAG améliore la précision des agents IA en ancrant les réponses des LLM dans de vastes bases de connaissances. Au lieu d’envoyer l’intégralité de la base de connaissances au LLM, RAG vectorise la requête, récupère les informations les plus pertinentes et les transmet au modèle comme contexte. Dans notre système, nous ajoutons d’abord une étape de réécriture de la requête, qui condense l’historique du dialogue en une requête précise et autonome avant la récupération.
Pour les très petites bases de connaissances, il peut être plus simple de tout transmettre directement dans le prompt. Mais lorsque la base de connaissances s’agrandit, RAG devient essentiel pour préserver la précision des réponses sans surcharger le modèle.
De nombreux systèmes considèrent RAG comme un outil externe. Nous l’avons toutefois intégré directement au pipeline de traitement des requêtes afin qu’il s’exécute pour chacune d’elles. Cela garantit une précision constante, mais crée aussi un risque de latence.
Pourquoi la réécriture des requêtes nous ralentissait
La plupart des requêtes utilisateur font référence à des échanges précédents. Le système doit donc condenser l’historique du dialogue en une requête précise et autonome.
Par exemple :
- Si l’utilisateur demande : « Pouvons-nous personnaliser ces limites en fonction de nos pics de trafic ? »
- Le système la reformule ainsi : « Les limites de débit de l’API du forfait Enterprise peuvent-elles être personnalisées pour des modèles de trafic spécifiques ? »
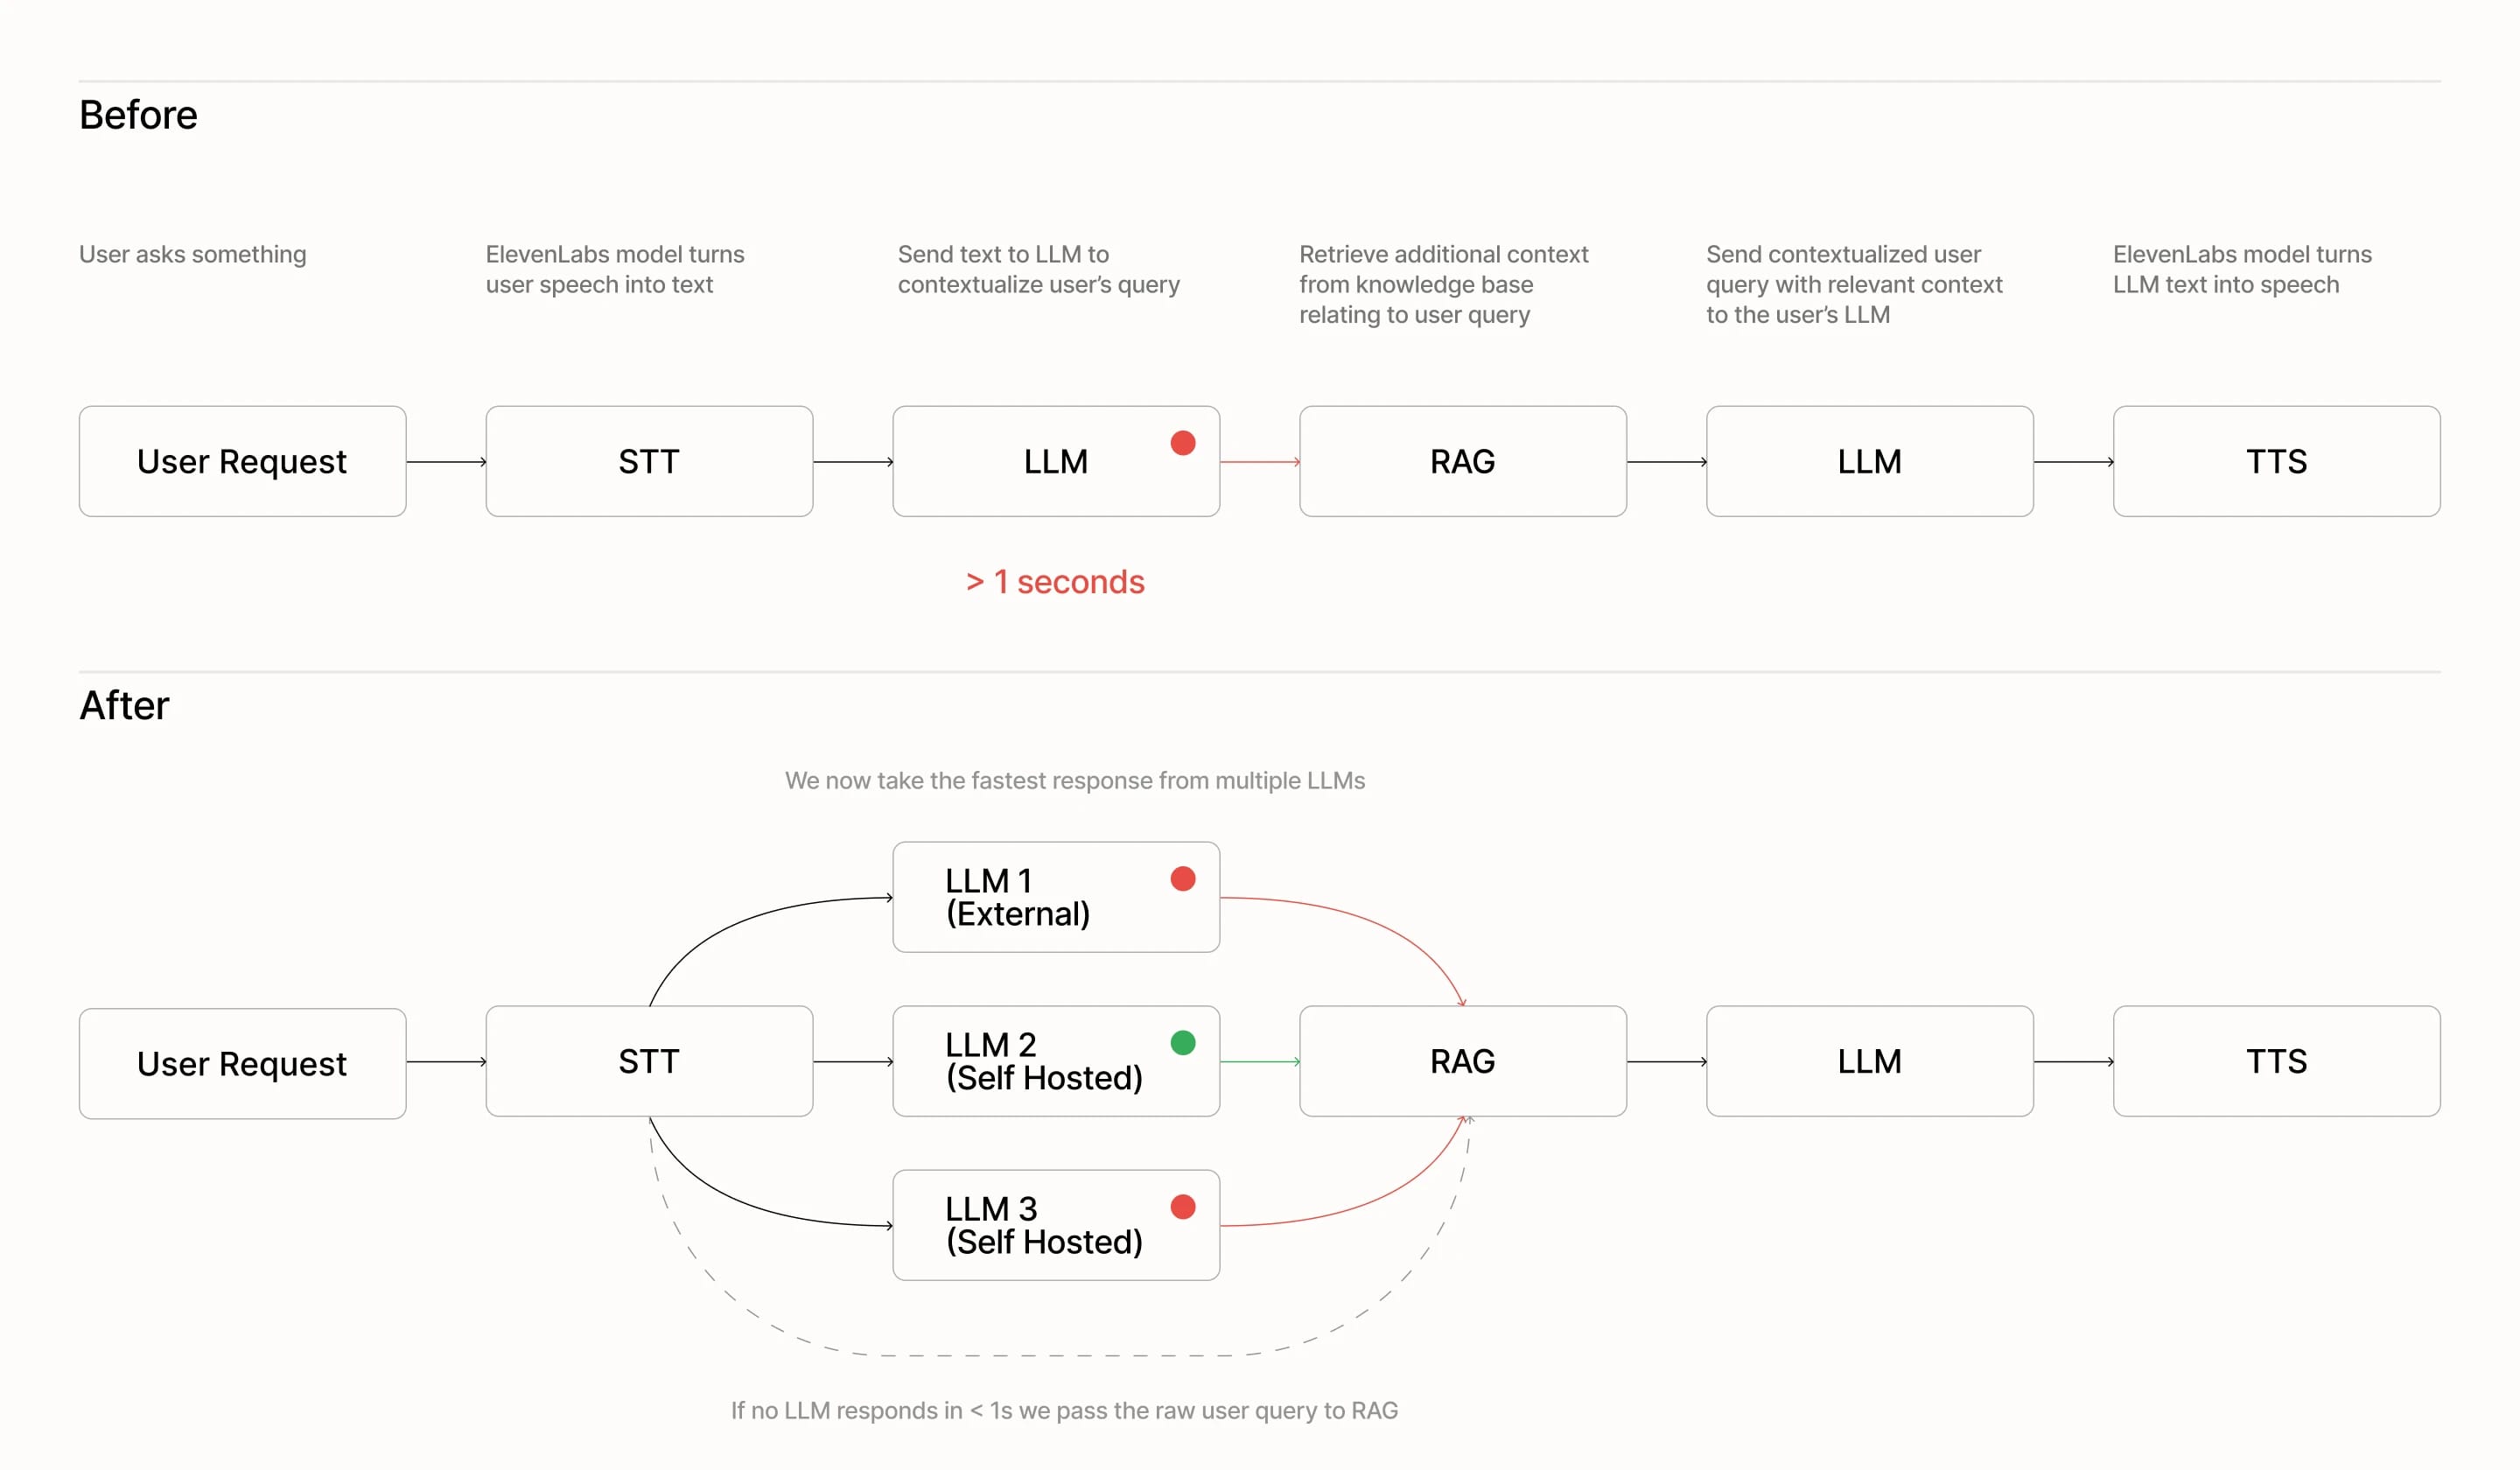
La réécriture transforme des références vagues comme « ces limites » en requêtes autonomes exploitables par les systèmes de récupération, ce qui améliore le contexte et la précision de la réponse finale. Mais dépendre d’un seul LLM hébergé en externe créait une forte dépendance à sa vitesse et à sa disponibilité. Cette seule étape représentait plus de 80 % de la latence de RAG.
Comment nous avons résolu ce problème grâce à la course entre modèles
Nous avons repensé la réécriture des requêtes comme une course :
- Plusieurs modèles en parallèle. Chaque requête est envoyée simultanément à plusieurs modèles, dont nos modèles Qwen 3-4B et 3-30B-A3B auto-hébergés. La première réponse valide l’emporte.
- Des solutions de secours qui assurent la continuité des conversations. Si aucun modèle ne répond dans la seconde, nous utilisons le message brut de l’utilisateur. Il peut être moins précis, mais évite les blocages et garantit la continuité.
L’impact sur les performances
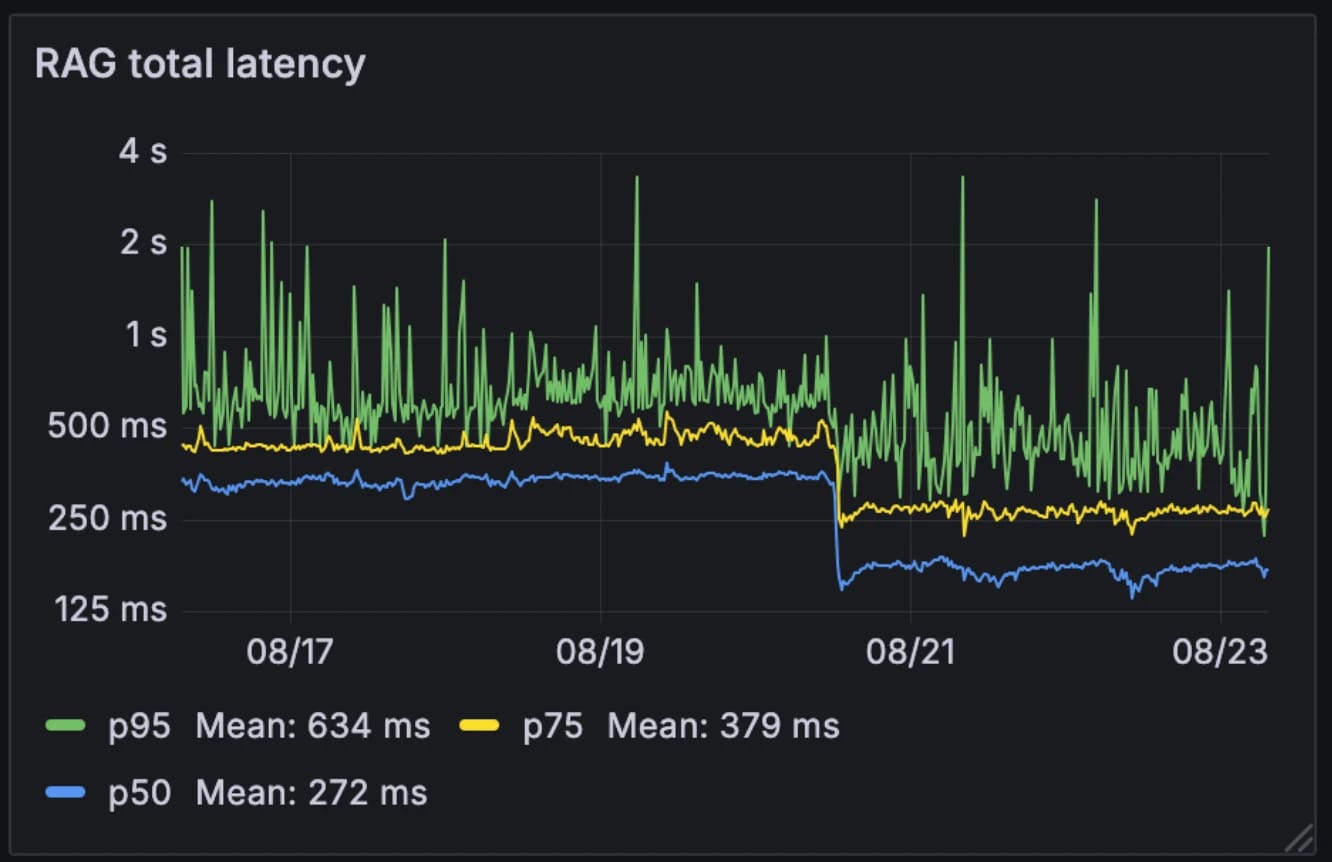
Cette nouvelle architecture a réduit de moitié la latence médiane de RAG, de 326 ms à 155 ms. Contrairement à de nombreux systèmes qui déclenchent RAG de manière sélective comme un outil externe, nous l’exécutons pour chaque requête. Avec une latence médiane ramenée à 155 ms, le surcoût est négligeable.
Latence avant et après :
- Médiane : 326 ms → 155 ms
- p75 : 436 ms → 250 ms
- p95 : 629 ms → 426 ms
L’architecture a également rendu le système plus résilient face à la variabilité des modèles. Si les modèles hébergés en externe peuvent ralentir durant les pics de demande, nos modèles internes restent relativement constants. La course entre modèles atténue cette variabilité et transforme les performances imprévisibles de chaque modèle en un comportement système plus stable.
Par exemple, lorsqu’un de nos fournisseurs de LLM a connu une interruption de service le mois dernier, les conversations se sont poursuivies sans interruption sur nos modèles auto-hébergés. Nous exploitons déjà cette infrastructure pour d’autres services ; le coût de calcul supplémentaire est donc négligeable.
Pourquoi c’est important
La réécriture de requêtes RAG en moins de 200 ms élimine un obstacle majeur pour les agents conversationnels. Le résultat : un système qui reste à la fois conscient du contexte et en temps réel, même avec de vastes bases de connaissances d’entreprise. Avec un surcoût de récupération devenu quasi négligeable, les agents conversationnels peuvent passer à l’échelle sans compromettre les performances.