Décryptage du moteur d’orchestration d’ElevenAgent
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
ElevenAgents repose sur un moteur d’orchestration à faible latence, conçu pour les conversations en temps réel, avec moins de 100 ms de surcharge. Cette architecture associe le meilleur de la recherche d’ElevenLabs à des LLM de pointe de fournisseurs majeurs tels qu’OpenAI, Google et Anthropic, ainsi qu’à une sélection de modèles open source hébergés par ElevenLabs. En utilisant plusieurs modèles à différentes étapes du pipeline de réponse, l’agent garantit des conversations à la fois très réactives et attentives au contexte. En exploitant dynamiquement et conjointement les atouts de chaque modèle, nous obtenons des performances fiables et évolutives pour diverses tâches d’entreprise et situations conversationnelles, tout en optimisant l’équilibre entre intelligence, rapidité et coût.
Dans cet article, nous expliquons comment ces modèles travaillent ensemble pour fournir les capacités essentielles dont les agents ont besoin dans des environnements complexes, et plus précisément quel modèle reçoit quels tokens, et à quel moment. Au cœur de cette approche se trouve la gestion de l’historique conversationnel aux différents moments de l’interaction. Nous verrons comment et où cet historique est partagé afin de préciser son rôle dans l’orchestration des agents indépendants comme des workflows multi-agents.
Agent indépendant
Commençons par examiner l’agent indépendant et ses composants essentiels. Un agent apportant une valeur minimale dispose généralement d’un prompt système, d’un accès à plusieurs outils et à une base de connaissances. Les clients devraient privilégier les agents indépendants aux workflows lorsque leur cas d’usage exige peu de vérifications d’une séquence stricte d’étapes ou lorsqu’il est important d’éviter les silos de connaissances entre les agents. Ces silos apparaissent lorsque certains outils, documents ou contextes historiques sont accessibles à certains sous-agents, mais pas à d’autres. Ils sont inhérents aux workflows multi-agents et impliquent un compromis entre flexibilité et déterminisme.
Pour les agents indépendants d’ElevenLabs, il est important de comprendre comment ils :
- Construisent des requêtes de génération efficaces
- Récupèrent et intègrent les documents pertinents
- Génèrent et exécutent des appels d’outils pour éclairer les réponses de l’agent
- Produisent des résultats pour l’évaluation et la collecte de données
Construire le contexte conversationnel
Une conversation entre un client et un agent ElevenLabs correspond à une succession de tours, chacun composé d’un échange de messages entre les deux parties. Cette liste alternée de messages de l’agent et de l’utilisateur sert de point de départ à la construction du contexte conversationnel. À chaque tour, le LLM sous-jacent reçoit des requêtes de génération contenant une série alternée de messages de l’agent et de l’utilisateur, avec un message de plus qu’au tour précédent. Cette série est naturellement précédée d’un unique message système correspondant au prompt système de l’agent.
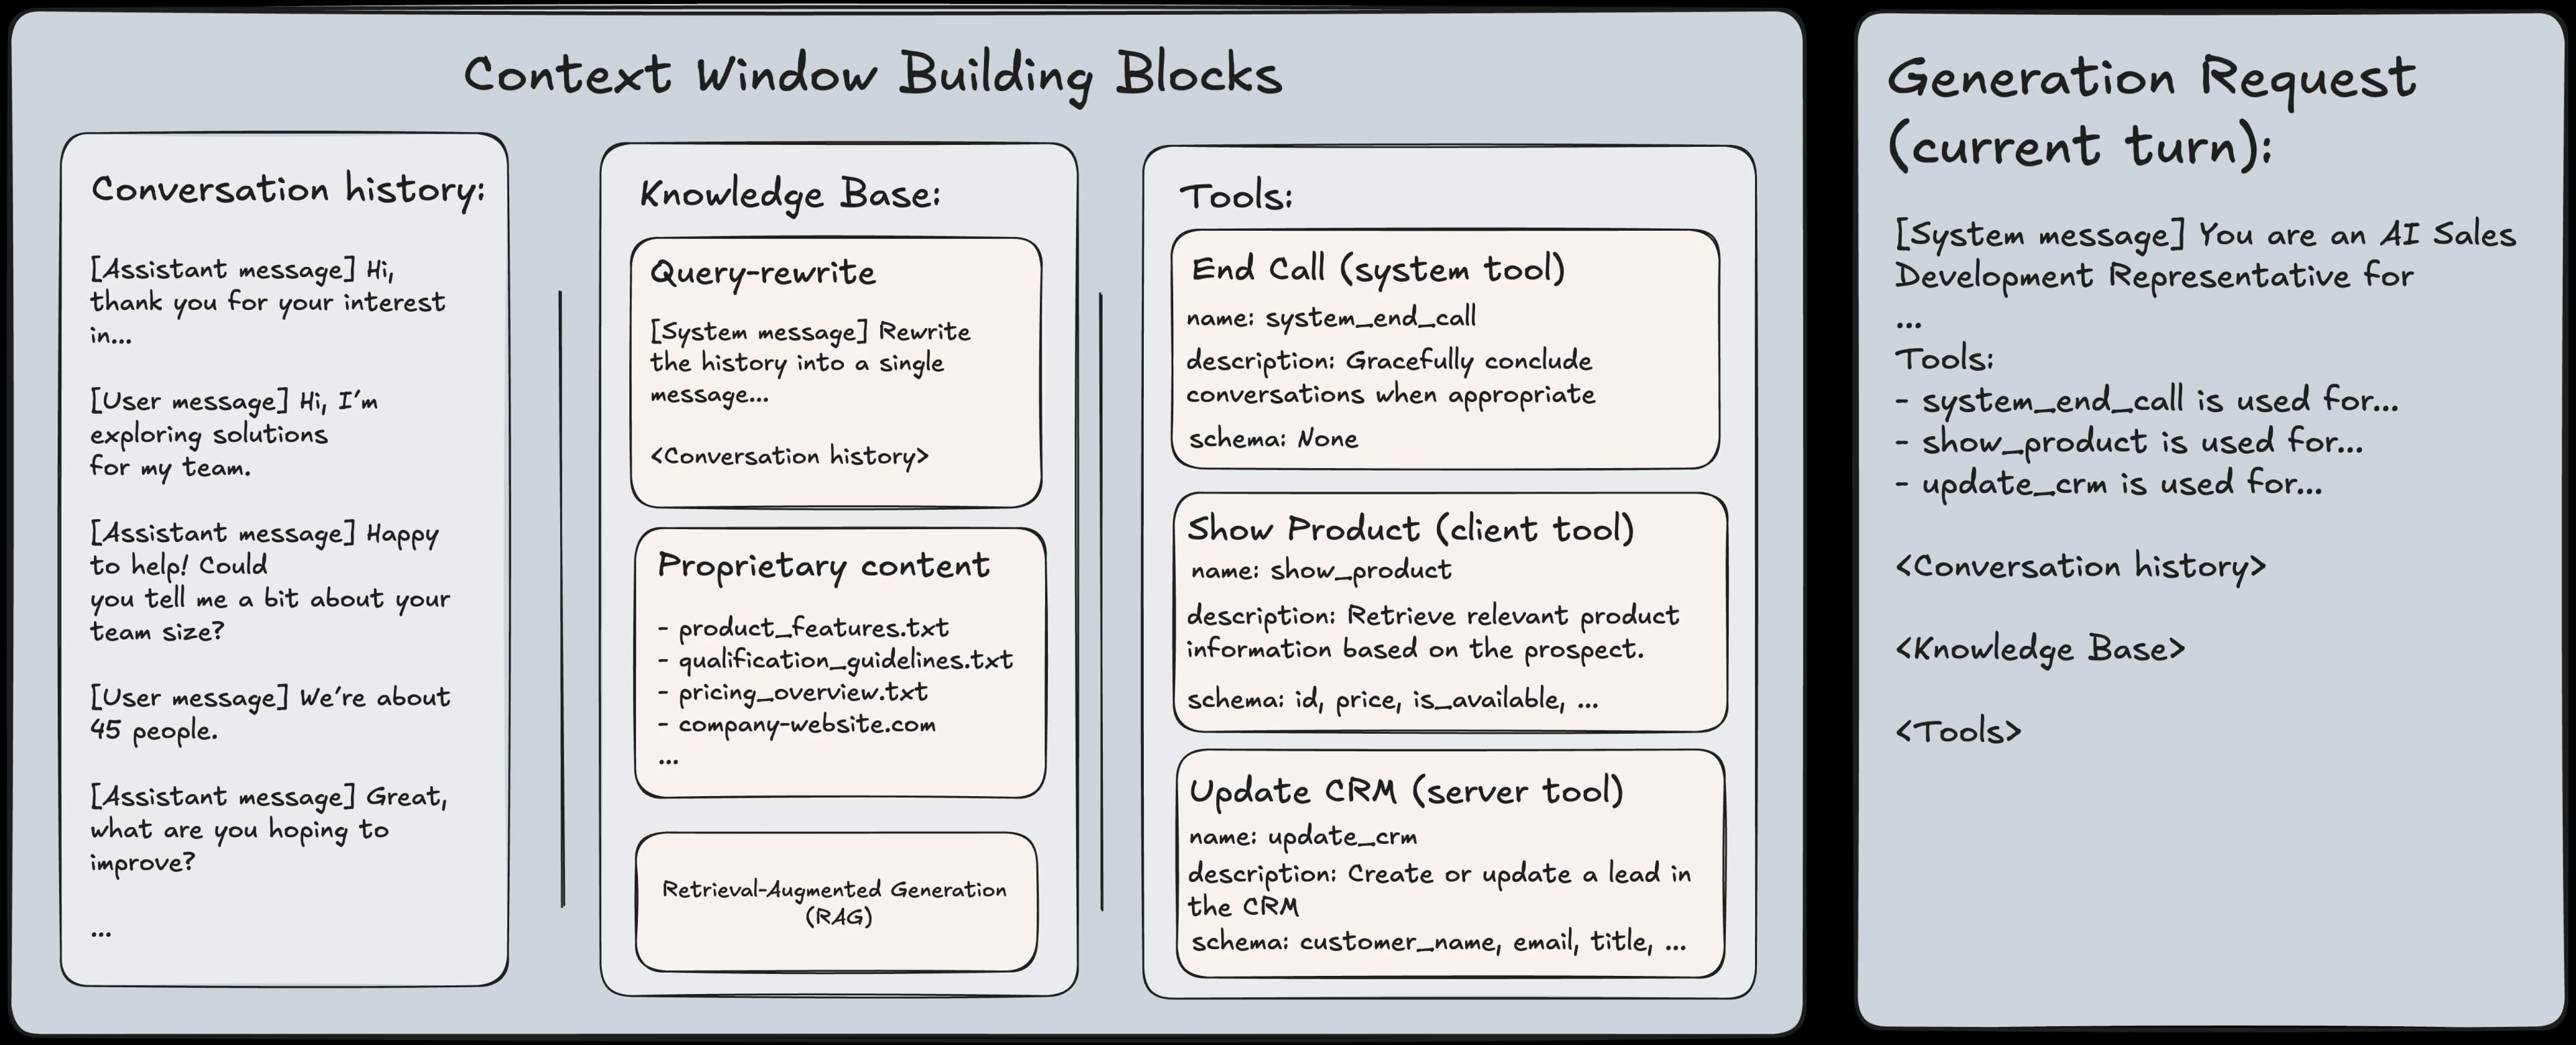
L’orchestrateur ElevenLabs réduit la latence perçue du LLM en prédisant le moment où un utilisateur a fini de parler. Dans certains cas, cela peut entraîner plusieurs requêtes de génération au LLM avec le même contexte conversationnel au cours d’un même tour. Si l’orchestration optimise la rapidité de réponse des agents, la qualité des réponses dépend tout autant de l’accès aux connaissances. À mesure qu’ils avancent, les clients commencent généralement à ancrer les réponses de leurs agents dans une combinaison de documentation propriétaire et de contenu public. Depuis plusieurs années, la génération augmentée par récupération (RAG) est l’approche de référence pour y parvenir. Bases de connaissances ElevenAgents s’appuient sur RAG grâce à une architecture multi-modèle optimisée, détaillée dans un article précédent. Cette approche permet une récupération fiable des documents, même lorsque la dernière saisie de l’utilisateur est une relance, l’acquittement d’une clarification ou ne contient pas de question explicite.
La récupération n’est toutefois qu’une des façons dont les agents interagissent avec les systèmes externes.
Agir et récupérer des informations à l’aide d’outils
Les agents ElevenLabs peuvent effectuer des actions concrètes et récupérer des informations en direct au cours d’une conversation grâce à un système d’outils flexible. Cette capacité implique un point de conception important : chaque outil activé augmente la taille du prompt sérialisé, car son nom, sa description et son schéma de paramètres sont inclus avec le prompt système et l’historique conversationnel. À mesure que de nouveaux outils sont ajoutés, la charge de raisonnement imposée au modèle pour appeler la bonne séquence d’outils augmente également. Dans Agent Builder, la description de l’outil précise ce qu’il fait et les champs qu’il renvoie. C’est cette information que le modèle de langage utilise pour comprendre le contexte de son utilisation. Une fois l’outil défini, les conditions précises de son appel figurent dans le prompt système de l’agent. Par exemple :
- Description de l’outil lookup_order : « Récupère les détails d’une commande client à partir de son identifiant. Renvoie le statut de la commande, les articles achetés, l’adresse de livraison et le numéro de suivi. »
- Instruction du prompt système : « Après avoir vérifié l’identité du client, appelez l’outil lookup_order pour récupérer les détails de sa commande. »
Cette séparation des responsabilités permet de réutiliser les définitions d’outils entre différents agents, tout en laissant le prompt système de chaque agent contrôler le moment précis où un outil est appelé. Pour aider les clients à concevoir efficacement ces prompts système, nous fournissons des recommandations détaillées dans notre Guide de prompting. Dans ce cadre, plusieurs types d’outils peuvent notamment être définis :
- Des outils webhook qui appellent des API externes.
- Des outils client qui envoient les requêtes d’outils sous forme d’événements via le websocket de la conversation.
- Des outils système pour des actions intégrées, comme le transfert d’appels.
- Des outils MCP qui se connectent à des serveurs Model Context Protocol.
Lorsqu’un agent décide d’utiliser un outil, il extrait les détails nécessaires de la conversation et envoie une requête pour l’exécuter. Une fois l’outil exécuté, son résultat est ajouté à la conversation afin que le modèle puisse naturellement s’y référer dans sa réponse suivante. Si nécessaire, la sortie de l’outil peut également mettre à jour les informations stockées par l’agent sous forme de variable dynamique. Ces informations sont conservées sous forme de simples paires clé-valeur, extraites de la réponse de l’outil à l’aide de mappages prédéfinis. Une fois définies, ces variables peuvent être réinjectées dans l’agent via son prompt système, les paramètres de futurs outils et les conditions du workflow. Cette boucle de rétroaction donne aux agents une forme de mémoire de travail qui évolue au fil des interactions.
Si cela décrit l’intégration des outils dans le raisonnement de l’agent, le moment de leur exécution peut également être configuré. Les outils peuvent fonctionner selon trois modes d’exécution, chacun adapté à un besoin conversationnel distinct. En mode immédiat, l’outil s’exécute dès que le LLM le demande. C’est le mode par défaut pour les recherches rapides, lorsqu’un utilisateur attend une réponse quasi instantanée, par exemple pour vérifier le statut d’une commande. Associé à une prise de parole avant l’outil, l’agent génère d’abord un bref acquittement, tel que « Je vérifie cela pour vous », qu’il renvoie à l’utilisateur pendant que l’outil s’exécute en parallèle, afin de limiter les silences. Pour les outils plus lents, la plateforme prolonge automatiquement ces messages d’attente selon le délai estimé. À l’inverse, le mode de prise de parole après l’outil diffère l’exécution jusqu’à ce que l’agent ait fini de parler. Il est essentiel pour les actions ayant des conséquences concrètes, comme transférer un appel, mettre fin à une session ou soumettre un paiement. L’utilisateur entend ainsi l’intégralité du contexte, par exemple « Je vais maintenant vous transférer au service facturation », et peut interrompre l’agent avant l’exécution de l’action. Le mode asynchrone exécute l’outil entièrement en arrière-plan, sans interrompre la conversation. Ce mode convient aux opérations sans attente de résultat, comme l’envoi d’un e-mail, le déclenchement d’un workflow externe ou la journalisation de données, lorsque l’agent n’a pas besoin de mentionner le résultat dans sa réponse.
Une fois l’exécution et l’orchestration en place, l’étape suivante consiste à comprendre comment mesurer les performances.
Mesurer les performances
Après un appel avec un Agent, les clients peuvent vouloir extraire certains éléments de l’appel pour les analyser et les stocker, ou déterminer si l’appel a été concluant. C’est là que Collecte de données et Critères d’évaluation interviennent. La Collecte de données permet d’extraire des informations structurées d’une transcription d’appel pour les analyser et les agréger ultérieurement. Les clients exportent souvent ces résultats vers leur lakehouse de données d’entreprise pour le reporting ou des workflows d’enrichissement. Par exemple, un agent de développement commercial peut extraire automatiquement les informations d’un prospect d’une conversation pour créer ou mettre à jour un lead dans le système de gestion de la relation client (CRM). Les Critères d’évaluation déterminent quant à eux si un appel est considéré comme concluant. Si tous les critères configurés sont remplis, l’appel est marqué comme concluant ; sinon, il est signalé comme un échec. Les conversations respectent ainsi systématiquement des normes définies de qualité et d’intégrité, tout en fournissant un retour rapide. Une fois l’appel terminé et le webhook post-appel déclenché, l’agent traite la transcription finalisée, y compris les exécutions d’outils et les métadonnées, avec un LLM et tous les points de collecte de données et critères d’évaluation configurés. Le modèle utilise ce prompt combiné pour déterminer si chaque critère d’évaluation est rempli et extraire les données spécifiées pour les analyses ultérieures. Comme le LLM interprète directement ces configurations dans son prompt d’entrée, il est important de les formater clairement et de manière cohérente pour que le modèle puisse les comprendre et les appliquer avec précision. Nous recommandons donc les bonnes pratiques suivantes pour rédiger les descriptions des Critères d’évaluation et de la Collecte de données.
Critères d’évaluation
- Un objectif clair par critère : une phrase ou un point court vaut mieux que plusieurs objectifs dans un même critère.
- Observable et fondé sur la transcription : formulez l’objectif de sorte que la réussite ou l’échec puisse être déterminé à partir de la transcription (ce qui a été dit, ce que l’agent a fait, ce que l’utilisateur a demandé). Évitez les objectifs qui nécessitent un contexte externe dont le LLM ne dispose pas.
- Résultats explicites : réussite, échec ou indéterminé : le LLM sait déjà que l’objectif doit être rempli pour marquer une réussite, qu’il ne doit pas l’être pour marquer un échec et qu’il doit être impossible à déterminer depuis la transcription pour le marquer comme indéterminé. L’objectif doit donc être formulé de manière à distinguer clairement « rempli » et « non rempli » ; s’il est ambigu, le modèle peut privilégier des classifications indéterminées ou incorrectes
- Restez concis : plusieurs critères d’évaluation peuvent parfois être envoyés simultanément. Des critères trop longs peuvent donc ajouter du bruit et potentiellement provoquer des hallucinations
- La langue compte : toute justification fournie par le LLM pour indiquer si un critère d’évaluation est rempli ou non sera rédigée dans la même langue que la description du critère ; il est donc important d’en tenir compte
Collecte de données
- Décrivez précisément ce qu’il faut extraire : la description est le principal signal pour le LLM. Indiquez ce que signifie le champ, dans quelle situation il doit être renseigné et quoi faire en cas d’ambiguïté (par exemple, « Laissez null si le client n’a jamais indiqué de date préférée »).
- Respectez le type attendu : la valeur fournie par le LLM correspondra toujours au type de données attribué au point de collecte (par exemple, booléen, chaîne de caractères, entier, etc.). La description doit donc s’y aligner. Par exemple, vous pouvez utiliser « Extrayez le nombre d’articles demandés » pour un entier, et « Oui/non : le client a-t-il accepté l’offre ? » pour un booléen.
- Utilisez des énumérations lorsque c’est possible : pour le type chaîne de caractères, si l’ensemble des valeurs est fixe, utilisez une énumération dans le schéma ; cela contraint le modèle et réduit les sorties non valides.
- Une cible d’extraction par élément : ne regroupez pas plusieurs faits sans lien dans la description d’un même élément ; répartissez-les en éléments distincts afin que chaque appel ait une cible d’extraction unique et claire.
- Gardez des descriptions courtes : quelques phrases suffisent ; nul besoin de longs paragraphes. La transcription figure déjà dans le message utilisateur : le schéma et une courte description suffisent.
Actuellement, le LLM utilisé pour cette étape d’évaluation et d’extraction est un modèle à faible latence, afin de garantir un traitement rapide. Nous prévoyons prochainement d’introduire des options offrant davantage de flexibilité aux clients.
Nous nous intéressons maintenant aux cas d’usage nécessitant une orchestration structurée, du déterminisme ou une spécialisation entre plusieurs rôles conversationnels, pour lesquels les clients peuvent utiliser les Workflows.
Workflows
Workflows offrent une interface visuelle pour concevoir des flux conversationnels complexes. Ils produisent l’objet logique que l’orchestrateur utilise pour gérer plusieurs sous-agents, outils et transferts sous l’identifiant d’un agent indépendant. Les Workflows ajoutent des composants à prendre en compte, au-delà de ceux déjà présentés pour les agents indépendants, notamment la manière dont :
- Les prompts système et les objectifs conversationnels des sous-agents interagissent.
- Le parcours des différents points de transition du graphe est déterminé.
Objectifs conversationnels spécialisés
Les Workflows réutilisent les fonctionnalités des agents indépendants pour assurer un comportement cohérent tout au long d’une interaction. Cela comprend des éléments partagés tels que le prompt système de base, les outils essentiels et les bases de connaissances globales, qui doivent toujours être disponibles, quelle que soit la partie active du workflow. Le prompt système global définit généralement le contexte conversationnel général, le ton attendu, les contraintes de sécurité et les instructions propres à la marque ou applicables à l’ensemble du produit.
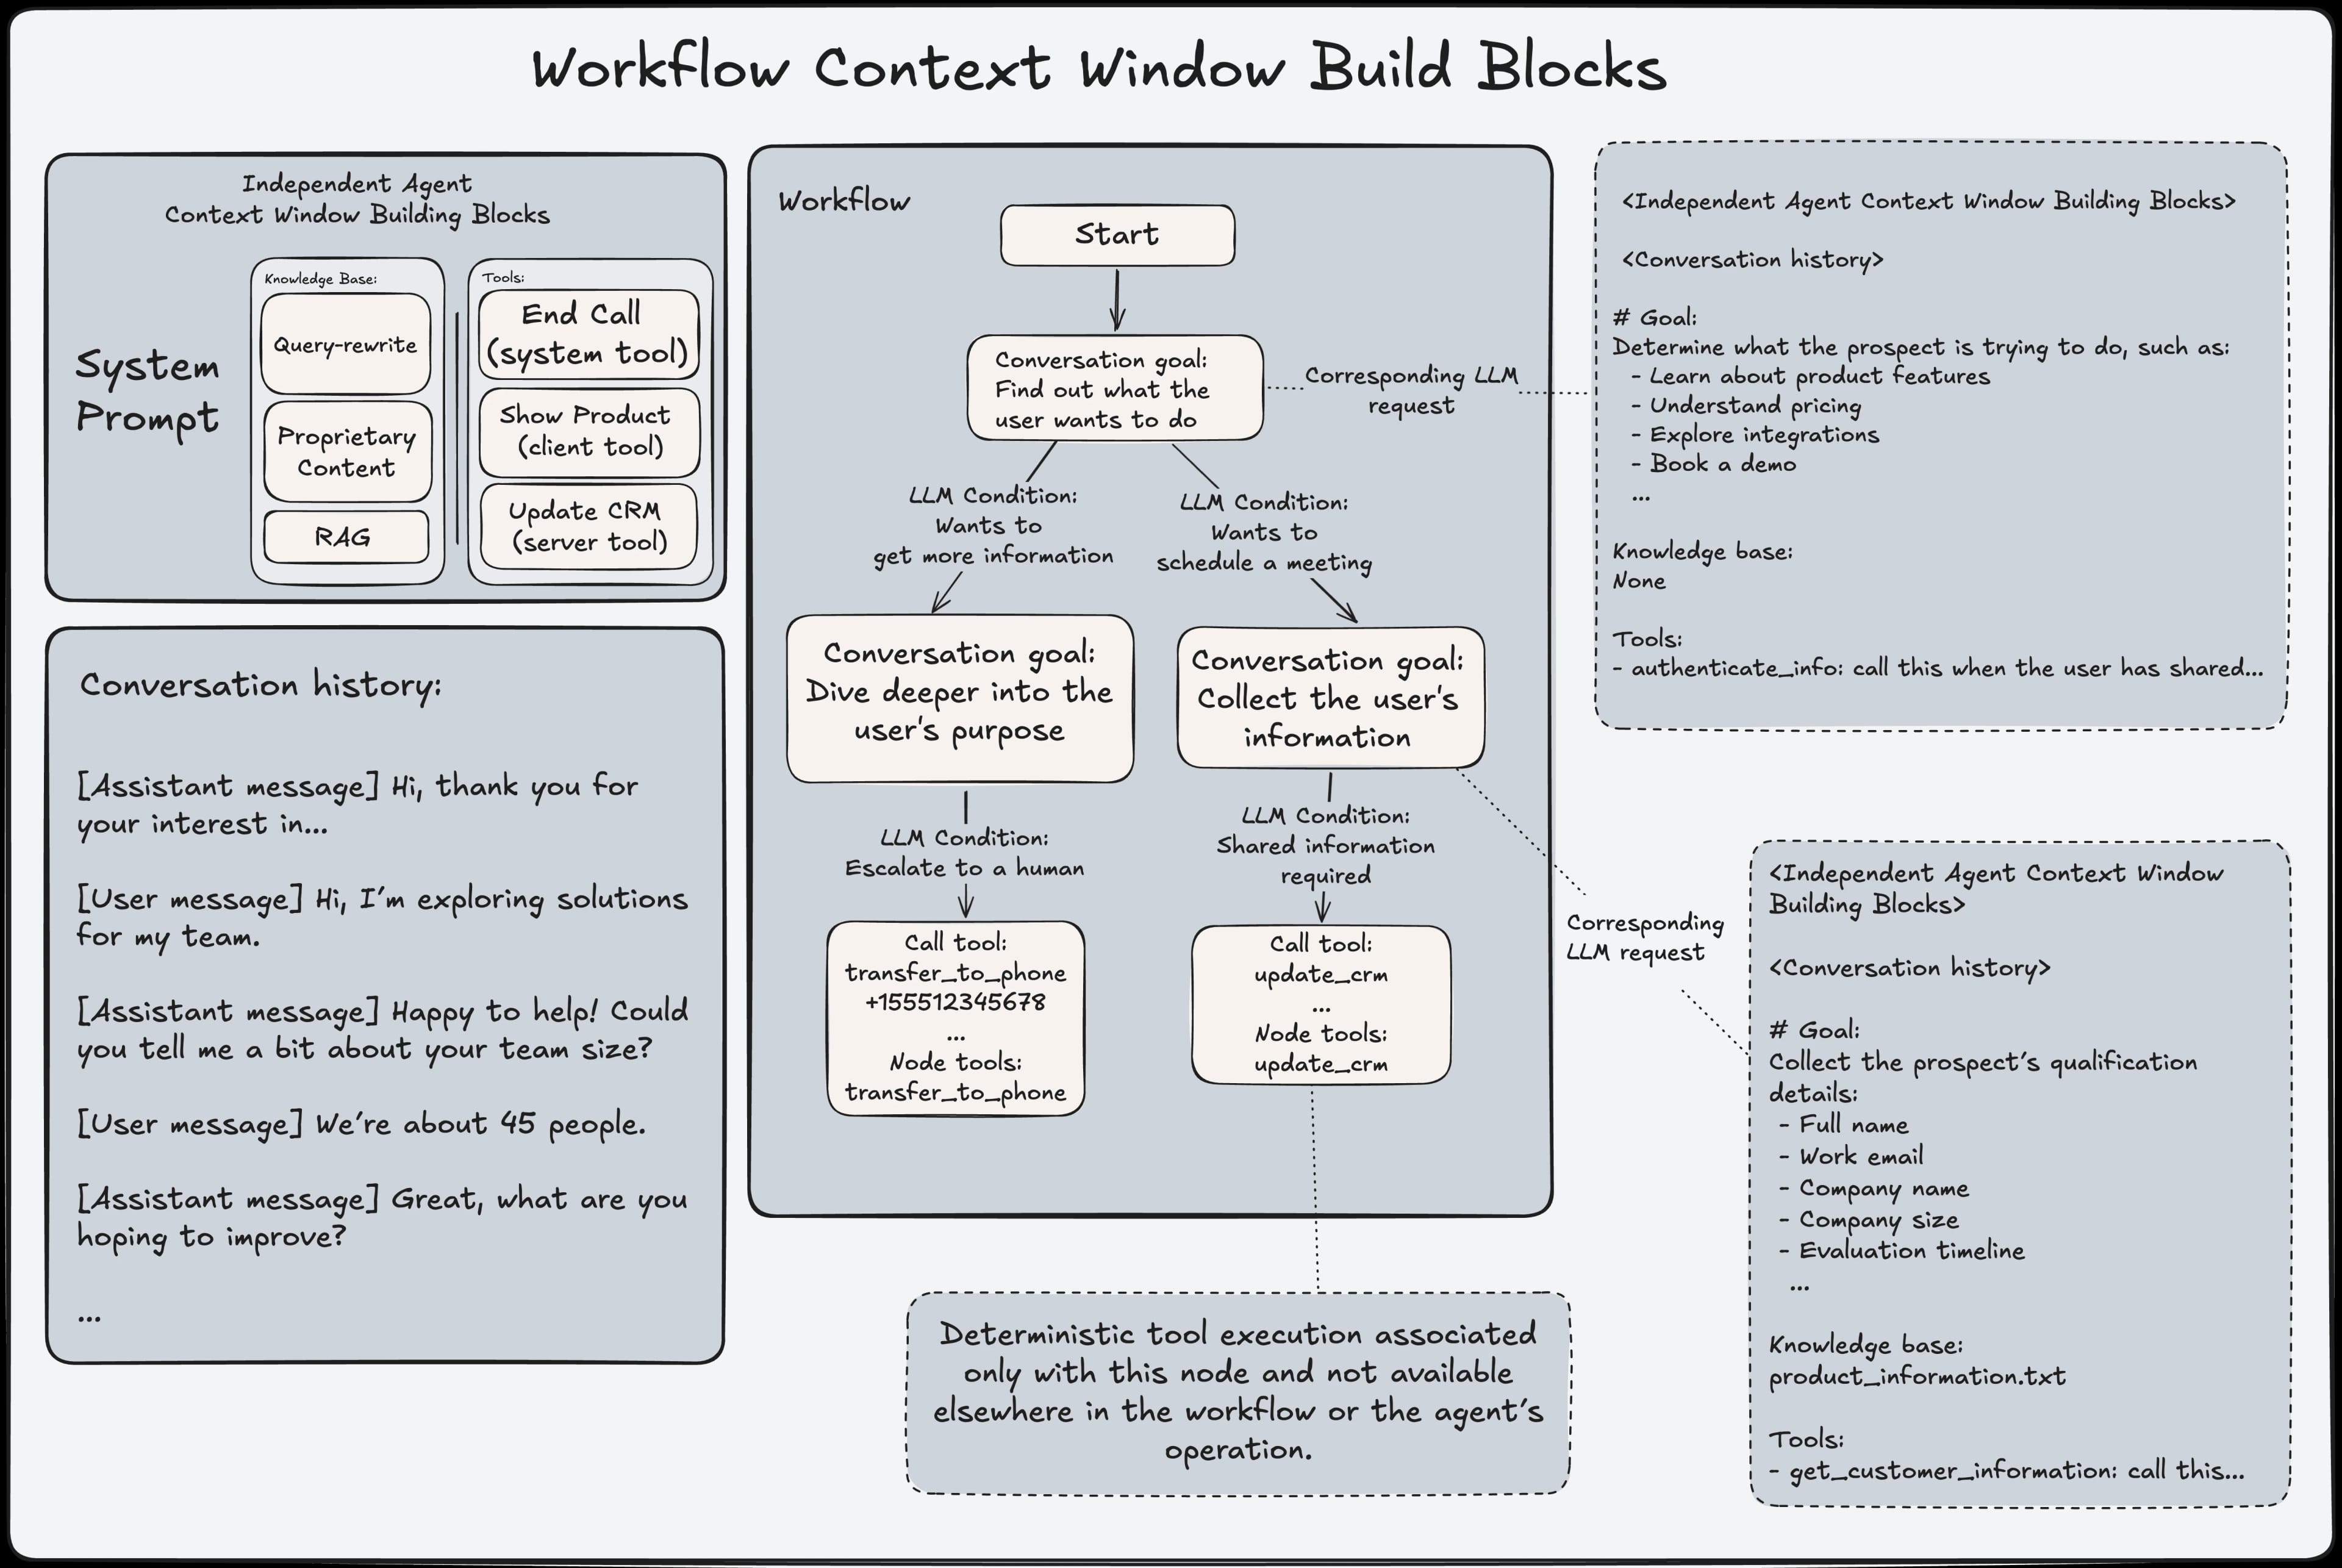
Sur cette base commune, les Workflows introduisent des sous-agents spécialisés qui opèrent au sein d’un graphe orienté. Chaque sous-agent reçoit un objectif précisément délimité et complète la configuration de base par des instructions de prompt, des outils et des sources de connaissances pertinents uniquement pour son rôle. Au lieu de redéfinir l’ensemble de la configuration conversationnelle, les sous-agents ajoutent leur intention à l’agent de base grâce à la composition de prompts et à une extension sélective du contexte. Si l’historique conversationnel est conservé lors des transitions entre sous-agents afin d’assurer la continuité, chaque sous-agent opère avec une vue délibérément limitée du système. Les bases de connaissances et les outils sont exposés de manière sélective, créant des silos clairs qui empêchent toute fuite entre les responsabilités. Pour renforcer cette isolation, l’objet orchestrateur est reconstruit à chaque transition comme s’il s’agissait d’un agent indépendant. L’état du prompt, la configuration et les capacités disponibles du sous-agent actif restent ainsi entièrement déterministes. Cette conception permet aux Workflows de préserver une cohérence globale tout en prenant en charge la spécialisation locale, pour un comportement prévisible, une séparation claire des responsabilités et un contrôle précis de l’application du contexte, des connaissances et des actions à chaque étape d’une interaction.
L’un des mécanismes essentiels qui rendent ce contrôle possible réside dans la gestion des transitions entre les sous-agents.
Piloter les transitions du workflow avec des conditions LLM
Les Workflows progressent en parcourant un graphe orienté de sous-agents, dans lequel les transitions entre les nœuds sont contrôlées par des conditions explicites. Ces conditions déterminent quand le contrôle doit passer d’un sous-agent à un autre et permettent aux workflows de réagir aux saisies des utilisateurs, aux résultats des outils et aux variables dynamiques. Les conditions du graphe peuvent être déterministes ou évaluées par un LLM. Les conditions déterministes, comme les transitions inconditionnelles, les vérifications fondées sur des expressions de variables dynamiques ou les conditions basées sur les résultats d’outils, offrent de solides garanties sur le flux de contrôle et conviennent particulièrement à l’application d’une progression stricte dans un workflow. À l’inverse, les conditions basées sur un LLM permettent une évaluation sémantique de critères en langage naturel, par exemple pour détecter l’intention d’un utilisateur ou reconnaître la transmission d’une information spécifique.
Il est important de noter que les conditions LLM sont évaluées en dehors du prompt système de l’agent actif et n’influencent pas son comportement de génération. Elles sont au contraire évaluées en parallèle par l’orchestrateur à partir de l’état actuel de la conversation. Cette séparation garantit que la logique de transition ne contamine pas le prompt de l’agent et n’affecte pas la génération des réponses, tout en permettant aux workflows de tirer parti du raisonnement des LLM pour parcourir le graphe avec souplesse. En combinant des conditions déterministes et évaluées par LLM, les workflows allient prévisibilité et adaptabilité : ils utilisent des transitions déterministes lorsque l’exactitude est essentielle et des transitions basées sur un LLM lorsqu’une interprétation sémantique est requise.
Lorsqu’une conversation passe à une nouvelle étape, le système active une version de l’agent spécifiquement adaptée à cette étape. Chaque étape dispose de ses propres instructions ciblées et n’accède qu’aux connaissances et aux outils pertinents pour sa responsabilité. Par exemple, une étape de traitement des remboursements peut consulter les politiques de remboursement sans hériter de contexte sans rapport provenant de l’onboarding ou du triage. Le passage d’une étape à l’autre est régi par des conditions de transition explicites. Ces conditions déterminent quand la responsabilité doit changer et permettent aux décisions de routage d’intervenir naturellement au fil de la conversation. Pour préserver la continuité, l’expérience utilisateur reste fluide entre les transitions : chaque étape hérite du contexte conversationnel pertinent sans exposer les mécanismes du transfert. Des garde-fous surveillent également les transitions afin d’éviter les cycles de routage improductifs et de maintenir la stabilité du workflow, orienté vers son objectif.
Sécurité et sûreté
Pour les cas nécessitant des contrôles renforcés de sûreté et de sécurité, les clients peuvent s’appuyer sur des composants supplémentaires de l’orchestrateur.
Garde-fous
Les Agents ElevenLabs mettent en œuvre des garde-fous de sécurité grâce à un système configurable de modération et d’alignement qui évalue les messages des utilisateurs et des agents en temps réel. Les contenus entrants sont classés dans plusieurs catégories de risques, notamment les contenus sexuels, la violence, le harcèlement, la haine et l’automutilation, chacune avec des seuils configurables indépendamment. Lorsqu’un garde-fou est déclenché, la conversation est immédiatement interrompue et le client est informé d’un motif d’échec clair. Les interactions dangereuses sont ainsi bloquées tôt et systématiquement, sans dépendre uniquement de mesures d’atténuation fondées sur les prompts. Les garde-fous opèrent en dehors de la logique de prompt de l’agent et fournissent une couche d’application fiable qui ne peut être contournée par le comportement du modèle ou les saisies de l’utilisateur. Cette approche permet aux clients d’ajuster la sensibilité de sécurité selon leur domaine, tout en maintenant une application déterministe à l’exécution.
Gestion conforme des données
Les interlocuteurs peuvent parfois partager avec un agent des informations sensibles soumises à des exigences strictes de stockage et de traitement, par exemple des données médicales nécessitant un traitement conforme à la loi HIPAA. Pour prendre en charge ces cas d’usage, nous proposons le Zero Retention Mode (ZRM) au niveau de l’Agent ou du Workspace. Lorsqu’il est activé, toutes les données d’appel sont traitées uniquement en mémoire et ne sont jamais écrites dans un stockage persistant. Une fois l’appel et son traitement terminés, ElevenLabs ne conserve aucune information. Par conséquent, les transcriptions, enregistrements audio et résultats d’analyse ne sont pas disponibles dans le Dashboard Agents, et cette règle s’applique aux systèmes destinés aux clients comme aux journaux internes. Bien que les données ne soient pas conservées, elles sont traitées pendant l’appel, et tous les webhooks post-appel configurés reçoivent les résultats, ce qui permet aux clients de stocker les transcriptions ou résultats d’analyse dans leurs propres systèmes si nécessaire.
Lorsque le ZRM est actif, nous veillons également à ce que les sous-traitants ne conservent pas les données en limitant les LLM disponibles aux fournisseurs ayant des engagements contractuels interdisant l’entraînement sur les données clients et leur conservation ; cela inclut actuellement des modèles de Google Gemini et Anthropic Claude. Les clients qui souhaitent utiliser un autre LLM sous ZRM peuvent conclure leur propre accord avec ce fournisseur et le configurer comme LLM personnalisé à l’aide de clés API couvertes par cet accord. Comme cela étend le traitement des données au-delà de notre périmètre de confiance standard, notre équipe Safety doit examiner et approuver manuellement le cas d’usage avant son activation. Si le ZRM garantit qu’ElevenLabs et ses sous-traitants ne conservent pas les données d’appel, les clients restent responsables de la conformité des outils externes ou webhooks utilisés par leur Agent aux exigences applicables de conservation et de réglementation.
Perspectives
Dans cet article, nous avons vu comment les Agents ElevenLabs gèrent le contexte conversationnel, les outils, l’évaluation et les workflows structurés afin d’offrir des expériences fiables et en temps réel à grande échelle. À mesure que les clients déploient des agents dans des environnements de plus en plus complexes, nous continuons à étendre la flexibilité de notre moteur d’orchestration : modèles d’évaluation configurables, contrôles de transition plus riches et meilleure visibilité sur la composition des prompts et l’utilisation des tokens à chaque étape.
Notre équipe Forward Deployed Engineering travaille en étroite collaboration avec les clients pour que ces capacités évoluent au même rythme que les déploiements réels. La prochaine génération d’Agents offrira encore davantage de transparence, de déterminisme et d’adaptabilité, sans compromettre les performances à faible latence qui rendent la conversation en temps réel possible.

