
Qu’est-ce qu’un LLM ? Guide pratique des modèles de langage
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Un grand modèle de langage (LLM) est un système d’intelligence artificielle entraîné sur un vaste jeu de données afin d’analyser, de prédire et de générer du langage naturel. Parmi les LLM les plus connus figurent les modèles GPT d’OpenAI, Claude d’Anthropic et Gemini de Google, souvent utilisés pour la rédaction, l’édition et le codage.
À l’origine, les jeux de données des LLM contenaient principalement des textes issus de livres, de blogs et même de forums en ligne. Les LLM modernes utilisent désormais des données multimodales pour élargir leurs cas d’usage, notamment pour alimenter des agents vocaux et conversationnels ou créer de la musique.
Avant de mettre en œuvre cette technologie, les organisations ont souvent besoin de réponses à des questions telles que : qu’est-ce qu’un LLM, comment fonctionne-t-il et quelles architectures l’équipe doit-elle utiliser ? Ce guide répond à ces questions tout en présentant des applications concrètes de la technologie et leurs avantages tangibles.
À retenir
- Un grand modèle de langage (LLM) est un modèle d’intelligence artificielle entraîné sur de vastes jeux de données textuelles et multimodales afin d’analyser, de prédire et de générer des résultats.
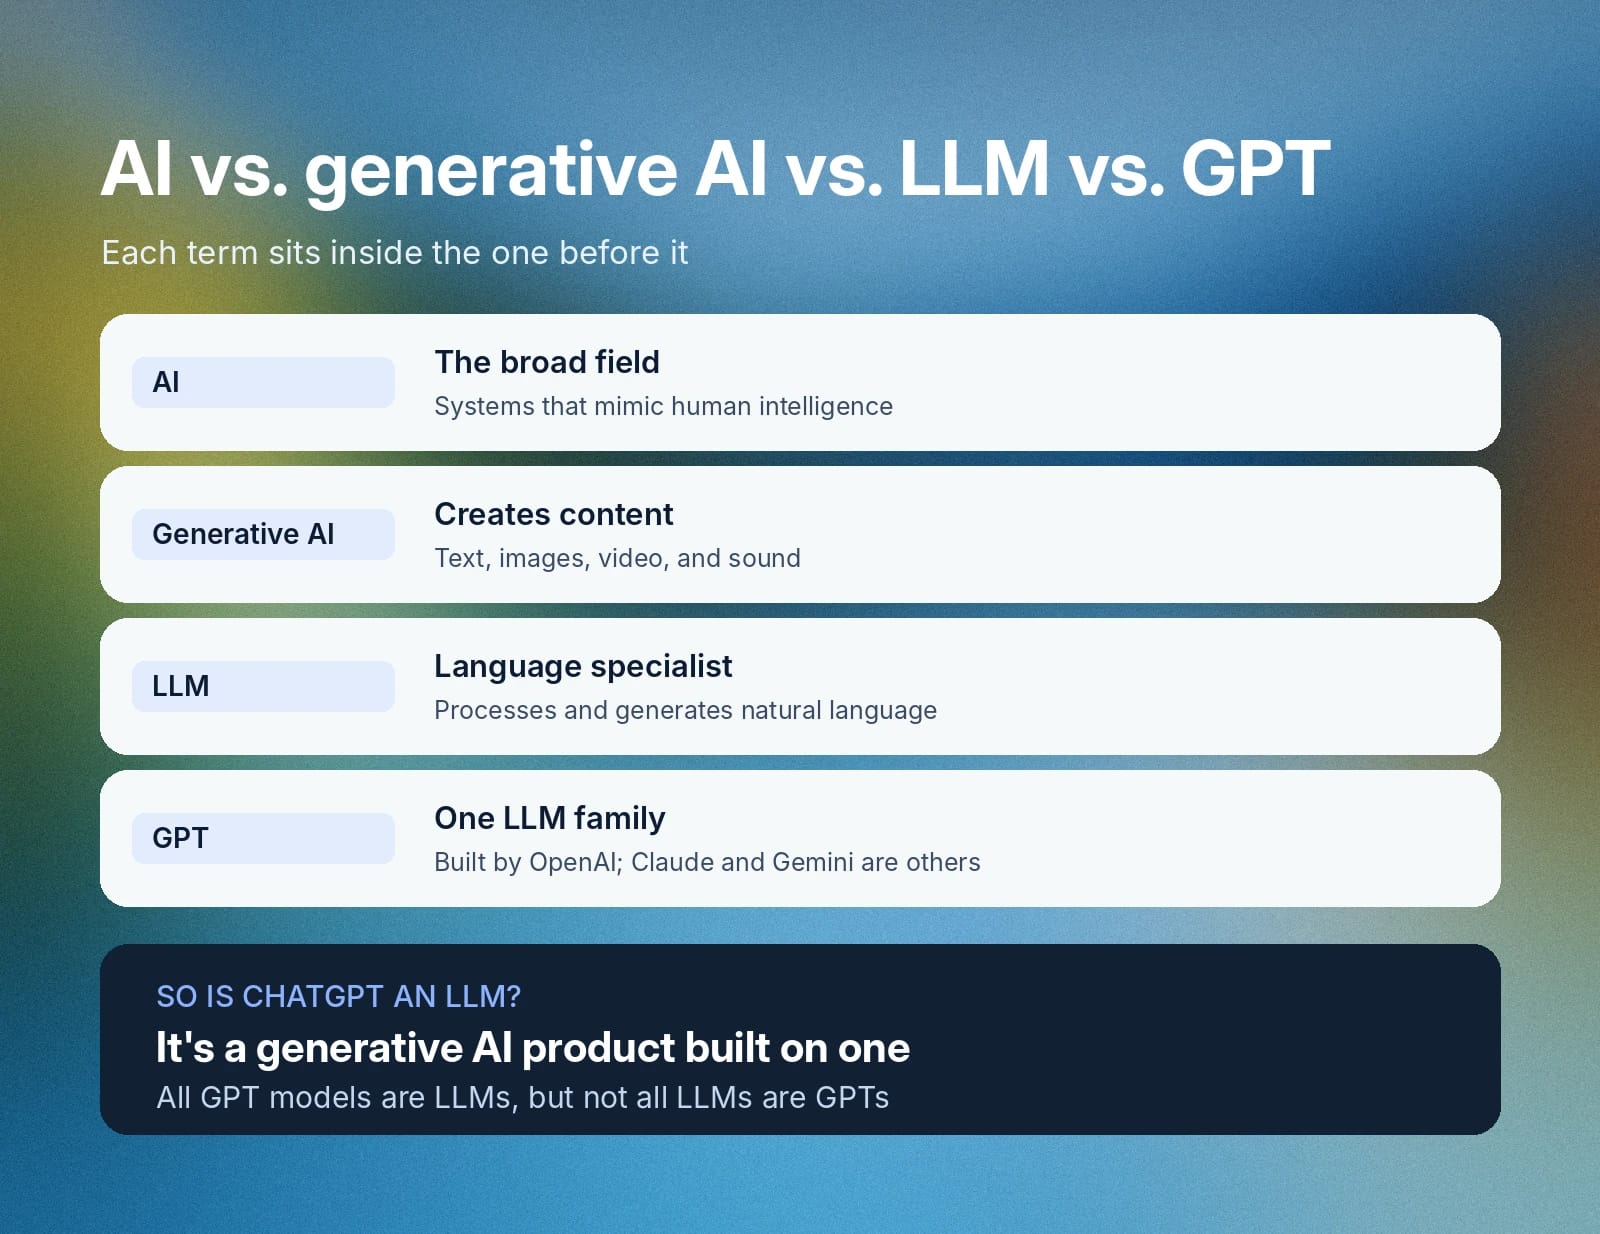
- La principale différence entre les GPT et les LLM est que GPT (Generative Pre-trained Transformer) désigne une famille spécifique de LLM créée par OpenAI, tandis que LLM est le terme générique qui englobe des modèles comme Claude et Gemini.
- L’IA générative est la catégorie générale des modèles qui créent un large éventail de contenus à partir de données d’entraînement, tandis que les LLM constituent une catégorie spécialisée de l’IA générative axée sur le traitement du langage naturel.
- Les LLM utilisent des réseaux neuronaux de type transformer pour découper le texte en unités plus petites appelées tokens, puis prédire le token suivant à partir des informations contextuelles du prompt et de l’historique de chat existant.
- Les exemples concrets de grands modèles de langage incluent les chatbots de service client, les outils de rédaction automatisée, les générateurs de code et les couches de traitement du langage naturel pour les applications vocales.
Qu’est-ce qu’un LLM ? Définition d’un grand modèle de langage
Un grand modèle de langage est un programme d’IA reposant sur des réseaux neuronaux d’apprentissage profond, conçu pour analyser, prédire et générer du langage naturel. Les développeurs entraînent ces modèles sur des jeux de données contenant des milliards de contenus issus de livres, d’articles universitaires, de sites web et de blogs. Le terme « grand » renvoie à la fois au volume considérable de données utilisé pour entraîner ces modèles et aux milliards de paramètres internes qui régissent leur comportement.
Les grands modèles de langage marquent une évolution majeure par rapport aux logiciels précédents : les logiciels traditionnels reposaient sur des commandes à syntaxe explicite, contrairement aux LLM. Au lieu de traiter chaque mot de façon isolée, les LLM exploitent les relations contextuelles pour reconnaître des structures linguistiques complexes et la grammaire. Ils interprètent le langage humain non structuré et répondent à des prompts utilisateur ouverts, en s’adaptant aux changements de contexte au cours de la conversation.
Ces avancées du traitement du langage naturel permettent à ElevenAgents de comprendre les intentions complexes des clients et d’exécuter des workflows automatisés.
Comment fonctionnent les grands modèles de langage ?
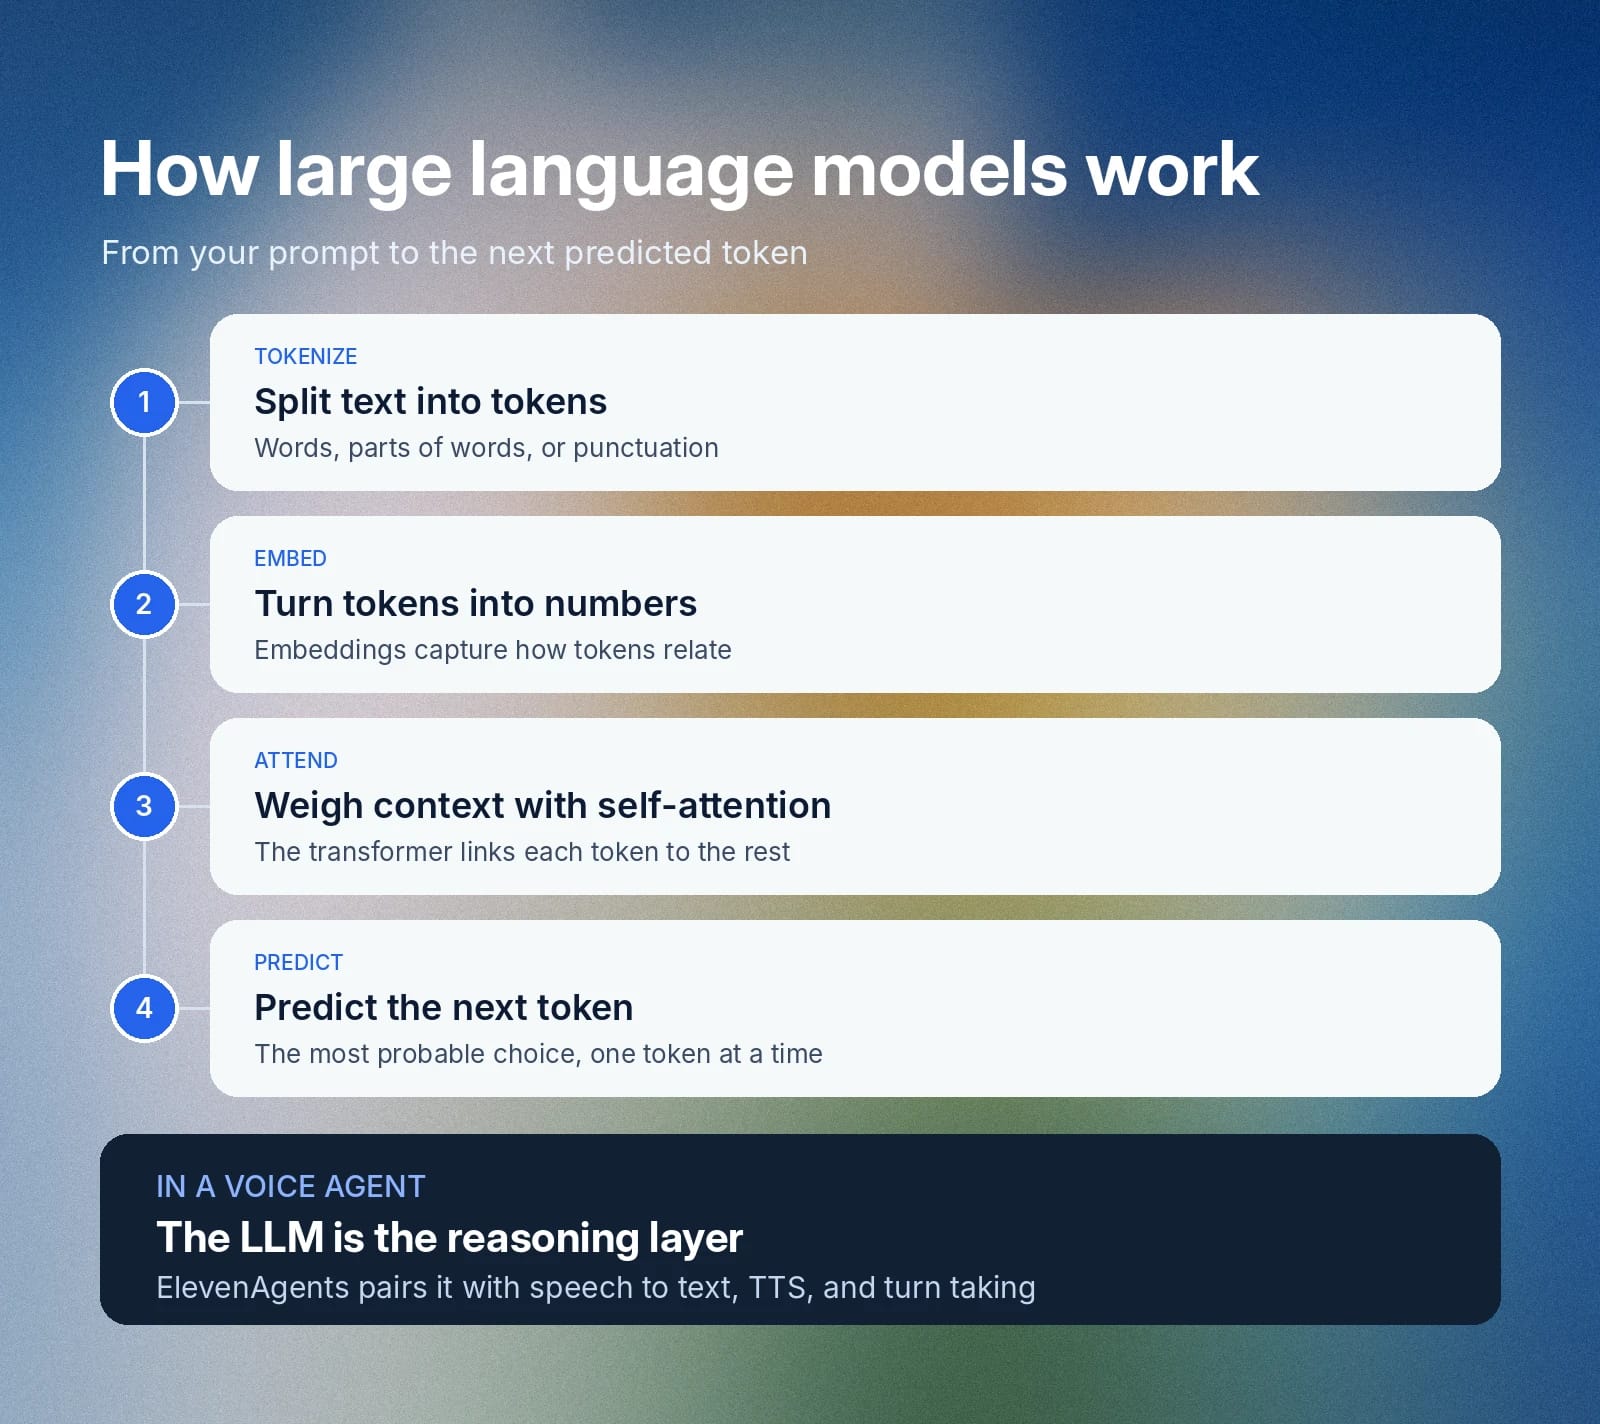
Les grands modèles de langage traitent le texte à l’aide de réseaux neuronaux artificiels afin d’analyser les entrées en langage naturel et de générer du contenu pertinent. Le processus commence par la tokenisation, lors de laquelle le modèle divise le texte d’entrée en unités plus petites appelées tokens. Le modèle traduit ensuite ces tokens en représentations numériques, appelées embeddings, pour évaluer les relations mathématiques ou statistiques entre eux.
La plupart des systèmes LLM modernes reposent sur l’architecture de réseau neuronal transformer. Les transformers utilisent des mécanismes d’auto-attention qui évaluent les relations contextuelles entre les tokens. Le modèle prédit le token statistiquement le plus probable pour compléter une séquence en utilisant des schémas appris afin de calculer des distributions de probabilités.
L’auto-attention permet aux modèles de traitement du langage naturel de conserver un contexte à long terme et de s’adapter aux changements au cours d’une conversation. Les intégrations de plateforme avec ElevenAgents s’appuient sur ces capacités pour fournir des réponses pertinentes à faible latence, proches d’une conversation humaine naturelle.
Qu’est-ce que la température d’un LLM ?
La température d’un LLM est un paramètre variable que les développeurs peuvent configurer pour déterminer le degré d’aléa de ses résultats. Les LLM génèrent le token suivant dans une suite de mots en sélectionnant l’option la plus fréquente. Cependant, pour chaque choix effectué par un LLM, plusieurs autres alternatives peuvent présenter une pondération similaire.
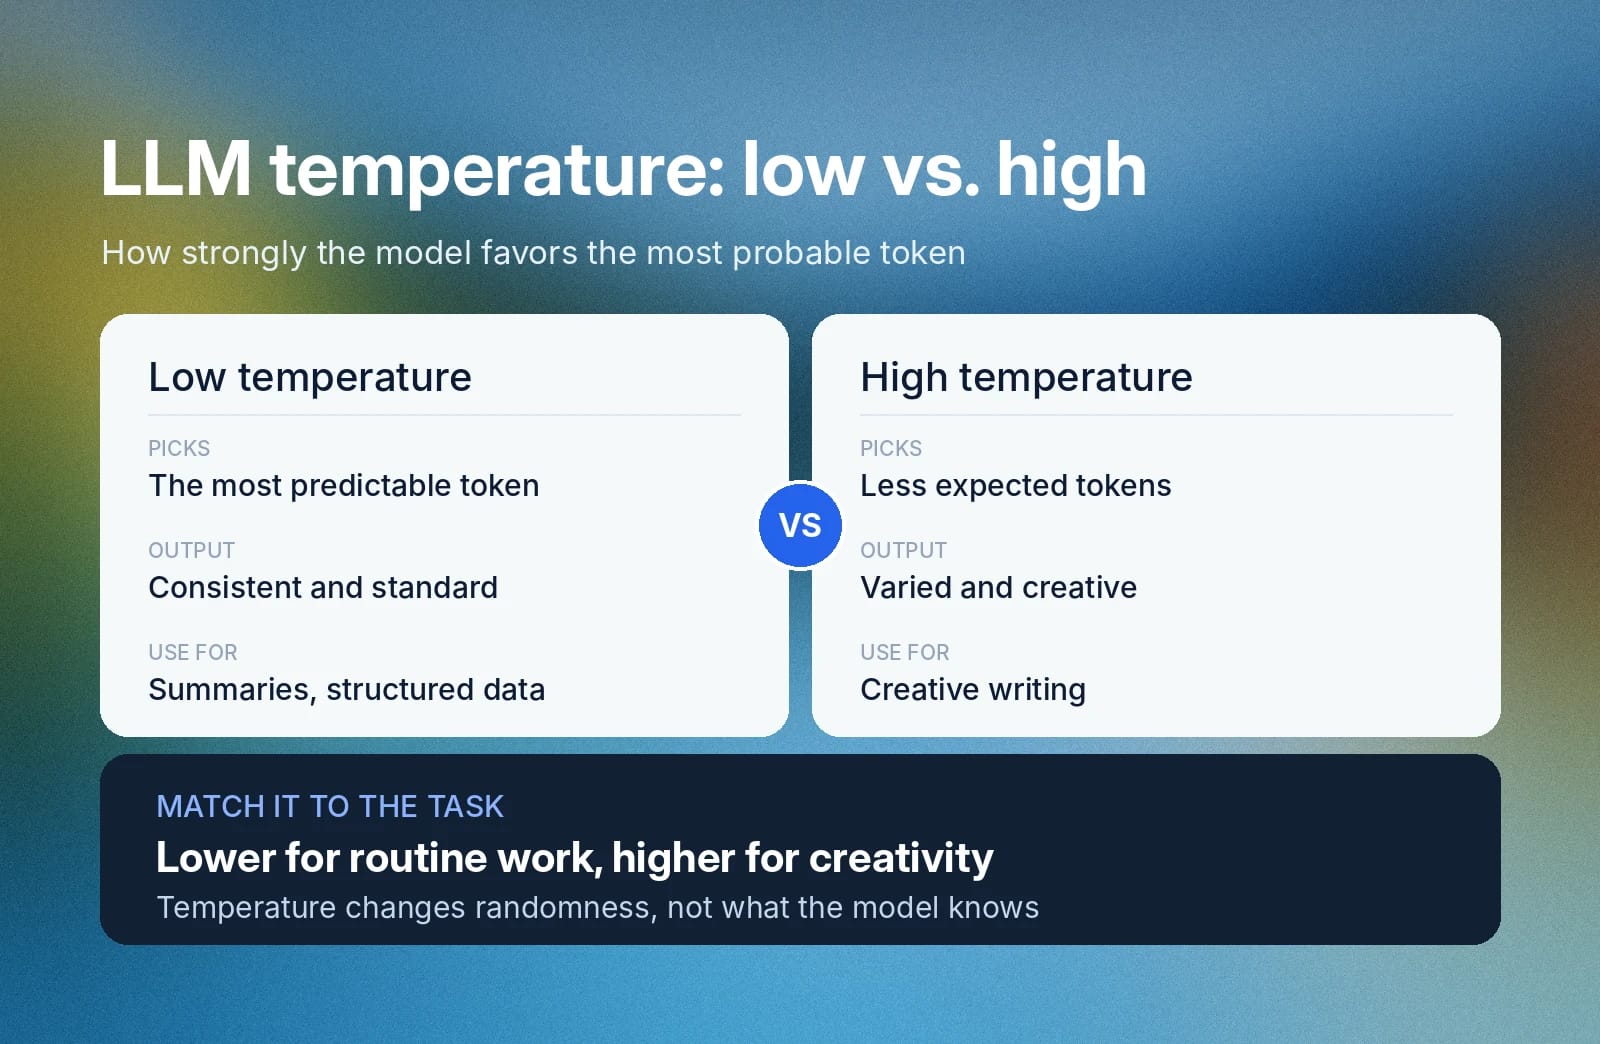
En ajustant la température d’un LLM, vous modifiez à quel point il privilégie l’option la plus probable. Un réglage de température faible produit un résultat standard et cohérent, car il tend à toujours choisir le token suivant le plus prévisible dans une suite. À l’inverse, une température élevée s’écarte plus souvent du choix attendu et produit des résultats plus créatifs et variés.
Adaptez la valeur de température de votre LLM à la tâche visée. Les tâches nécessitant une part de créativité doivent privilégier des températures plus élevées, tandis que les tâches répétitives ou les résultats structurés, comme les synthèses de données, doivent privilégier des températures plus basses.
Comment les LLM sont-ils entraînés et affinés ?
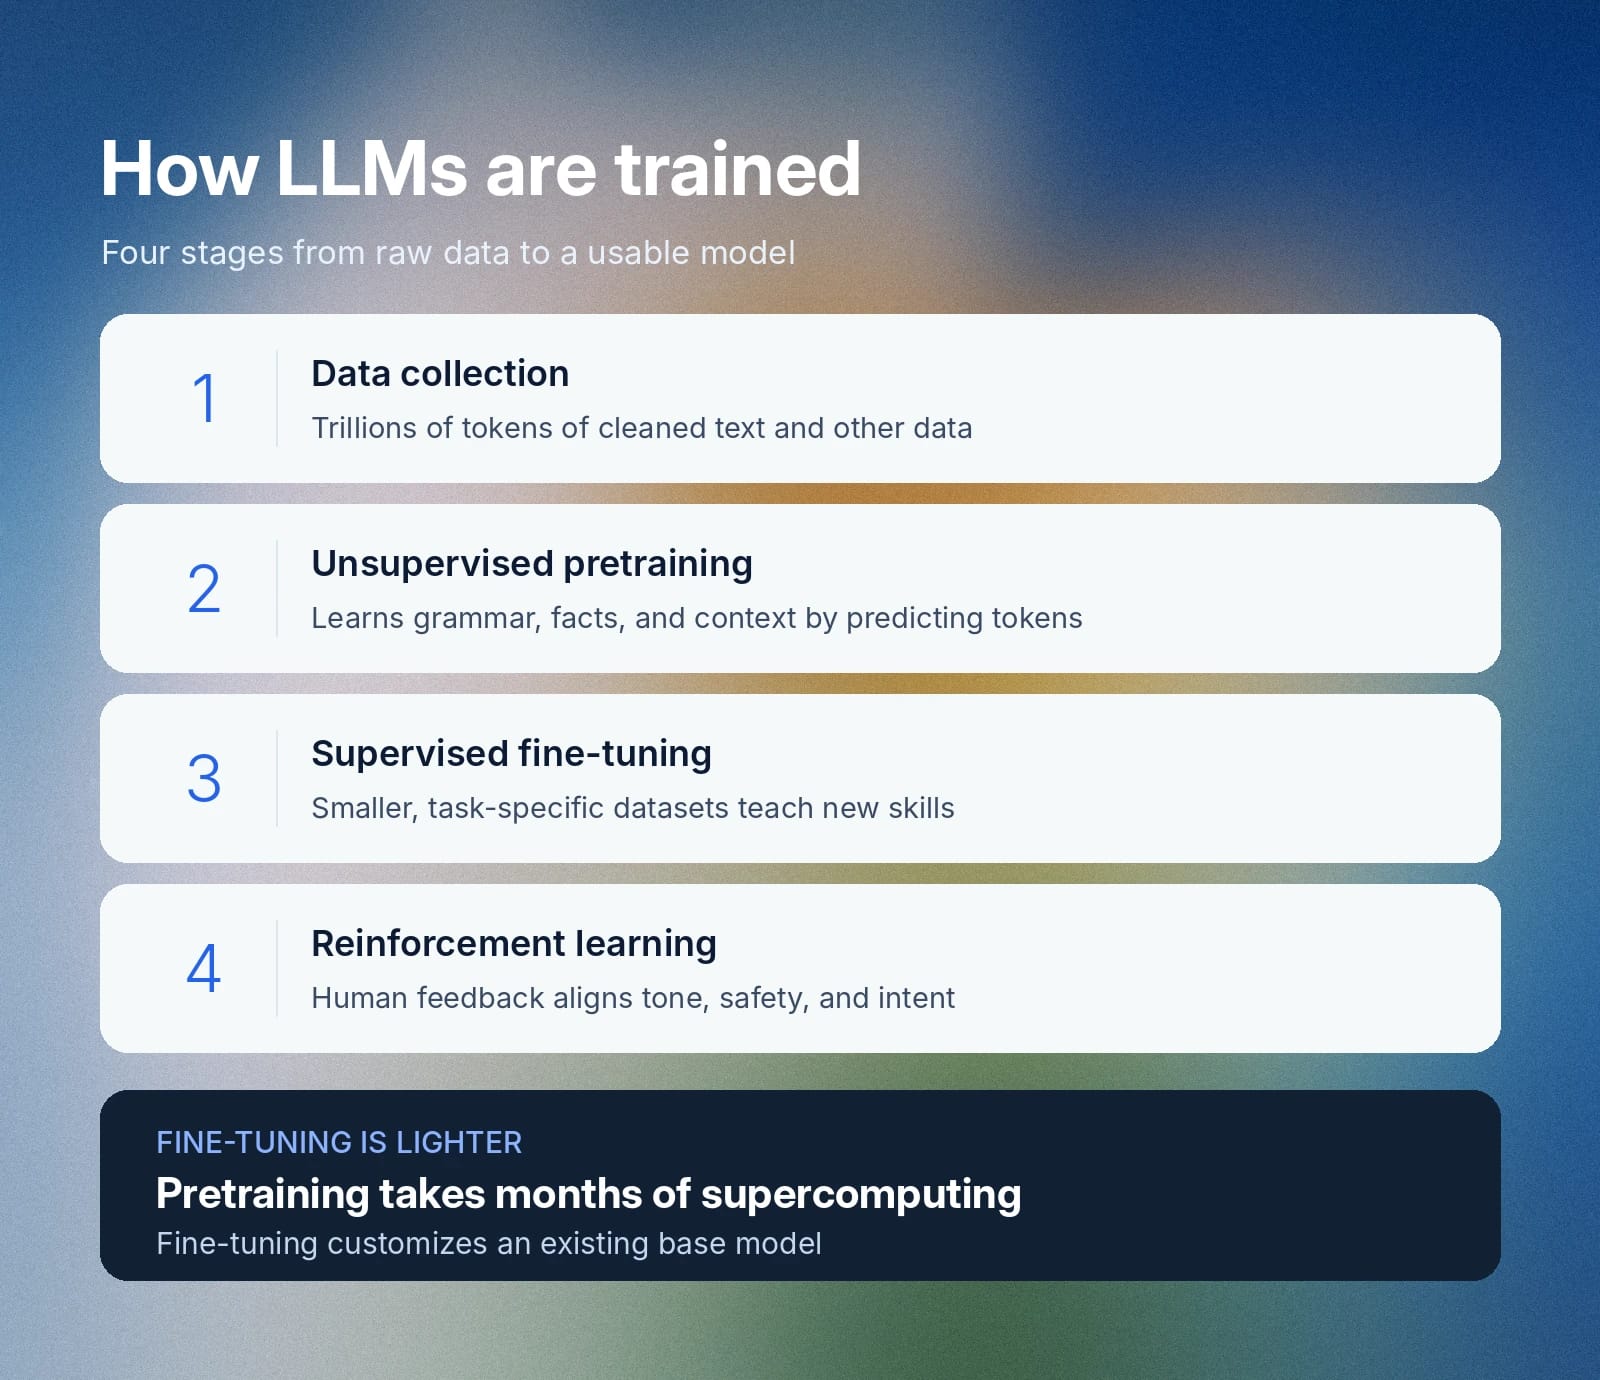
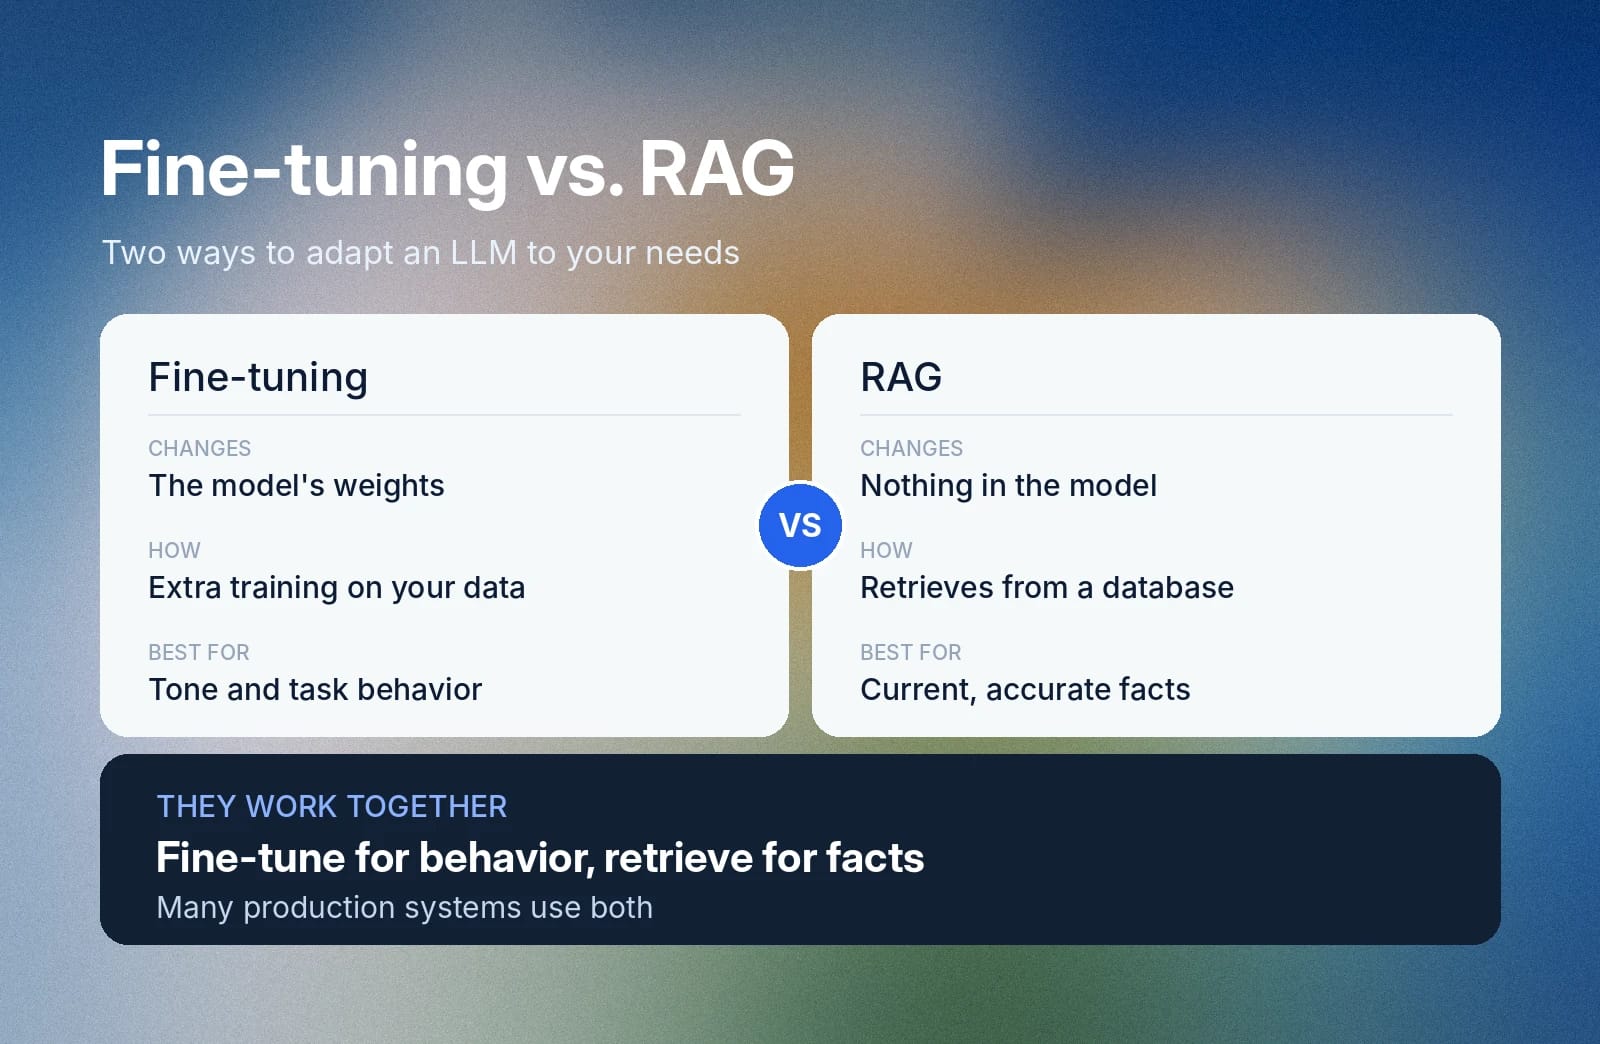
L’entraînement des LLM exige un processus en plusieurs étapes pour transformer des textes bruts et des données multimodales en systèmes de langage fonctionnels. Les entreprises ont besoin de capacités de supercalcul avancées fonctionnant pendant plusieurs mois, tandis que le fine-tuning est un processus plus léger qui personnalise le modèle de base existant.
Les entreprises d’IA de pointe considèrent généralement leur processus d’entraînement précis comme une information propriétaire, et la plupart ne divulguent ni leur code source ni leurs pondérations. L’entraînement suit néanmoins généralement ce processus :
- Collecte et prétraitement des données : Les développeurs constituent des jeux de données à partir de sources multiples, avec des corpus de préentraînement comprenant des milliers de milliards de tokens extraits de téraoctets de texte nettoyé. L’extraction ou l’exploration de textes provenant de sources Internet est l’un des principaux moyens utilisés par les entreprises pour constituer ces jeux de données.
- Préentraînement non supervisé : Le grand modèle de langage lit des milliers de milliards de tokens pour apprendre les règles de grammaire, les relations factuelles et le contexte linguistique. Il se préentraîne essentiellement par modélisation autorégressive du langage, alimentée par des mécanismes d’auto-attention qui calculent le token suivant statistiquement probable dans une séquence.
- Fine-tuning supervisé : Les ingénieurs utilisent des jeux de données plus petits et plus spécifiques à certaines tâches pour ajuster le modèle préentraîné. Cette étape apprend au modèle des compétences précises, allant de la réponse à des questions générales à la génération de logos ou à la conduite de recherches en laboratoire.
- Apprentissage par renforcement et alignement : Les développeurs affinent le comportement du modèle à l’aide des retours d’évaluateurs humains et de modèles de récompense. Cette étape aligne les résultats du modèle sur les consignes de sécurité, les exigences de ton et l’intention humaine.
Types d’architectures de LLM : encodeurs, décodeurs et modèles hybrides
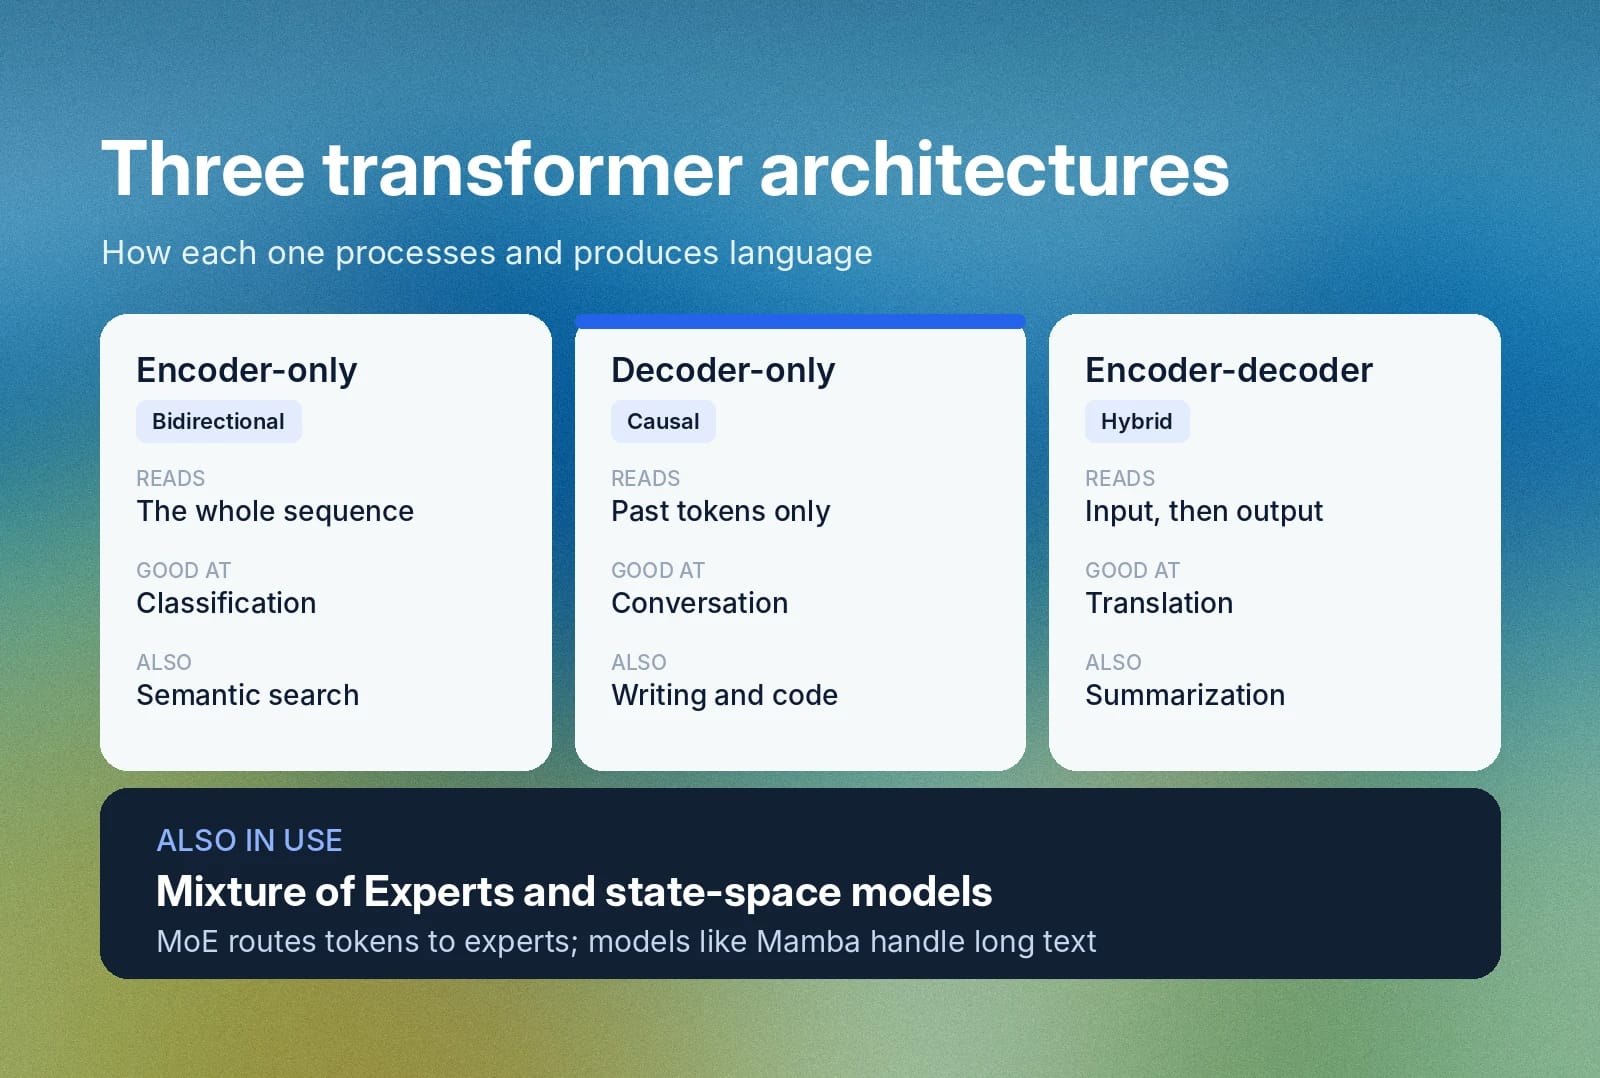
Les architectures transformer organisent les couches des réseaux neuronaux de différentes manières pour traiter les entrées et produire du contenu. Les transformers classiques se répartissent en trois grandes catégories : les modèles à encodeur seul, à décodeur seul et encodeur-décodeur, ou hybrides. Les systèmes modernes intègrent toutefois aussi des architectures d’efficacité pour faire évoluer les performances.
Modèles à encodeur seul
Les architectures à encodeur seul traitent des séquences entières en une fois grâce à l’auto-attention bidirectionnelle. Elles permettent à la machine d’évaluer la relation de chaque token avec les autres tokens passés et futurs. En pratique, elles optimisent les modèles pour des tâches telles que :
- Classification de texte
- Analyse des sentiments
- Recherche d’informations
- Recherche sémantique
Ces tâches interviennent aussi dans les workflows de traitement de la parole. Le modèle Scribe de Speech to Text d’ElevenLabs transcrit la parole dans plus de 90 langues, et sa fonctionnalité de détection d’entités signale les informations sensibles et le langage offensant dans les transcriptions.
Modèles à décodeur seul
Les architectures à décodeur seul utilisent l’attention causale pour traiter les tokens et prédire chaque mot à partir des tokens précédents. Ces modèles génèrent des conversations fluides et constituent l’architecture principale des chatbots conversationnels modernes, des assistants d’écriture ouverte et des outils de génération de code.
Dans ElevenAgents, le LLM que vous choisissez, généralement un modèle à décodeur seul, génère les réponses de l’agent, tandis qu’un modèle propriétaire de prise de tour gère le rythme de la conversation.
Modèles encodeur-décodeur, ou hybrides
Les modèles encodeur-décodeur utilisent un encodeur pour traiter les entrées et un décodeur pour générer les résultats. Cette approche à double structure rend les modèles hybrides plus adaptés aux tâches qui exigent une conservation stricte du contexte, comme la synthèse de documents, la traduction et le reformatage des données.
La traduction est une tâche classique d’encodeur-décodeur, et Dubbing d’ElevenLabs prend en charge plus de 90 langues.
Modèles Mixture of Experts (MoE) et modèles à espace d’état
Au lieu d’activer chaque paramètre du réseau neuronal pour chaque mot, Mixture of Experts (MoE) achemine les tokens individuels vers de petites équipes de sous-réseaux « experts » spécialisés. Cette approche offre une profondeur de raisonnement comparable à celle de modèles massifs, avec des vitesses plus élevées et des coûts de calcul réduits. Les modèles à espace d’état, tels que Mamba, traitent quant à eux efficacement des textes extrêmement longs.
ElevenAgents inclut des LLM open source qu’ElevenLabs héberge dans sa propre infrastructure.
Exemples de grands modèles de langage et applications quotidiennes
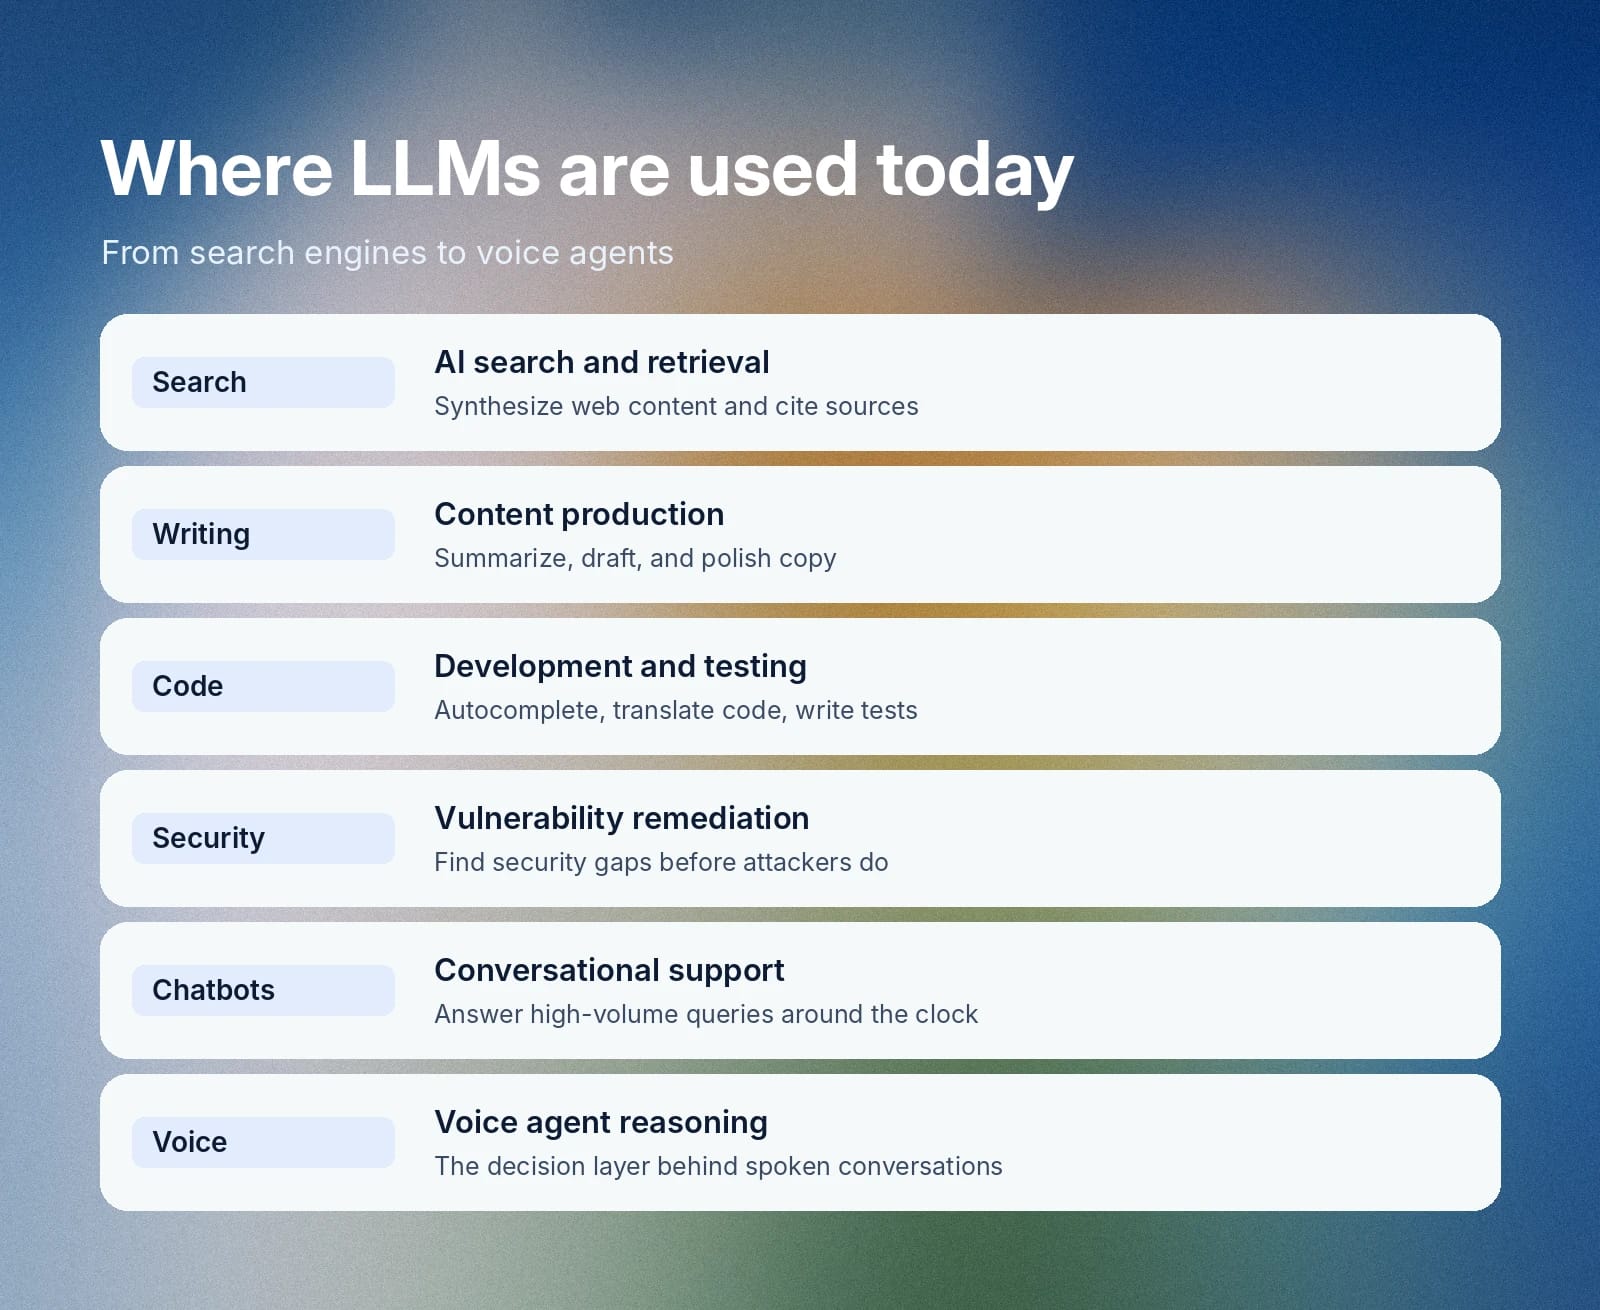
Les organisations ont trouvé un large éventail de cas d’usage pour les grands modèles de langage. Ces cas d’usage montrent comment l’IA est passée de la recherche expérimentale à une fonctionnalité standard sur le web, dans les applications logicielles et les appareils du quotidien. Alors que les chercheurs en IA continuent d’étudier et d’optimiser l’architecture sous-jacente, les exemples concrets de LLM montrent comment les équipes les ont mis en œuvre jusqu’à présent :
- Recherche par IA et recherche d’informations : Les moteurs de recherche conversationnels comme Bing, Google AI Overviews et Perplexity utilisent des LLM pour analyser le contenu web en temps réel. Les modèles synthétisent les informations, citent directement les sources et permettent aux utilisateurs de poser des questions complémentaires.
- Rédaction, édition et production de contenu : Les LLM et autres outils propulsés par l’IA facilitent la rédaction et l’édition de contenus à usage interne comme externe. Par exemple, NotebookLM synthétise de longs rapports, Jasper AI rédige des publicités et Grammarly améliore les textes.
- Génération de code, développement et tests : L’IA alimente des outils de codage tels que GitHub Copilot pour compléter automatiquement des fonctions et traduire du code d’un langage de programmation à un autre. Les équipes peuvent aussi l’utiliser pour générer des suites de tests automatisés afin d’identifier et de corriger facilement les bugs avant le déploiement.
- Cybersécurité et correction des vulnérabilités : Des entreprises d’IA de pointe ont lancé des modèles spécialisés dans la détection des failles de sécurité, aidant les organisations à déployer des correctifs avant que des attaquants puissent les découvrir et les exploiter.
- Chatbots et assistants conversationnels : Les organisations déploient des interfaces conversationnelles pour assurer une assistance client 24 h/24 et 7 j/7. L’intégration de plateformes comme ElevenAgents permet aux entreprises d’automatiser les demandes à fort volume grâce à des solutions conversationnelles plutôt que de s’appuyer sur des FAQ.
- Moteur de raisonnement des agents vocaux : Les LLM constituent aussi la couche de raisonnement centrale des systèmes d’IA vocale. ElevenAgents associe le LLM de votre choix à Speech to Text, à Text to Speech à faible latence et à un modèle propriétaire de prise de tour pour mener des conversations naturelles en temps réel.
Quelles sont les limites des grands modèles de langage ?
Colonne vertébrale de la plupart des produits d’IA avec lesquels les consommateurs interagissent, les LLM constituent une architecture puissante utile à de nombreux workflows et cas d’usage. Mais si vous souhaitez concevoir avec des LLM ou entraîner votre propre modèle, vous devez connaître leurs principales limites :
- Hallucinations : Rien ne garantit l’exactitude de ce qu’un LLM génère. Une réponse peut facilement contenir des informations fabriquées ou tout simplement erronées.
- Connaissances statiques : Sans RAG, un LLM est limité au périmètre de connaissances établi lors de son entraînement.
- Biais : Si vos données d’entraînement comportent des biais, votre modèle les reflétera. Il est particulièrement important d’en tenir compte lorsque vous utilisez un LLM pour classifier des données ou prendre des décisions à partir d’informations, car certains biais implicites présents dans vos données peuvent influencer négativement les résultats à votre insu.
- Fenêtre contextuelle limitée : Les LLM ne travaillent généralement qu’avec une quantité fixe de texte, ce qui signifie que les conversations longues peuvent commencer à perdre des détails et devenir moins efficaces au fil du temps.
- Coût et latence : Plus le LLM est grand, plus son exécution requiert de puissance de calcul. Si vous optez pour des modèles plus puissants, vous paierez probablement un supplément pour ce niveau de service amélioré.
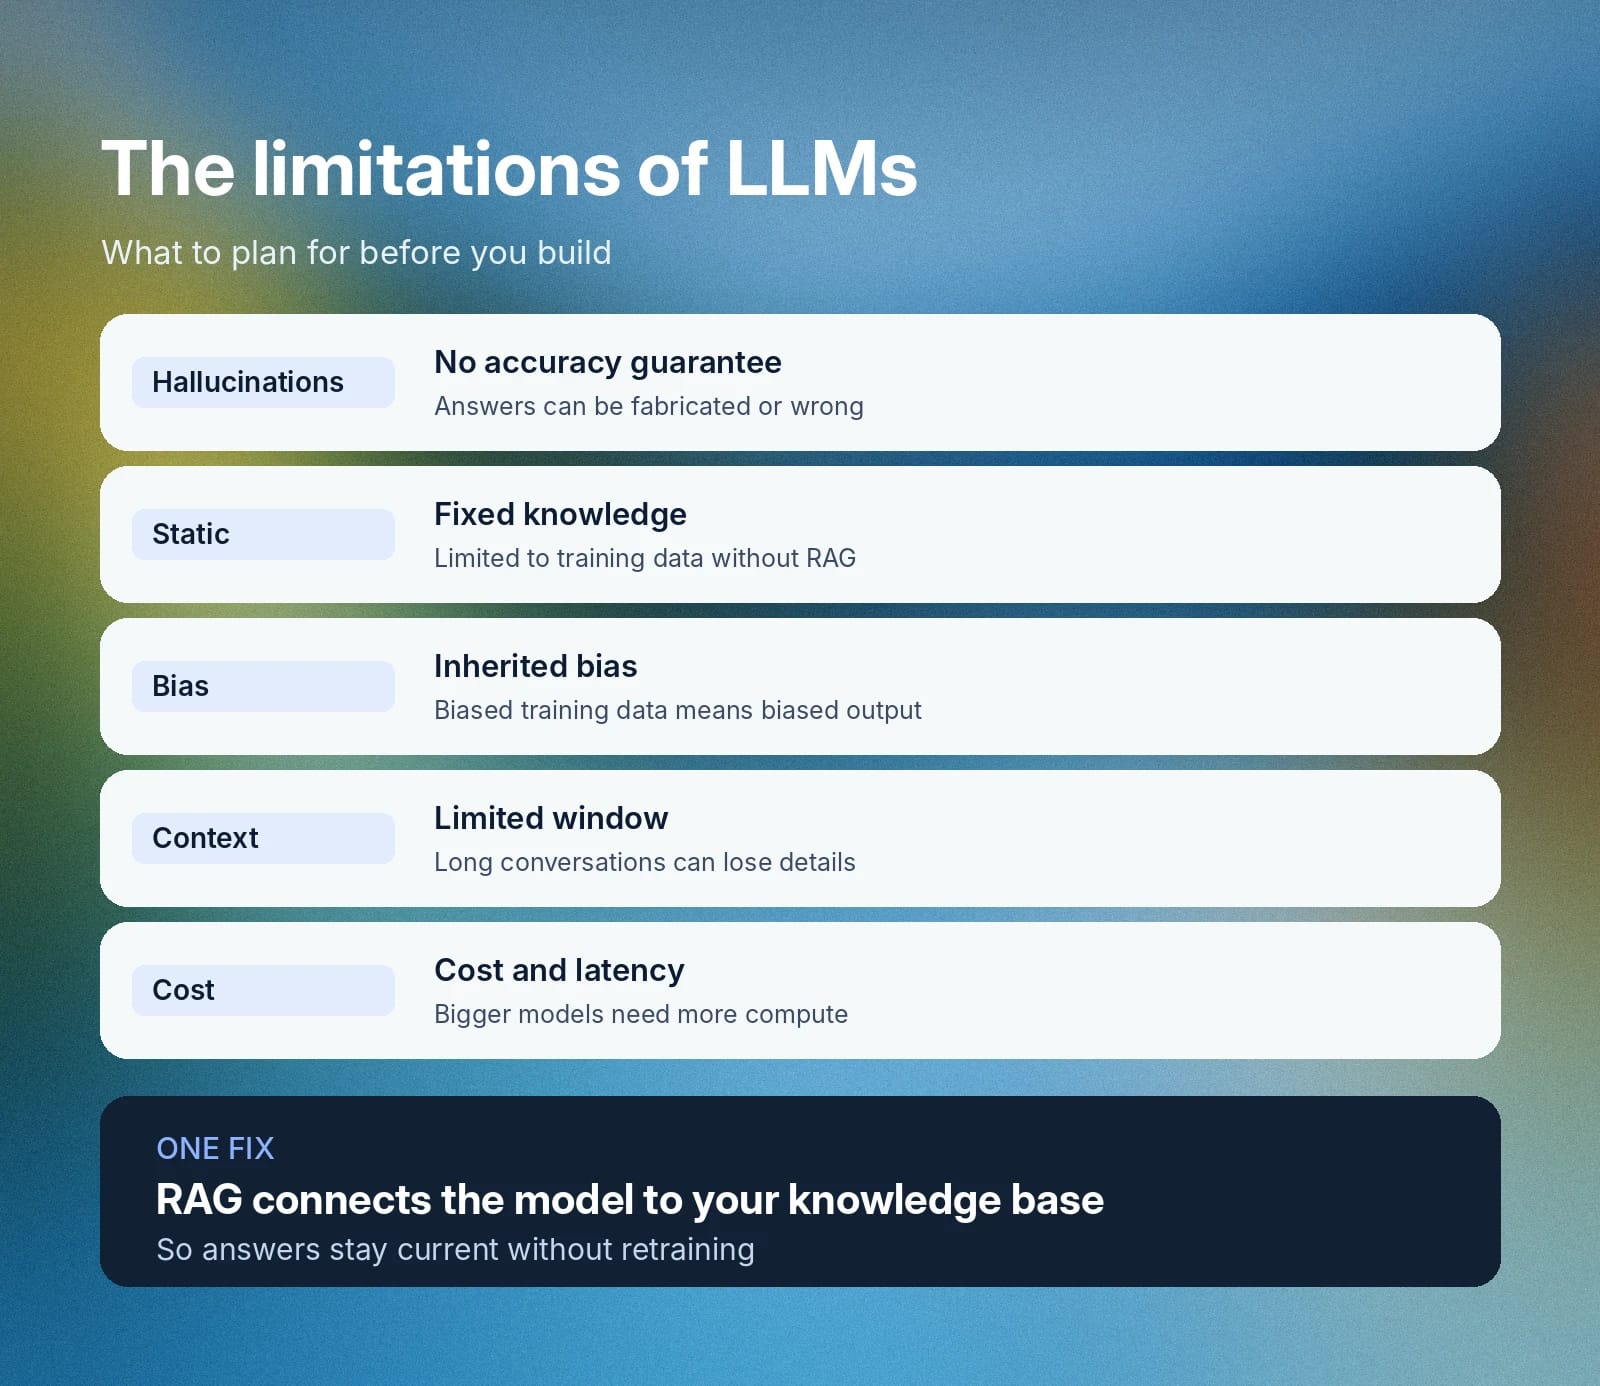
Plusieurs stratégies et mises en œuvre permettent de réduire l’impact de ces limites. Par exemple, activer le RAG dans un LLM et y associer une base de connaissances en expansion continue permettrait de résoudre le problème des connaissances statiques.
Concevez des expériences LLM vocales avec ElevenAgents
Choisir un grand modèle de langage pour votre cas d’usage est une décision critique que vous devrez peut-être ajuster à mesure que les besoins de votre entreprise, voire les exigences réglementaires, évoluent. Éviter la dépendance à un fournisseur préserve l’agilité et la flexibilité de l’entreprise lors de la conception de solutions d’IA vocale conversationnelle.
ElevenAgents vous permet de choisir parmi les LLM pris en charge de fournisseurs tels qu’OpenAI, Anthropic et Google, ou de connecter votre propre modèle personnalisé via un endpoint compatible avec OpenAI. Vous pouvez ainsi trouver facilement le juste équilibre entre vitesse, capacité de raisonnement et coût selon vos besoins spécifiques.
Découvrez ElevenAgents pour voir comment les LLM hébergés simplifient les workflows vocaux, ou nous contacter pour commencer dès aujourd’hui à concevoir vos agents vocaux à faible latence.
Questions fréquentes sur les LLM

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


