
Qu’est-ce que le RAG ? Comment fonctionne la génération augmentée par récupération
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les modèles IA génèrent des réponses à partir de ce qu’ils ont appris pendant leur entraînement. Ils ne connaissent donc pas automatiquement les politiques, les produits ou toute autre information créée par une entreprise après cet entraînement. Le RAG (Retrieval-Augmented Generation) résout ce problème en récupérant des informations externes pertinentes et en les transmettant au modèle avant qu’il ne réponde.
Le RAG ancre les réponses d’une IA dans les documents réels de l’entreprise. Un agent de support client utilisant le RAG peut consulter la politique de retour ou les caractéristiques produit en vigueur avant de répondre, ce qui réduit le risque d’hallucination.
Ce guide explique ce que signifie le RAG en IA, comment la récupération et la génération fonctionnent ensemble, et en quoi le RAG diffère d’un LLM seul. Nous aborderons également les limites du RAG, ses cas d’usage dans les applications d’IA générative et la manière dont il facilite la récupération de connaissances dans les agents IA.
En résumé
- Le RAG associe un système de récupération à un modèle génératif afin que celui-ci puisse exploiter des informations au-delà de ses données d’entraînement.
- Les connaissances récupérées par le RAG sont stockées hors du modèle. Elles peuvent donc être mises à jour sans réentraîner quoi que ce soit.
- ElevenAgents utilise automatiquement le RAG lorsqu’une base de connaissances est trop volumineuse pour tenir directement dans le contexte du modèle. Les réponses restent ainsi rapides et précises, même avec des bases de connaissances vastes et complexes.
Qu’est-ce que le RAG en IA ?
RAG est une architecture système construite autour d’un LLM pour lui fournir des informations externes, telles que des directives de marque, des manuels produit, des articles de base de connaissances ou des bases de données internes. L’IA peut ainsi exploiter des informations propres à l’entreprise, et ses réponses refléter les politiques actuelles, les connaissances privées et les détails de l’entreprise sur lesquels le modèle n’a jamais été entraîné.
Un LLM ne peut également traiter qu’une quantité limitée d’informations à la fois, appelée fenêtre de contexte. Une vaste base de connaissances organisationnelle peut rapidement dépasser cette limite. Le RAG conserve donc les informations hors du LLM et ne récupère que les passages nécessaires à la question en cours.
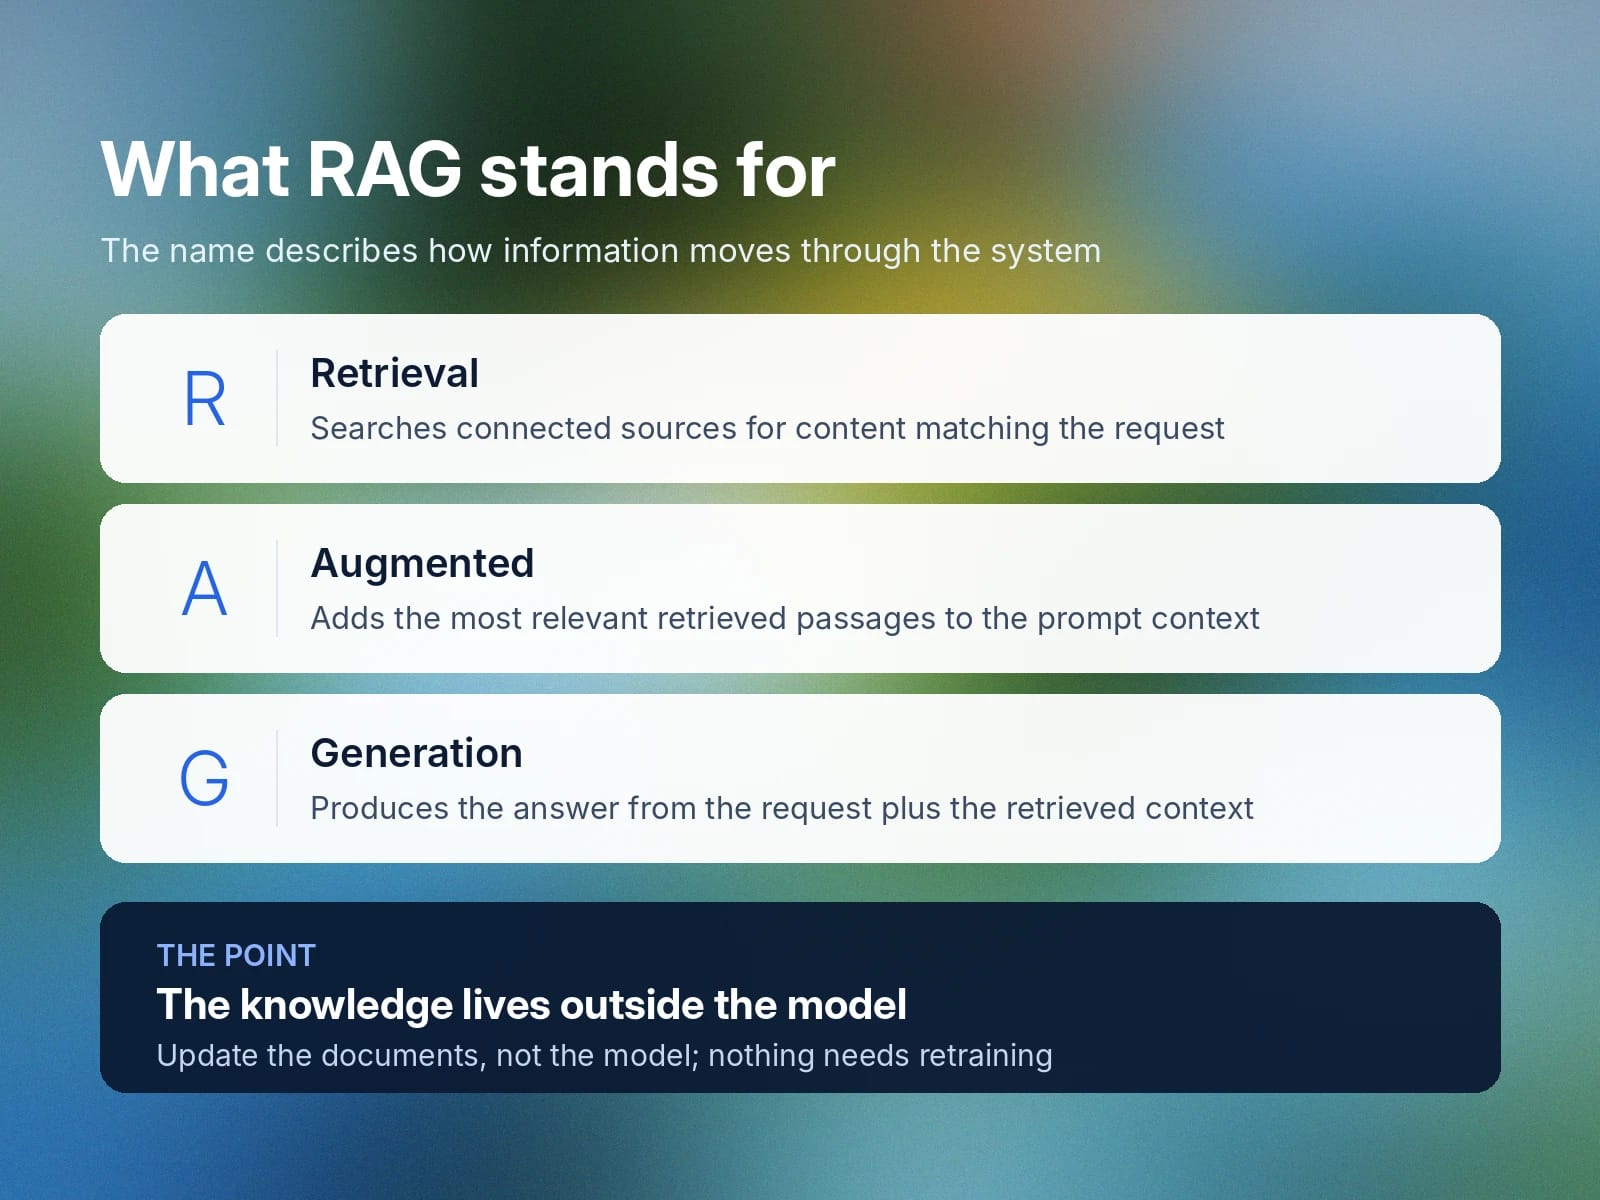
Le nom décrit la circulation de l’information dans le système :
- Récupération : recherche, dans les sources connectées telles que des documents de politique, des journaux du support ou des fichiers d’inventaire, le contenu correspondant à la demande de l’utilisateur.
- Augmentation : ajoute les passages récupérés les plus pertinents au contexte du prompt.
- Génération : utilise la demande de l’utilisateur et le contexte récupéré pour produire la réponse.
Le RAG favorise aussi l’ancrage factuel, qui consiste à relier une réponse de l’IA à des informations sources précises, en fournissant au LLM des éléments pertinents à utiliser pour générer une réponse. Par exemple, si un client pose une question sur une politique de garantie, le système RAG récupère les conditions pertinentes dans la documentation de l’entreprise et les transmet au LLM pour qu’il y réponde.
Comment fonctionne la Retrieval-Augmented Generation ?
Un système RAG prépare les connaissances externes pour la recherche, récupère les informations les plus pertinentes pour la question d’un utilisateur et les fournit au LLM comme contexte avant qu’il ne génère une réponse.
Les implémentations du RAG varient en complexité. Le RAG de base suit un processus simple de récupération et de génération, tandis que les approches plus avancées peuvent ajouter la réécriture des requêtes, le filtrage, le réordonnancement ou d’autres techniques de récupération.
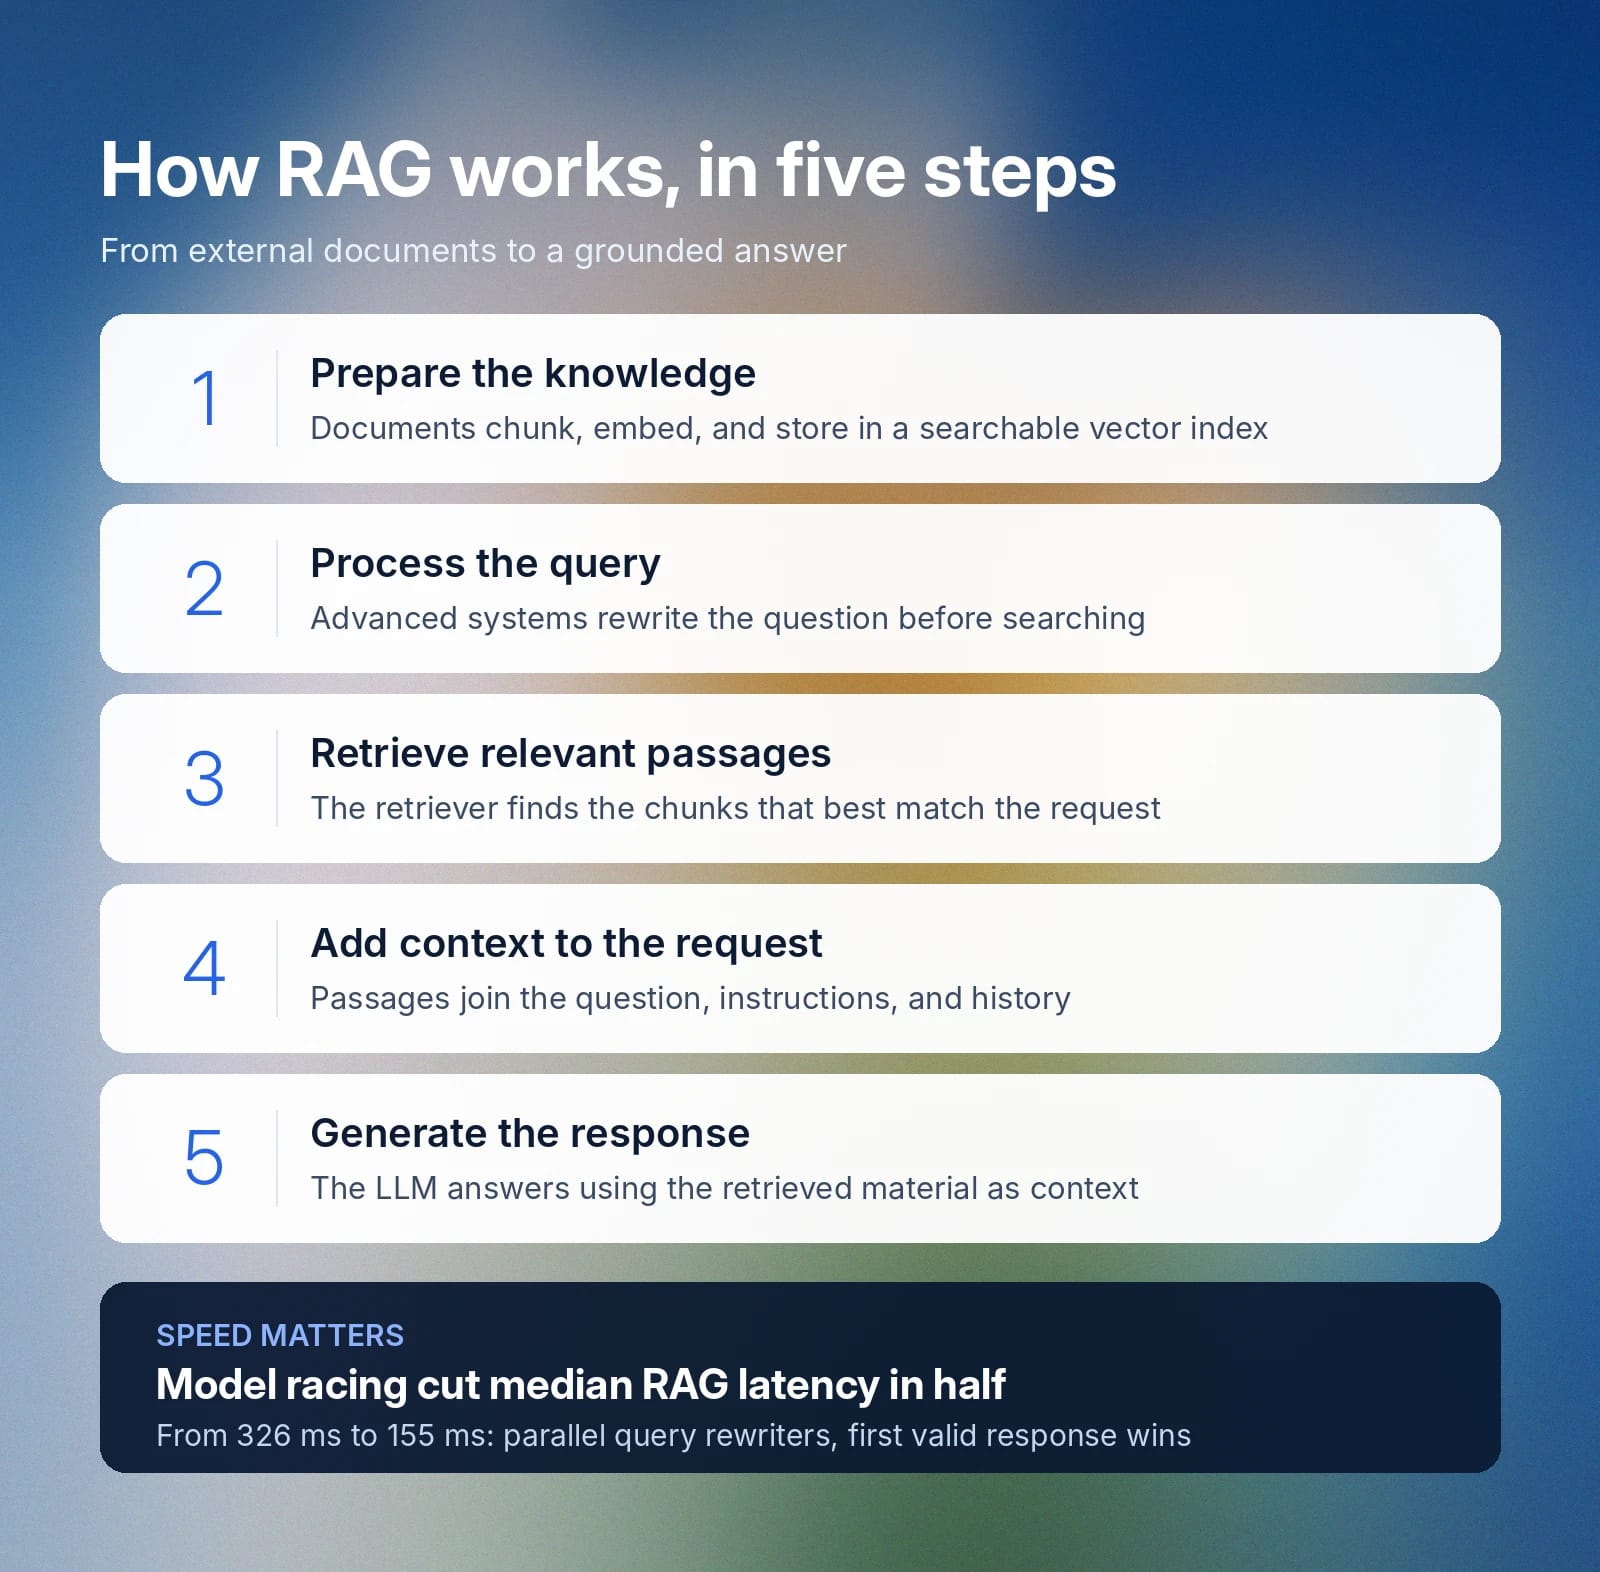
Le processus RAG suit généralement cinq étapes :
- Préparer les connaissances : les documents sont divisés en passages plus petits (un processus appelé « chunking »), convertis en représentations mathématiques appelées embeddings, puis stockés dans un index interrogeable ou une base de données vectorielle.
- Traiter la requête : le système interprète la question de l’utilisateur et, dans les systèmes RAG plus avancés, la réécrit ou l’affine avant la recherche.
- Récupérer les passages pertinents : le récupérateur recherche dans la base de connaissances indexée les segments de texte qui correspondent le mieux à la demande.
- Ajouter du contexte à la requête du modèle : les passages sélectionnés sont envoyés au LLM avec la question de l’utilisateur, les instructions pertinentes et l’historique de conversation.
- Générer la réponse : le LLM produit une réponse en utilisant les éléments récupérés dans son contexte.
De nombreux systèmes RAG déclenchent sélectivement la récupération comme outil externe. ElevenAgents permet aux équipes d’activer le RAG pour une base de connaissances directement dans les paramètres de l’agent. Le système utilise la réécriture des requêtes pour transformer les échanges antérieurs et les références vagues en une requête de recherche précise et autonome lors des suivis conversationnels.
Pour garantir des réponses rapides, ElevenLabs a également développé une architecture de mise en concurrence de modèles qui envoie chaque requête à plusieurs modèles de réécriture en parallèle et utilise la première réponse valide. Cette approche a réduit de moitié la latence médiane du RAG, la faisant passer de 326 ms à 155 ms. La récupération reste ainsi suffisamment rapide pour préserver la fluidité naturelle des conversations, même lorsqu’elle est déclenchée par une vaste base de connaissances.
Quelle est la différence entre les LLM et les modèles RAG ?
Un LLM est un modèle qui comprend et génère du langage. Le RAG est une architecture autour du LLM qui récupère des informations externes lorsque l’application en a besoin.
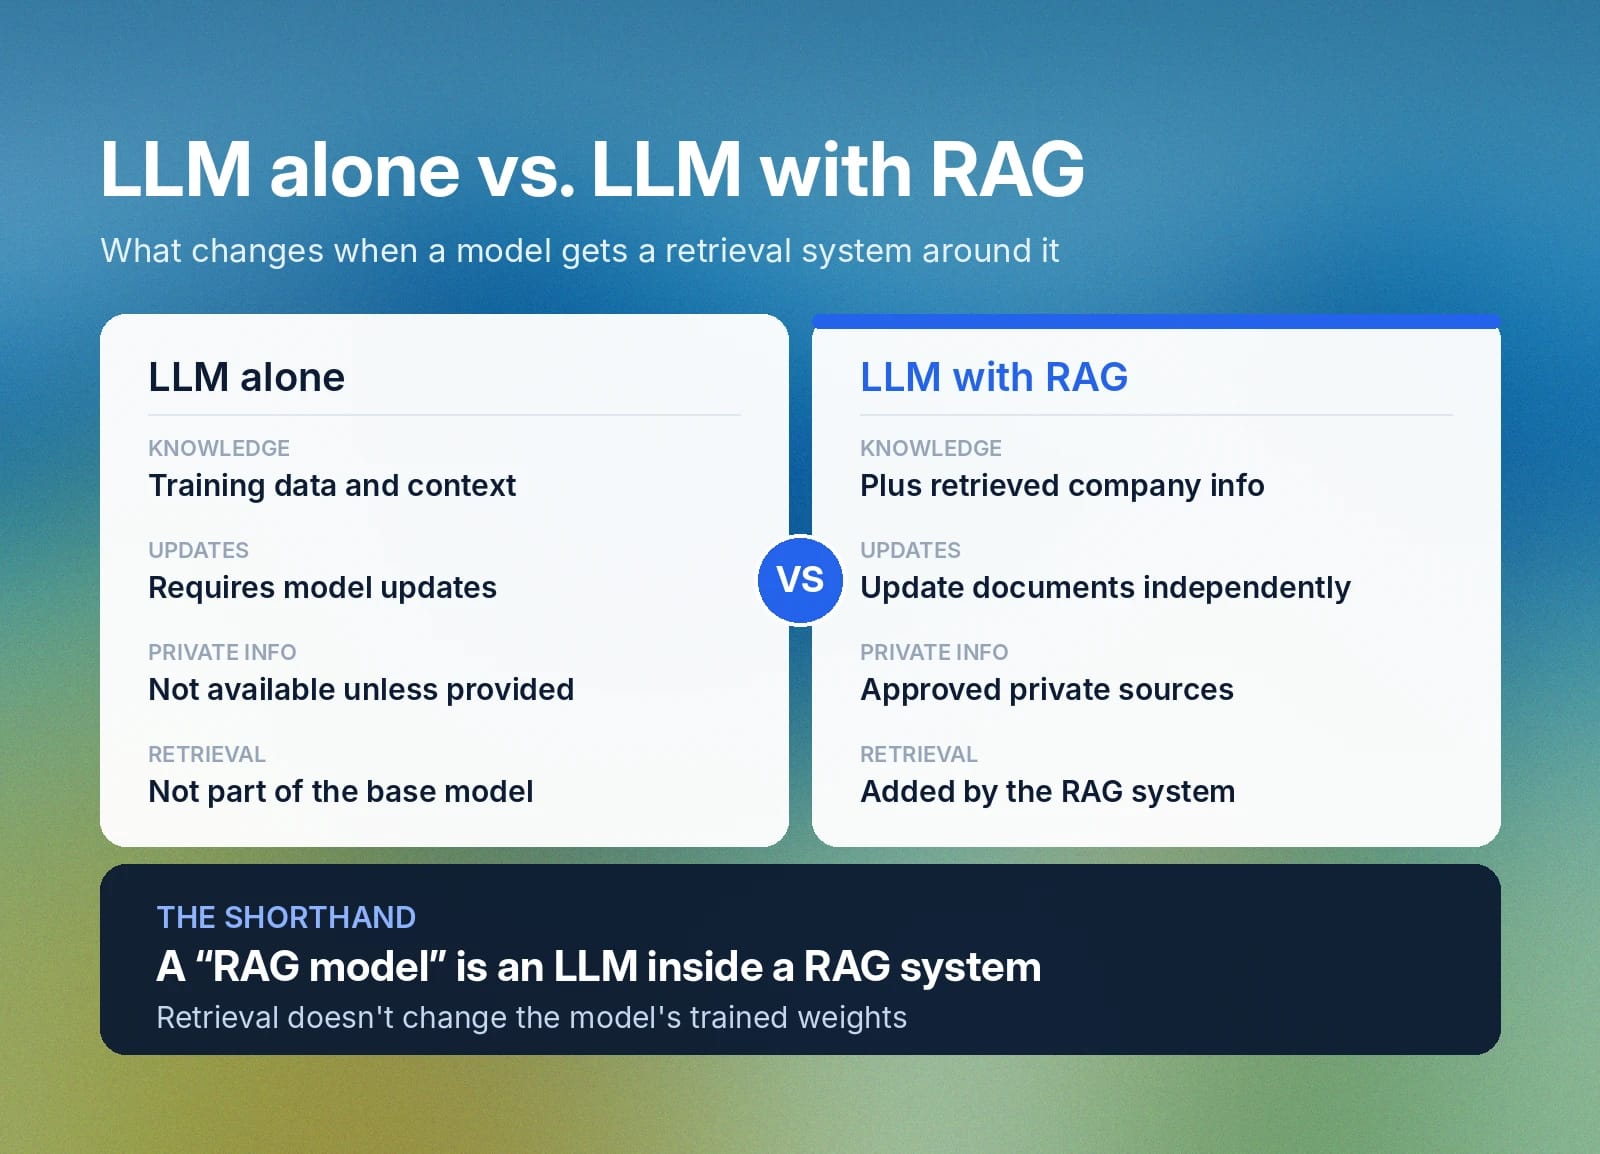
Voici ce qui change lorsqu’un LLM est associé au RAG :
Fonctionnalité | LLM seul | LLM utilisé avec le RAG |
Connaissances | Données d’entraînement et contexte actuel | Données d’entraînement, contexte actuel et informations d’entreprise récupérées, telles que des politiques, de la documentation produit ou le contenu d’une base de connaissances |
Mises à jour | Les nouvelles informations doivent être fournies dans le contexte ou via des mises à jour du modèle | Les connaissances externes peuvent être mises à jour indépendamment du modèle |
Informations privées | Indisponibles, sauf si elles sont fournies | Peut récupérer des informations depuis des sources privées approuvées |
Récupération | Ne fait pas partie du modèle de base | Ajoutée par le système RAG qui l’entoure |
L’expression « modèle RAG » est parfois utilisée comme raccourci pour désigner un LLM utilisé dans un système RAG. Par exemple, une entreprise peut dire qu’elle utilise un « modèle RAG » pour le support client alors que sa configuration repose en réalité sur un LLM qui récupère le contenu pertinent du centre d’aide ou des politiques avant de générer une réponse.
Limites des modèles RAG dans les applications réelles
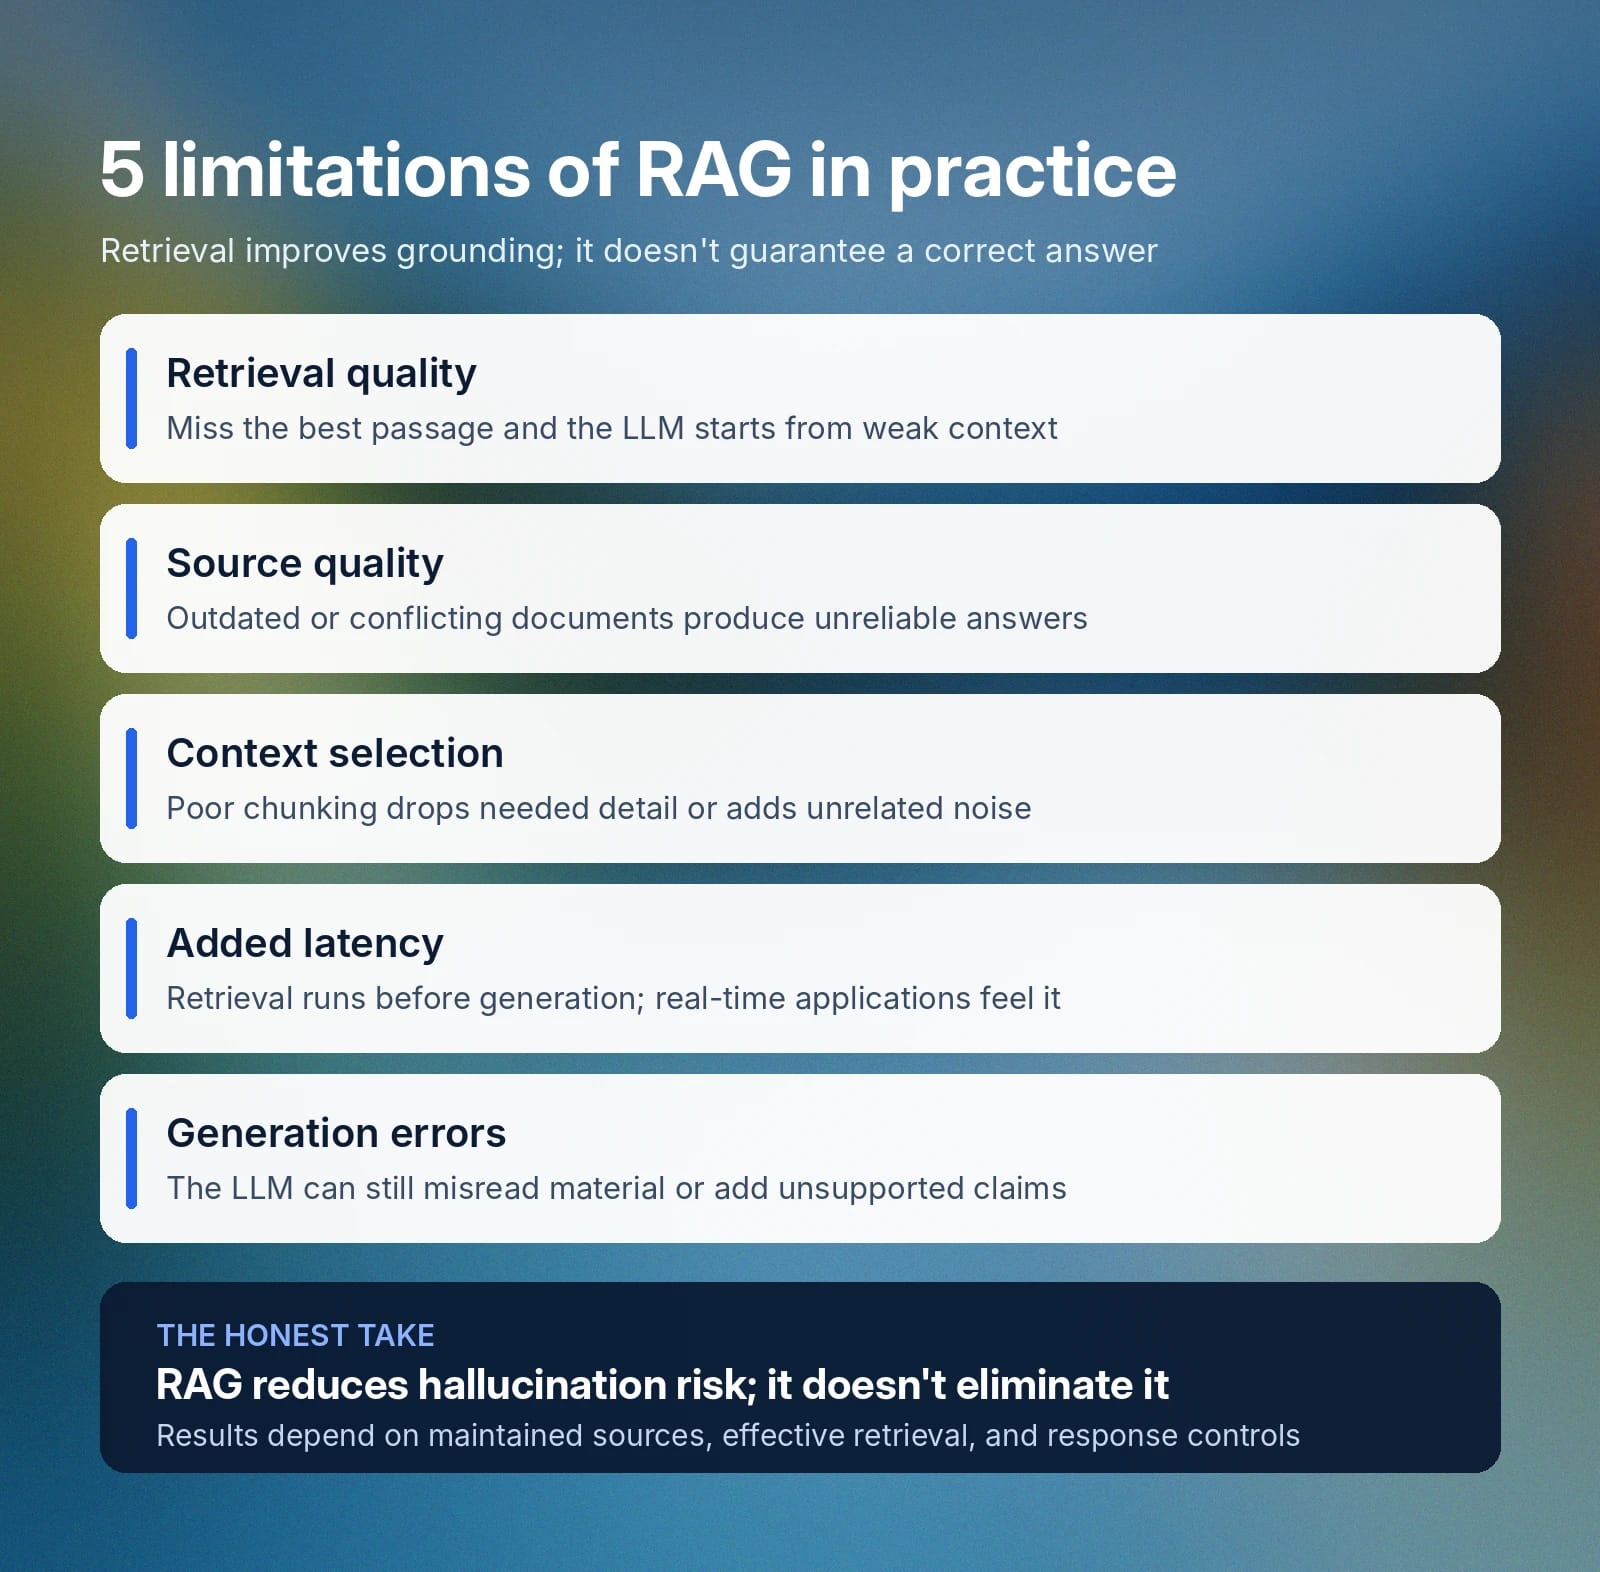
Le RAG améliore l’accès aux connaissances métier pertinentes stockées hors du LLM, mais la récupération présente ses propres limites et ne garantit pas une réponse correcte. Les principales limites concernent ce que le système récupère, ce qu’il envoie au modèle et la manière dont le modèle répond :
- Qualité de la récupération : si le système ne trouve pas le passage le plus pertinent, le LLM part d’un contexte incomplet ou insuffisant. Des requêtes mal formulées, des correspondances sémantiques faibles ou des formulations ambiguës peuvent orienter la récupération dans la mauvaise direction.
- Qualité des sources : des documents obsolètes, contradictoires ou incomplets peuvent conduire à des réponses peu fiables.
- Sélection du contexte : de mauvais choix de chunking ou de récupération peuvent supprimer des détails nécessaires ou introduire des informations sans rapport.
- Latence ajoutée : la récupération et le traitement des requêtes interviennent avant la génération, ce qui peut ralentir les réponses dans les applications en temps réel.
- Erreurs de génération : le LLM peut toujours mal interpréter les informations récupérées ou introduire des affirmations non étayées.
Le RAG peut réduire le risque d’hallucination, sans toutefois l’éliminer complètement. La précision des résultats dépend toujours de sources bien entretenues, d’une récupération efficace et de contrôles autour de la réponse finale.
Le RAG dans l’IA générative : cas d’usage et avantages concrets
Le RAG est particulièrement utile lorsqu’une application IA a besoin d’informations qui évoluent fréquemment, appartiennent à l’organisation ou sont trop volumineuses pour être incluses dans chaque requête au modèle.
Voici où le RAG fait le plus de différence :
Suivre les informations fréquemment mises à jour
Le RAG aide les équipes à aligner les réponses de l’IA sur les caractéristiques produit, les tarifs, les politiques et les stocks actuels. Les équipes peuvent mettre à jour les informations sources indépendamment, et le RAG récupère la version pertinente lorsqu’une question est posée. Par exemple, un agent de qualification de prospects peut récupérer les derniers tarifs ou détails des offres lorsqu’il qualifie un appel entrant.
Exploiter des connaissances privées ou spécialisées
Certaines connaissances sont privées ou spécialisées plutôt que publiques, comme les politiques internes, la documentation technique ou les contenus de support destinés à une équipe spécifique. Le RAG permet à un agent de récupérer directement ces sources, au lieu de s’appuyer uniquement sur ce qui est disponible publiquement ou intégré au modèle.
Par exemple, un agent interne de helpdesk informatique ou RH peut récupérer des informations dans une base de connaissances dédiée aux RH pour répondre aux questions sur les avantages sociaux des employés, plutôt que de rechercher une documentation publique qui ne contient pas ces informations.
Rechercher dans de vastes bases de connaissances
Le RAG est utile lorsqu’une entreprise possède bien plus de documentation qu’un LLM ne peut en traiter dans une seule requête. Il récupère uniquement les passages pertinents pour la question en cours, au lieu d’envoyer l’ensemble de la collection au modèle. Dans un contexte commercial, un assistant technique peut rechercher dans les manuels produit les exigences pertinentes pendant un appel.
Démarrez avec ElevenAgents pour des solutions RAG avancées
ElevenAgents permet aux équipes de créer des agents IA vocaux et conversationnels qui utilisent le RAG avec des sources de connaissances connectées, via la plateforme web no-code ou l’API pour les équipes souhaitant intégrer directement des agents à leurs propres produits.
Pour les agents équipés du RAG, les équipes peuvent ajouter des documents, des URL ou du texte à une base de connaissances et ne récupérer que les informations pertinentes pour chaque requête.
ElevenLabs a également optimisé la récupération pour les conversations en temps réel, réduisant la latence médiane du RAG de 326 ms à 155 ms dans son architecture ElevenAgents. Les équipes qui créent avec ElevenAgents bénéficient de ces capacités de récupération prêtes à l’emploi, qu’elles configurent un agent depuis le Dashboard ou développent avec l’API.
Commencer à créer avec ElevenAgents ou contacter notre équipe pour définir la configuration adaptée à votre application.


