
Qu’est-ce qu’une fenêtre de contexte ? Ce que tout utilisateur de LLM doit savoir
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Une fenêtre de contexte correspond à la quantité d’informations qu’un grand modèle de langage (LLM) peut traiter dans une seule requête. Mesurée en jetons, elle peut inclure votre prompt, l’historique de conversation, les instructions système, les documents récupérés, les résultats d’outils et la réponse générée par le modèle.
Une fenêtre de contexte plus grande permet à un modèle de traiter davantage d’informations dans une seule requête. Par exemple, un agent de programmation qui enquête sur un bug peut exploiter simultanément les fichiers sources pertinents, la documentation, les résultats de tests et les modifications récentes du code, au lieu d’analyser chaque élément séparément et de perdre du contexte utile entre les requêtes.
Une fenêtre de contexte plus grande ne constitue toutefois pas une mémoire parfaite. Les prompts plus longs exigent davantage de calculs, consomment plus de jetons et peuvent compliquer l’identification, par le modèle, des détails réellement importants. Des recherches sur les modèles à contexte long, dont l’étude Lost in the Middle et le benchmark RULER de NVIDIA, RULER benchmark ont montré à plusieurs reprises que les modèles exploitent moins les informations disponibles à mesure que le contexte grandit, en particulier lorsque les informations pertinentes sont enfouies parmi des éléments moins utiles.
Cet article explique le fonctionnement et la mesure des fenêtres de contexte, ce qui se passe lorsqu’elles sont saturées, ainsi que la manière dont les développeurs peuvent les gérer efficacement.
Résumé
- Une fenêtre de contexte est le budget total de jetons dont un LLM dispose pour une requête. Elle couvre le prompt utilisateur, l’historique de conversation, le contenu récupéré et la sortie.
- Des fenêtres de contexte plus grandes permettent de traiter des documents, des bases de code et des conversations plus longs, sans garantir que le modèle exploite correctement chacun de leurs éléments.
- Les modèles récupèrent le moins fiablement les informations situées au milieu de prompts longs, un phénomène documenté par l’étude Lost in the Middle et le benchmark RULER.
- Une gestion efficace du contexte, grâce à la récupération, la synthèse et la mise en cache, est généralement préférable à la simple maximisation du nombre de jetons envoyés.
- La meilleure stratégie de contexte est celle qui correspond à votre charge de travail réelle, et non celle qui exploite la plus grande fenêtre de contexte annoncée.
Qu’est-ce qu’une fenêtre de contexte dans un modèle IA ?
Une fenêtre de contexte est l’espace de travail actif d’un modèle, où toutes les informations pertinentes pour la requête en cours sont réunies avant que le modèle ne génère une réponse.
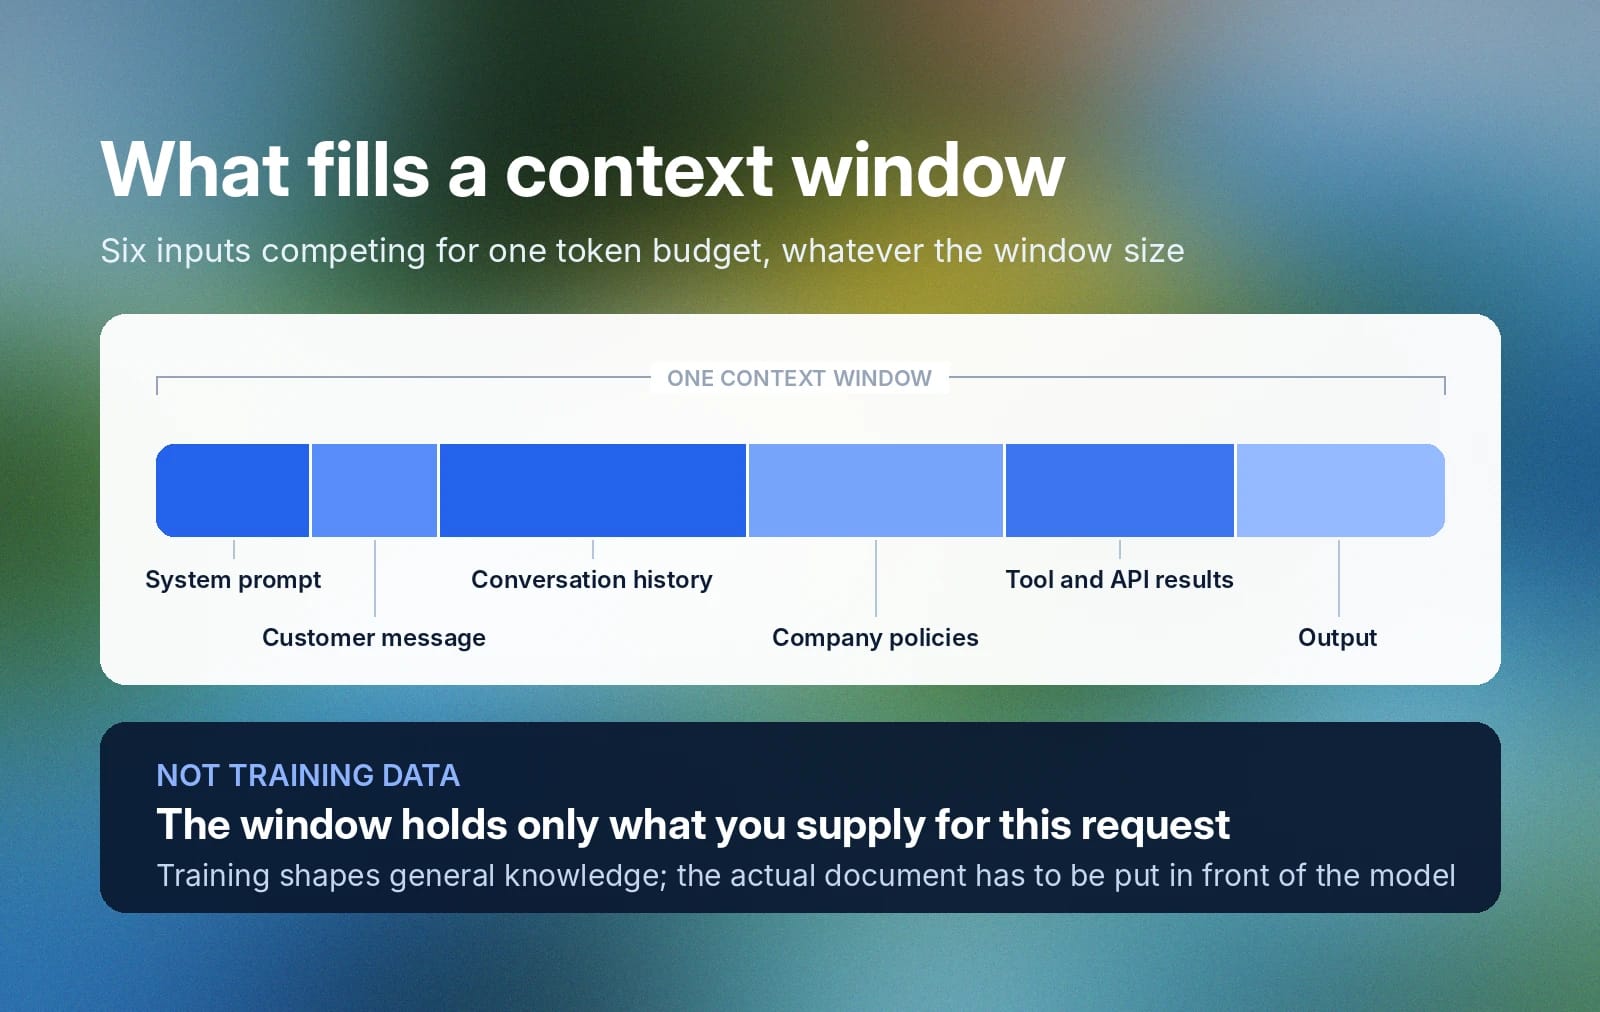
Prenons un agent IA qui synthétise une conversation de service client et recommande une solution. Pour le faire correctement, le modèle doit traiter :
- Le prompt système
- Le message du client
- L’historique de la conversation
- Les politiques de l’entreprise
- Les résultats des outils et des API
- La sortie
Tous ces éléments se disputent l’espace au sein de la même fenêtre de contexte, quelle que soit sa taille.
Les fenêtres de contexte n’incluent pas les données d’entraînement. L’entraînement inscrit durablement des informations dans les paramètres d’un modèle, façonnant ce qu’il « sait » de manière générale. Une fenêtre de contexte, en revanche, ne contient que les informations fournies pour la tâche en cours.
Cette distinction est importante en pratique : si une application a besoin qu’un modèle raisonne sur une politique précise, un dossier client ou un document technique, cette information n’est pas disponible simplement parce que le modèle a été entraîné sur des contenus similaires. Elle doit généralement être intégrée directement au contexte de travail du modèle, dans le prompt ou via un système de récupération ou d’outils ; autrement, le modèle raisonnera à partir de connaissances générales plutôt qu’à partir du document dont il dispose.
Tokenisation et fenêtres de contexte : comment les données sont traitées
Avant qu’un LLM ne traite un texte, un tokenizer le découpe en unités plus petites appelées jetons. Un jeton peut représenter un mot entier, une partie de mot, un signe de ponctuation ou un autre court segment de texte.
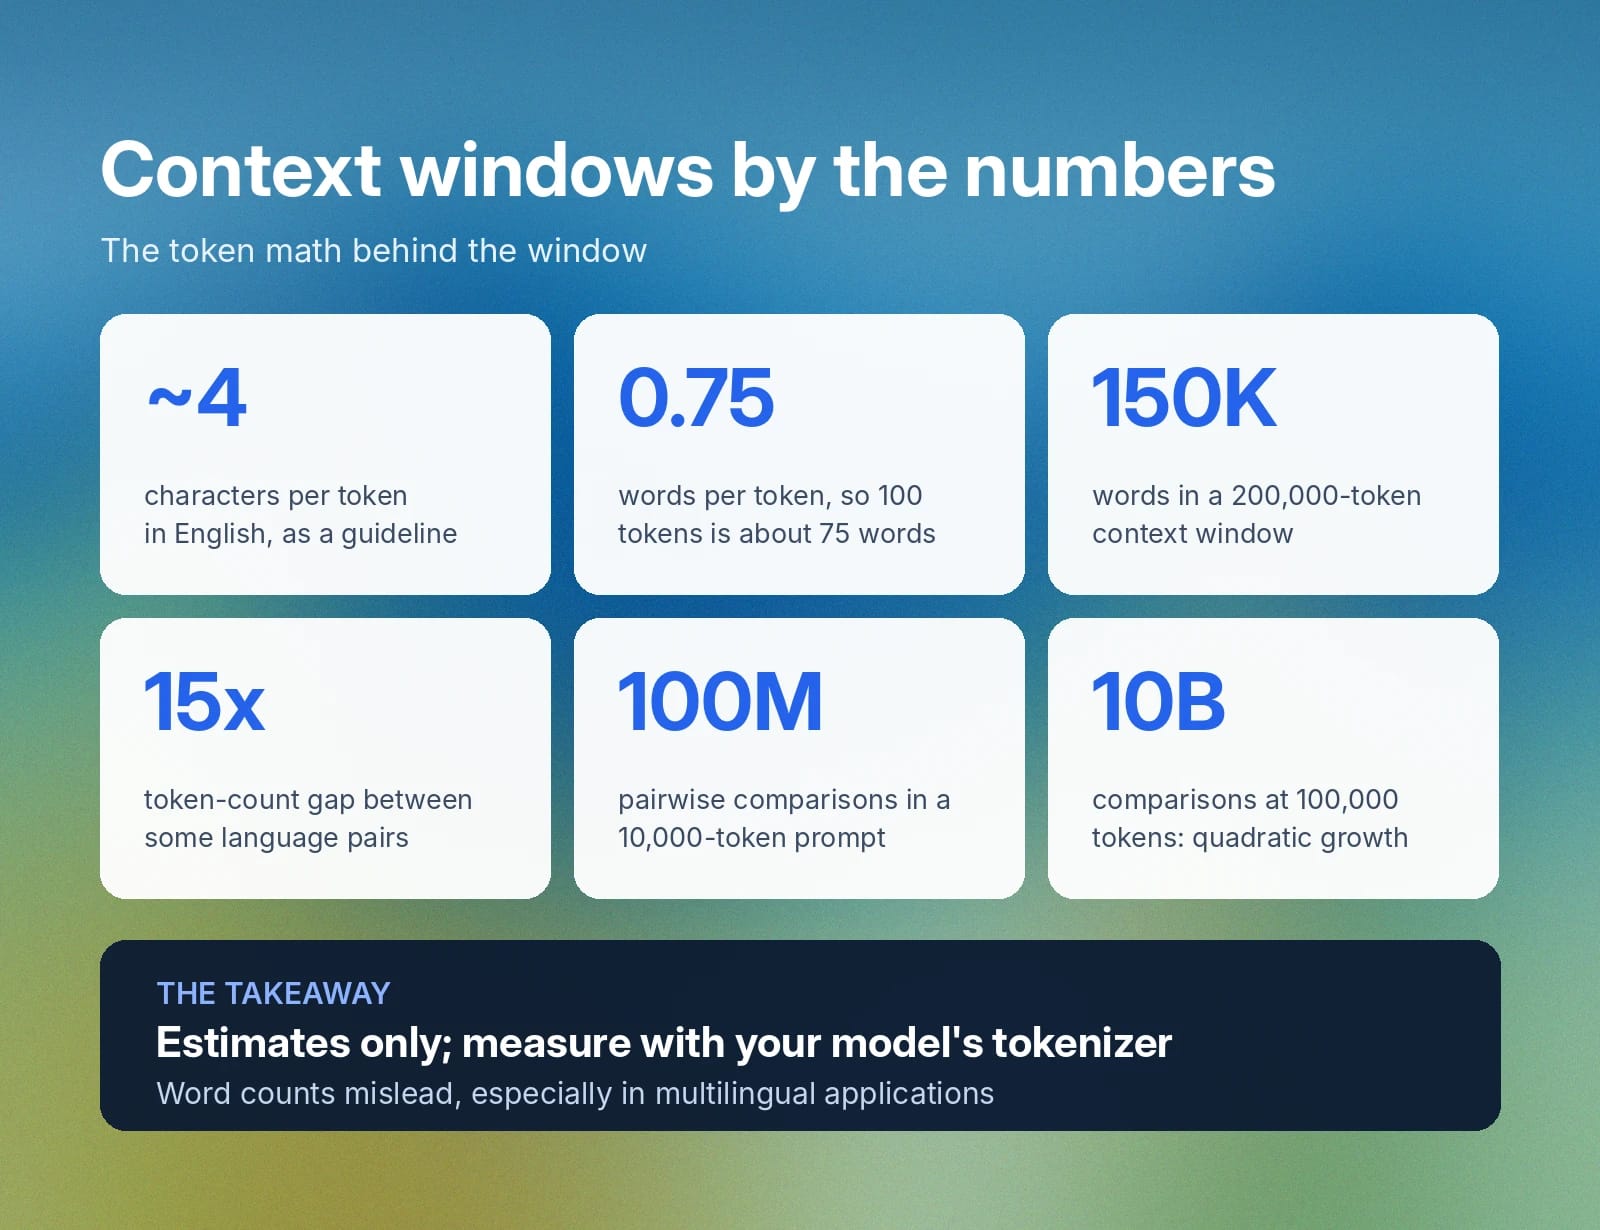
En anglais, une règle pratique consiste à considérer qu’un jeton représente environ quatre caractères, soit environ trois quarts de mot. Selon cette estimation, 100 jetons correspondent à environ 75 mots. Il ne s’agit toutefois que d’une approximation. Prenons la phrase « Les fenêtres de contexte affectent les performances des applications. » Un tokenizer ne la représente pas nécessairement sous la forme de cinq mots complets ; selon le tokenizer, un ou plusieurs mots peuvent être divisés en plusieurs sous-jetons.
La tokenisation varie également fortement d’une langue à l’autre. Deux phrases de sens et de longueur visuelle similaires peuvent consommer des nombres de jetons très différents selon la langue et le tokenizer. Les recherches sur l’équité des tokenizers ont montré que, pour des textes équivalents, certaines paires de langues peuvent présenter un écart de longueur tokenisée allant jusqu’à 15 fois, même avec des tokenizers conçus pour la prise en charge multilingue. Les développeurs qui créent des applications multilingues doivent mesurer l’utilisation des jetons avec le tokenizer réel de leur modèle plutôt que de l’estimer à partir du nombre de mots.
Une fenêtre de contexte de 200 000 jetons peut sembler immense, mais une application qui ajoute continuellement l’historique de conversation, la documentation récupérée, les réponses d’outils et les instructions système peut atteindre cette limite plus vite que prévu. C’est pourquoi les applications en production suivent souvent l’utilisation des jetons et recourent à des techniques comme la synthèse, l’élagage de l’historique, le filtrage des résultats récupérés et la compression des prompts pour conserver les informations les plus pertinentes dans le contexte actif.
Comment fonctionne une fenêtre de contexte dans les modèles de langage ?
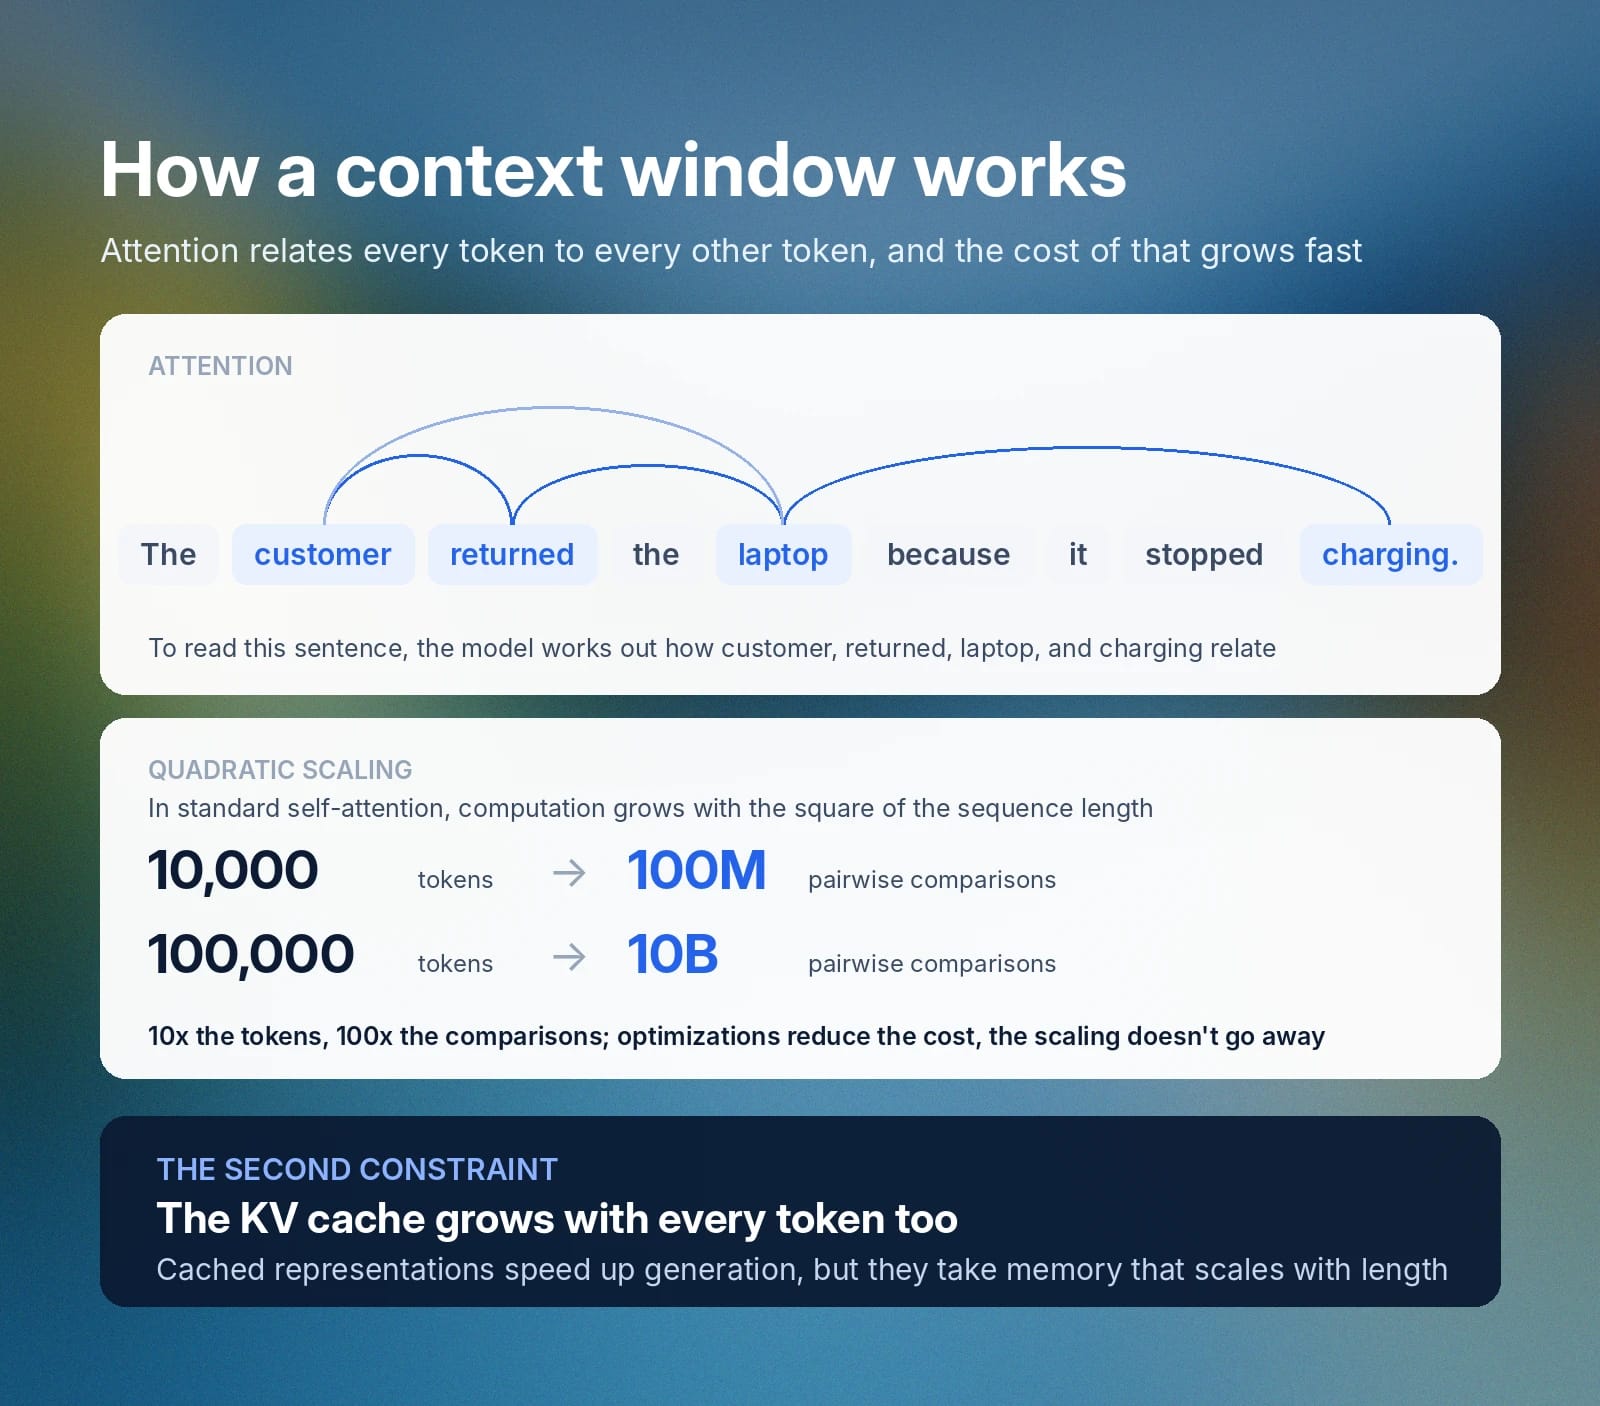
Une fenêtre de contexte repose sur le mécanisme d’attention de l’architecture Transformer, qui calcule la relation entre chaque jeton d’une entrée et tous les autres avant que le modèle ne produise une réponse.
Prenons la phrase « Le client a retourné l’ordinateur portable parce qu’il ne se rechargeait plus. » Pour l’interpréter correctement, le modèle doit déterminer comment client, ordinateur portable, retourné et rechargeait sont liés les uns aux autres. À mesure qu’une séquence s’allonge, le nombre de ces relations augmente rapidement.
Dans l’auto-attention standard, la quantité de calcul nécessaire croît approximativement avec le carré de la longueur de la séquence. Par exemple, un prompt de 10 000 jetons exige environ 100 millions de comparaisons par paires, contre environ 10 milliards pour un prompt de 100 000 jetons. Les modèles modernes utilisent diverses optimisations d’architecture et d’infrastructure pour réduire ce coût en pratique, mais le problème de mise à l’échelle sous-jacent demeure.
Les longues conversations ajoutent une deuxième contrainte : le cache clé-valeur, ou cache KV. Lors de la génération, les modèles conservent les représentations intermédiaires des jetons précédents au lieu de les recalculer pour chaque nouveau jeton, ce qui accélère considérablement l’inférence. Ce cache occupe toutefois de la mémoire et croît avec la longueur de la séquence.
Longueur maximale de contexte des modèles IA et son importance
La longueur maximale de contexte d’un modèle définit la quantité d’informations qu’il peut accepter et traiter dans une seule requête. La capacité du modèle à exploiter efficacement une grande fenêtre de contexte est toutefois une question distincte.
Des fenêtres de contexte plus longues permettent des cas d’usage difficiles ou peu pratiques avec les LLM antérieurs. Les développeurs peuvent fournir à un modèle un dépôt de code entier, un long document juridique, un article de recherche, une transcription de réunion, ou un historique de conversation conséquent sans devoir d’abord ramener le contenu à quelques milliers de jetons.
C’est important, car préserver davantage du contexte original peut améliorer la capacité du modèle à répondre précisément aux questions, à identifier les relations entre des informations éloignées et à effectuer des tâches dépendant du document dans son ensemble. Par exemple, un assistant de programmation peut devoir examiner plusieurs fichiers pour comprendre comment une fonction est appelée, tandis qu’un assistant juridique peut devoir comparer des définitions d’une section avec des obligations décrites bien plus loin dans le document.
Toutefois, une fenêtre de contexte plus grande ne produit pas automatiquement de meilleurs résultats. Des entrées très longues peuvent augmenter le coût et la latence, et les modèles peuvent accorder moins d’attention aux informations enfouies au milieu d’un vaste contexte. Les développeurs doivent donc inclure les informations pertinentes de manière sélective, organiser clairement les entrées longues et utiliser, lorsque nécessaire, des techniques telles que la récupération, la synthèse et l’élagage du contexte.
Comparaison des tailles de fenêtres de contexte par modèle
Les fenêtres de contexte varient fortement parmi les grandes familles de modèles actuelles, de quelques centaines de milliers à 10 millions de jetons. Voici comment se comparent les modèles phares actuels :
Modèle | Fenêtre de contexte | Remarques |
10 millions de jetons | Modèle de Meta à poids ouverts ; la plus grande fenêtre accessible publiquement à ce jour | |
1,05 million de jetons | Modèle phare actuel d’OpenAI pour la programmation et le raisonnement agentique | |
1 million de jetons | Modèle actuel de Google de niveau Pro pour l’analyse de documents longs et de plusieurs fichiers | |
1 million de jetons | Modèle actuel d’Anthropic de niveau Sonnet ; cette fenêtre s’applique par défaut dans l’API Claude |
Les limites annoncées évoluent rapidement à mesure que les fournisseurs lancent de nouveaux modèles et relèvent leurs plafonds. Considérez donc ce type de tableau comme un instantané plutôt que comme un classement durable. La taille du contexte n’est aussi qu’un critère parmi d’autres pour choisir un modèle. À elle seule, elle ne dit rien sur la qualité du raisonnement, les limites de sortie, la latence ou le coût.
Implications d’une petite ou d’une grande fenêtre de contexte
Une petite fenêtre de contexte oblige les développeurs à être sélectifs. Les documents longs sont découpés, l’historique de conversation ancien est synthétisé et les connaissances externes ne sont récupérées que lorsqu’elles sont réellement nécessaires.
Une grande fenêtre de contexte lève certaines de ces contraintes. Vous pouvez fournir davantage d’exemples, conserver un historique de conversation plus complet ou analyser un ensemble plus vaste de documents sans tout diviser au préalable.
Toutefois, une fenêtre plus grande introduit un autre problème : la dilution de l’attention. Lorsqu’un prompt contient une grande quantité d’informations, le modèle peut avoir du mal à identifier les détails les plus pertinents pour la requête en cours. Des instructions ou des preuves importantes peuvent être enfouies parmi du contenu moins pertinent, ce qui augmente le risque de réponses incomplètes, incohérentes ou moins précises.
Pourquoi les modèles se perdent au milieu
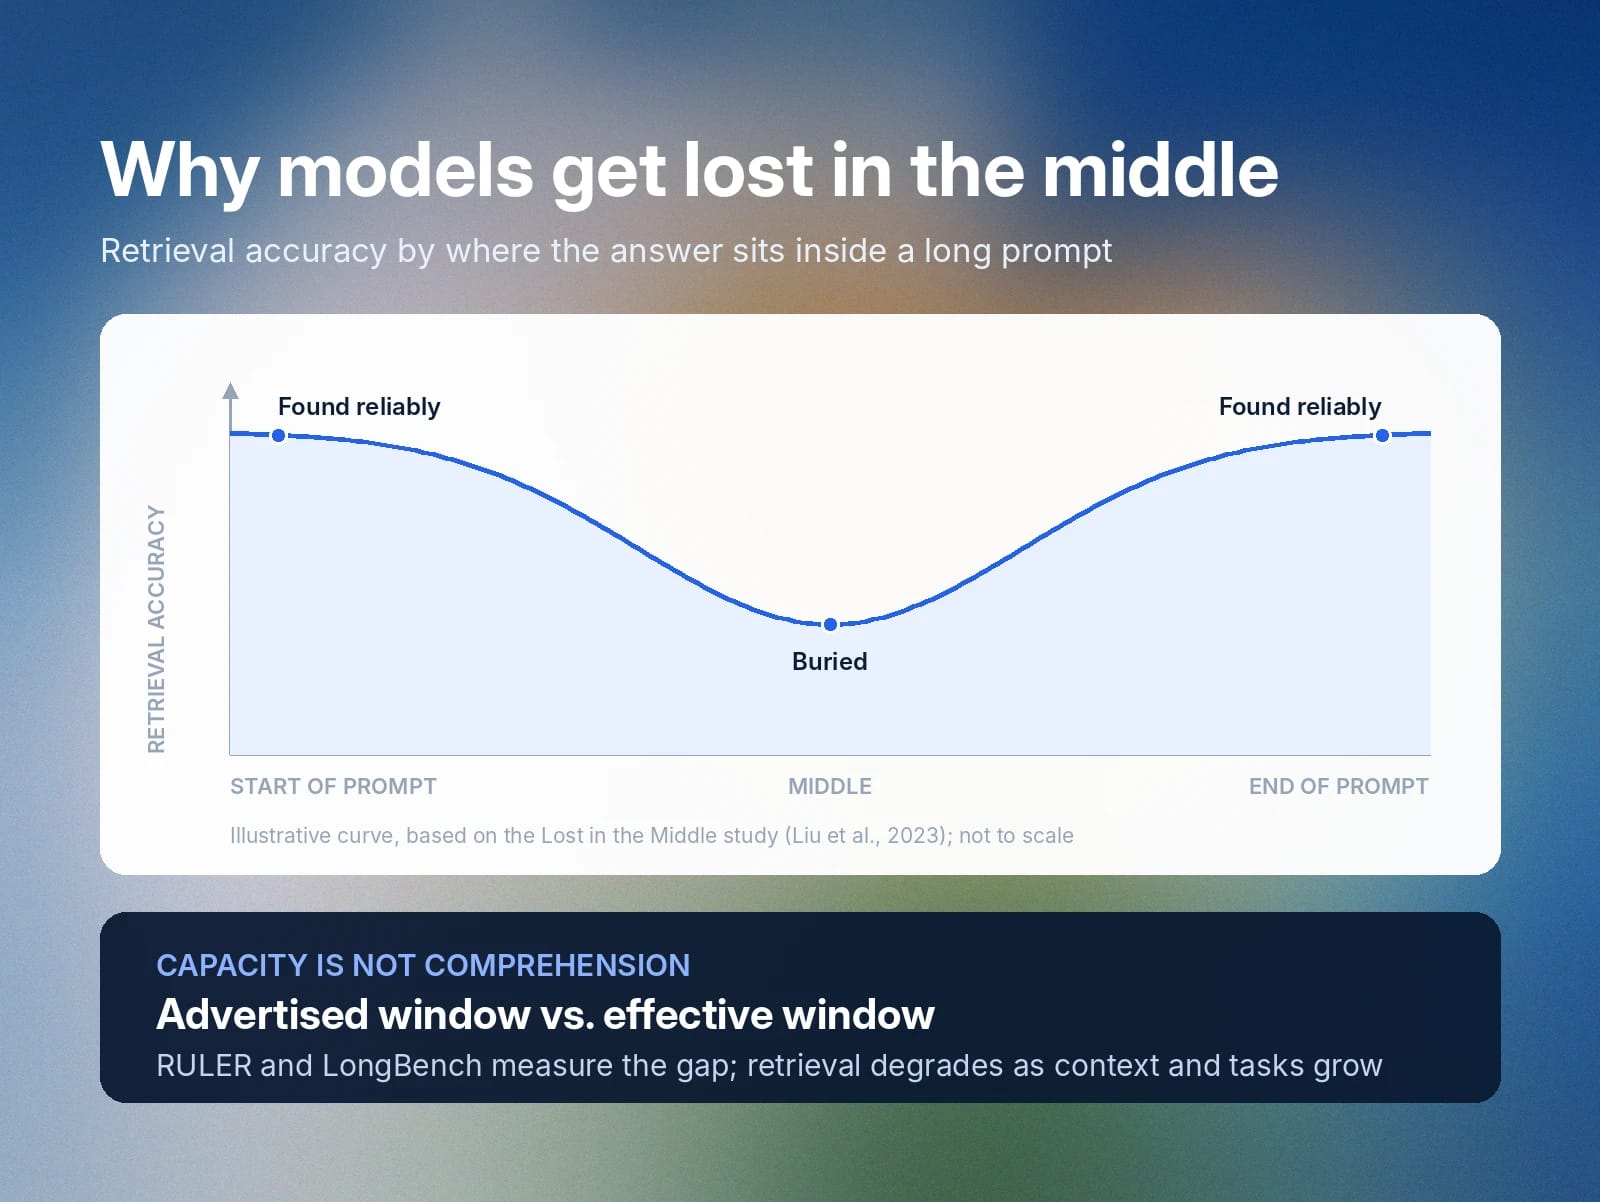
Les modèles ont tendance à mieux récupérer les informations lorsqu’elles se situent au début ou à la fin d’un prompt long, et moins bien lorsqu’elles sont enfouies au milieu. L’influente étude Lost in the Middle a directement testé ce phénomène en plaçant la réponse à une question à différentes positions d’un prompt long et en mesurant la fréquence à laquelle les modèles la trouvaient. La précision était systématiquement meilleure au début et à la fin du contexte, et plus faible au milieu.
Cela signifie qu’un modèle peut techniquement accepter un document sans en exploiter fiablement chaque partie. Envoyez à un LLM 100 documents de support parce que l’un d’eux contient la réponse à la question d’un client, et une plus grande fenêtre de contexte permettra peut-être d’y faire entrer les 100. Mais le modèle doit toujours extraire un passage pertinent parmi 99 passages non pertinents, et une fenêtre plus longue ne le garantit pas.
Il est donc utile de distinguer la fenêtre de contexte annoncée d’un modèle de sa fenêtre de contexte effective pour une charge de travail donnée. Des benchmarks comme RULER et LongBench tentent de mesurer cet écart. RULER a montré que les modèles obtenant des scores presque parfaits sur de simples tests de récupération se dégradaient tout de même à mesure que la longueur du contexte et la complexité des tâches augmentaient. LongBench évalue des tâches plus larges, dont les questions-réponses sur documents, le raisonnement multi-documents, la synthèse, l’apprentissage few-shot et la complétion de code.
Un contexte long apporte néanmoins une réelle valeur. La capacité et la compréhension sont simplement des propriétés différentes, et toutes deux comptent pour choisir un modèle adapté à une tâche donnée.
Gérer les limites de contexte : bonnes pratiques pour les développeurs
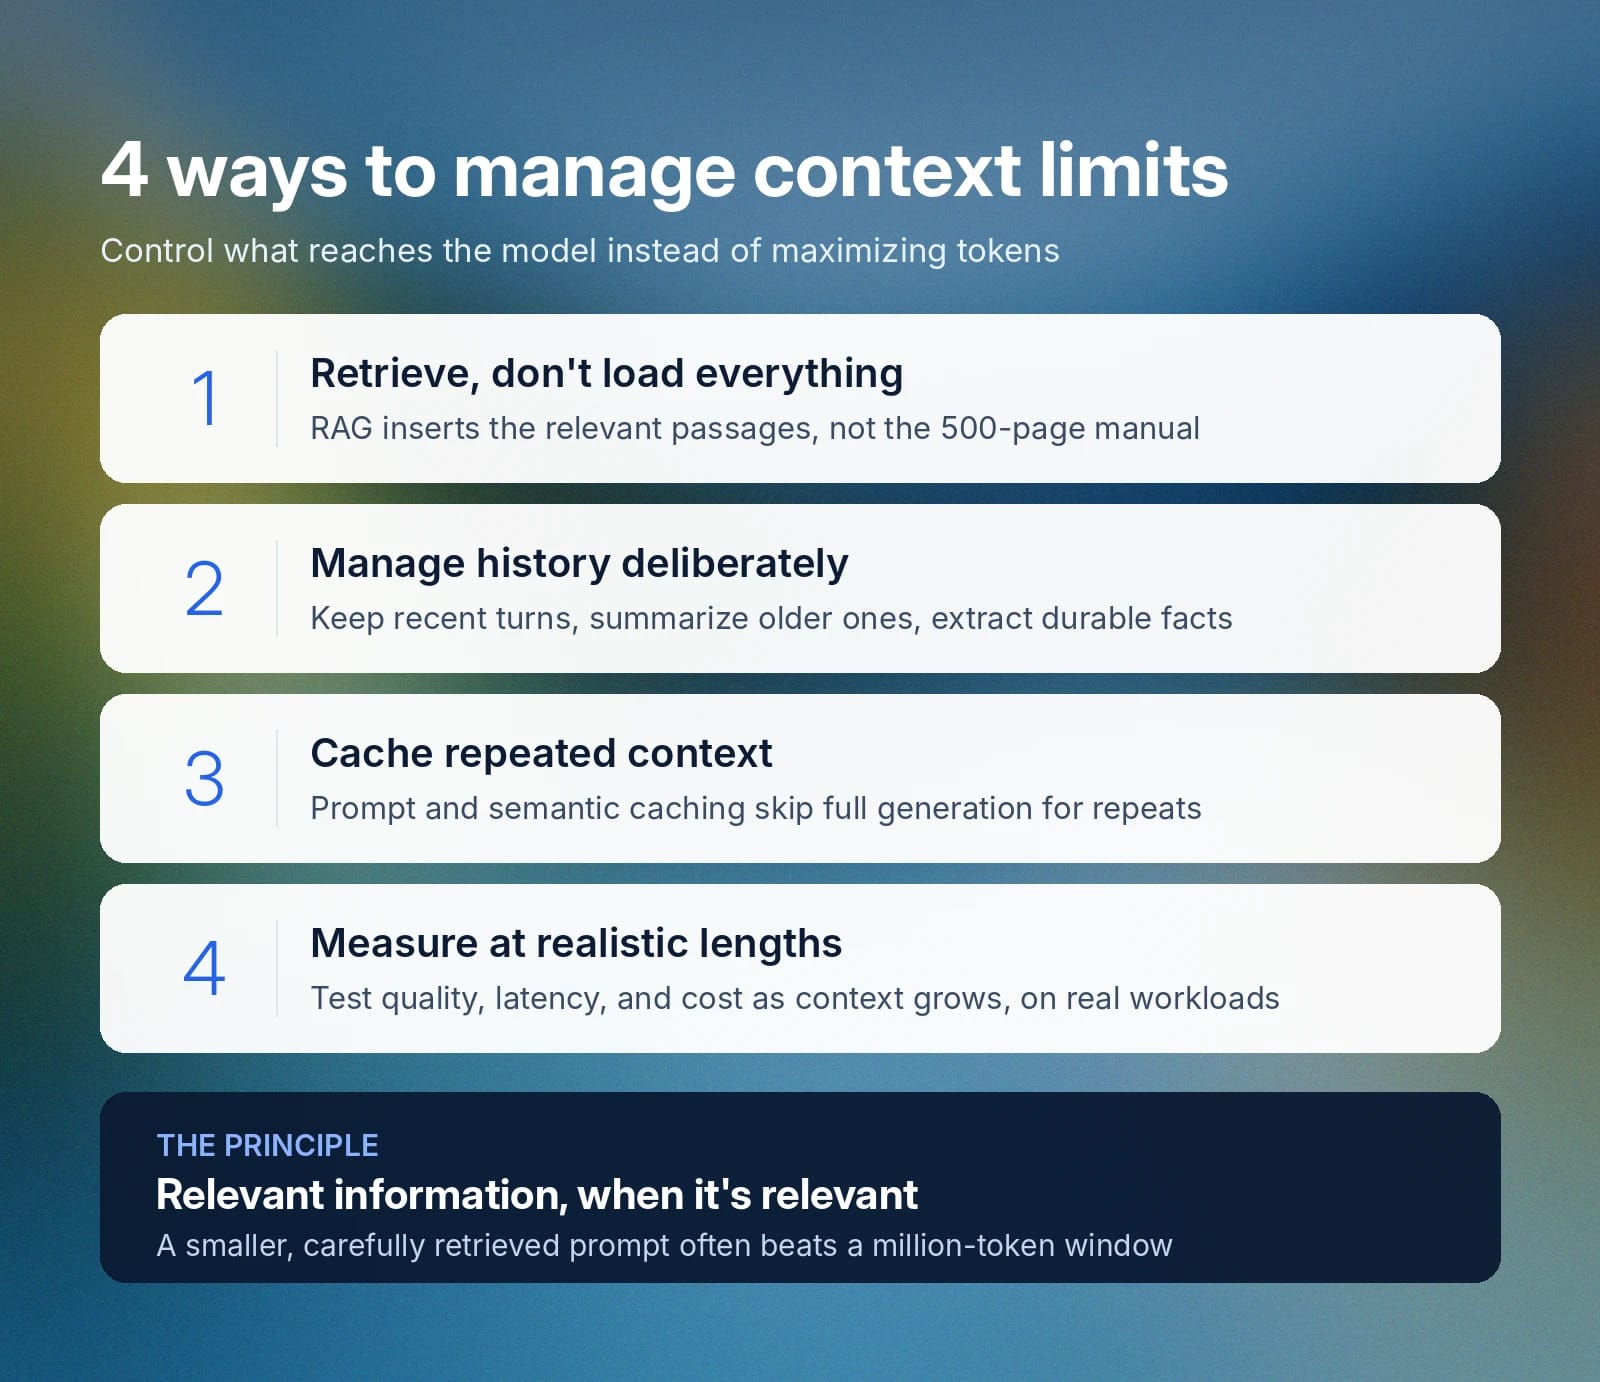
Bien gérer le contexte consiste à contrôler ce qui parvient au modèle : lui fournir les informations pertinentes pour la tâche au moment où elles le sont, plutôt que de chercher à maximiser le nombre de jetons dans chaque requête. Les pratiques suivantes peuvent aider les développeurs à réduire le contexte inutile, améliorer la qualité des réponses et maîtriser le coût et la latence.
1. Récupérer les informations pertinentes plutôt que tout charger
La génération augmentée par récupération, ou RAG, permet à une application de rechercher dans une base de connaissances externe et de n’insérer dans le contexte du modèle que les passages pertinents. Au lieu d’ajouter un manuel entier de 500 pages à chaque demande de support, l’application récupère les quelques passages les plus proches de la question réelle du client.
Cela réduit l’utilisation des jetons et donne au modèle un signal bien plus clair sur ce qui compte. La qualité de la récupération reste essentielle : les systèmes RAG en production améliorent généralement leurs résultats en découpant soigneusement les documents, en récupérant plusieurs passages candidats, en les réordonnant et en éliminant tout élément non pertinent avant de construire le prompt final. ElevenLabs, par exemple, a reconstruit son pipeline RAG afin d’ajouter la réécriture des requêtes et des appels de modèles parallèles, réduisant de moitié la latence médiane de récupération.
2. Gérer délibérément l’historique de conversation
Les applications conversationnelles accumulent rapidement du contexte. Ajouter indéfiniment chaque message précédent gaspille des jetons et peut introduire des détails non pertinents dans les tours suivants.
Les applications y répondent en conservant les tours les plus récents, en synthétisant les échanges plus anciens, en extrayant les faits durables dans une mémoire structurée et en ne récupérant les détails plus anciens que lorsqu’ils redeviennent pertinents. Cela crée une séparation utile entre le contexte conversationnel à court terme, dont le modèle a besoin immédiatement, et la mémoire applicative à plus long terme, qui peut être réintroduite ultérieurement.
3. Utiliser la mise en cache lorsque le contexte se répète
De nombreuses applications envoient à répétition les mêmes instructions volumineuses ou répondent à des questions sémantiquement similaires à celles déjà traitées. La mise en cache réduit cette charge.
La mise en cache des prompts ou du contexte permet de réutiliser plus efficacement les entrées répétées, et la mise en cache sémantique va plus loin en reconnaissant qu’une nouvelle question a sensiblement le même sens qu’une question à laquelle le système a déjà répondu. « Quelle est votre politique de retour ? » et « Combien de temps ai-je pour retourner un article ? » sont deux chaînes différentes qu’un cache sémantique peut considérer comme une même question, évitant un appel de génération complet et réduisant à la fois la latence et le coût des jetons.
4. Mesurer les performances à des longueurs de contexte réalistes
Ne choisissez pas une stratégie de contexte uniquement en fonction de la limite de jetons annoncée par un fournisseur de modèles. Testez des charges de travail représentatives de la production et mesurez la qualité des réponses, la précision de la récupération, la latence, l’utilisation des jetons, le coût et les taux d’échec à mesure que la longueur du contexte augmente.
Comparez des stratégies telles que fournir davantage de contexte, récupérer moins de passages, synthétiser l’historique de conversation ou combiner récupération et synthèse. Un modèle doté d’une fenêtre de contexte d’un million de jetons peut techniquement prendre en charge votre application, alors qu’un prompt plus court, soigneusement alimenté par récupération, produit des résultats plus rapides et plus précis à moindre coût.
Commencez avec ElevenAgents pour des solutions linguistiques évolutives
La gestion du contexte est particulièrement importante pour les agents conversationnels, qui doivent combiner l’énoncé actuel avec les tours précédents, les instructions métier, les informations client, le contenu de la base de connaissances et les résultats d’outils, tout en répondant assez vite pour que la conversation reste naturelle.
ElevenAgents réunit ces éléments sur une seule plateforme pour créer et déployer des agents vocaux IA. Son moteur d’orchestration coordonne la reconnaissance vocale, un LLM et Text to Speech, tandis que les développeurs configurent les prompts, les bases de connaissances, les outils, les workflows et le modèle de langage sous-jacent. La restitution expressive, notamment la façon dont un agent transmet le contexte émotionnel dans la parole, dépend du même contexte qui façonne ce que l’agent dit en premier lieu.
Pour la gestion des connaissances en particulier, ElevenAgents prend en charge à la fois les documents à contexte complet et le RAG, configurable directement sur la plateforme. Les petits documents sont directement intégrés au prompt d’un agent, de sorte que leur contenu reste disponible tout au long de la conversation. Les bases de connaissances plus volumineuses sont plutôt indexées, le RAG récupérant les passages pertinents pour chaque requête au lieu de tout charger simultanément dans la fenêtre de contexte.
Commencez dès aujourd’hui en vous inscrivant à ElevenAgents ou contactez notre équipe pour en savoir plus sur vos options de déploiement.
FAQ sur les fenêtres de contexte

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.

