
Cadre d’évaluation des agents vocaux : explication des 6 piliers
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les agents vocaux doivent orchestrer une symphonie d’outils quasi simultanés. C’est un exercice délicat : enregistrer les commentaires d’un client grâce à la reconnaissance vocale (STT) en temps réel, assimiler le contexte et produire une réponse avec un grand modèle de langage (LLM), puis générer un fichier audio avec un logiciel de synthèse vocale (TTS).
Avec autant de composants en mouvement, comment évaluer précisément les performances d’un agent vocal ?
Dans cet article, nous proposons un cadre d’évaluation des agents vocaux en six piliers, qui définit précisément les mesures à suivre pour évaluer la réussite d’un agent. Nous verrons aussi pourquoi ces piliers doivent être pondérés différemment selon les secteurs et quelles erreurs d’évaluation éviter.
En résumé
- Les six principaux piliers pour évaluer un agent vocal sont la qualité de la voix TTS, la qualité des conversations, l’utilisation des outils et l’exécution des tâches, l’intelligence, la conformité et la sécurité, ainsi que la fiabilité.
- Les principaux objectifs de production sont un MOS de 4,3, un TSR supérieur à 85 % et un délai avant le premier audio inférieur à 500 ms.
- Chaque secteur pondère ces piliers différemment, certains déploiements privilégiant l’un d’eux par rapport aux autres.
- Parmi les erreurs fréquentes, on évalue uniquement des audios propres et on ignore les pics de latence P99.
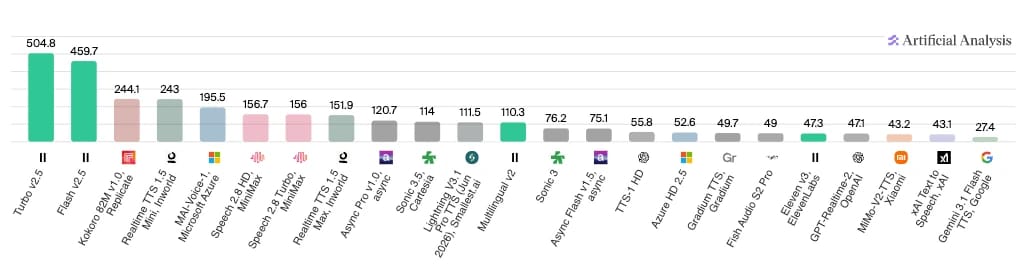
- ElevenLabs se distingue sur les métriques les plus importantes : Scribe v2 atteint le WER le plus bas du marché, à 2,2 % (Artificial Analysis, juin 2026), Flash v2.5 et Turbo v2.5 figurent parmi les modèles les plus rapides (Artificial Analysis, juin 2026), et ElevenAgents offre une latence d’inférence de modèle d’environ 75 ms.
Qu’est-ce qu’un cadre d’évaluation des agents vocaux ?
Un cadre d’évaluation des agents vocaux IA est un système structuré qui permet de tester les performances selon plusieurs dimensions. Un cadre complet comprend des métriques pour évaluer la fidélité audio, la fluidité des conversations et même la conformité réglementaire.
Contrairement à un chatbot textuel, un agent vocal fait transiter chaque interaction par au moins trois technologies superposées : la reconnaissance automatique de la parole (ASR), qui convertit les paroles d’un utilisateur en texte ; un LLM qui élabore une réponse ; et un système TTS qui reconvertit cette réponse en audio. Si l’un de ces systèmes échoue, toute l’expérience se dégrade.
Cette complexité explique précisément pourquoi les entreprises doivent évaluer les agents vocaux avant de choisir un fournisseur et de les déployer. Toute latence supplémentaire ou réponse imprécise peut avoir des conséquences réelles, comme la perte de clients ou, au pire, des amendes réglementaires et une atteinte à la réputation.
Un cadre d’évaluation des agents vocaux s’appuie sur des benchmarks et des données mesurables pour déterminer si un agent convient à certains cas d’usage. Pour une entreprise, pouvoir évaluer différents modèles vocaux permet de choisir le plus adapté à ses clients.
Les six piliers à évaluer pour les agents vocaux
Bien que créer et déployer un agent IA n’ait jamais été aussi simple, les processus actifs en coulisses restent assez complexes. Plusieurs composants agissent de concert pour écouter un utilisateur, comprendre son intention, transmettre ces informations à un LLM, puis produire une réponse audio : de nombreuses actions ont lieu presque simultanément.
Pour s’associer au meilleur agent vocal possible, les entreprises ont besoin d’un cadre rigoureux auquel se comparer.
Si vous souhaitez plutôt consulter des résultats de tests, Artificial Analysis propose plusieurs comparaisons d’agents fondées sur différents composants. Ci-dessous figurent les résultats de leur comparaison de vitesse entre modèles, où Turbo v2.5 d’ElevenLabs et Flash v2.5 dominent largement en nombre de caractères traités par seconde.
Pour les développeurs et les entreprises qui souhaitent mener leurs propres expérimentations, voici les six piliers à utiliser dans un cadre d’évaluation des agents IA :
- Qualité de la voix TTS : degré de naturel, de clarté et d’expressivité de la parole synthétisée pour les utilisateurs finaux. Les meilleurs modèles du marché, comme Eleven v4, offrent une restitution expressive et proche de l’humain dans plus de 70 langues.
- Qualité des conversations : un modèle comprend-il la parole humaine, en interprète-t-il le sens et répond-il rapidement dans le contexte au fil de plusieurs tours de dialogue ?
- Utilisation des outils : dans quelle mesure un agent IA accomplit-il des tâches à l’aide des ressources disponibles, sans intervention humaine ?
- Intelligence : capacité d’un modèle à raisonner, à gérer des entrées inédites et à éviter les réponses inexactes ou hallucinées.
- Conformité et sécurité : en plus de leurs capacités, les agents vocaux IA doivent respecter toutes les exigences réglementaires et de conformité, y compris des garde-fous actifs.
- Fiabilité : des éléments comme le temps de disponibilité total et la constance des performances sous charge permettent de déterminer si un agent d’IA conversationnelle peut évoluer avec la demande.
Bien que chacun de ces piliers soit indépendant, ils sont liés et contribuent à une expérience finale de qualité pour l’utilisateur. Par exemple, si un modèle améliorait sa qualité vocale tout en conservant une latence élevée, le client subirait des temps d’attente gênants avant d’entendre la réponse.
Examinons plus en détail chacun de ces piliers d’évaluation de l’IA vocale.
Qualité de la voix TTS
Commençons par la qualité de la voix, car c’est probablement le premier élément qu’une personne remarquera en interagissant avec un agent conversationnel IA. Si la voix paraît robotique ou étrange, l’expérience subjective avec l’agent sera nettement moins bonne.
L’une des premières métriques d’évaluation, définie par le Secteur de la normalisation des télécommunications de l’Union internationale des télécommunications (UIT-T), est le Mean Opinion Score (MOS). Le MOS fonctionne sur une échelle de 1 à 5, où 1 est inutilisable et 5 excellent. Cette mesure subjective repose sur des auditeurs humains, dont les retours sont recueillis après un appel.
Un score inférieur à 3,5 sur l’échelle MOS est peu convaincant, surtout au regard des standards actuels, et risque d’affecter la satisfaction client.
Bien que le MOS soit une métrique centrée sur l’humain, plusieurs exigences techniques contribuent à ce score :
- Cohérence de la hauteur et jitter : la hauteur et le jitter sont deux éléments linguistiques que les humains perçoivent naturellement lorsqu’ils écoutent. La « hauteur » désigne les variations d’intonation au cours de la parole, comme lorsque vous élevez naturellement la voix pour poser une question. Le jitter apparaît lorsque la compréhension de la hauteur par un modèle vocal varie, l’empêchant de maintenir une prosodie cohérente dans une phrase. La référence du secteur pour le jitter est de 30 ms.
- Expressivité émotionnelle : une voix claire et précise paraît malgré tout inappropriée si son ton ne correspond pas au registre émotionnel attendu d’une phrase. Sans indices tonals précis, les auditeurs humains ressentent moins d’affinité avec les agents conversationnels IA et les évaluent moins favorablement. ElevenAgents offre une expressivité proche de celle d’un humain afin d’associer chaque réponse à une intention émotionnelle claire.
- Bruit de fond : le bruit de fond des agents vocaux présente deux dimensions distinctes à évaluer. En sortie, un bruit ambiant est subtilement ajouté aux réponses pour rendre les agents plus naturels. En entrée, le filtrage du bruit de fond au niveau STT est une option qui améliore la précision. Lors de l’évaluation d’un agent, testez les deux : vérifiez que le bruit ambiant paraît naturel et évaluez la précision du STT avec et sans filtre de bruit.
Lors du calcul du MOS, visez un score compris entre 4,3 et 4,5, ce qui traduit de très bons résultats dans toutes ces catégories perceptives. Pour prédire le MOS à grande échelle sans panel humain, vous pouvez utiliser des outils comme UTMOS et NISQA.
Qualité des conversations
La qualité des conversations est un pilier composite, situé entre la qualité de la voix et l’exécution des tâches. Elle vise à mesurer l’efficacité avec laquelle un agent vocal comprend les besoins d’un utilisateur, l’interrompt dans le bon contexte et mène un dialogue à plusieurs tours jusqu’à son aboutissement.
La métrique principale est ici la précision de classification des intentions, généralement comprise entre 85 % et 92 %, les meilleurs acteurs dépassant 96 %. Si 85 % peut sembler élevé, cela signifie tout de même que 15 % du trafic entrant est mal catégorisé et orienté vers les mauvaises ressources.
Les éléments techniques qui contribuent à une forte précision de classification des intentions sont les suivants :
- Gestion des tours de parole : elle détermine la capacité d’un agent vocal à gérer le déroulement naturel d’une conversation. Elle évalue sa faculté à savoir quand écouter, répondre ou attendre davantage d’informations. Elle couvre également la gestion des interruptions, lorsqu’un modèle annule une réponse en cours et en génère une nouvelle à partir de la nouvelle entrée. ElevenLabs utilise un websocket multi-contexte pour gérer ces interruptions de manière fluide.
- Latence : La latence désigne le délai de bout en bout entre le moment où un utilisateur termine sa phrase et celui où l’agent commence sa réponse audio. Les agents vocaux prêts pour la production doivent viser un délai avant le premier audio inférieur à 500 ms, et inférieur à 300 ms pour de meilleures performances. Les modèles Flash d’ElevenLabs offrent un temps d’inférence de modèle d’environ 75 ms, parmi les meilleurs du secteur, ce qui vous place dans de bonnes conditions pour réussir dans cette catégorie.
- Taux de repli : le taux de repli mesure la fréquence à laquelle un agent IA ne comprend pas un utilisateur et demande une clarification ou une répétition. Il découle largement de la précision du STT : si la couche de reconnaissance vocale entend mal ou interprète mal les propos d’un client, le LLM reçoit une entrée corrompue. Le taux de repli se calcule simplement ainsi : Taux de repli (%) = (Nombre de replis / Nombre total d’interactions) * 100.
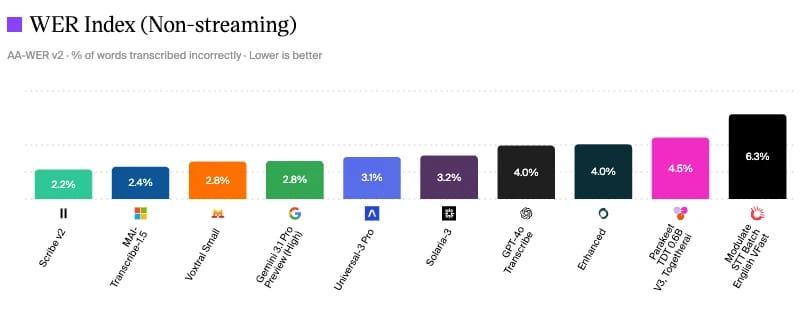
ElevenLabs Scribe V2 affiche le WER le plus bas, à 2,2 %, dans l’évaluation des modèles de reconnaissance vocale d’Artificial Analysis
Évaluation des modèles de reconnaissance vocale d’Artificial Analysis
Pour mesurer la qualité des conversations, vous pouvez examiner les benchmarks du secteur pour différents composants. Comme vous pouvez le constater, Scribe v2 d’ElevenLabs affiche le taux d’erreur sur les mots le plus faible, à 2,2 % en juin 2026, ce qui signifie moins de mauvaises interprétations, moins de replis et une classification des intentions plus précise.
Les entreprises peuvent constater que la qualité conversationnelle dépend également du workflow dans lequel opère l’agent vocal. Dans le service client, par exemple, il faut aussi prendre en compte la qualité du transfert lors d’une escalade ou la résolution des FAQ.
Utilisation des outils et exécution des tâches
Alors que la qualité mesure le ressenti d’une conversation, l’exécution des tâches détermine si elle a abouti. Les entreprises doivent prêter une attention particulière à cette partie du cadre d’évaluation des agents vocaux, car elle est directement liée aux résultats opérationnels.
La précision du remplissage des champs est une mesure de l’utilisation des outils. Elle détermine la capacité des agents IA à accomplir des tâches relativement courantes, comme remplir un formulaire avec les informations d’un client. Une forte précision démontre que l’agent peut passer sans rupture de la conversation à l’action, sans perdre d’informations en cours de route.
Le taux de réussite des tâches (TSR) est une mesure en pourcentage des tâches de bout en bout qu’un agent a réalisées avec succès. La réussite dépend de la capacité de l’agent à comprendre une demande, puis à utiliser les bons outils connectés (API, bases de données, génération augmentée par récupération (RAG) et bases de connaissances internes) pour obtenir de l’aide.
La formule du TSR est :
TSR = (Tâches entièrement réalisées / Nombre total de tâches tentées) x 100
Les agents vocaux prêts pour la production doivent viser un TSR supérieur à 85 %, tout en surveillant la précision et la fiabilité des appels d’outils. Pour éviter toute baisse de votre TSR, effectuez des tests de régression après toute modification des prompts ou des modèles connectés. Même un faible écart peut avoir des conséquences importantes sur votre TSR.
Intelligence
L’intelligence couvre les capacités de raisonnement et de niveau supérieur d’un agent vocal. C’est ce pilier qui distingue clairement un SVI vocal (serveur vocal interactif) d’un agent vocal IA.
Les principales dimensions à évaluer sont les suivantes :
- Risque d’hallucination : les hallucinations, lorsqu’un agent produit des informations inexactes ou incompatibles avec les documents de l’entreprise, sont particulièrement préjudiciables en IA vocale, car elles peuvent être énoncées avec assurance. Des études récentes suggèrent que les hallucinations fréquentes nuisent considérablement à la satisfaction des clients envers les agents vocaux.
- Gestion des demandes hors périmètre : les agents intelligents savent lorsqu’une question dépasse leur domaine contextuel et peuvent répondre de manière appropriée. Au lieu d’halluciner une réponse, ils déclinent la demande ou redirigent la conversation vers un périmètre défini par le contexte.
- Conservation du contexte : sur plusieurs tours, un agent peut-il suivre les entités et les engagements formulés précédemment ? Sans cette capacité, les clients risquent de devoir se répéter ou de recevoir des réponses contradictoires.
- Raisonnement et logique en plusieurs étapes : l’agent peut-il gérer correctement une logique conditionnelle ou enchaîner des inférences sur plusieurs tours ? Dans les cas d’usage plus techniques, comme les services financiers, la capacité à raisonner dans un contexte prédéfini est essentielle à la réussite.
Plusieurs benchmarks tiers existent pour ces dimensions et composants. Par exemple, le benchmark Holistic Evaluation of Language Models (HELM) de Stanford évalue les performances des LLM dans différentes catégories. Pour les hallucinations, TruthfulQA fournit une analyse robuste de la fréquence à laquelle des réponses fausses s’immiscent dans les résultats.
L’un des avantages d’ElevenAgents est que, contrairement à certaines plateformes vocales qui vous enferment dans un seul modèle sous-jacent, vous pouvez remplacer entièrement la couche LLM. En pratique, vous pouvez intégrer le modèle qui domine les benchmarks de raisonnement pour votre cas d’usage précis.
Conformité et sécurité
Les entreprises doivent mettre en œuvre des garde-fous actifs pour prévenir les sorties nuisibles ou contraires aux politiques. Contrairement aux instructions de prompt au niveau système, qui peuvent être contournées ou remplacées, des contrôles de garde-fous indépendants s’exécutent dans une couche distincte, hors du modèle lui-même. Ils évaluent les sorties avant qu’elles n’atteignent l’utilisateur et interrompent la conversation si elle dérive vers un terrain dangereux.
L’auditabilité est une exigence connexe : les agents en production doivent conserver des journaux détaillés des décisions et des sorties dans un format permettant une revue a posteriori. Dans les secteurs fortement réglementés en particulier, démontrer la conformité après coup est aussi important que l’assurer dès le départ.
Les réglementations auxquelles votre entreprise doit se conformer varient selon le secteur. Parmi les cadres les plus couramment applicables :
- HIPAA : pour les données de santé protégées dans le contexte des soins de santé aux États-Unis.
- PCI-DSS : pour tout agent traitant des données de cartes de paiement.
- RGPD : obligations de protection des données pour l’UE et les entreprises ayant des clients dans l’UE.
Pour les entreprises qui évaluent leur niveau de conformité, ElevenLabs respecte les normes AICPA SOC Type II et le RGPD, et a obtenu la certification AIUC-1. La norme AIUC-1 est conçue spécifiquement pour la sécurité des agents IA.
Fiabilité
La fiabilité est le dernier pilier de notre cadre d’évaluation des agents vocaux. Elle couvre la capacité d’un agent à fournir un service constant en temps réel.
Lors de l’évaluation d’un agent vocal, recherchez les caractéristiques suivantes :
- Disponibilité : tout déploiement destiné aux clients exige une disponibilité de 99,9 % pour éviter les interruptions. Pour les cas d’usage toujours actifs, comme l’assistance entrante, une disponibilité fiable est un facteur majeur.
- Dégradation maîtrisée : en raison de la complexité inhérente aux agents vocaux, si un composant commence à échouer, l’agent doit gérer cette dégradation de manière maîtrisée. En pratique, cela implique de transférer vers un humain plutôt que de continuer à fonctionner sous une charge accrue ou en renvoyant des erreurs.
- Performances sous charge : les tests de charge doivent simuler au moins deux fois le volume maximal de requêtes simultanées prévu avant le lancement. Les tests sous forte contrainte permettent d’identifier les hausses de latence ou les baisses de performances qui n’apparaissent qu’à grande échelle.
Même un modèle de grande qualité qui remplit tous les autres critères peut être inutilisable s’il ne s’adapte pas à la demande de vos clients. ElevenAgents est plébiscité par 1 000 000 de créateurs et d’entreprises de premier plan, démontrant la capacité de la plateforme à assurer des déploiements à l’échelle de l’entreprise sans compromettre les performances.
Comment mesurer le MOS des agents vocaux, étape par étape
Si votre entreprise souhaite mesurer le MOS manuellement, vous aurez besoin d’un vaste panel d’auditeurs humains et d’une sélection d’extraits audio issus de conversations réelles. Il s’agit d’un processus structuré qui consiste à recueillir des retours, calculer des moyennes, puis interpréter les données.
Voici comment mesurer concrètement le MOS des agents vocaux :
- Préparez votre jeu de test : sélectionnez un échantillon représentatif des sorties audio de votre agent, couvrant au moins 100 extraits issus de diverses conversations.
- Organisez la session d’évaluation : demandez à vos auditeurs humains de noter chaque extrait sur une échelle de 1 à 5, selon la qualité de l’expérience de communication.
- Regroupez les évaluations et calculez les scores : calculez la moyenne des notes pour chaque extrait, puis la moyenne sur l’ensemble des extraits de l’échantillon pour obtenir un MOS global. Un MOS de 4,3 ou plus indique que votre agent vocal est prêt pour la production.
Bien qu’intensif sur le plan manuel, ce processus vous donnera un MOS solide pour l’agent vocal choisi. Si vous souhaitez effectuer le test à grande échelle, vous pouvez remplacer les auditeurs humains par des outils automatisés comme NISQA, qui prédisent les scores MOS par programmation. Vous pouvez intégrer ces systèmes à vos pipelines actifs afin de suivre continuellement le MOS au fil du temps.
Benchmarks de test IA et humains : FCR, AHT et CSAT
Calculer le MOS à plusieurs reprises au fil du temps permet d’observer l’amélioration ou la régression d’un modèle. Vous pouvez enrichir cette analyse en vous comparant aux performances humaines. Constater les résultats obtenus par des humains dans des rôles similaires indiquera si votre agent vocal se rapproche d’un niveau idéal.
Voici quelques métriques à prendre en compte pour les benchmarks de test entre IA et humains.
Les agents IA doivent pouvoir égaler les résultats humains en FCR et CSAT, tout en améliorant nettement l’AHT. Cette amélioration s’explique par le fait que les agents IA traitent généralement des conversations plus générales que les agents humains. De nombreuses entreprises mettent en place un workflow où les agents IA répondent en premier, puis transfèrent les appels aux agents humains uniquement lorsqu’ils sont trop complexes à gérer de façon autonome.
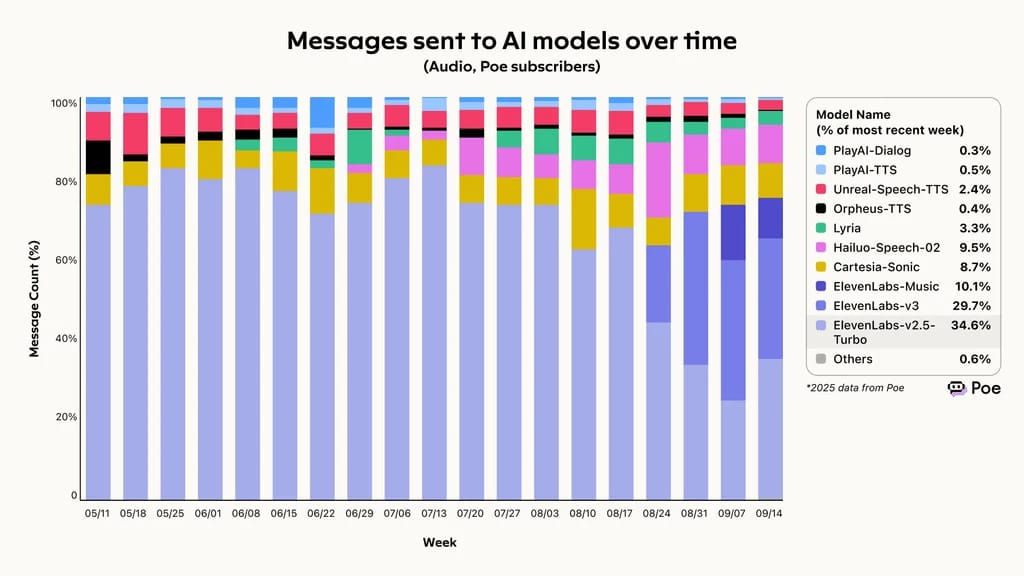
Les données de 2025 de Poe, un agrégateur de comparaisons d’IA, révèlent qu’ElevenLabs a conservé la meilleure capacité globale à répondre aux demandes, en réalisant 74,4 % de toutes les demandes entrantes. Ce succès s’est traduit par une croissance rapide de l’utilisation, Eleven v3 et v2.5-Turbo représentant plus de 60 % des messages envoyés aux modèles IA au fil du temps.
Pour une expérience améliorée, utilisez Eleven v4 , notre modèle TTS le plus expressif.
Messages envoyés aux modèles IA au fil du temps, ElevenLabs en tête du cadre d’évaluation des agents vocaux de Poe
Messages envoyés aux modèles IA au fil du temps, selon le benchmark de Poe
Erreurs courantes lors des tests d’agents vocaux
Lorsqu’on suit un cadre d’évaluation des agents vocaux, il est tentant de tester les scénarios les plus favorables. Or, l’expérience quotidienne des clients qui interagissent avec vos systèmes d’IA vocale ne se déroule pas dans des conditions idéales.
Voici trois erreurs courantes lors des tests d’agents vocaux et comment les corriger :
- Tester le scénario le plus simple : lorsque vous sélectionnez des extraits audio pour le MOS, veillez à inclure des cas limites. Les extraits comportant du bruit de fond ou une parole avec accent sont très fréquents dans la vie réelle ; tester uniquement des fichiers audio « propres » conduit donc à un mauvais calibrage du MOS.
- Privilégier le confinement plutôt que la résolution : optimiser vos modèles pour garder les utilisateurs dans votre système d’agents gonfle les taux de confinement sans améliorer les résultats. Si votre FCR est faible malgré un taux de confinement élevé, l’agent fait tourner les utilisateurs dans une boucle frustrante. Prévoyez des mécanismes permettant aux utilisateurs de parler à des agents humains s’ils le souhaitent.
- Ignorer les percentiles de latence : les SLA définissent souvent la latence au niveau P95. Cette métrique est importante pour offrir une expérience cohérente à la majorité de vos clients, mais n’oubliez pas que les 5 % restants sont aussi de vrais clients. À grande échelle, 5 % d’un système qui traite 10 000 appels quotidiens représentent encore 500 personnes confrontées à une conversation lente. Faites de P99 votre objectif SLA principal, et ne vous limitez pas à la médiane ou au P95.
En tenant compte de ces éléments, vous pouvez établir des références justes et représentatives plutôt que de vous appuyer sur des moyennes idéalisées.
Pourquoi adopter des évaluations spécifiques aux cas d’usage
Si les six piliers définis dans ce cadre indiquent les domaines à explorer, leur pondération dépend de votre secteur. Une entreprise de services financiers peut par exemple donner la priorité à la conformité et à l’utilisation des outils, tandis qu’une marque grand public considérera la qualité de la voix TTS comme son principe directeur.
Voici deux exemples d’évaluations spécifiques à un cas d’usage et de leur effet sur l’équilibre entre les piliers.
Service client
Dans certains secteurs, comme les centres d’appels, d’autres métriques d’exécution des tâches, telles que la résolution au premier appel (FCR), occupent une place importante. La capacité à traiter avec succès un appel entrant sans intervention humaine réduit considérablement la charge pesant sur les agents du service client. McKinsey estime que les centres d’appels utilisant des agents vocaux peuvent réduire le volume d’interactions jusqu’à 50 %.
Bien qu’il soit moins important que le taux de réussite des tâches, le taux de confinement constitue une autre dimension à considérer. Il mesure la durée totale d’un appel. Si votre taux de confinement est très élevé mais que votre FCR est faible, vos agents gardent les personnes en ligne sans apporter de solution au client. Dans la pratique, cela peut se traduire par une expérience frustrante où le client tourne en rond.
Parmi les autres métriques à suivre figure l’AHT, les agents IA devant résoudre rapidement les problèmes courants. Ainsi, le domaine du service client donnera la priorité à la qualité des conversations, notamment à la gestion des tours de parole et au taux de repli, plutôt qu’à d’autres domaines.
Santé
La santé est un secteur fortement réglementé, dont les exigences strictes de conformité rendent l’exploitation d’agents vocaux particulièrement délicate. La conformité est une préoccupation centrale, ce qui augmente fortement le poids du pilier de la sécurité et de l’intelligence par rapport aux autres.
Les chatbots de santé doivent gérer la prise de rendez-vous, les parcours d’accès à la télésanté, le triage des symptômes et les questions d’assurance. Toutes ces tâches exigent un haut niveau d’intelligence et d’utilisation des outils, ce qui montre une nouvelle fois que les exigences propres au secteur ou au rôle influencent le pilier le plus important.
Quel que soit le secteur de votre entreprise, comprendre les piliers fondamentaux de l’évaluation des agents vocaux et les appliquer de manière équilibrée vous aidera à identifier les agents les mieux adaptés à vos besoins.
Créez avec ElevenAgents pour des performances élevées et une faible latence
La plateforme sur laquelle vous développez influence directement les performances de vos agents vocaux dans des workflows réels. Lorsque vous interagissez avec vos clients en particulier, vous devez être certain que votre agent excellera dans chaque catégorie.
ElevenAgents est conçu pour les déploiements vocaux en production. Il associe un TTS de référence avec Eleven v4, un STT en temps réel grâce à Scribe v2, et une couche d’orchestration d’agents conçue pour l’échelle de l’entreprise. Chaque composant est conçu pour répondre aux benchmarks définis dans ce cadre, afin de vous permettre d’offrir des expériences de qualité à vos clients.
Que vous évaluiez vos options ou soyez prêt à commencer à développer, ElevenLabs vous offre une voie adaptée. Découvrez la plateforme ElevenAgents pour voir comment elle répond à votre cas d’usage, ou inscrivez-vous et commencez à développer dès aujourd’hui.
FAQ sur l’évaluation des agents vocaux

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


