Comment intégrer Text to Speech à vos applications
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Pour intégrer Text to Speech à vos applications, créez une clé API, installez le SDK ElevenLabs, envoyez votre texte au point de terminaison TTS avec une voix et un modèle, puis lisez l’audio reçu.
Ce guide détaille chacune de ces étapes en Python et TypeScript, explique comment choisir la méthode d’intégration TTS la mieux adaptée à vos besoins et présente des solutions aux erreurs courantes.
Qu’est-ce qu’une API Text to Speech ?
Une API Text to Speech permet aux développeurs de convertir du texte écrit en audio naturel par programmation, sans avoir à héberger leur propre modèle TTS. Une fois l’API TTS intégrée à une application, il suffit d’envoyer une requête à l’API et de récupérer l’audio, pour ajouter facilement une couche vocale aux applications.
Les meilleures API Text to Speech, telles que celle proposée par ElevenAPI, offrent un contrôle précis du rendu audio final, du choix de la voix qui prononce un segment de texte à l’émotion qu’elle transmet. Selon le cas d’usage de votre application, vous pouvez également choisir entre des options de traitement par lots et en streaming pour créer vos extraits audio.
Fonctionnement d’une requête API Text to Speech
Lorsque vous appelez une API TTS, plusieurs étapes se déroulent en arrière-plan pour fournir votre audio.
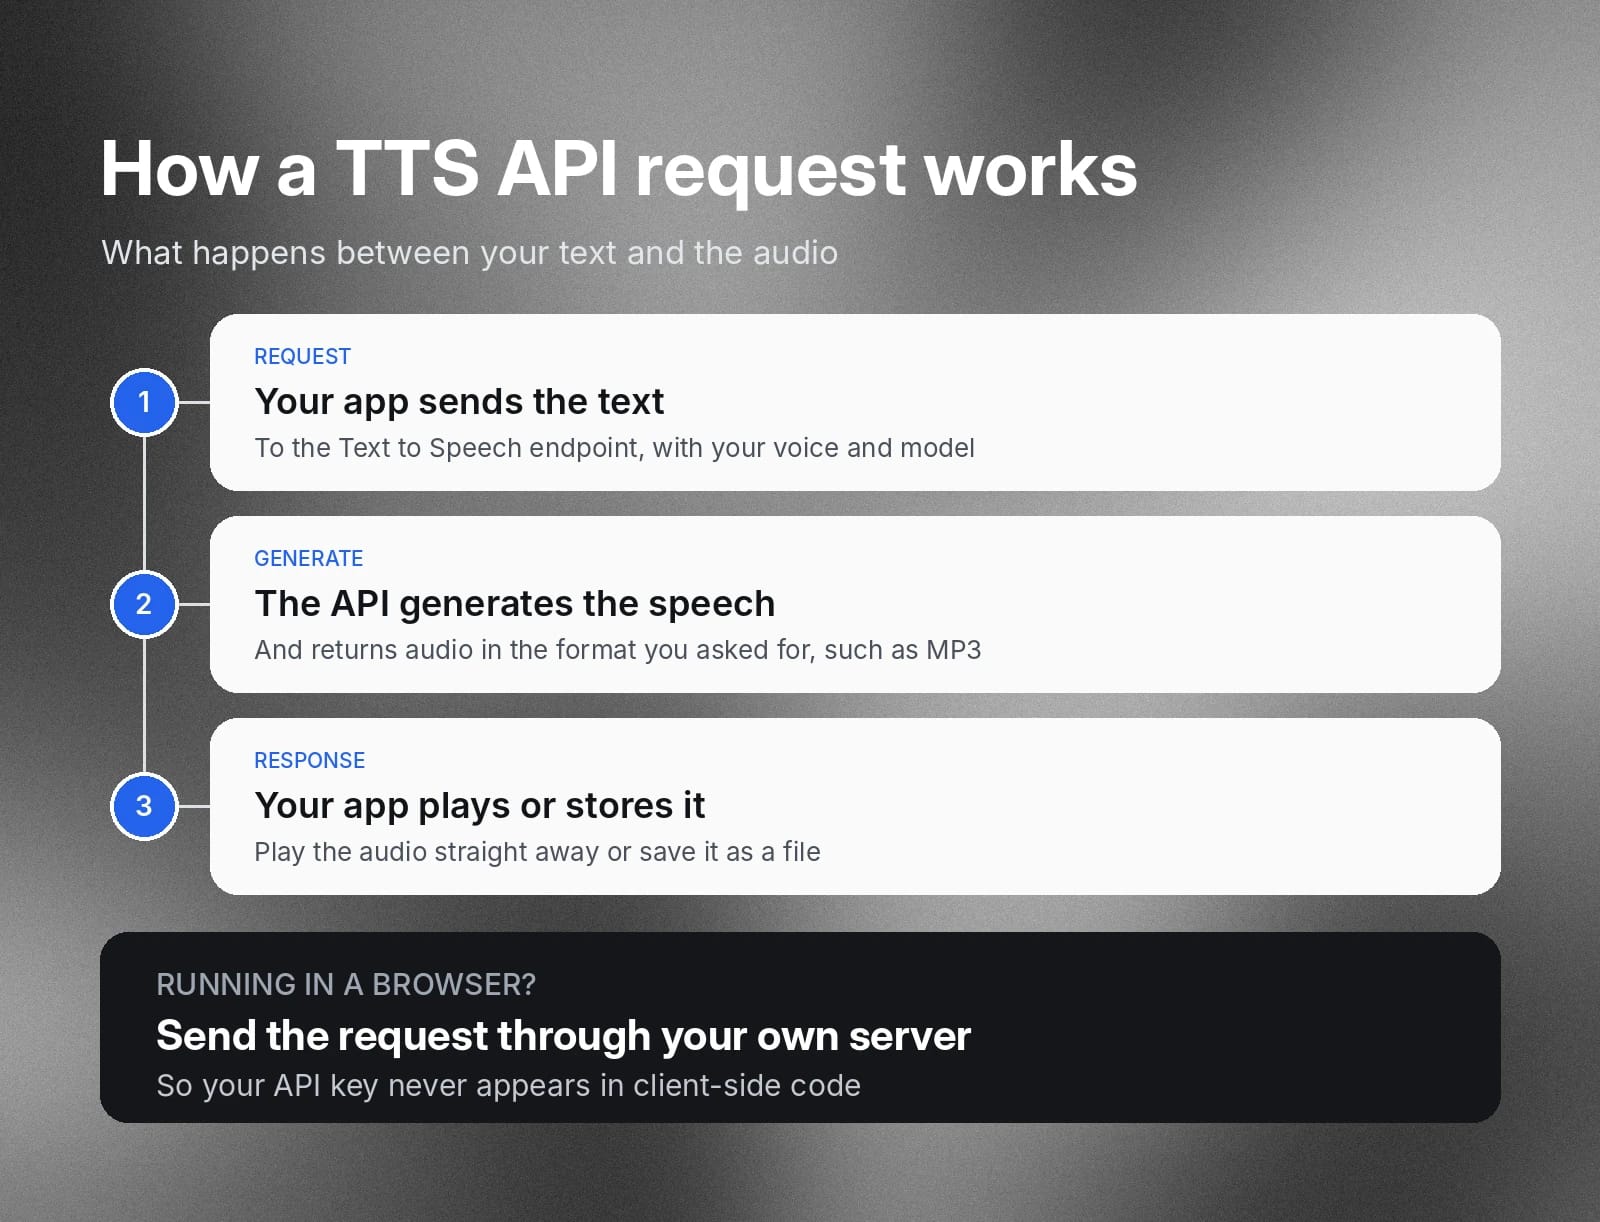
Voici comment fonctionne une requête API Text to Speech :
- Votre application envoie le texte au point de terminaison Text to Speech avec la voix et le modèle choisis.
- L’API génère la parole et renvoie l’audio dans le format de sortie demandé, tel que MP3.
- Votre application lit l’audio ou l’enregistre dans un fichier.
Si votre application s’exécute dans un navigateur, envoyez la requête via votre propre serveur afin que votre clé API n’apparaisse jamais dans le code côté client.
Checklist avant d’intégrer TTS à vos applications
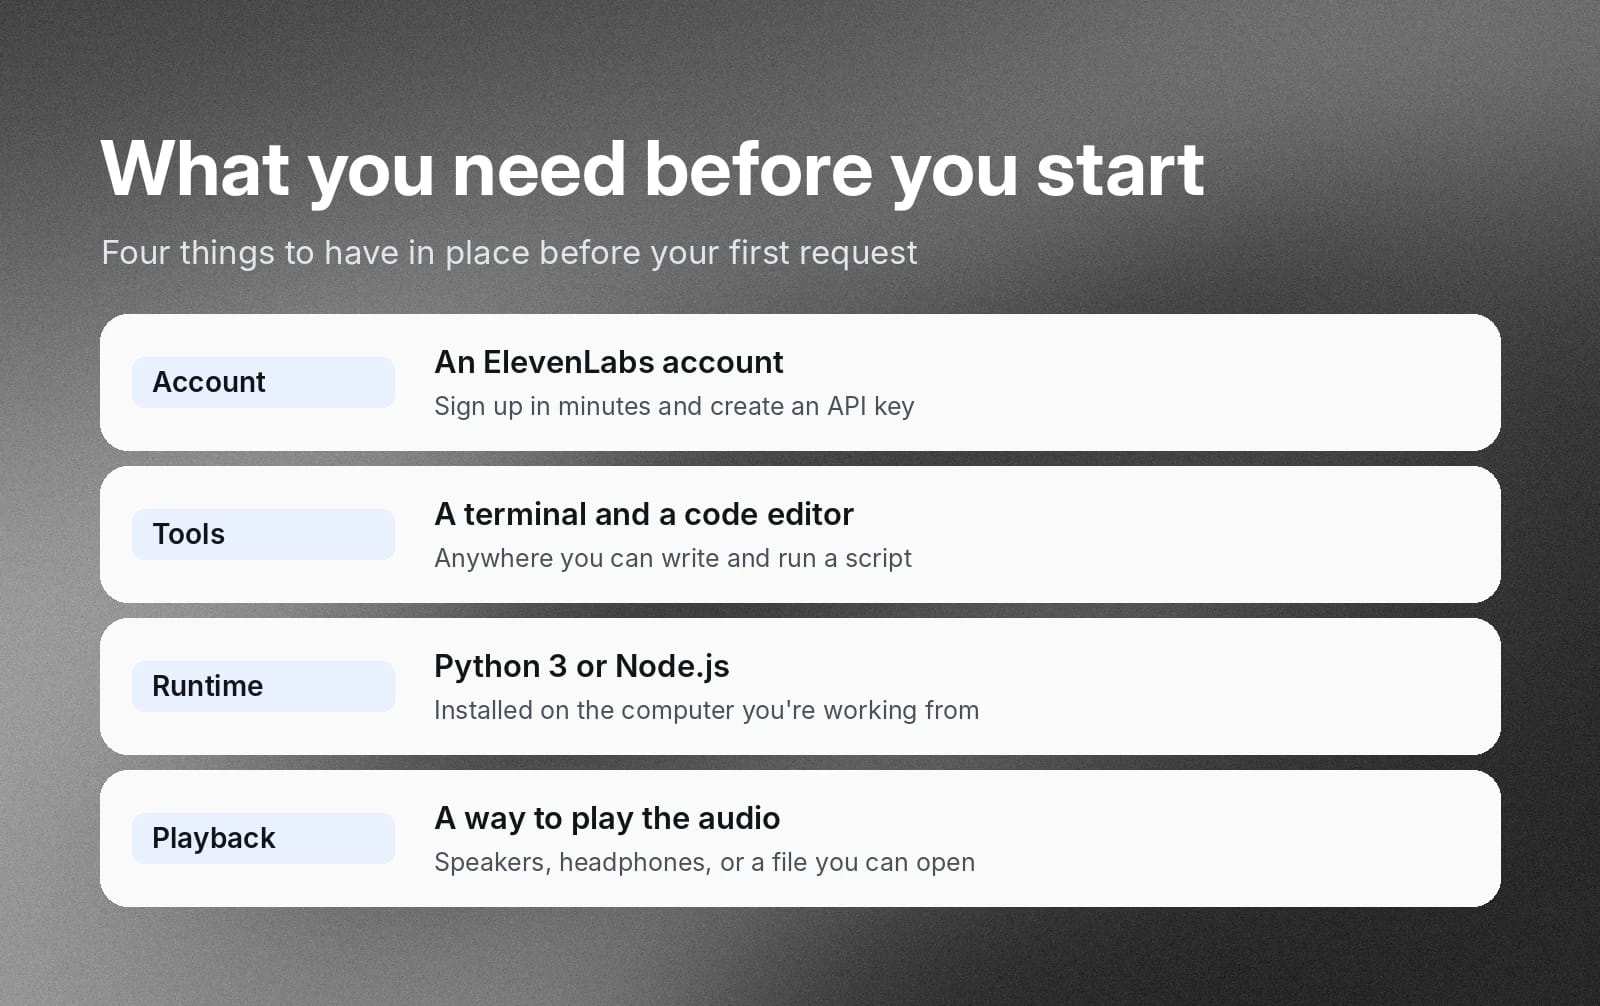
Avant d’intégrer Text to Speech à vos applications, assurez-vous de disposer des éléments suivants :
- Un compte ElevenLabs. Vous pouvez vous inscrire en quelques minutes.
- Un terminal et un éditeur de code.
- Python 3 ou Node.js installé sur l’ordinateur depuis lequel vous travaillez.
- Un moyen de lire l’audio reçu.
Une fois ces éléments réunis, vous êtes prêt à intégrer TTS à votre application.
Comment intégrer Text to Speech à votre application
Avec ElevenAPI, intégrer une API TTS à votre application ne prend que quelques minutes. Si vous avez déjà créé un compte, passez directement aux étapes ci-dessous. Sinon, pensez à vous inscrire pour commencer.
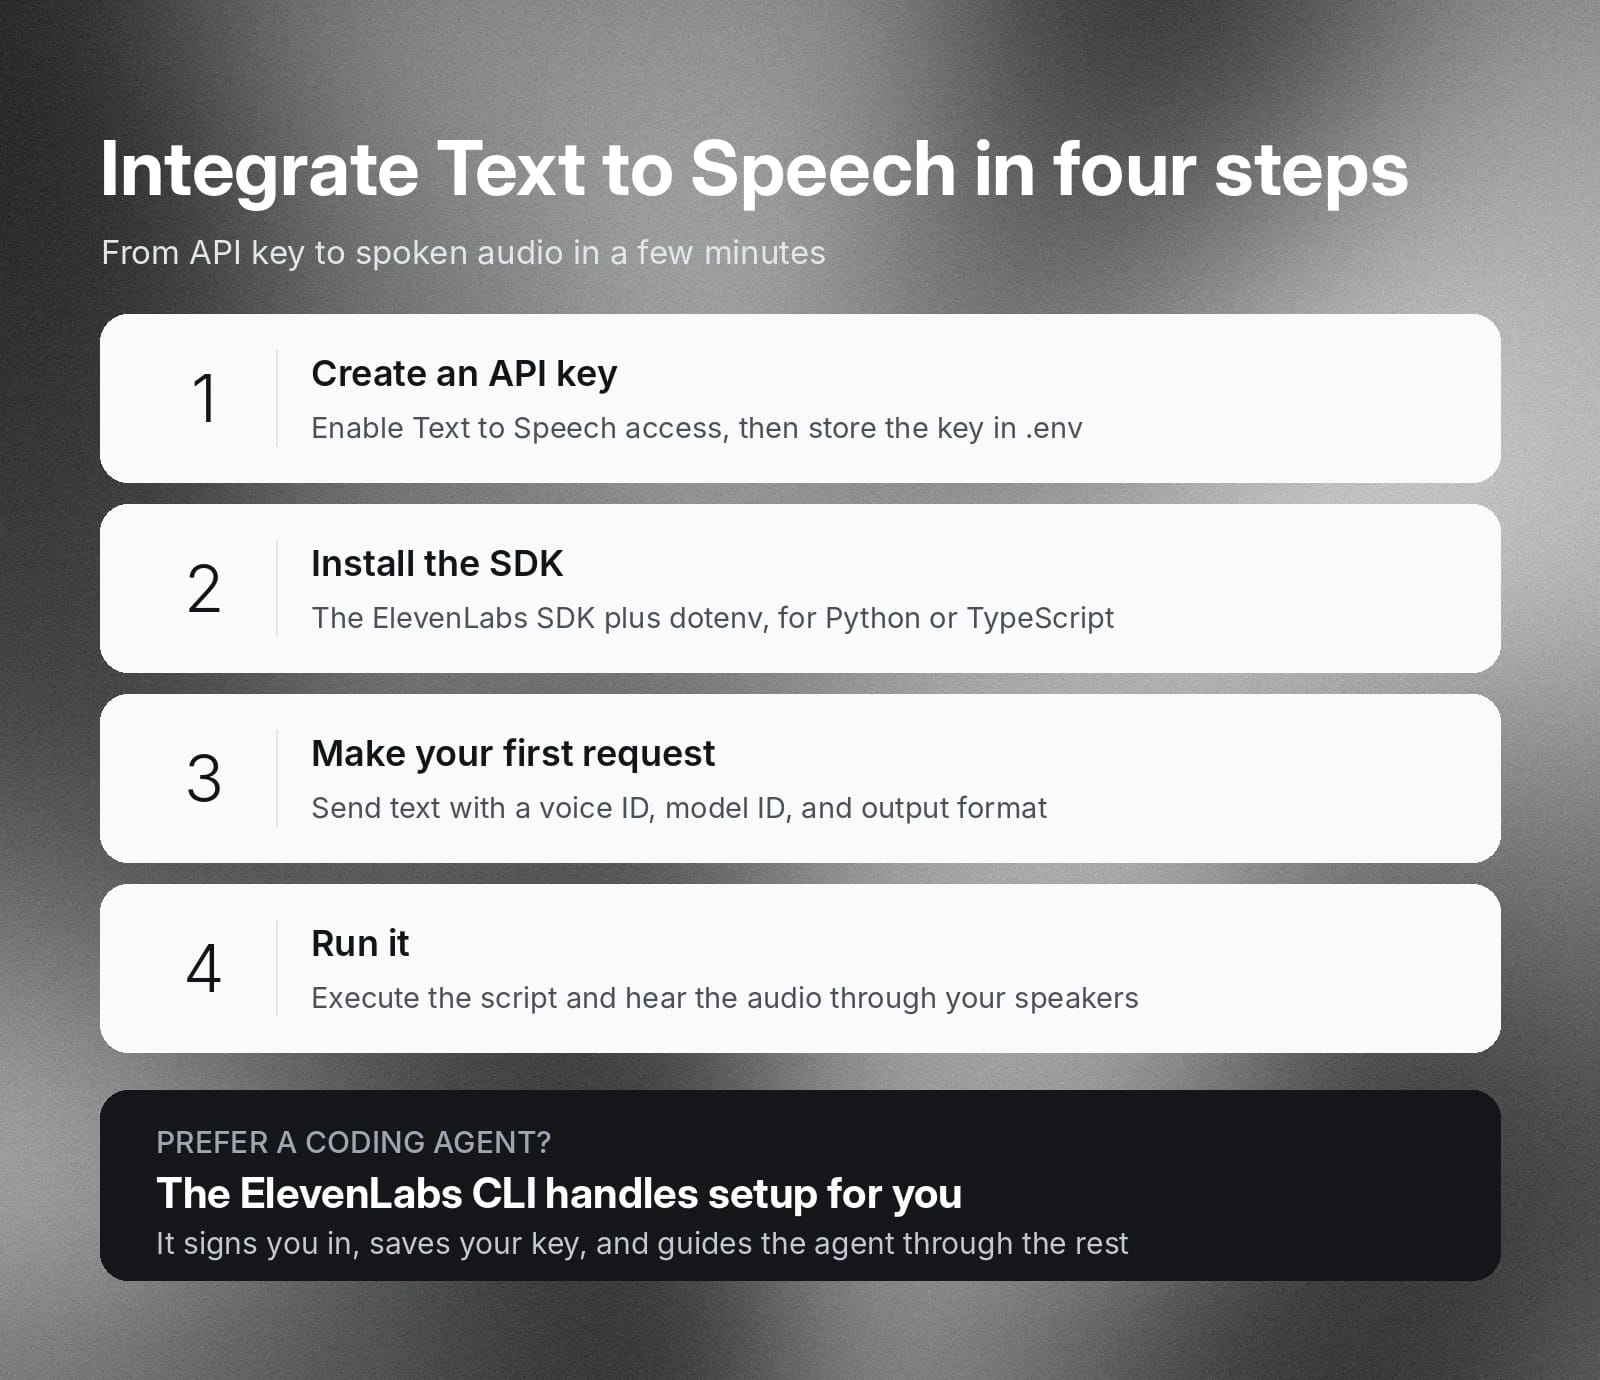
Voici les étapes :
- Créer une clé API
- Installer le SDK
- Effectuer votre première requête
- L’exécuter
Examinons ces étapes plus en détail.
Créer une clé API
Récupérez une clé API depuis le Dashboard API ElevenLabs. Après avoir cliqué sur « Create Key », vous pourrez configurer le type d’API à mettre en place. Pour ce cas d’usage, vérifiez que TTS est activé avec l’option « Access ».
Copiez la clé API et collez-la comme variable d’environnement dans .env, ou directement dans la configuration de votre application, selon son architecture. La stocker dans votre fichier .env permet de la garder secrète tout en autorisant votre script à la charger à l’exécution.
Vous préférez confier la configuration à votre agent de programmation ? Collez ceci dans votre agent : npx -y @elevenlabs/cli@latest onboard init. La CLI ElevenLabs ouvre votre navigateur pour vous connecter, enregistre la clé dans le fichier env de votre projet et guide l’agent à travers les étapes restantes. Node.js est requis pour npx. Consultez le guide de démarrage rapide pour en savoir plus.
Installer le SDK
Deux packages principaux sont nécessaires pour configurer une API Text to Speech. Le premier est le SDK ElevenLabs, qui se charge de l’appel API. Le second est dotenv, qui charge votre clé API depuis le fichier .env configuré à l’étape 1.
Si vous travaillez avec la CLI, consultez notre documentation de l’API TTS, où vous trouverez des instructions plus précises et les options disponibles.
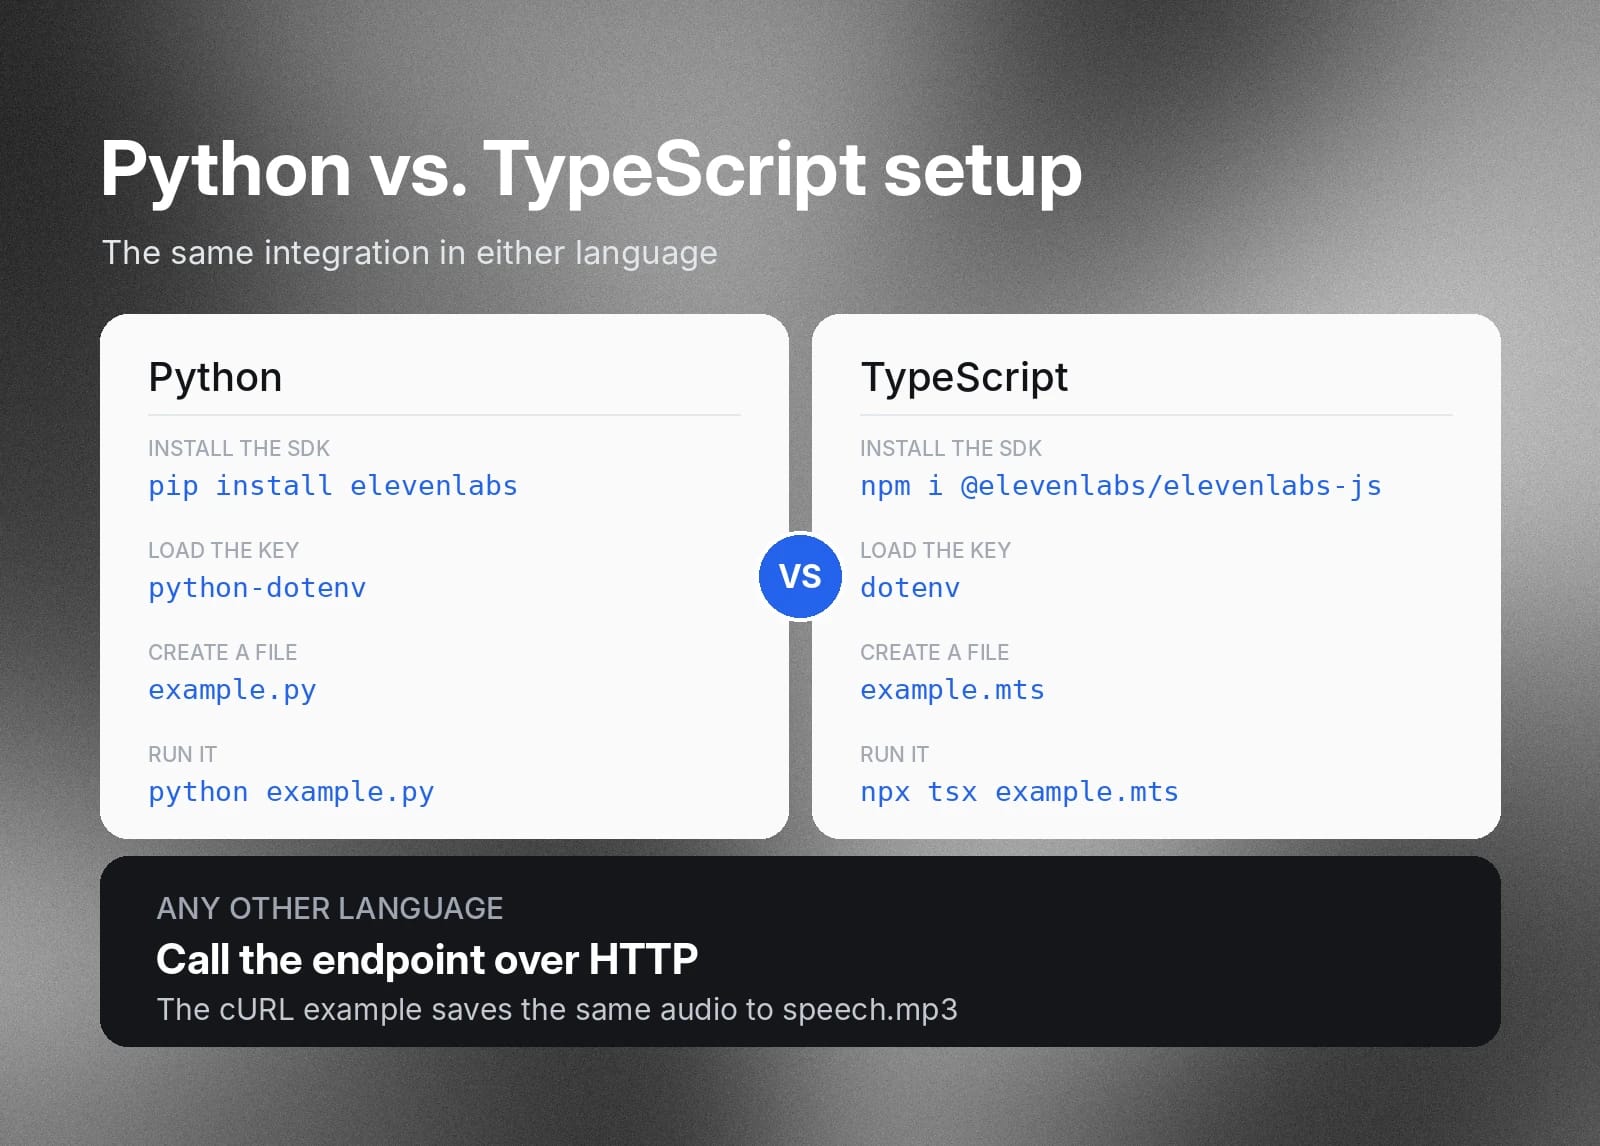
Voici comment installer le SDK et dotenv pour votre API TTS en Python et en TypeScript.
Python
TypeScript
Effectuer votre première requête
Créez ensuite le client. Le client est un objet qui encapsule ElevenAPI. Créez un fichier .py ou .mts, selon le langage de programmation utilisé.
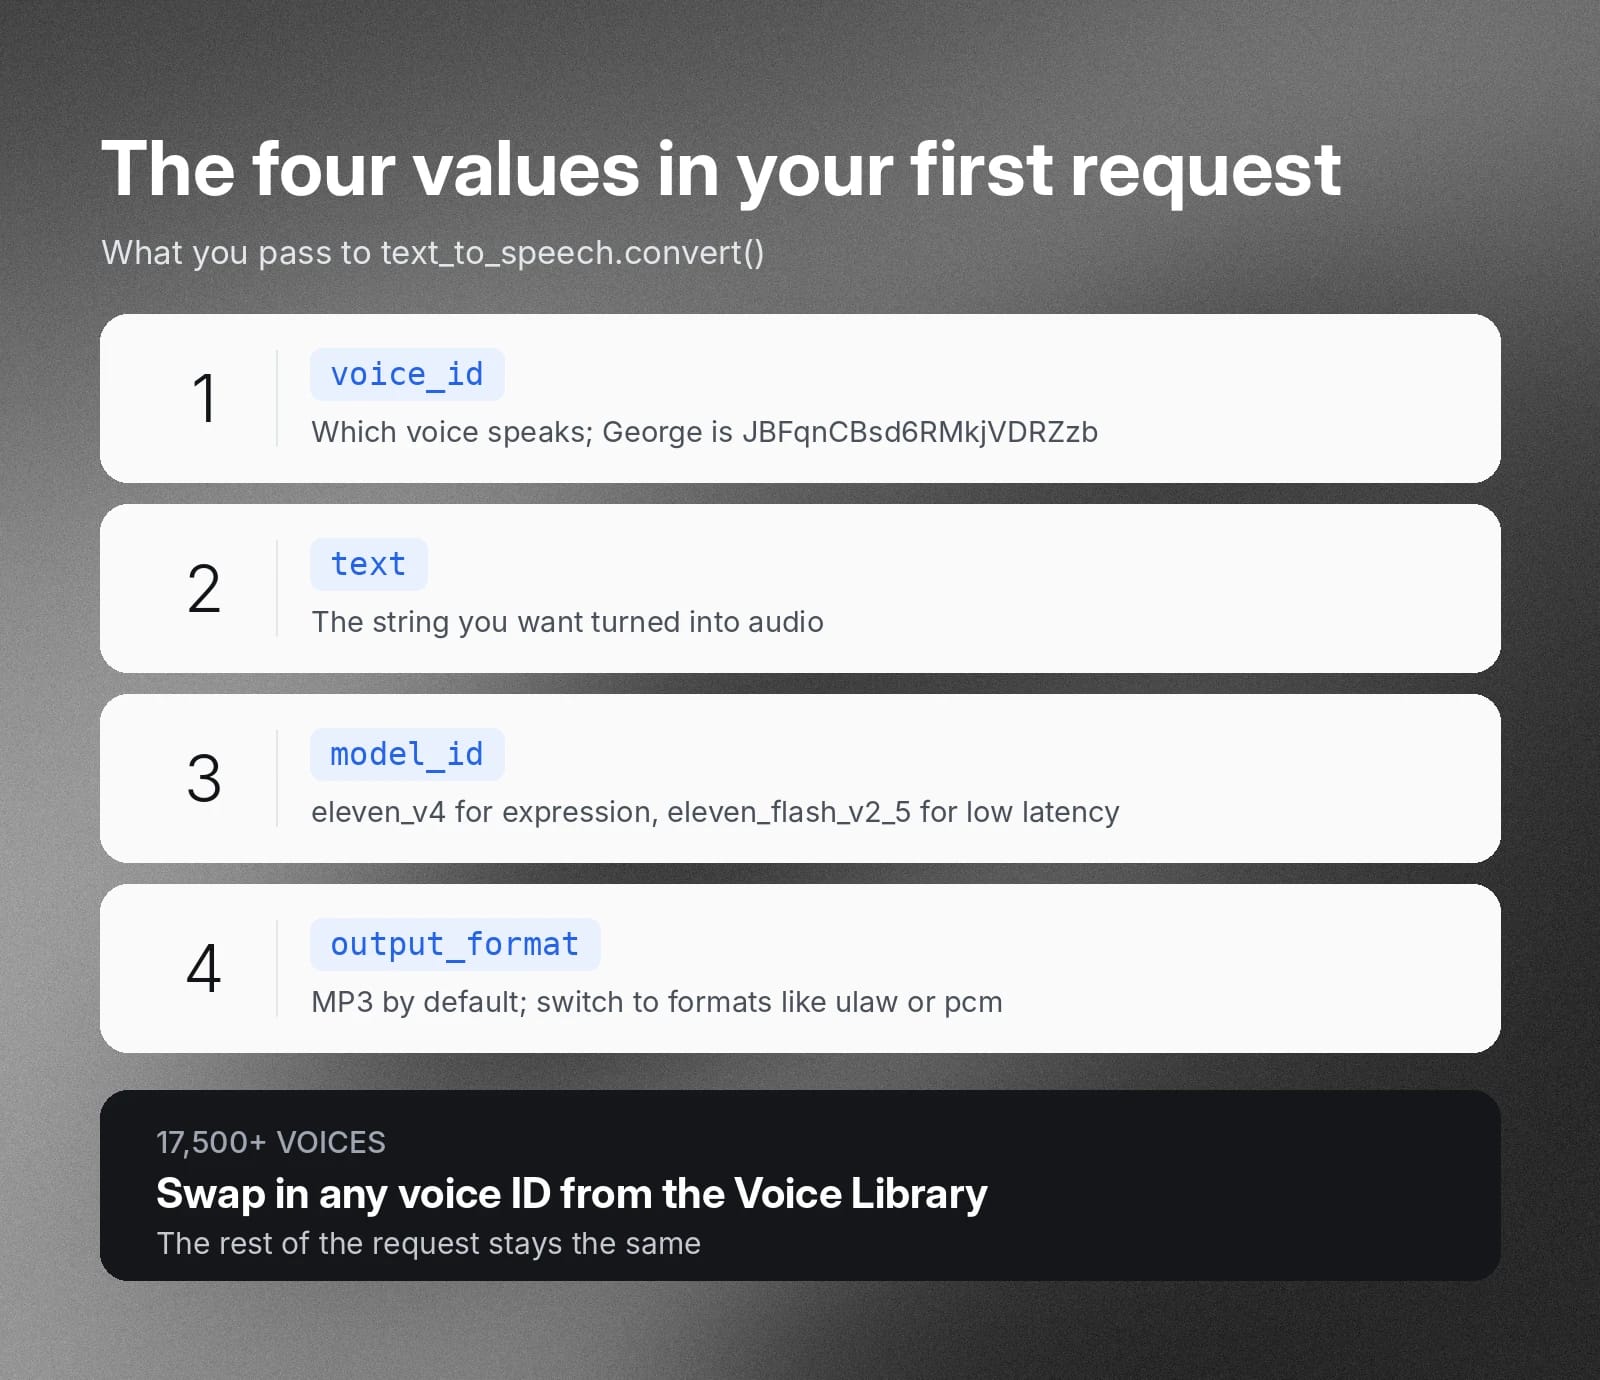
Quatre valeurs principales influencent la sortie :
- ID de voix : ElevenLabs propose plus de 17 500 voix dans notre Voice Library. Choisissez une voix qui représente au mieux votre application ou adaptez-la à votre cas d’usage. Dans les blocs de code du guide de démarrage rapide ci-dessous, nous utilisons « George », dont l’ID de voix est « JBFqnCBsd6RMkjVDRZzb »
- Texte : La chaîne de texte que vous souhaitez convertir en fichier audio avec le modèle TTS ElevenAPI.
- ID de modèle : Le modèle précis choisi pour générer l’audio. Dans l’exemple ci-dessous, nous utilisons eleven_v4, mais vous pouvez aussi choisir l’un de nos modèles Text to Speech s’il répond mieux à votre cas d’usage. Par exemple, vous pouvez choisir Eleven Flash v2.5 (eleven_flash_v2_5 dans le champ d’ID de modèle) pour sa faible latence.
- Format de sortie : Définissez l’encodage audio que vous souhaitez recevoir de l’API TTS. Par défaut, l’API renvoie un mp3, mais vous pouvez choisir des formats tels que ulaw ou pcm.
Voici à quoi ressemblent ces fichiers d’API TTS en Python et en TypeScript. Les deux exemples ci-dessous utilisent le modèle eleven_v4.
Python
TypeScript
cURL
Vous pouvez également appeler le point de terminaison depuis tout langage effectuant des requêtes HTTP. Cet exemple cURL envoie le même texte et enregistre l’audio dans un fichier :
L’exécuter
Vous êtes maintenant prêt à exécuter le fichier d’API TTS. Lancez l’une des commandes suivantes, selon que vous utilisez Python ou TypeScript.
Python
TypeScript
Vous devriez entendre l’audio via vos haut-parleurs. Avec l’exemple cURL, ouvrez plutôt speech.mp3.
Résoudre les erreurs courantes d’intégration TTS
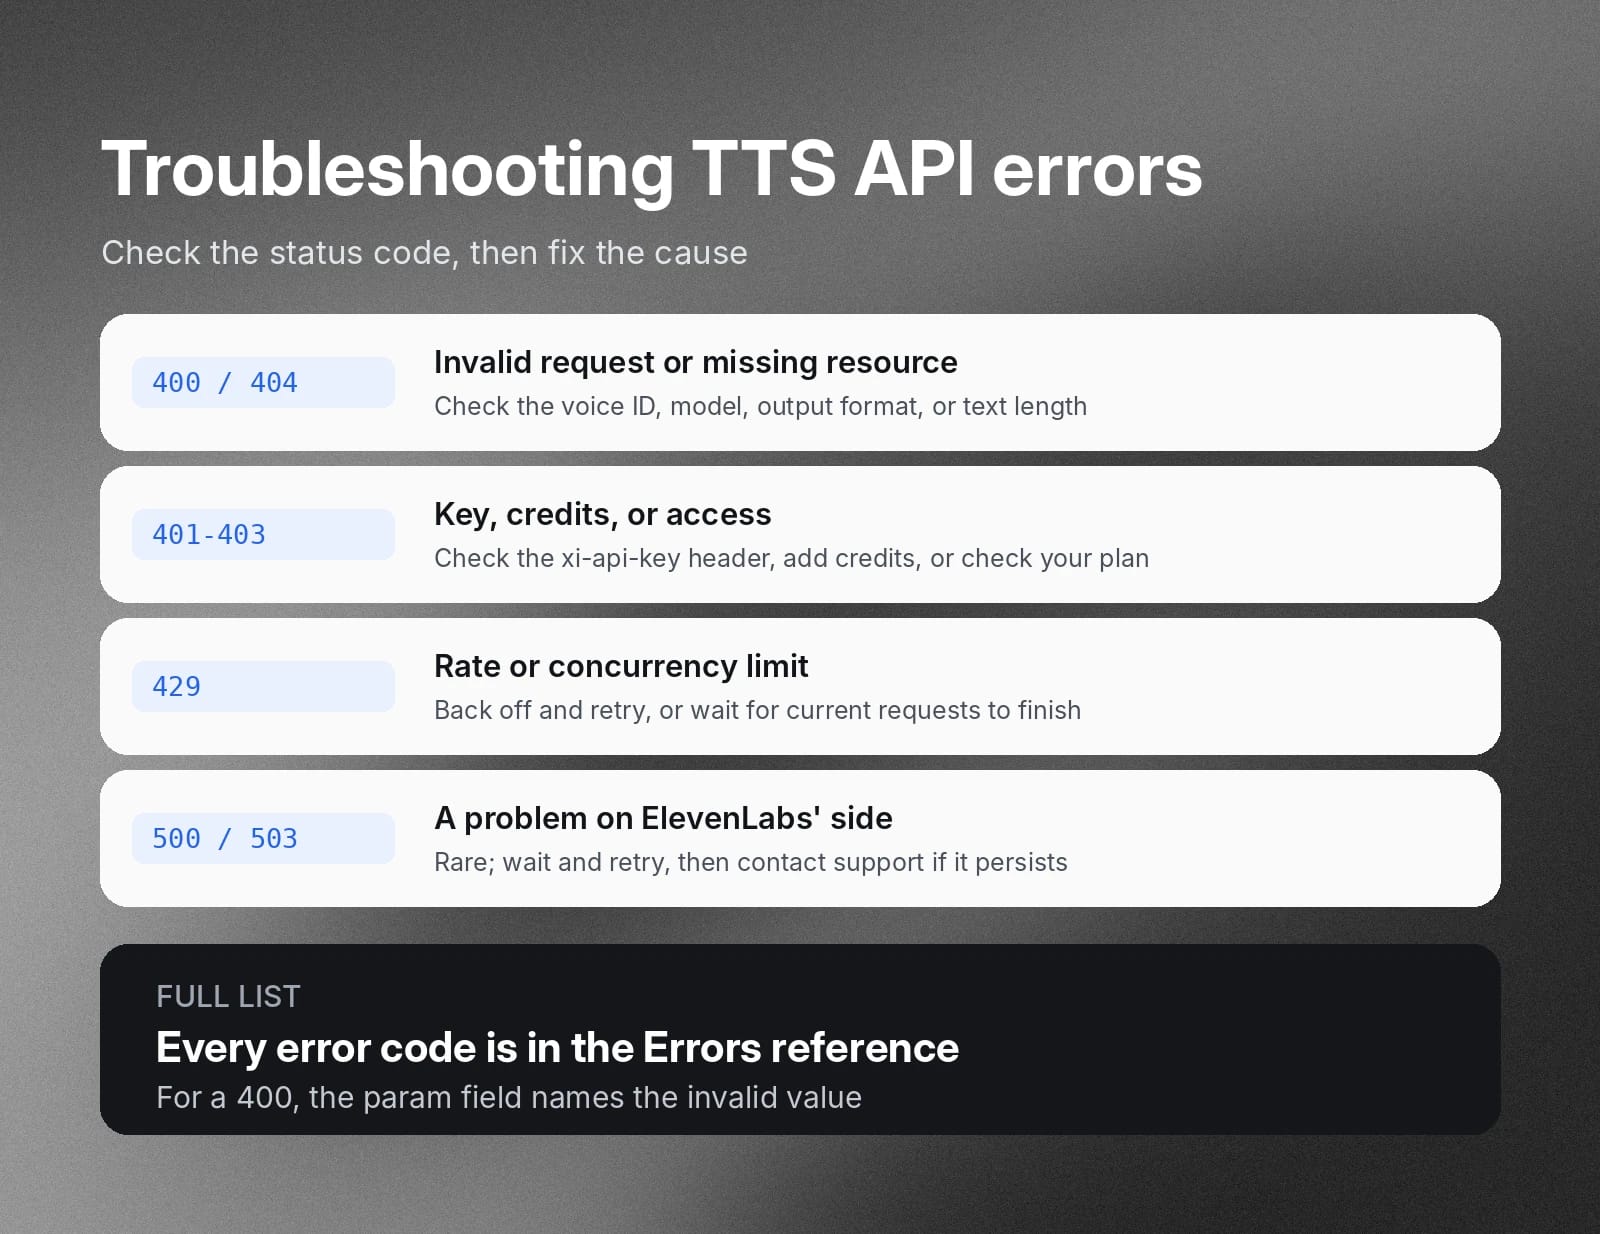
Si votre première requête échoue, comparez le code d’état reçu à cette liste d’erreurs possibles.
État
Signification
Que faire
400 ou 404
validation_error, invalid_request ou not_found : la requête est invalide, ou la voix ou une autre ressource n’existe pas
Corrigez la requête avant de réessayer. Le champ param de l’erreur indique la valeur invalide. Les causes courantes sont un ID de voix invalide (invalid_voice_id, ou voice_not_found pour un ID inexistant), un modèle ou un format de sortie non pris en charge, ou un texte trop long (text_too_long).
401, 402 ou 403
authentication_error, payment_required ou authorization_error : un problème avec votre clé API, vos crédits ou vos accès
Pour une erreur 401, vérifiez votre clé API et l’en-tête xi-api-key. Pour une erreur 402, ajoutez des crédits (insufficient_credits). Pour une erreur 403, vérifiez que votre forfait inclut la fonctionnalité ou le modèle (feature_not_available ou model_access_denied).
429
rate_limit_error : vous avez dépassé la limite de débit (rate_limit_exceeded) ou de requêtes simultanées (concurrent_limit_exceeded)
En cas de limite de débit, réessayez avec un backoff exponentiel. En cas de limite de requêtes simultanées, attendez la fin de vos requêtes en cours avant d’en envoyer de nouvelles, ou passez à un forfait avec une limite plus élevée.
500 ou 503
internal_error ou service_unavailable : un problème du côté d’ElevenLabs, ce qui devrait être rare
Patientez un instant, puis réessayez. Contactez l’assistance si une erreur 500 persiste.
Pour obtenir la liste complète des erreurs, consultez la page Guide des erreurs pour en savoir plus.
Avantages de l’intégration d’une API Text to Speech
Ajouter une interface vocale à votre application crée une nouvelle façon pour les utilisateurs d’interagir avec elle. Pour certaines personnes, notamment celles ayant une déficience visuelle, il peut s’agir du seul moyen pratique d’utiliser votre application.
Voici les avantages de l’intégration d’une API TTS à votre application :
- Accessibilité : L’audio parlé offre une nouvelle manière d’interagir avec votre application, et la rend accessible aux personnes qui ne peuvent pas facilement la lire à l’écran.
- Engagement : Les fonctionnalités de lecture à voix haute et d’écoute permettent aux utilisateurs de consulter du contenu tout en faisant autre chose, une pratique de plus en plus courante.
- Expériences vocales : Les réponses orales donnent aux chatbots et aux guides intégrés à l’application un moyen naturel de répondre aux utilisateurs.
- Portée multilingue : Eleven v4 couvre plus de 90 langues, ce qui permet à votre intégration de servir des audiences dans le monde entier.
Compte tenu de sa simplicité de configuration, l’intégration d’une API TTS à votre application permet efficacement de la rendre plus interactive et expressive.
Choisir la bonne méthode d’intégration et le bon modèle
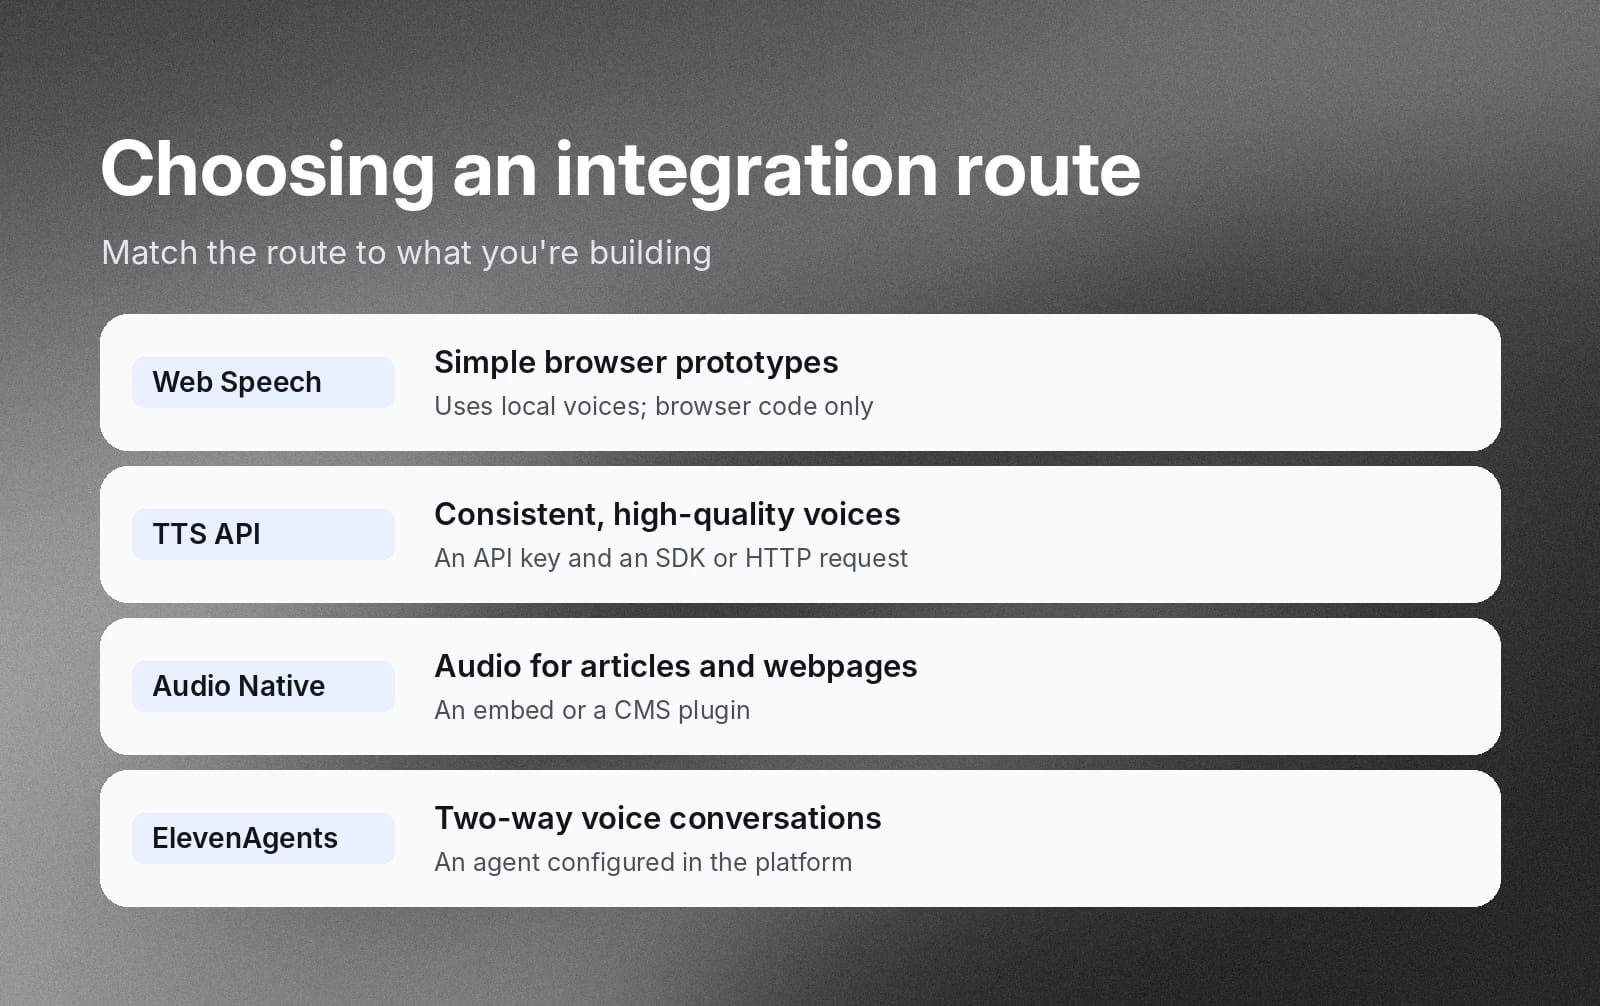
ElevenAPI est l’un des moyens les plus rapides et les plus simples d’ajouter la voix à une application, mais plusieurs autres méthodes sont disponibles selon vos besoins.
Voici quelques méthodes d’intégration TTS :
Méthode
Idéal pour
Prérequis
Synthèse vocale du navigateur (Web Speech API)
Prototypes simples dans un navigateur utilisant des voix locales
Code navigateur uniquement
Applications nécessitant des voix cohérentes et de haute qualité, avec contrôle du rendu
Une clé API et un SDK ou une requête HTTP
Intégration de la parole dans des articles ou des pages web, comme le fait TIME.
Un embed ou un plugin CMS
Si vous choisissez ElevenAPI, vous devez également sélectionner le modèle à inclure dans votre requête. Voici un aperçu des modèles TTS ElevenLabs disponibles :
Modèle
Idéal pour
Langues
eleven_v4
La parole la plus expressive
plus de 90
eleven_flash_v2_5
Utilisation en temps réel, agents et volumes élevés
32
eleven_multilingual_v2
Narration stable et haute fidélité
29
Vous pouvez également choisir parmi plus de 17 500 voix dans notre Voice Library. Remplacez simplement l’ID d’exemple dans un extrait de code par celui de votre choix.
Cas d’usage courants d’une API Text to Speech dans une application
Une fois votre première requête fonctionnelle, le même appel peut alimenter de nombreuses fonctionnalités.
Voici quelques exemples d’utilisation d’une API TTS dans une application :
- Lecture dans l’application : Envoyez le texte par segments et lisez l’audio dans l’ordre. Pour en savoir plus, consultez notre guide d’intégration du traitement par lots avec l’API.
- Réponses audio de chatbot : Faites passer chaque réponse de votre chatbot par l’API et diffusez l’audio en streaming vers l’utilisateur pour une expérience plus interactive.
- Systèmes téléphoniques : Demandez le format de sortie ulaw_8000 pour la téléphonie. Consultez notre guide d’intégration TTS avec Twilio pour en savoir plus.
Si vous cherchez à concevoir des agents vocaux qui tiennent des conversations bidirectionnelles, ElevenAgents est conçu pour cela. Configurez et déployez un agent dans la plateforme plutôt que d’assembler vous-même toute la chaîne de traitement vocal. Découvrez ElevenAgents pour en savoir plus.
Intégrez l’API TTS à vos applications avec ElevenAPI
L’intégration de Text to Speech se résume à quatre étapes : créez une clé API, installez le SDK, effectuez votre première requête, puis exécutez-la. Le même appel fonctionne en TypeScript, en Python ou dans tout autre langage capable d’effectuer une requête HTTP. Vous pouvez également choisir le modèle et la voix adaptés à votre application.
Si vous êtes prêt à intégrer TTS à vos applications, inscrivez-vous pour effectuer votre première requête avec ElevenAPI dès aujourd’hui ou en savoir plus sur l’API Text to Speech.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.