
Intégration de l’API Text to Speech : streaming, traitement par lots, gestion des erreurs
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Intégrer une API Text to Speech est simple… après quelques décisions concrètes : quel mode de transfert utiliser, comment choisir un modèle et un format de sortie, comment diffuser en streaming, comment gérer un volume élevé sans dépasser votre limite de requêtes simultanées, comment mettre en cache et relancer les requêtes pour ne jamais payer deux fois la génération du même audio, et comment comparer le délai avant réception du premier octet à celui d’un autre fournisseur.
Pour vous aider à intégrer une API Text to Speech, nous détaillons chacune de ces décisions d’architecture et la marche à suivre. Ce guide vous aidera à intégrer l’API Text to Speech d’ElevenLabs API Text to Speech et à passer à l’échelle, grâce à des extraits de code que vous pouvez déployer directement en production.
Pour mieux comprendre les concepts mentionnés ici, consultez nos guides sur la compréhension du streaming audio, l’optimisation de la latence, ainsi que la présentation des modèles ElevenLabs.
Résumé
- L’API Text to Speech d’ElevenLabs possède un seul point de terminaison, accessible de trois façons : conversion par lots, streaming HTTP et WebSocket stream-input.
- En HTTP, chaque requête en cours compte dans votre limite de requêtes simultanées, tandis qu’avec WebSocket, seule la génération active est prise en compte.
- Limitez votre parallélisme juste en dessous de la limite de votre forfait et mettez en cache un hachage de chaque paramètre influant sur la sortie, afin de ne jamais facturer deux fois le même texte.
- Relancez les erreurs 429 et 5xx avec un backoff exponentiel et un jitter complet afin de ralentir avant d’atteindre la limite de requêtes simultanées.
Trois façons d’intégrer l’API Text to Speech
Il existe un seul point de terminaison Text to Speech, mais son mode d’intégration détermine votre latence, votre complexité et vos coûts.
Le même appel POST /v1/text-to-speech/{voice_id} peut prendre trois formes, chacune adaptée à un usage légèrement différent. Voici les trois façons d’intégrer l’API Text to Speech :
- La conversion par lots (convert) est l’intégration la plus simple : vous envoyez une requête et recevez une réponse audio. C’est l’option la moins complexe, mais son délai avant le premier audio est le plus élevé, car l’extrait complet est synthétisé avant le retour du moindre octet.
- Le streaming HTTP (stream) conserve la même requête, mais segmente la réponse : ajoutez /stream au chemin, appelez la méthode stream, et l’audio est renvoyé sous forme de réponse segmentée. Le code est presque identique, mais la latence perçue est bien plus faible.
- Le WebSocket (stream-input) maintient une connexion persistante : vous envoyez du texte progressivement et recevez des segments audio au fil de l’eau. Il est conçu pour les agents interactifs et pour transformer en parole la sortie d’un LLM à mesure que les jetons sont générés, avant même la fin de la phrase.
Le streaming n’accélère pas la génération audio par le modèle : le temps d’inférence reste identique. Ce qu’il change, c’est le moment où vous recevez le premier segment : il est envoyé avant la fin de l’extrait complet, ce qui réduit l’attente perçue par l’utilisateur, même si le travail total reste le même.
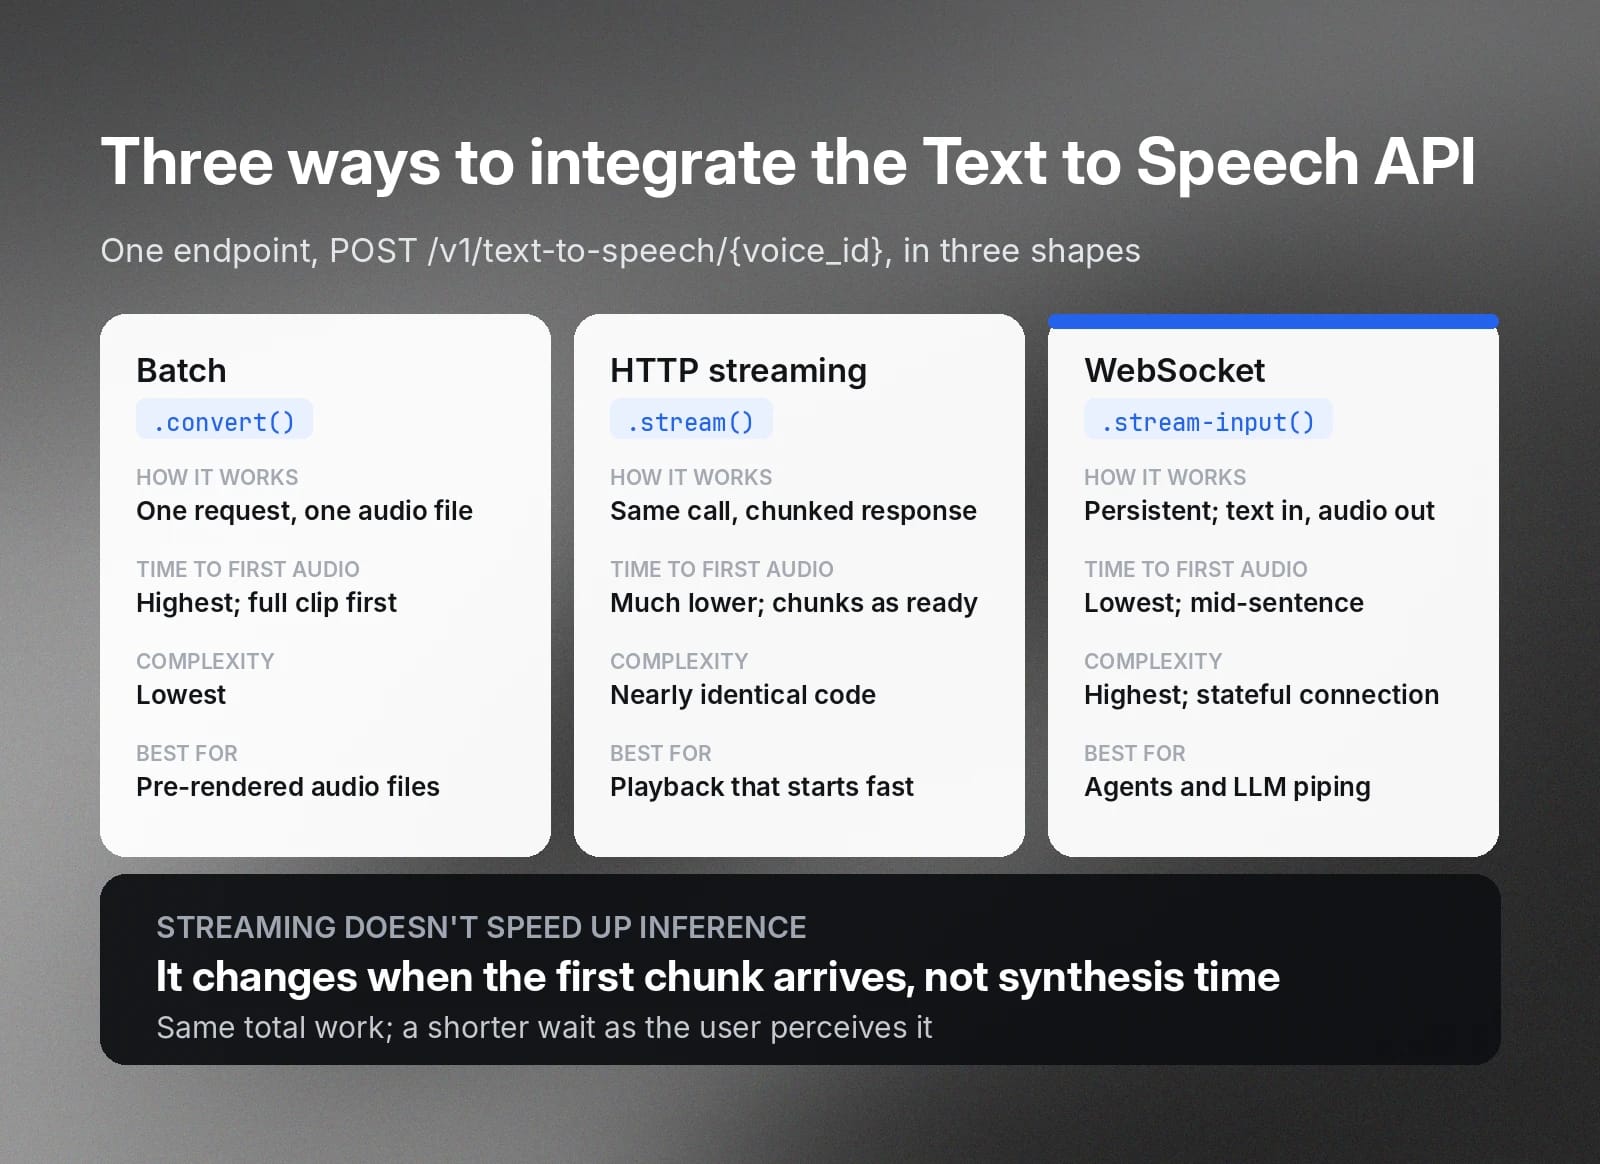
Tableau de décision : lots, streaming ou WebSocket
Plusieurs facteurs sont à prendre en compte pour choisir entre ces trois méthodes.
En bref : choisissez le traitement par lots pour le rendu hors ligne, le streaming HTTP pour un texte connu qu’un utilisateur attend, et le WebSocket pour les agents et la conversion en direct de sorties de LLM en parole.
Le tableau ci-dessous détaille les compromis selon les dimensions importantes à grande échelle.
En HTTP, qu’il s’agisse de traitement par lots ou de streaming, chaque requête en cours compte dans la limite de requêtes simultanées de votre forfait pendant toute sa durée. Avec un WebSocket, seul le temps durant lequel le modèle génère activement de l’audio est pris en compte ; un socket ouvert mais inactif ne coûte pratiquement rien.
Pour un agent vocal en cascade qui maintient une connexion ouverte pendant toute une conversation mais ne génère de l’audio que lors des tours de parole de l’agent, la différence est considérable. C’est la principale raison d’utiliser les WebSockets pour créer des agents. Le protocole complet est documenté dans le guide WebSocket Text to Speech en temps réel.
Choisir un modèle et un format de sortie
Deux choix déterminent l’audio obtenu via votre intégration d’API TTS. D’abord le modèle, qui définit la qualité et la vitesse. Ensuite le format de sortie, qui définit le conteneur, le débit binaire et la fréquence d’échantillonnage.
Bien choisir ces deux éléments dès le départ garantit que tout le reste, comme la latence et la compatibilité avec la téléphonie, s’aligne correctement.
Modèles
Nous proposons plusieurs modèles Text to Speech. Ils ne sont pas classés du meilleur au moins bon : chacun implique des compromis différents.
À noter : la valeur d’environ 75 ms correspond à l’inférence du modèle dans des conditions représentatives, hors latence réseau et applicative. Elle augmente avec des entrées plus longues et sous charge. Mesurez toujours depuis votre application, et non à partir d’une valeur de benchmark.
Les modèles Flash sont plus petits et utilisent des approximations plus agressives pour réduire le temps d’inférence. Eleven v4 et Multilingual v2 sont des modèles plus volumineux, qui consacrent davantage de temps à chaque caractère pour produire un résultat plus riche.
Pour un parcours en temps réel ou destiné à un agent, utilisez eleven_flash_v2_5 : c’est l’option multilingue à la latence la plus faible. Pour la narration, les livres audio ou les voix off marketing, utilisez eleven_multilingual_v2 pour une haute fidélité stable, ou eleven_v4 pour une expressivité et une gamme émotionnelle maximales.
Lorsque la prononciation est importante, par exemple pour des numéros de téléphone, des dates ou des montants, normalisez vous-même les nombres dans votre application avant que le texte n’atteigne l’API. Écrivez la forme orale souhaitée.
Cette normalisation garantit une prononciation prévisible d’un modèle à l’autre et évite de dépendre de réglages par défaut propres à chaque modèle, susceptibles d’évoluer.
Format de sortie
Le paramètre output_format contrôle le conteneur, la fréquence d’échantillonnage et le débit binaire de l’audio renvoyé. Voici les valeurs les plus utilisées :
Paramètres vocaux
Les paramètres suivants contrôlent le rendu de la parole générée :
- Stability : contrôle la régularité par rapport à l’expressivité. Des valeurs faibles produisent une parole plus variée et expressive, tandis que des valeurs élevées offrent un rendu plus stable et prévisible.
- SimilarityBoost : contrôle la fidélité de la sortie à la voix de référence.
- Style : accentue le style de parole naturel de la voix lorsqu’il est augmenté.
- useSpeakerBoost : renforce la ressemblance avec le locuteur d’origine, au prix d’une légère augmentation de la latence.
- Speed : ajuste le rythme de parole autour de la valeur par défaut de 1,0.
Parmi ces paramètres, Stability a généralement le plus grand impact sur la qualité perçue. Des valeurs faibles créent un résultat plus expressif mais moins homogène, tandis que des valeurs élevées privilégient la régularité et la prévisibilité.
Lors du choix d’une voix, la combinaison offrant la latence la plus faible est Flash associé à un Clonage de voix instantané ou à une voix par défaut ; les clonages de voix professionnels offrent un excellent rendu, mais ajoutent une surcharge par génération à prendre en compte.
Dans tout ce guide, l’identifiant de voix utilisé est JBFqnCBsd6RMkjVDRZzb (George).
Intégration du streaming (HTTP et WebSocket)
Dans cette section, nous abordons la partie pratique de l’intégration d’une API Text to Speech : installation du SDK, ouverture d’un flux et consommation de l’audio à mesure de son arrivée. Le parcours HTTP couvre la plupart des lectures web et applicatives, tandis que le parcours WebSocket couvre les agents et les sorties de LLM en direct.
Ces deux approches supposent que le client ElevenLabs est initialisé comme ci-dessous.
Le parcours de streaming ouvre un flux et consomme les segments à mesure de leur arrivée. voiceId est le premier argument positionnel, suivi d’un objet d’options avec des clés en camelCase (modelId, outputFormat, voiceSettings) :
Pour la variante WebSocket, connectez-vous à wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, envoyez un premier message contenant vos paramètres vocaux et un espace initial, puis envoyez les messages texte à mesure qu’ils deviennent disponibles et lisez les trames JSON dont le champ audio contient des segments encodés en base64.
Traitement par lots et limites de requêtes simultanées pour un débit élevé
L’intégration à haut débit est régie par les requêtes simultanées, c’est-à-dire le nombre de requêtes générant de l’audio au même instant. Chaque forfait comporte une limite par famille de modèles.
Chaque forfait inclut une limite de requêtes simultanées distincte :
- Free : 4 requêtes Flash simultanées.
- Starter : 6 requêtes Flash simultanées.
- Creator : 10 requêtes Flash simultanées.
- Pro : 20 requêtes Flash simultanées.
- Scale et Business : 30 requêtes Flash simultanées ; les limites Enterprise sont personnalisées.
Les limites de Multilingual v2 représentent environ la moitié de ces valeurs.
Un pool borné permet d’y remédier en plafonnant le nombre de requêtes exécutées simultanément :
Définissez MAX_CONCURRENCY légèrement en dessous de la limite de votre forfait plutôt qu’exactement à cette limite. Cette marge absorbe tout autre trafic utilisant la même clé et vous maintient sous le seuil à partir duquel une erreur 429 est renvoyée.
Limites de caractères et découpage des textes longs
Chaque modèle plafonne le nombre de caractères accepté dans une seule requête. Toute intégration de contenu long doit découper le texte puis réassembler l’audio.
Voici les limites de caractères par requête pour chaque modèle :
- Flash v2.5 : accepte jusqu’à 40 000 caractères par requête.
- Flash v2 : accepte jusqu’à 30 000 caractères par requête.
- Multilingual v2 : accepte jusqu’à 10 000 caractères par requête.
- Eleven v3 : accepte jusqu’à 5 000 caractères par requête.
- Eleven v4 : accepte jusqu’à 10 000 caractères par requête.
Tout texte plus long doit être réparti sur plusieurs requêtes. Essayez de découper aux limites des phrases afin de préserver la prosodie à la jonction des segments.
Générez les segments dans l’ordre puis concaténez l’audio. Pour une narration longue où chaque segment est indépendant, les deux éléments s’articulent directement : transmettez la sortie de splitText au pool borné ci-dessus et laissez-le gérer le reste.
Mise en cache et idempotence
La sortie Text to Speech est suffisamment déterministe pour que générer à nouveau le même texte avec la même voix, le même modèle et les mêmes paramètres soit inutile. Mettez le résultat en cache à partir d’un hachage des entrées qui influent sur l’audio ; cette même clé sert aussi de jeton d’idempotence lors des nouvelles tentatives.
Voici comment procéder dans les deux cas.
La règle qui permet ce fonctionnement est que chaque paramètre modifiant l’audio doit figurer dans la clé, y compris outputFormat et les paramètres vocaux. Correctement appliquée, cette même clé fait aussi office de jeton d’idempotence. Lorsqu’un client relance une requête déjà réussie, vous renvoyez les octets mis en cache au lieu de générer à nouveau l’audio.
Gestion des erreurs et limites de débit (erreurs 429)
Un client de production doit relancer les requêtes avec backoff et jitter, et appliquer une gestion adaptée à chaque code d’état, car certains échecs méritent une nouvelle tentative et d’autres non.
Le tableau ci-dessous associe chaque statut à l’action appropriée et explique pourquoi une erreur 429 constitue une limite souple plutôt qu’un mur infranchissable.
Une erreur 429 n’est pas un mur infranchissable ; il est utile d’en comprendre le mécanisme. Lorsque vous dépassez la limite de requêtes simultanées, les requêtes sont d’abord mises en file selon leur priorité, ce qui ajoute généralement environ 50 ms. Vous ne recevez une erreur 429 que si la capacité reste dépassée après cela.
La réponse contient également les en-têtes current-concurrent-requests et maximum-concurrent-requests, qui indiquent votre marge disponible en temps réel. Vous pouvez donc les lire et réduire le rythme avant d’atteindre la limite.
Si vous avez besoin de davantage de marge plutôt que d’un meilleur comportement de relance, effectuez un upgrade de votre forfait. Les clients Enterprise peuvent demander des limites plus élevées via leur responsable de compte.
Comparer la latence et le délai avant réception du premier octet
La latence dépend de votre région, de votre entrée et de la charge actuelle. Le seul chiffre de latence fiable est donc celui que vous mesurez depuis votre propre environnement.
Cette section présente le délai avant réception du premier octet (TTFB) pour le point de terminaison de streaming Flash. Elle est structurée pour vous permettre d’appliquer le même banc de test à un autre fournisseur et de les comparer dans des conditions identiques.
Considérez cela comme une méthodologie, non comme un résultat publié. Une seule exécution ne garantit rien.
Voici quelques points importants lors de l’évaluation de la latence d’une intégration d’API Text to Speech :
- Incluez l’aller-retour réseau : le TTFB dépend de votre position géographique et du cluster le plus proche du fournisseur ; exécutez donc le test depuis l’emplacement habituel de vos serveurs.
- Écartez une exécution de préchauffage : la première requête sur une connexion inactive est plus lente et peut fausser vos mesures.
- Gardez les entrées constantes : la longueur de l’entrée, la voix, le modèle et la charge influencent tous le résultat ; conservez-les identiques d’un fournisseur à l’autre.
- Publiez une distribution : les résultats varient d’une exécution à l’autre ; publiez donc la médiane et le p95 plutôt qu’une valeur unique.
Une fois ces éléments pris en compte, vous êtes prêt à effectuer vos benchmarks.
Pour comparer avec un autre fournisseur, écrivez une fonction de même structure. Exécutez ensuite les deux avec un petit runner qui écarte un appel de préchauffage, collecte environ 20 échantillons chronométrés suffisamment espacés pour qu’ils ne se concurrencent pas, puis calcule la médiane et le p95 en millisecondes.
Une comparaison équitable repose sur le contrôle des variables.
Exécutez les tests des deux fournisseurs depuis la même machine et le même réseau, idéalement un serveur dans la région où vous déployez réellement, plutôt qu’un ordinateur portable connecté à un réseau résidentiel. Utilisez le même texte d’entrée et gardez l’audio court afin que l’inférence du modèle prédomine sur la durée de génération. Indiquez la médiane et le p95 sur un grand nombre d’exécutions, car une mesure unique n’est que du bruit.
Gardez à l’esprit que le TTFB sur l’internet public inclut 20 à 200 ms d’aller-retour réseau, sans rapport avec le modèle. Nous opérons des clusters en Amérique du Nord, en Europe et en Asie du Sud-Est, avec un routage vers le plus proche. Placez donc votre client de test à proximité, sinon vous mesurerez surtout la distance jusqu’au centre de données.
Points clés pour votre intégration de l’API Text to Speech
Une intégration d’API Text to Speech prête pour la production repose sur quelques décisions importantes.
En les prenant correctement, tout le reste s’aligne :
- Choisissez le modèle selon l’usage : utilisez Flash v2.5 pour tout usage interactif, et un modèle à plus haute fidélité comme Multilingual v2 ou Eleven v4 pour le rendu hors ligne, où la latence importe moins.
- Diffusez en streaming dès qu’un utilisateur attend : utilisez le streaming HTTP pour les textes connus et un WebSocket pour les agents, afin que les périodes d’inactivité ne pèsent pas sur votre budget de requêtes simultanées.
- Limitez votre parallélisme à la limite de votre forfait : plafonnez les requêtes simultanées juste en dessous de cette limite et mettez en cache un hachage de chaque paramètre influant sur la sortie, afin que le même audio ne soit jamais facturé deux fois.
- Relancez les erreurs 429 et 5xx avec un backoff exponentiel et un jitter complet : réduisez le rythme en cas de 429 ou de 5xx avec un jitter complet, et surveillez les en-têtes de requêtes simultanées pour savoir à quel point vous êtes proche de la limite.
- Découpez les textes longs aux limites des phrases : découpez aux limites des phrases, dans la limite de caractères de chaque modèle, afin de préserver la prosodie à la jonction.
Pour aller encore plus loin, consultez le guide pratique du streaming, le concept de streaming audio, l’authentification, ainsi que les jetons à usage unique pour une utilisation côté client.
Créez votre intégration Text to Speech avec ElevenAPI
Après avoir lu ce guide, vous disposez de tous les schémas nécessaires à une intégration d’API Text to Speech prête pour la production. Streaming, traitement par lots, mise en cache, nouvelles tentatives et même benchmarking : vous êtes prêt à passer à l’opérationnel.
Commencez par en savoir plus sur l’API Text to Speech ou S’inscrire pour effectuer dès aujourd’hui votre premier appel avec ElevenAPI.
FAQ sur l’intégration de l’API Text to Speech

Tadas Petra est ingénieur en relations développeurs et aide les développeurs à utiliser la suite de produits ElevenLabs. Il est aussi le fondateur de Hungrimind, une plateforme d’apprentissage pour développeurs. Auparavant, il était Lead Developer Advocate chez Agora et formateur chez Zero To Mastery.



