Mesurer l’IA conversationnelle : les indicateurs essentiels de réussite
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les outils d’IA conversationnelle réduisent considérablement le coût d’un service client disponible 24 h/24, 7 j/7. Ils y parviennent sans devoir assurer des horaires de nuit ni prendre les risques liés à la confidentialité des données qu’implique l’externalisation de postes à l’étranger.
Mais ces économies ne comptent que si un agent IA est capable de résoudre les problèmes des clients. Mesurer l’IA conversationnelle à l’aide des bons indicateurs clés de performance permet de savoir si elle fonctionne, en particulier pour les entreprises qui gèrent un volume élevé de demandes clients.
Cet article explique comment l’évaluation du flux conversationnel et de l’exactitude des réponses protège à la fois l’expérience client et votre marque. Nous expliquons comment les équipes chargées de l’expérience client mènent des tests A/B efficaces sur les formules d’accueil des appelants. Vous découvrirez également comment maintenir une plateforme d’IA conversationnelle fiable et multilingue.
En résumé
- Mesurer systématiquement l’IA conversationnelle selon des indicateurs de qualité, d’expérience et d’exploitation fournit les données nécessaires pour préserver l’expérience client.
- Les outils d’évaluation automatisée suivent et améliorent en continu les indicateurs de l’IA conversationnelle à grande échelle, tandis que des évaluateurs humains effectuent régulièrement des contrôles ponctuels.
- Isoler une seule variable à la fois lors des tests A/B permet d’identifier précisément ce qui n’a pas fonctionné, afin de déployer des correctifs qui ciblent directement les problèmes identifiés.
- L’amélioration continue est nécessaire, car les entreprises d’IA mettent fréquemment à jour les modèles sous-jacents, ce qui amène souvent des chatbots auparavant fiables à se comporter différemment en production.
Ce que signifie mesurer l’IA conversationnelle et pourquoi c’est important
Mesurer l’IA conversationnelle consiste à évaluer systématiquement dans quelle mesure vos agents IA testés ou déployés répondent aux demandes des clients et résolvent leurs problèmes. L’objectif est de déterminer l’efficacité avec laquelle vos systèmes automatisés gèrent des conversations à plusieurs tours en conditions réelles, selon les standards de performance que vous avez définis. Ces standards reflètent généralement la capacité des modèles à comprendre l’intention de l’utilisateur, à respecter l’identité de la marque, à fournir des réponses exactes et à résoudre le problème.
Évaluer les modèles peut sembler représenter beaucoup de travail supplémentaire pour un système destiné à réduire la charge de votre équipe. Mais sans évaluation régulière, il est difficile de savoir dans quelle mesure le modèle est performant dans des cas d’usage réels. Autrement dit, vous savez que votre système d’IA réduit les coûts opérationnels du service client, mais pouvez-vous confirmer qu’il satisfait les clients plutôt que de les pousser à chercher d’autres solutions ?
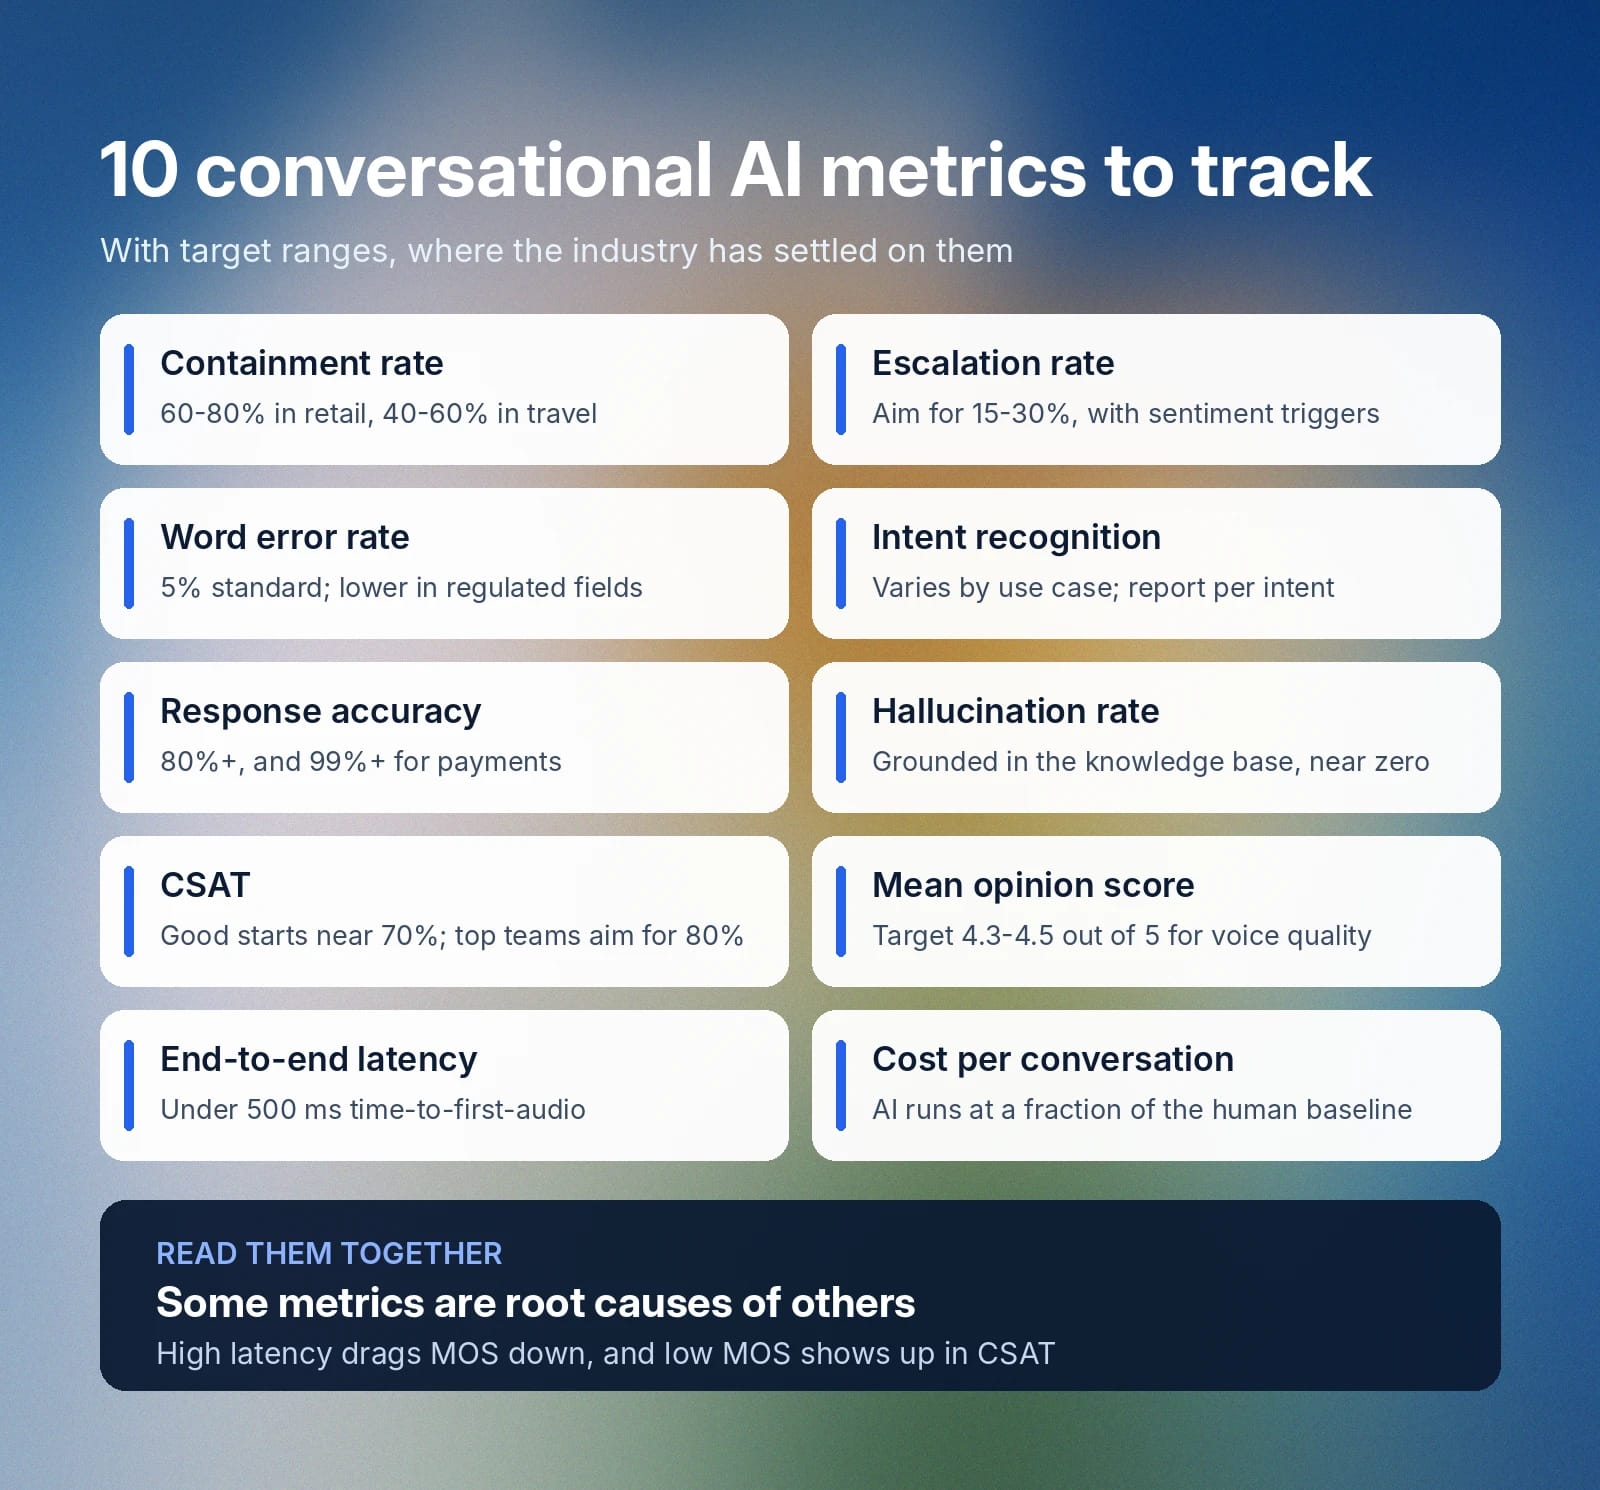
Une mesure complète exige d’évaluer le modèle selon trois grandes catégories :
- Qualité : Évaluez l’exactitude, la cohérence et la pertinence des réponses de l’IA au regard de la demande initiale de l’utilisateur. La question essentielle est la suivante : l’IA fournit-elle les bonnes réponses aux utilisateurs, ou hallucine-t-elle et commet-elle des erreurs ?
- Expérience : Évaluez l’expérience client, notamment la rapidité de réponse de l’IA et le nombre de tours nécessaires pour apporter une réponse satisfaisante. La question essentielle est la suivante : l’expérience paraît-elle naturelle et utile à l’utilisateur, ou robotique et frustrante ?
- Exploitation : Déterminez si le système fonctionne de manière fiable et demeure une solution rentable pour vos besoins de service client. Les questions courantes sont les suivantes : le système offre-t-il une haute disponibilité et génère-t-il le retour sur investissement nécessaire pour justifier son utilisation ?
La réussite ne se définit pas de la même manière pour toutes les équipes, et les difficultés rencontrées avant l’automatisation du support jouent un rôle déterminant. Par exemple, si votre équipe peinait initialement à assurer un service client disponible 24 h/24, 7 j/7, la disponibilité continue des agents IA améliore facilement les performances du service client. Toutefois, chaque catégorie contribue à la réussite globale : un système toujours disponible et rarement défaillant sera peu utile aux clients s’il semble robotique et hallucine des réponses.
Indicateurs clés de l’IA conversationnelle à suivre
Suivez des chiffres clairs et exploitables pour évaluer les performances des agents auprès des clients et déterminer si votre implémentation actuelle génère une réelle valeur métier. L’évaluation continue ouvre aussi la voie à des améliorations régulières. Lorsque vous identifiez précisément les goulets d’étranglement de votre flux de travail ou les ajustements nécessaires, vous disposez des données pour traiter efficacement la cause première.
Utilisez ces indicateurs de l’IA conversationnelle comme point de départ pour évaluer les appels vocaux et les performances des chatbots :
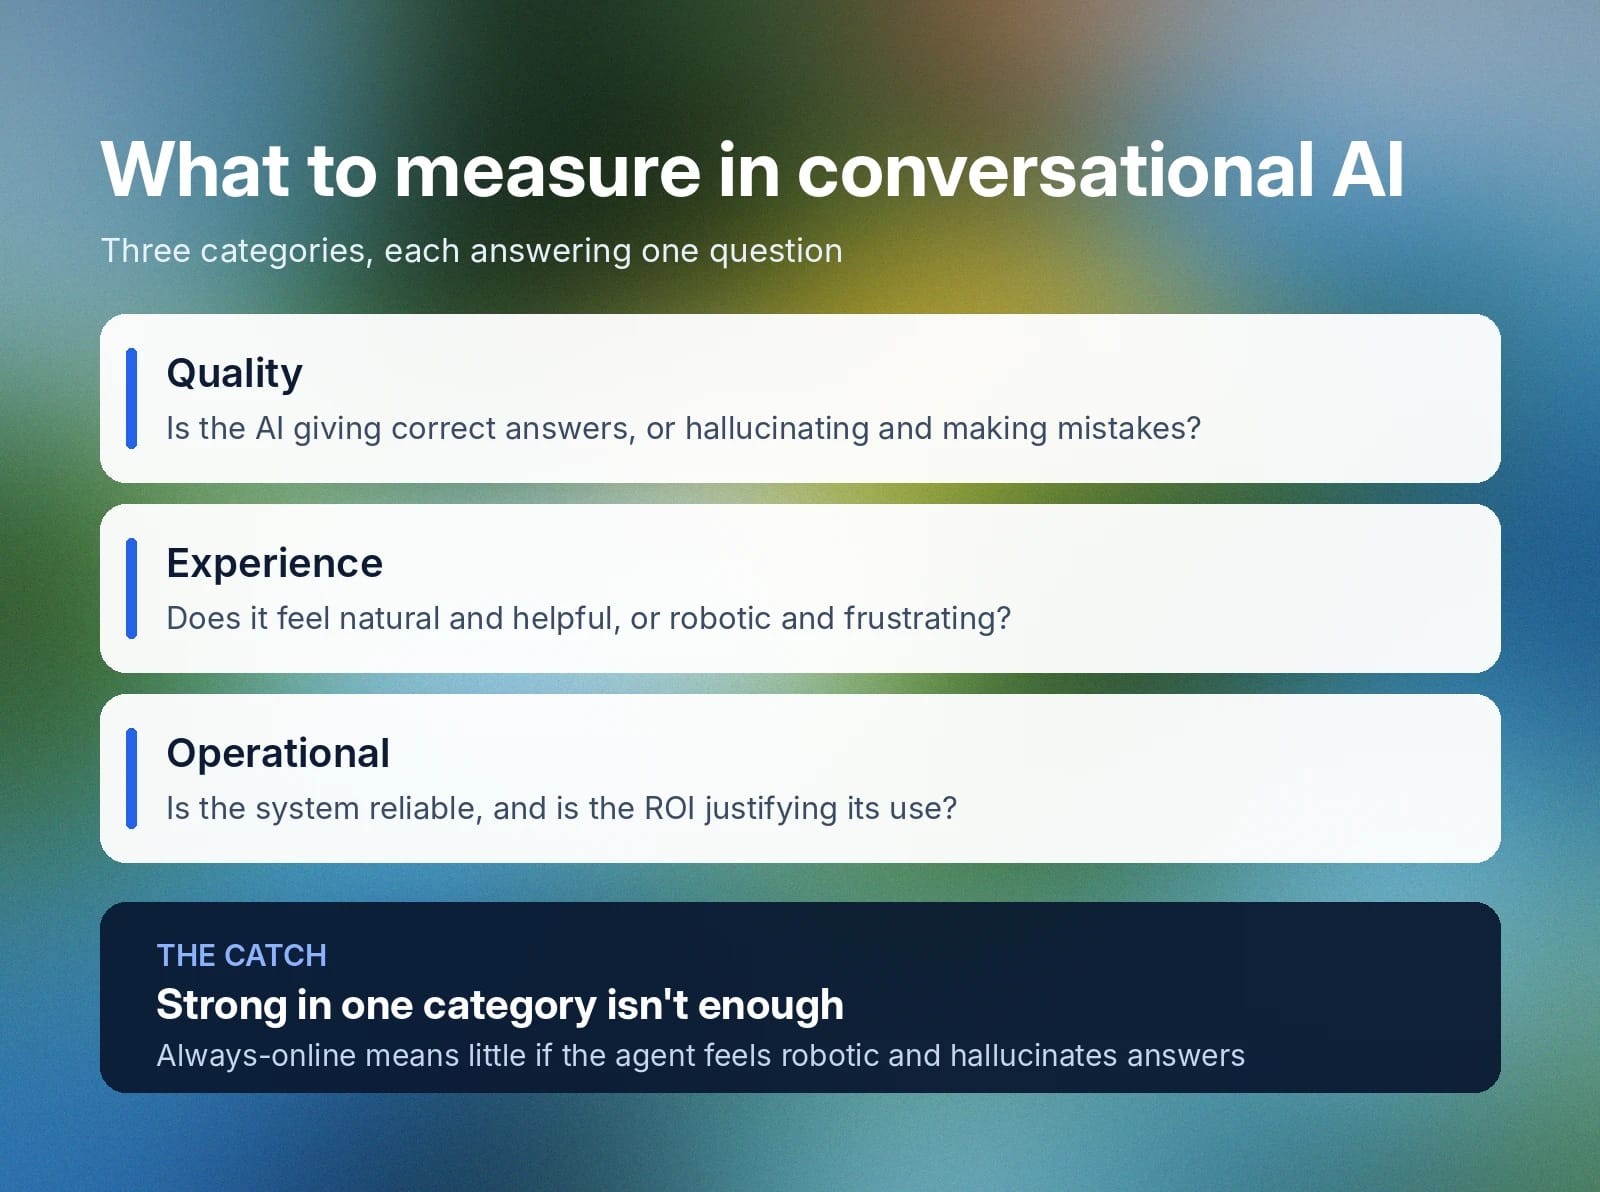
- Taux de résolution automatisée : Suivez le pourcentage de demandes entièrement résolues dans le canal automatisé. Les objectifs varient selon le secteur, le contexte, les cas d’usage et le type de bot. Par exemple, un taux de 60 à 80 % est assez courant dans le commerce de détail, tandis qu’il se situe entre 40 et 60 % pour les sites de voyage.
- Taux d’escalade : Mesurez la fréquence à laquelle les agents IA traitent les appels sans les transférer à un humain. Les entreprises proactives définissent des seuils automatiques pour transférer les appels à des humains dès que le sentiment devient négatif. Un bon taux d’escalade varie selon le secteur et la complexité de la tâche, mais visez entre 15 et 30 %.
- Taux d’erreur de mots (WER) : Suivez la capacité de l’IA à correctement « entendre » les mots lors d’un appel ou d’une transcription. Un bon standard du secteur est de 5 %, mais vous avez besoin d’un WER inférieur pour les cas d’usage dans des secteurs réglementés ou traitant des informations sensibles, comme la santé, la finance et le droit.
- Exactitude de la reconnaissance des intentions : Au-delà des seuls mots, la réussite d’un agent IA commence par une compréhension précise du problème de l’utilisateur et de ses besoins. Les objectifs d’exactitude varient selon le cas d’usage et les catégories d’intention.
- Exactitude des réponses : Déterminez avec quelle fiabilité le modèle fournit des réponses véridiques et utiles. C’est essentiel pour garantir que les clients résolvent leurs problèmes. Les demandes générales de service client exigent un taux de 80 % ou plus, mais les cas d’usage sensibles, comme les paiements, requièrent 99 % ou plus.
- Taux d’hallucination : Étroitement lié à l’exactitude des réponses, ce taux mesure plus précisément leur exactitude factuelle au regard de la base de connaissances. Un faible taux d’hallucination est essentiel pour fournir une aide utile et empêcher les modèles de faire des promesses que l’entreprise ne peut tenir.
- Satisfaction client (CSAT) : Recueillez le sentiment des clients au moyen d’enquêtes après appel afin de mesurer leur satisfaction. Les entreprises collectent ces données sur une échelle de cinq points, mais expriment souvent les résultats en pourcentage. Selon SurveyMonkey, de bons scores CSAT commencent généralement autour de 70 %, certaines entreprises visant 80 % ou plus.
- Score d’opinion moyen (MOS) : Cet indicateur centré sur l’humain utilise lui aussi une échelle de cinq points, mais vise à mesurer le naturel de la réponse de l’IA et la clarté de la voix synthétique. Visez un MOS d’environ 4,3 à 4,5.
- Latence vocale de bout en bout : Mesurez le délai total entre la fin de la demande d’un utilisateur et le moment où l’agent commence à répondre. Les agents prêts pour la production visent un délai de bout en bout jusqu’au premier audio (TTFA) inférieur à 500 millisecondes. Le modèle ElevenLabs Flash v2.5 atteint actuellement une latence d’inférence interne de près de 75 ms. La latence réelle de bout en bout varie selon des facteurs tels que votre localisation et le type de point de terminaison utilisé.
- Coût par conversation : Mesurez le coût total d’exploitation de chaque interaction client automatisée par rapport aux échanges avec un humain. Les conversations ElevenLabs commencent à 10 cents par minute, tandis que le salaire horaire moyen des représentants du service client indique que les conversations humaines coûtent environ 32 cents par minute. Cela représente une économie d’environ 70 %, bien que les prix puissent varier selon le forfait et l’utilisation. Consultez la page des tarifs d’ElevenLabs pour connaître les tarifs actuels.
Lorsque vous choisissez les indicateurs pour mesurer les performances de votre modèle, tenez compte des domaines les plus importants pour votre secteur et votre modèle économique. Par exemple, l’exactitude et la fiabilité factuelle sont particulièrement importantes dans la banque et pour les informations patients, tandis que la latence, le MOS et les taux d’escalade comptent davantage pour les entreprises qui privilégient l’expérience client.
Notez que certains indicateurs expliquent les causes profondes des autres. Par exemple, une latence élevée entraîne probablement un faible score MOS et, par conséquent, une faible satisfaction client exprimée par le CSAT.
Comment mesurer l’exactitude de l’IA conversationnelle
Mesurez l’exactitude du modèle en constituant un jeu de test de vérité terrain à partir d’environ 500 à 1 000 conversations historiques réelles. Les journaux réels capturent des formulations naturelles et imparfaites que les données synthétiques omettent souvent, comme les fautes de frappe, l’argot et les erreurs des utilisateurs. Évaluez ensuite votre système à partir de ces journaux réels selon la reconnaissance des intentions, l’exactitude des réponses et le taux d’hallucination.
Effectuez des évaluations automatisées de ces interactions à l’aide d’une méthode de notation où un LLM agit comme juge. Validez toutefois toujours les scores automatisés par rapport à des systèmes annotés par des humains afin de vérifier leur cohérence. Des évaluateurs humains réalisent ensuite chaque semaine des contrôles ponctuels des performances des chatbots à l’aide d’une grille simple à trois niveaux :
- Correct : La réponse est factuelle, pertinente dans son contexte et répond directement à l’intention principale de l’utilisateur.
- Acceptable : La réponse est techniquement correcte et utile, mais présente quelques problèmes stylistiques mineurs, des formulations maladroites ou une mise en forme qui ne respecte pas l’identité de la marque.
- Incorrect: La réponse doit être corrigée immédiatement, car elle contient des erreurs factuelles, des hallucinations graves ou interprète totalement mal l’intention de l’utilisateur.
Dans l’idéal, évaluez le modèle par intention, car les agents IA réussissent dans certains contextes et échouent complètement dans d’autres. Les chiffres agrégés peuvent masquer des faiblesses critiques dans les domaines les plus performants.
Nous avons simplifié ce flux de travail en intégrant les tests Next Reply (Scenario) directement à nos tests ElevenAgents. La fonctionnalité Next Reply évalue le message de suivi envoyé par un agent plutôt que l’intégralité de la conversation à plusieurs tours. Vous fournissez toutefois l’historique de discussion précédant le point d’évaluation et notez la réponse au regard des standards de politique, de ton et de qualité.
Comment tester les réponses d’une IA conversationnelle avec des tests A/B
Les tests A/B recueillent des retours en conditions réelles afin d’éviter de deviner les préférences des clients. Vous utilisez ensuite ces données empiriques pour ajuster les performances des modèles IA. Après avoir suivi les indicateurs, votre équipe a probablement une liste de changements à apporter ou d’expériences à mener. Mais modifier plusieurs éléments à la fois rend difficile l’identification de ce qui a fonctionné ou non.
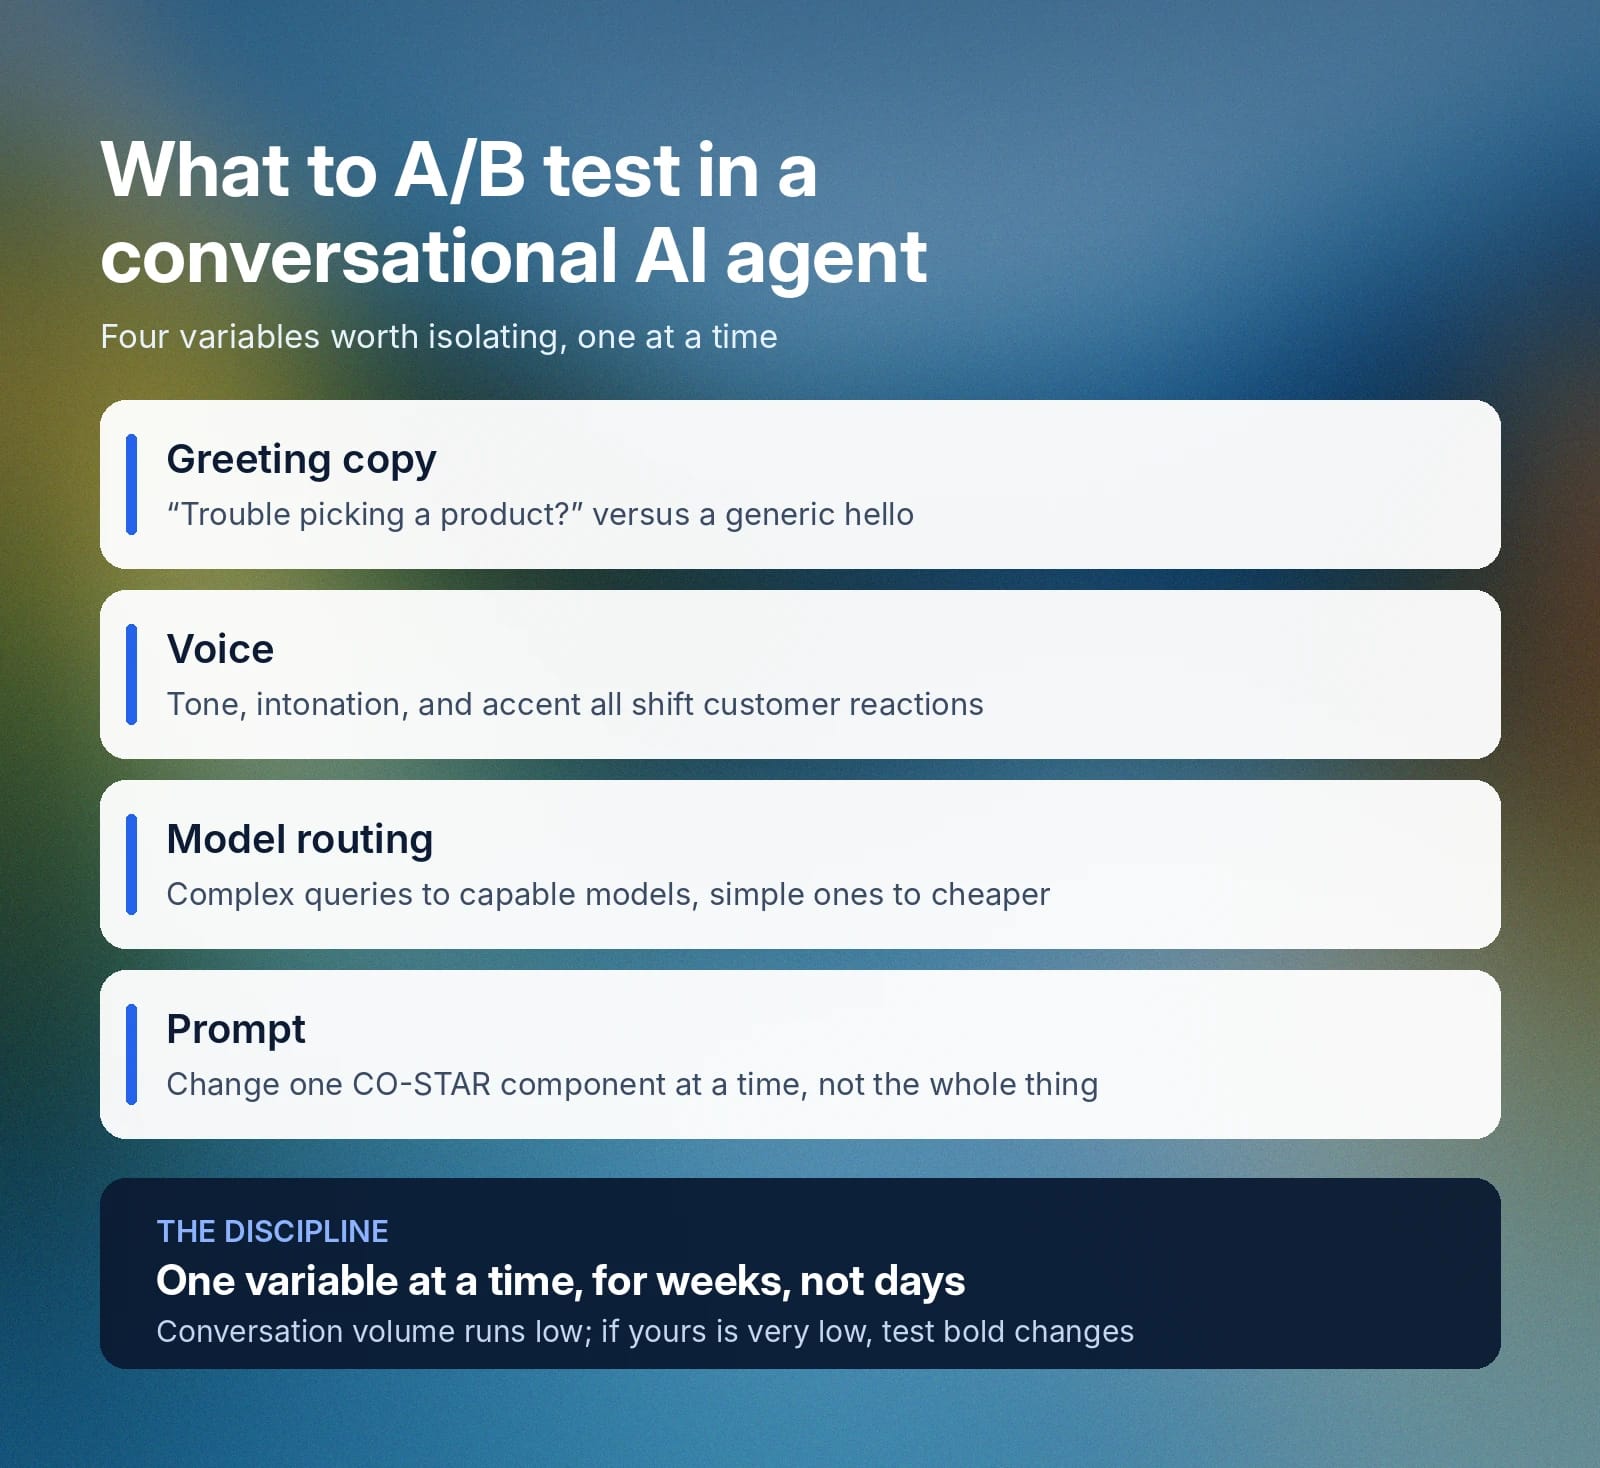
Par conséquent, un test valide exige d’isoler une variable précise à la fois, tout en maintenant le reste de la base de connaissances sous-jacente constant. Les éléments susceptibles de varier comprennent :
- Texte d’accueil : Modifiez le message d’accueil initial pour le rendre plus précis, par exemple : « Bonjour. Vous avez du mal à choisir un produit ? », plutôt que de dire simplement : « Bonjour, comment puis-je vous aider ? »
- Voix : Selon le contexte, les clients peuvent réagir plus favorablement à certaines voix qu’à d’autres en fonction du caractère masculin ou féminin, du ton, de l’intonation et même de l’accent.
- Routage des modèles : Les modèles très performants coûtent généralement plus cher. Une approche efficace et rentable consiste donc à orienter les demandes complexes et simples vers les modèles appropriés.
- Prompt : Les prompts comportent plusieurs composants : ne modifiez donc qu’un aspect à la fois, comme le contexte, l’objectif, le style, le ton, l’audience ou le modèle de réponse (CO-STAR).
Les équipes doivent également ajuster la durée des tests. Le trafic conversationnel est généralement bien inférieur aux consultations de pages web : vous devrez donc exécuter le test pendant des semaines plutôt que des jours pour atteindre une significativité statistique. Si votre volume est extrêmement faible, testez des changements importants et marqués plutôt que des ajustements mineurs.
Un flux de travail opérationnel requiert aussi le versionnage des agents, ainsi que des outils de comparaison et de retour à une version antérieure. Nous les avons intégrés directement à ElevenAgents.
Comment tester un agent d’IA conversationnelle avant son déploiement
Le service client est un point de contact direct avec les personnes qui influent sur vos résultats, et l’IA réagit parfois de façon imprévisible à de petits changements. Testez donc toujours un agent d’IA conversationnelle nouveau ou révisé avant de le lancer en production. Se contenter de « tester au feeling » ne suffit pas.
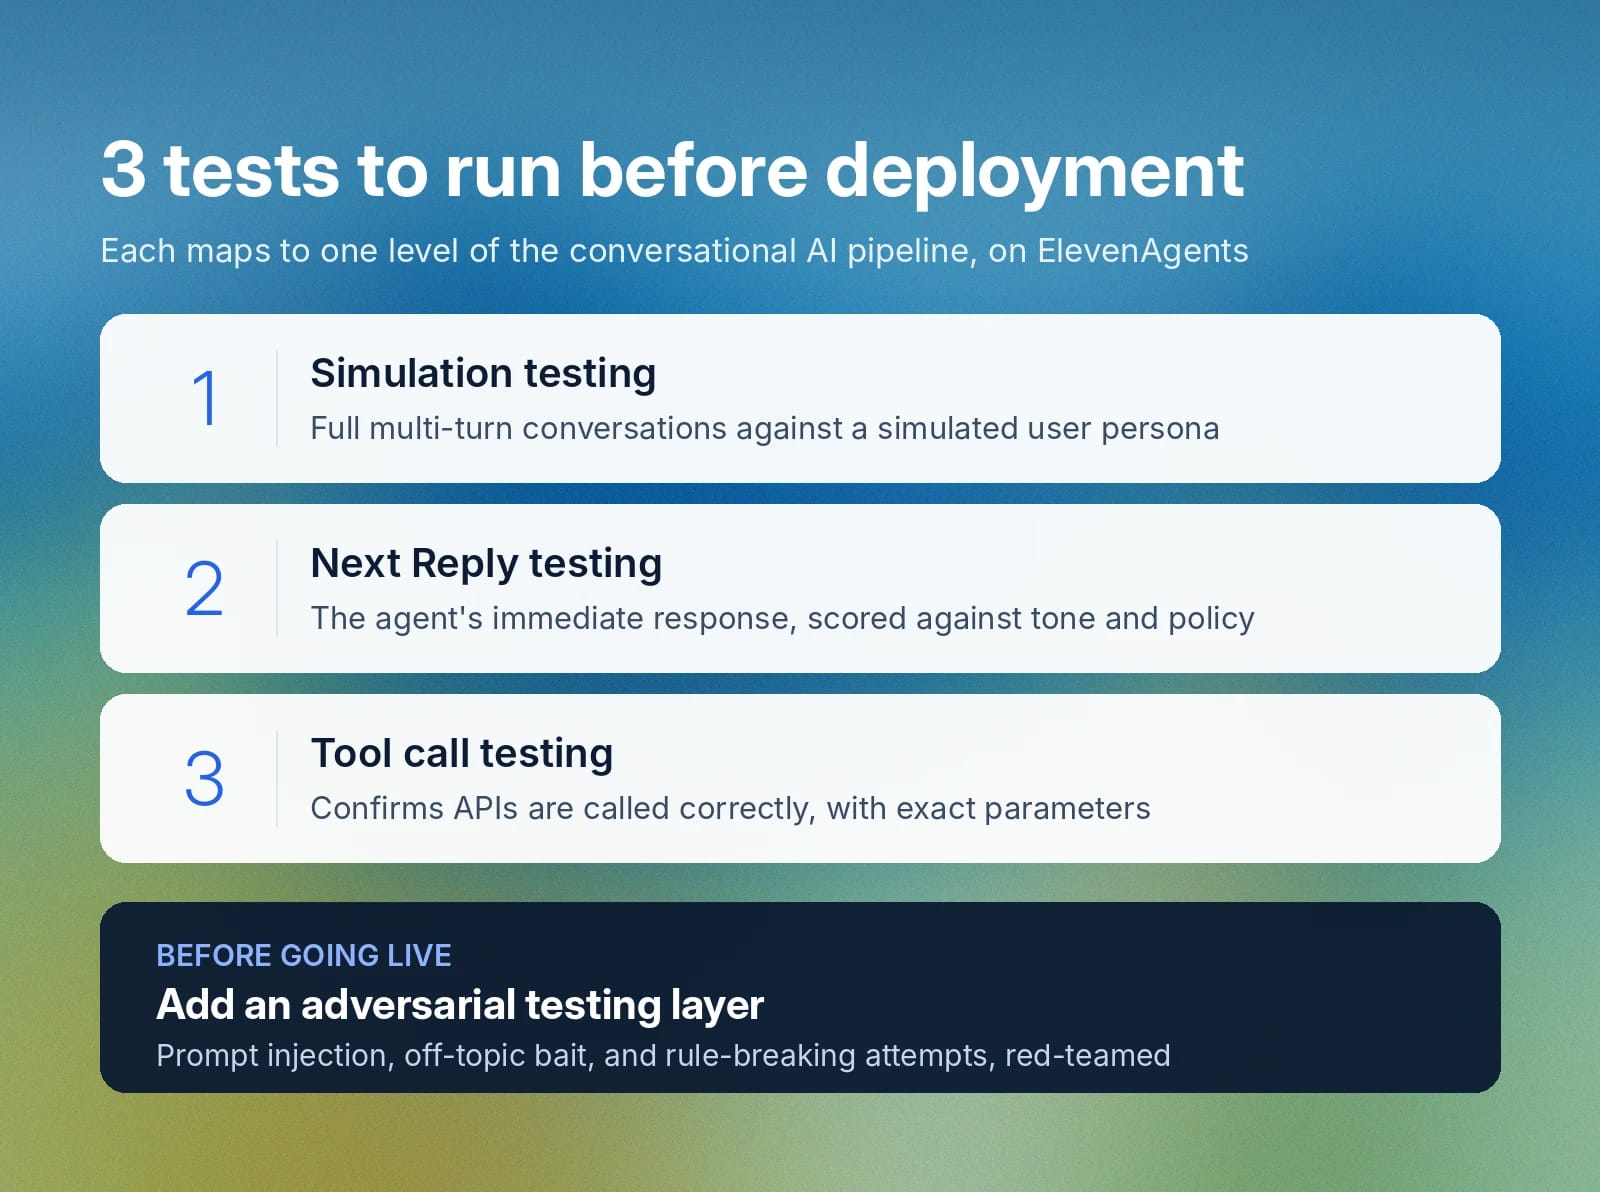
Nous avons conçu notre cadre de test ElevenAgents autour de trois grands types de tests ciblant des niveaux spécifiques de votre pipeline d’IA conversationnelle :
- Test de simulation : Exécute une conversation complète à plusieurs tours avec un utilisateur simulé afin de confirmer que le dialogue atteint les niveaux de performance souhaités.
- Test Next Reply : Teste uniquement les réponses immédiates de l’agent au regard de contraintes précises de ton, de politique ou autres, afin de confirmer leur pertinence et leur exactitude.
- Test d’appel d’outil : Vérifie que les agents appellent correctement les API connectées et transmettent les paramètres exacts nécessaires aux recherches ou transferts sensibles dans des bases de données.
Face au nombre d’attaquants qui tentent de contourner les garde-fous des modèles à des fins malveillantes, vous aurez également besoin d’une couche de tests adversariaux avant la mise en production. Collaborez avec les équipes QA, les ingénieurs prompt et les professionnels de la cybersécurité red team pour tester les injections de prompts, les sollicitations hors sujet et les tentatives de contournement des règles.
Enfin, adoptez un déploiement progressif en lançant des versions pilotes auprès d’un petit groupe d’utilisateurs et en observant leur comportement en conditions réelles. Définissez des critères stricts que le modèle doit remplir avant de l’ouvrir à un groupe plus large ou à l’ensemble de votre clientèle. Désignez une personne responsable pour superviser la mise en production et prévoyez un mécanisme de retour à une version antérieure si un ajustement entraîne une baisse des indicateurs de performance.
Évaluer les performances des chatbots en production
Avant de lancer votre modèle d’IA conversationnelle, définissez ce que signifie la réussite pour chaque cas d’usage. Cela est particulièrement important pour les applications dans des secteurs très réglementés, où l’exactitude et la confidentialité des données répondent à des standards plus élevés et à des exigences plus strictes.
Les réponses automatisées facilitent les tests A/B des modèles à grande échelle, mais des tests objectifs exigent de les associer à la lecture ponctuelle de transcriptions et aux retours de testeurs humains. Les humains dans la boucle détectent les nuances conversationnelles que les modèles IA ne perçoivent pas et les particularités des données qui se perdent autrement dans les chiffres agrégés. Une stratégie d’évaluation complète inclut aussi l’analyse des sentiments et les retours directs des utilisateurs.
L’amélioration continue distingue davantage les systèmes matures qui génèrent un fort retour sur investissement. Là où les concurrents traitent les tests et le suivi comme des tâches séparées, un pipeline mature les combine. Dans ce cas, les échecs en production alimentent directement votre jeu de test afin d’entraîner le prochain agent optimisé.
Des ajustements réguliers deviennent également nécessaires lorsque les entreprises d’IA mettent à jour les modèles de base sur lesquels s’exécute votre agent. Ce changement peut faire qu’un prompt auparavant efficace contribue soudainement à des réponses peu fiables, voire inappropriées.
Nous avons intégré cette boucle de retour directement à notre plateforme. Utilisez nos outils d’analyse des conversations pour automatiser la collecte de données structurées et évaluer facilement le sentiment. Les grandes organisations utilisent aussi notre infrastructure d’IA conversationnelle pour les entreprises afin de gérer et de faire évoluer leurs agents dans le monde entier en toute confiance.
Démarrer avec ElevenAgents pour les indicateurs de service client
Lancer avec succès une IA conversationnelle à grande échelle exige plus que des voix de haute qualité et des modèles à faible latence. Vous avez besoin d’un écosystème intégré pour concevoir, créer, tester, déployer et ajuster des flux de travail multi-agents.
ElevenAgents vous fournit l’infrastructure évolutive dont vous avez besoin. Votre équipe accède à des outils tels que la vérification Next Reply, le suivi des sentiments et la collecte automatique de données afin de suivre et d’optimiser en continu les modèles pour de meilleurs résultats. Mieux encore, vous détectez les régressions avant qu’elles n’atteignent vos clients.
Prêt à simplifier la mesure de l’IA conversationnelle ? Découvrez nos fonctionnalités de test des agents et voyez comment nos équipes entreprise déploient des agents fiables qui améliorent vos indicateurs de service client.
En savoir plus sur ElevenAgents ou s’inscrire pour commencer dès aujourd’hui.
Questions fréquentes sur la mesure de l’IA conversationnelle

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.