Qu’est-ce que la détection d’activité vocale et comment fonctionne-t-elle ?
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
La détection d’activité vocale détermine si de courtes trames audio de quelques millisecondes contiennent de la parole humaine. Elle est utilisée dans de nombreuses applications de traitement audio numérique, notamment la transcription, la téléphonie et les agents vocaux.
Dans cet article, nous examinons ce que fait la détection d’activité vocale, ce qu’elle ne fait pas et son rôle dans les principales applications d’entreprise.
En résumé
- La détection d’activité vocale (VAD) est un composant fondamental des workflows audio modernes. Elle analyse en continu un flux audio et détermine, par oui ou par non, si chaque trame audio de quelques millisecondes contient de la parole humaine.
- La VAD indique aux outils audio en aval quand s’exécuter et quand rester en attente. Elle est utilisée par les LLM, les services de transcription et d’autres pipelines audio d’entreprise.
- Les algorithmes de détection d’activité vocale fonctionnent dans une boucle continue en cinq étapes : capture de l’audio, découpage en trames, extraction des caractéristiques vocales, évaluation de la probabilité de présence de parole et transmission d’une décision aux services en aval.
- À l’origine, la VAD reposait sur le traitement mathématique des signaux pour déterminer, par oui ou par non, la présence de parole. Les systèmes modernes basés sur l’IA utilisent des réseaux neuronaux pour remplir la même fonction, avec une meilleure compréhension contextuelle du bruit de fond et des indices sémantiques.
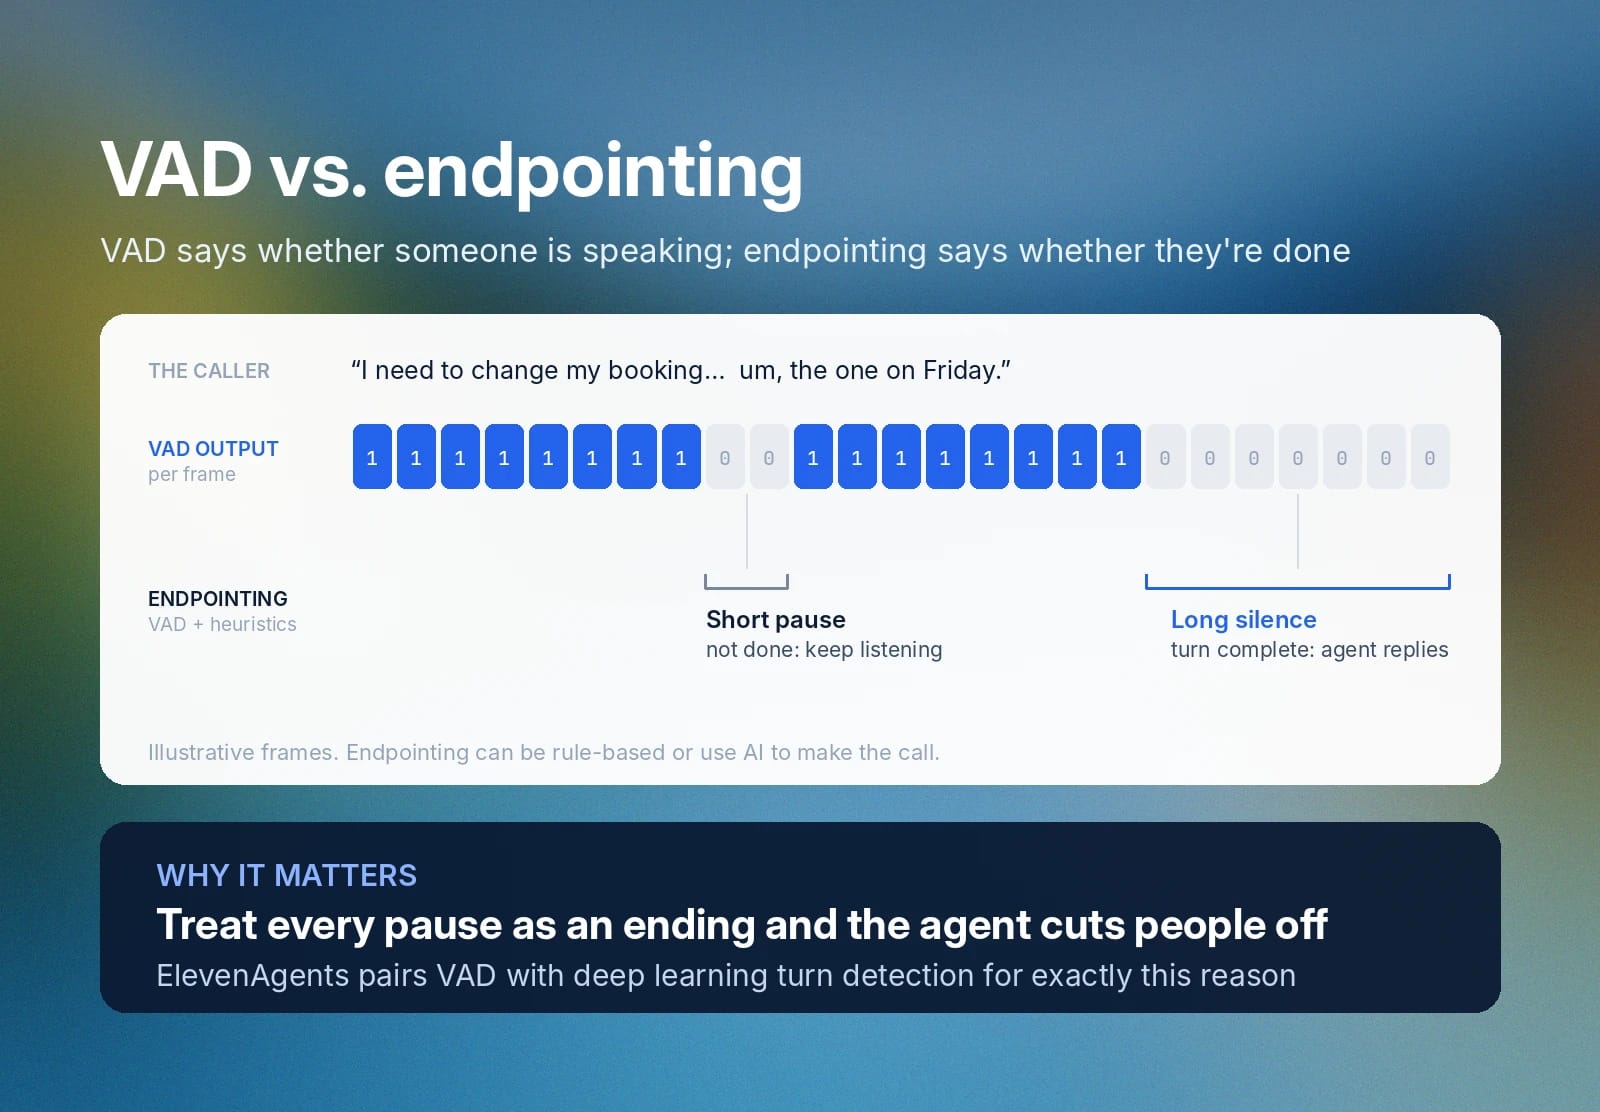
- Les systèmes VAD déterminent uniquement si une trame audio contient de la parole. Ils n’indiquent pas quand une personne a fini de parler. Les systèmes de détection de fin de tour utilisent la VAD et d’autres outils d’analyse heuristique pour déterminer si un locuteur a terminé son propos.
- En entreprise, la VAD aide les agents vocaux à converser naturellement avec les clients sans les interrompre, optimise l’utilisation de la bande passante VoIP, limite les coûts de transcription IA Speech to Text (STT) et répond à d’autres besoins.
- Testez les systèmes VAD dans des conditions réelles. Des enregistrements de studio impeccables ne permettent pas d’évaluer efficacement leurs capacités.
Qu’est-ce que la détection d’activité vocale (VAD) ?
La détection d’activité vocale (VAD) est un processus logiciel qui détermine si de petits segments audio, appelés trames, contiennent de la parole. Les algorithmes VAD s’exécutent des dizaines à des centaines de fois par seconde sur un flux audio et renvoient une réponse binaire, « oui » ou « non », selon qu’ils détectent ou non de la parole.
Elle s’intègre à des pipelines audio numériques plus larges, comme les télécommunications ou la transcription vocale. Elle indique à d’autres systèmes en aval, comme l’ASR/STT, les LLM et les planificateurs de tours de parole, s’ils doivent écouter activement le flux audio ou rester en attente.
La VAD n’est pas la même chose que la reconnaissance automatique de la parole (ASR). Un système VAD se limite à produire une réponse probabiliste par oui ou par non sur la détection de parole. Il ne produit pas les mots eux-mêmes. Sa fonction principale consiste à indiquer aux systèmes en aval s’ils doivent traiter une trame audio donnée.
Comment fonctionnent les algorithmes de détection d’activité vocale ?
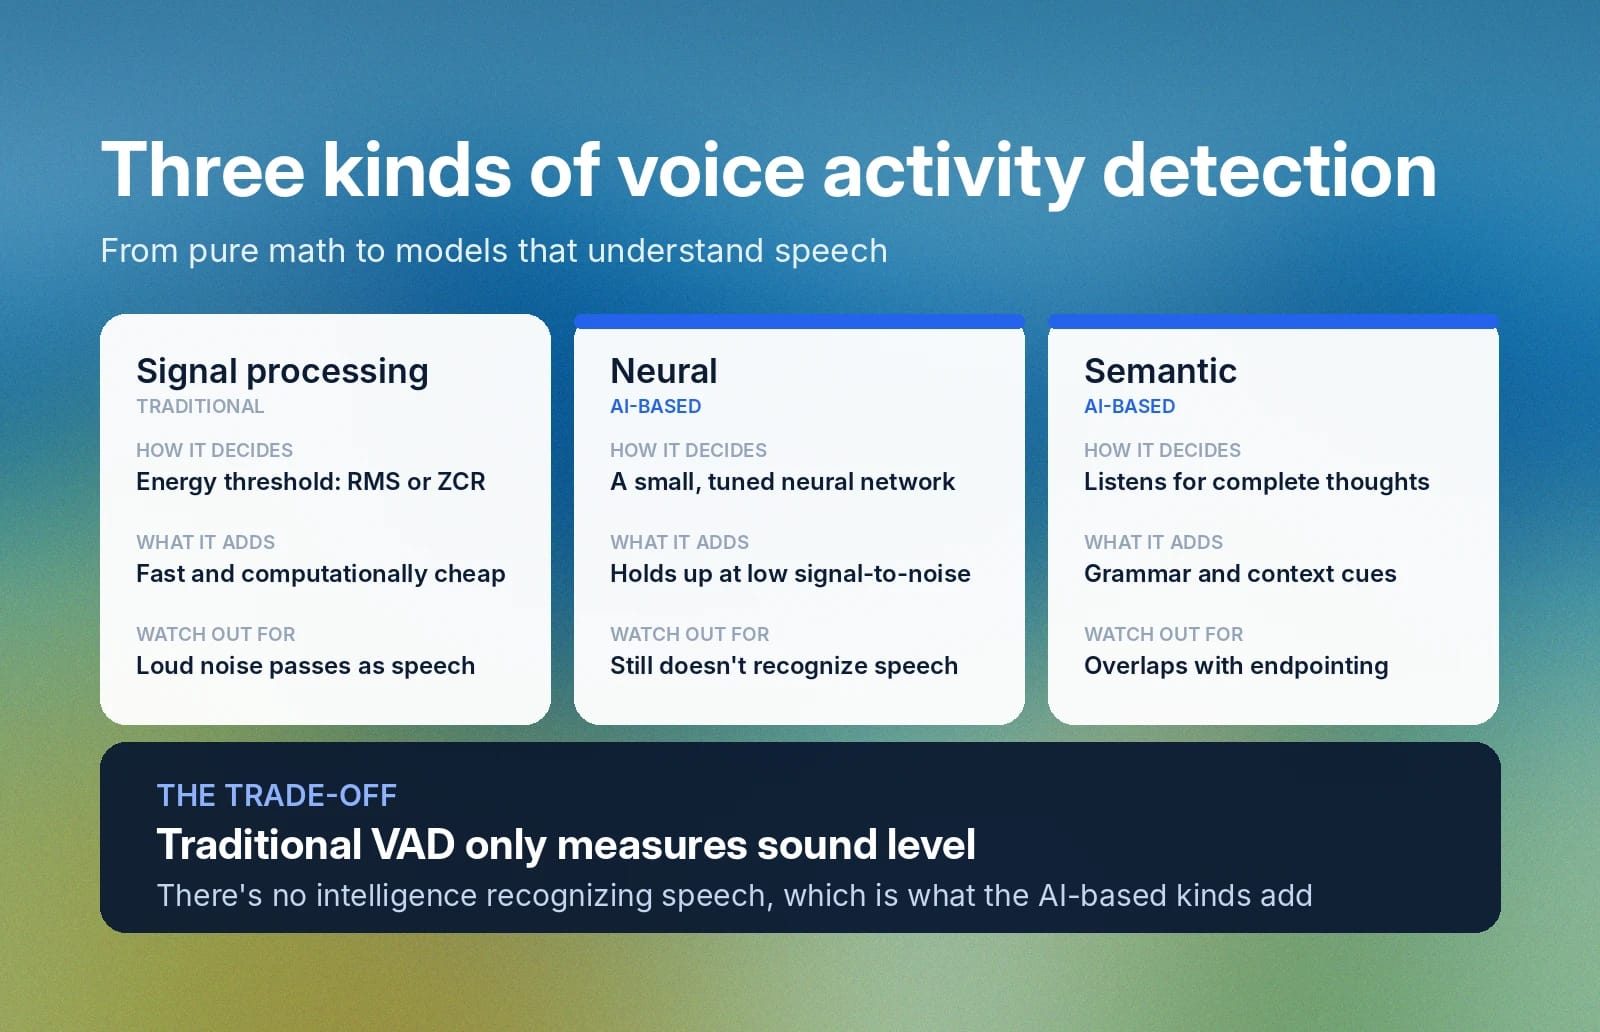
Un algorithme VAD analyse un flux audio et décide, par oui ou par non, si une trame audio donnée, généralement de 10 à 30 millisecondes, contient de la parole.
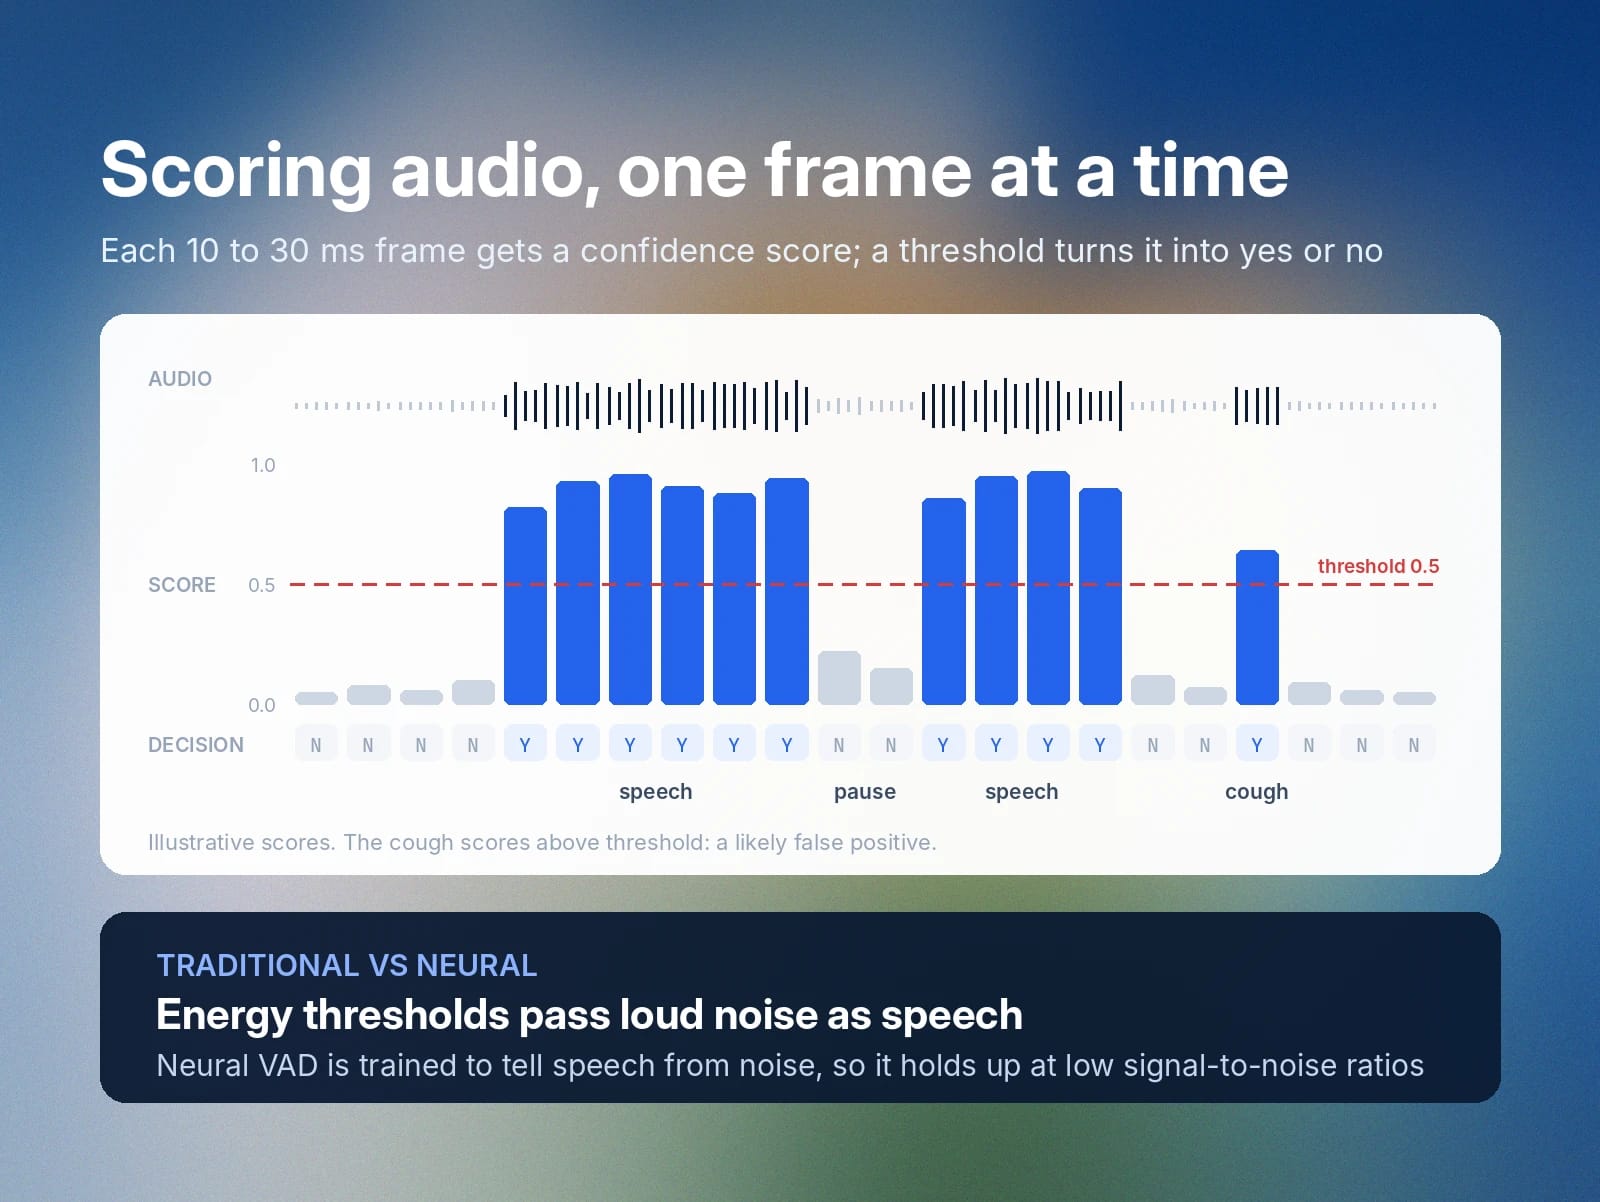
Ils fonctionnent en continu selon une boucle en cinq étapes :
- Capture vocale : le système exécutant la VAD reçoit un flux audio via WebRTC ou la téléphonie et applique un filtrage de base du bruit aux données.
- Découpage en trames : l’algorithme découpe le flux audio brut en trames uniformes.
- Extraction des caractéristiques : l’algorithme extrait du flux des caractéristiques acoustiques qu’il peut représenter mathématiquement sous forme de données numériques.
- Évaluation : le système soumet les caractéristiques extraites d’une trame à l’algorithme VAD afin de générer un score de confiance entre 0 et 1, 0 correspondant à « pas de parole » et 1 à « parole », quant à la présence de parole.
- Décision d’état : le système VAD transmet le score de confiance au pipeline audio dans lequel il s’exécute, afin que celui-ci décide de la manière de le traiter.
Détection d’activité vocale traditionnelle ou basée sur l’IA
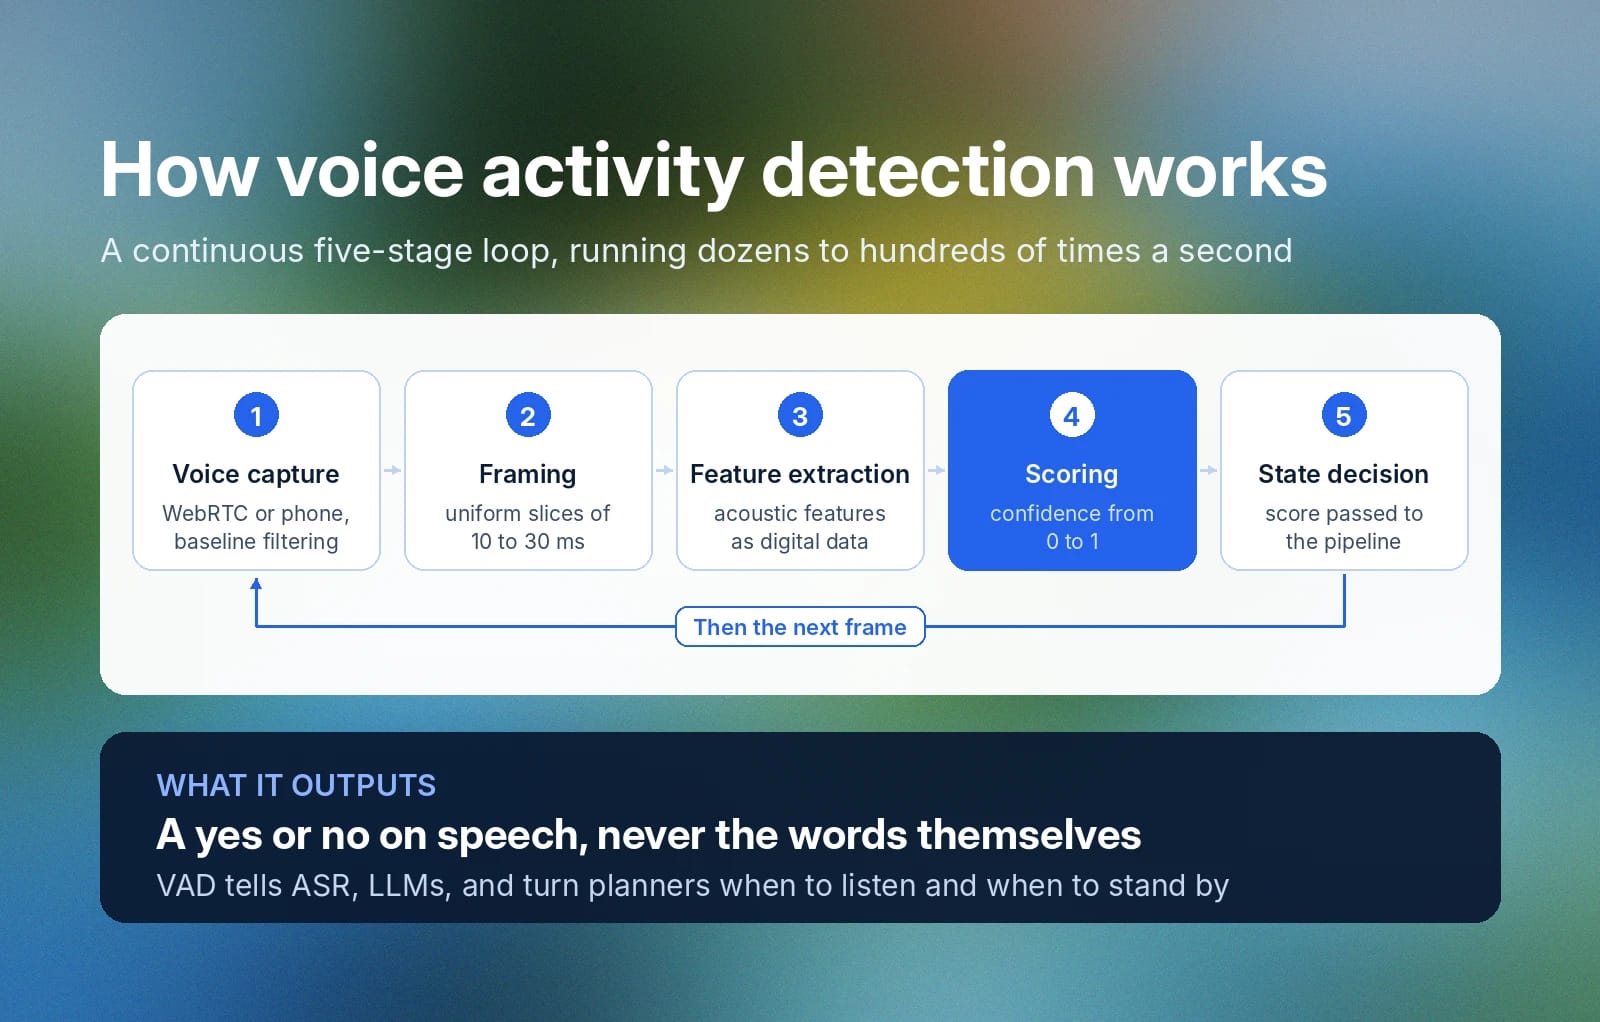
La VAD se divise en deux grandes catégories : le traitement du signal et l’IA.
La VAD basée sur l’IA comprend deux approches distinctes, ce qui porte à trois le nombre total de types de détection d’activité vocale.
Examinons-les plus en détail.
VAD traditionnelle (traitement du signal)
La technologie VAD traditionnelle mesure le niveau d’énergie d’un flux audio et confirme la présence de parole s’il dépasse un certain seuil. Elle repose uniquement sur des calculs mathématiques, souvent de valeur efficace (RMS) ou de taux de passage par zéro (ZCR). Si une trame dépasse le seuil, elle est considérée comme de la parole. Dans le cas contraire, non.
La VAD traditionnelle est rapide et peu coûteuse en ressources de calcul, mais elle ne mesure que le niveau sonore de l’audio. Un bruit de fond important peut provoquer des faux positifs. Elle ne reconnaît pas réellement la parole.
VAD basée sur l’IA
Il existe deux nouveaux types de VAD basée sur l’IA : neuronale et sémantique. Plutôt que d’utiliser un seuil purement mathématique, la VAD neuronale s’appuie sur un petit réseau neuronal hautement optimisé pour déterminer si une trame audio contient de la parole ou du silence. Son entraînement lui permet de distinguer la parole du bruit ; elle est donc plus performante que la VAD traditionnelle lorsque le rapport signal sur bruit (SNR) d’un flux audio est faible, c’est-à-dire en présence d’un bruit de fond important.
L’inconvénient de la VAD neuronale est qu’elle ne reconnaît toujours pas la parole elle-même. La VAD sémantique basée sur l’IA, elle, le fait. Elle recoupe la détection de fin de tour, car elle écoute un flux audio pour évaluer si les propos exprimés sont complets. Elle peut déterminer, sur le plan grammatical et contextuel, si la personne est susceptible de continuer à parler.
VAD et détection de fin de tour
La VAD et la détection de fin de tour sont des technologies complémentaires. Un système de détection d’activité vocale décide simplement si une personne parle dans chaque trame audio qu’il traite. Il prend une décision binaire, par oui ou par non, et la transmet au reste du pipeline de traitement audio.
Un système de détection de fin de tour utilise les résultats de la VAD, associés à une analyse heuristique, pour déterminer si un locuteur a terminé son propos. Il peut s’appuyer sur un traitement du signal fondé sur des règles ou sur l’IA pour prendre cette décision.
Applications de la détection d’activité vocale dans l’IA en temps réel
La détection d’activité vocale est importante dans de nombreux cas d’usage.
Agents vocaux autonomes et centres d’appels
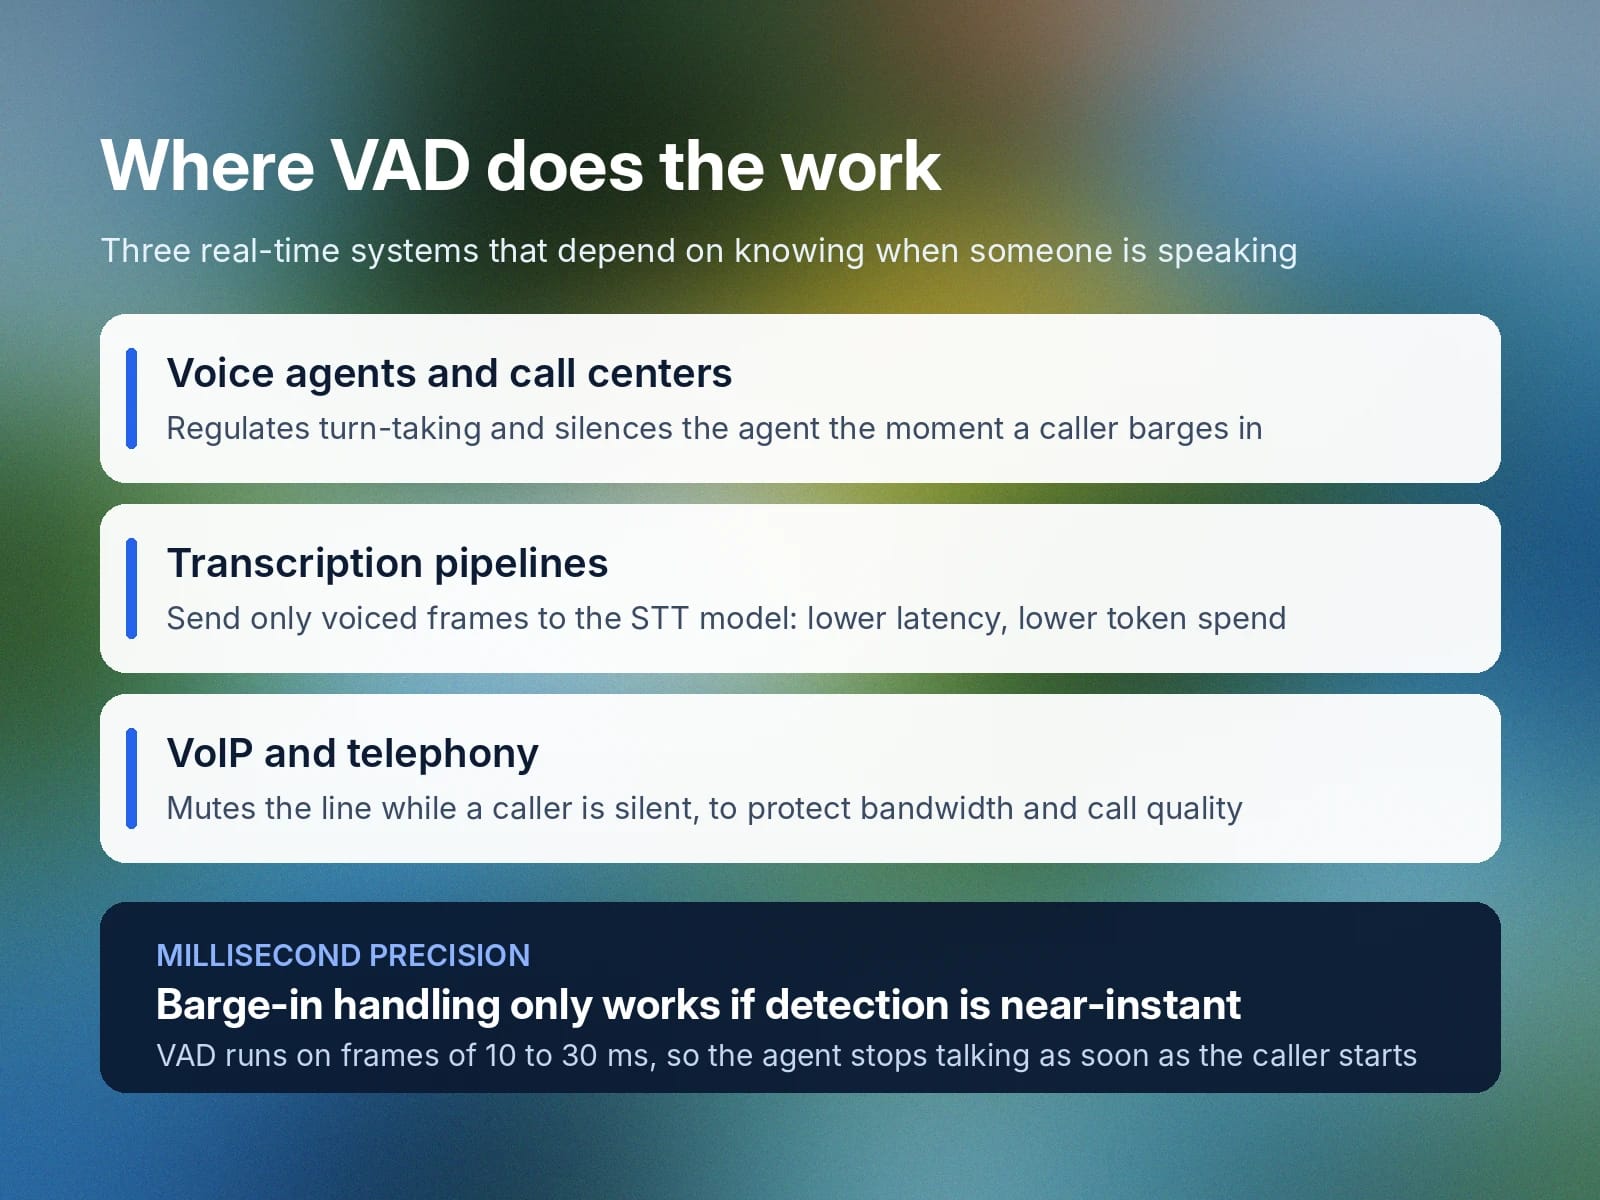
Un agent autonome qui traite les appels clients doit savoir quand il est approprié de répondre. Vous ne voulez pas qu’il interrompe un client au milieu d’une phrase ou qu’il continue à parler par-dessus lui lorsque celui-ci répond avant la fin. La VAD aide à réguler la prise de parole conversationnelle et à maintenir un flux naturel dans l’interaction. Comme elle fonctionne à la milliseconde près, elle gère aussi très efficacement les interruptions du client, en coupant l’agent lorsque le client l’interrompt.
Pipelines de transcription
Si vous utilisez un Speech to Text service d’API de transcription, comme ElevenAPI, vous pouvez filtrer l’audio que vous lui envoyez à l’aide de la détection d’activité vocale afin que le modèle ne traite que les trames contenant de la parole. Cela réduit la latence réseau et, surtout, votre consommation de tokens sur le modèle de transcription. Vous ne dépensez pas de ressources IA pour le bruit de fond.
Optimisation de la VoIP et de la téléphonie
La latence peut également affecter la qualité des appels sur les réseaux VoIP d’entreprise. Pour optimiser les performances, ces systèmes audio numériques coupent temporairement une ligne à l’aide de la VAD lorsqu’un appelant ne parle pas.
Quels sont les défis de la détection d’activité vocale ?
La détection d’activité vocale traditionnelle s’appuie sur des algorithmes mathématiques pour décider si de la parole est présente. Or, les modes d’expression humains sont irréguliers. Les conversations sont souvent hachées, avec des arrêts et des reprises, et se déroulent dans des environnements réels où le bruit de fond et les conversations parallèles sont fréquents. Le principal défi de la VAD est d’identifier les silences significatifs dans un audio bruité.
Cela se traduit par plusieurs défis précis.
Pauses au milieu d’une phrase
Les personnes ne parlent pas à un rythme régulier pendant toute une conversation. Elles font des pauses, rassemblent leurs idées, se reprennent pendant qu’elles parlent et perdent le fil de leur pensée. Aucune de ces pauses ne signifie qu’un locuteur a fini de parler. Les auditeurs humains le comprennent généralement facilement, mais cela peut être difficile pour les logiciels, y compris les modèles IA les plus récents.
Lorsque les systèmes VAD confondent ces pauses avec une fin de parole, ils peuvent couper une phrase au cours d’une transaction ou amener un agent vocal à interrompre un interlocuteur humain.
Bruits vocaux
Une parole faible, des consonnes finales décroissantes, fréquentes en fin de phrase, et des caractéristiques comme la voix craquée peuvent amener les systèmes VAD à manquer de la parole légitime.
Acoustique imprévisible
Un bruit blanc de fond continu, comme un ventilateur ou de l’eau qui coule, est relativement facile à filtrer pour les systèmes VAD. En revanche, un bruit sporadique, comme un chien qui aboie, peut être signalé à tort comme de la parole.
Une forte compression audio réduit la plage dynamique et peut compliquer la différenciation, par la VAD, entre les trames silencieuses et les trames contenant de la parole.
Comment évaluer les performances de la VAD
La parole humaine est irrégulière, en particulier lorsqu’elle est enregistrée dans des environnements dynamiques et réels. Des enregistrements audio impeccables ne constituent pas une bonne méthode pour tester les performances de la VAD. La précision pure de la transcription Speech to Text ne mesure pas non plus directement l’efficacité d’un système VAD, car elle intervient après ce que la VAD détecte.
Faux positifs et faux négatifs
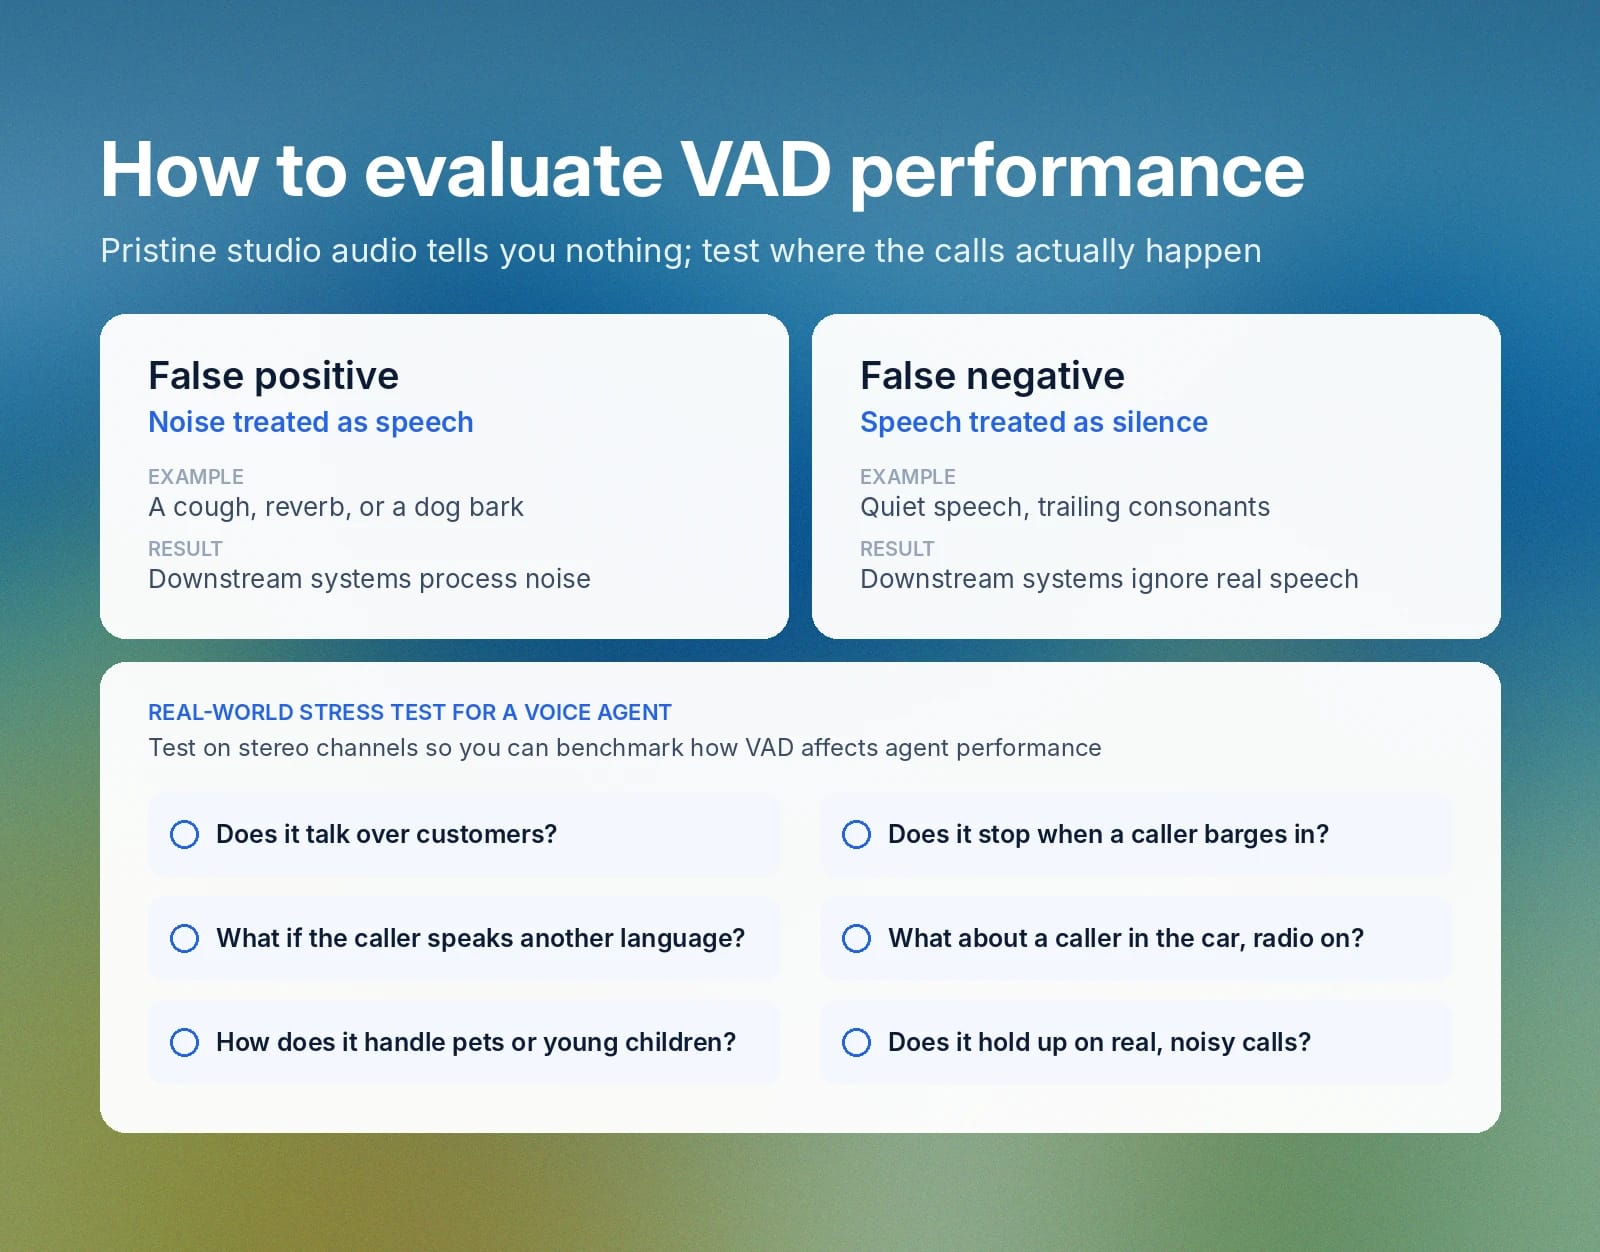
Les faux positifs de la VAD correspondent à du bruit traité comme de la parole. Une toux, de la réverbération, l’aboiement d’un chien ou tout autre bruit de fond soudain peuvent les déclencher et être transmis par inadvertance comme des trames de parole.
Les faux négatifs correspondent à de la parole traitée comme du silence. La VAD indique alors par erreur aux services en aval d’ignorer les trames audio.
Tests de résistance en conditions réelles
Pour évaluer un service VAD, vous devez observer ses performances dans les environnements où l’audio sera enregistré et dans des conditions réelles.
Par exemple, si vous comptez utiliser la VAD pour un agent vocal, testez-la avec des canaux stéréo afin de mesurer son impact sur les performances de l’agent. Voici quelques questions à examiner :
- Des faux négatifs l’amènent-ils à parler par-dessus les clients ?
- Empêche-t-elle l’agent de parler lorsqu’un utilisateur l’interrompt ?
- Que se passe-t-il si l’appelant parle une langue étrangère ?
- Comment fonctionne-t-elle avec des locuteurs qui appellent depuis des environnements réels ?
- Que se passe-t-il lorsqu’un client appelle depuis sa voiture sans baisser le volume de sa radio ?
- Comment gère-t-elle le bruit de fond causé par les animaux domestiques ou les jeunes enfants ?
Toutes ces conditions sont susceptibles de se présenter lors d’appels clients. La VAD doit résister à ces contraintes et rester performante.
Commencez avec ElevenAgents pour le service client
ElevenAgents utilise un système hybride de VAD et de détection des tours de parole par apprentissage profond pour des conversations agentiques fluides et naturelles.
Commencez dès aujourd’hui à créer un nouvel agent de service client avec ElevenAgents. S'inscrire pour commencer.
FAQ

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.