Scribe v2 Medical est désormais accessible à tous
- Rédigé par
- Min Kim
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
L’audio clinique constitue l’un des défis les plus exigeants pour une reconnaissance vocale précise. Les noms de médicaments sont longs, rares et faciles à confondre, l’hydroxyzine et l’hydralazine ne se distinguant que par une syllabe mal entendue. Le vocabulaire est dense, avec des posologies, des unités et des termes d’anatomie et de pathologie qui peuvent s’enchaîner rapidement. L’enjeu est également plus important, car une erreur de transcription peut se retrouver dans le dossier d’un patient.
C’est pourquoi ElevenLabs lance aujourd’hui Scribe v2 Medical, notre modèle Speech to Text affiné pour l’audio clinique, désormais disponible pour tous sur ElevenAPI. Dans les évaluations présentées ci-dessous, il affiche systématiquement l’un des taux d’erreur par mot (WER) les plus faibles parmi les modèles comparés et réduit le WER sur l’audio clinique d’environ 35 % par rapport à notre modèle Scribe v2 de base.
Les modèles généralistes gèrent efficacement la parole du quotidien, mais leurs performances peuvent se dégrader là où les flux de travail cliniques en ont le plus besoin. Nous avons entraîné une version médicale affinée de Scribe v2 axée sur les noms de médicaments et la dictée clinique, à partir de benchmarks publics que chacun peut reproduire.
Scribe v2 Medical est optimisé pour les cas d’usage cliniques
Dictée clinique (MedDictate)
MedDictate de Corti évalue la transcription de notes cliniques dictées, comprenant des noms de médicaments, des posologies et des unités qui s’enchaînent en anglais, en français et en allemand. Lors de notre évaluation, Scribe v2 Medical obtient le WER global le plus faible parmi les modèles testés, et un WER inférieur d’environ 35 % à celui de Scribe v2 de base.
Modèle | EN | FR | DE | WER global |
Scribe v2 Medical | 3,0 % | 8,3 % | 7,2 % | 4,9 % |
OpenAI GPT Transcribe | 3,9 % | 7,8 % | 9,6 % | 5,9 % |
Scribe v2 (base) | 5,0 % | 10,7 % | 11,7 % | 7,6 % |
Muse Voice Transcribe 1.0 | 4,5 % | 11,0 % | 13,3 % | 7,8 % |
Deepgram Nova-3 Medical* | 5,5 % | - | - | - |
*Anglais uniquement (24 extraits) : Deepgram Nova-3 Medical ne prend pas en charge le français ni l’allemand.
Terminologie médicale (MedTerm)
MedTerm est également un jeu de données publié par Corti. Il comprend un benchmark de terminologie clinique de 600 échantillons dans les mêmes trois langues, dont les termes médicaux sont annotés dans chaque échantillon. Cette annotation permet d’évaluer les modèles selon deux dimensions, au-delà du WER de la transcription complète. Le rappel des termes correspond au pourcentage de termes médicaux annotés qui apparaissent correctement dans la transcription, un score plus élevé étant préférable. Le Term-WER est le taux d’erreur sur ces seuls termes, sans tenir compte de la parole ordinaire qui les entoure, un score plus faible étant préférable.
Scribe v2 Medical arrive en tête de tous les modèles testés sur les deux dimensions, ainsi que de tous les autres fournisseurs dans les trois langues :
Modèle | Rappel des termes ↑ | WER des termes ↓ |
Scribe v2 Medical | 77,7 % | 10,4 % |
Scribe v2 (base) | 77,1 % | 10,7 % |
OpenAI GPT Transcribe | 74,0 % | 12,3 % |
Muse Voice Transcribe 1.0 | 73,4 % | 12,9 % |
Deepgram Nova-3 Medical* | 72,5 % | 13,6 % |
Benchmark Eka Medical ASR
Le benchmark Eka Medical ASR comprend 3 619 échantillons audio cliniques en anglais, couvrant des noms isolés de médicaments et d’affections, des phrases cliniques et des conversations entre cliniciens et patients, avec des annotations par terme et un classement publié sur la fiche du jeu de données.
Le jeu de données publié incluant des modèles plus anciens tels que Gemini 2.5 Flash et GPT-4o, nous avons effectué l’évaluation avec des modèles plus récents. Le SemWER, ou WER sémantique, mesure si le modèle a entendu le bon contenu, indépendamment de la mise en forme, « mg » et « milligrammes » étant comptabilisés comme la même réponse. Le kwWER, ou WER par mot-clé, applique la même évaluation aux seuls mots-clés médicaux annotés.
Modèle | semWER | kwWER |
Scribe v2 Medical | 6,50 % | 6,02 % |
Scribe v2 (base) | 7,35 % | 7,04 % |
Deepgram Nova-3 Medical | 7,79 % | 7,65 % |
Muse Voice Transcribe 1.0 | 8,85 % | 8,99 % |
OpenAI GPT Transcribe | 13,90 % | 13,20 % |
Eka annote les termes médicaux de chaque échantillon, ce qui permet d’évaluer plus finement les gains de Scribe v2 Medical par rapport au modèle de base sur les seuls termes médicaux. Scribe v2 Medical commet 15 % d’erreurs en moins que le modèle de base (9,5 % contre 11,1 %), et les gains sont les plus importants lorsque les termes apparaissent dans des phrases cliniques complètes (7,5 % contre 9,9 %).
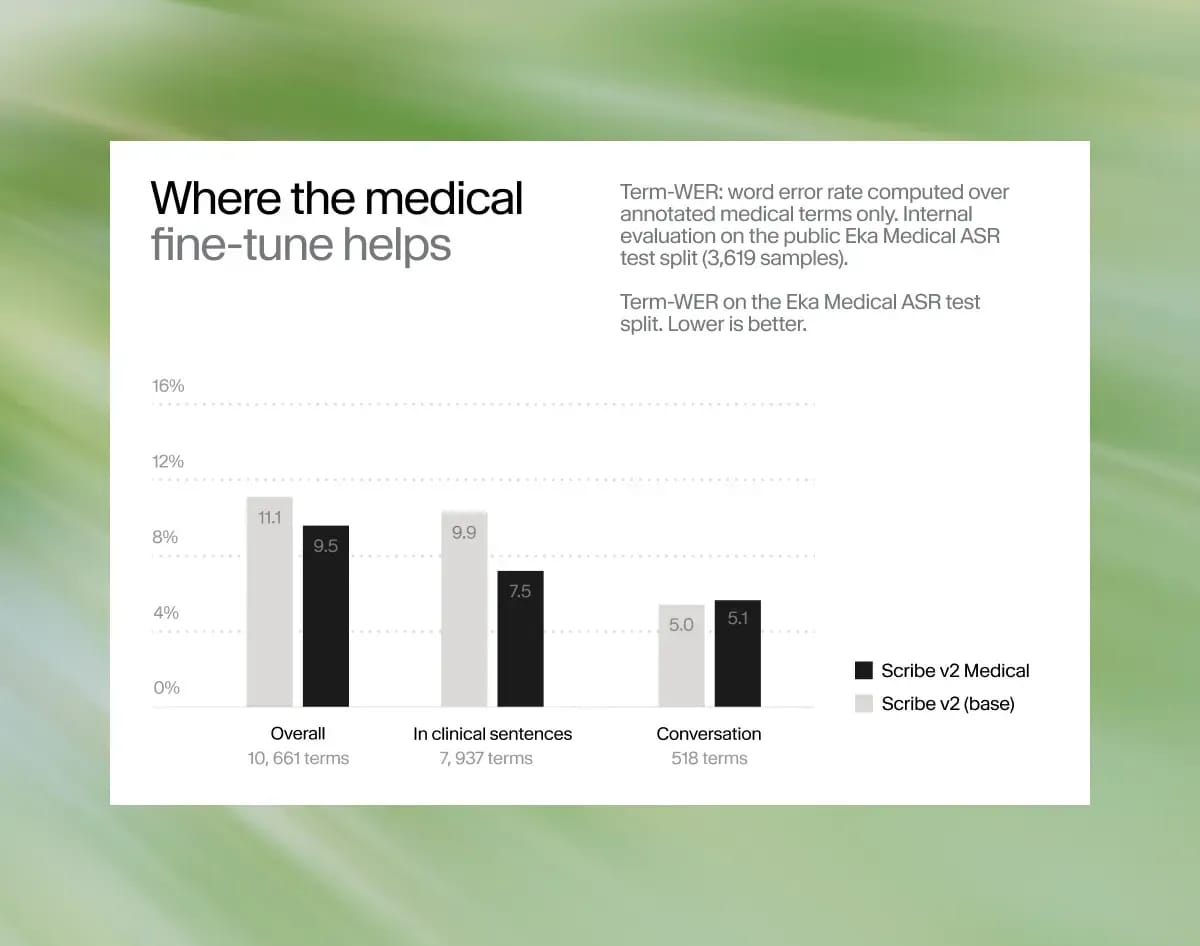
Ces mêmes données révèlent toutefois que les extraits isolés d’un seul mot, soit un nom de médicament prononcé sans aucun contexte, restent le cas le plus difficile pour tous les modèles du classement, y compris Scribe v2 Medical. Il obtient un WER de 14,3 % sur les termes isolés, contre 7,5 % lorsque ces termes apparaissent dans des phrases. Sans aucun contexte, une syllabe mal entendue peut entraîner des erreurs frappantes :
- etodolac (un AINS) → « It’ll do the luck »
- levomilnacipran (un antidépresseur) → « Leave me alone now, Sephora. »
- methdilazine (un antihistaminique) → « Let’s play our scene. »
Pour réduire ces erreurs, vous pouvez recourir au invites de termes clés, qui permet de mettre en avant des noms de médicaments ou des expressions médicales afin d’orienter le modèle vers leur transcription correcte.
Des clients en production
Des clients utilisent déjà Scribe v2 Medical en production et constatent des améliorations sur l’audio clinique.
« Depuis notre passage de Deepgram à ElevenLabs Scribe v2 Medical, nous constatons une précision bien supérieure sur la terminologie clinique, ce qui a transformé la manière dont l’équipe travaille », déclare Mendel Erlenwein, PDG et fondateur de CareCo. « Lorsque nos coordinateurs font confiance aux transcriptions, ils consacrent moins de temps à corriger les notes et davantage de temps au téléphone avec les patients. Nos patients suivent des traitements complexes, et les notes lues par l’équipe soignante doivent être exactes. »
De solides performances sur la parole générale
L’équipe a également vérifié que l’affinage médical ne dégrade pas les performances dans d’autres domaines. Sur 6 000 échantillons de parole quotidienne non médicale issus de Common Voice, Scribe v2 Medical obtient, après arrondi, le même score que Scribe v2 de base : un WER de 5,3 % dans les deux cas. Avec v2 Medical, vous bénéficiez donc d’un modèle médical spécialisé sans sacrifier la précision sur ce benchmark.
Conçu pour les informations de santé protégées
Scribe v2 Medical est éligible HIPAA pour les clients Enterprise disposant d’un Business Associate Agreement et ayant activé le Mode zéro rétention (ZRM).
Lorsque le ZRM est activé pour les requêtes de l’API Speech to Text, l’entrée audio et la sortie texte sont supprimées immédiatement après la fin de chaque requête. ElevenLabs ne conserve ni l’une ni l’autre, et votre application reçoit la réponse complète de l’API tout en contrôlant la conservation des transcriptions.
Premiers pas
Scribe v2 Medical est disponible sur l’API Speech to Text. Il vous suffit de transmettre le nouvel identifiant de modèle : scribe_v2_medical
Le modèle fonctionne sur le point de terminaison Speech to Text par lot.