Voice-KI-Infrastruktur: Der Stack 2026 erklärt
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Voice-KI-Infrastruktur umfasst Modelle, Verbindungen, Tools und Dienste, mit denen ein KI-Agent einem Anruf zuhören, entscheiden, was zu tun ist, Aktionen in anderen Systemen ausführen und laut antworten kann. Bei führenden Anbietern wie ElevenLabs geschieht das alles in Sekundenbruchteilen.
Ein produktiver Voice Agent basiert auf mehreren Ebenen: Spracherkennung, Sprecherwechsel, großes Sprachmodell, Orchestrierung, Tools, Wissensabruf, Sprachsynthese, Telefonie und Monitoring.
Dieser Leitfaden erklärt die KI-Agentenarchitektur hinter einem funktionierenden Voice Agent. Jeder Abschnitt beschreibt die Aufgabe einer Ebene, ihre Bedeutung für die umfassendere Infrastruktur und die Umsetzung durch ElevenAgents – mit Eleven v4 als Beispiel für die Stimmebene.
So fügt sich Voice-KI-Infrastruktur zusammen
Ein Voice Agent wandelt Audio in Text um, verarbeitet diese Eingabe, generiert eine Antwort und verwandelt sie wieder in Audio, das der Kunde hört. Diese Abfolge von Aktionen besteht aus einem robusten Stack der KI-Agentenarchitektur.
Dies sind die wichtigsten Ebenen der Voice-KI-Infrastruktur im Jahr 2026:
- Spracherkennung: Die Automatic Speech Recognition-Technologie (ASR) wandelt das Audio des Anrufers zur Verarbeitung in Text um.
- Sprecherwechsel: Turn Taking entscheidet, wann der Anrufer fertig ist und wann nicht mehr gesprochen werden soll. So entstehen flüssigere, reaktionsfähige Gespräche.
- Sprachmodell(e): Interpretiert die transkribierte Anfrage und generiert nach Abruf des nötigen Kontexts eine Antwort.
- Orchestrierung: Eine KI-Orchestrierungsebene leitet das Gespräch zwischen Prompts, Subagenten, Tools und Menschen weiter.
- Tools und MCP: Verbinden den Agenten mit externen Systemen wie CRM-Plattformen oder Contact Centern, um Aufgaben auszuführen.
- Wissen und Gedächtnis: Stellen Fakten und Anruferkontext über Retrieval Augmented Generation bereit.
- Sprachsynthese: Nutzt Text to Speech, um die generierte Textantwort in Audio umzuwandeln.
- Transport und Telefonie: Überträgt Audio zwischen Agent und Anrufer.
- Guardrails, Tests und Monitoring: Halten den Agenten bei seiner Aufgabe und messbar.
Zusammen ermöglichen diese Komponenten Echtzeitgespräche zwischen KI-Agenten und anrufenden Kunden.
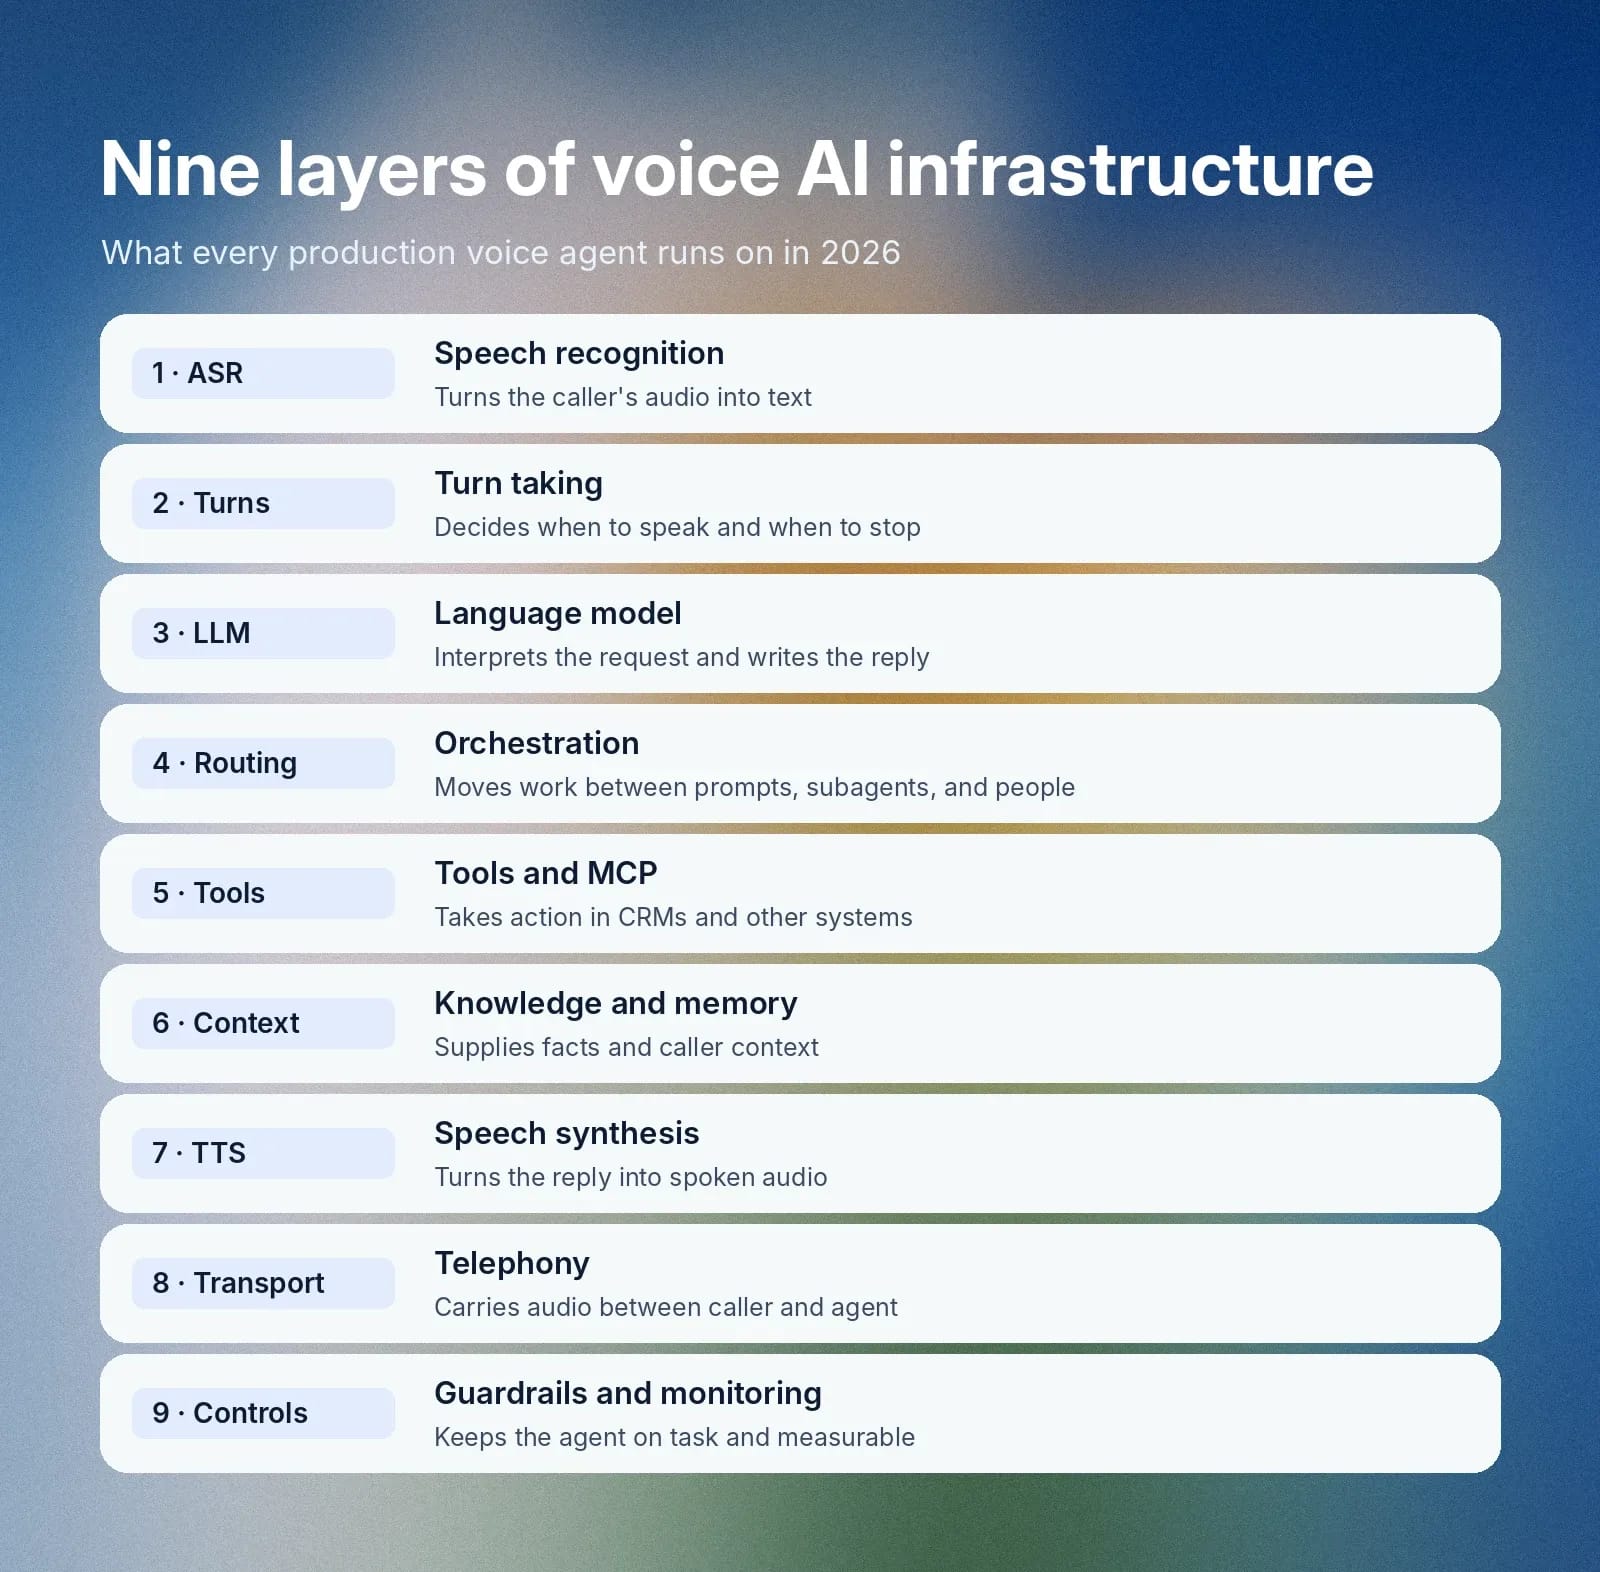
Diagramm der Voice-KI-Architektur
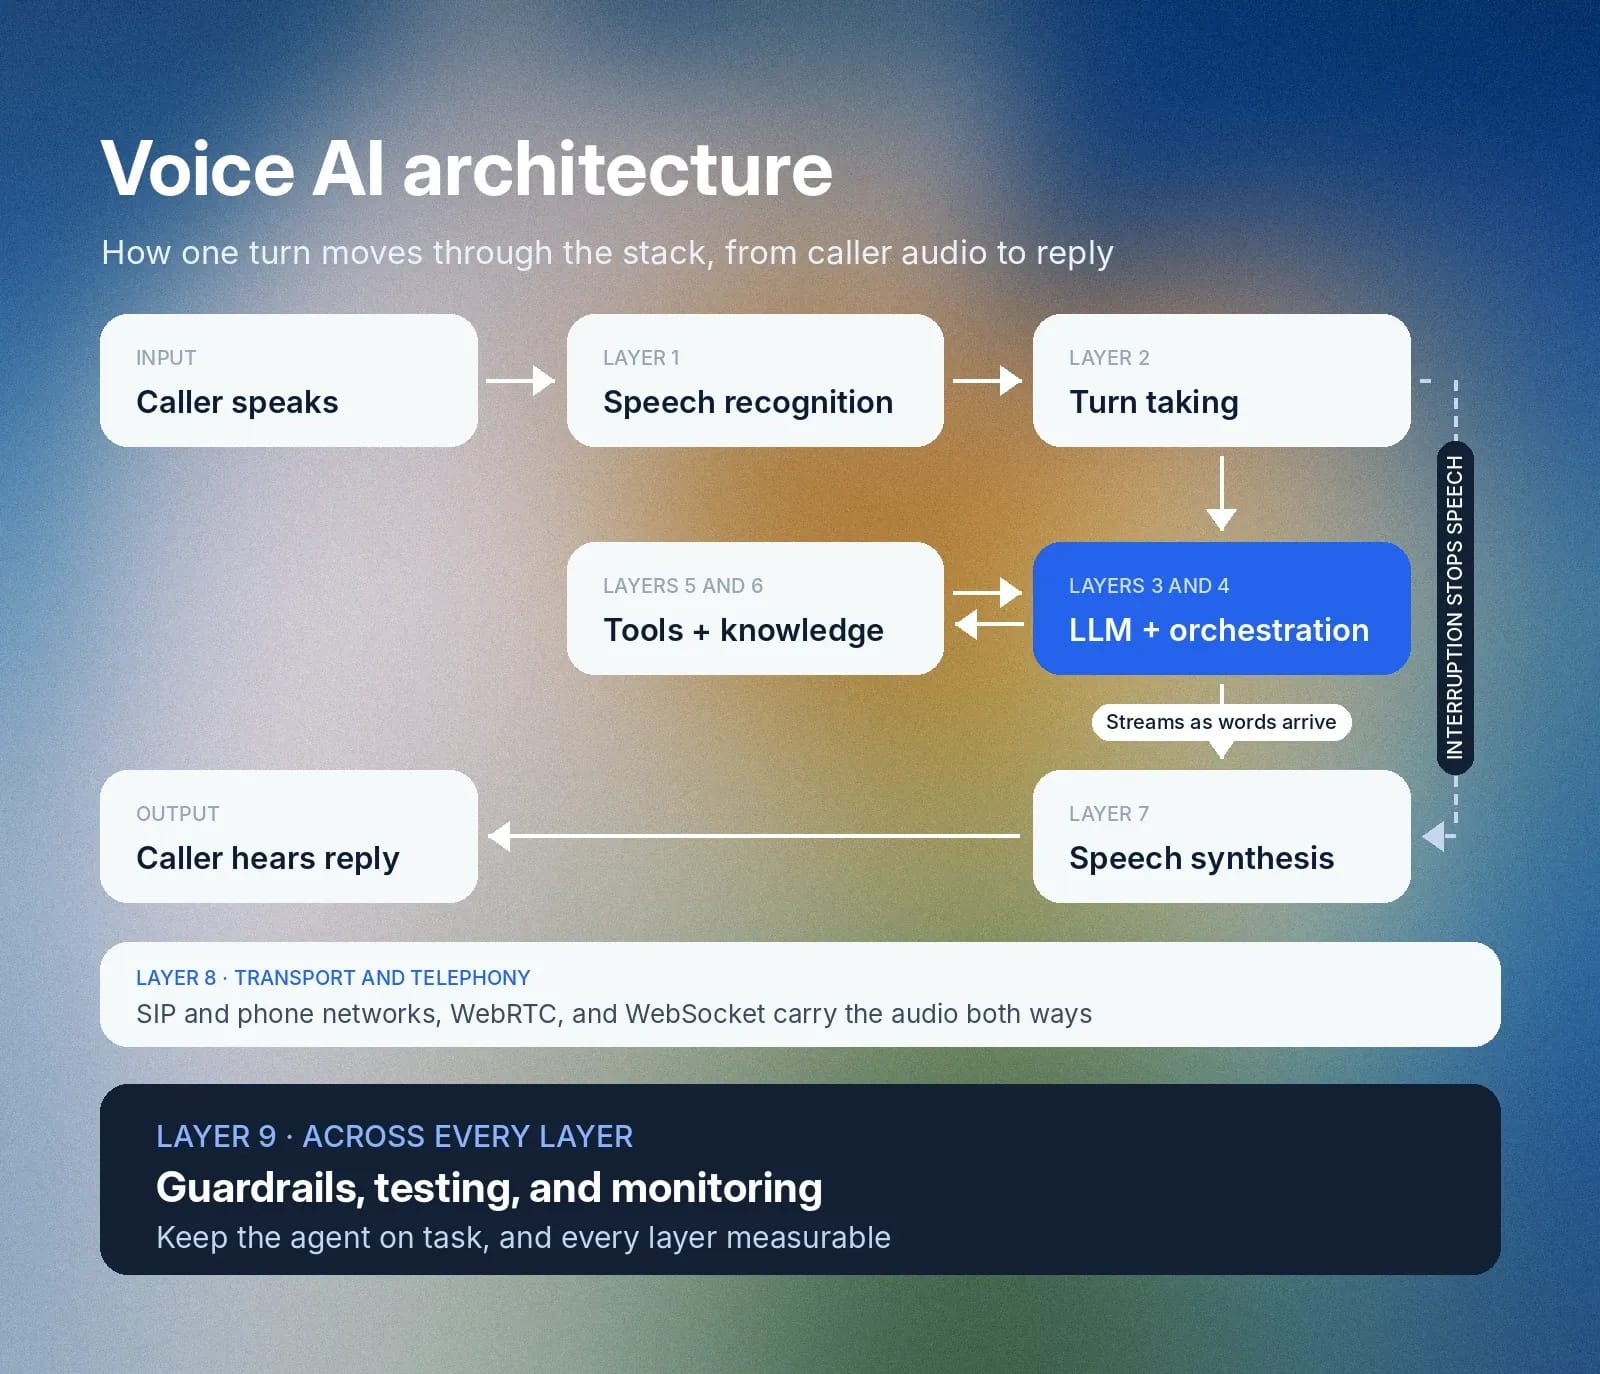
Der Ablauf ist nicht linear. ElevenAgents beginnt zu sprechen, sobald es vom Sprachmodell „genug Wörter und ein Komma“ erhält. Das Audio wird also abgespielt, bevor die vollständige Antwort vorliegt. Tool-Aufrufe und Abrufe laufen mitten in einem Turn. Unterbrechungen können eintreffen und werden vom Agenten während der Sprachgenerierung natürlich verarbeitet.
Zwei Wege zum Aufbau einer Voice-KI-Architektur
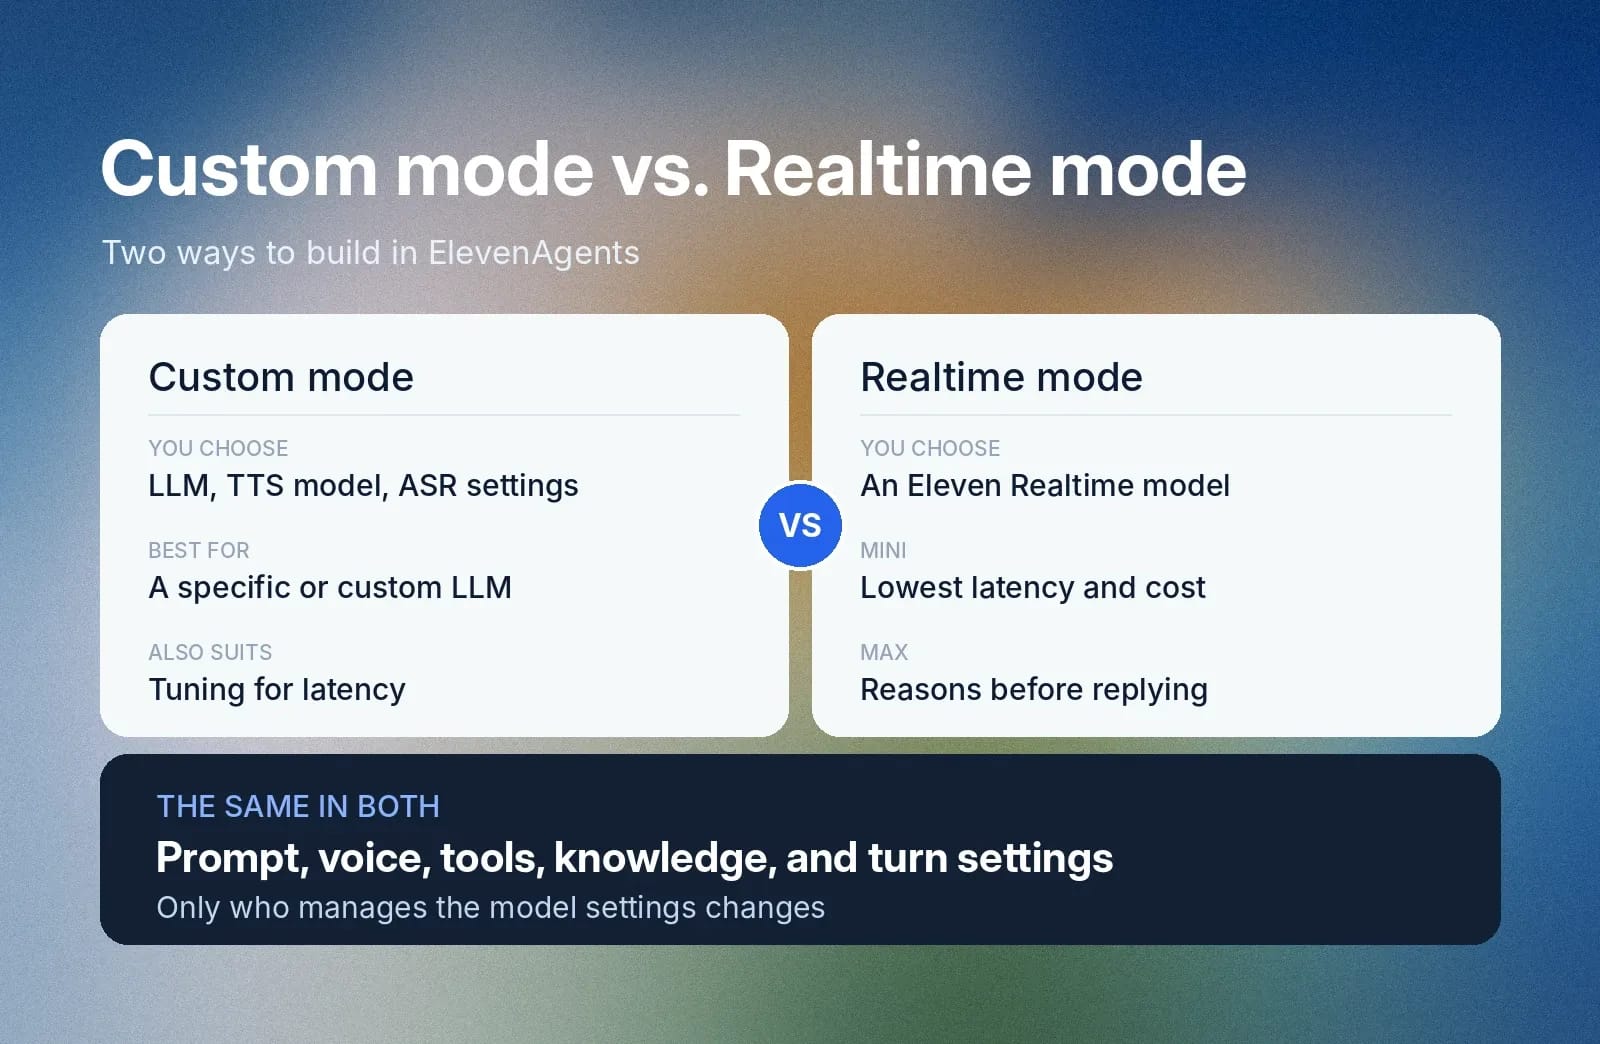
ElevenAgents unterstützt zwei Sprachmodi. Im Custom-Modus wählen Sie Sprachmodell, Text-to-Speech-Modell und Einstellungen für die Spracherkennung selbst.
Im Realtime-Modus wählen Sie ein Eleven-Realtime-Modell, und ElevenLabs verwaltet diese Einstellungen für Sie. Eleven Realtime v1 Mini ist der Standard und bietet die niedrigste Latenz bei den geringsten Kosten. Eleven Realtime v1 Max denkt vor der Antwort nach und eignet sich für komplexere Anweisungen und Fälle, die mehrstufige Tool-Nutzung erfordern.
Der System-Prompt, die gewählte Stimme, Tools, die angebundene Wissensdatenbank und die Turn-Einstellungen funktionieren in beiden Modi gleich. Der Custom-Modus ist die bessere Wahl, wenn Sie ein bestimmtes Sprachmodell, ein individuelles LLM oder ein bestimmtes TTS-Modell benötigen – etwa für Performance oder Latenzoptimierung.
Spracherkennung: Audio in Text umwandeln
Spracherkennung, auch ASR oder Speech to Text genannt, ist die erste Ebene des Stacks.
Was sie tut
Das Modell transkribiert das Audio des Anrufers fortlaufend, während er spricht. Dadurch kann der Rest der Pipeline schon vor dem Satzende arbeiten und Latenz sparen. Fortschrittliche Modelle verarbeiten starke Akzente, unterschiedliche Sprechgeschwindigkeiten und Hintergrundgeräusche.
Warum sie für Voice-KI-Infrastruktur wichtig ist
Die Transkription ist wohl eine der wichtigsten Ebenen im Stack, denn Fehler hier wirken sich auf alle nachfolgenden Stufen aus. Eine Buchungsreferenz falsch verstanden? Der falsche Kundendatensatz wird bearbeitet. Einen Medikamentennamen falsch verstanden? Potenziell katastrophal.
In seinem Trust Framework for Healthcare zeigt ElevenLabs, wie hoch die Risiken bei einer falsch verstandenen Silbe sind: Hydroxyzin statt Hydralazin.
So macht es ElevenAgents
ElevenAgents nutzt Scribe v2 Realtime, das Sprache in etwa 150 ms transkribiert. ElevenLabs trainierte es für laute Umgebungen, unterschiedliche Akzente und Kennungen wie Namen, E-Mail-Adressen und IDs. Im mehrsprachigen FLEURS-Benchmark für 30 Sprachen meldete ElevenLabs die niedrigste Wortfehlerrate aller ASR-Modelle mit niedriger Latenz.
Sie aktivieren es im Bereich „Erweitert“ der Agentenkonfiguration. Im oben erwähnten Whitepaper berichtet ElevenLabs, dass Scribe v2 Medical zum Veröffentlichungszeitpunkt mit einer Wortfehlerrate von 7,0 % jedes Modell im öffentlichen Eka Medical ASR Benchmark übertraf.
Präzise und schnelle Transkription liefert den folgenden Ebenen die sauberen Eingaben, die sie brauchen, ohne nennenswerte Latenz hinzuzufügen.
Sprecherwechsel: Wissen, wann gesprochen und wann aufgehört werden muss
Turn Taking bezeichnet die Regeln, die bestimmen, wann der Agent antwortet und wann er zuhört. Gesprächswechsel effektiv zu verstehen und darauf zu reagieren, unterscheidet ein Gespräch von einem herkömmlichen IVR-Telefonmenü.
Was es tut
Eine Turn-Taking-Komponente stellt der Voice-KI-Infrastruktur mehrere Funktionen bereit:
- Sprachaktivitätserkennung (VAD): VAD klassifiziert eingehendes Audio dutzendfach pro Sekunde als Sprache oder Stille.
- Erkennung des Turn-Endes: Beurteilt anhand von Tonfall, Rhythmus und Wortkontext, ob der Anrufer fertig ist.
- Barge-in: Ermöglicht dem Anrufer zu unterbrechen. Der Agent hört dann auf zu sprechen, damit der Nutzer fortfahren kann.
- Backchannels: Kurze Bestätigungen wie „ja“, die keinen Turn übernehmen.
Warum es wichtig ist
In menschlichen Gesprächen beträgt die typische Pause zwischen Sprechern etwa 200 ms. Ein Agent, der zu früh antwortet, unterbricht Anrufer. Wartet er zu lange, entstehen Pausen, durch die der Anruf fehlerhaft oder träge wirkt.
Nehmen wir einen Anrufer, der sagt: „Ich möchte Freitag Nachmittag buchen, aber ...“ und innehält. Ein Stille-Timer antwortet bei der Pause und verpasst die Einschränkung. Ein Modell, das Wörter und Rhythmus liest, wartet und lässt den Nutzer ausreden: „Es darf nicht zwischen 15 und 17 Uhr sein, weil ich beschäftigt bin.“
Ein Agent versteht die Absicht des Anrufers falsch und plant den Termin zur falschen Zeit. Der andere vermeidet mit effektivem Turn Taking den angegebenen Zeitraum.
So macht es ElevenAgents
ElevenAgents verwendet ein proprietäres Turn-Taking-Modell, das Tonfall, Rhythmus und Wortkontext analysiert, statt sich allein auf Stille-Timer zu verlassen. Unterbricht ein Anrufer, trifft das Signal zum Stoppen des Agenten in unter 200 ms ein.
ElevenLabs misst mit Eleven v4 Turbo auf ElevenAgents einen Median von etwa 150 ms von der Anfrage bis zur hörbaren Sprache.
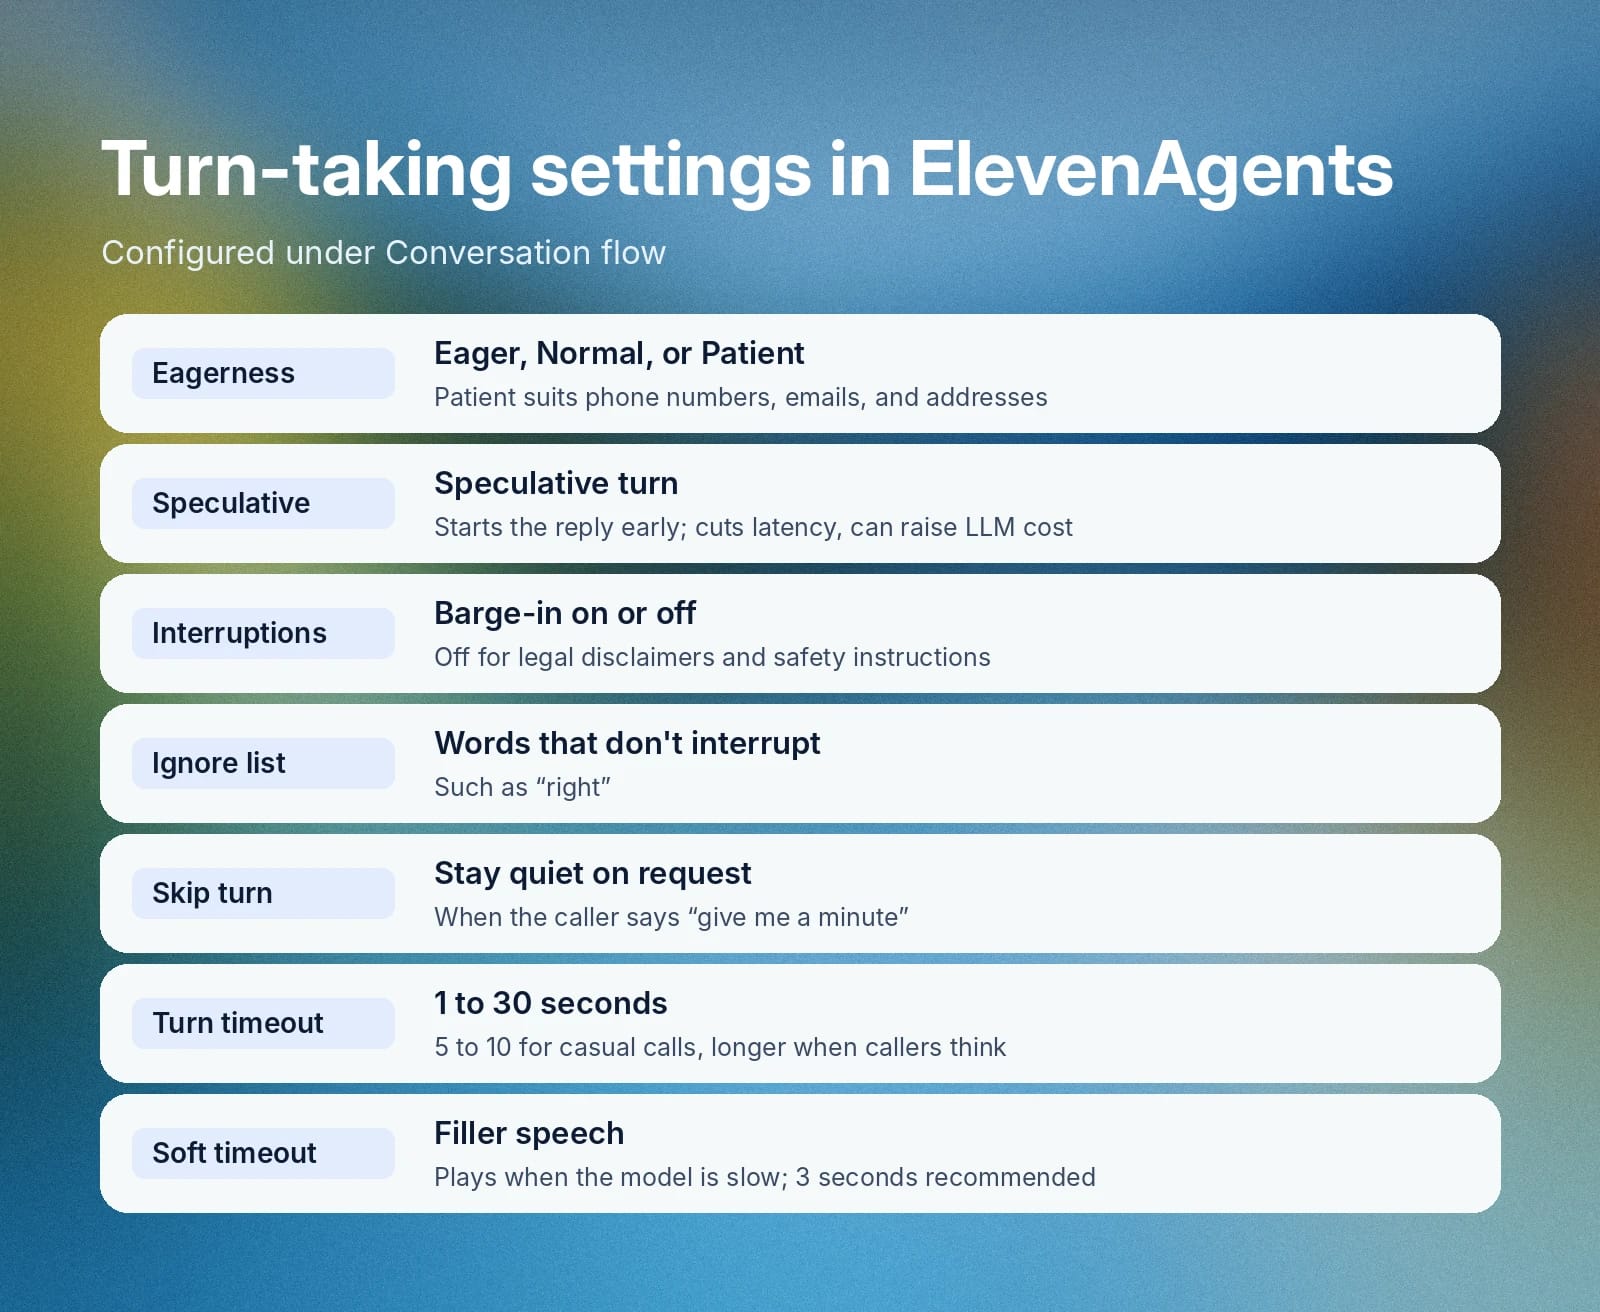
Das Verhalten lässt sich über Conversation Flow konfigurieren:
Einstellung
Was sie steuert
Antwortbereitschaft
Eager antwortet bei der frühesten Gelegenheit. Normal ist der ausgewogene Standard. Patient wartet länger und eignet sich für Telefonnummern, Adressen und E-Mail-Adressen.
Spekulativer Turn
Startet die Antwort des Sprachmodells, bevor bestätigt ist, dass der Anrufer fertig ist. Das senkt die Latenz, kann aber die LLM-Kosten erhöhen.
Unterbrechungen
Deaktivieren Sie sie, wenn jedes Wort gehört werden muss, etwa bei rechtlichen Hinweisen und Sicherheitsanweisungen.
Ignorierliste
Wörter wie „genau“, die den Agenten nicht unterbrechen sollen.
Tool „Turn überspringen“
Lässt den Agenten schweigen, wenn der Anrufer sagt: „Geben Sie mir eine Minute.“
Turn-Timeout
Übernimmt nach 1 bis 30 Sekunden Stille einen Turn. Nutzen Sie 5 bis 10 Sekunden für lockere Gespräche und 10 bis 30 Sekunden, wenn Anrufer Zeit zum Nachdenken brauchen.
Soft Timeout
Gibt Fülllaute wie „Hhmmmm ... ja.“ wieder, wenn das Modell langsam ist. Bereich: 0,5 bis 8 Sekunden; empfohlen sind 3 Sekunden.
Erkennung lauter Umgebungen
Eine Enterprise-Einstellung, die Stimmen im Hintergrund erkennt und den Anrufer höchstens einmal pro Gespräch bittet, an einen ruhigeren Ort zu gehen.
Workflows können die Antwortbereitschaft während eines Anrufs ändern. Ihr Client erhält außerdem ein vad_score-Ereignis, eine Wahrscheinlichkeit von 0 bis 1 dafür, dass der Nutzer spricht.
Gut abgestimmtes Turn Taking entscheidet, ob Anrufer den Agenten als aufmerksam oder abrupt erleben. Weitere Informationen finden Sie in unserem vollständigen Leitfaden zum Turn Taking.
Das Sprachmodell: Schlussfolgern und Antworten generieren
Das Large Language Model (LLM) ist die Ebene für Schlussfolgerungen. Es liest Transkript, Anweisungen und bisherigen Gesprächsverlauf und formuliert dann die Antwort oder entscheidet sich für einen Tool-Aufruf.
Was es tut
Ein skriptgesteuerter Voice Bot erkennt eine Handvoll Befehle. Ein LLM interpretiert unterschiedlich formulierte Anfragen, behält den Kontext über mehrere Turns und entscheidet, wann Informationen abgerufen oder weitergeleitet werden.
Warum es wichtig ist
Modelle unterscheiden sich in Tiefe der Schlussfolgerungen, Geschwindigkeit und Kosten. Bei Live-Sprachgesprächen ist die Antwortzeit genauso wichtig wie die Antwortqualität. Die Modellwahl ist daher eine Latenz- und Kostenentscheidung.
So macht es ElevenAgents
ElevenAgents bietet Ihnen eine Oberfläche für Modelle von Google, OpenAI und Anthropic sowie für von ElevenLabs gehostete offene Modelle. Sie können auch Ihr eigenes LLM verbinden, indem Sie einen Endpunkt angeben und Zugangsdaten als Secrets speichern. ElevenLabs gibt Kosten für LLMs von Drittanbietern zum veröffentlichten Tarif des Anbieters ohne Aufschlag weiter.
Sie können das Modell pro Subagent auswählen. Das Enterprise Conversational Agent Playbook, Band 2, empfiehlt leistungsstärkere Modelle für komplexe Schlussfolgerungen zu reservieren und günstigere Modelle mit niedriger Latenz für Aufgaben wie Intent-Klassifizierung und FAQs zu verwenden.
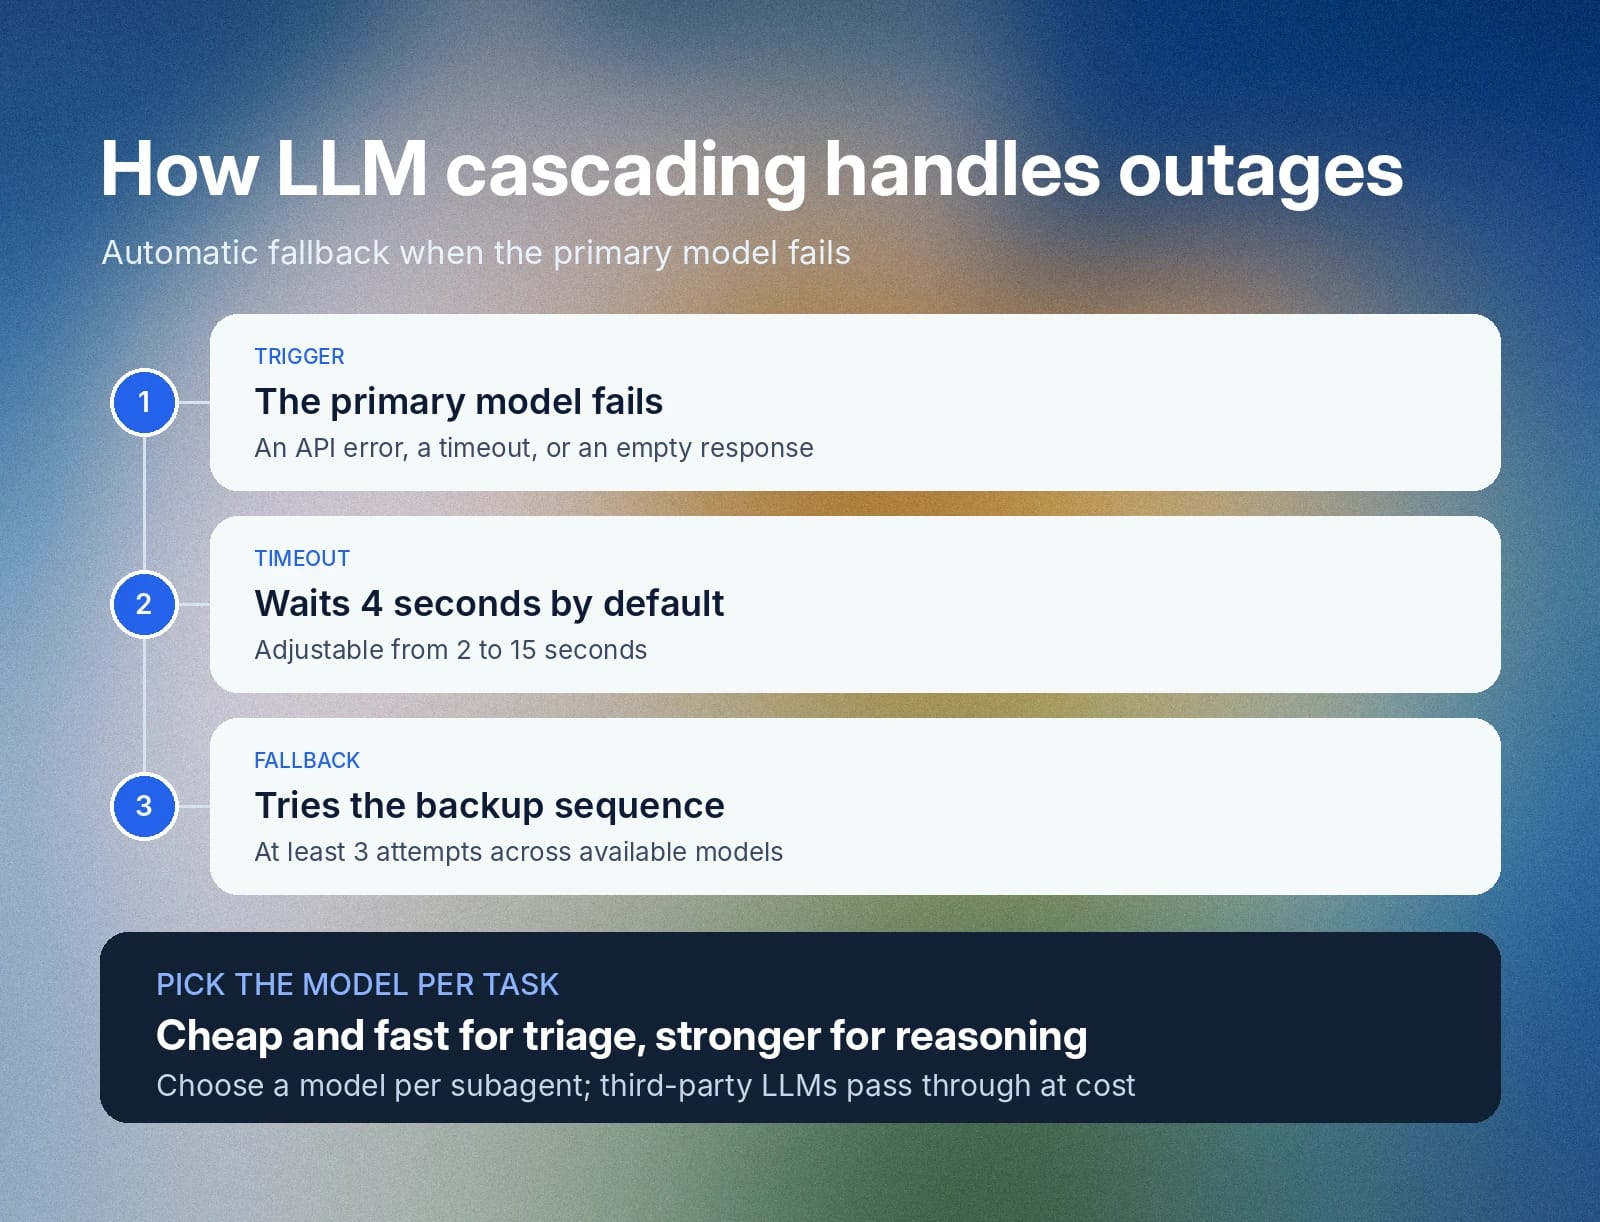
Anbieter haben Ausfälle. LLM-Cascading fängt sie ab: Gibt das primäre Modell einen API-Fehler zurück, läuft in ein Timeout oder sendet eine leere Antwort, probiert ElevenAgents eine Backup-Sequenz. Das Standard-Timeout vom primären zum Backup-Modell beträgt 4 Sekunden und lässt sich auf 2 bis 15 Sekunden einstellen. Das System unternimmt über die verfügbaren Modelle mindestens 3 Versuche.
Ein individuelles LLM als primäres Modell versucht es mindestens 3-mal erneut, sofern Sie keine eigene Backup-Reihenfolge festlegen. Das richtige Modell für jede Aufgabe hält den Agenten schnell und kosteneffizient.
Orchestrierung: Arbeit zwischen Agenten und Menschen weiterleiten
Die Agentenorchestrierung koordiniert die Prompts, Subagenten, Tools und Menschen, die an der Erledigung einer Aufgabe beteiligt sind. Sie entscheidet an jedem Punkt des Anrufs, was als Nächstes geschieht.
Was sie tut
Ein Agent mit einem langen Prompt wird mit zunehmenden Aufgaben schwer zu verwalten. Die Orchestrierung teilt die Arbeit in Phasen mit eigenen Anweisungen, Modellen und Tools auf und leitet den Anrufer zwischen ihnen weiter.
Warum sie wichtig ist
Kleinere Prompts lassen sich leichter testen und günstiger ausführen, weil jede Interaktion weniger Text lädt. Die Aufteilung eines Ablaufs erlaubt einem günstigen Modell, Triage und FAQs zu bearbeiten, und übergibt nur bei Bedarf an ein leistungsstärkeres Modell.
So macht es ElevenAgents
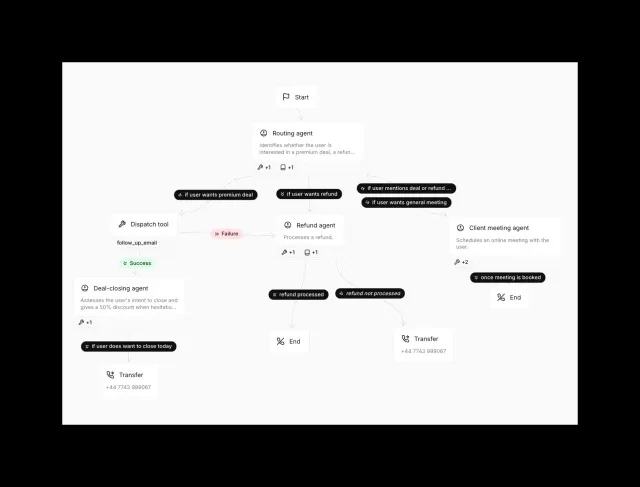
Workflows in ElevenAgents sind ein visueller Builder für verzweigte Gesprächsgraphen.
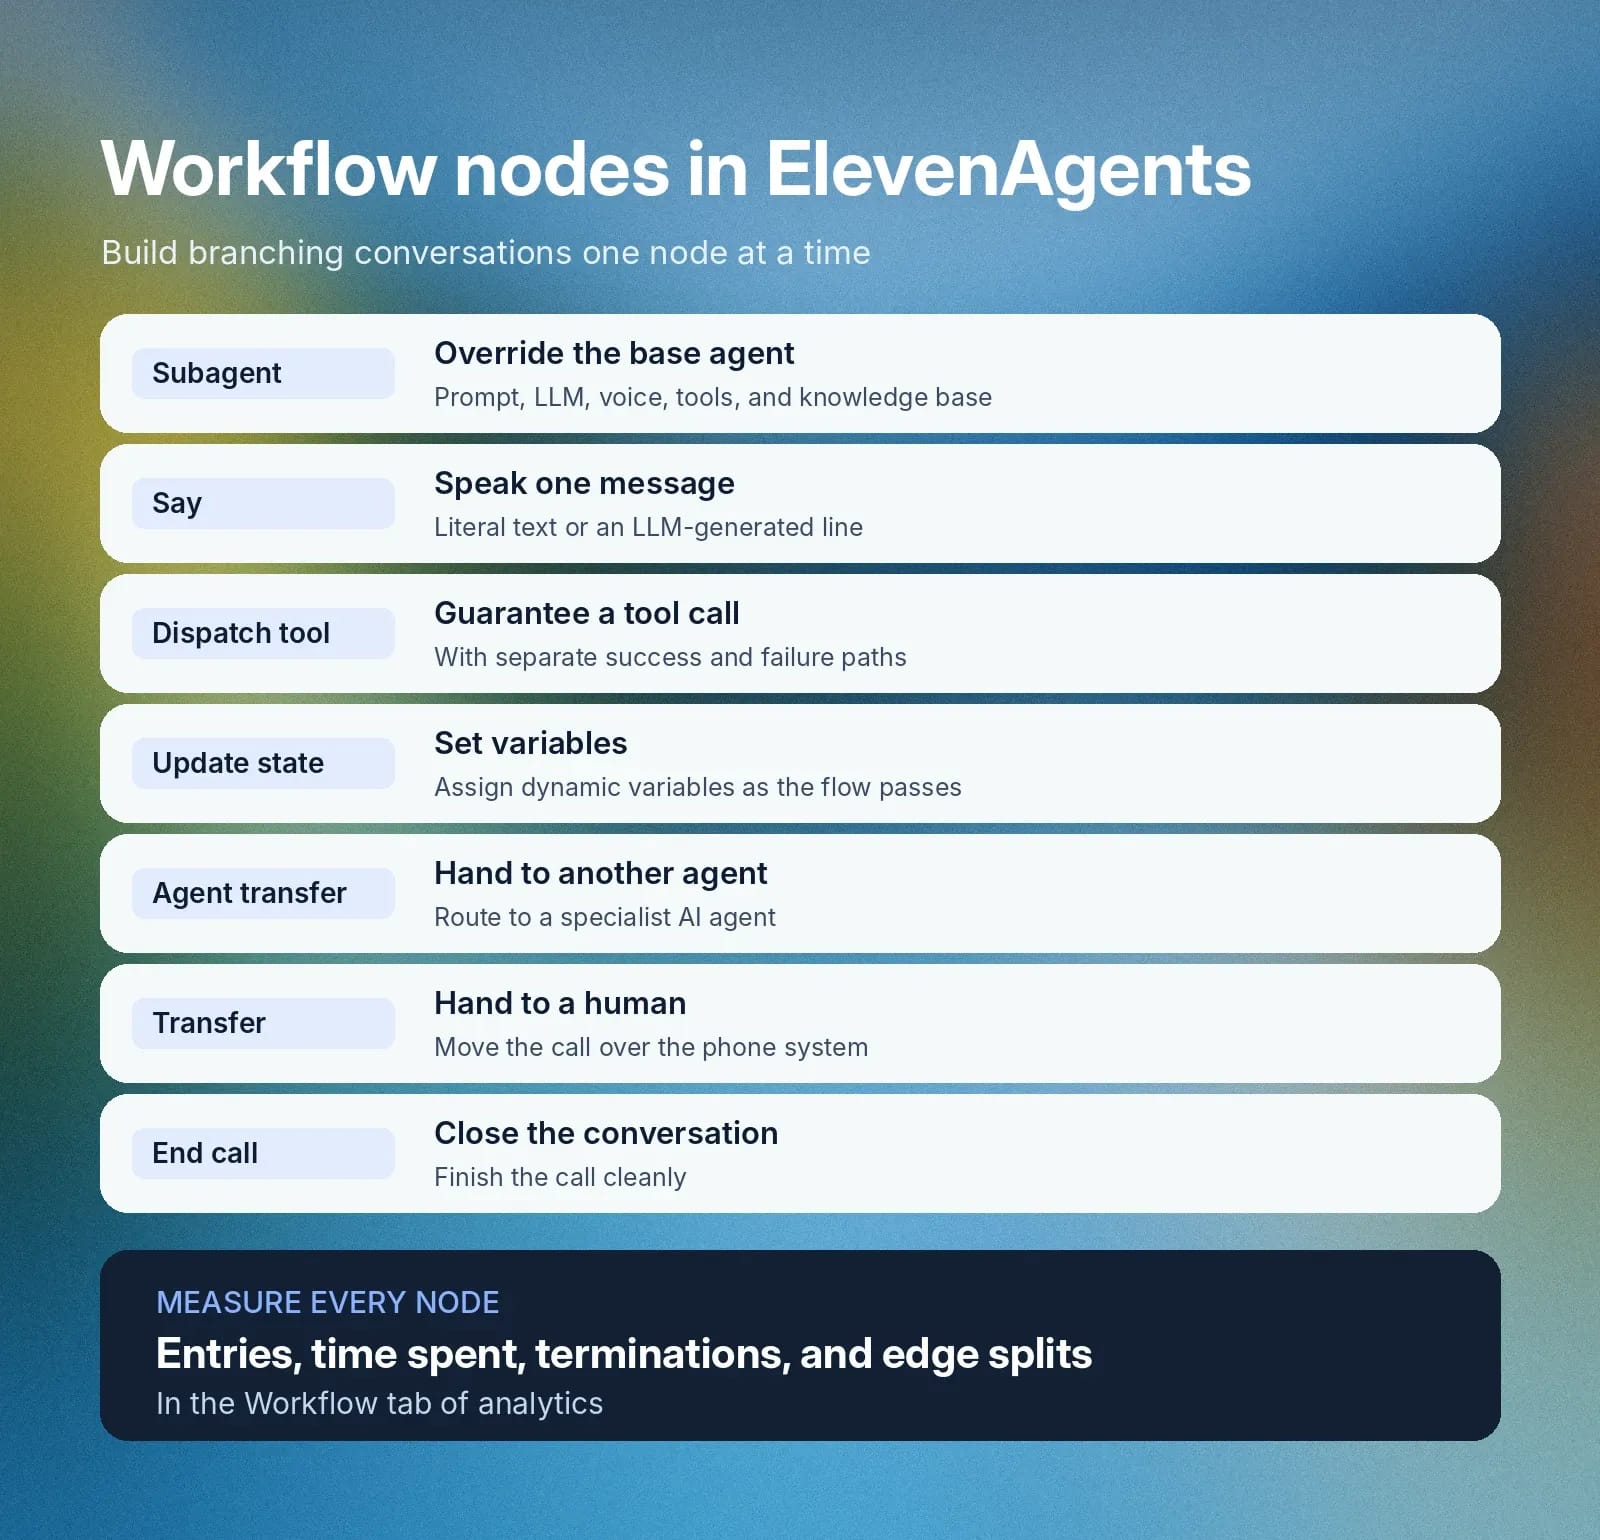
Die Knoten sind:
- Subagent: Ändert oder überschreibt den Basisagenten einschließlich Prompt, LLM, Stimme, Tools und Wissensdatenbank.
- Say: Spricht eine Nachricht, entweder als wörtlichen Text oder als LLM-generierte Zeile.
- Dispatch Tool: Ein dedizierter Schritt, der einen Tool-Aufruf garantiert, mit getrennten Pfaden für Erfolg und Fehler.
- Update State: Weist dynamische Variablen zu, während der Ablauf durchlaufen wird.
- Agent Transfer: Übergibt den Anruf an einen anderen Agenten.
- Transfer to Number: Übergibt den Anruf über das Telefonsystem vom KI-Agenten an einen Menschen.
- End Call: Beendet das Gespräch.
Kanten zwischen Knoten enthalten Bedingungen in natürlicher Sprache, die das LLM in Echtzeit auswertet. Ein Support-Ablauf kann mit einem Routing-Subagenten auf einem schnellen Modell beginnen, Fragen zur Abrechnung an einen Abrechnungs-Subagenten auf einem stärkeren Modell senden und mit einem Transfer-to-Number-Knoten enden, wenn der Anrufer nach einer Person fragt. Nach dem Start zeigt der Workflow-Tab in der Analyse für jeden Knoten Eintritte, durchschnittliche Verweildauer, Abbrüche und Kantenverteilung.
Die Orchestrierung verwandelt einen einzelnen Agenten in ein System, das Sie Knoten für Knoten gestalten, messen und verbessern können.
Tools und MCP: Den Agenten handeln lassen
Function Calling, auch Tool Calling genannt, ermöglicht einem Agenten, Aktionen von externer Software anzufordern, die Sie mit Ihrem Tech-Stack verbunden haben.
Damit wird eine Frage-Antwort-Oberfläche zu einem agentischen KI-System, das Aufgaben erledigen und in Ihrem Namen mit anderen Tools interagieren kann.
Was es tut
Nehmen Sie einen Anrufer, der den Termin von morgen auf Freitag verschieben möchte. Der Agent ruft die Buchung ab, prüft die Verfügbarkeit am Freitag, aktualisiert das Planungssystem und bestätigt die Änderung. Jeder Schritt ist ein Tool-Aufruf, der eine Aktion ausführt.
Warum es wichtig ist
Tools sorgen dafür, dass Gespräche zu Ergebnissen führen. Jedes Tool braucht klare Ein- und Ausgaben, und der Agent muss wissen, ob ein Aufruf erfolgreich war, bevor er dies dem Anrufer mitteilt.
So macht es ElevenAgents
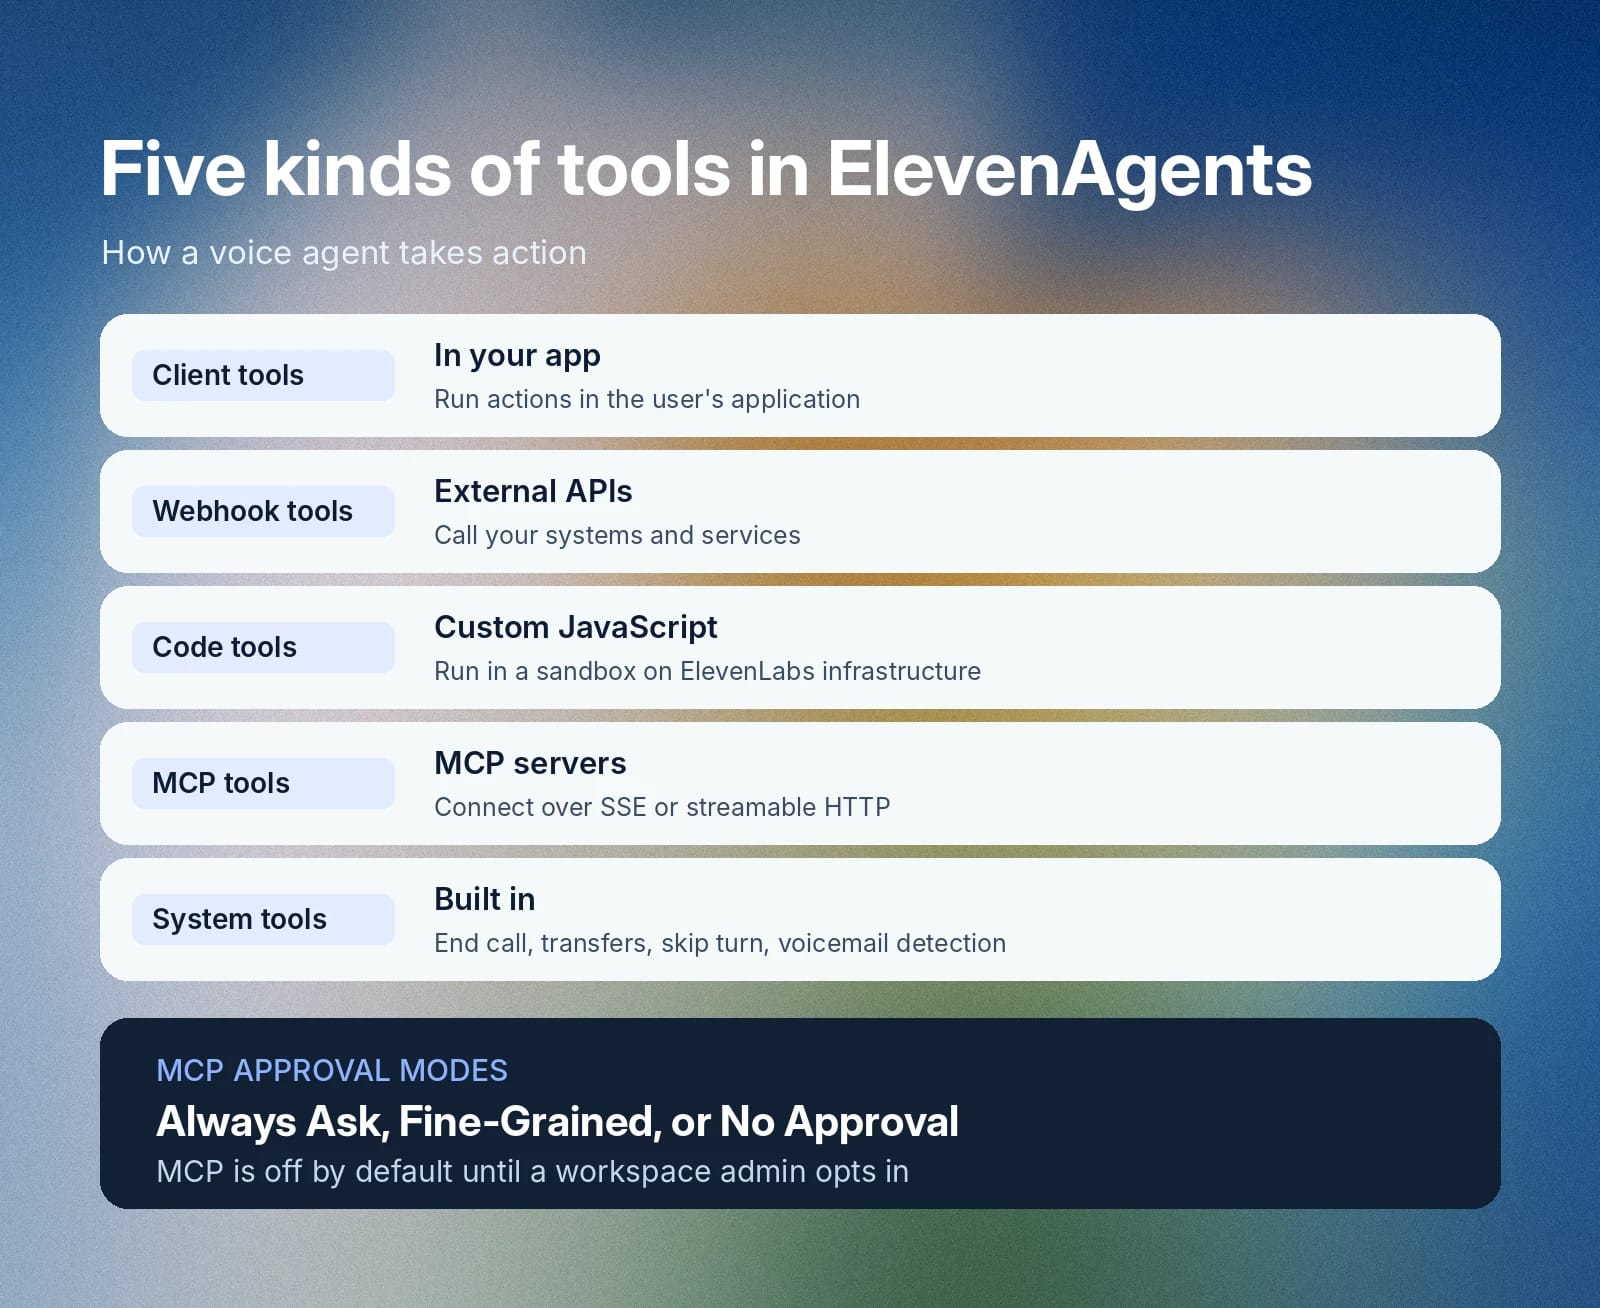
ElevenAgents unterstützt Client Tools, die in der Anwendung des Nutzers ausgeführt werden, Webhook Tools, die externe APIs aufrufen, Code Tools für individuelles JavaScript in einer Sandbox auf der ElevenLabs-Infrastruktur, MCP Tools und integrierte System-Tools.
Zu den System-Tools gehören Anruf beenden, Spracherkennung, Agentenübergabe, Übergabe an eine Nummer, Turn überspringen, Wähltastenton abspielen und Mailbox-Erkennung. Sie können Umgebungsgeräusche hinzufügen, während ein Tool läuft, und steuern, ob Anrufer die Ausführung unterbrechen können.
Das Model Context Protocol (MCP) ist ein offener Standard dafür, wie Anwendungen Sprachmodellen Kontext und Tools bereitstellen. ElevenAgents verbindet sich über SSE und streambares HTTP mit MCP-Servern. Workspace-Administratoren müssen dies zuerst aktivieren, da MCP standardmäßig für jeden Workspace deaktiviert ist. Anschließend wählen Sie für jeden Server einen Freigabemodus: Immer fragen, detaillierte Tool-Freigabe oder keine Freigabe.
Client-Ereignisse wie client_tool_call und mcp_tool_call melden Tool-Aktivitäten, und die MCP-Ereignisberichte umfassen vier Zustände: Laden, Freigabe ausstehend, Erfolg und Fehler. Zuverlässige Tools geben dem Agenten Reichweite in der realen Welt, und klare Freigaberegeln halten diese unter Kontrolle.
Wissen und Gedächtnis: Fakten und Anruferkontext
Retrieval-Augmented Generation (RAG) versorgt den Agenten mit Fakten aus Ihren eigenen Inhalten, etwa einer internen Faktendatenbank oder einem umfassenderen Kundenhistorienprotokoll. Gedächtnis und Personalisierung geben ihm Kontext über den Anrufer, sodass Ihr Agent Personalisierung und Nutzen für Ihr Unternehmen verbessern kann.
Was es tut
Ein Sprachmodell hat einen Trainingsstichtag und keinen Zugriff auf Ihre Dokumentation oder Datensätze. RAG durchsucht für jede Anfrage eine Wissensdatenbank, ruft die relevantesten Passagen ab und liefert sie dem Modell als zusätzlichen Kontext für eine hilfreiche Antwort.
Personalisierungsdaten teilen dem Agenten mit, wer anruft und was für diese Person relevant ist.
Warum es wichtig ist
Antworten auf genehmigten Inhalten zu gründen, hält sie präzise. Auch die Abrufgeschwindigkeit ist wichtig, denn jede zusätzliche Millisekunde ist eine weitere, auf die Ihre Kunden warten. Personalisierung verhindert zudem, dass Anrufer Informationen über verschiedene Anrufe hinweg wiederholen müssen, da Ihren Agenten die CRM-Datensätze zu Beginn jeder neuen Sitzung vorliegen.
So macht es ElevenAgents
Sie fügen Dokumente der Wissensdatenbank als Dateien hinzu (PDF, DOCX, TXT, MD, HTML oder EPUB, jeweils bis zu 20 MB), als URLs oder eingefügten Text. Ein Dokument nutzt den vollständigen Kontext, wenn sein extrahierter Text bis etwa 300.000 Zeichen in den Prompt passt. Größere Dokumente verwenden RAG. Der Abruf kann bei jedem Turn oder bei Bedarf erfolgen. Der Standardmodus Auto nutzt RAG, wenn es aktiviert und das Dokument indexiert ist.
ElevenLabs arbeitet direkt an der Abrufgeschwindigkeit. Der Engineering-Artikel „How we reduced RAG latency“ dokumentiert mithilfe selbst gehosteter Modelle auf bereits betriebener ElevenLabs-Infrastruktur einen Rückgang der medianen RAG-Latenz von 326 ms auf 155 ms.
Für den Anruferkontext verwendet ElevenAgents dynamische Variablen im Format {{ var_name }}, die Nachrichten, System-Prompts und Tools ausfüllen. Bei eingehenden Anrufen über Twilio, SIP-Trunk, WhatsApp und SMS kann ElevenAgents vor Gesprächsbeginn Startdaten von Ihrem Server abrufen. Ihr Server sucht den Anrufer anhand von caller_id und gibt die Variablen – beispielsweise aus Ihrem CRM – mit einer Antwort von bis zu 256 KB zurück. Nach dem Anruf liefern Post-Call-Webhooks Bewertungsergebnisse und extrahierte Daten an Ihre externen Systeme.
Abruf und Personalisierung geben dem Agenten zusammen die richtigen Fakten und den richtigen Anrufer.
Sprachsynthese: Dem Agenten eine Stimme geben
Text to Speech (TTS) wandelt die Antwort des Sprachmodells in gesprochene Sprache um. Diese Ebene hört der Anrufer tatsächlich.
Was sie tut
Das Modell wandelt Text mit natürlichem Tempo und emotionalem Ausdruck in Audio um. In einem Live-Anruf streamt es Audio in Abschnitten, sodass die Wiedergabe beginnt, bevor die vollständige Antwort generiert wurde.
Warum sie wichtig ist
Latenz und Vortrag beeinflussen beide, wie Anrufer den Anruf bewerten. Für Echtzeit-Anwendungen sind zwei Kennzahlen entscheidend: die Zeit zur Audiogenerierung und die Zeit, bis der Anrufer den ersten Ton hört. Auch Namen, Medikamentennamen und Fachbegriffe müssen korrekt ausgesprochen werden, sonst verlieren Anrufer das Vertrauen in den Agenten.
Wie Eleven v4 die Stimmebene antreibt
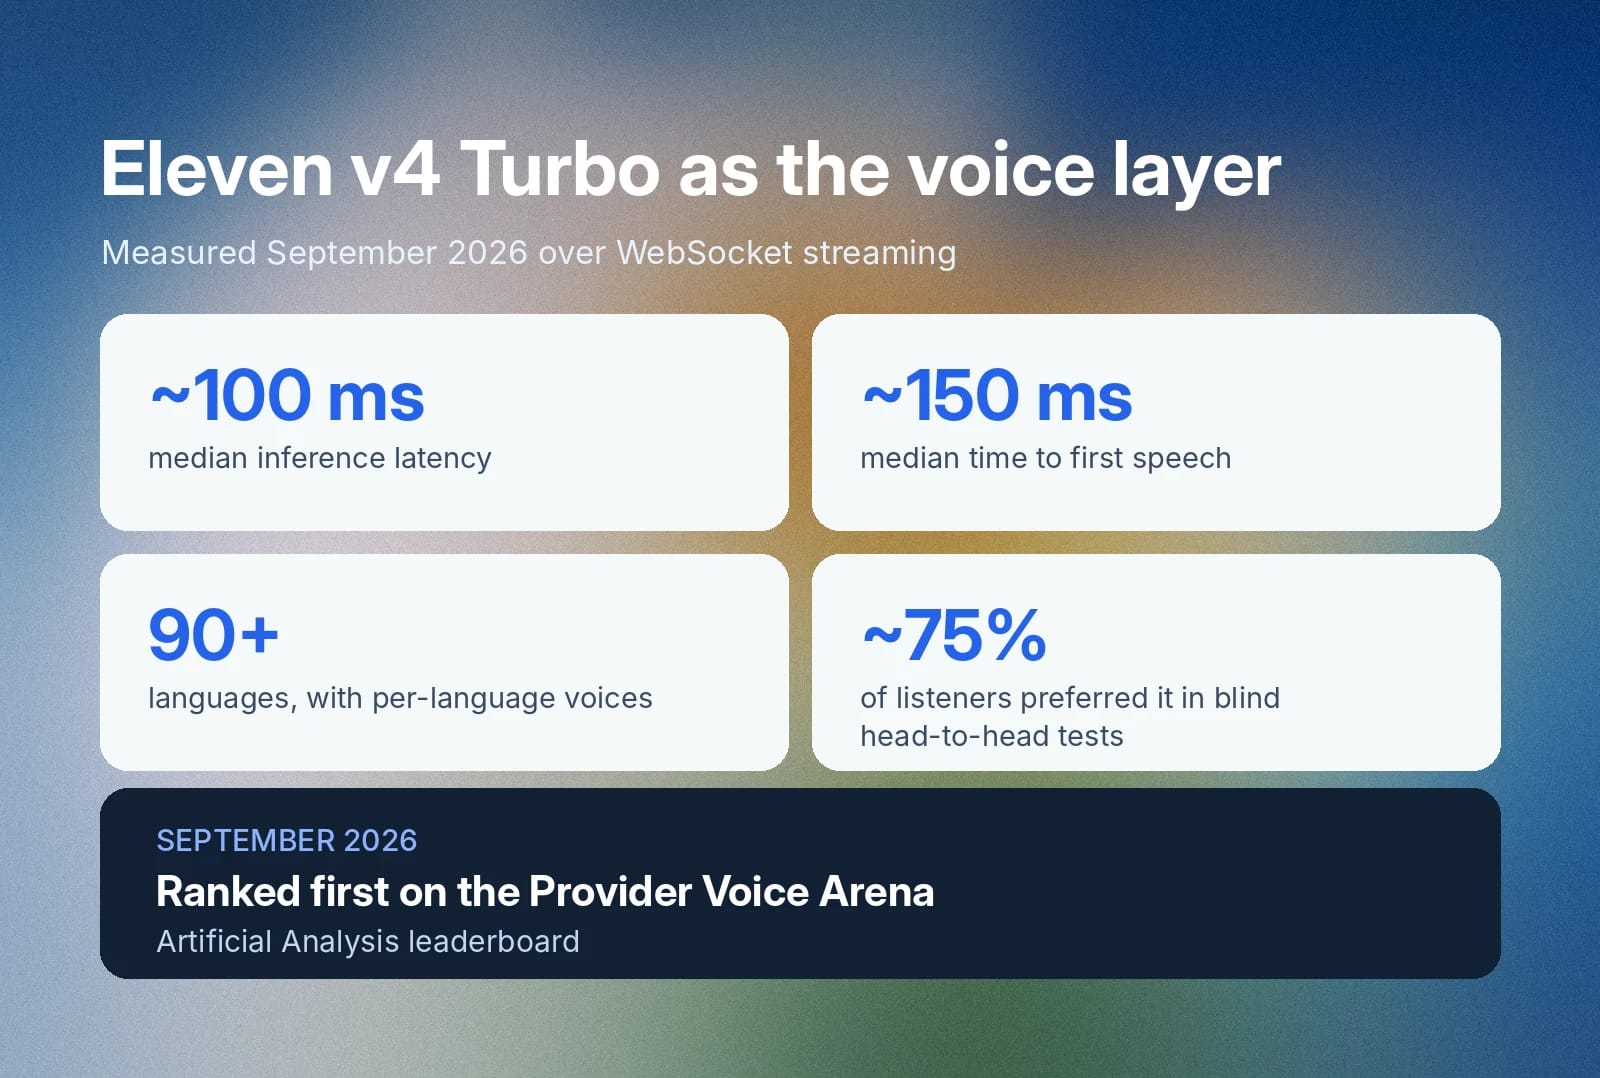
Eleven v4 ist das bisher ausdrucksstärkste Text-to-Speech-Modell von ElevenLabs und basiert auf einer völlig neuen Architektur. Eleven v4 Turbo ist die Variante mit niedriger Latenz für Echtzeitanwendungen wie Agenten und als ein System mit ElevenAgents optimiert.
Eleven v4 Turbo
Wert
Mediane Inferenzlatenz
Etwa 100 ms
Mediane Zeit bis zur ersten Sprache
Etwa 150 ms
Sprachen
90+
ElevenLabs maß die Latenzwerte im September 2026 per WebSocket-Streaming ohne Netzwerklatenz. Eleven v4 belegte im September 2026 den ersten Platz in der Artificial Analysis Provider Voice Arena Leaderboard*, und etwa 75 % der Zuhörer bevorzugten es in Blindtests**.
* Artificial Analysis, Provider Voice Arena Leaderboard, Sept. 2026
** Basierend auf direkten Nutzerpräferenztests gegenüber Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS und Google Gemini 3.8 Flash TTS.
Eleven v4 unterstützt Inline-Audio-Tags wie [laughs] für den Vortrag sowie IPA-Phonem-Unterstützung für die Aussprache. Bei Healthcare-Agenten umfasst diese Aussprachekontrolle medizinische Begriffe. ElevenAgents ergänzt dies um Steuerungsmöglichkeiten auf Agentenebene. Die Multi-Voice-Unterstützung ermöglicht einem Agenten, bei Gesprächen mit mehreren Charakteren zwischen Stimmen zu wechseln. Die Geschwindigkeit reicht von 0,7x bis 1,2x. Jede weitere Sprache kann eine eigene Stimme verwenden. Aussprachewörterbücher akzeptieren IPA- oder CMU-Notation für bestimmte Wörter.
Ein schneller erster Ton und eine präzise, ausdrucksstarke Stimme lassen den Agenten wie einen Gesprächspartner wirken.
Telefonie und Transport: Den Agenten mit Anrufern verbinden
Die Transportebene überträgt Audio zwischen Anrufer und Agent. Welche Integrationen Sie hier in Ihre Voice-KI-Infrastruktur aufnehmen, hängt vom verwendeten Telefoniekanal ab.
Was sie tut
Telefonanrufe laufen über ein Telefonnetz und SIP, während Gespräche im Browser und in Apps über WebRTC oder WebSocket laufen. Ein Website-Widget verpackt die Browserverbindung in einer sofort nutzbaren Oberfläche.
Warum sie wichtig ist
Jeder Kanal hat andere Einrichtungsanforderungen und Audioeinschränkungen. Entscheiden Sie sich daher früh für Ihre Kanäle. Ein telefonieorientiertes Deployment benötigt Trunking und Nummernverwaltung. Ein Produkt-Deployment benötigt ein SDK.
So macht es ElevenAgents
- SIP-Trunking: Verbindet Ihr Telefonsystem direkt mit ElevenLabs, eingehend und ausgehend. Es funktioniert mit Twilio, Vonage, Sinch, Infobip, Telnyx und anderen Standardanbietern. Die Signalisierung läuft über TCP an Port 5060 oder TLS 1.2 bzw. höher an Port 5061; Audio verwendet G.711 oder G.722. Planen Sie mindestens 100 Kbit/s pro Anruf ein. Die Limits für gleichzeitige Anrufe richten sich nach Ihrem Abonnement, und Anrufer warten bei aktivierter Anrufwarteschlange.
- Native Twilio-Integration: Importieren Sie eine erworbene Twilio-Nummer für eingehende und ausgehende Anrufe. Verifizierte Anrufer-IDs funktionieren nur ausgehend.
- Batch-Anrufe: Laden Sie eine Empfängerliste als CSV oder XLS hoch; jede zusätzliche Spalte wird zu einer dynamischen Variablen. Sie können sofort starten oder einen Startzeitpunkt planen. Batches verwenden den niedrigeren Wert aus 50 % Ihres Workspace-Limits für gleichzeitige Vorgänge oder 70 % des Limits Ihres Agenten, sodass Kapazität für eingehende Anrufe bleibt.
- WebRTC und WebSocket: Die SDKs verwenden standardmäßig WebRTC für Sprache und WebSocket für reine Textgespräche. Private Agenten authentifizieren sich mit einer signierten URL oder einem auf Ihrem Server erzeugten Conversation Token. Der WebSocket-Endpunkt lautet wss://api.elevenlabs.io/v1/convai/conversation.
- SDKs: Python, JavaScript, React, React Native, Swift, Kotlin und Unity.
- Widget: Fügen Sie das Element <elevenlabs-convai> zu einer Seite hinzu. Es unterstützt reine Sprache, Sprache plus Text und Chat-Modi; der Agent kann Schnellantworten und Karussells anzeigen.
Ein Agent kann Telefon, Web, WhatsApp, SMS und E-Mail bedienen. So können Teams einmal entwickeln und kanalübergreifend bereitstellen.
Guardrails: Den Agenten bei seiner Aufgabe halten
Guardrails sind Kontrollmechanismen, die das Verhalten eines Agenten innerhalb definierter Grenzen halten. Sie ergänzen Grounding, denn ein Guardrail begrenzt, was ein Agent sagt, ohne die zugrunde liegenden Fakten korrekt zu machen. Guardrails laufen parallel zu Agentengesprächen und helfen, Ihre KI-Agentengespräche konform und präzise zu halten.
Was sie tun
ElevenAgents setzt Guardrails ein auf drei Ebenen. Der System-Prompt legt erlaubtes und unerlaubtes Verhalten fest, idealerweise unter der Überschrift # Guardrails. Die Validierung von Nutzereingaben prüft Nachrichten auf Prompt Injection. Die Antwortvalidierung überprüft jede Antwort vor der Ausgabe.
Warum sie wichtig sind
Ein Agent, der vom Thema abweicht oder Richtlinien erfindet, untergräbt schnell Vertrauen. Ein Kundensupport-Agent sollte die Erstattungsrichtlinie vor der Antwort aus einer genehmigten Quelle abrufen; ein Guardrail setzt diese Grenze durch.
So macht es ElevenAgents
ElevenAgents führte Guardrails 2.0 im September 2026 ein. Dieses neue System umfasst unter anderem folgende Konfigurationen für wirksame Guardrails:
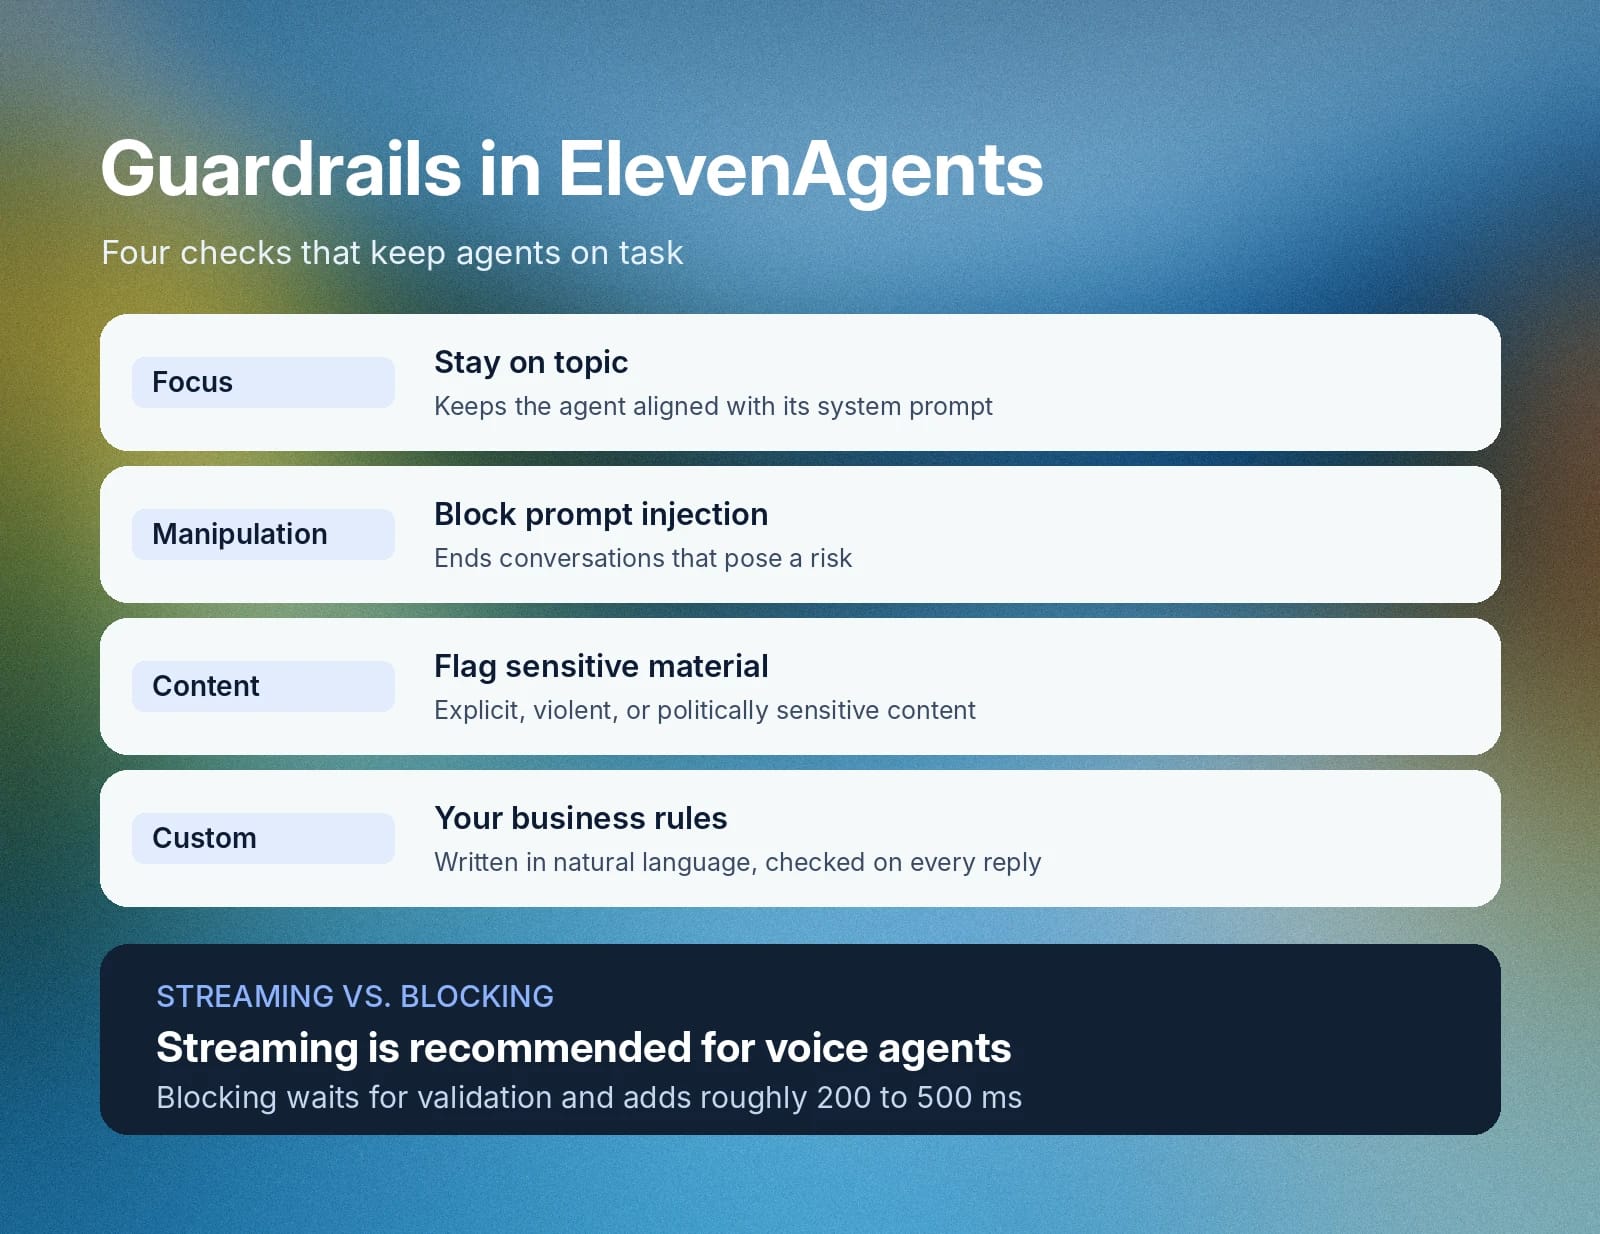
- Fokus: Hält den Agenten beim Thema und im Einklang mit seinem System-Prompt.
- Manipulation: Erkennt Prompt Injection und beendet riskante Gespräche.
- Inhalt: Kennzeichnet Kategorien wie sexuell explizites, gewalttätiges oder politisch sensibles Material.
- Benutzerdefiniert: Von Ihnen in natürlicher Sprache verfasste Geschäftsregeln, die bei jeder Antwort ausgewertet werden.
Der Ausführungsmodus bestimmt den Latenz-Kompromiss. Im Streaming-Modus kann die Antwort beginnen, bevor die Prüfung abgeschlossen ist. Dadurch können weniger als 500 ms Audio abgespielt werden, bevor eine Sperre den Anruf beendet. ElevenLabs empfiehlt diesen Modus für Voice Agents. Der Blocking-Modus wartet auf die Validierung und fügt etwa 200 bis 500 ms hinzu.
Wenn ein benutzerdefinierter Guardrail ausgelöst wird, beendet die Trigger-Aktion entweder den Anruf oder versucht die Antwort mit Ihrem Feedback bis zu dreimal erneut. Ihr Client kann auf das Ereignis guardrail_triggered warten.
Mehrschichtige Guardrails mit einem gewählten Latenzprofil halten das Verhalten vorhersagbar, ohne jede Antwort zu verlangsamen.
Tests und Experimente: Nachweisen, dass der Agent funktioniert
Tests prüfen einen Agenten vor dem Start. Experimente prüfen Änderungen nach dem Start anhand von Live-Traffic.
Was sie tun
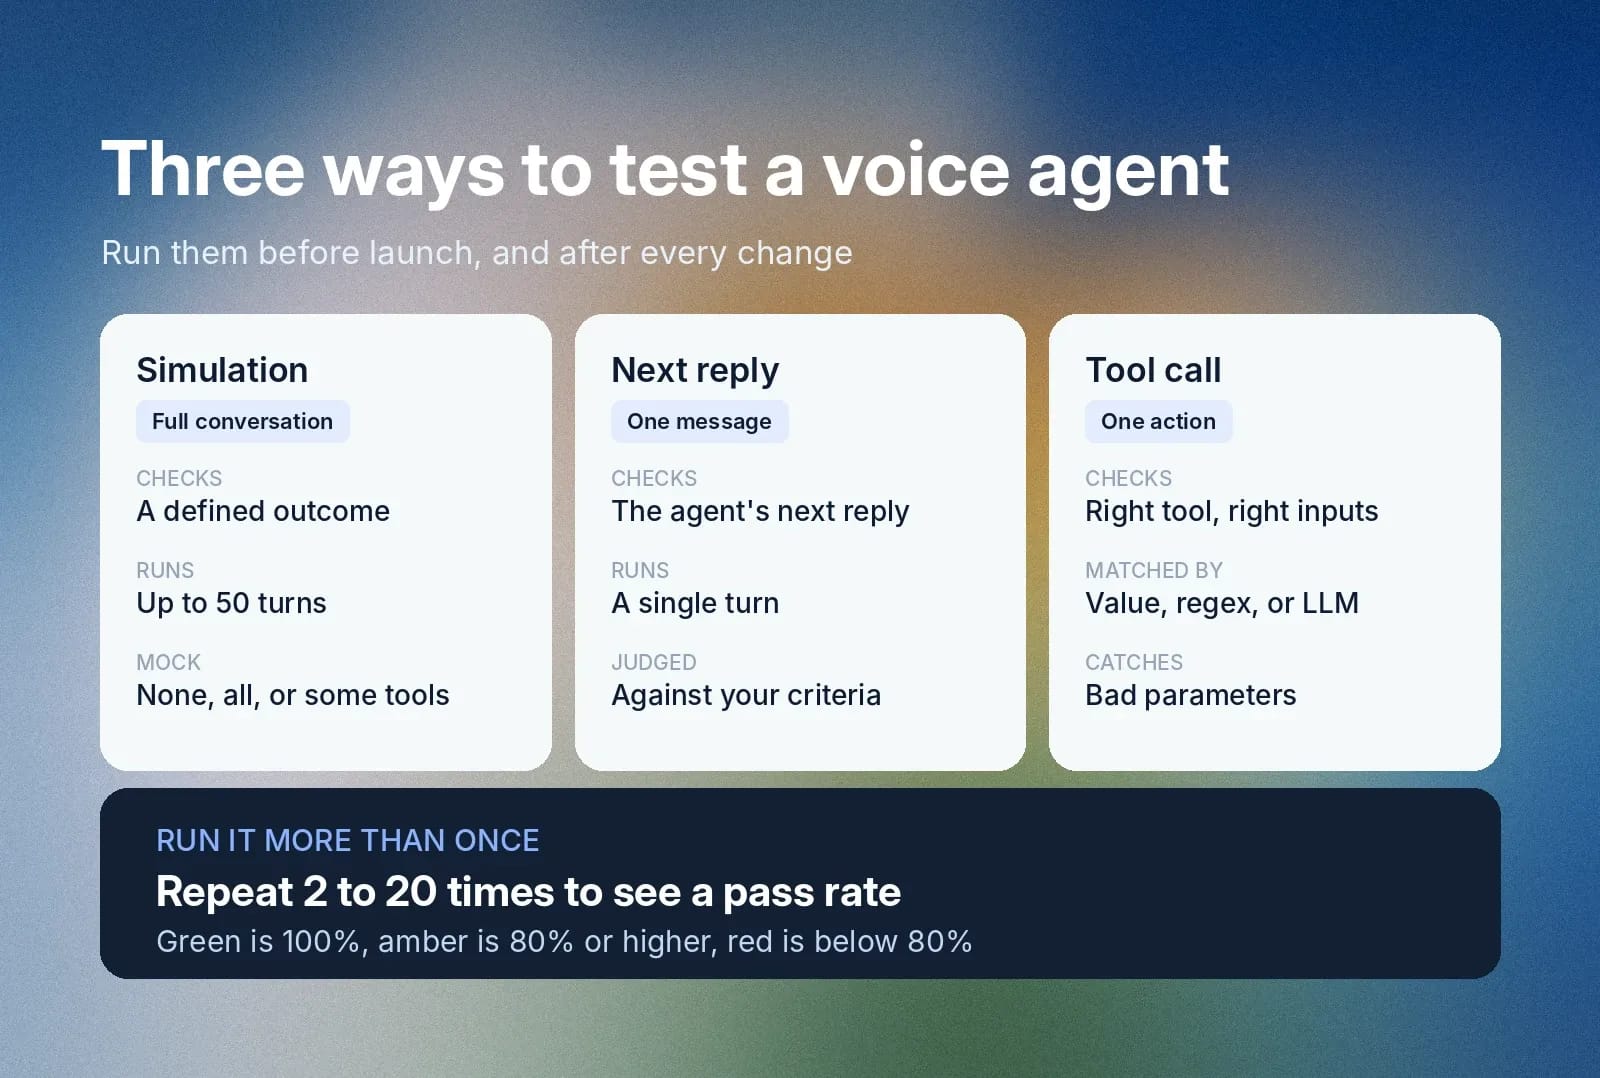
ElevenAgents bietet drei Agententesttypen. Simulation führt ein vollständiges Gespräch mit einem simulierten Nutzer und prüft, ob ein definiertes Ergebnis erreicht wird – mit bis zu 50 Turns, standardmäßig 5. Next-Reply-Tests bewerten nur die nächste Nachricht des Agenten anhand Ihrer Kriterien. Tool-Call-Tests prüfen, ob der Agent das richtige Tool mit den richtigen Parametern nutzt; abgeglichen wird über exakte Werte, Regex oder LLM-Bewertung. In Simulationen können Sie keine, alle oder ausgewählte Tools simulieren.
Warum es wichtig ist
Ein einzelner erfolgreicher Lauf zeigt, dass ein Agent erfolgreich sein kann. Wiederholte Tests zeigen, wie oft er es sein wird. Die API akzeptiert repeat_count von 2 bis 20, und die Ergebnisse zeigen eine Erfolgsquote. Grün bedeutet 100 %, Gelb 80 % oder mehr und Rot weniger als 80 %. Fehler werden nach Ursache gruppiert. Prompts, Modelle, Workflows und Integrationen verändern alle das Verhalten, daher wird auch nach dem Start weiter getestet.
So funktionieren Experimente
Experimente sind A/B-Tests auf Basis der Agentenversionierung. Sie verzweigen Ihre Konfiguration, ändern eine Variable wie System-Prompt, Workflow, Stimme, Tools, Wissensdatenbank oder LLM-Einstellungen und leiten einen Teil des Live-Traffics zur Variante. ElevenLabs empfiehlt, mit 5 bis 10 % zu beginnen.
Das Routing ist anhand der Conversation ID deterministisch. Ein bestimmter Nutzer bleibt also im selben Zweig, und die Prozentsätze müssen insgesamt 100 % ergeben. CARS24, ein Kunde von ElevenLabs, steigerte den Traffic wie im Bericht beschrieben über 5 %, 10 %, 20 %, 50 % und 100 % und hielt jede Stufe zwei Tage.
Tests vor dem Start und Live-Experimente verwandeln Änderungen gemeinsam in messbare Verbesserungen.
Observability: Messen, was in der Produktion passiert
Observability ist die Fähigkeit, zu sehen, was der Agent getan hat, wie er abgeschnitten hat und gegebenenfalls wo er fehlgeschlagen ist. Ein Agent, der in einem Test funktioniert, kann sich bei echten Anrufern anders verhalten. Vollständige Observability und überprüfbare Aufzeichnungen sind daher unverzichtbar.
Was sie tut
Die Gesprächsanalyse bewertet jeden Anruf. Die Erfolgsauswertung wendet von Ihnen definierte Kriterien für Zielerreichung und Qualität an, und die Datenerfassung extrahiert strukturierte Felder wie Kontaktdaten und Problemtyp. Das Analyse-Dashboard ergänzt Anrufvolumen, Dauer, Kosten, Fehlerraten und Latenz. Aktive Anrufe werden in Echtzeit aktualisiert, und bei steigenden Fehlerraten werden Warnungen ausgelöst.
Warum sie wichtig ist
Ohne Monitoring ist ein schlechter Anruf nur eine Anekdote. Damit sehen Sie, welcher Knoten, welches Tool oder welches Modell das Problem verursacht hat.
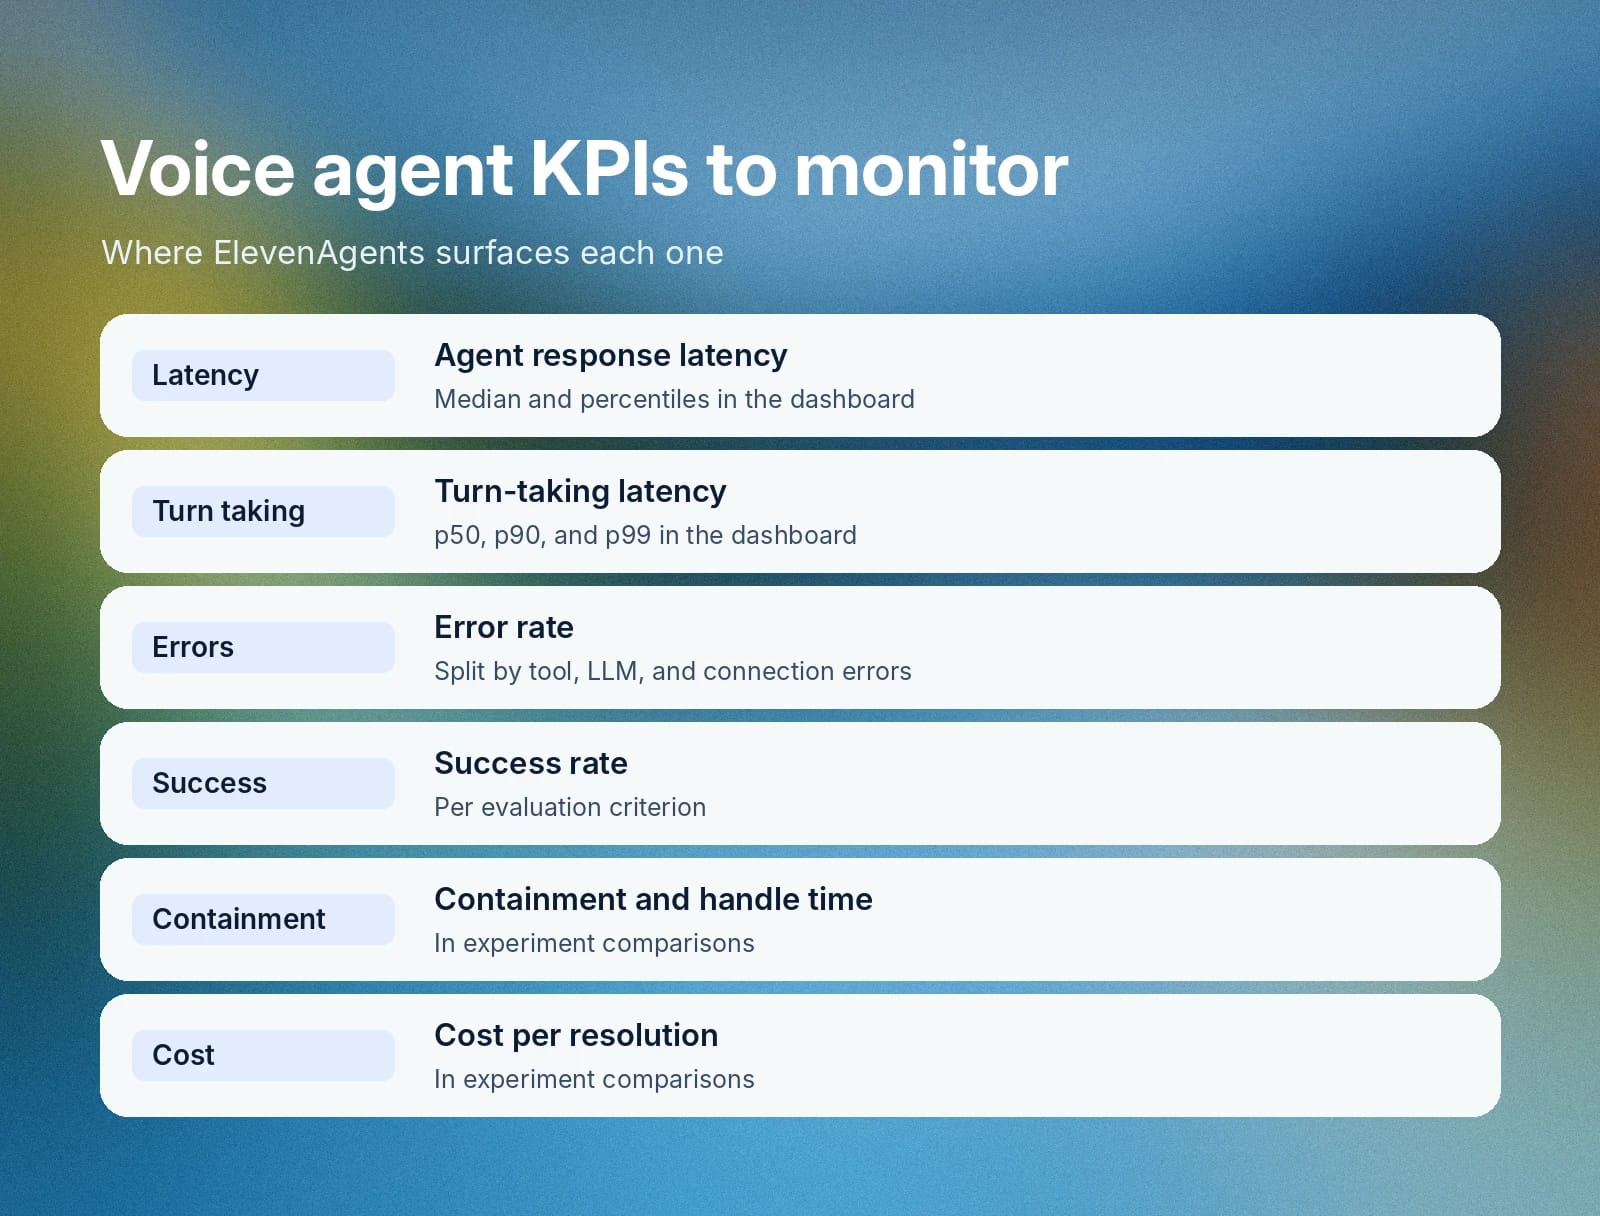
KPI
Was sie aussagt
Wo ElevenAgents sie anzeigt
Antwortlatenz des Agenten
Wie lange Anrufer auf eine Antwort warten
Analyse-Dashboard, Median und Perzentile
Turn-Taking-Latenz
Wie schnell der Agent seinen Turn übernimmt
Analyse-Dashboard, p50, p90 und p99
Fehlerrate
Anteil der Gespräche mit Fehlern
Dashboard, aufgeschlüsselt nach Tool-, LLM- und Verbindungsfehlern
Erfolgsquote
Zielerreichung je Kriterium
Bewertungskriterien mit Raten für Erfolg, Fehler und unbekannt
Containment-Rate und Bearbeitungszeit
Ohne menschliche Hilfe gelöste Anrufe und Anrufdauer
Experimentvergleiche
Kosten pro Lösung
Was jedes gelöste Gespräch kostet
Experimentvergleiche
Wählen Sie die Metriken, die für die konkrete Aufgabe am nützlichsten sind. Ein Support-Agent stützt sich auf Lösungs- und Eskalationsrate, während ein Outbound-Agent sich hauptsächlich auf Verbindung und Abschluss konzentriert.
Skalierung, Zuverlässigkeit und Übergabe an Menschen
Voice-KI-Infrastruktur muss leistungsfähig sein, egal ob Sie mit 5 oder 500.000 Kunden sprechen. Auch bei hohem Volumen müssen diese Komponenten robust sein und bei Bedarf an Menschen eskalieren können.
Was es tut
Skalierung bedeutet, viele gleichzeitige Gespräche über Spracherkennung, LLM-Inferenz, Sprachsynthese, Integrationen und Telefonie zu unterstützen. Zuverlässigkeit bedeutet, dass jede dieser Abhängigkeiten einen definierten Fehlerpfad hat. Übergabe bedeutet einen klaren Weg zu einem Menschen.
Sie sind zwar streng genommen keine Komponenten der Voice-KI-Infrastruktur, aber in der Praxis allesamt entscheidende Bestandteile eines guten Systems.
Warum es wichtig ist
Ein System, das zehn Testanrufe verarbeitet, kann sich bei zehntausend anders verhalten. Ein Buchungstool, bei dem ein Timeout auftritt, darf nicht dazu führen, dass der Agent eine Buchung bestätigt, die nie erfolgt ist. Ein Anrufer, der nach einer Person fragt, muss diese mit intaktem Kontext erreichen – typischerweise über eine warm transfer.
So macht es ElevenAgents
Limits für gleichzeitige Vorgänge richten sich nach dem Abonnement, und die Anrufwarteschlange hält Anrufer, wenn ein Limit erreicht ist. LLM-Cascading deckt Modellausfälle ab. Transfer-to-Number-Knoten, das Transfer-to-Number-System-Tool und Agent Transfer ermöglichen die Übergabe; Bewertungskriterien können entscheiden, wann eskaliert wird. Stille Zeiträume werden mit 5 % des üblichen Minutentarifs abgerechnet.
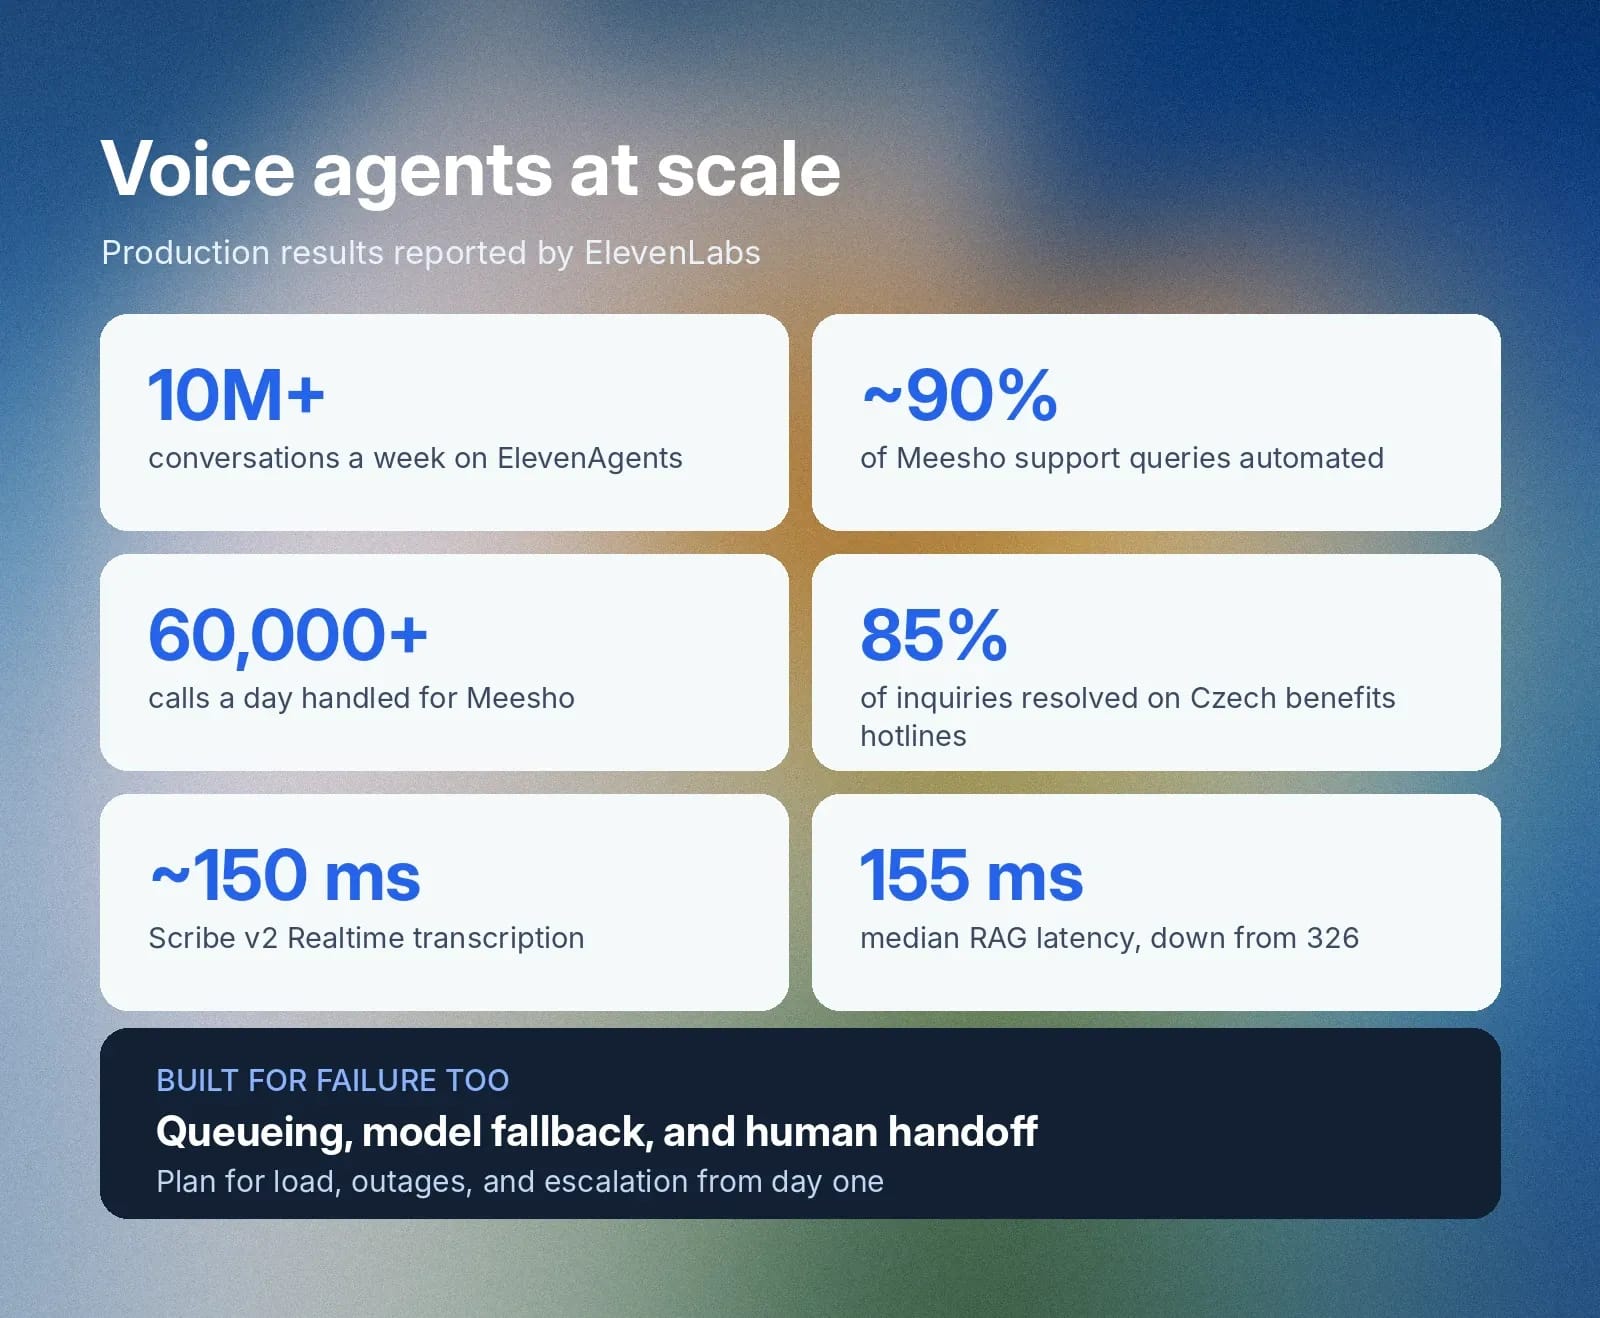
ElevenLabs berichtet über Produktionsergebnisse im großen Maßstab. ElevenAgents verarbeitet mehr als 10 Millionen Gespräche pro Woche. Meesho automatisiert laut Bericht „Building Enterprise-grade Voice Agents“ etwa 90 % der Supportanfragen über mehr als 60.000 Anrufe täglich. In der Tschechischen Republik bearbeiten ElevenLabs-gestützte Agenten laut Bericht „State of Conversational Agents in Government“ täglich rund 5.000 Anrufe auf nationalen Leistungshotlines und lösen 85 % der Anfragen selbstständig.
Die Planung für Last, Ausfälle und Übergaben von Anfang an unterscheidet eine Demo von einem Deployment.
Worauf Sie bei produktionsreifer Voice-KI-Infrastruktur im Jahr 2026 achten sollten
Nutzen Sie diese Checkliste, um jede Voice-KI-Plattform anhand Ihrer Anforderungen zu bewerten.
- Spracherkennung: präzise Transkripte für Ihre Sprachen, Akzente und Audioqualität, einschließlich Namen und Kennungen.
- Turn Taking: konfigurierbares Verhalten am Turn-Ende, Barge-in und eine gemessene Reaktionszeit bei Unterbrechungen.
- Modellauswahl: ein auswählbares LLM pro Agent oder Subagent, eine Option für ein individuelles LLM und automatischer Fallback.
- Orchestrierung: mehrstufige Workflows und Routing zwischen spezialisierten Agenten.
- Tools: Webhooks, Client Tools, MCP-Unterstützung und Freigabekontrollen.
- Wissen: Ihre eigenen Dokumente mit messbarer Abruflatenz.
- Personalisierung: Anruferdaten sind verfügbar, bevor das erste Wort gesprochen wird.
- Stimme: kurze Zeit bis zur ersten Sprache sowie Kontrolle über Aussprache und Ausdruck.
- Kanäle: Telefon, Web, Mobilgeräte und Messaging mit SDKs und API.
- Guardrails: konfigurierbare Verhaltensgrenzen mit bekannten Latenzkosten.
- Tests: simulierte Gespräche, Prüfungen von Tool-Aufrufen und wiederholte Läufe.
- Experimente und Analysen: A/B-Tests, Perzentil-Latenz und Fehleraufschlüsselungen.
- Skalierung und Übergabe: dokumentierte Parallelität, Warteschlangen und Eskalation an Menschen.
Führende Systeme für KI-Voice-Agents wie ElevenAgents bieten Ihnen alle diese Komponenten auf einer Plattform.
Starten Sie noch heute, indem Sie das Team kontaktieren, oder entwickeln Sie eigene KI-Agentensysteme, indem Sie ein Konto erstellen.
Häufig gestellte Fragen zur Voice-KI-Infrastruktur

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.