Word Error Rate (WER): Zentrale Konzepte, Formel und Anwendungsbereiche
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Theoretisch ist die Word Error Rate (WER) eine Kennzahl zur Bestimmung der Genauigkeit eines Automatic Speech Recognition-Tools (ASR). Eine niedrige WER bedeutet ein genaueres finales Transkript, während eine höhere Fehlerrate auf fehlerhaft transkribierte Informationen hinweist.
In der Praxis kann die WER den Unterschied ausmachen zwischen medizinischer Transkriptionssoftware, die dokumentiert, dass ein Patient „fünfzehn Milligramm“ statt „fünfzig Milligramm“ eines Medikaments benötigt. Sie entscheidet auch darüber, ob ein Support-Tool die Anliegen eines Kunden korrekt transkribiert oder Nutzer frustriert zurücklässt.
In diesem Artikel erklären wir, was WER ist, wie sie berechnet wird und wie Sie damit Ihren eigenen ASR-Anbieter vergleichen können.
Zusammenfassung
- Die Word Error Rate zählt drei Fehlertypen – Ersetzungen, Löschungen und Einfügungen – und teilt sie durch die Wortanzahl im Referenztranskript.
- Die Formel für WER lautet: WER = (S + D + I) / N.
- Niedrigere WER-Werte bedeuten eine genauere Ausgabe.
- Eine WER von unter 5 % ist ein guter Richtwert, auch wenn rechtliche oder medizinische Transkriptionen eine noch niedrigere Word Error Rate erfordern können.
- WER behandelt alle Fehler gleich und ist daher keine perfekte Kennzahl für die kontextbezogene Bewertung. Neuere Metriken wie die Semantic Word Error Rate (SWER) sollen dies lösen, indem sie messen, ob die Bedeutung einer Äußerung erhalten blieb.
Was ist die Word Error Rate?
Die Word Error Rate (WER) ist die Standardkennzahl zur Messung der Spracherkennungsgenauigkeit in Speech-to-Text-Modellen. Sie gibt auf einer Skala von 0 bis 1 an, was ein STT-System beim Transkribieren falsch macht (0,8 entspricht einer Fehlerrate von 80 %), basierend auf Ersetzungen, Löschungen und Einfügungen.
Eine Ersetzung liegt vor, wenn ein Wort durch ein falsches ersetzt wird. Eine Löschung bedeutet, dass ein Wort vollständig fehlt. Bei einer Einfügung enthält das Transkript ein Wort, das nie gesprochen wurde. Die WER verwendet alle drei Komponenten und teilt sie durch die Wortanzahl im korrekten Transkript. So erhalten Sie einen Wert, den Sie mit anderen Anbietern vergleichen können.
Hier ist die ausgeschriebene WER-Formel:
WER = (S + D + I) / N
Dabei gilt:
- S: Ersetzungen (Wort ist falsch)
- D: Löschungen (Wort fehlt)
- I: Einfügungen (zusätzliches Wort ist vorhanden)
- N: Gesamtzahl der Wörter im Referenztranskript
Sie können die WER als Dezimalzahl oder Prozentwert angeben. Je niedriger die WER, desto besser war das Ergebnis, da das Modell beim Transkribieren weniger Fehler gemacht hat.
In der Praxis bedeutet eine WER von 10 %, dass etwa 1 von 10 Wörtern in Ihrem Meeting-Transkript überprüft werden muss.
Warum ist die Word Error Rate für Spracherkennungssysteme wichtig?
Die Word Error Rate liefert eine objektive Kennzahl, mit der Teams verschiedene Anbieter vergleichen können. Sie geht über Marketingversprechen hinaus und zeigt klar, wie genau ein Spracherkennungsmodell ist. Unternehmen, die ihre Optionen anhand von Daten bewerten, erkennen so klar, welche Modelle derzeit führend sind.
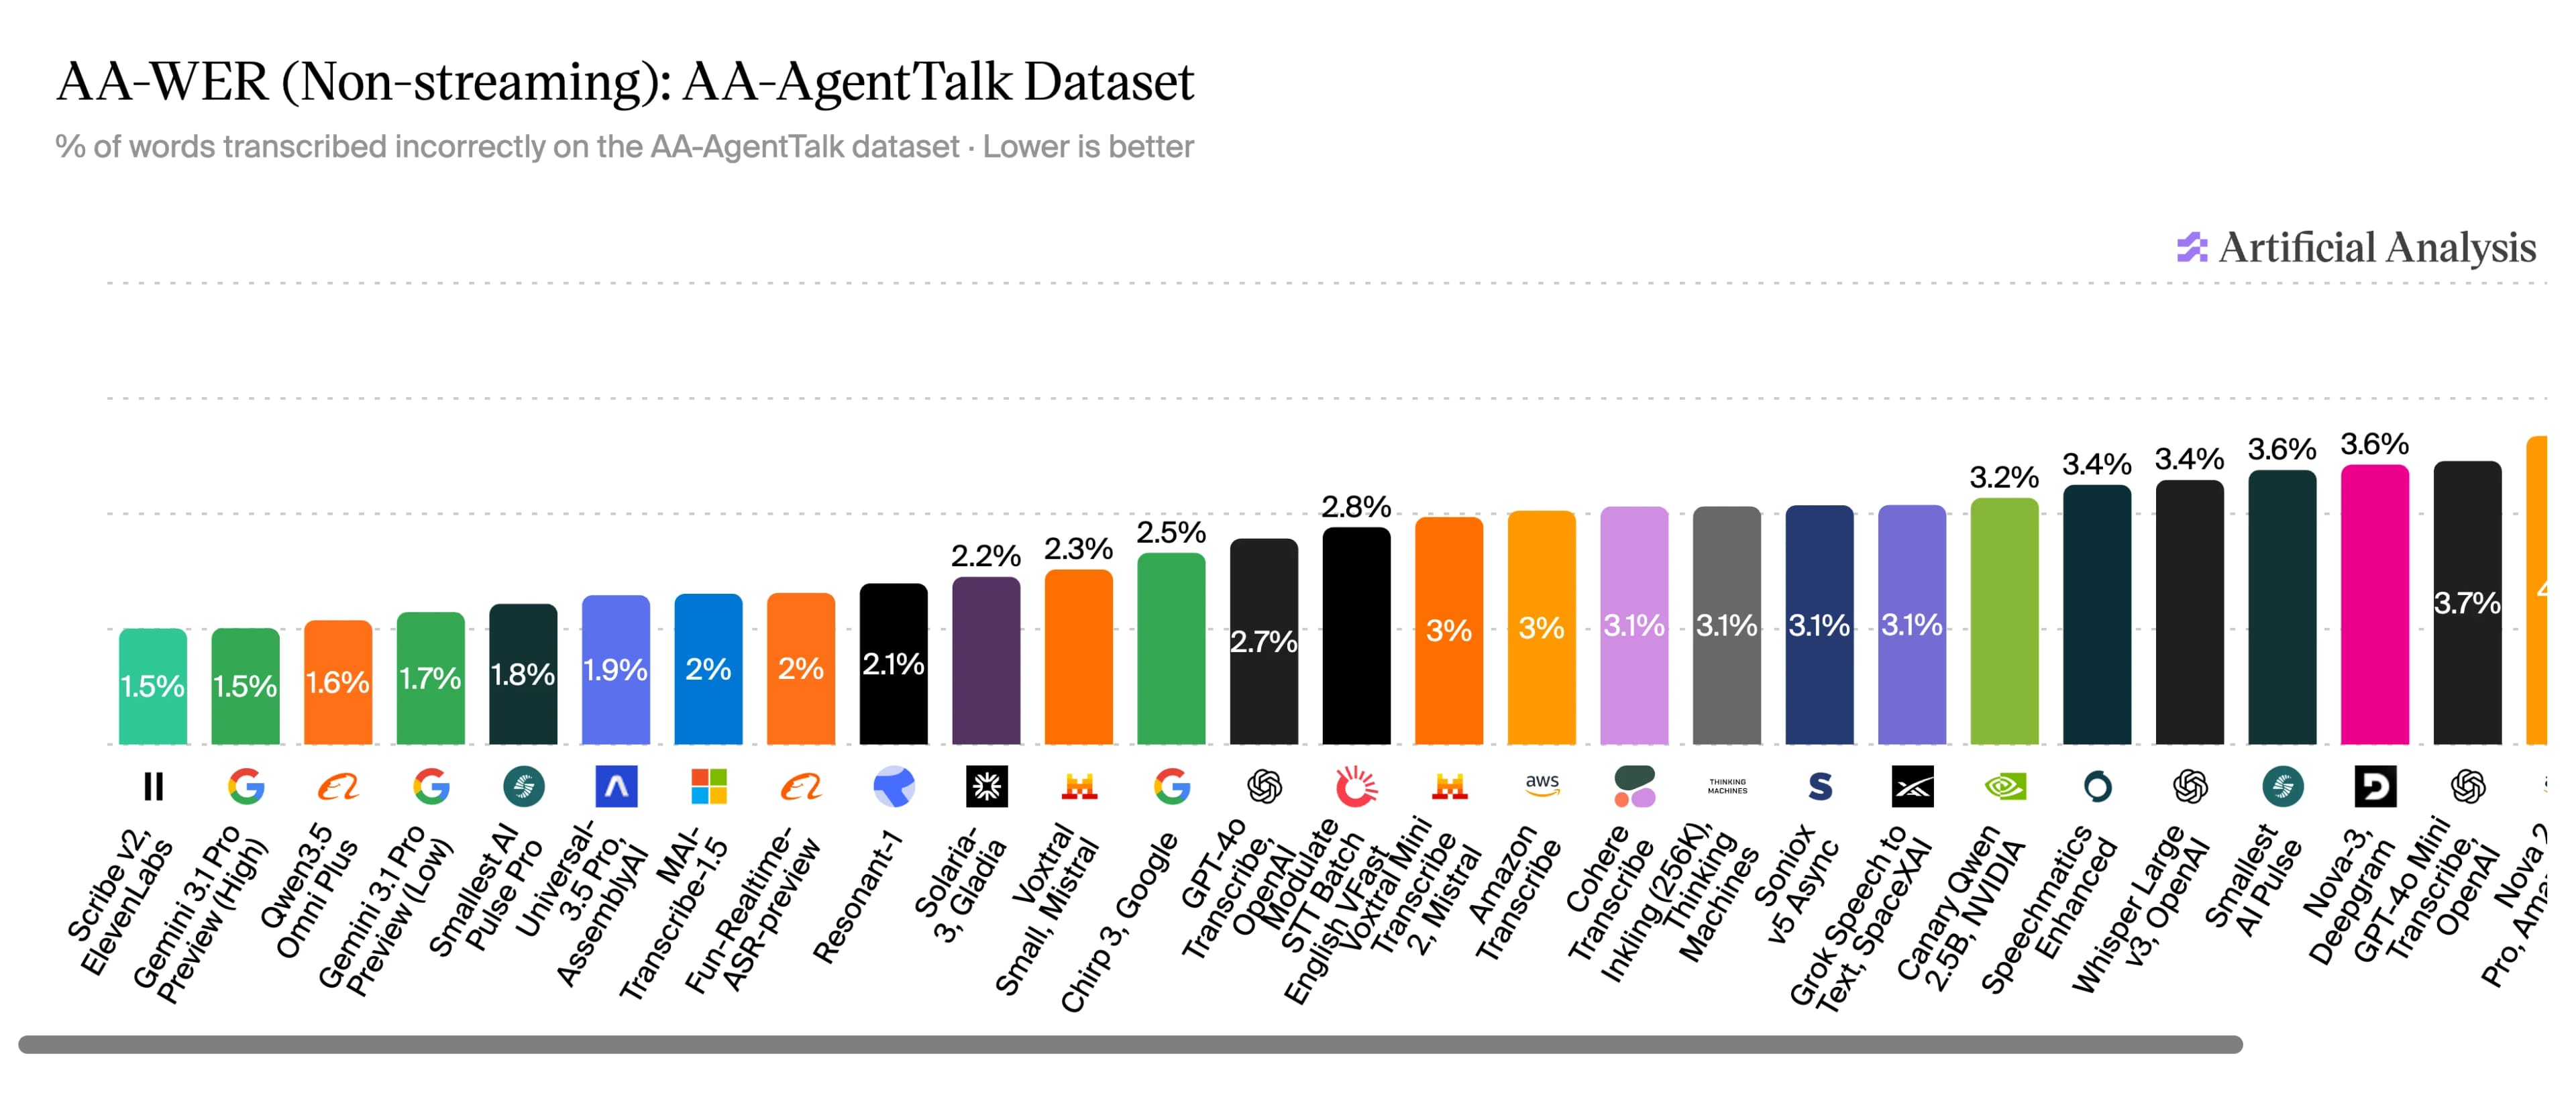
Quelle: Artificial Analysis, abgerufen am 10. Juli 2026.
Laut unabhängigen Untersuchungen von Artificial Analysis liegt ElevenLabs’ Scribe v2 seit Juli 2026 beim AA-AgentTalk-Datensatz für nicht-streamende Transkriptionsmodelle mit 1,5 % WER an der Spitze der Branche.
Über die Anbieterbewertung hinaus hat die WER auf Produktebene reale Auswirkungen. Medizinische Transkriptionssoftware mit einer WER von 12 % könnte kritische Fehler in Patientenakten einführen. Fehlerhafte Transkriptionen in einem Kundensupport-Gespräch können Folgefehler verursachen, etwa ungenaue Sentiment-Analysen oder eine schlechte Kategorisierung.
Über diese anwendungsspezifischen Probleme hinaus sind bei Fehlern von ASR-Systemen oft jene Menschen am stärksten betroffen, für die ein Transkript die einzige Möglichkeit ist, auf gesprochene Inhalte zuzugreifen. Das World Wide Web Consortium bietet für weiteren Kontext umfangreiche Dokumentation zu den Mindeststandards, die von Barrierefreiheitsinitiativen erwartet werden.
Word Error Rate berechnen: Formel und Beispiel
Die Berechnung der Word Error Rate ist einfach, wenn Sie die Schritte kennen. Wie oben erläutert, verwenden Sie die Formel WER = (S + D + I) / N. Die Begriffe wurden oben erklärt: Ersetzungen, Löschungen, Einfügungen und N für die Gesamtzahl der Wörter in der Transkription.
So berechnen Sie die WER:
- Referenztranskript erstellen: Nutzen Sie menschliche Transkription und Prüfung, um eine genaue Transkription eines Audioclips zu erstellen.
- Ihr STT-Tool verwenden: Transkribieren Sie den Audioclip mit einer ASR-Plattform und erstellen Sie so ein KI-Transkript für Ihren Test.
- Die beiden Versionen abgleichen: Nutzen Sie dynamische Programmierung, insbesondere den Levenshtein-Algorithmus, um die minimale Anzahl an Änderungen zu ermitteln. Auf diesen Algorithmus gehen wir in einem späteren Abschnitt näher ein.
- Formel anwenden: Zählen Sie die Gesamtzahl der Fehler in der KI-generierten Version im Vergleich zur menschlich geprüften Fassung und berechnen Sie dann mit WER = (S + D + I) / N die exakte WER.
Auf dem Papier wirkt das recht technisch, in der Praxis ist es jedoch viel einfacher. Dieses Übungsbeispiel zeigt, was gemeint ist.
Referenztranskript: Mrs. Dalloway sagte, sie würde die Blumen selbst kaufen.
ASR-Ausgabe: Miss Dalloway sagte, sie würde Blumen selbst kaufen.
Bei der Berechnung der Gesamtfehler erhalten wir 1 S und 1 D bei insgesamt 9 Wörtern.
Mit der Formel ergibt sich: WER = 2 / 9 = 0,222 = 22,2 %.
Word Error Rate mit Python berechnen
Die manuelle Methode funktioniert gut, aber Sie sparen Zeit, wenn Sie die WER mit Python berechnen. Die jiwer-Bibliothek erledigt all das vollständig automatisch.
Mithilfe der jiwer-Dokumentation können Sie das Paket installieren, das speziell zur Bewertung eines ASR-Systems und zur Ermittlung zentraler Kennzahlen wie der WER entwickelt wurde. Nach dem Download können Sie mit folgendem Code die WER schnell mit Python berechnen:
Beachten Sie, dass sich die ASR-Ausgabe in diesem Beispiel an zwei Stellen von der ursprünglichen Referenz unterscheidet. Das Wort „jumps“ wurde fälschlich als „leaps“ transkribiert (eine Ersetzung) und „last“ vor „lazy“ eingefügt (eine Einfügung). Bei zwei Fehlern in den neun Wörtern des Referenztranskripts ergibt sich eine Word Error Rate (WER) von 0,222 bzw. 22,2 %.
Word Error Rate und andere Erkennungsmetriken vergleichen
WER ist die Standardkennzahl zur Berechnung der Genauigkeit eines ASR-Systems, doch es gibt weitere Tools. Zum Beispiel:
- Character Error Rate (CER): Ähnlich wie die WER misst sie die Transkriptionsgenauigkeit auf Zeichen- statt auf Wortebene. Sie eignet sich besonders für Sprachen ohne klare Wortgrenzen (Scriptio continua) oder für Aufgaben, bei denen die Schreibweise entscheidend ist.
- Match Error Rate (MER): Misst den Anteil der Transkriptionsfehler, behandelt Ersetzungen, Einfügungen und Löschungen jedoch etwas anders als die WER. Der Fokus liegt auf dem Anteil falscher Elemente in einem Satz.
- Word Information Lost (WIL): Eine Schätzung, wie viele der ursprünglichen Informationen bei der Transkription verloren gingen. Sie misst die Verständlichkeit statt wie die WER die direkte Fehleranzahl.
- Embedding Error Rate (EmbER): Bietet eine semantische Analyse zwischen den Transkriptionen. Sie geht über die WER hinaus und liefert Einblicke in die semantische Distanz zwischen dem korrekten Wort und der fehlerhaften Transkription.
Jede dieser Metriken eignet sich am besten für ein anderes Szenario. Diese Tabelle bietet eine Übersicht:
Levenshtein-Distanz: Die Mathematik hinter der WER
Die Word Error Rate misst letztlich die Distanz zwischen dem Original und der Hypothesenausgabe. Um diesen Unterschied mathematisch zu verstehen, verwenden wir die Levenshtein-Distanz.
Die Levenshtein-Distanz zählt die minimale Anzahl einzelner Änderungen, die nötig sind, um eine Sequenz in eine andere umzuwandeln. Für die WER sind das konkret Ersetzungen, Einfügungen und Löschungen. Um beispielsweise „Cat“ in „Mat“ umzuwandeln, müssten Sie den Buchstaben „C“ durch „M“ ersetzen. Die Levenshtein-Distanz beträgt dann 1.
Bei CER-Berechnungen kommt dies deutlich häufiger vor, doch die WER überträgt die Levenshtein-Distanz auf die Wortebene. Jede Einheit ist ein ganzes Wort statt eines Zeichens. Die tatsächliche Distanz misst, wie viele Wortänderungen nötig wären, um unsere ASR-Ausgabe in das korrekte Original umzuwandeln.
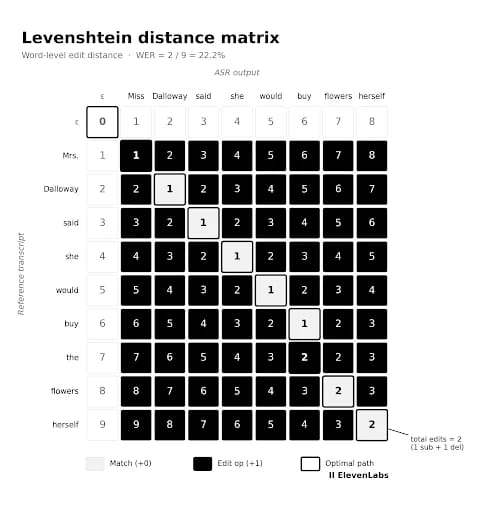
Wir erstellen eine Matrix, in der jede Zelle die Gesamtdistanz zwischen dem Originaltranskript und dem ASR-Transkript darstellt. Die Levenshtein-Distanz füllt die Matrix dann von links oben nach rechts unten aus; die letzte Zelle gibt die Gesamtzahl der Änderungen auf Wortebene an. Wenn Sie diese Zahl durch N teilen, erhalten Sie die WER.
Diese Matrix wird normalerweise mit einzelnen Zeichen berechnet. Zur Vereinfachung sehen Sie hier jedoch eine skalierte Version unseres vorherigen Beispiels.
Häufige Fallstricke und Missverständnisse bei der Word Error Rate
Insbesondere weil STT-APIs zugänglicher werden und ASR-Software ein gängiger Teil umfassenderer Agent-Stacks wird, werden wir viele Vergleiche zwischen verschiedenen Tools sehen.
Bevor Sie eigene Word Error Rates berechnen, sollten Sie einige häufige Probleme und Missverständnisse kennen.
- Alle Fehler sind gleich: Die WER behandelt jeden Fehler als gleich bedeutsam. In vielen Kontexten kann das in Ordnung sein, für manche Anwendungsfälle ist es jedoch nicht akzeptabel. In einem Krankenhaus kann beispielsweise eine Fehlerrate von 5 %, die als gute WER gilt, dennoch untragbar sein, weil schon ein oder zwei Fehler Patienten gefährden könnten. Diese Einschränkung führte zur Entwicklung neuerer Metriken wie der Semantic Word Error Rate (SWER). Sie soll messen, ob die Bedeutung eines Satzes erhalten blieb, statt ob jedes Wort exakt übereinstimmt.
- WER kann über 100 % liegen: Obwohl wir zuvor angegeben haben, dass die WER zwischen 0 und 1 liegt, kann sie auch über 100 % liegen. Das liegt daran, dass Einfügungsfehler zu mehr Wörtern führen können, als das ursprüngliche Transkript enthält. Ein häufiges Beispiel ist die Transkription von „I’m“ als „I am“, wodurch aus einem Wort zwei werden.
- Eine niedrigere WER ist technisch nicht immer besser: Auf dem Papier ist eine WER von 5 % besser als eine WER von 10 %. Wenn die Fehler, die zu den 5 % beitrugen, jedoch den Kontext eines Satzes erheblich verändern, während jene bei 10 % das nicht tun, zeigt die Kennzahl nicht das ganze Bild. Der Kontext bleibt entscheidend. Deshalb werden Metriken wie SWER entwickelt, die diese semantische Auswirkung gezielt erfassen.
2024 veröffentlichte Apple eine interessante Studie zum zuletzt genannten Punkt. Als Menschen eine WER-Berechnung von 9,4 % danach bewerteten, ob das ASR-Ergebnis lesbar war, gaben sie derselben Passage eine WER von nur 2,2 %. Im getesteten Beispiel sahen Menschen die „Fehler“ in vielen Fällen als unbedeutend an. Dadurch war die menschliche WER mehr als viermal nachsichtiger als die von Maschinen.
Branchen-Benchmarks für WER
Die ideale WER hängt stark von der Branche oder dem Anwendungsfall ab, in dem Sie ASR-Technologie einsetzen. Während unter 5 % ein Branchen-Benchmark für die WER ist, benötigen Bereiche wie medizinische oder juristische Transkription eine deutlich niedrigere Rate.
In der Studie von Artificial Analysis vom Juli 2026 erreichte ElevenLabs Scribe v2 eine WER von 1,5 %. Wichtig ist jedoch, dass diese Statistiken üblicherweise für Englisch als Primärsprache erhoben werden. STT-Technologie kann in anderen Sprachen weniger effektiv sein.
Die ElevenLabs Docs erläutern die allgemeinen WER-Bereiche für alle Sprachen, die Scribe v1 und Scribe v2 unterstützen.
Mit ElevenAPI starten und die Erkennungsgenauigkeit steigern
Wenn Sie eine Anwendung oder ein Produkt entwickeln, bei dem die Transkriptionsqualität entscheidend ist, zeigt sich der Unterschied zwischen einer gut gewählten ASR-API und einer mittelmäßigen zunächst in Ihrer WER und dann in den Erfahrungen Ihrer Nutzer.
ElevenLabs Scribe ist die Speech to Text-Ebene, die über ElevenAPI verfügbar ist. Neben über 90 Sprachen und einer branchenführenden WER bietet sie Funktionen wie Sprecherdiarisierung, Zeitstempel auf Wortebene, Keyterm Prompting und Entitätserkennung.
Entdecken Sie die ElevenLabs Docs, um mehr über ElevenAPI zu erfahren, oder starten Sie noch heute mit der Registrierung.
FAQ zur Word Error Rate

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.